首页 文章 精选 留言 我的

精选列表

搜索[k],共10000篇文章
优秀的个人博客,低调大师

19.7K Star!让AI代码审查省82倍Token!这个开源项目太狠了!

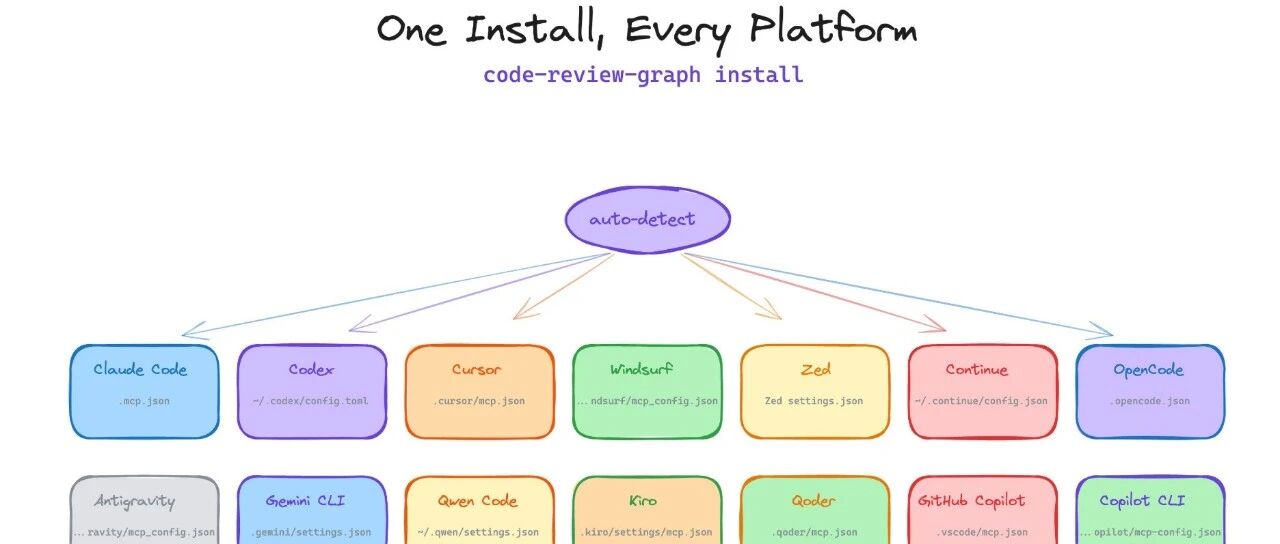
**大多数AI编码工具默认"给越多上下文越好",但事实恰恰相反**。 精准的结构化上下文,远优于海量的原始文本。 刚好前几天我发现了 **code-review-graph** 这个开源项目。它的slogan很直接:**"Stop burning tokens. Start reviewing smarter."** ![](https://developer.qcloudimg.com/http-save/yehe-2946312/b2435adb9f6fadb3ee415f7adb015e27.jpg) 这个项目的核心思想和我手动做的事情一样,但它把整个流程自动化了。它构建代码库的结构化依赖图,让AI助手只读取真正相关的文件。 ![](https://developer.qcloudimg.com/http-save/yehe-2946312/ffef892a749841bcdef4ed4905bd18c4.png) ### **工作原理** code-review-graph的工作流程可以分为三步: **第一步:构建图谱**。它用Tree-sitter解析整个代码库,提取出函数、类、导入、调用关系、继承关系等,把这些信息存储到一个SQLite数据库里,形成一个结构化的知识图谱。 **第二步:增量更新**。当文件发生变化时,它不是重新解析整个仓库,而是通过SHA-256哈希检查,只重新解析变化的文件及其依赖。一个2900个文件的项目,增量更新只需要不到2秒。 **第三步:精准查询**。当AI需要审查代码时,它查询这个图谱,通过"爆炸半径分析"(Blast-radius Analysis)找出所有受影响的文件,然后只把这些文件提供给AI。 ### **核心亮点** #### **1. 爆炸半径分析——精准定位影响范围** 当你修改一个文件时,code-review-graph会追踪所有调用者、依赖项和相关测试。 比如你改了`utils/validator.py`里的`validate_email`函数,它会找出所有调用这个函数的文件、所有导入了这个模块的文件,以及所有测试这个函数的测试文件。 这样AI就只读这些受影响的文件,而不是整个代码库。 #### **2. 增量更新——2秒内完成重建** 这是code-review-graph最惊艳的特性之一。 传统的代码索引工具每次更新都要重新扫描整个仓库,大项目可能要几分钟。但code-review-graph通过SHA-256哈希检查,跳过未修改的文件,只重新解析变化的部分。 官方数据显示:一个2900个文件的项目,增量更新时间**不到2秒**。 #### **3. Monorepo杀手——27700个文件变15个** 大型Monorepo是AI代码审查的重灾区。一个Next.js项目有27732个文件,让AI全部读一遍简直是灾难。 但code-review-graph通过图谱过滤,能把27700+文件排除在审查上下文之外,实际只读取约15个相关文件。 #### **4. 30+语言支持——几乎覆盖所有主流语言** code-review-graph 支持的语言包括:Python、JavaScript/TypeScript/TSX、Go、Rust、Java、C/C++、C#、Ruby、Kotlin、Swift、PHP、Scala、Solidity、Dart、R、Perl、Lua/Luau、Objective-C、Shell、Elixir、Zig、PowerShell、Julia、SQL、Vue/Svelte SFCs、Astro,甚至包括Jupyter Notebook。 而且添加新语言非常简单,不需要修改代码,只需要在`.code-review-graph/languages.toml`里配置一下就行。 ### **性能基准** 项目官方做了6个真实开源仓库的基准测试,数据非常惊人: |仓库|原始Token数|图查询Token数|降低倍数| | --- | --- | --- | --- | |fastapi|951,071|2,169|528.4x| |code-review-graph|208,821|2,495|93.0x| |gin|166,868|1,990|91.8x| |flask|125,022|1,986|71.4x| |express|135,955|3,465|40.6x| |httpx|89,492|2,438|38.0x| **中位数:约82倍**。也就是说,平均下来,AI只需要读原来1/82的内容就能完成审查任务。 ### **快速上手** #### **安装方式** ``` # 方式一:pip安装 pip install code-review-graph # 方式二:pipx安装(推荐,隔离环境) pipx install code-review-graph # 方式三:uv安装(最快) uv pip install code-review-graph ``` #### **配置平台** 安装完成后,运行`install`命令,它会自动检测你当前使用的AI编码工具,并配置好MCP连接: ``` code-review-graph install ``` 如果你只想配置特定平台,可以用`--platform`参数: ``` code-review-graph install --platform cursor # 仅配置Cursor code-review-graph install --platform claude-code # 仅配置Claude Code code-review-graph install --platform copilot # 仅配置GitHub Copilot code-review-graph install --platform gemini-cli # 仅配置Gemini CLI ``` 支持的平台包括:Codex、Cursor、Claude Code、Gemini CLI、Kiro、GitHub Copilot (VS Code)、GitHub Copilot CLI。 #### **构建图谱** 进入你的项目目录,运行`build`命令: ``` code-review-graph build ``` 初次构建大约需要10秒(500文件项目)。构建完成后,你就可以在AI助手中使用了。 #### **在AI助手中使用** 打开你的AI编码工具(如Cursor、Claude Code等),然后直接问: ``` Build the code review graph for this project ``` 或者直接让它审查代码: ``` Review this PR and identify potential issues ``` AI会自动调用code-review-graph查询相关文件,只读取必要的代码。 ### **写在最后** 不论你是: 1. 1. **AI编码工具重度用户**——每天用Cursor、Claude Code等工具写代码 1. 2. **大型项目开发者**——在Monorepo或几千个文件的项目中工作 1. 3. **成本敏感型团队**——不想为浪费的Token支付高额费用 1. 4. **追求审查质量**——希望AI给出更精准的代码分析 那么code-review-graph都值得一试。 GitHub:https://github.com/tirth8205/code-review-graph ![](https://developer.qcloudimg.com/http-save/yehe-2946312/d3b70b786eae80123ccceda197f35b72.gif) 如果本文对您有帮助,也请帮忙点个 赞👍 + 在看 哈!❤️ **在看你就赞赞我!** ![](https://developer.qcloudimg.com/http-save/yehe-2946312/17ea0dca23dc9d33802a7baaf7e0ad92.gif)
优秀的个人博客,低调大师

太炸了,21.4K star !多Agent智能 , 结合Claude Code,效率真的起飞

![Swarm Logo](https://developer.qcloudimg.com/http-save/yehe-11919542/f5778c6558cfc7bd3bb0a161c2d41ac6.png) 2026年,聊AI如果不提“多智能体”,差不多等于带了手机出门忘插SIM卡——时髦是挺时髦,就是感觉少了点啥。 搞开发的人最近应该注意到一个趋势:**曾经的聊天机器人正在悄悄变成一支看不见的“打工队伍”。** 不是跟一个AI来回拉扯,而是一群AI各司其职,像流水线上的工人一样,接活、干完、丢给下一个人——全程不用管,代码就写好了。 那谁在管这件事? ![](https://developer.qcloudimg.com/http-save/yehe-11919542/fe45009bee8f6cc30c0f796df46acafc.png) 主角登场了:OpenAI Swarm,一个主打“轻量级多智能体编排”的开源框架,GitHub星数已经冲到**21400+的仓库**,虽然比不上2-3万的那几位大神,但后台资源不容小觑。它背后的核心队伍就是OpenAI那帮工程师——有AIPI团队的骨干,也有从迁移学习和分布式系统研究出来的技术好手。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/9248e975fc43ba1bbdeb07677839c8b2.png) ## **一、「一句话交接」** 先说说Swarm到底是个什么怪物。 市面上的多智能体框架,有的像螺丝刀套装,有的是吃灰还带说明书那种。Swarm走了一条截然相反的路——它几乎没往里面加东西,而是做**减法**。 Swarm只靠两个东西活着:**Agents(智能体)** 和**Handoffs(交接)** 。 Agent长什么样?说白了就是一个“系统指令+一组可调用的函数”。你让它写代码,它就是一个写代码的Agent;你让它测试,它就是一个测试的Agent。角色完全由你定义,跟换工作服似的——换身衣服,换个岗位。 Handoffs就更离谱了。一个Agent干完自己的活,直接返回另一个Agent对象,Swarm就自动换人。整个对话历史还会带走,新Agent拿到老Agent手上所有的上下文,无缝衔接。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/8a407096558809eb16c299bda0997dd9.png) |框架|核心复杂度|上手门槛|适合干嘛| | --- | --- | --- | --- | |OpenAI Swarm|极简(2个概念)|半天|学习多智能体原理、快速原型| |LangGraph|中高|几天|状态复杂的图式工作流| |CrewAI|中等|1-2天|角色分工明确的团队任务| |Claude Agent SDK|中高|需要适应|编程、文件系统与MCP深度整合| 数据参考多框架对比分析 这就好比打电话去客服——接线员听你说“我要退款”,然后“啪”一声接通了退货专员的电话,全程无感的体验。只不过在Swarm里,那个“接线员”和“专员”都是AI,听不懂方言的问题当然也存在,但逻辑是一致的。 ## **二、「一把起子」** 说完了“是什么”,来拆个机看看“怎么装”。 装Swarm的条件非常低配——**Python 3.10或以上**就够了,没有别的卡脖子要求。 **第一步:把框架搞下来** ``` pip install git+https://github.com/openai/swarm.git ``` 这行命令直接从GitHub仓库拉取安装。没有多余的依赖,装完就能用。 **第二步:导入并创建客户端** ``` from swarm import Swarm, Agent client = Swarm() ``` 就这么简单。⚠️ 这里有个小坑:Swarm默认会使用OpenAI的API,如果服务器不在同一区域,网络延迟会比较明显。 **第三步:定义你的第一个Agent** ``` defhandoff_to_tester(): return tester_agent coder_agent = Agent( name="Coder", instructions="你是一个写Python的工程师,输出可直接运行的代码。", functions=[handoff_to_tester], ) tester_agent = Agent( name="Tester", instructions="你是一个代码测试员。收到代码后,找出可能的逻辑错误。", ) response = client.run( agent=coder_agent, messages=[{"role": "user", "content": "写个判断闰年的函数"}], ) ``` 如果你想用一个测试类别的场景做个完整演示:定义一个 Python 代码生成代理,当它编写完功能模块后,通过交接机制自动激活一个 Code Review 智能体完成检查。整个流程在调用链式交接的情况下依然保持流畅。 **完整可跑的示例**可以在官方GitHub仓库的`examples/basic`目录里看到,那里有交接、函数调用、上下文变量等多种基础模式的实现。 ![Swarm Diagram](https://developer.qcloudimg.com/http-save/yehe-11919542/d8b4923bce57a5f6f46a127541b8819e.png) 运行完输出大致是这样的: > 💬 Coder: 这是判断闰年的函数`:def is_leap(year): return year % 4 == 0 and (year % 100 != 0 or year % 400 == 0`) 🔄 交接给了 Tester 💬 Tester: 收到。考虑边角案例1900年和2000年,1900返回False是预期行为,2000返回True也正确。但需确认调用方对输入year的数据类型做好校验。 整个流程下来,写代码的和测试代码的是两个人(两个Agent)。自然,如果交接链条太长,算力消耗会显著增加,这需要在实际使用时根据任务复杂度而非简单数量来把握分寸。 ## **三、「一群打手」** 装了也跑了,那这玩意儿到底能拿来干嘛?还有,Claude Code跟它搞在一起又能干出什么名堂? ### **场景一:一夜之间,产出一套完整项目** 假设有个需求:开发一个带购物车功能的小型电商前端。传统的路径是给AI丢一句话让它全写出来,大概会得到一堆bug夹杂CSS惨不忍睹的样子。 用Swarm包装一下就不一样了——搞一套专门分工的队伍: - **PM Agent**:拆需求。确定购物车需要哪些数据结构和交互逻辑。 - **前端Agent**:写HTML/CSS/JS骨架。搭建页面的核心布局。 - **逻辑Agent**:补全购物车的增删改和价格计算功能。 - **测试Agent**:自动化跑边界测试。完成全流程检测后输出报告。 - **文档Agent**:最后收尾补齐代码注释和使用说明。 这5个Agent在Swarm的交接链条上一个接一个动起来,最后送出来的是一个带验证代码和一串简短文档说明的产物。 ### **场景二:Claude Code加入,让智力升级** Claude Code的官方Agent SDK(现称Claude Agent SDK)提供了文件系统读写、Shell命令执行以及通过MCP协议连接Slack/GitHub/Playwright等200多个外部服务的能力。 让Claude Agent SDK与Swarm做“并联”时,发生的化学反应很直接: - Swarm负责**拆解任务路线图**:把一个大目标切成若干小任务,配给不同的Agent。 - Claude Agent扮演**任务引擎**:负责具体干重的活——写代码、读文件、执行命令、调API。 光说不练不合适,来看一个能跑起来的**代码级示例**: ``` # 先引入Claude Agent SDK from anthropic import Anthropic claude = Anthropic() # Swarm负责代理调度 from swarm import Swarm, Agent defcode_with_claude(task_description): resp = claude.messages.create( model="claude-sonnet-4-5-2026", messages=[{"role": "user", "content": task_description}] ) return resp.content[0].text defexecute_code_generation(): response = code_with_claude("给出一段Python脚本,从OpenWeatherMap获取当前温度并格式化打印") return response code_exec_agent = Agent( name="ClaudeCoder", instructions="使用 Claude Code 引擎完成生成并返回代码。", functions=[execute_code_generation], ) ``` 在这个结构里,Swarm 跑在 `code_exec_agent` 这一层,负责承接上游传来的需求指令;Claude SDK 是具体干活的那双手,真正生成代码的时候才调用它。两者之间不需要多建额外的桥接层,逻辑上各管一段。 ### **场景三:从0到1,高速企业级应用** 还有一个更“重”的可能方向:OpenAI自有的 Agents SDK(2025年3月发布的Swarm生产化后续版本)配合Claude Agent SDK的深层MCP集成,让整个多智能体团队在架构层面获得更好的保障——包括沙箱级别的安全运行环境、自动重试能力,以及跨系统的微服务自动化整合。 这已经不是“做个Demo玩一玩”的级别,它正在指向一种**不需要人工大量干预的软件工程模式**。 再猛一点,参考Cursor在2026年初的实验——并发跑100多个LLM编码Agent,连续几周在大型项目上自主运行,产出了远超人力能企及的工作量。虽然不是通用的,但这个方向正在变得越来越具体。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/522973ae465d82f4a178541bdcf0a01e.png) ## **写在最后** Swarm的核心价值其实就一句话:**它让复杂的AI协作,变得像写注释一样简单。** 多数人以为多智能体是个超级复杂的事情——动不动就是十几个Agent同时跑,状态管理一团乱麻。但Swarm告诉你,多智能体其实可以很简单:每个Agent做一件事;做完了,交给下一个——接力跑。 而Claude Code的加入,让这条接力线有了更强的爆发力。Swarm负责“管事儿”,Claude负责“干活儿”,两个家伙凑在一起,确实能让开发这件事变得高效不少。 如果你还没试过多智能体编排,就从Swarm开始玩吧——轻量、干净、不费脑子。再加上Claude Code加速,可能真的会刷新对“效率”的认知。 **#多智能体** **#OpenAI** **#Swarm框架** **#ClaudeCode** **#AI编程** **#2026技术教程** **#两万星开源项目**

优秀的个人博客,低调大师

API Server 全挂,k8s 集群还能活多久?用一个实践

> 内容有点长,可收藏后续查看。 **可能的场景** 凌晨三点,你被 PagerDuty 吵醒。告警面板一片飘红:`kubectl get nodes`返回 `Unable to connect`。 你的第一反应可能是:**整个集群完蛋了。** 但事实是——业务 Pod 依然在跑,用户流量依然在转发。 API Server 挂了,集群并没有你想的那么脆弱。 --- 这是 **「Kubernetes Cluster HA 故障演练」**系列的第四篇。前几篇我们验证了单 Master 宕机、LB 节点故障、ETCD 多数派失效,这一篇我们玩个更狠的——**直接停掉所有 API Server 实例**,看看集群到底会怎样。 ### **故障演练系列** - **EP.1**一台 Master 宕机 —— 集群无感知 - **EP.2LB 节点整机宕机 —— VIP 漂移验证** - **EP.3**ETCD 多数派失效 —— 控制面瘫痪 - **EP.4**API Server 全挂(本文)—— 各组件降级行为验证 --- ## **一、"API Server 挂了"到底是什么意思?** 在深入实验之前,先厘清一个关键概念:"API Server 挂了"并不只有一种情况。 ### **场景一:单个实例故障 → 用户无感** 三 Master 高可用部署中,如果 `master01`上的 API Server 进程异常退出,但负载均衡器健康检查正常且其余两个实例正常,`kubectl`请求会自动转发到 `master02`或 `master03`——用户几乎无感知。 ### **场景二:所有实例不可用 → 本文实验场景** Kubernetes API 入口完全消失: ``` kubectl get nodes # Unable to connect to the server: EOF ``` 集群进入"失聪失明"状态。 ### **场景三:进程在跑,但连不上 etcd** API Server 仍在监听 `6443`,但与 etcd 之间链路出问题。写操作全部失败,部分只读请求可能短暂成功。这种场景更"诡异"。(EP.3 已验证) 本文重点讨论 **场景二**——最能帮助我们理解控制面与数据面边界的极端场景。 > **核心认知纠正:**API Server 是集群的"控制入口",不是"运行时执行者"。它负责认证、鉴权、写入 etcd,但**不负责让容器活着**。 ### **各组件对 API Server 的依赖关系** |组件|主要依赖|全宕后影响| | --- | --- | --- | |kubectl|CRUD 所有资源|完全无法操作| |Controller Manager|Watch 资源变化、更新状态|停止调谐,自愈停摆| |Scheduler|Watch Pending Pod、写入绑定|新 Pod 永远 Pending| |kubelet|获取 Pod 清单、上报状态|已有容器继续运行| |kube-proxy|Watch Service/Endpoint|转发规则仍生效| |etcd|被动被 API Server 访问|不受影响| --- ## **二、原理推演:各组件会怎样?** 实验之前,先理解每个组件的工作机制,观察现象时才能知其所以然。 ### **1. Controller Manager:不退出,但调谐完全停止** Controller Manager 的设计哲学:**持续观察集群当前状态,驱动至用户声明的期望状态。** 它并非不断轮询 API Server,而是通过 **Informer 机制**建立长连接 Watch。全宕后: - **Watch 连接中断**——不再收到任何新增/修改事件 - **本地缓存定格**——内存中的资源快照停留在故障前最后一刻 - **Reconcile 全部失败**——即使发现需要创建 Pod,调用 API 也会 connection refused - **进程不崩溃**——持续输出 lease 续约失败日志,等待恢复 **各控制器的具体影响:** - **Deployment / ReplicaSet Controller**:无法创建或删除 Pod,即使 Pod 被手动 kill 也无法补足副本数 - **StatefulSet Controller**:无法创建新的 Stateful Pod - **Node Controller(关键)**:正常情况下 kubelet 每 10 秒上报心跳,超过 40 秒未收到会标记 NotReady。但 API Server 全宕时,Node Controller 自身也无法更新 Node 对象——**节点状态永远定格,即便某节点真的宕机,外部也看不到变化** > **结论:**Controller Manager 进程保持运行,但完全丧失获取新状态和修改资源的能力。已有 Pod 不会被主动删除,也不会被恢复。 ### **2. Scheduler:无法调度,但不会崩溃** Scheduler 的工作很简单:找到 `spec.nodeName`为空的 Pod(Pending),挑一个最优 Node,写回 Binding。 API Server 全宕后,调度决策无法写入 etcd,所有调度行为停滞。但 Scheduler 进程保持运行,持续尝试重连。 实际上,由于 kubectl 创建 Deployment 这一步就已经失败,**根本不会有新 Pod 对象产生**。但故障前已处于 Pending 的 Pod 会一直等下去。 > **结论:**Scheduler 自身不崩溃,但无法获取新任务也无法写回调度结果。已运行的 Pod 不受影响。 ### **3. kubelet:已有 Pod 会不会停?——最关键的误解** 很多人直觉认为:kubelet 失去了与集群的联络,Pod 应该会停止。 **事实恰恰相反——不会停止。** kubelet 不是"远程遥控"的代理,它是运行在每个节点上的**自主管理进程**,拥有独立的本地状态和对容器运行时的直接控制权。 一旦某个 Pod 被调度到该节点并且 kubelet 成功启动了对应容器,这个 Pod 的运行状态就存在于一条**完全的本地链路**中,不再需要与 API Server 实时通信即可维持容器存活。 kubelet 内部有一个关键组件——**PLEG (Pod Lifecycle Event Generator)**。它通过定期调用 CRI 检查容器状态,只要容器运行时正常,PLEG 就能独立工作,不依赖 API Server。 **API Server 全宕后,kubelet 受影响的功能:** 1. **节点心跳无法上报**——Lease 续约失败 1. **新 Pod 无法被分配**——创建链路依赖 API Server 1. **Pod 状态无法同步**——外部看到的状态永远定格在故障前 但最关键的是:**容器崩溃了,kubelet 仍然能在本地重新拉起。**只要 Pod 的 `restartPolicy`为 `Always`或 `OnFailure`,kubelet 通过 PLEG 检测到退出事件后会在本地重新启动容器,整个过程无需 API Server 参与。 > **结论:**API Server 故障期间,kubelet 仍能维护已运行容器,执行探针与重启策略。节点上的业务容器不会因 API Server 宕机而终止。 ### **4. kube-proxy:已有网络规则不消失** 已刷入内核的 iptables/IPVS 规则仍然存在,Linux 内核不会主动删除。**已有 Service 的流量转发不受影响。** 但任何 Service/Endpoint 变化都无法同步,可能导致部分新 Pod 无法接收流量。 ### **5. etcd:完全不受影响** etcd 只与 API Server 通信,不感知上层的 Kubernetes 资源。API Server 只是 etcd 的一个客户端——**API Server 宕机不会导致 etcd 停止。**只要 etcd 集群满足 quorum,它就会继续运行。 > etcd 的 Raft 共识和多数派机制,是整篇集群"扛住"的根本。 ### **6. 为什么已有的 Pod 不会被杀?** Pod 的删除需要经历完整的请求链路: ``` 用户/控制器 → API Server 接收请求 → 写入 deletionTimestamp → kubelet 收到事件 → 执行清理 ``` API Server 全宕时,**删除请求根本无法被接收和处理**。已在运行的 Pod 永远不会收到删除指令。 --- ## **三、实验:直接停掉所有 API Server** ### **实验环境** - Kubernetes v1.36 | 3 Master + 3 Worker - 容器运行时:containerd - CNI:Calico - 负载均衡:HAProxy(VIP 方式访问 API Server) ### **实验前检查:建立健康基线** 所有节点 Ready,核心组件 Running,部署 nginx 测试业务,验证访问正常。 ![实验前集群状态](https://developer.qcloudimg.com/http-save/yehe-12454170/5df265b5d79eb21305d3bcfae3a5f97d.png) 实验前集群状态 ![核心组件 Pod 状态](https://developer.qcloudimg.com/http-save/yehe-12454170/20e2ef79170ea0c56ad8204d126e5cc3.png) 核心组件 Pod 状态 ![测试业务创建及访问](https://developer.qcloudimg.com/http-save/yehe-12454170/726dfbfa54bbac0927fb4152f42c0c6d.png) 测试业务创建及访问 ### **停掉所有 API Server 实例** kubeadm 将 API Server 作为静态 Pod 运行,停止方法是将清单文件移出监控目录: ``` # 在所有 Master 节点上执行 mv /etc/kubernetes/manifests/kube-apiserver.yaml /tmp/ ``` kubelet 几秒内检测到文件消失,停止对应容器。验证: ``` kubectl get nodes --request-timeout=5s # client rate limiter Wait returned an error: # context deadline exceeded - error from a previous attempt: EOF kubectl get nodes # Unable to connect to the server: EOF ``` > **⚠️ 排障提示:**看到 `EOF`不要误以为是网络配置问题!本实验中 kubectl 经过 HAProxy LB,后端容器停止后 TLS 握手阶段就断开了,LB 把这个 EOF 透传给 kubectl。直连或等 LB 健康检查更新后,才会看到 `connection refused`。 ![kubectl 连接被拒](https://developer.qcloudimg.com/http-save/yehe-12454170/b4b9e670242adc9db18394631587db8a.png) kubectl 连接被拒 ### **确认:业务容器还在跑** 登录 Worker 节点直接查看容器运行时: ``` sudo crictl ps | grep nginx # e6cac9a74deae nginx 41 minutes ago Running nginx-f79c7c654-kfb52 ``` 容器仍在运行,启动时间停在 41 分钟前——**API Server 的消失对已运行的容器没有任何影响。** ![](https://developer.qcloudimg.com/http-save/yehe-12454170/33533cee5ef9a194c0cde52a62d01ac3.png) nginx 容器仍在运行 验证业务流量: ``` curl http://: # Welcome to nginx! ``` 已有 Service 转发规则依然有效。 ![curl 访问成功](https://developer.qcloudimg.com/http-save/yehe-12454170/d7c4583036ad7ea69f498434c5094d61.png) curl 访问成功 ### **控制面组件:冻结而非崩溃** **Controller Manager 日志**中高频出现 Leader Election 租约获取失败: ``` E0715 06:59:22 leaderelection.go:461] "Error retrieving lease lock" err="dial tcp 192.168.114.145:6443: connect: connection refused" lock="kube-system/kube-controller-manager" ...(每 2-3 秒一条,持续输出) ``` 注意:**不是 Watch 失败,而是 Lease 续约失败。**当前 leader 仍会在租期内尝试履职,但所有需要访问 API Server 的操作全部失败。进程从未退出。 **Scheduler 日志**显示它卡在启动阶段的缓存同步: ``` I0715 06:22:02 shared_informer.go:402] "Waiting for caches to sync" ``` Informer 需要从 API Server List 全量资源完成初始缓存同步,这一步永远无法完成。Scheduler 卡在启动流程中,既没有完成缓存同步,也没有进入正常调度循环。 ![Scheduler 与 Controller 真实日志](https://developer.qcloudimg.com/http-save/yehe-12454170/d341fc07ab37f59ee643ab91535b4ff0.png) Scheduler 与 Controller 真实日志 尝试扩容和创建新 Pod 均失败: ``` kubectl scale deployment nginx --replicas=5 # Unable to connect to the server: EOF kubectl run test-nginx --image=nginx # Unable to connect to the server: EOF ``` ![](https://developer.qcloudimg.com/http-save/yehe-12454170/8cdd0ff04d7de6454c0db613989833e2.png) ### **kubelet 心跳失败与节点状态冻结** kubelet 与 API Server 的交互远不止心跳上报,至少涉及**四类请求**: ``` # 1. Lease 续约失败(节点心跳) E0715 15:31:14 controller.go:201] "Failed to ensure lease exists" err="...EOF" interval="7s" # 2. Node Status 上报失败 E0715 15:31:16 kubelet_node_status.go:479] "Error updating node status" err="...EOF" # 3. Webhook 认证失败 E0715 15:31:10 webhook.go:154] Failed to make webhook authenticator request err="...EOF" # 4. Event 写入失败 E0715 15:31:11 event.go:368] "Unable to write event" err="...EOF" ``` > **⚠️ 关键点:**由于 Node Controller 自身也无法通过 API Server 更新节点状态,所以节点**不会被标记为 NotReady**,基于 NotReady 触发的 Pod 驱逐也不会发生。整个集群对节点状态的观察是"冻结"的。 ### **核心验证:kubelet 能否独立重启容器?** 这是本次实验最关键的验证——**手动停掉一个容器,看 kubelet 能否自行拉起。** **步骤 1**:查看 nginx 容器,记录 ID ``` sudo crictl ps | grep nginx ``` **步骤 2**:手动停止该容器 ``` sudo crictl stop ``` **步骤 3**:再次查看——**全新容器 ID,启动时间在几秒内** ``` sudo crictl ps | grep nginx # 全新的容器 ID,刚刚启动 ``` ![容器重启前后 ID 对比](https://developer.qcloudimg.com/http-save/yehe-12454170/7e66e420d96a9b0487f6ee761961902d.png) 容器重启前后 ID 对比 > **✅ 这直接证明了:**kubelet 对已调度到本节点的 Pod 拥有完整的本地自治能力。容器的存活与 API Server 无关,完全由节点上的 kubelet 和容器运行时决定。 --- ## **四、恢复 API Server,集群如何自愈?** 将清单文件移回原位: ``` mv /tmp/kube-apiserver.yaml /etc/kubernetes/manifests/ ``` kubelet 检测到文件变化,约 30 秒至 1 分钟后 API Server 完全就绪。 ![API Server 容器恢复](https://developer.qcloudimg.com/http-save/yehe-12454170/82eb9c178689c19acd90d3e4afa4b0ad.png) API Server 容器恢复 恢复后,各组件迅速重新建立 Watch 连接: - **Controller Manager**:重新 List/Watch 所有资源,发现副本数不足立即创建 Pod - **Scheduler**:重新 Watch Pending Pod,立即执行调度 - **kubelet**:重新上报节点和 Pod 状态,获取新分配的 Pod ![恢复后集群状态](https://developer.qcloudimg.com/http-save/yehe-12454170/25c55da310abd658890e1a4f30969ea1.png) 恢复后集群状态 --- ## **五、实验结果总结** |组件/资源|故障期间|恢复后| | --- | --- | --- | |API Server|完全不可用|容器重建后恢复| |etcd|正常运行,数据完整|无影响| |Controller Manager|Watch 中断,调谐停止|重新同步,继续 Reconcile| |Scheduler|无法调度新 Pod|立即处理积压 Pending Pod| |kubelet|本地维护容器,可重启|恢复上报,获取新 Pod| |已有 Pod|正常运行,不受影响|无影响| |已有 Service 流量|转发规则仍在内核中|同步最新规则变更| |新 Pod 创建|完全失败|控制器按需创建| |Node 状态|冻结,不标 NotReady|心跳恢复,状态更新| --- ## **六、为什么 Kubernetes 能做到"控制面挂了,业务不停"?** 这背后是四个核心设计原则的集中体现: 1. **控制面与数据面严格分离**——控制面负责全局调度和状态管理,数据面负责本地容器运行。两者通过异步 API 调用解耦,而非实时心跳强关联。 1. **声明式模型**——用户只声明期望状态,控制器持续驱动实际状态向期望状态靠拢。短暂中断只暂停驱动过程,不破坏状态本身。 1. **Informer 与本地缓存**——各组件维护从 API Server 同步的本地缓存,Watch 中断后缓存依然保留全量快照,重连后有上下文可循。 1. **etcd 独立持久化**——所有期望状态安全保存在 etcd 中,与 API Server 生命周期完全解耦。只要 etcd 存活,集群就拥有"恢复记忆"的能力。 --- ## **七、生产环境启示** - **部署高可用 API Server**——至少 3 个 Master,前端 LB 使用 `/healthz`或 `/readyz`做健康检查 - **监控关键指标**——请求延迟、错误率、etcd 延迟、API Server 内存/CPU(防 OOM) - **防范常见诱因**——etcd 性能下降、证书过期、准入 Webhook 阻塞、资源竞争 - **定期故障演练**——只有真实演练才能确认集群承受能力 --- ## **八、常见问题** **Q:API Server 全宕后,Pod 会被杀掉吗?** A:不会。Pod 删除需要 API Server 下发 `deletionTimestamp`。API Server 不可用时,删除命令根本无法生成。 **Q:API Server 挂了还能创建 Pod 吗?** A:不能。创建 Pod 的第一步就是访问 API Server,不可达则整个流程中断。 **Q:挂多久才算危险?** A:没有绝对阈值。短期中断业务通常无感,但随着时间拉长,自动扩容、故障自愈、状态同步全部丧失。建议 5 分钟内恢复,超过 15 分钟需人工介入。 **Q:恢复后数据会丢失吗?** A:不会。期望状态完整保存在 etcd 中,恢复后控制器根据 etcd 数据进行 Reconcile,使集群恢复一致。 **Q:故障期间节点重启了怎么办?** A:节点重启后 kubelet 需从 API Server 获取 Pod 清单。如果 API Server 仍不可用,Pod 无法恢复,直到 API Server 恢复后由控制器在其他节点重建。 --- ## **九、总结** 1. API Server 是控制面的唯一入口,但**不是容器运行时的依赖** 1. API Server 全宕后,业务 Pod 不会停止,数据面继续运行 1. Controller Manager 和 Scheduler 不会退出,但暂停所有控制能力 1. kubelet 能独立维护已调度 Pod,甚至本地重启崩溃的容器 1. 已有 Service 网络规则不受影响,流量转发正常 1. API Server 恢复后,集群通过声明式模型自动修复所有偏差 > 理解这些行为,也就掌握了 Kubernetes 高可用架构设计的核心思想: **控制面可以短暂"失聪失明",但只要 etcd 数据完好、数据面组件健壮,业务就能持续运行,系统终将自愈。** --- > 如果这篇文章帮你真正理解了 Kubernetes 控制面与数据面的边界,欢迎关注 「一根头发丝的宽度」。 这里不会只讲概念,而是坚持用 真实实验 + 源码原理 + 架构图解,拆开 Kubernetes 每一个容易误解的知识点。 本文完整实验过程、所有命令、日志截图、组件时序图,以及 API Server 故障实验 EP.1~EP.3 已整理到个人站点。 📖 点击「阅读原文」,查看完整版。

优秀的个人博客,低调大师

这个 8K Star 的项目做到了!

我最近一直在想一个问题。 现在的AI应用,聊天能力越来越强,但界面还是死的。 你跟它说“给我画个销售漏斗图表”,它给你一段文字描述,或者一段JSON。然后你得把这段话复制给前端,前端再照着画一遍。 这不叫AI生成界面,这叫AI帮你写了个需求文档。 我一直在找一个东西:**能让AI直接生成能操作、能点击、能刷新的真实界面。** 后来看到了OpenUI。(thesysdev/openui) ![OpenUI GitHub 项目卡片](https://developer.qcloudimg.com/http-save/yehe-5359587/2cb5103bd47b00c56f2e0c1d00640506.png) Stars:7,734 | Forks:565 | License:MIT | 主要语言:TypeScript | 最近更新:2026-07-04 **01 它到底解决了啥?** 先说我自己的感受。 我之前用Claude帮我写过一个数据看板。它写代码很快,但改界面特别折腾。 “把柱状图放在表格左边”、“筛选器放在顶部”、“颜色调成蓝色系”……每一轮都要重新生成完整代码,然后刷新页面看效果。 一来一回,改一次界面要5分钟。 我当时就想:**如果AI能直接在我眼前把界面搭出来,就像拖组件一样实时,那该多爽。** OpenUI就是干这个的。 它不是一个聊天界面,也不是一个API封装。它是一套让LLM直接生成**可交互界面**的工程框架。 ![OpenUI 生成与执行架构](https://developer.qcloudimg.com/http-save/yehe-5359587/29ce207e969f3657c16bd4c97d80845d.png) 底层有一个叫OpenUI Lang的语法。模型用这套语法描述界面,前端一边接收一边渲染,**就像打字一样,一边出文字一边出界面**。 你问它“给我一个销售漏斗”,它直接给你一个可以点、可以筛选的漏斗图表,而不是一段描述。 ![OpenUI Lang 工作流](https://developer.qcloudimg.com/http-save/yehe-5359587/0c3d8488d98d4fa07a0ea8434ffb42a7.png) **02 我最在意的三个点** **第一个,它生成的界面,是用你自己的组件。** 这是我最看重的一点。 很多AI生成UI的工具,吐出来的是HTML,或者是它自己定义的一套组件。你没法控制样式,没法接业务逻辑,用起来很别扭。 OpenUI的思路是:**你先把你的组件库告诉模型,模型只能在你的组件里组合。** ![OpenUI 响应式数据流](https://developer.qcloudimg.com/http-save/yehe-5359587/4c3bf44ecda701bac713c32dc16a03b8.png) 比如你公司有设计规范,有Button、Table、Chart、Modal这些组件。模型生成的界面,全部基于这套组件。样式统一,逻辑能接上,不违和。 ![OpenUI 查询流程](https://developer.qcloudimg.com/http-save/yehe-5359587/9b635e8b2e440202f54699be9940302b.png) **第二个,它不用等全部生成完才能看。** 这一点体验非常好。 模型还在说话的时候,界面就开始渲染了。先出来骨架,再一点点填数据。 用过那种等完整JSON返回再渲染的,应该都懂那种“卡一下”的感觉。OpenUI是流式的,体感上快很多。 **第三个,交互不绕回模型。** 这招我觉得很聪明。 模型只负责生成一次界面。之后用户点按钮、切tab、填表单,**这些交互由运行时直接处理**,不用每点一下都去问大模型。 既省Token,响应又快。 ![OpenUI 格式对比](https://developer.qcloudimg.com/http-save/yehe-5359587/37bdc308809b37dd94ccc60b8268a06d.png) **03 怎么用起来?** 官方给了脚手架,一条命令就能起一个Next.js应用: ``` pnpx @openuidev/cli@latest create --name genui-chat-app cd genui-chat-app echo "OPENAI_API_KEY=sk-your-key-here" > .env pnpm dev ``` 跑起来之后,你就能在聊天里让AI直接生成可操作的界面了。 如果不想用脚手架,也可以只装核心包。React、Vue、Svelte都有对应的runtime,后端用`@openuidev/lang-core`也能跑。 **组件边界设计得好,模型就拆不烂。** 你给它什么组件,它就用什么组件。所以如果你有一套设计规范,开几个典型的组件给它,生成结果基本可控。 **04 它适合谁?** - 你在做内部工具、数据看板、客服后台 - 你在做Copilot类产品,希望AI不只回文字,还能回可操作的卡片 - 你已经有了一套组件库,想让AI在这套组件里组合界面 - 你受够了“AI写代码、你复制粘贴、刷新页面看效果”的循环 **不适合谁?** 如果你只是想要一个聊天机器人,不需要界面交互,这个项目对你来说太重了。 **05 最后聊两句** 我说实话,OpenUI目前还不是一个“装了就能用”的产品。 ![OpenUI 官网预览](https://developer.qcloudimg.com/http-save/yehe-5359587/791baf1005b5688009b15404b201d228.png) 它更像一个**基础层**。你需要设计好组件库,处理好鉴权和错误边界,才能把它接到真实业务里。 但它的方向我觉得是对的。 AI应用不能一直停留在“你问我答”的阶段。 将来用户问“帮我分析一下这个数据”,AI应该直接给一张可操作的图表,而不是一段文字说明。 OpenUI在往这个方向走。 **你们现在做的AI产品,界面是怎么生成的?是自己手动搭的,还是让AI生成的?** 欢迎在评论区聊聊。我们下期再见!

优秀的个人博客,低调大师

🔥🔥 4.3k Star,对标 Coze 和 Dify 的 AIFlowy v2.1.3 发布

AIFlowy v2.0.6 正式发布了! 同时,我们的全新官网上线了! 🎉 如果你也在使用 AIFlowy,欢迎为我们点个 Star 支持一下🌟: 🔗 Gitee 地址:https://gitee.com/aiflowy/aiflowy 你的每一个 Star 都是对我们最大的鼓励,也是让更多人看到 AIFlowy 的关键一步! 我们的愿景始终如一: 🔹 成为中国最具影响力的人工智能品牌之一 🔹 引领核心技术自主创新 🔹 推动中国 AI 生态繁荣发展,助力科技自立 让我们一起见证 AIFlowy 的成长,也欢迎更多伙伴加入我们,共建更强大的 AI 开源生态🚀! AIFlowy v2.1.3 更新详情:https://gitee.com/aiflowy/aiflowy/releases/tag/v2.1.3 ✨ 核心功能 * AI 能力 ✅ 智能 Bot 构建与发布 ✅ 插件系统(支持自定义工具集成) ✅ RAG 知识库(支持文档上传、解析与检索) ✅ AI Workflow 编排(可视化工作流 + 条件 / 分支 / 循环) ✅ 素材中心(AI 自动生成图片、音频、视频等) ✅ 数据中枢(自定义数据表 + 工作流读写能力) ✅ 多模型管理(统一接入主流大模型) ✅ MCP 接入、执行、挂载到聊天助手、并自动调用 🔐 系统管理 ✅ 用户 / 角色 / 部门 / 岗位 / 权限体系 ✅ 菜单与系统配置 ✅ 访问令牌(API Key) ✅ 定时任务 & 操作日志 ✅ 用户反馈 & 外观定制 ✅ 认证方式配置(支持多种登录策略) ✅ 国际化支持(目前已经完整支持中文和英文) 快速开始 git clone https://gitee.com/aiflowy/aiflowy.git cd aiflowy mvn clean package cd aiflowy-ui-admin pnpm install pnpm dev 环境要求 JDK 17+ Node.js 20.0+ MySQL 8.0+ v2.1.3 更新内容 新增: 新增工作流与执行记录对外开放API控制器,完善对外开放API控制器与安全能力 新增: 新增系统环境变量管理功能 新增: 开发可对外发布的Web SDK工具包 新增: 支持用户中心接入与嵌入功能 新增: 支持通过URL参数同步主题、链接参数、智能体选择、会话及智能体信息 新增: 知识库新增AI自动优化标题与描述能力 新增: 知识库数据提供者支持加载子知识库内容 新增: 新增智能体集成与嵌入独立文档页面,配套集成文档上传智能体发布示意图 优化: 重构InputStreamFile实现,支持懒加载并优化文件解析逻辑;统一工作流参数类型为小写 优化: 页面布局与样式细节优化,格式化VitePress配置文件 优化: 升级项目全部依赖,升级@tinyflow-ai/vue至1.3.4版本 优化: 项目仓库迁移至GitHub,更新包发布配置 修复: 去除分类数据库分页重复查询逻辑 修复: 校验公开对话接口消息序列合法性 修复: 完善模型校验与配置检查逻辑 修复: 保证历史聊天记录顺序稳定,空列表安全返回 修复: 限制任务工具仅可访问允许的包路径 修复: 修改智能体消息表内容字段为长文本类型,设置智能体最大回复长度默认值20000 修复: 修复系统潜在安全漏洞 修复: 详情查询接口增加资源归属权限校验 修复: 修改知识库父ID字段为无符号大整数类型 文档: 文档内将「聊天助手」统一重命名为「智能体」 文档: 更新产品文档侧边栏,新增功能配套文档,补充知识库文档并调整侧边栏链接 文档: 替换文档内bots.png图片资源 文档: 更新Docker部署指引,调整快速上手导航栏并补充各类部署文档 文档: 完善WebSDK配套文档、侧边栏入口,优化WebSDK图片样式并更新文档内容 文档: 文档新增站内本地搜索功能,优化页面头部布局 文档: 更新知识库文档链接引用 开发及产品文档 官方网站:https://aiflowy.tech Gitee:https://gitee.com/aiflowy/aiflowy Github:https://github.com/aiflowy/aiflow

优秀的个人博客,低调大师

🔥🔥 3.7k Star,对标 Coze 和 Dify 的 AIFlowy v2.0.6 发布

AIFlowy v2.0.6 正式发布了! 同时,我们的全新官网上线了! 🎉 如果你也在使用 AIFlowy,欢迎为我们点个 Star 支持一下🌟: 🔗 Gitee 地址:https://gitee.com/aiflowy/aiflowy 你的每一个 Star 都是对我们最大的鼓励,也是让更多人看到 AIFlowy 的关键一步! 我们的愿景始终如一: 🔹 成为中国最具影响力的人工智能品牌之一 🔹 引领核心技术自主创新 🔹 推动中国 AI 生态繁荣发展,助力科技自立 让我们一起见证 AIFlowy 的成长,也欢迎更多伙伴加入我们,共建更强大的 AI 开源生态🚀! AIFlowy v2.0.6 更新详情:https://gitee.com/aiflowy/aiflowy/releases/tag/v2.0.6 ✨ 核心功能 🧠 AI 能力 ✅ 智能 Bot 构建与发布 ✅ 插件系统(支持自定义工具集成) ✅ RAG 知识库(支持文档上传、解析与检索) ✅ AI Workflow 编排(可视化工作流 + 条件 / 分支 / 循环) ✅ 素材中心(AI 自动生成图片、音频、视频等) ✅ 数据中枢(自定义数据表 + 工作流读写能力) ✅ 多模型管理(统一接入主流大模型) ✅ MCP 接入、执行、挂载到聊天助手、并自动调用 🔐 系统管理 ✅ 用户 / 角色 / 部门 / 岗位 / 权限体系 ✅ 菜单与系统配置 ✅ 访问令牌(API Key) ✅ 定时任务 & 操作日志 ✅ 用户反馈 & 外观定制 ✅ 认证方式配置(支持多种登录策略) ✅ 国际化支持(目前已经完整支持中文和英文) 快速开始 git clone https://gitee.com/aiflowy/aiflowy.git cd aiflowy mvn clean package cd aiflowy-ui-admin pnpm install pnpm dev 环境要求 JDK 17+ Node.js 20.0+ MySQL 8.0+ v2.0.5 更新内容 新增: 模型校验为向量模型时返回向量维度 新增: 知识库新增分类功能,支持向量模型维度动态配置 新增: 知识库检索支持动态配置最大召回数量和最小相似度 新增: 聊天功能支持自动切换至新建会话 新增: 基础功能模块新增修改密码按钮链接 新增: API模块新增密钥权限校验功能,并同步接口信息 优化: 聊天助手挂载MCP服务启动失败时,新增友好提示并添加重启MCP服务按钮 优化: 知识库支持内部配置功能 优化: CardList组件新增IconifyIcon图标支持 优化: MCP服务启动失败时新增提示,机器人默认仅查询已启动的MCP服务 优化: 优化聊天侧边栏展开动画效果 优化: 更新国际化文案内容 优化: 优化聊天AI消息状态展示样式 优化: 调整聊天气泡最大宽度样式,优化显示效果 优化: 更新加载页面文案内容 开发及产品文档 官方网站:https://aiflowy.tech Gitee:https://gitee.com/aiflowy/aiflowy Github:https://github.com/aiflowy/aiflowy

优秀的个人博客,低调大师

🔥🔥 3.6k Star, 对标 Coze 和 Dify 的 AIFlowy v2.0.5 发布

AIFlowy v2.0.5 正式发布了! 同时,我们的全新官网上线了! 🎉 如果你也在使用 AIFlowy,欢迎为我们点个 Star 支持一下🌟: 🔗 Gitee 地址:https://gitee.com/aiflowy/aiflowy 你的每一个 Star 都是对我们最大的鼓励,也是让更多人看到 AIFlowy 的关键一步! 我们的愿景始终如一: 🔹 成为中国最具影响力的人工智能品牌之一 🔹 引领核心技术自主创新 🔹 推动中国 AI 生态繁荣发展,助力科技自立 让我们一起见证 AIFlowy 的成长,也欢迎更多伙伴加入我们,共建更强大的 AI 开源生态🚀! AIFlowy v2.0.5 更新详情:https://gitee.com/aiflowy/aiflowy/releases/tag/v2.0.5 ✨ 核心功能 🧠 AI 能力 ✅ 智能 Bot 构建与发布 ✅ 插件系统(支持自定义工具集成) ✅ RAG 知识库(支持文档上传、解析与检索) ✅ AI Workflow 编排(可视化工作流 + 条件/分支/循环) ✅ 素材中心(AI 自动生成图片、音频、视频等) ✅ 数据中枢(自定义数据表 + 工作流读写能力) ✅ 多模型管理(统一接入主流大模型) ✅ MCP 接入、执行、挂载到聊天助手、并自动调用 🔐 系统管理 ✅ 用户 / 角色 / 部门 / 岗位 / 权限体系 ✅ 菜单与系统配置 ✅ 访问令牌(API Key) ✅ 定时任务 & 操作日志 ✅ 用户反馈 & 外观定制 ✅ 认证方式配置(支持多种登录策略) ✅ 国际化支持(目前已经完整支持中文和英文) 快速开始 git clone https://gitee.com/aiflowy/aiflowy.git cd aiflowy mvn clean package cd aiflowy-ui-admin pnpm install pnpm dev 环境要求 JDK 17+ Node.js 20.0+ MySQL 8.0+ v2.0.5 更新内容 新增:初始化公共模块并添加 API 密钥拦截器和工作流控制器 优化:调整文字省略显示的样式 优化:添加图标库用于本地使用 优化:更新滑动验证按钮样式和图像 优化:简化 Redis 容器配置 优化:更新 agents-flex 版本至 2.0.0-rc.3 优化:移除冗余的国际化翻译 优化:修改并保存 MCP 方法的返回值 重构:移除未使用的 BotApiKey 重构:移除 common 和 core 模块,更新目录结构文档 重构:更新全局加载页面 修复:修复删除知识库时的 bug 修复:修复知识库文档中删除和修改块向量的失败问题 修复:修复未配置重排模型 ID 时获取重排模型 ID 空指针的问题 修复:修复机器人挂载知识库时的 MCP bug 修复:修复本地文件上传 bug 修复:修复工作流标题最大宽度的 CSS 类问题 修复:修复 crypto.randomUUID 未找到的问题 修复:修复工作流无法选择插件的 bug 修复:修复 Markdown 渲染代码块 bug 修复:修复用户中心未挂载 MCP 及机器人挂载 MCP 但未检查工具的问题 修复:修复 Docker 部署权限、数据库初始化及跨平台上传路径兼容性问题 修复:修复 tb_bot_plugin 表字段 plugin_tool_id 更新后代码仍使用旧字段的问题 修复:验证聊天大模型关闭思考模式 修复:修复模型管理页面供应商类型无法保存的问题 修复:更新 ollama 默认不需要 apikey 的兼容处理 文档:移除未使用的文档 文档:添加前端文档 文档:重写自定义节点文档并更新工作流部分 文档:添加文件存储文档 文档:重写数据字典文档并添加详细代码示例 文档:行为验证码文档 文档:更新代码生成器文档 文档:修复开发文档路由配置 文档:更新并简化部署说明 文档:更新并统一 application.yml 和 yml 文件文档 开发及产品文档 官方网站:https://aiflowy.tech Gitee:https://gitee.com/aiflowy/aiflowy Github:https://github.com/aiflowy/aiflowy

优秀的个人博客,低调大师

🔥🔥 3.6k Star, 对标 Coze 和 Dify 的 AIFlowy v2.0.4 发布

AIFlowy v2.0.4 正式发布了!同时,我们的全新官网上线了! 🎉 如果你也在使用 AIFlowy,欢迎为我们点个 Star 支持一下🌟: 🔗 Gitee 地址:https://gitee.com/aiflowy/aiflowy 你的每一个 Star 都是对我们最大的鼓励,也是让更多人看到 AIFlowy 的关键一步! 我们的愿景始终如一: 🔹 成为中国最具影响力的人工智能品牌之一 🔹 引领核心技术自主创新 🔹 推动中国 AI 生态繁荣发展,助力科技自立 让我们一起见证 AIFlowy 的成长,也欢迎更多伙伴加入我们,共建更强大的 AI 开源生态🚀! AIFlowy v2.0.4 更新详情:https://gitee.com/aiflowy/aiflowy/releases/tag/v2.0.4 ✨ 核心功能 🧠 AI 能力 ✅ 智能 Bot 构建与发布 ✅ 插件系统(支持自定义工具集成) ✅ RAG 知识库(支持文档上传、解析与检索) ✅ AI Workflow 编排(可视化工作流 + 条件/分支/循环) ✅ 素材中心(AI 自动生成图片、音频、视频等) ✅ 数据中枢(自定义数据表 + 工作流读写能力) ✅ 多模型管理(统一接入主流大模型) ✅ MCP 接入、执行和自动调用 🔐 系统管理 ✅ 用户 / 角色 / 部门 / 岗位 / 权限体系 ✅ 菜单与系统配置 ✅ 访问令牌(API Key) ✅ 定时任务 & 操作日志 ✅ 用户反馈 & 外观定制 快速开始 git clone https://gitee.com/aiflowy/aiflowy.git cd aiflowy mvn clean package cd aiflowy-ui-admin pnpm install pnpm dev 环境要求 JDK 1.8+ Node.js 20.0+ MySQL 8.0+ v2.0.4 更新内容 新增: 新增 MCP 功能 新增: 为 bots 模块添加多语言配置 新增: 更新岗位菜单图标并新增 SVG 图标,添加 OAuth 菜单并优化岗位管理菜单 UI 新增: 新增岗位管理功能模块 优化: 更新 tb_sys_menu 表排序值,调整样式(运行页面布局、文本溢出显示等) 优化: 更新 slogan 图片,移除 logo 自定义配置 优化: 清理未使用的脚本和工作空间,删除过期的岗位管理菜单 SQL 初始化脚本 优化: 更新依赖版本(agents-flex 多版本迭代、统一 netty 版本、升级 Java 至 17) 优化: 移除冗余编译配置,迁移至 jakarta 包并更新依赖至 Spring Boot 3 优化: 重构验证码模块(重命名包 / 模块、格式化代码),移除废弃 OAuth 配置及相关菜单映射 优化: 更新 Dockerfile,使用 eclipse-temurin 作为基础镜像,支持 macos arm64,适配 JDK 17 和 V2 版本 修复: 修正模型供应商删除验证逻辑,补充缺失异常处理并增加删除约束校验 修复: 修正 Bot 删除接口路径,修复知识库重排模型 bug 修复: 修复 Bot 相关问题(微信公众号发布异常、用户反馈查询无权限) 修复: 修复复选框显示不清晰、岗位管理国际化显示异常问题 修复: 修复 Bot 删除失败问题,删除大模型之前供应商先删除所有关联模型 修复: 限制仅状态为 0 的定时任务可执行启动操作,更新 netty 依赖版本 修复: 修正登出 API 请求中使用的客户端实例 文档: 更新 README 文档,补充新增功能、路线图、岗位功能及技术栈相关内容 文档: 调整快速入门文档目录结构,更新联系人组引用及快速入门指南 开发及产品文档 官方网站:https://aiflowy.tech Gitee:https://gitee.com/aiflowy/aiflowy Github:https://github.com/aiflowy/aiflowy

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码