首页 文章 精选 留言 我的

精选列表

搜索[Solon框架],共10000篇文章
优秀的个人博客,低调大师

Springboot整合mybatis框架(含实例Demo)

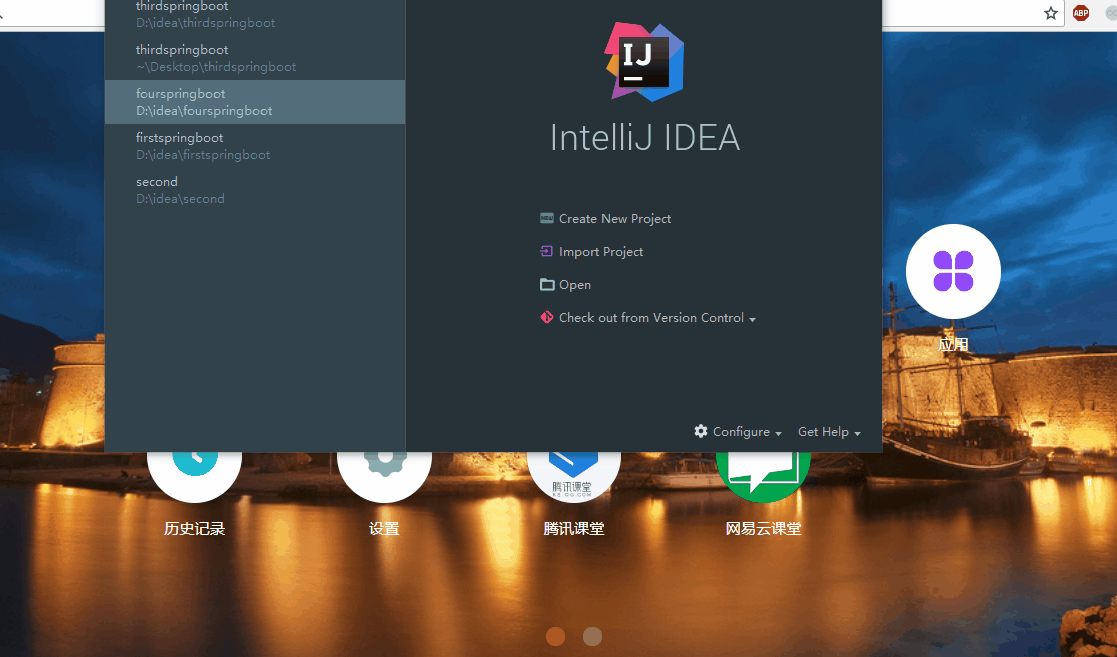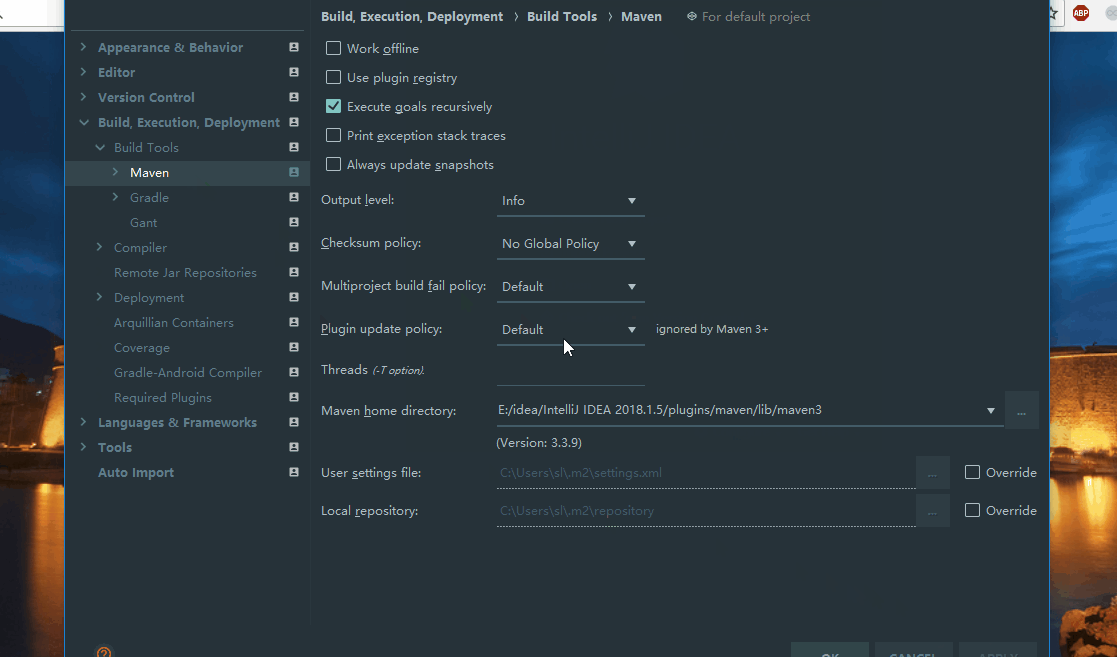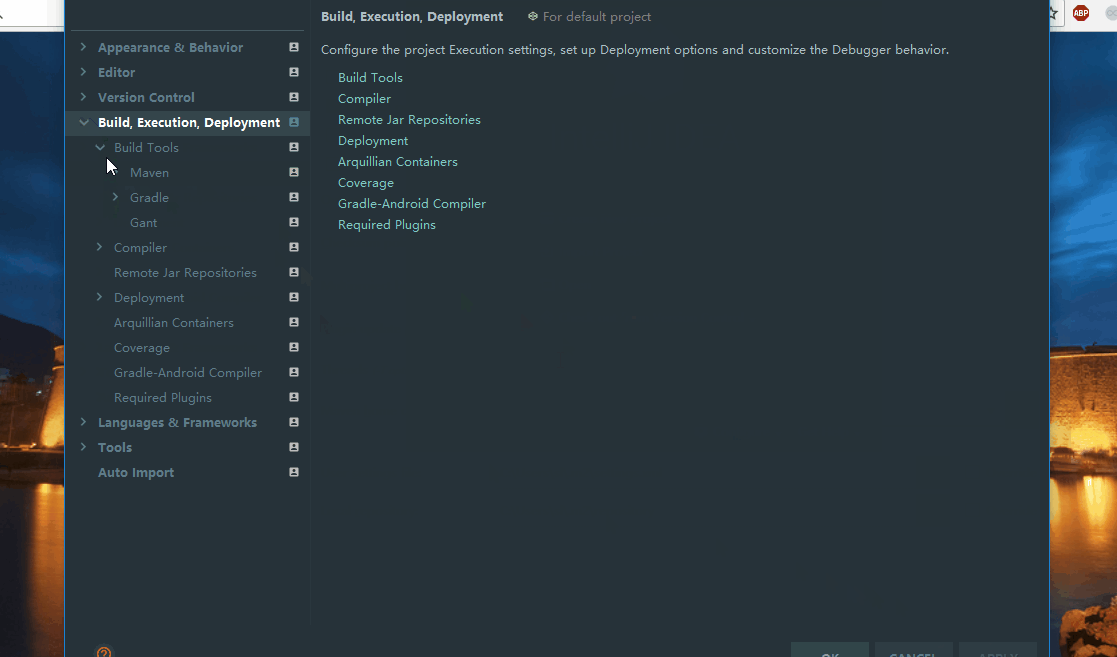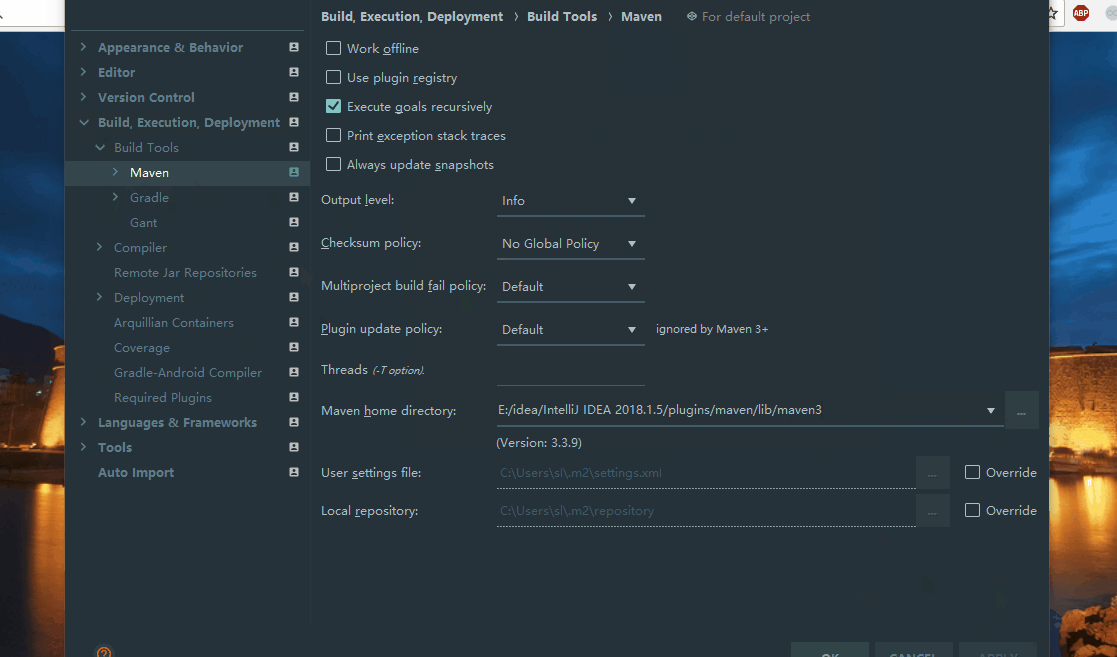
最近要交一份project项目作业,前后端分离,我负责后端,选用了Springboot+mybatis进行整合操作。 一.前期准备: 开发使用的IDE为IntelliJ IDEA:https://www.jetbrains.com/idea/ maven仓库整合jar包:http://mvnrepository.com/artifact/org.apache.maven/maven-plugin-api/3.5.3 下完上述两样后,IDEA安装略,我们开始使用IDEA配置默认的maven库 准备.gif 从GIF中可以看到,我们点击configure菜单项下的Project Defaults来设置项目的默认配置,从settings选项中,找到Maven库一栏,选择我们刚才下载好的maven仓库的安装目录。 创建好我们的数据表。数据库名为jiguo,表名为jiguo_user。 数据表.JPG 以上,前期准备就准备好啦。 二.项目结构一栏以及实现步骤。 概览.JPG 实现步骤: 1.Springboot项目创建 2.在pom.xml中,使用maven架包导入mybatis依赖dependency 3.逆向工程,配置自己的generatorConfig逆向工程的配置文件,然后使用maven插件执行出来,逆向出DAO层还有Model层 4.在application.properties中,配置我们的数据源 mybatis所需要的配置 5.MyMapper接口的创建 6.service层代码的创建 7.创建controller,处理前端的请求。 8.启动文件中设置DAO层扫描,这样就能识别出DAO层注解 @MapperScan(basePackages = "com.example.sl.xxxxx.dao") 步骤一:Springboot项目创建 1.1.JPG 1.2.JPG 1.3.JPG 完成创建一个名为demospringboot的项目 步骤二:在pom.xml中,使用maven架包导入mybatis等依赖 pom.xml: <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.example.sl</groupId> <artifactId>demospringboot</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>demospringboot</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.3.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> </dependency> <!--alibaba-start--> <dependency> <groupId>com.alibaba</groupId> <artifactId>druid</artifactId> <version>1.1.0</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>druid-spring-boot-starter</artifactId> <version>1.1.9</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson</artifactId> <version>1.2.47</version> </dependency> <!--alibaba-end--> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>5.1.41</version> </dependency> <!--mybatis-start--> <!--mybatis--> <dependency> <groupId>org.mybatis.spring.boot</groupId> <artifactId>mybatis-spring-boot-starter</artifactId> <version>1.3.1</version> </dependency> <!--generator--> <dependency> <groupId>org.mybatis.generator</groupId> <artifactId>mybatis-generator-core</artifactId> <version>1.3.2</version> <scope>compile</scope> <optional>true</optional> </dependency> <!--mapper--> <dependency> <groupId>tk.mybatis</groupId> <artifactId>mapper-spring-boot-starter</artifactId> <version>1.2.4</version> </dependency> <!--pagehelper--> <dependency> <groupId>com.github.pagehelper</groupId> <artifactId>pagehelper-spring-boot-starter</artifactId> <version>1.2.3</version> </dependency> <!--mybatis-end--> <!-- 引入 redis 依赖 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-surefire-plugin</artifactId> <version>2.18.1</version> <configuration> <skipTests>true</skipTests> </configuration> </plugin> <plugin> <groupId>org.mybatis.generator</groupId> <artifactId>mybatis-generator-maven-plugin</artifactId> <version>1.3.2</version> <configuration> <verbose>true</verbose> <overwrite>true</overwrite> </configuration> <dependencies> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>5.1.29</version> </dependency> <dependency> <groupId>tk.mybatis</groupId> <artifactId>mapper</artifactId> <version>4.0.0</version> </dependency> </dependencies> </plugin> </plugins> </build> </project> 2.1.JPG import以后,我们导入了mybatis,mysql,阿里巴巴的sql检测插件,分页插件等。 步骤三:逆向工程,配置自己的generatorConfig(resource包下)逆向工程的配置文件,然后使用maven插件执行出来,逆向出DAO层还有Model层 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE generatorConfiguration PUBLIC "-//mybatis.org//DTD MyBatis Generator Configuration 1.0//EN" "http://mybatis.org/dtd/mybatis-generator-config_1_0.dtd"> <generatorConfiguration> <!--1.jdbcConnection设置数据库连接--> <!--2.javaModelGenerator设置类的生成位置--> <!--3.sqlMapGenerator设置生成xml的位置--> <!--4.javaClientGenerator设置生成dao层接口的位置--> <!--5.table设置要进行逆向工程的表名以及要生成的实体类的名称--> <context id="default" targetRuntime="MyBatis3Simple" defaultModelType="flat"> <property name="beginningDelimiter" value="`"/> <property name="endingDelimiter" value="`"/> <plugin type="tk.mybatis.mapper.generator.MapperPlugin"> <property name="mappers" value="com.example.sl.demospringboot.util.MyMapper"/> </plugin> <!-- optional,旨在创建class时,对注释进行控制 --> <commentGenerator> <property name="suppressDate" value="true"/> <property name="suppressAllComments" value="true"/> </commentGenerator> <!--jdbc的数据库连接 --> <jdbcConnection driverClass="com.mysql.jdbc.Driver" connectionURL="jdbc:mysql://localhost:3306/jiguo?characterEncoding=utf-8" userId="root" password="root"> </jdbcConnection> <!-- 非必需,类型处理器,在数据库类型和java类型之间的转换控制--> <javaTypeResolver> <property name="forceBigDecimals" value="false"/> </javaTypeResolver> <!-- Model模型生成器,用来生成含有主键key的类,记录类 以及查询Example类 targetPackage 指定生成的model生成所在的包名 targetProject 指定在该项目下所在的路径 --> <!--<javaModelGenerator targetPackage="com.mmall.pojo" targetProject=".\src\main\java">--> <javaModelGenerator targetPackage="com.example.sl.demospringboot.model" targetProject="./src/main/java"> <!-- 是否允许子包,即targetPackage.schemaName.tableName --> <property name="enableSubPackages" value="false"/> <!-- 是否对model添加 构造函数 --> <property name="constructorBased" value="false"/> <!-- 是否对类CHAR类型的列的数据进行trim操作 --> <property name="trimStrings" value="true"/> <!-- 建立的Model对象是否 不可改变 即生成的Model对象不会有 setter方法,只有构造方法 --> <property name="immutable" value="false"/> </javaModelGenerator> <!--mapper映射文件生成所在的目录 为每一个数据库的表生成对应的SqlMap文件 --> <!--<sqlMapGenerator targetPackage="mappers" targetProject=".\src\main\resources">--> <sqlMapGenerator targetPackage="mappers" targetProject="./src/main/resources"> <property name="enableSubPackages" value="false"/> </sqlMapGenerator> <!-- 客户端代码,生成易于使用的针对Model对象和XML配置文件 的代码 type="ANNOTATEDMAPPER",生成Java Model 和基于注解的Mapper对象 type="MIXEDMAPPER",生成基于注解的Java Model 和相应的Mapper对象 type="XMLMAPPER",生成SQLMap XML文件和独立的Mapper接口 --> <!-- targetPackage:mapper接口dao生成的位置 --> <!--<javaClientGenerator type="XMLMAPPER" targetPackage="com.mmall.dao" targetProject=".\src\main\java">--> <javaClientGenerator type="XMLMAPPER" targetPackage="com.example.sl.demospringboot.dao" targetProject="./src/main/java"> <!-- enableSubPackages:是否让schema作为包的后缀 --> <property name="enableSubPackages" value="false" /> </javaClientGenerator> <table tableName="jiguo_user" domainObjectName="User" enableCountByExample="false" enableUpdateByExample="false" enableDeleteByExample="false" enableSelectByExample="false" selectByExampleQueryId="false"></table> <!-- geelynote mybatis插件的搭建 --> </context> </generatorConfiguration> 然后执行我们的mybatis插件 3.1.JPG 就发现我们的DAO层和model层已经创建好了。对应jiguo数据库中的 jiguo_user表。 四。在application.properties中,配置我们的数据源 mybatis所需要的配置 server.port=8080//服务器的端口号 #mysql链接配置 spring.datasource.url=jdbc:mysql://localhost:3306/jiguo spring.datasource.username=root spring.datasource.password=root spring.datasource.driver-class-name=com.mysql.jdbc.Driver spring.datasource.durid.initialsize=1 #mybatis配置 #首先是实体类所在的包的名字 mybatis.type-aliases-package=com.example.sl.demospringboot.model mybatis.mapper-locations=classpath:mappers/*.xml #mybatis使用resources的xml来映射数据库表,这里就是resources下的mappers包的所有xml文件 #MyMapper是继承了一些封装好的方法接口 CRUD #mapper #mappers 多个接口时逗号隔开 通配mappers mapper.mappers=com.example.sl.demospringboot.util.MyMapper mapper.not-empty=false mapper.identity=MYSQL #pagehelper 分页插件 pagehelper.helperDialect=mysql pagehelper.reasonable=true pagehelper.supportMethodsArguments=true pagehelper.params=count=countSql 配置了服务器端口号,数据库的链接数据,以及mybatis的映射表关系,我们发现有一个MyMapper接口,是我们之前没创建的,这是一个通配mappers(封装了一些常用CRUD操作,可以通过实现接口来进行),在maven库中添加依赖的时候,我们已经添加了相关接口的库tk.mybatis。 所以我们执行步骤五。 五.MyMapper接口的创建 util包下,创建MyMapper接口: MyMapper: package com.example.sl.demospringboot.util; import tk.mybatis.mapper.common.Mapper; import tk.mybatis.mapper.common.MySqlMapper; //自定义接口集成大牛给我们写好的数据层的接口类 public interface MyMapper<T> extends Mapper<T>,MySqlMapper<T> { } 然后在DAO层继承这个接口。 UserMapper: package com.example.sl.demospringboot.dao; import com.example.sl.demospringboot.model.User; import com.example.sl.demospringboot.util.MyMapper; public interface UserMapper extends MyMapper<User> { } 以上我们完成了DAO层和数据库的准备,然后我们开发我们的service层,业务层。 六.service层代码的创建 我们将UserMapper使用注解的方式,生成,减少内存消耗,再调用之前别人写好的接口方法,进行CRUD操作(自己定制的CRUD操作暂略)。 UserService: package com.example.sl.demospringboot.service; import com.example.sl.demospringboot.model.User; import java.util.List; public interface UserService { public List<User> findAll(); } UserServiceImpl: package com.example.sl.demospringboot.service; import com.example.sl.demospringboot.dao.UserMapper; import com.example.sl.demospringboot.model.User; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Service; import java.util.List; @Service("userService") public class UserServiceImpl implements UserService{ @Autowired private UserMapper userMapper; @Override public List<User> findAll() { return userMapper.selectAll(); } } 七.创建controller,处理前端的请求 UserController: package com.example.sl.demospringboot.controller; import com.example.sl.demospringboot.model.User; import com.example.sl.demospringboot.service.UserService; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import java.util.List; @RestController @RequestMapping(value = "/user") public class UserController { @Autowired private UserService userService; @RequestMapping("/findAll") public List<User> findAllUser(){ List<User> userlist=userService.findAll(); return userlist; } } 八..启动文件中设置DAO层扫描,这样就能识别出DAO层注解 @MapperScan(basePackages = "com.example.sl.xxxxx.dao") package com.example.sl.demospringboot; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import tk.mybatis.spring.annotation.MapperScan; @SpringBootApplication @MapperScan(basePackages = "com.example.sl.demospringboot.dao")//这个注解注意一下 放DAO层的包名 对这个包下进行注入 public class DemospringbootApplication { public static void main(String[] args) { SpringApplication.run(DemospringbootApplication.class, args); } } 保存~后台完成 三.自定义一个login.html进行请求测试。(由于JS要跨域,这里不进行ajax请求了 这里我们直接使用表单 PS:本地可以将一个ajax请求的页面放在本地Apache容器中来解决) login.html: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>login.html</title> </head> <body> <form action="/user/findAll"> <input type="submit" value="login"> </form> </body> </html> 然后运行~ 演示.gif 测试完成~终于可以睡觉啦 以上demo收录在Ricardo-L-Song的github 喜欢就给个小吧,你的支持是对博主最大的支持。

优秀的个人博客,低调大师

Java集合框架源码解析之HashMap

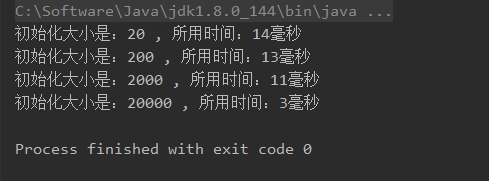
HashMap 是用于映射(键值对)处理的数据类型,基于哈希表的 Map 接口的非同步实现,允许插入最多一条key为null的记录,允许插入多条value为null的记录。此外,HashMap 不保证元素顺序,根据需要该容器可能会对元素重新哈希,元素的顺序也会被重新打散,因此在不同时间段迭代同一个 HashMap 的顺序可能会不同。HashMap 非线程安全,即任一时刻有多个线程同时写 HashMap 的话可能会导致数据的不一致 HashMap 实际上是数组+链表+红黑树的结合体,其底层包含一个数组,数组中的每一项元素的可能值有四种:null、单独一个结点、链表、红黑树(JDK1.8 开始 HashMap 通过使用红黑树来提高元素查找效率)。当往 HashMap 中 put 元素的时候,需要先根据 key 的哈希值得到该元素在数组中的位置(即下标),如果该位置上已经存放有其他元素了,那么在这个位置上的元素将以链表或者红黑树的形式来存放,如果该位置上没有元素,就直接向该位置存放元素 HashMap 要求映射中的 key 是不可变对象,即要求该对象在创建后它的哈希值不会被改变,否则 Map 对象很可能就定位不到映射的位置了 类声明 public class HashMap<K, V> extends AbstractMap<K, V> implements Map<K, V>, Cloneable, Serializable 常量 HashMap 中声明的常量有以下几个,其中需要特别关注的是装载因子 DEFAULT_LOAD_FACTOR 和 TREEIFY_THRESHOLD 装载因子用于规定数组在自动扩容之前可以数据占有其容量的最高比例,即当数据量占有数组的容量达到这个比例后,数组将自动扩容。装载因子衡量的是一个散列表的空间的使用程度,装载因子越大表示散列表的装填程度越高,反之愈小。因此如果装载因子越大,则对空间的利用程度更高,相对应的是查找效率的降低。如果装载因子太小,那么数组的数据将过于稀疏,对空间的利用率低,官方默认的装载因子为0.75,是平衡空间利用率和运行效率两者之后的结果。如果在实际情况中,内存空间较多而对时间效率要求很高,可以选择降低装载因子的值;如果内存空间紧张而对时间效率要求不高,则可以选择提高装载因子的值 此外,即使装载因子和哈希算法设计得再合理,也不免会出现由于哈希冲突导致链表长度过长的情况,这将严重影响 HashMap 的性能。为了优化性能,从 JDK1.8 开始引入了红黑树,当链表长度超出 TREEIFY_THRESHOLD 规定的值时,链表就会被转换为红黑树,利用红黑树快速增删改查的特点以提高 HashMap 的性能 //序列化ID private static final long serialVersionUID = 362498820763181265L; //哈希桶数组的默认容量 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; //网上很多文章都说这个值是哈希桶数组能够达到的最大容量,其实这样说并不准确 //从 resize() 方法的扩容机制可以看出来,HashMap 每次扩容都是将数组的现有容量增大一倍 //如果现有容量已大于或等于 MAXIMUM_CAPACITY ,则不允许再次扩容 //否则即使此次扩容会导致容量超出 MAXIMUM_CAPACITY ,那也是允许的 static final int MAXIMUM_CAPACITY = 1 << 30; //装载因子的默认值 //装载因子用于规定数组在自动扩容之前可以数据占有其容量的最高比例,即当数据量占有数组的容量达到这个比例后,数组将自动扩容 //装载因子衡量的是一个散列表的空间的使用程度,负载因子越大表示散列表的装填程度越高,反之愈小 //对于使用链表的散列表来说,查找一个元素的平均时间是O(1+a),因此如果负载因子越大,则对空间的利用程度更高,相对应的是查找效率的降低 //如果负载因子太小,那么数组的数据将过于稀疏,对空间的利用率低 //官方默认的负载因子为0.75,是平衡空间利用率和运行效率两者之后的结果 static final float DEFAULT_LOAD_FACTOR = 0.75f; //为了提高效率,当链表的长度超出这个值时,就将链表转换为红黑树 static final int TREEIFY_THRESHOLD = 8; 成员变量 //哈希桶数组,在第一次使用时才初始化 //容量值应是2的整数倍 transient Node<K, V>[] table; /** * Holds cached entrySet(). Note that AbstractMap fields are used * for keySet() and values(). */ transient Set<Map.Entry<K, V>> entrySet; //Map的大小 transient int size; //每当Map的结构发生变化时,此参数就会递增 //当在对Map进行迭代操作时,迭代器会检查此参数值 //如果检查到此参数的值发生变化,就说明在迭代的过程中Map的结构发生了变化,因此会直接抛出异常 transient int modCount; //数组的扩容临界点,当数组的数据量达到这个值时就会进行扩容操作 //计算方法:当前容量 x 装载因子 int threshold; //使用的装载因子值 final float loadFactor; 构造函数 //设置Map的初始化大小和装载因子 public HashMap(int initialCapacity, float loadFactor) { //检查参数合法性 if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } //设置Map的初始化大小 public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } //都使用默认值 public HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; } //传入初始数据 public HashMap(Map<? extends K, ? extends V> m) { this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false); } 结点类 //结点 static class Node<K, V> implements Map.Entry<K, V> { //当前结点的 key 的哈希值 final int hash; //键 final K key; //值 V value; //下一个结点 Node<K, V> next; Node(int hash, K key, V value, Node<K, V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } ··· } 哈希算法 在查询、添加和移除键值对时,定位到哈希桶数组的指定位置都是很关键的第一步,只有 HashMap 中的元素尽量分布均匀,才能在定位键值对时快速地查找到相应位置,避免频繁地去遍历链表或者红黑树,这就需要依靠于一个比较好的哈希算法了 以下是 HashMap 中计算 key 值的哈希值以及根据哈希值获取其在哈希桶数组中位置的算法 //计算哈希值 static final int hash(Object key) { int h; //高位参与运算 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } //根据 key 值获取 Value public V get(Object key) { Node<K, V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } //查找指定结点 final Node<K, V> getNode(int hash, Object key) { ··· //只有当 table 不为空且 hash 对应的位置不为 null 才有可获取的元素值 if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { ··· } return null; } 确定键值对在哈希桶数组的位置的步骤分为三步:计算 key 的 hashCode(h = key.hashCode())、高位运算(h >>> 16)、取模运算((n - 1) & hash) 我也不懂这么取值的优点在于哪里,就不多说了 插入数据 在上边说过,HashMap 是数组+链表+红黑树的结合,数组包含的元素的可能值分为四种类型:null、单个结点、链表、红黑树。在插入结点时(每一个待存数据都会被包装为结点对象),会根据待插入 Key 的哈希值来决定结点在数组中的位置,如果计算得出的位置此时包含的元素为 null ,则直接将结点存入该位置,如果不为 null ,则说明发生了哈希碰撞,此时就需要将结点插入到链表或者是红黑树中。当哈希算法的计算结果越分散均匀,哈希碰撞的概率就越小,map 的存取效率就会越高 如果待插入结点的 key 与链表或红黑树中某个已有结点的 key 相等(hash 值相等且两者 equals 成立),则新添加的结点将覆盖原有数据 插入数据对应的是 put(K key, V value) 方法 //插入数据 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } //计算哈希值 static final int hash(Object key) { int h; return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } /** * Implements Map.put and related methods * * @param hash hash for key * @param key the key * @param value the value to put * @param onlyIfAbsent 为 true 表示不会覆盖有相同 key 的非 null value,否则会覆盖原有值 * @param evict if false, the table is in creation mode. * @return previous value, or null if none */ final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K, V>[] tab; Node<K, V> p; int n, i; //如果 table 还未初始化,则调用 resize 方法进行初始化 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; //判断要存入的 key 是否存在哈希冲突,等于 null 说明不存在冲突 if ((p = tab[i = (n - 1) & hash]) == null) //直接在索引 i 处构建包含待存入元素的结点 tab[i] = newNode(hash, key, value, null); else { //走入本分支,说明待存入的 key 存在哈希冲突 Node<K, V> e; K k; //p 值已在上一个 if 语句中赋值了,此处就直接来判断 key 值之间的相等性 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) //指向冲突的头结点 e = p; //如果头结点的 key 与待插入的 key 不相等,且头结点是 TreeNode 类型,说明该 hash 值是采用红黑树来处理冲突 else if (p instanceof TreeNode) //如果红黑数中包含有相同 key 的结点,则返回该结点,否则返回 null e = ((TreeNode<K, V>) p).putTreeVal(this, tab, hash, key, value); else { //采用链表来处理 hash 值冲突 for (int binCount = 0; ; ++binCount) { //当遍历到链表尾部时 if ((e = p.next) == null) { //构建一个新的结点添加到链表尾部 p.next = newNode(hash, key, value, null); //如果链表的长度已达到允许的最大长度 TREEIFY_THRESHOLD - 1 时,就将链表转换为红黑树 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } //当 e 指向的结点的 key 值与待插入的 key 相等时则跳出循环 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } //如果 e != null,说明原先已存在相同 key 的键 if (e != null) { V oldValue = e.value; //只有当 onlyIfAbsent 为 true 且 oldValue 不为 null 时才不会覆盖原有值 if (!onlyIfAbsent || oldValue == null) e.value = value; //用于 LinkedHashMap ,在 HashMap 中是空实现 afterNodeAccess(e); return oldValue; } } ++modCount; //当元素数量达到扩容临界点时,需要进行扩容 if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 读取数据 读取数据对应的是 get(Object key)方法 //根据 key 值获取 Value public V get(Object key) { Node<K, V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } //查找指定结点 final Node<K, V> getNode(int hash, Object key) { Node<K, V>[] tab; Node<K, V> first, e; int n; K k; //只有当 table 不为空且 hash 对应的位置不为 null 才有可获取的元素值 if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { //如果头结点的 hash 值与 Key 与待插入数据相等的话,则说明找到了对应值 if (first.hash == hash && ((k = first.key) == key || (key != null && key.equals(k)))) return first; // != null 说明存在哈希冲突 if ((e = first.next) != null) { //如果是由红黑树来处理哈希冲突,则由此查找相应结点 if (first instanceof TreeNode) return ((TreeNode<K, V>) first).getTreeNode(hash, key); //遍历链表 do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } 移除结点 从 Map 中移除键值对的操作,在底层数据结构的体现就是移除对某个结点对象的引用,可能是从数组中、也可能是链表或者红黑树 public V remove(Object key) { Node<K, V> e; return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value; } /** * Implements Map.remove and related methods * * @param hash key 的哈希值 * @param key the key * @param value key对应的值,只有当 matchValue 为 true 时才需要使用到,否则忽略该值 * @param matchValue 如果为 true ,则只有当 Map 中存在某个键 equals key 且 value 相等时才会移除该元素,否则只要 key 的 hash 值相等就直接移除该元素 * @param movable if false do not move other nodes while removing * @return the node, or null if none */ final Node<K, V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) { Node<K, V>[] tab; Node<K, V> p; int n, index; //只有当 table 不为空且 hash 对应的索引位置存在值时才有可移除的对象 if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { Node<K, V> node = null, e; K k; V v; //如果与头结点的 key 相等 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; else if ((e = p.next) != null) { //存在哈希冲突 //用红黑树来处理哈希冲突 if (p instanceof TreeNode) //查找对应结点 node = ((TreeNode<K, V>) p).getTreeNode(hash, key); else { //用链表来处理哈希冲突 do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; break; } p = e; } while ((e = e.next) != null); } } //node != null 说明存在相应结点 //如果 matchValue 为 false ,则通过之前的判断可知查找到的结点的 key 与 参数 key 的哈希值一定相等,此处就可以直接移除结点 node //如果 matchValue 为 true ,则当 value 相等时才需要移除该结点 if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { if (node instanceof TreeNode) //对应红黑树 ((TreeNode<K, V>) node).removeTreeNode(this, tab, movable); else if (node == p) //对应 key 与头结点相等的情况,此时直接将指针移向下一位即可 tab[index] = node.next; else //对应的是链表的情况 p.next = node.next; ++modCount; --size; //用于 LinkedHashMap ,在 HashMap 中是空实现 afterNodeRemoval(node); return node; } } return null; } 扩容 如果哈希桶数组很大,即使用的是较差的哈希算法元素也会比较分散,如果哈希桶数组很小,即使用的是好的哈希算法也会出现较多哈希碰撞的情况,所以就需要在空间成本和时间成本之间权衡,除了设计较好的哈希算法以减少哈希冲突外,也需要在合适的的时机对哈希桶数组进行必要的扩容 当 HashMap 中的元素越来越多时,因为数组的长度是固定的,所以哈希冲突的几率也就越来越高,为了提高效率,此时就需要对 HashMap 中的数组进行扩容,而扩容操作最消耗性能的地方就在于:原数组中的数据必须重新计算其在新数组中的位置并存放到新数组中 那么 HashMap 扩容操作的触发时机是什么时候呢?当 HashMap 中的元素个数超出 threshold 时(数组容量 与 loadFactor 的乘积),就会进行数组扩容。默认情况下,数组的默认值为 16,loadFactor 的默认值为 0.75,这是平衡空间利用率和运行效率两者之后的结果。也就是说,假设数组当前大小为16,loadFactor 值为0.75,那么当 HashMap 中的元素个数达到12个时,就会自动触发扩容操作,把数组的大小扩充到 2 * 16 = 32,即扩大一倍,然后重新计算每个元素在新数组中的位置,而这是一个非常消耗性能的操作,所以如果已经预知到待存入 HashMap 的数据量,那么在初始化 HashMap 时直接指定初始化大小会是一种更为高效的做法 扩容操作对应的是 resize()方法 //用于初始化 table 或者对之进行扩容 //并返回新的数组 final Node<K, V>[] resize() { //扩容前的数组 Node<K, V>[] oldTab = table; //扩容前数组的容量 int oldCap = (oldTab == null) ? 0 : oldTab.length; //扩容前Map的扩容临界值 int oldThr = threshold; //扩容后数组的容量和扩容临界值 int newCap, newThr = 0; if (oldCap > 0) { //oldCap > 0 对应的是 table 已被初始化的情况,此时是来判断是否需要进行扩容 //如果数组已达到最大容量,则不再进行扩容,并将扩容临界点 threshold 提升到 Integer.MAX_VALUE,结束 if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) { //如果将数组的现有容量提升到现在的两倍依然小于允许的最大容量,而且现有容量大于或等于默认容量 //则将数组的容量和扩容临界值均提升为原先的两倍 newThr = oldThr << 1; } //此处应该还有一种情况 //即将数组的现有容量提升到现在的两倍后大于 MAXIMUM_CAPACITY 的情况 //此时 newThr 等于 0,newCap 等于 oldCap 的两倍值 //此处并没有对 newCap 的数值进行还原,说明 HashMap 是允许扩容后容量超出 MAXIMUM_CAPACITY 的 //只是在现有容量超出 MAXIMUM_CAPACITY 后,不允许再次进行扩容 } else if (oldThr > 0) { //oldCap <= 0 && oldThr > 0 对应的是 table 还未被初始化,且在调用构造函数时有传入初始化大小 initialCapacity 或者包含原始数据的 Map 的情况 //这导致了 threshold 被赋值 (tableSizeFor 方法) //此时就直接将Map的容量提升为 threshold,在后边重新计算新的扩容临界值 newCap = oldThr; } else { //oldCap <= 0 && oldThr <= 0 对应的是 table 还未被初始化,且调用的是无参数的构造函数 //此时就将 table 的容量扩充到默认值大小,并使用默认的装载因子值来计算扩容临界值 newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int) (DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } if (newThr == 0) { float ft = (float) newCap * loadFactor; //计算扩容后新的扩容临界值 newThr = (newCap < MAXIMUM_CAPACITY && ft < (float) MAXIMUM_CAPACITY ? (int) ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes", "unchecked"}) Node<K, V>[] newTab = (Node<K, V>[]) new Node[newCap]; table = newTab; //如果旧数组中存在值,则需要将其中的数据复制到新数组中 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K, V> e; if ((e = oldTab[j]) != null) { //将旧数组中的引用切换,帮助GC回收 oldTab[j] = null; //e.next == null 说明元素 e 没有产生 hash 冲突,因此可以直接转移该元素 if (e.next == null) //计算元素 e 在新数组中的位置 newTab[e.hash & (newCap - 1)] = e; //e instanceof TreeNode 说明元素 e 有产生 hash 冲突,且使用红黑树管理冲突的元素 else if (e instanceof TreeNode) ((TreeNode<K, V>) e).split(this, newTab, j, oldCap); //走入如下分支,说明元素 e 有产生 hash 冲突,且使用链表结构来管理冲突的元素 else { Node<K, V> loHead = null, loTail = null; Node<K, V> hiHead = null, hiTail = null; Node<K, V> next; do { next = e.next; if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } return newTab; } 效率测试 这里来测试下不同的初始化大小以及 key 值的 HashCode 值的分布情况的不同对 HashMap 效率的影响 首先来定义作为 Key 的类,hashCode() 方法直接返回其包含的属性 value public class Key { private int value; public Key(int value) { this.value = value; } @Override public boolean equals(Object o) { if (this == o) return true; if (o == null || getClass() != o.getClass()) return false; Key key = (Key) o; return value == key.value; } @Override public int hashCode() { return value; } } 初始化大小从 100 到 100000 之间以 10 倍的倍数递增,向 HashMap 存入同等数据量的数据,观察不同 HashMap 存入数据消耗的总时间 public class KeyMain { private static final int MAX_KEY = 20000; private static final Key[] KEYS = new Key[MAX_KEY]; static { for (int i = 0; i < MAX_KEY; i++) { KEYS[i] = new Key(i); } } private static void test(int size) { long startTime = System.currentTimeMillis(); Map<Key, Integer> map = new HashMap<>(size); for (int i = 0; i < MAX_KEY; i++) { map.put(KEYS[i], i); } long endTime = System.currentTimeMillis(); System.out.println("初始化大小是:" + size + " , 所用时间:" + (endTime - startTime) + "毫秒"); } public static void main(String[] args) { for (int i = 20; i <= MAX_KEY; i *= 10) { test(i); } } } 在上述使用的例子中,各个 Key 对象之间的哈希码值各不相同,所以键值对在哈希桶数组中的分布可以说是很均匀的了,此时主要影响性能的就是扩容机制了,由上图可以看出各个初始化大小对 HashMap 的性能影响还是很大的 接下来再看看各个 Key 对象之间频繁发生哈希冲突时 HashMap 的性能 令 Key 类的 hashCode() 方法固定返回 100,则每个键值对在存入 HashMap 时,一定会发生哈希冲突 @Override public int hashCode() { return 100; } 可以看到此时存入同等数据量的数据所用时间呈几何数增长了,此时主要影响性能的点就在于对哈希冲突的处理了 更详细的源码解析可以看这里:Java_Android_Learn
优秀的个人博客,低调大师

Java集合框架源码解析之ArrayList

ArrayList 可能是很多人使用得最为频繁的容器类了,ArrayList 实现了 List 接口,是一个有序容器,即存放元素的顺序与添加顺序相同,允许添加相同元素,包括 null ,底层通过数组来实现数据存储,容器内存储的元素个数不能超出数组空间。所以向容器中添加元素时如果发现数组空间不足,容器会自动对底层数组进行扩容操作 ArrayList 的类声明 public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable 从其实现的几个接口可以看出来,ArrayList 是支持快速访问,可克隆,可序列化的 包含的成员变量 //序列化ID private static final long serialVersionUID = 8683452581122892189L; //集合默认的初始大小 private static final int DEFAULT_CAPACITY = 10; //如果外部为集合设置的初始化大小为 0,则 elementData 指向空数组对象 EMPTY_ELEMENTDATA private static final Object[] EMPTY_ELEMENTDATA = {}; //如果在初始化集合时使用的是无参数的构造函数,则 elementData 指向空数组对象 DEFAULTCAPACITY_EMPTY_ELEMENTDATA private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; //包含实际元素的数组 transient Object[] elementData; //集合大小 private int size; elementData 是一个 Object 类型的数组对象,即可用来存放任何对象类型,也是 ArrarList 中用来存放数据的容器。而 ArrayList 是一个泛型类,我们在初始化时就直接指定了数据类型,Java泛型只是编译器为我们提供的语法糖,方便我们在向 elementData 存取数据时,将之自动转换为特定的类型 包含的构造函数 //指定集合的初始容量,以此来进行数组的初始化操作 public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+initialCapacity); } } //使用默认的初始化大小 public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } //传入一份初始数据,以此进行初始化 public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); if ((size = elementData.length) != 0) { // c.toArray might (incorrectly) not return Object[] (see 6260652) if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } else { this.elementData = EMPTY_ELEMENTDATA; } } 可以在初始化 ArrayList 的时候传入集合的初始化大小,这通常来说都是更为高效率一些的,因为如果是让集合在赋值的过程中自动扩容,则可能会需要进行多次扩容操作,而每次扩容都需要复制原有数据到新数组,这会导致运行效率降低 添加/修改 元素 在获取指定索引处的元素时,都是直接通过坐标指向该元素 (E) elementData[index],而无需从头开始遍历集合,所以说 ArrayList 的遍历效率较高 //通过索引直接访问数组 @SuppressWarnings("unchecked") E elementData(int index) { return (E) elementData[index]; } //获取索引 index 处的元素值 public E get(int index) { rangeCheck(index); return elementData(index); } //将索引 index 出的元素值置为 element,并返回原始数值 public E set(int index, E element) { rangeCheck(index); E oldValue = elementData(index); elementData[index] = element; return oldValue; } ArrayList 在存入数据时相对来说就不是那么理想了 如果是直接向集合尾端添加数据 add(E e),则先检查是否需要扩容,需要的话则创建一个新的符合大小的数组,并将原数组中的元素移到新数组中,再向数组尾端添加待存入的元素 如果是向集合非尾端位置添加数据 add(int index, E element),一样需要先检查是否需要扩容,然后将数组中索引 index 后的所有元素向后推移一位,然后将 element 插入到空出的位置上 由此看出来,向集合添加元素由于可能会导致数组扩容,从而导致数组元素的大量移动,所以说 ArrayList 存入数据的效率并不高 //向集合添加数据 public boolean add(E e) { //检查是否需要扩容 ensureCapacityInternal(size + 1); //赋值 elementData[size++] = e; return true; } //将元素 element 添加索引 index 位置 public void add(int index, E element) { rangeCheckForAdd(index); //检查是否需要扩容 ensureCapacityInternal(size + 1); //将索引 index 后的所有数值向后推移一位 System.arraycopy(elementData, index, elementData, index + 1,size - index); //将 element 插入到空出的位置 elementData[index] = element; //集合大小加1 size++; } 以上说的是存入单个元素,此外还有存入整个集合的情况 //向集合添加数据 //如果待添加的数据不为空则返回 true,否则返回 false public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); int numNew = a.length; //检查是否需要扩容 ensureCapacityInternal(size + numNew); //将数组 a 复制到 elementData 的尾端 System.arraycopy(a, 0, elementData, size, numNew); size += numNew; return numNew != 0; } //从指定索引处添加数据 //如果待添加的数据不为空则返回 true,否则返回 false public boolean addAll(int index, Collection<? extends E> c) { rangeCheckForAdd(index); Object[] a = c.toArray(); int numNew = a.length; //检查是否需要扩容 ensureCapacityInternal(size + numNew); //需要移动的数组元素数量 int numMoved = size - index; //因为要添加的数据可能刚好是从数组最尾端开始添加,所以 numMoved 可能为 0 //所以只在 numMoved > 0 的时候才需要对数组的元素值进行移动,以此空出位置给数组 a if (numMoved > 0) System.arraycopy(elementData, index, elementData, index + numNew, numMoved); //将数组 a 包含的数据添加到 elementData 中 System.arraycopy(a, 0, elementData, index, numNew); size += numNew; return numNew != 0; } 移除元素 再看下移除元素的方法 因为数组是一种内存地址连续的数据结构,所以移除某个元素同样可能导致大量元素的移动 //移除指定索引处的元素值,并返回该值 public E remove(int index) { rangeCheck(index); modCount++; //待移除的元素值 E oldValue = elementData(index); //因为要移除元素导致需要移动的元素数量 int numMoved = size - index - 1; //因为要移除的元素可能刚好是数组最后一位,所以 numMoved 可能为 0 //所以只在 numMoved > 0 的时候才需要对数组的元素值进行移动 if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); //不管数组是否需要对元素值进行移动,数组的最后一位都是无效数据了 //此处将之置为 null 以帮助GC回收 elementData[--size] = null; return oldValue; } //移除集合中包含的第一位元素值为 o 的对象 //如果包含该对象,则返回 true ,否则返回 false public boolean remove(Object o) { if (o == null) { for (int index = 0; index < size; index++) if (elementData[index] == null) { fastRemove(index); return true; } } else { for (int index = 0; index < size; index++) if (o.equals(elementData[index])) { fastRemove(index); return true; } } return false; } 扩容机制 以上多处说到了数组的扩容,这里就来看下数组的扩容机制 实际进行扩容操作的是 grow(int grow(int minCapacity)) 方法,参数 minCapacity 用于指定要求的最小空间,在扩容前,会先判断如果将当前容量提升到当前的 1.5 倍是否能达到 minCapacity 的要求 ,如果符合要求则直接将数据扩充到当前的 1.5 倍容量,否则则扩充到 minCapacity ,构建一个新的符合大小的数组后,就将原数组中的元素复制到新数组中 由此可想到,如果在初始化 ArrayList 前已知目标数据的数据量,则最好使用 ArrayList(int initialCapacity)来进行初始化,直接让底层数组扩充到目标大小,避免之后赋值过程中多次扩容 //触发集合进行扩容操作,参数 minCapacity 表示集合扩容后的最小空间 //如果在向集合进行赋值操作前已知数据量大小,则直接调用此方法让集合直接扩容到该大小有助于提高集合的运行效率 //如果是让集合在赋值的过程中自动扩容,则可能会需要进行多次扩容操作,而每次扩容都需要复制原有数据到新数组,这会导致运行效率降低 public void ensureCapacity(int minCapacity) { //1. 如果当前数组还未进行任何赋值操作,即 elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA,则数组空间只由参数 minCapacity 影响 //2. 如果当前数组已进行过赋值操作,即 elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA,则当前数组大小可能还是在使用默认容量 DEFAULT_CAPACITY // 则此时只有当 minCapacity 大于 DEFAULT_CAPACITY 时,才需要进行扩容 int minExpand = (elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) // any size if not default element table ? 0 // larger than default for default empty table. It's already // supposed to be at default size. : DEFAULT_CAPACITY; if (minCapacity > minExpand) { ensureExplicitCapacity(minCapacity); } } //检查当前的数组容量,minCapacity 用于指定当前需要的最小空间 //如果数组容量没有达到一定标准,则需要进行扩容 private void ensureCapacityInternal(int minCapacity) { if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { //数组空间至少需要扩容到 DEFAULT_CAPACITY minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } ensureExplicitCapacity(minCapacity); } private void ensureExplicitCapacity(int minCapacity) { modCount++; //如果当前数组大小的确是比需要的最小空间 minCapacity 小,则进行扩容 if (minCapacity - elementData.length > 0) grow(minCapacity); } //数组可扩充到的最大空间 private static final int MAX_ARRAY_SIZE = Integer.MAX_VALUE - 8; //对数组进行扩容 private void grow(int minCapacity) { //扩容前的数组大小 int oldCapacity = elementData.length; //oldCapacity >> 1 的含义即为:将 oldCapacity 值除以 2 //即先假设扩容后的空间大小是原先的1.5倍 int newCapacity = oldCapacity + (oldCapacity >> 1); //如果 newCapacity 依然是达不到最小空间要求,则直接将空间扩大到由 minCapacity 指定的大小 if (newCapacity - minCapacity < 0) newCapacity = minCapacity; //如果扩容后的数组空间超出了最大容量限制,则将容量定为 Integer.MAX_VALUE if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); //构建符合容量大小的数组并复制原数组的数据 elementData = Arrays.copyOf(elementData, newCapacity); } 遍历集合的方法 //遍历集合元素 @Override public void forEach(Consumer<? super E> action) { Objects.requireNonNull(action); final int expectedModCount = modCount; @SuppressWarnings("unchecked") final E[] elementData = (E[]) this.elementData; final int size = this.size; //如果 modCount 值被改动,则直接停止遍历并抛出异常 for (int i=0; modCount == expectedModCount && i < size; i++) { //将集合元素依次传递给 accept 方法 action.accept(elementData[i]); } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } } 遍历并过滤集合的方法 //按照给定规则对集合元素进行过滤,如果元素符合过滤规则 filter 则将之移除 @Override public boolean removeIf(Predicate<? super E> filter) { Objects.requireNonNull(filter); //要移除的元素个数 int removeCount = 0; //用于标记集合是哪个索引位置需要被移除 final BitSet removeSet = new BitSet(size); final int expectedModCount = modCount; final int size = this.size; for (int i=0; modCount == expectedModCount && i < size; i++) { @SuppressWarnings("unchecked") final E element = (E) elementData[i]; //依次判断集合元素是否符合过滤规则 if (filter.test(element)) { //set 方法将导致索引位置 i 的元素变为 true removeSet.set(i); removeCount++; } } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } //只有 removeCount > 0 才说明需要移除元素 final boolean anyToRemove = removeCount > 0; if (anyToRemove) { //集合移除指定元素后的大小 final int newSize = size - removeCount; for (int i=0, j=0; (i < size) && (j < newSize); i++, j++) { //略过被标记为 true 的位置,直接跳到不需要移除元素的数组索引位 i = removeSet.nextClearBit(i); //有效数据逐渐从尾部向头部聚集 elementData[j] = elementData[i]; } //移除尾部的无效数据,帮助GC回收 for (int k=newSize; k < size; k++) { elementData[k] = null; } this.size = newSize; if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } modCount++; } return anyToRemove; } //将集合元素遍历传递给 operator,并将原始数据替换为 operator 的返回值 @Override @SuppressWarnings("unchecked") public void replaceAll(UnaryOperator<E> operator) { Objects.requireNonNull(operator); final int expectedModCount = modCount; final int size = this.size; for (int i=0; modCount == expectedModCount && i < size; i++) { //依次传递数组元素给 apply 方法,并将其返回值替换原始数据 elementData[i] = operator.apply((E) elementData[i]); } //不允许在排序的过程中集合被其它方法修改了数据结构(例如:移除元素) if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } modCount++; } 迭代器 在这里有个小细节,ArrayList 里多处使用到了 modCount 这个参数,每当集合的结构发生变化时,modCount 就会递增,当在对集合进行迭代操作时,迭代器会检查此参数值,如果检查到此参数的值发生变化,就说明在迭代的过程中集合的结构发生了变化,此时迭代的元素可能就并不是最新的了,因此会直接抛出异常 //返回集合迭代器 public Iterator<E> iterator() { return new Itr(); } //一个优化版本的迭代器 private class Itr implements Iterator<E> { //lastRet 指向的元素的下一个元素的索引 int cursor; //最后一个返回的元素的索引 //如果值为 -1,说明还未返回过元素或者改元素被移除了 int lastRet = -1; //用于验证集合的数据结构在迭代的过程中是否被修改了 int expectedModCount = modCount; //是否还有元素未被遍历 public boolean hasNext() { return cursor != size; } //获取下一个元素 @SuppressWarnings("unchecked") public E next() { checkForComodification(); int i = cursor; //如果索引值超出集合的可索引范围则抛出异常 if (i >= size) throw new NoSuchElementException(); Object[] elementData = ArrayList.this.elementData; //如果索引值超出数组的可索引范围则抛出异常 if (i >= elementData.length) throw new ConcurrentModificationException(); //游标递增 cursor = i + 1; return (E) elementData[lastRet = i]; } //移除 lastRet 位置的元素 public void remove() { if (lastRet < 0) throw new IllegalStateException(); checkForComodification(); try { ArrayList.this.remove(lastRet); //因为 lastRet 位置原始的元素被移除了,所以此时 lastRet 指向的元素是原先 lastRet+1 位置的元素 cursor = lastRet; lastRet = -1; //因为是 Itr 主动对集合进行修改,所以此处需要主动更新 expectedModCount 值,避免之后抛出异常 expectedModCount = modCount; } catch (IndexOutOfBoundsException ex) { throw new ConcurrentModificationException(); } } //遍历集合从索引 cursor 开始之后剩下的元素 @Override @SuppressWarnings("unchecked") public void forEachRemaining(Consumer<? super E> consumer) { Objects.requireNonNull(consumer); final int size = ArrayList.this.size; int i = cursor; if (i >= size) { return; } final Object[] elementData = ArrayList.this.elementData; if (i >= elementData.length) { throw new ConcurrentModificationException(); } //遍历调用 accept 方法 while (i != size && modCount == expectedModCount) { consumer.accept((E) elementData[i++]); } cursor = i; lastRet = i - 1; checkForComodification(); } //判断迭代器在遍历集合的过程中,集合是否被外部改动了(例如被其它迭代器移除了元素) //如果是的话则抛出异常 final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); } } 效率测试 最后来测试下 ArrayList 扩容次数的高低对其运行效率的影响 对三个 ArrayList 存入相同数据量的数据,但分别为 ArrayList 指定不同的初始化大小 public static void main(String[] args) { //开始时间 long startTime = System.currentTimeMillis(); List<String> stringList = new ArrayList<>(); for (int i = 0; i < 300000; i++) { stringList.add("leavesC " + i); } //结束时间 long endTime = System.currentTimeMillis(); System.out.println("不指定初始大小,所用时间:" + (endTime - startTime) + "毫秒"); //开始时间 startTime = System.currentTimeMillis(); List<String> stringList2 = new ArrayList<>(100000); for (int i = 0; i < 300000; i++) { stringList2.add("leavesC " + i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("指定初始大小为目标数据量的三分之一,所用时间:" + (endTime - startTime)+ "毫秒"); //开始时间 startTime = System.currentTimeMillis(); List<String> stringList3 = new ArrayList<>(300000); for (int i = 0; i < 300000; i++) { stringList3.add("leavesC " + i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("指定初始大小为目标数据量,所用时间:" + (endTime - startTime)+ "毫秒"); } 可以看出来,各种方式之间的运行效率差距还是很大的 关于 ArrayList 的内容就讲到这里了,一方面是篇幅所限,一方面我是觉得很多知识点其实也不需要怎么讲,直接看源码的话认知会更为深刻一点,因此我也把对 ArrayList 的详细源码注释开源到了 GitHub 上,欢迎关注 源码地址:Java_Android_Learn

优秀的个人博客,低调大师

Java集合框架源码解析之LinkedList

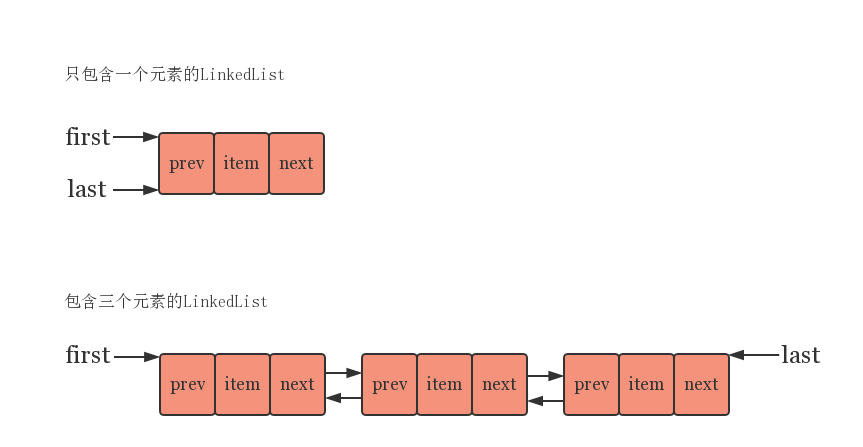
LinkedList 同时实现了 List 接口和 Deque 接口,所以既可以将 LinkedList 当做一个有序容器,也可以将之看作一个队列(Queue),同时又可以看作一个栈(Stack)。虽然 LinkedList 和 ArrayList 一样都实现了 List 接口,但其底层是通过双向链表来实现的,所以 LinkedList 插入和删除元素的效率都要比 ArrayList 高,因此随机访问的效率也要比 ArrayList 低 LinkedList 的类声明 public class LinkedList<E> extends AbstractSequentialList<E> implements List<E>, Deque<E>, Cloneable, java.io.Serializable 从其实现的几个接口可以看出来,LinkedList 是支持快速访问,可克隆,可序列化的,而且可以将之看成一个支持有序访问的 队列/栈 上面说过,LinkedList 内部是通过双向链表的数据结构来实现的,对于链表中的结点来说,除了首尾两个结点外,其余每个结点除了存储本结点的数据元素外,还分别有两个指针用于指向其上下两个相邻结点,这个结点类就是 LinkedList 中的静态类 Node //结点类 private static class Node<E> { //当前结点包含的实际元素 E item; //指向下一个结点 Node<E> next; //指向上一个结点 Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } 包含的成员变量 //双向链表包含的结点总数 transient int size = 0; //双向链表的头结点 transient Node<E> first; //双向链表的尾结点 transient Node<E> last; //序列化ID private static final long serialVersionUID = 876323262645176354L; 当中的成员变量 first 和 last 分别用于指向链表的头部和尾部结点,因此 LinkedList 的数据结构图是类似于这样的 构造函数 不同于 ArrayList,因为 LinkedList 使用的是链表结构,所以 LinkedList 不需要去请求一片连续的内存空间来存储数据,而是在每次有新的元素需要添加进来时,再来动态请求内存空间。因此 LinkedList 的两个构造函数要简单得多 public LinkedList() { } //传入初始数据 public LinkedList(Collection<? extends E> c) { this(); addAll(c); } 添加元素 add(E e) 方法用于向链表的尾部添加结点,因为有 last 指向链表的尾结点,因此向尾部添加新元素只需要修改几个引用即可,效率较高 //将元素 e 作为尾结点添加 //因为 LinkedList 允许添加相同元素,所以此方法固定返回 true public boolean add(E e) { linkLast(e); return true; } //将元素 e 置为尾结点 void linkLast(E e) { //先保存原尾结点 final Node<E> l = last; //构建新的尾结点,并指向原尾结点 final Node<E> newNode = new Node<>(l, e, null); last = newNode; //如果原尾结点为 null,说明原链表包含的元素个数为 0,则此时插入的尾结点同时即为头结点 //如果原尾结点不为 null,则将 next 指向新的尾结点 if (l == null) first = newNode; else l.next = newNode; //元素个数加1 size++; modCount++; } add(int index, E element) 方法用于向指定索引处添加元素,需要先通过索引 index 获取相应位置的结点,并在该位置开辟一个新的结点来存储元素 element,最后还需要修改相邻结点间的引用 //在索引 index 处插入元素 element public void add(int index, E element) { //判断索引大小是否合法,不合法则抛出 IndexOutOfBoundsException checkPositionIndex(index); //如果 index == size,则将 element 作为尾结点来添加 //否则则在索引 index 前开辟一个新结点 if (index == size) linkLast(element); else linkBefore(element, node(index)); } //将元素 e 置为 succ 结点的上一个结点 void linkBefore(E e, Node<E> succ) { //保存 succ 的上一个结点信息 final Node<E> pred = succ.prev; //构建元素 e 对应的结点 final Node<E> newNode = new Node<>(pred, e, succ); //将结点 succ 的上一个结点指向 newNode succ.prev = newNode; //如果 pred 为 null,说明 succ 是头结点,则将 newNode 置为新的头结点 if (pred == null) first = newNode; else pred.next = newNode; //元素个数加1 size++; modCount++; } 移除元素 remove() 方法有两种重载形式,其内部都是通过调用 unlink(Node<E> x) 方法来移除指定结点在链表中的引用,不同于 ArrayList 在移除元素时可能导致的大量数据移动,LinkedList 只需要通过移除引用即可将指定元素从链表中移除 //移除索引 index 处的结点 public E remove(int index) { //判断索引大小是否合法,不合法则抛出 IndexOutOfBoundsException checkElementIndex(index); return unlink(node(index)); } //对链表进行正向遍历,移除第一个元素值为 o 的结点 //如果移除成功则返回 true,否则返回 false public boolean remove(Object o) { if (o == null) { for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) { //移除结点 x unlink(x); return true; } } } else { for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) { //移除结点 x unlink(x); return true; } } } return false; } //移除结点 x 并返回其包含的元素值 E unlink(Node<E> x) { final E element = x.item; final Node<E> next = x.next; final Node<E> prev = x.prev; //如果 prev == null,说明结点 x 为头结点,则将头结点置为原先的第二个结点 //如果 prev != null,则移除对结点 x 的引用 if (prev == null) { first = next; } else { prev.next = next; x.prev = null; } //如果 next == null,则说明结点 x 为尾结点,则将尾结点置为原先的倒数第二个结点 //如果 next != null,则移除对结点 x 的引用 if (next == null) { last = prev; } else { next.prev = prev; x.next = null; } //帮助GC回收 x.item = null; //元素个数减1 size--; modCount++; return element; } 获取/修改 元素 在获取或修改指定索引的元素前,都需要先通过正向遍历或者反向遍历获取到该结点,如果集合包含的数据量很大,那么要相应的代价也会很大,因此说 LinkedList 的查找效率并不高 //获取索引 index 处的结点元素 public E get(int index) { //判断索引大小是否合法,不合法则抛出 IndexOutOfBoundsException checkElementIndex(index); return node(index).item; } //将索引 index 处的结点包含的元素修改为 element,并返回旧元素 public E set(int index, E element) { //判断索引大小是否合法,不合法则抛出 IndexOutOfBoundsException checkElementIndex(index); Node<E> x = node(index); E oldVal = x.item; x.item = element; return oldVal; } //获取索引 index 处的结点 Node<E> node(int index) { //size >> 1 的含义即为:将 size 值除以 2 //如果 index 靠近链表的头部,则从头部向尾部正向遍历查找结点 //如果 index 靠近链表的尾部,则从尾部向头部反向遍历查找结点 if (index < (size >> 1)) { Node<E> x = first; for (int i = 0; i < index; i++) x = x.next; return x; } else { Node<E> x = last; for (int i = size - 1; i > index; i--) x = x.prev; return x; } } 几个常用的方法 //判断是否包含元素 o public boolean contains(Object o) { return indexOf(o) != -1; } //获取元素个数 public int size() { return size; } //清空链表元素 //这里将各个结点之间的引用都切断了,这并不是必须的,但这样有助于GC回收 public void clear() { for (Node<E> x = first; x != null; ) { Node<E> next = x.next; x.item = null; x.next = null; x.prev = null; x = next; } first = last = null; size = 0; modCount++; } //返回第一个元素值为 o 的结点所在的索引值 //如果查找不到,则返回 -1 public int indexOf(Object o) { int index = 0; if (o == null) { for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) return index; index++; } } else { for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) return index; index++; } } return -1; } //返回最后一个元素值为 o 的结点所在的索引值 //如果查找不到,则返回 -1 public int lastIndexOf(Object o) { int index = size; if (o == null) { for (Node<E> x = last; x != null; x = x.prev) { index--; if (x.item == null) return index; } } else { for (Node<E> x = last; x != null; x = x.prev) { index--; if (o.equals(x.item)) return index; } } return -1; } Deque接口 以上介绍的几个方法都是 List 接口中所声明的,接下来看下 Deque 接口中的方法 其实 Deque 接口中很多方法的含义都是类似的,且一些方法都是相互调用的,并不算复杂 //将元素 e 置为头结点 public void addFirst(E e) { linkFirst(e); } //将元素 e 置为尾结点 public void addLast(E e) { linkLast(e); } //将元素 e 作为尾结点添加 public boolean offer(E e) { return add(e); } //将元素 e 作为头结点添加 public boolean offerFirst(E e) { addFirst(e); return true; } //将元素 e 作为尾结点添加 public boolean offerLast(E e) { addLast(e); return true; } //获取头部结点的元素值 public E peekFirst() { final Node<E> f = first; return (f == null) ? null : f.item; } //获取尾部结点的元素值 public E peekLast() { final Node<E> l = last; return (l == null) ? null : l.item; } //获取头部结点的元素值,并将之从链表中移除 public E pollFirst() { final Node<E> f = first; return (f == null) ? null : unlinkFirst(f); } //获取尾部结点的元素值,并将之从链表中移除 public E pollLast() { final Node<E> l = last; return (l == null) ? null : unlinkLast(l); } //将元素 e 作为头结点添加 public void push(E e) { addFirst(e); } //获取头部结点的元素值,并将之从链表中移除 public E pop() { return removeFirst(); } //从链表头部向尾部正向遍历,移除第一个元素值为 o 的结点 //如果移除成功则返回 true,否则返回 false public boolean removeFirstOccurrence(Object o) { return remove(o); } //从链表尾部向头部反向遍历,移除第一个元素值为 o 的结点 //如果移除成功则返回 true,否则返回 false public boolean removeLastOccurrence(Object o) { if (o == null) { for (Node<E> x = last; x != null; x = x.prev) { if (x.item == null) { unlink(x); return true; } } } else { for (Node<E> x = last; x != null; x = x.prev) { if (o.equals(x.item)) { unlink(x); return true; } } } return false; } 效率比较 上面说过,LinkedList 相比 ArrayList 添加和移除元素的效率会高些,但随机访问元素的效率要比 ArrayList 低,这里我也来做个测试,看下两者之间的差距 分别向 ArrayList 和 LinkedList 存入同等数据量的数据,然后各自移除 100 个元素以及遍历 10000 个元素,观察两者所用的时间 public static void main(String[] args) { List<String> stringArrayList = new ArrayList<>(); for (int i = 0; i < 300000; i++) { stringArrayList.add("leavesC " + i); } //开始时间 long startTime = System.currentTimeMillis(); for (int i = 0; i < 100; i++) { stringArrayList.remove(100 + i); } //结束时间 long endTime = System.currentTimeMillis(); System.out.println("移除 ArrayList 中的100个元素,所用时间:" + (endTime - startTime) + "毫秒"); //开始时间 startTime = System.currentTimeMillis(); for (int i = 0; i < 10000; i++) { stringArrayList.get(i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("遍历 ArrayList 中的10000个元素,所用时间:" + (endTime - startTime) + "毫秒"); List<String> stringLinkedList = new LinkedList<>(); for (int i = 0; i < 300000; i++) { stringLinkedList.add("leavesC " + i); } //开始时间 startTime = System.currentTimeMillis(); for (int i = 0; i < 100; i++) { stringLinkedList.remove(100 + i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("移除 LinkedList 中的100个元素,所用时间:" + (endTime - startTime) + "毫秒"); //开始时间 startTime = System.currentTimeMillis(); for (int i = 0; i < 10000; i++) { stringLinkedList.get(i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("遍历 LinkedList 中的10000个元素,所用时间:" + (endTime - startTime) + "毫秒"); } 可以看出来,两者之间的差距还是非常大的,因此,在使用集合时需要根据实际情况来判断到底哪一种数据结构才更加适合 更详细的源码解析可以看这里:Java_Android_Learn
优秀的个人博客,低调大师

Java集合框架源码解析之HashSet

HashSet 实现了 Set 接口,不允许插入重复的元素,允许包含 null 元素,且不保证元素迭代顺序,特别是不保证该顺序恒久不变 HashSet 的代码十分简单,去掉注释后的代码不到两百行。HashSet 底层是通过 HashMap 来实现的,如果看过我上一篇关于 HashMap 源码的解析,再来看 HashSet 就会有一种“不过如此”的感觉了 在向 HashSet 添加元素时,HashSet 会将该操作转换为向 HashMap 添加键值对,如果 HashMap 中包含 key 值与待插入元素相等的键值对(hashCode() 方法返回值相等,通过 equals() 方法比较也返回 true),则待添加的键值对的 value 会覆盖原有数据,但 key 不会有所改变,因此如果向 HashSet 添加一个已存在的元素时,元素不会被存入 HashMap 中,从而实现了 HashSet 元素不重复的特征 在此就直接贴出源代码了 package java.util; import java.io.InvalidObjectException; public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, java.io.Serializable{ //序列化ID static final long serialVersionUID = -5024744406713321676L; //HashSet 底层用 HashMap 来存放数据 //Key值由外部传入,Value则由 HashSet 内部来维护 private transient HashMap<E,Object> map; //HashMap 中所有键值对都共享同一个值 //即所有存入 HashMap 的键值对都是使用这个对象作为值 private static final Object PRESENT = new Object(); //无参构造函数,HashMap 使用默认的初始化大小和装载因子 public HashSet() { map = new HashMap<>(); } //使用默认的装载因子,并以此来计算 HashMap 的初始化大小 //+1 是为了弥补精度损失 public HashSet(Collection<? extends E> c) { map = new HashMap<>(Math.max((int) (c.size()/.75f) + 1, 16)); addAll(c); } //为 HashMap 自定义初始化大小和装载因子 public HashSet(int initialCapacity, float loadFactor) { map = new HashMap<>(initialCapacity, loadFactor); } //为 HashMap 自定义初始化大小 public HashSet(int initialCapacity) { map = new HashMap<>(initialCapacity); } //此构造函数为包访问权限,只用于对 LinkedHashSet 的支持 HashSet(int initialCapacity, float loadFactor, boolean dummy) { map = new LinkedHashMap<>(initialCapacity, loadFactor); } //将对 HashSet 的迭代转换为对 HashMap 的 Key 值的迭代 public Iterator<E> iterator() { return map.keySet().iterator(); } //获取集合中的元素数量 public int size() { return map.size(); } //判断集合是否为空 public boolean isEmpty() { return map.isEmpty(); } //判断集合是否包含指定元素 public boolean contains(Object o) { return map.containsKey(o); } //如果 HashSet 中不包含元素 e,则添加该元素,并返回 true //如果 HashSet 中包含元素 e,则不会影响 HashSet ,并返回 false //该方法将向 HashSet 添加元素 e 的操作转换为向 HashMap 添加键值对 //如果 HashMap 中包含 key 值与 e 相等的结点(hashCode() 方法返回值相等,通过 equals() 方法比较也返回 true) //则新添加的结点的 value 会覆盖原有数据,但 key 不会有所改变 //因此如果向 HashSet 添加一个已存在的元素时,元素不会被存入 HashMap 中 //从而实现了 HashSet 元素不重复的特征 public boolean add(E e) { return map.put(e, PRESENT)==null; } //移除集合中的元素 o //如果集合不包含元素 o,则返回 false public boolean remove(Object o) { return map.remove(o)==PRESENT; } //清空集合中的元素 public void clear() { map.clear(); } /** * Returns a shallow copy of this <tt>HashSet</tt> instance: the elements * themselves are not cloned. * * @return a shallow copy of this set */ @SuppressWarnings("unchecked") public Object clone() { try { HashSet<E> newSet = (HashSet<E>) super.clone(); newSet.map = (HashMap<E, Object>) map.clone(); return newSet; } catch (CloneNotSupportedException e) { throw new InternalError(e); } } /** * Save the state of this <tt>HashSet</tt> instance to a stream (that is, * serialize it). * * @serialData The capacity of the backing <tt>HashMap</tt> instance * (int), and its load factor (float) are emitted, followed by * the size of the set (the number of elements it contains) * (int), followed by all of its elements (each an Object) in * no particular order. */ private void writeObject(java.io.ObjectOutputStream s) throws java.io.IOException { // Write out any hidden serialization magic s.defaultWriteObject(); // Write out HashMap capacity and load factor s.writeInt(map.capacity()); s.writeFloat(map.loadFactor()); // Write out size s.writeInt(map.size()); // Write out all elements in the proper order. for (E e : map.keySet()) s.writeObject(e); } /** * Reconstitute the <tt>HashSet</tt> instance from a stream (that is, * deserialize it). */ private void readObject(java.io.ObjectInputStream s) throws java.io.IOException, ClassNotFoundException { // Read in any hidden serialization magic s.defaultReadObject(); // Read capacity and verify non-negative. int capacity = s.readInt(); if (capacity < 0) { throw new InvalidObjectException("Illegal capacity: " + capacity); } // Read load factor and verify positive and non NaN. float loadFactor = s.readFloat(); if (loadFactor <= 0 || Float.isNaN(loadFactor)) { throw new InvalidObjectException("Illegal load factor: " + loadFactor); } // Read size and verify non-negative. int size = s.readInt(); if (size < 0) { throw new InvalidObjectException("Illegal size: " + size); } // Set the capacity according to the size and load factor ensuring that // the HashMap is at least 25% full but clamping to maximum capacity. capacity = (int) Math.min(size * Math.min(1 / loadFactor, 4.0f), HashMap.MAXIMUM_CAPACITY); // Create backing HashMap map = (((HashSet<?>)this) instanceof LinkedHashSet ? new LinkedHashMap<E,Object>(capacity, loadFactor) : new HashMap<E,Object>(capacity, loadFactor)); // Read in all elements in the proper order. for (int i=0; i<size; i++) { @SuppressWarnings("unchecked") E e = (E) s.readObject(); map.put(e, PRESENT); } } /** * Creates a <em><a href="Spliterator.html#binding">late-binding</a></em> * and <em>fail-fast</em> {@link Spliterator} over the elements in this * set. * * <p>The {@code Spliterator} reports {@link Spliterator#SIZED} and * {@link Spliterator#DISTINCT}. Overriding implementations should document * the reporting of additional characteristic values. * * @return a {@code Spliterator} over the elements in this set * @since 1.8 */ //为了并行遍历数据源中的元素而设计的迭代器 public Spliterator<E> spliterator() { return new HashMap.KeySpliterator<E,Object>(map, 0, -1, 0, 0); } } 更详细的源码解析可以看这里:Java_Android_Learn
优秀的个人博客,低调大师

Gearman——分布式任务分发框架

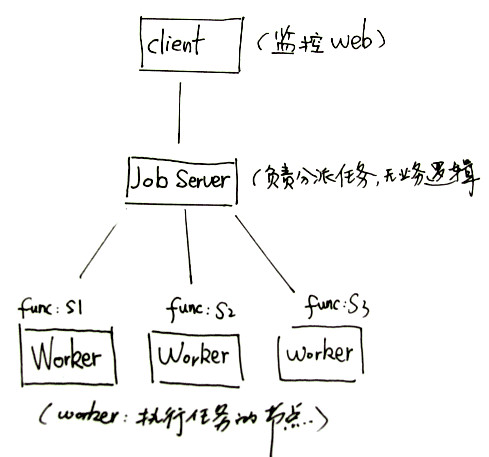
工作中我们有时候会遇到比如需要同时发布数据到多个个服务器上,或者同时处理多个任务。可以使用PHP的curl_multi的方式并发处理请求,但是由于网络和数据以及各个服务器等等的一些情况导致这种并发处理的响应时间很慢,因为在并发请求的过程中还包括记录日志,处理数据等逻辑,等待处理结果并返回,所以也不能友好的满足后台操作的体验。 现在有另外一种方案,利Gearman来实现并发的需求。通过Client将请求发送到Gearman的Jobs,在每个Work中来再来进行curl_multi和数据处理和日志等一些操作,同时用supervisor 来监控Gearman以及Works的进程,这样可以实现一个并行的多进程和负载均衡的方案。 Gearman可以做什么: 异步处理:图片处理,订单处理,批量邮件/通知之类的 要求高CPU或内存的处理:大容量的数据处理,MapReduce运算,日志聚集,视频编码 分布式和并行的处理 定时处理:增量更新,数据复制 限制速率的FIFO处理 分布式的系统监控任务 Gearman工作原理: 使用Gearman的应用通常有三部分组成:一个Client、一个Worker、一个 任务服务器。 Client的作用是提出一个 Job 任务 交给 Job Server 任务服务器。Job Server 会去寻找一个 合适的 Worker 来完成这项任务。Worker 执行由 Client 发送过来的 Job,并且将结果通过 Job Server 返回给 Client。Gearman 提供了 Client 和 Worker 的 API,利用这些API 应用可以同 Gearman Job Server来进行通信。Gearman 内部 Client 和 Worker 之间的通信都是通过 TCP 连接来进行的。 通常,多语言多系统之间的集成是个大问题,一般来说,人们多半会采用WebService的方式来处理此类集成问题,但不管采用何种风格的WebService,如RPC风格,或者REST风格,其本身都有一定的复杂性。相比之下,Gearman也能实现类似的作用,而且更简单易用。 一个Gearman请求的处理过程涉及三个角色:Client -> Job -> Worker。 Client:请求的发起者,可以是C,PHP,Perl,MySQL UDF等等。 Job:请求的调度者,用来负责协调把Client发出的请求转发给合适的Work。 Worker:请求的处理者,可以是C,PHP,Perl等等。 因为Client,Worker并不限制用一样的语言,所以有利于多语言多系统之间的集成。 甚至我们通过增加更多的Worker,可以很方便的实现应用程序的分布式负载均衡架构。 3 Gearman下载 1)官网 http://gearman.org/ 2)官网下载 https://launchpad.net/gearmand 3)官网使用向导 http://gearman.org/getting-started/ 3)本次安装用到的所有软件下载地址(安装环境为CentOS-6.5) http://download.csdn.net/detail/clevercode/8698699 4 Gearman安装 4.1 安装linux必备常用库 Linux中必备常用支持库的安装:http://blog.csdn.net/clevercode/article/details/45438401 4.2 安装gearmand依赖的库 # yum install -y boost-devel gperf libevent-devel libuuid-devel 4.3 安装gearmand服务 1)解压 # cd /usr/local/src/gearman # tar xzf gearmand-1.1.12.tar.gz 2)配置 # cd gearmand-1.1.12 # ./configure 3)编译 # make 4)安装 # make install 5)安装成功图,输入 # gearman 5 安装php扩展 1)安装phpize # yum install -y php-devel 2)解压 # cd /usr/local/src/gearman # tar xzf gearman-1.1.2.tgz 3)配置 # cd gearman-1.1.2 # phpize # ./configure 4)编译 # make 5)安装 # make install 6)安装成功 出现“Installing shared extensions: /usr/lib64/PHP/modules/”表示安装成功,/usr/lib64/php/modules/是gearman.so扩展的目录。如图 7)配置(加入扩展) # vi /usr/local/php5/etc/php.ini extension="gearman.so" 8)查配置是否成功 # vi test.php print gearman_version() . "\n"; ?> 执行php test.php后,出现1.1.12表示安装成功 # php test.php 1.1.12 6 Gearman启动停止 1) 创建日志/data0/logs/gearmand.log # touch /data0/logs/gearmand.log 2)启动 # /usr/local/sbin/gearmand -d -u root -L 192.168.142.130 --log-file=/data0/logs/gearmand.log 3)参数详解 -b,--backlog= 储备的监听连接数量 -d, --daemon 后台运行 -f, --file-descriptors= 文件描述符的数量 -h, --help 帮助 -j, --job-retries= 在ob server移除不可用job之前运行的次数,防止不断运行导致其他可用worker崩溃。默认没有限制 -l, -log-file= 日志文件存放位置(默认记录最简单日志) -L, --listen= 监听的IP,默认全部接受 -p, --port= 指定监听端口 -P, --pid-file= 指定进程ID写入位置 -r, --protocol= 加载协议模块 -q, --queue-type= 指定持久化队列 -t, --threads= 使用的I/9线程数量。默认为0 -u, --user= 启动后,切换到指定用户 -v, --verbose 增加一级详细程度 -V, --version 显示版本信息 4)查是否运行 # ps axu | grep gearmand 5)查看监听端口 # netstat -anp | grep 4730 6)停止,直接kill掉进程。 7 Gearman使用 7.1 创建Worker 创建worker.php,创建一个发送邮件的Worker端。代码如下 [php]view plaincopy $worker=newGearmanWorker(); $worker->addServer('192.168.142.130','4730'); $worker->addFunction("sendMail","my_sendmail_function"); while($worker->work()); functionmy_sendmail_function($job){ //接收数据 $tmp=$job->workload(); $receiveArr=unserialize($tmp); $from=$receiveArr['from']; $to=$receiveArr['to']; $subject=$receiveArr['subject']; $content=$receiveArr['content']; //发送邮件 //.... return$subject.'sendmailOK'; } ?> 7.2 启动Worker端 如果处理的数据量大,可以执行以下脚本多次,即启动多个Worker端。 # nohup php worker.php > tmp.txt & 7.3 创建Client(阻塞模式,需要等待返回结果才结束) 创建一个client.php。do()方法是阻塞模式,必须等待worker端返回结果,程序才能停止。(如图返回:hello Gearman sendmail OK) [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //等到worker端返回结果,才会结束。 $ret=$client->do("sendMail",$job); echo$ret."\r\n"; ?> 7.4 创建Client(非阻塞,不用等结果) 创建一个client2.php。doBackground()不用等待worker端返回结果,程序就结束了。 [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //不等待返回结果,就会结束 $ret=$client->doBackground("sendMail",$job); echo$ret."\r\n"; ?> 8 Gearman管理 输入以下命令,查看4730端口情况。 # (echo "status" ; sleep 2 ) | telnet 192.168.142.130 4730 1)字段说明:"已知注册的任务" "正在运行的任务" "队列中的任务" "可用的 Worker". 2)sendMail 0 0 1,注册的任务名为 sendMail,0 个正常在运行,队列为空,有一个可用的 Worker.

优秀的个人博客,低调大师

6种Java序列化框架

下面介绍几种常用的Java序列化技术,耗时比较,单位纳秒 0.002511:com.my.tools.serialize.KryoRegisterSerialize 0.007207:com.my.tools.serialize.FSTSerialize 0.00811:com.my.tools.serialize.KryoSerialize 0.010137:com.my.tools.serialize.GsonSerialize 0.012367:com.my.tools.serialize.FastjsonSerialize 0.021474:com.my.tools.serialize.JDKSerialize 1.JDKSerialize 方法一:若Student类仅仅实现了Serializable接口; 方法二:若Student类仅仅实现了Serializable接口,并且还定义了readObject(ObjectInputStream in)和writeObject(ObjectOutputSteam out); 方法三:若Student类实现了Externalnalizable接口,且Student类必须实现readExternal(ObjectInput in)和writeExternal(ObjectOutput out)方法, [java] view plain copy publicstaticbyte[]serialize(Objectobj){try{ByteArrayOutputStreambaos=newByteArrayOutputStream();ObjectOutputStreamoos=newObjectOutputStream(baos);oos.writeObject(obj);byte[]bs=baos.toByteArray();baos.close();oos.close();returnbs;}catch(IOExceptione){thrownewRuntimeException(e);}}publicstaticObjectdeserialize(byte[]bits){try{ByteArrayInputStreambais=newByteArrayInputStream(bits);ObjectInputStreamois=newObjectInputStream(bais);Objectobj=ois.readObject();bais.close();ois.close();returnobj;}catch(Exceptione){thrownewRuntimeException(e);}} 2.FastjsonSerialize 一个JSON库涉及的最基本功能就是序列化和反序列化。Fastjson支持java bean的直接序列化。 使用com.alibaba.fastjson.JSON这个类进行序列化和反序列化。 [java] view plain copy publicstaticStringserialize(Objectobj){Stringjson=JSON.toJSONString(obj);returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){Objectobj=JSON.parseObject(json,clazz);returnobj;} 3.FSTSerialize FST fast-serialization 是重新实现的 Java 快速对象序列化的开发包。序列化速度更快(2-10倍)、体积更小,而且兼容 JDK 原生的序列化。 要求 JDK 1.7 支持。 Java 快速序列化库 FST 已经发布了 2.0 版本,该版本的包名已经更改,无法平滑升级。另外官方建议为了稳定性考虑还是使用最新的 1.58 版本为好 [java] view plain copy staticFSTConfigurationconfiguration=FSTConfiguration.createDefaultConfiguration();publicstaticbyte[]serialize(Objectobj){returnconfiguration.asByteArray((Serializable)obj);}publicstaticObjectdeserialize(byte[]sec){returnconfiguration.asObject(sec);} 4.GsonSerialize 这里采用JSON格式同时使用采用Google的gson-2.2.4.jar 进行转义. [java] view plain copy staticGsongson=newGson();publicstaticStringserialize(Objectobj){Stringjson=gson.toJson(obj);returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){Objectobj=gson.fromJson(json,clazz);returnobj;} 5.JacksonSerialize Jackson库(http://jackson.codehaus.org),是基于java语言的开源json格式解析工具,整个库(使用最新的2.2版本)包含3个jar包: jackson-core.jar——核心包(必须),提供基于“流模式”解析的API。 jackson-databind——数据绑定包(可选),提供基于“对象绑定”和“树模型”相关API。 jackson-annotations——注解包(可选),提供注解功能。 Jackson的优势: 相对于java json解析的其他库,诸如json-lib、gson包,Jackson具有以下优点: 功能全面,提供多种模式的json解析方式,“对象绑定”使用方便,利用注解包能为我们开发提供很多便利。 性能较高,“流模式”的解析效率超过绝大多数类似的json包。 核心包:JsonPaser(json流读取),JsonGenerator(json流输出)。 数据绑定包:ObjectMapper(构建树模式和对象绑定模式),JsonNode(树节点) [java] view plain copy publicstaticStringserialize(Objectobj){ObjectMappermapper=newObjectMapper();Stringjson=null;try{json=mapper.writeValueAsString(obj);}catch(Exceptione){//TODOAuto-generatedcatchblocke.printStackTrace();}returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){ObjectMappermapper=newObjectMapper();Objectobj=null;try{obj=mapper.readValue(json,clazz);}catch(Exceptione){//TODOAuto-generatedcatchblocke.printStackTrace();}returnobj;} 6.KryoSerialize 和KryoRegisterSerialize Kryo的运行速度是java Serializable 的20倍左右 Kryo的文件大小是java Serializable的一半左右 Kryo有两种模式: 一种是先注册(regist),再写对象,即writeObject函数,实际上如果不先注册,在写对象时也会注册,并为class分配一个id。 注意,如果是rpc,则必须两端都按同样的顺序注册,否则会出错,因为必须要明确类对应的唯一id。 另一种是写类名及对象,即writeClassAndObject函数。 writeClassAndObject函数是先写入(-1 + 2)(一个约定的数字),再写入类ID(第一次要先写-1,再写类ID + 类名),写入引用关系(见引用的实现),最后才写真正的数据)。 注意每一次writeClassAndObject调用后信息都会清空,所以不用担心和client交互时会出错。 [java] view plain copy staticKryokryo=newKryo();publicstaticbyte[]serialize(Objectobj){byte[]buffer=newbyte[2048];Outputoutput=newOutput(buffer);kryo.writeClassAndObject(output,obj);byte[]bs=output.toBytes();output.close();returnbs;}publicstaticObjectdeserialize(byte[]src){Inputinput=newInput(src);Objectobj=kryo.readClassAndObject(input);input.close();returnobj;} [java] view plain copy staticKryokryo=null;static{kryo=newKryo();kryo.setReferences(false);kryo.setRegistrationRequired(false);kryo.setInstantiatorStrategy(newStdInstantiatorStrategy());}publicstaticbyte[]serialize(Objectobj){kryo.register(obj.getClass());byte[]buffer=newbyte[2048];Outputoutput=newOutput(buffer);kryo.writeObject(output,obj);byte[]bs=output.toBytes();output.close();returnbs;}publicstaticObjectdeserialize(byte[]src,Class<?>clazz){kryo.register(clazz);Inputinput=newInput(src);Objectobj=kryo.readObject(input,clazz);input.close();returnobj;} Json的优点:明文结构一目了然,可以跨语言,属性的增加减少对解析端影响较小。缺点:字节数过多,依赖于不同的第三方类库。 Object Serializalbe 优点:java原生支持,不需要提供第三方的类库,使用比较简单。缺点:无法跨语言,字节数占用比较大,某些情况下对于对象属性的变化比较敏感。 对象在进行序列化和反序列化的时候,必须实现Serializable接口,但并不强制声明唯一的serialVersionUID,是否声明serialVersionUID对于对象序列化的向上向下的兼容性有很大的影响。 我们通常以为将Java对象序列化成二进制比序列化成XML或Json更快,其实是错误的,如果你关心性能,建议避免Java序列化。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册