首页 文章 精选 留言 我的

精选列表

搜索[字节级],共10000篇文章
优秀的个人博客,低调大师

RWKV 模型本地部署工具 Ai00 Server 保姆级教程

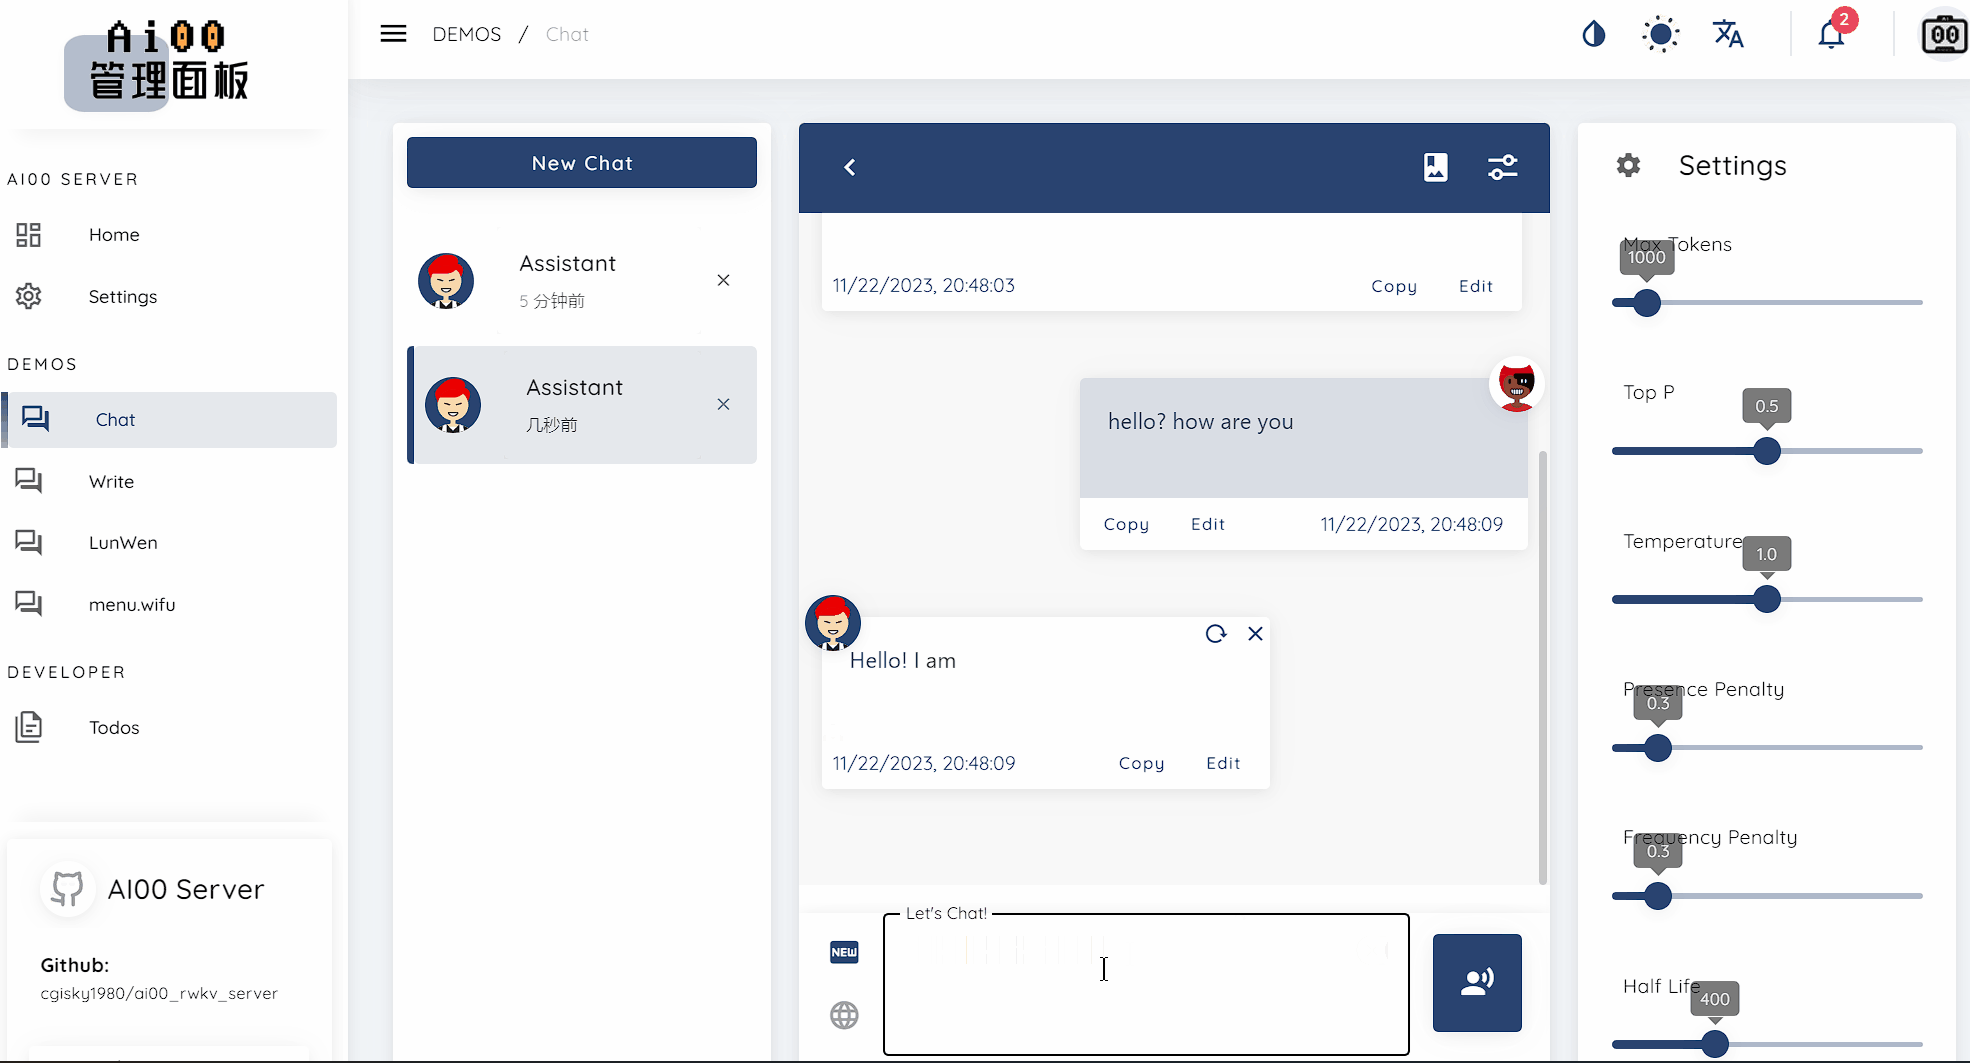
了解Ai00 简介 Ai00 Server 是基于 web-rwkv 推理引擎的 RWKV 语言模型推理 API 服务器。它本身也是一个基于 MIT 协议的开源软件,由 RWKV 开源社区成员 @cryscan 和@顾真牛牵头成立的 Ai00-x 开发组开发。 Ai00 Server 支持 Vulkan 作为推理后端,支持 Vulkan 并行和并发批量推理,可以在所有支持 Vulkan 的 GPU 上运行。事实上, Ai00 Server 支持大部分 NVIDIA、AMD、Intel 的显卡(包括集成显卡)。 在高兼容性的同时,Ai00 Server 又不需要笨重的 pytorch 、 CUDA 和其他运行时环境。它结构紧凑,开箱即用,且支持 INT8/NF4 量化,可以在绝大部分的个人电脑上高速运行。 Ai00 Server 仓库地址:https://github.com/Ai00-X/ai00_server 这篇新手教程旨在为一些刚接触 RWKV 大模型和 Ai00 Server 的朋友们提供指引。遵循本文的步骤,应该可以成功使用 Ai00 Server 本地运行 RWKV 模型,并进行各种任务,包括聊天、文本生成、翻译和问答。 功能预览 聊天功能 与模型对话,聊天或提出问题让模型回答。 续写功能 使 RWKV 模型根据你给定的内容进行续写。 也可以使用特定格式的 prompt ,让模型遵循某种指令执行任务。具体的 prompt 实现请参阅:https://shoumenchougou.github.io/Awesome-RWKV-Prompts/#/Writer-Prompts 写论文 从给定的论文标题生成论文提纲,再根据提纲生成论文内容。 快速上手 下载与安装 对于新手来说,我们建议直接从 Ai00 Server 的 Release 页面下载最新版本。 在每个版本发布的 Assets 版块可以找到已经打包好的 Ai00 Server 压缩包,下载并解压即可使用。 下载/转换 RWKV 模型 Ai00 Server 目前仅支持 .st 后缀的 Safetensors 模型,有两种方法可以得到 .st 模型: 1. 下载已经转换好的 .st 模型(推荐方式) RWKV-5 系列:https://huggingface.co/cgisky/AI00_RWKV_V5/tree/main RWKV-6 系列:https://huggingface.co/cgisky/ai00_rwkv_x060/tree/main 如果你无法访问上面的网站,请访问以下镜像站: RWKV-5 系列:https://hf-mirror.com/cgisky/AI00_RWKV_V5/tree/main RWKV-6 系列:https://hf-mirror.com/cgisky/ai00_rwkv_x060/tree/main 2. 下载 .pth 后缀模型,并通过工具转换成 .st 模型 首先,可以从 RWKV 官方仓库中下载 .pth 后缀的 RWKV 模型,下载地址: RWKV-5 系列:https://huggingface.co/BlinkDL/rwkv-5-world/tree/main RWKV-6 系列:https://huggingface.co/BlinkDL/rwkv-6-world/tree/main 如果你无法访问上面的网站,请访问以下镜像站: RWKV-5 系列:https://hf-mirror.com/BlinkDL/rwkv-5-world/tree/main RWKV-6 系列:https://hf-mirror.com/BlinkDL/rwkv-6-world/tree/main 下载完成后,应该可以在文件夹中找到 .pth 模型: 在 Ai00 Server 解压的文件夹中,可以找到名为 “converter.exe” 的模型转换工具。在命令行中执行以下命令,可以将指定路径的 .pth 模型转化成 .st 模型: $ ./converter --input /path/to/model.pth 请将上述命令中的 /path/to/model.pth 改成需要转换的模型文件路径。 获得 .st 后缀的 RWKV 模型后,我们需要在 assets 文件夹中新建一个 models 文件夹,并将 RWKV 模型放在此文件夹中。 调整配置参数 Ai00 程序会按照 assets/configs/Config.toml 配置文件中的参数运行 RWKV 模型。可以通过文本编辑软件(如记事本等)修改 Config.toml 的配置项,调整模型的运行效果。 下面是一组推荐的 Config.toml 配置。 注意:带中文标注的配置项可以尝试更改,其他英文标注的配置项不建议自行更改,除非你了解其具体作用。 [model] embed_device = "Cpu" # 在GPU还是CPU上放模型的Embed矩阵 ("Cpu" or "Gpu"). max_batch = 8 # The maximum batches that are cached on GPU. name = "RWKV-x060-World-3B-v2.1-20240417-ctx4096.st" # 模型名称,只支持后缀st格式模型,请自己在RWKV程序中转换好,或者直接下载转换好的模型 path = "assets/models" # 模型路径 precision = "Fp16" # Precision for intermediate tensors ("Fp16" or "Fp32"). "Fp32" yields better outputs but slower. quant = 0 # 量化层数,调高会提升效率,但可能损失精度,使模型效果变差 quant_type = "Int8" # 量化类型 ("Int8" or "NF4"),Int 8 效果比 NF4 好,但需要更多显存 stop = ["\n\n"] # Additional stop words in generation. token_chunk_size = 128 # 并行Token块大小,范围32-128,显卡越牛逼这个数调越大(64 or 128) # [[state]] # 是否挂载 state # default = true # 启动 Ai00 时是否加载 state 文件 # id = "fd7a60ed-7807-449f-8256-bccae3246222" # state 文件的 UUID,不指定则随机分配 # name = "x060-3B" # 是否为此 state 文件命名(可选项) # path = "rwkv-x060-chn_single_round_qa-3B-20240505-ctx1024.state" # state 文件的路径 # [[state]] # 是否挂载第二个 state 文件 # default = false # 启动 Ai00 时是否加载第二个 state 文件 # id = "6a9c60a4-0f4c-40b1-a31f-987f73e20315" # state 文件的 UUID,不指定则随机分配 # path = "rwkv-x060-chn_single_round_qa-3B-20240502-ctx1024.state" # state 文件的路径 # [[lora]] # 是否默认启用 LoRA # alpha = 192 # path = "assets/models/rwkv-x060-3b.lora" # LoRA 文件的路径 [tokenizer] path = "assets/tokenizer/rwkv_vocab_v20230424.json" # Path to the tokenizer. [bnf] enable_bytes_cache = true # Enable the cache that accelerates the expansion of certain short schemas. start_nonterminal = "start" # The initial nonterminal of the BNF schemas. [adapter] Auto = {} # Choose the best GPU. # Manual = 0 # Manually specify which GPU to use. [listen] acme = false domain = "local" ip = "0.0.0.0" # IPv4 地址 # ip = "::" # Use IpV6. force_pass = true port = 65530 slot = "permisionkey" tls = true # 是否使用 https ,如果你只在本地体验 AI00 请设置为 false [[listen.app_keys]] # Allow mutiple app keys. app_id = "JUSTAISERVER" secret_key = "JUSTSECRET_KEY" [web] # Remove this to disable WebUI. path = "assets/www/index.zip" # Path to the WebUI. 运行 Ai00 程序 配置项修改完毕后,请保存 Config.toml 文件,并双击运行 ai00_server.exe 程序。 当命令行中出现 INFO [ai00_server::middleware] model reloaded 提示时,意味着模型已经加载完成: 此时我们打开任意浏览器,并访问 https://localhost:65530,即可打开 Ai00 的 Web 界面。 调整右侧解码参数 Web 页面的右侧有一些可设置的模型解码参数,如 Temperature 、Top_P、Presence Penalty 和 Frequency Penalty ,调整这些参数会影响模型的生成效果。 参数对应的效果如下: API 参数 效果描述 Temperature 采样温度,就像给模型喝酒,数值越大随机性越强,更具创造力,数值越小则越保守稳定。 Top_P 就像给模型喂镇静剂,优先考虑前 n% 概率质量的结果。如设置成 0.1 则考虑前 10%,生成内容质量更高但更保守。如设置成 1,则考虑所有质量结果,质量降低但更多样。 Presence Penalty 存在惩罚,正值根据“新 token 在至今的文本中是否出现过”来对其进行惩罚,从而增加了模型涉及新话题的可能性。 Frequency Penalty 频率惩罚,正值根据“新 token 在至今的文本中出现的频率/次数”来对其进行惩罚,从而减少模型原封不动地重复相同句子的可能性。 其中 Temperature 和 Top_P 两个参数对模型生成效果的影响最大。 参数推荐 续写小说和对话这一类需要创造性的任务,需要高 Temperature + 低 Top_P 的参数组合,可以尝试以下四种参数搭配: Temperature 1.2 ,Top_P 0.5 Temperature 1.4 ,Top_P 0.4 Temperature 1.4 ,Top_P 0.3 Temperature 2 ,Top_P 0.2 举个例子,续写小说可以尝试将 Temperature 设为 2 ( Temperature 增加会提高文采,但逻辑会下降),然后将 Top_P 设为 0.1 ~ 0.2 (Top_P 越低,逻辑能力越强),这样生成的小说内容逻辑和文采都很好。 完成相对机械的任务,例如材料问答、文章摘要等,则可将参数设为: Temperature 1 ,Top_P 0.2 Temperature 1 ,Top_P 0.1 Temperature 1 ,Top_P 0 举个例子,如果你正在执行像关键词提取之类的机械任务,不需要模型进行任何开放性思考,则可以将 Temperature 设为 1 ,Top_P、Presence Penalty、Frequency Penalty 都设为 0 。 进阶功能 除了驱动 RWKV 模型进行对话、续写之外,Ai00 还有许多进阶功能。 你可以在 Ai00 发布新版本的时候回到本页面,以查看 Ai00 的最新功能。 挂载 State 文件 [版本 0.4.9] 挂载 State 文件可以强化模型在某一类任务的表现。以一个强化单轮问答 + emoji 的 State 为例,同样都是“东京到巴黎怎么走”这个问题,模型在挂载该 State 前后的回答画风完全不同: 不挂载 State 文件: 挂载“强化单轮中文对话 + Emoji ”的 State 文件后: 下载 State 文件 Ai00 Server 目前仅支持 .state 后缀的 State 文件,可以从 HF 仓库下载 .state 文件。 如果你无法访问上面的网站,请访问 HF 镜像站。 如何挂载 State ? 在 Config.toml 配置文件中修改关于挂载 State 的参数: # [[state]] # 是否挂载 state # id = "fd7a60ed-7807-449f-8256-bccae3246222" # state 文件的 UUID,不指定则随机分配 # name = "x060-3B" # 是否为此 state 文件命名(可选项) # path = "rwkv-x060-chn_single_round_qa-3B-20240505-ctx1024.state" # state 文件的路径 要启用 State 挂载功能,请移除 # 注释符号,并修改对应的参数。参考如下: [[state]] # 是否挂载 state # id = "fd7a60ed-7807-449f-8256-bccae3246222" # 非开发环境一般不指定 UUID,可保留 `#` 注释符 name = "x060-7B-Chinese" # 为此 state 文件命名为“x060-7B-Chinese” path = "rwkv-x060-chn_single_round_qa-7B-20240516-ctx2048.state" # state 文件的名称,存放在 `model` 文件夹 挂载 State 注意事项 注意:挂载 state 文件时,必须使用与 State 文件参数一致的基底 RWKV 模型。 举个例子:这个 State 文件是基于 RWKV-6-World-7B 模型微调而来,那么你在 Ai00 中必须启动 RWKV-6-World-7B 模型,挂载的 State 文件才会生效。 截至 Ai00 0.5.0 版本,支持在 WebUI-聊天模式右上方动态切换 State,但不支持同时挂载多个 State 。 挂载 LoRA 模型 [版本 0.4.9] 挂载 LoRA 模型和 State 的效果相似,也可以增强模型在某类任务上的表现。 如何挂载 LoRA 模型 ? 可以在 Config.toml 文件配置中修改挂载 LoRA 模型的参数: # [[lora]] # 是否默认启用 LoRA # alpha = 192 # path = "assets/models/rwkv-x060-3b.lora" # LoRA 文件的路径 要启用 LoRA 挂载功能,请移除 # 注释符号,并修改对应的参数。参考如下: [[lora]] # 默认启用 LoRA # alpha = 192 path = "assets/models/rwkv-x060-3b.lora" # LoRA 文件的路径 挂载 LoRA 模型注意事项 与挂载 state 相似,挂载 LoRA 文件时,必须使用与 LoRA 模型参数一致的基底 RWKV 模型。 举个例子:这个 LoRA 文件是基于 RWKV-6-World-3B 模型微调而来,那么你在 Ai00 中必须启动 RWKV-6-World-3B 模型,挂载的 LoRA 模型才会生效。 截至 Ai00 0.5.0 版本,支持在 WebUI 中同时加载多个 LoRA ,但不支持在 WebUI 中动态切换 LoRA。 这意味着想要取消 LoRA ,必须重启 Ai00 服务。 BNF (Backus-Naur Form) [版本 0.4.9] BNF 可以强制模型以您想要的格式输出(例如,JSON、带有指定字段的 markdown)。 以下是一个 JSON 的 BNF 示例,其中包含字段 name 和 age : <start> ::= <json_object> <json_object> ::= "{" <object_members> "}" <object_members> ::= <json_member> | <json_member> ", " <object_members> <json_member> ::= <json_key> ": " <json_value> <json_key> ::= '"' "name" '"' | '"' "age" '"' | '"' "job" '"' <json_value> ::= <json_string> | <json_number> <json_string>::='"'<content>'"' <content>::=<except!([escaped_literals])>|<except!([escaped_literals])><content>|'\\"'<content>|'\\"' <escaped_literals>::='\t'|'\n'|'\r'|'"' <json_number> ::= <positive_digit><digits>|'0' <digits>::=<digit>|<digit><digits> <digit>::='0'|<positive_digit> <positive_digit>::="1"|"2"|"3"|"4"|"5"|"6"|"7"|"8"|"9" 以 prefab 格式导出量化模型[版本 0.4.9] 在 Ai00 的 WebUI - Setting 界面,可以以 prefab 格式导出量化后的 RWKV 模型。 什么是 prefab 格式?prefab 格式的 RWKV 模型有什么用? Prefab(预制件)通常是指在游戏开发中使用的一种资源格式,Prefab 允许开发者创建、保存和复用游戏对象(GameObject)及其组件的配置。一个Prefab可以包含任何类型的游戏对象,比如角色、道具、环境元素等,以及它们的所有属性和设置。 以 prefab 格式导出 RWKV 模型,可以方便地将 RWKV 模型集成到游戏中,比如用于对话系统、故事生成或者角色行为。 常见问题 Q:访问 https://localhost:65530 加载失败 A:如果你在 Config.toml 设置了 tls = false ,则需要将 https 改为 http,即访问 http://localhost:65530 Q:为什么我在 config 里面把 tls=true 改成了 false,启动的时候还是把 tls 打开了? A:如果设置了 ACME 的话,TLS 无论如何都是打开的。 Q:在自己电脑上可以成功运行,在 autodl 上报错。 A:autodl 不支持 vulkan,无法使用。 Q:为啥电脑有多张显卡时,跑 AI00 只有一张显卡在干活的感觉 A:AI00 暂时不支持多显卡推理。 Q:报错: ERROR [ai00 server::middleware] reload model failed: failed to request adaptor A:这是因为设备缺少 vulkan 驱动,请安装最新版本驱动。 Q:AI00 支持 CUDA 驱动吗? A:不支持。AI00 支持 Vulkan 作为推理后端,曾经支持 Dx12/openGL ,但不支持 CUDA 驱动。 Q:为什么我使用共享显存后感觉速度变慢了 A:一旦用了共享显存,运行速度会慢 20 倍。这是计算机硬件的工作原理,并非 bug。 倘若大家遇到其他问题,欢迎加入 RWKV QQ 群 224287095 或 Ai00 QQ 群 30920262 提问。

优秀的个人博客,低调大师

高效构建 vivo 企业级网络流量分析系统

作者:vivo 互联网服务器团队- Ming Yujia 随着网络规模的快速发展,网络状况的良好与否已经直接关系到了企业的日常收益,故障中的每一秒都会导致大量的用户流失与经济亏损。因此,如何快速发现网络问题与定位异常流量已经成为大型企业内必须优先解决的问题,诸多网络流量分析技术也同时应运而生。 一、概述 随着网络规模的快速发展,网络状况的良好与否已经直接关系到了企业的日常收益,故障中的每一秒都会导致大量的用户流失与经济亏损。每一家企业都在不断完善自己的网络监控手段,但在监控体系建设过程中,却又不可避免的面临以下难点: 网络流量数据庞大:由于网络流量的规模和复杂性都非常高,很难对大量的数据进行有效的监控和分析。 流量数据采集分析建设成本高昂:为获取准确的流量数据,需要使用高效的数据采集技术和大容量的存储设备,以及大量的开发资源,这使得监控成本直线上升 监控手段单一、缺乏扩展性:传统的监控手段一般只能监控固定的几个数据点,难以针对不同的网络环境进行定制化和扩展。 难以快速定位和解决问题:由于网络流量数据量大、变化频繁,往往需要花费大量的时间和精力才能找出问题根源。 因此,如何利用尽可能低的监控成本快速发现网络问题与定位异常流量已经成为大型企业内必须优先解决的问题,诸多网络流量分析技术也同时应运而生。 sFlow技术就是这样一种高效、灵活的解决方案。它可以通过流量采样技术抽取数据包中的部分信息,从而实现对大量网络流量数据进行持续监控。同时,sFlow技术还具有灵活的配置和扩展性,可以根据实际需求进行定制,并支持多种网络设备和协议。这些优势使得sFlow技术在现代网络监控和管理中得到广泛应用。 二、常见的网络流量采集技术 主流的网络流量采集主要分为全流量采集与采样流量采集两种。 2.1 全流量采集 全流量采集包括端口镜像、分光设备等方式。在流量庞大的网络中,使用端口镜像方式不仅会导致全链路时延增加,而且会使吞吐量庞大情况下的网络设备压力激增。分光设备虽然可以降低链路时延,但同样存在采购价格高昂的门槛。除此之外,由于大型企业内IDC规模庞大,由此导致的全流量数据量也会激增,想要完整的靠自研做好全流量数据分析,不仅需要一定的存储计算资源,也需要一定的软件开发周期,不利于项目的快速搭建成型。 2.2 采样流量采集 在流量分析系统欠缺的情况下,使用采样分析的优势就体现出来了,相对于全流量,他部署成本低,数据分析代价小,很适合对异常流量的快速定位以及网络内的趋势占比分析。以下主要对比介绍sFlow与Netflow两种采样方式的优缺点。 sFlow在流量监控上范围更广,在满足硬件要求的IDC内部环境,使用sFlow进行采样流量监测,可以有效降低网络设备负载,并且提供实时流量监控手段,以应对突发网络异常场景。 三、基于sFlow的系统设计 3.1 基础设计 在满足硬件条件的情况下,基于sFlow的基础系统设计很简单,使用sFlow agent + sFlow collector + sFlow analyser即可实现整个流程的数据闭环。 sFlow agent:通过enabled相关网络设备上的sFlow能力,设定采样比等参数并制定收集端相应地址,即可对端口收发流量进行采集。agent侧更重要的反而是如何确定采集的网络设备范围,相对于无目的的全量网络设备部署,针对边界核心网络设备进行部署更有意义,因为所有的对外流量最终都必须经过边界网络设备。在能更好监控外部流量异常的情况下,也能减轻数据存储负担。 sFlow collector:收集并解析agent侧采集传输的 sFlow datagrams。 sFlow analyser:对格式化的数据进行可视化分析展示,以供网络管理员进行有效观测分析。 3.2 开源+自研:架构进阶 在确定了基本架构之后,如何进行组件选用与定制化功能扩充,开源解决方案elastiflow为我们提供了很好的示例,笔者基于开源进行了扩展,以满足更多定制化功能。 sFlow agent:使用上报统一vip的形式进行端口流量采样(官方规定的采样比需是2^n),可以利用vip的LB能力进行负载均衡,使得sFlow报文均衡打到收集端固定端口。针对不同的网络线路设定不同的采样比,在降低数据存储的同时也可以保证重要线路更高的精准性。 sFlow collector:使用ELK套件进行数据收集与可视化分析是比较成熟的技术方案之一。因此,收集端我们使用logstash进行原生数据报文收集与解析。elastiflow的作者使用了logstash内原生的udp-sFlow报文解析组件进行数据解析,但笔者在实际测试中发现,虽然该方案能得到结构化更好的数据格式,但在数据解析的性能表现上很差,在数据量庞大的情况下会造成大量数据丢包现象,导致数据准确性下降。而sFlowtool由于底层是基于C语言来编写的,在性能表现上很优异,单物理机(32c64g)即可达到10w+tps,虽然对sFlow报文解析后的数据结构化要弱一点,但可以在后续分析模块对数据进行清洗与结构化构建。sFlowtool分析的数据示例如下所示。经由logstash的数据发送到kafka消息队列中。 [root@server src]# ./sFlowtool -lFLOW,10.0.0.254,0,0,00902773db08,001083265e00,0x0800,0,0,10.0.0.1,10.0.0.254,17,0x00,64,35690,161,0x00,143,125,80FLOW后的字段释义如下agent_addressinputPortoutputPortsrc_MACdst_MACethernet_typein_vlanout_vlansrc_IPdst_IPIP_protocolip_tosip_ttludp_src_port OR tcp_src_port OR icmp_typeudp_dst_port OR tcp_dst_port OR icmp_codetcp_flagspacket_sizeIP_sizesampling_rate sFlow analyser:通过从kafka实时消费数据,将数据进行清洗结构化,并借助三方metadata,对解析后的数据进行软件定义,以便于后续存储与分析。 database+display:使用Elasticsearch+Kibana进行存储与可视化展示,同时也可以利用mertic beat对logstash的采集性能进行监控。Kibana作为Bi类的数据可视化方案,提供了大部分可供免费使用的图表及Dashboard,可以很好的进行可视化分析。 3.3 分析端软件定义 拥有原生数据的情况下,我们已经能基于一些ip五元组等进行基本会话流量分析。但是流量数据所能体现的价值远不止这些,利用企业内其他的cmdb等平台,可以为我们的流量数据提供更大价值。 网络设备维度:通过数据内的交换机地址,出入向端口,可以根据采集配置的交换机端口index,判断该条流量出入向。也可基于网络设备ip,赋予其通道,线路,以及设备名等等其他属性。 ip维度:ip五元组提供了探索数据更高的可能,我们可以根据归属ip,判断他的项目,部门等归属信息,也可反向关联域名。这在对异常流量进行分析判断时能够快速定位到所属业务方,很大程度提高了运维效率。 3.4 压缩存储与可视化自研 由于Elasticsearch本身的数据压缩效果不够理想,使得我们在进行长时间存储数据时体量庞大臃肿。相应的,olap型数据库Druid很好地解决了这个问题,数据采样后经过分析端严格的结构化处理,可以在Druid内实现很好的数据压缩。除此之外,Druid内嵌的数据预聚合能力也能更好的帮助我们对历史数据进行降精处理,减少存储压力。切换存储引擎后,也就意味着没办法再使用Kibana进行通用展示,使用自研的web服务框架也能够应对灵活的需求场景,实现更多定制化的分析。 3.5 基于Celery设计的轻量流处理模型 虽然流量数据经过了采样降精,但整体的数据量依然很庞大。高效快速的进行流处理,降低整体系统时延至30s内,能够更快的帮助网络管理人员发现问题,除却利用传统的流处理工具外,我们也可以使用Celery来构建一个轻量高效易扩展的分布式流处理集群。 Celery是一个简单、灵活且可靠的,处理大量消息的分布式系统,专注于实时处理的异步任务队列,同时也支持任务调度。我们基于celery实时异步处理的特性,设计 celerybeat → watcher → producer → consumer 的消费链路来进行流处理。 celery beat:作为定时任务的触发器,每1s向watcher队列里派发一个新任务。 watcher worker:在队列中拿到任务后,转发给producer,并根据设置的队列最大值,对producer队列进行拥塞控制。 producer worker:在队列中拿到任务后,从kafka中获取采集的流量数据,按照batch size批量发送给consumer队列,并根据设置的队列最大值,对consumer队列进行拥塞控制。 consumer worker:在队列中拿到任务后,根据本地缓存/共享缓存内的业务信息,对采集数据进行数据清洗,打业务标签等操作,并写入另一kakfa或直接写入database。 每一个角色以及节点可以通过Celery broker进行通信,实现分布式集群部署,针对consumer单元化操作,可以使用eventlet以协程方式启动,以保证集群高并发消费。 四、应用场景 4.1 机房维度流量分析 通过基于网络cmdb的ip匹配,对流量数据进行机房维度的汇总,可以得到机房整体的对外出入向流量分析,在IDC同外部交互时,整体流量的趋势变化,是判断带宽占用程度的直接标准。 4.2 网络线路信息关联 通过对网络设备基于ip+ifindex的逻辑信息映射,可以对核心通道线路做到聚合展示,在针对一些公网线路异常,专用线路带宽打满等异常问题时,通过观察线路分析可以直接准确定位故障发生的第一时间点。 4.3 ip会话信息挖掘 虽然sflow只截取了报文的头部信息而不包含数据包部分,但ip五元组本身也提供了极大的网络流量分析价值。 利用会话信息,我们可以准确有效的定位异常流量的ip归属,通过ip+服务端口的,我们甚至可以定位具体产生流量异常的服务与进程,从而做出下一步决策。除此之外,ip也能同企业内CMDB产生联动,定位到ip所属资源的所在资源组,从而得到不同部门/行政组产生的流量占比分析,这同时也有利于在产生异常流量时第一时间感知到相关业务,并进行通知管控。 4.4 ip归属地分析 除了结合内部信息,通过运营商提供的归属地信息,我们可以查看ip访问的来源,进行相关归属地分析与Dashboard制作。 五、总结 要实现对网络全面、实时的监控分析必须依靠先进有效的网络监控协议和技术来满足业务日益增长的需求。基于sFlow的流量分析虽然在轻量化构建上有着很大的优势,在面对异常流量时也能够基于流量趋势与分布占比做出快速反应。但sFlow本身的采样却不包含报文内数据包的信息,针对一些sql注入、数据安全等等网络安全攻防问题,没办法提供准确定位与解决方案。因此,全流量分析也应是流量分析系统未来必不可少的一环,两者相结合才能够提供更全面、更精细化的流量监控,为数据中心的网络安全保驾护航。 六、未来展望 虽然sFlow技术在网络性能监控和管理领域中得到了广泛应用,但在未来更大规模的网络流量场景冲击下,还需要具备更多的能力: 1.支持更多协议和应用:sFlow监控的思想不仅适用于网络流量,还可以监控应用流量、虚拟化环境、云平台等。未来,sFlow技术应该支持更多的协议和应用,以更好地适应新型网络环境。 2.自适应流量采集技术:sFlow技术的流量采集技术是固定周期的,但是随着网络流量的变化,固定周期的采集可能无法准确反映网络实时状态。未来,sFlow监控技术应该支持自适应流量采集技术,能够根据实际网络流量变化自动调整采集周期。 3.便捷的管理功能:sFlow目前的配置更多依赖于网络管理人员在交换机上进行配置,无法实现一键下发,自动发现,快速调整采样比等等功能,未来更需要一个能够便捷下发命令,热加载配置变更的sFlow管理平台。 END 猜你喜欢 Jedis 参数异常引发服务雪崩案例分析 HBase Compaction 原理与线上调优实践 深入解析Redis的LRU与LFU算法实现 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

GoFrame v2.5 版本发布,企业级 Golang 开发框架

大家好啊,GoFrame框架今天发布了v2.5.0正式版本啦!👏👏👏👏 本次版本主要是对已有功能组件以及开发工具上的改进工作。其中,开发工具新增了gf gen ctrl命令,以规范化定义、开发API接口,增加控制器、SDK的代码生成提高开发效率,以解决Golang工程开发中接口层面的规范和效率问题,详情请参考:接口规范-gen ctrl。其他变更内容请参考以下change log。Enjoy!🍺🍺🍺🍺🍺🍺🍺🍺 Github ChangeLog:https://github.com/gogf/gf/releases/tag/v2.5.0 完整代码变更:v2.4.0...v2.5.0,感谢本次所有的贡献开发者: 功能改进 gdb 改进ORM SQL日志记录,操作的字段按照数据表字段定义顺序进行操作。 改进HOOK方法实现,支持修改in参数的Table字段后修改执行的表名。 新增AllAndCount/ScanAndCount方法,用于实现便捷的分页查询场景。 新增Model.WhereOrNot/WhereOrPrefixNot条件方法。 gi18n 改进支持中文(Unicode)作为转译的键名。 gclient 新增Discovery链式操作方法,用于设置本次请求的服务发现组件。 ghttp 改进请求Context上下文处理,每次Context的变更将会影响底层的http.Request对象。以支持自定义HTTP Handler的数据交互场景。 新增Endpoints配置项支持,用于自定义Server的服务注册发现地址,而可以使用当前监听的地址。 goai 改进参数校验识别,如果参数为必须参数,则在OpenAPIv3结果中进行标记。 gsel 修复RoundRobin实现中Endpoints更新的锁机制问题。 glog 新增TimeFormat配置,用于自定义日志输出的时间格式:日志组件-配置管理 改进Rotation实现,支持短运行程序的日志文件切分。 gtag 新增GetGlobalEnums方法,用于获取全局注册的枚举类型。 gutil 新增DumpJson方法,用于将任意类型变量按照JSON格式化打印到终端,便于人工阅读。 gvalid 新增enums校验规则,用于实现枚举类型的自动识别和校验:数据校验-校验规则 社区组件 修复contrib/registry/polaris组件在多个服务端时的负载均衡问题。 改进contrib/drivers/pgsql在TableFields返回的Index字段序号统一从0开始。 改进contrib/nosql/redis新增用户配置项支持。 改进contrib/rpc/grpcx组件,grpcx.Server新增Endpoints配置项支持,用于自定义服务注册发现的地址。 新增contrib/sdk/httpclient组件,用于本次版本新增的gf gen ctrl命令生成的HTTP SDK代码文件依赖库。 新增contrib/trace/otlpgrpc及contrib/trace/otlphttp组件,用以实现基于OpenTelemetry的链路跟踪统一对接组件。 开发工具 新增gf gen ctrl命令,用于编译api定义目录,自动生成规范的controller、HTTP SDK代码:接口规范-gen ctrl 改进gf gen dao命令,新增TypeMapping特性,开发者可自定义数据表字段类型与生成的Go实体数据结构属性类型映射,并且可以方便引入第三方包类型(如decimal包以支持高精度类型):数据规范-gen dao 改进gf gen enums命令,其中的Prefix参数改为Prefixes,以支持多个生成枚举类型的包前缀指定:枚举维护-gen enums 改进gf gen service命令: 生成的service文件中,增加方法注释生成。 当生成的service文件中存在import冲突时,自动生成import alias。 改进命令行封装,暴露gfcmd.Command类型,便于开发者可以继承扩展自定义命令行功能。 改进gf docker命令,将构建文件参数设置为非必须(考虑兼容),未来将会只用于Docker构建,不再耦合二进制构建功能。如果有完整构建需求,建议未来结合gf build功能共同使用。并更新项目工程模板的make image命令,使用gf build+gf docker命令实现。 改进gf init命令,修复在部分场景下初始化项目覆盖已存在的.git/.gitignore目录及文件问题或权限报错问题。 改进gf up命令,修复在部分场景下的框架版本更新问题,以及在windows系统下的下载安装问题。 改进gf version命令,修复在部分场景下的框架版本识别问题。 修复gf gen pbentity命令,生成的proto文件实体数据结构的float32/float64/[]byte类型修改为float/double/bytes类型。 改进开发工具,部分命令可以不用显示配置importPrefix参数,如:gf gen dao/service

优秀的个人博客,低调大师

App复杂动画实现——Rive保姆级教程 | 京东云技术团队

作者:京东物流 沈明亮 在App开发过程中,如果想实现动画效果,可以粗略分为两种方式。一种是直接用代码编写,像平移、旋转等简单的动画效果,都可以这么干,如果稍微复杂点,就会对开发工程师的数学功底、图形图像学功底有很高的要求。 另一种方式,可以让UI同学配合,一次性出多张图片或者直接出一张GIF图,通过短时间内快速轮播图片的方式来实现复杂动画效果,这种方式真正实现起来还是有挺多问题的,比如缺少对动画过程的控制、图片尺寸的适配等等。那么,有没有更好的解决方案呢? 有的,Rive。 简介 Rive是专门为简化动画的实现而生的,设计师可以在其官网通过拖拉拽实现各种复杂动画效果,设计完毕后导出动画文件,工程师可以在App里直接导入此文件,配合相应的SDK即可实现。 其官网有详细的开发文档,同时也有自己的社区资源,我们可以直接从社区里下载别人设计好的动画效果进行学习。另外特别重要的是,Rive支持跨平台,同时支持Android、iOS、Flutter、JS、React、C++等等,本文以Flutter的实现为例介绍。 一个完整的例子 登陆Rive官网进行设计,并导出相应的动画文件,Rive的动画文件是以.riv结尾。 本文示例是从官网的社区里找的一个个人比较喜欢的动效。 依次运行下面的命令,引入rive sdk。 将导出的.riv文件放到资源目录下,并修改pubspec.yaml文件。 加载动画文件并展示的核心代码: 核心代码就这么多,对于代码中的标注详细说明下: 标注1的地方,主要作用是获取状态机控制器,fromArtboard 方法有两个参数,第二个参数是状态机的名称,这个名称需要和UI同学协商好,一旦确定好名称就不允许设计同学再改了,对应于设计面板界面的左下角,如下图: 标注2的地方,本例的动画是根据“数值”的变化而变化的,findInput的入参同样需要和UI同学协商好,一旦设计时把这个名字改了,代码里也别忘了进行相应的修改,也在设计面板的左下角,在状态机名称的右边,如下图: 完整的代码如下,大家可以按步骤自己操作体验下。 class RiveDemo extends StatefulWidget { const RiveDemo({Key? key}) : super(key: key); @override State<RiveDemo> createState() => _RiveDemoState(); } class _RiveDemoState extends State<RiveDemo> { /// 状态机控制器 StateMachineController? controller; /// 控制输入数值 SMIInput<double>? valueController; ///画板,配合Rive widget 使用,展示动画效果。 Artboard? riveArtboard; Timer? timer; @override void initState() { super.initState(); //加载 rootBundle.load('asset/rives/rive_demo.riv').then((value) async { final file = RiveFile.import(value); final artboard = file.mainArtboard; //1 controller = StateMachineController.fromArtboard(artboard, 'TreeMachine'); if (controller != null) { setState(() { artboard.addController(controller!); //2 valueController = controller!.findInput('input'); valueController!.value = -4; }); } riveArtboard = artboard; }); } @override void dispose() { controller?.dispose(); stopAnimation(); super.dispose(); } @override Widget build(BuildContext context) { return Scaffold( appBar: AppBar( title: const Text('Rive Demo'), ), backgroundColor: Colors.white, body: Center( child: riveArtboard == null ? const CircularProgressIndicator() : Rive(artboard: riveArtboard!), ), floatingActionButton: SizedBox( height: 50, child: Row( mainAxisAlignment: MainAxisAlignment.end, children: [ TextButton( onPressed: () { startAnimation(); }, child: const Text('start'), ), TextButton( onPressed: () { stopAnimation(); }, child: const Text('stop'), ), TextButton( onPressed: () { resetAnimation(); }, child: const Text('reset'), ), ], ), ), ); } /// 开始动画 void startAnimation() { if (timer != null) { return; } timer = Timer.periodic(const Duration(milliseconds: 60), (timer) { valueController?.value += 0.5; }); } /// 停止动画 void stopAnimation() { timer?.cancel(); timer = null; } /// 重置动画 void resetAnimation() { stopAnimation(); valueController?.value = 0; } } 总结 像本例中的动画效果,如果用代码来编写,时间成本会很大很大,如果靠图片的堆积,实现起来也很麻烦,而且由于图片的数量增多,安装包的体积也会增加很多。但是用rive,实现起来却很方便,可能唯一的成本就是设计师同学的学习成本。 Rive不仅支持本地动画文件的加载,还可以将动画文件放到服务器上,利用RiveAnimation.network方法进行加载。更多的使用示例可以参考:https://github.com/rive-app/rive-flutter/tree/master/example


资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册