首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

java安全编码指南之:基础篇

简介 作为一个程序员,只是写出好用的代码是不够的,我们还需要考虑到程序的安全性。在这个不能跟陌生人说话世界,扶老奶奶过马路都是一件很困难的事情。那么对于程序员来说,尤其是对于开发那种对外可以公开访问的网站的程序员,要承受的压力会大很多。 任何人都可以访问我们的系统,也就意味着如果我们的系统不够健壮,或者有些漏洞,恶意攻击者就会破门而入,将我们辛辛苦苦写的程序蹂躏的体无完肤。 所以,安全很重要,今天本文将会探讨一下java中的安全编码指南。 java平台本身的安全性 作为一个强类型语言,java平台本身已经尽可能的考虑到了安全性的,为我们屏蔽了大多数安全性的细节。 比如可以为不同级别权限的代码提供受限的执行环境。 java程序是类型安全的,并且在运行时提供了自动内存管理和数组边界检查,Java会尽可能的及早发现程序中的问题,从而使Java程序具有很高的抵抗堆栈破坏的能力。 尽管Java安全体系结构在许多情况下可以帮助保护用户和系统免受恶意代码或行为不当的攻击,但它无法防御可信任代码中发生的错误。也就说如果是用户本身代码的漏洞,java安全体系是无法进行判断的。 这些错误可能会绕过java本身的安全体系结构。在严重的情况下,可能会执行本地程序或禁用Java安全性。从而会被用来从计算机和Intranet窃取机密数据,滥用系统资源,阻止计算机的有用操作,协助进一步的攻击以及许多其他恶意活动。 所以,最大的安全在程序员本身,不管外部机制如何强大,如果核心的程序员出了问题,那么一切都将归于虚无。 接下来,我们看下java程序员应该遵循一些什么行为准则,来保证程序的安全性呢? 安全第一,不要写聪明的代码 我们可能会在很多教科书甚至是JDK的源代码中,看到很多让人惊叹的代码写法,如果你真的真的明白你在做什么,那么这样写没什么问题。但是很多情况下我们并不是很了解这样写的原理,甚至不知道这样写会出现什么样的问题。 并且现代系统是一个多人协作的过程,如果你写了这样的聪明代码,很有可能别人看不懂,最后导致未知的系统问题。 给大家举个例子: :(){:|:&};: 上面是一个shell下面的fork炸弹,如果你在shell下面运行上面的代码,几秒之后系统就会宕机或者运行出错。 怎么分析上面的代码呢?我们把代码展开: :() { :|:& }; : 还是不明白? 我们把:替换成函数名: fork() { fork|fork& }; fork 上面的代码就是无限的fork进程,通过几何级数的增长,最后导致程序崩溃。 java设计的很多大神把他们跳跃般的思想写到了JDK源代码里面,大神们的思想经过了千锤百炼,并且JDK是Java的核心,里面的代码再优化也不为过。 但是现在硬件技术的发展,代码级别的优化可能作用已经比较少了。为了避免出现不可知的安全问题,还是建议大家编写一眼就能看出逻辑的代码。虽然可能不是那么快,但是安全性有了保证。除非你真的知道你在做什么。 在代码设计之初就考虑安全性 安全性应该是一个在编写代码过程中非常重要的标准,我们在设计代码的时候就应该考虑到相关的安全性问题,否则后面重构起来会非常费事。 举个例子: public final class SensitiveClass { private final Behavior behavior; // Hide constructor. private SensitiveClass(Behavior behavior) { this.behavior = behavior; } // Guarded construction. public static SensitiveClass newSensitiveClass(Behavior behavior) { // ... validate any arguments ... // ... perform security checks ... return new SensitiveClass(behavior); } } 上面的例子中我们使用了final关键字来防止我们的某些关键类被继承扩展。因为没有扩展性,所以安全性判断会更加容易。 同时,java提供了SecurityManager和一系列的Permission类,通过合理的配置,我们可以有效的控制java程序的访问权限。 避免重复的代码 和重复代码相关的一个关键词就是重构。为什么会出现重复代码呢? 很简单,最开始我们在实现一个功能的时候写了一段代码逻辑。结果后面还有一个方法要使用这段代码逻辑。然后我们为了图方便,就把代码逻辑拷贝过去了。 看起来问题好像解决了。但是一旦这段业务逻辑要修改,那可就是非常麻烦的一件事情。因为我们需要找到程序中所有出现这段代码的地方,然后一个一个的修改。 为什么不把这段代码提取出来,做成一个单独的方法来供其他的方法调用呢?这样即使后面需要修改,也只用修改一处地方即可。 在现实的工作中,我们经常会遇到这种问题,尤其是那种年久失修的代码,大家都不敢修改,因为牵一发而动全身。往往是修改了这边忘记了那边,最后导致bug重重。 限制权限 JDK专门提供了一个SecurityManager类,来显示的对安全性进行控制,我们看下SecurityManager是怎么使用的: SecurityManager security = System.getSecurityManager(); if (security != null) { security.checkXXX(argument, ...); } SecurityManager提供了一系列的check方法,来对权限进行控制。 权限分为以下类别:文件、套接字、网络、安全性、运行时、属性、AWT、反射和可序列化。管理各种权限类别的类是 : java.io.FilePermission、 java.net.SocketPermission、 java.net.NetPermission、 java.security.SecurityPermission、 java.lang.RuntimePermission、 java.util.PropertyPermission、 java.awt.AWTPermission、 java.lang.reflect.ReflectPermission java.io.SerializablePermission JDK本身已经使用了很多这些权限控制的代码。比如说我们最常用的File: public boolean canRead() { SecurityManager security = System.getSecurityManager(); if (security != null) { security.checkRead(path); } if (isInvalid()) { return false; } return fs.checkAccess(this, FileSystem.ACCESS_READ); } 上面是File类的canRead方法,我们会首先去判断是否配置了SecurityManager,如果配置了,则去检查是否可以read。 如果我们在写代码中,遇到文件、套接字、网络、安全性、运行时、属性、AWT、反射和可序列化相关的操作时,也可以考虑使用SecurityManager来进行细粒度的权限控制。 构建可信边界 什么是可信边界呢?边界主要起拦截作用,边界里边的我们可以信任,边界外边的我们就不能信任了。 对于不能信任的外边界请求,我们需要进行足够的安全访问控制。 比如说web客户端来访问web服务器。web客户端是在全球各地的,各种环境都有,并且是不可控的,所以web客户端访问web服务器端的请求需要进行额外的安全控制。 而web服务器访问业务服务器又是不同的,因为web服务器是我们自己控制的,所以安全程度相对较高,我们需要针对不同的可信边界做不同的控制。 封装 封装(Encapsulation)是指一种将抽象性函式接口的实现细节部份包装、隐藏起来的方法。 封装可以被认为是一个保护屏障,防止该类的代码和数据被外部类定义的代码随机访问。通过对接口进行访问控制,可以严格的包含类中的数据和方法。 并且封装可以减少耦合,并且隐藏实现细节。 写文档 最后一项也是非常非常重要的一项就是写文档。为什么接别人的老项目那么痛苦,为什么读源代码那么困难。根本的原因就是没有写文档。 如果不写文档,可能你自己写的代码过一段时间之后也不知道为什么当时这样写了。 所以,写文档很重要。 本文已收录于 http://www.flydean.com/java-security-code-line-base/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

Hadoop hdfs 基础操作 client Api(1)

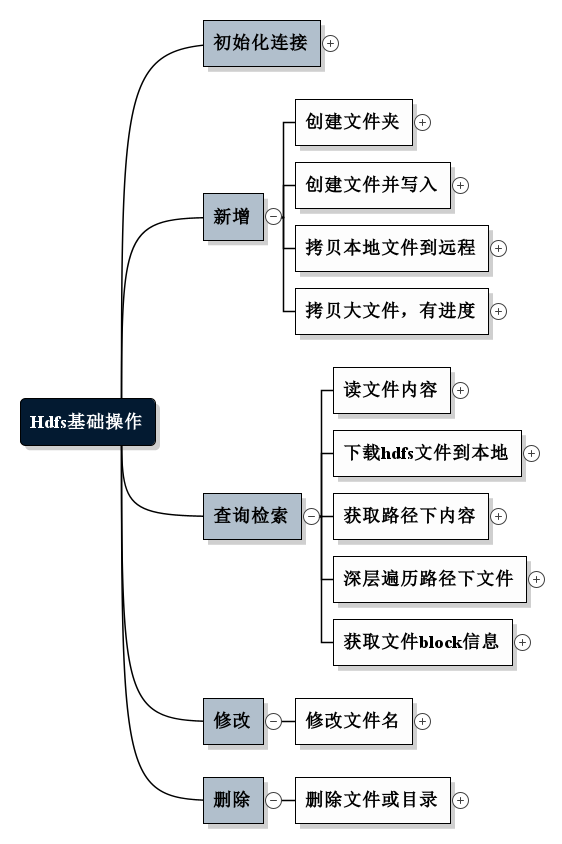
1. 初始化连接 @Before public void setup() throws Exception { configuration = new Configuration(); System.out.println(); configuration.set("dfs.replication", "1"); // configuration.set("hadoop.tmp.dir","/home/hadoop0/data/tmp"); Iterator iterator = configuration.iterator(); while(iterator.hasNext() ){ System.out.println(iterator.next()); //打印所有配置或默认参数 } fileSystem = FileSystem.get(new URI(HDFS_PATH), configuration, HDFS_USER); System.out.println("--------------setup-------------"); } @After public void teardown(){ try { fileSystem.close(); } catch (IOException e) { e.printStackTrace(); } configuration = null; System.out.println("--------------teardown-------------"); } 2. 新增 2.1 创建文件夹 @Test public void mkDir() throws Exception{ System.out.println(fileSystem.mkdirs(new Path("/Complete"))); } 2.2 创建文件并写入 @Test public void create() throws Exception{ FSDataOutputStream out = fileSystem.create(new Path("/HDFSApp/write/2.txt")); out.writeUTF("hello! first wirte to HDFS file!"); out.flush(); out.close(); } 2.3 拷贝本地文件到远程 @Test public void copyFromLocal() throws IOException { Path localFile = new Path("F:/校验大师_2.7.5.1632.zip"); Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); fileSystem.copyFromLocalFile(localFile, remoteFile); } 2.4 拷贝大文件,带进度条 @Test public void copyFromLocalLargeFile(){ String localFile = "F:/校验大师_2.7.5.1632.zip"; Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1633.zip"); InputStream in = null; FSDataOutputStream out = null; try { in = new BufferedInputStream(new FileInputStream(localFile)); out = fileSystem.create(remoteFile, new Progressable() { @Override public void progress() { System.out.println("!"); } }); } catch (IOException e) { e.printStackTrace(); System.out.println("创建输入输出流失败!"); } if(in != null && out != null){ try { IOUtils.copyBytes(in, out,2048, true); } catch (IOException e) { e.printStackTrace(); System.out.println("上传过程中失败!"); } } } 3. 查询检索 3.1 读文件内容 @Test public void text() throws Exception{ FSDataInputStream in = fileSystem.open(new Path("/output/part-r-00000")); IOUtils.copyBytes(in, System.out, 1024); } 3.2 下载hdfs文件到本地 @Test public void copyToLocal() throws IOException { Path localFile = new Path("F:/"); Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); fileSystem.copyToLocalFile(remoteFile, localFile); } 3.3 获取路径下内容 @Test public void listFiles() throws IOException { Path path = new Path("/HDFSApp/write"); FileStatus[] files = fileSystem.listStatus(path); for (FileStatus file:files) { String type = file.isDirectory() ? "文件夹" : "文件"; String permission = file.getPermission().toString(); short replication = file.getReplication(); String filePath = file.getPath().toString(); System.out.println(type + "\t" + permission + "\t" + replication + "\t" + filePath); } } 3.4 深层遍历路径下文件 @Test public void listFilesRecursive() throws IOException { Path path = new Path("/"); RemoteIterator<LocatedFileStatus> remoteIterator = fileSystem.listFiles(path, true); while(remoteIterator.hasNext()){ LocatedFileStatus file = remoteIterator.next(); String type = file.isDirectory() ? "文件夹" : "文件"; String permission = file.getPermission().toString(); short replication = file.getReplication(); String filePath = file.getPath().toString(); System.out.println(type + "\t" + permission + "\t" + replication + "\t" + filePath); } } 3.5 获取文件block信息 @Test public void getBlocksInfo() throws IOException { Path path = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); FileStatus fileStatus = fileSystem.getFileStatus(path); BlockLocation[] blockLocations = fileSystem.getFileBlockLocations(fileStatus, 0 , fileStatus.getLen()); for (BlockLocation block: blockLocations) { for (String name :block.getNames()) { System.out.println(name + ":" + block.getOffset() +"," + block.getLength()); } } } 4. 修改 4.1 修改文件名 @Test public void rename() throws IOException { Path oPath = new Path("/HDFSApp/write/0.txt"); Path nPath = new Path("/HDFSApp/write/3.txt"); boolean res = fileSystem.rename(oPath, nPath); System.out.println(res); } 5. 删除 5.1 删除文件或目录 public void delete() throws IOException { Path path = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); boolean res = fileSystem.delete(path, false); System.out.println(res); }

优秀的个人博客,低调大师

交易背书 - fabric交易并发的基础

Hyperledger Fabric和其他许多区块链的关键区别之一,就在于Fabric区块链的交易执行过程:Fabric交易需要首先通过节点的背书,然后再进行交易排序,最后才利用有序交易进行账本的更新。本文将介绍Hyperledger Fabric所采用的执行-排序-验证这一三步交易模型的工作原理,以及引入背书环节对Hyperledger Fabric区块链性能的有益作用。 Hyperledger Fabric相关开发教程: Java链码与应用开发详解 Node.js链码与应用开发详解 1、交易的生命周期:Hyperledger Fabric vs. 其他区块链 在其他区块链平台中,交易生命周期基本由如下环节构成: 排序:交易有序加入账本,然后扩散到所有节点 执行:交易在所有节点上按顺序依次执行并更新账本 为了让所有节点保持一致的状态,交易必须确定性执行,也就是说,无论何时何地,同样的交易必须产生同样的结果。这一要求对智能合约形成了很强的约束,也是智能合约通常需要使用领域特定语言(DSL)来开发的原因之一,因此使用像Java或Go这样的通用开发语言基本上无法保证确定性。 在Hyperledger Fabric中,交易的声明周期则有所不同: 执行:交易(通过智能合约)以任意顺序执行,甚至可以并行执行 排序:当足够数量的节点对交易结果达成一致,该交易就会 被加入账本并扩散给所有节点。 验证:每个节点验证并按顺序执行交易,从而更新账本 首先需要注意的一点是,交易的执行和对账本的实际更新被拆分为两个环节,这一拆分带来一些有益的作用: 所有节点都需要更新账本,因此所有节点都需要执行验证步骤。 但并不是所有的节点都需要执行智能合约。Hyperledger Fabric 使用背书策略来定义哪些节点需要执行交易。这意味着指定的 链码(智能合约)不必开放给所有的节点 —— 那些不在背书策略中 的节点不需要由访问链码的权限。 交易可以在被排序之前先执行。这是的节点可以并行执行交易, 从而提高系统的吞吐量 在Fabric的三步交易模型中,在交易被添加到账本之前,其链码 执行结果是显式达成一致的,其他区块链的两步交易模型使用 确定性的链码,本身就隐含了节点之间就智能合约的执行结果 达成一致。显式达成一致可以让Fabric使用非确定性的链码, 这也是为什么我们可以使用Go、Java和Node.js编写Fabric链码 的原因。 2、Hyperledger Fabric的交易背书策略 Hyperledger Fabric允许用户自己定义链码执行的策略。这些背书策略定义了在交易被加入账本之前,哪些节点需要就交易结果达成一致。Fabric提供了一个小型的DSL来定义背书策略。下面展示了一些背书策略样例: 节点A、B、C和F都需要对类型为T的交易进行背书 通道中的大部分节点必须对类型为U的交易进行背书 A、B、C、D、E、F、G中的至少3个节点必须对类型为V的交易进行背书 背书策略并不保证正确的链码安装在正确的节点上。然而,背书和安装链码的确存在类似的机制,我们将在后续教程中介绍这一点。 3、Hypereledger Fabric交易背书的实现机制 到目前为止,我们都是松散地使用交易(transaction)这一术语。在排序-执行模型中,链码执行和账本更新被合二为一 —— 交易。在Fabric中,这两个概念是分开的,因此交易本身也被拆分。 Fabric从交易提议(Transaction Proposal)开始。这是一个用来触发链码执行的数据包。交易提议被发送给用于背书的节点。背书节点执行链码,如果成功的话就生成一个实际的账本交易。背书节点签名建议并返回交易提议的响应,这是执行-排序-验证模型中的执行步骤。 一旦交易提议的创建者收到足够的可以满足背书策略的签名,它就可以将交易(以及签名)提交以便添加到账本中,这就是排序步骤。 4、结论 Hyperledger Fabric在区块链交易方面采取了一个新颖的思路,将智能合约的执行与账本的更新分开使它可以提高交易吞吐量,支持更细粒度的隐私控制,实现更灵活强大的智能合约。而这些特性得以实现的一个关键因素就是在交易加入账本之前进行显式地交易背书。 原文链接:Hyperledger Fabric交易背书的深入理解 - 汇智网

优秀的个人博客,低调大师

《吊打面试官》系列- Redis基础

你知道的越多,你不知道的越多 点赞再看,养成习惯 前言 Redis在互联网技术存储方面使用如此广泛,几乎所有的后端技术面试官都要在Redis的使用和原理方面对小伙伴们进行360°的刁难。作为一个在互联网公司面一次拿一次offer的面霸(请允许我使用一下夸张的修辞手法),打败了无数竞争对手,每次都只能看到无数落寞的身影失望的离开,略感愧疚,在一个寂寞难耐的夜晚,我痛定思痛,决定开始写吊打面试官系列,希望能帮助各位读者以后面试势如破竹,对面试官进行360°的反击,吊打问你的面试官,吊打一同面试的同僚(好像不太好),疯狂收割大厂offer! 面试开始 一个大腹便便,穿着格子衬衣的中年男子,拿着一个满是划痕的mac向你走来,看着快秃顶的头发,心想着肯定是尼玛顶级架构师吧!但是我们腹有诗书气自华,虚都不虚。 小伙子您好,看你简历上写了你项目里面用到了Redis,你们为啥用Redis? 心里忍不住暗骂,这叫啥问题,大家不都是用的这个嘛,但是你不能说出来。 认真回答道:帅气迷人的面试官您好,因为传统的关系型数据库如Mysql已经不能适用所有的场景了,比如秒杀的库存扣减,APP首页的访问流量高峰等等,都很容易把数据库打崩,所以引入了缓存中间件,目前市面上比较常用的缓存中间件有Redis 和 Memcached 不过中和考虑了他们的优缺点,最后选择了Redis。 至于更细节的对比朋友们记得查阅Redis 和 Memcached 的区别,比如两者的优缺点对比和各自的场景,后续我有时间也会写出来。 那小伙子,我再问你,Redis有哪些数据结构呀? 字符串String、字典Hash、列表List、集合Set、有序集合SortedSet。 这里我相信99%的读者都能回答上来Redis的5个基本数据类型。如果回答不出来的小伙伴我们就要加油补课哟,大家知道五种类型最适合的场景更好。 但是,如果你是Redis中高级用户,而且你要在这次面试中突出你和其他候选人的不同,还需要加上下面几种数据结构HyperLogLog、Geo、Pub/Sub。 如果你还想加分,那你说还玩过Redis Module,像BloomFilter,RedisSearch,Redis-ML,这个时候面试官得眼睛就开始发亮了,心想这个小伙子有点东西啊。 注:本人在面试回答到Redis相关的问题的时候,经常提到BloomFilter(布隆过滤器)这玩意的使用场景是真的多,而且用起来是真的香,原理也好理解,看一下文章就可以在面试官面前侃侃而谈了,不香么?下方传送门 ↓ 避免缓存击穿的利器之BloomFilter 如果有大量的key需要设置同一时间过期,一般需要注意什么? 如果大量的key过期时间设置的过于集中,到过期的那个时间点,redis可能会出现短暂的卡顿现象。严重的话会出现缓存雪崩,我们一般需要在时间上加一个随机值,使得过期时间分散一些。 电商首页经常会使用定时任务刷新缓存,可能大量的数据失效时间都十分集中,如果失效时间一样,又刚好在失效的时间点大量用户涌入,就有可能造成缓存雪崩 那你使用过Redis分布式锁么,它是什么回事? 先拿setnx来争抢锁,抢到之后,再用expire给锁加一个过期时间防止锁忘记了释放。 这时候对方会告诉你说你回答得不错,然后接着问如果在setnx之后执行expire之前进程意外crash或者要重启维护了,那会怎么样? 这时候你要给予惊讶的反馈:唉,是喔,这个锁就永远得不到释放了。紧接着你需要抓一抓自己得脑袋,故作思考片刻,好像接下来的结果是你主动思考出来的,然后回答:我记得set指令有非常复杂的参数,这个应该是可以同时把setnx和expire合成一条指令来用的! 对方这时会显露笑容,心里开始默念:嗯,这小子还不错,开始有点意思了。 假如Redis里面有1亿个key,其中有10w个key是以某个固定的已知的前缀开头的,如何将它们全部找出来? 使用keys指令可以扫出指定模式的key列表。 对方接着追问:如果这个redis正在给线上的业务提供服务,那使用keys指令会有什么问题? 这个时候你要回答redis关键的一个特性:redis的单线程的。keys指令会导致线程阻塞一段时间,线上服务会停顿,直到指令执行完毕,服务才能恢复。这个时候可以使用scan指令,scan指令可以无阻塞的提取出指定模式的key列表,但是会有一定的重复概率,在客户端做一次去重就可以了,但是整体所花费的时间会比直接用keys指令长。 不过,增量式迭代命令也不是没有缺点的: 举个例子, 使用 SMEMBERS 命令可以返回集合键当前包含的所有元素, 但是对于 SCAN 这类增量式迭代命令来说, 因为在对键进行增量式迭代的过程中, 键可能会被修改, 所以增量式迭代命令只能对被返回的元素提供有限的保证 。 使用过Redis做异步队列么,你是怎么用的? 一般使用list结构作为队列,rpush生产消息,lpop消费消息。当lpop没有消息的时候,要适当sleep一会再重试。 如果对方追问可不可以不用sleep呢? list还有个指令叫blpop,在没有消息的时候,它会阻塞住直到消息到来。 如果对方接着追问能不能生产一次消费多次呢? 使用pub/sub主题订阅者模式,可以实现 1:N 的消息队列。 如果对方继续追问 pub/su b有什么缺点? 在消费者下线的情况下,生产的消息会丢失,得使用专业的消息队列如RocketMQ等。 如果对方究极TM追问Redis如何实现延时队列? 这一套连招下来,我估计现在你很想把面试官一棒打死(面试官自己都想打死自己了怎么问了这么多自己都不知道的),如果你手上有一根棒球棍的话,但是你很克制。平复一下激动的内心,然后神态自若的回答道:使用sortedset,拿时间戳作为score,消息内容作为key调用zadd来生产消息,消费者用zrangebyscore指令获取N秒之前的数据轮询进行处理。 到这里,面试官暗地里已经对你竖起了大拇指。并且已经默默给了你A+,但是他不知道的是此刻你却竖起了中指,在椅子背后。 Redis是怎么持久化的?服务主从数据怎么交互的? RDB做镜像全量持久化,AOF做增量持久化。因为RDB会耗费较长时间,不够实时,在停机的时候会导致大量丢失数据,所以需要AOF来配合使用。在redis实例重启时,会使用RDB持久化文件重新构建内存,再使用AOF重放近期的操作指令来实现完整恢复重启之前的状态。 这里很好理解,把RDB理解为一整个表全量的数据,AOF理解为每次操作的日志就好了,服务器重启的时候先把表的数据全部搞进去,但是他可能不完整,你再回放一下日志,数据不就完整了嘛。不过Redis本身的机制是 AOF持久化开启且存在AOF文件时,优先加载AOF文件;AOF关闭或者AOF文件不存在时,加载RDB文件;加载AOF/RDB文件城后,Redis启动成功; AOF/RDB文件存在错误时,Redis启动失败并打印错误信息 对方追问那如果突然机器掉电会怎样? 取决于AOF日志sync属性的配置,如果不要求性能,在每条写指令时都sync一下磁盘,就不会丢失数据。但是在高性能的要求下每次都sync是不现实的,一般都使用定时sync,比如1s1次,这个时候最多就会丢失1s的数据。 对方追问RDB的原理是什么? 你给出两个词汇就可以了,fork和cow。fork是指redis通过创建子进程来进行RDB操作,cow指的是copy on write,子进程创建后,父子进程共享数据段,父进程继续提供读写服务,写脏的页面数据会逐渐和子进程分离开来。 注:回答这个问题的时候,如果你还能说出AOF和RDB的优缺点,我觉得我是面试官在这个问题上我会给你点赞,两者其实区别还是很大的,而且涉及到Redis集群的数据同步问题等等。想了解的伙伴也可以留言,我会专门写一篇来介绍的。 Pipeline有什么好处,为什么要用pipeline? 可以将多次IO往返的时间缩减为一次,前提是pipeline执行的指令之间没有因果相关性。使用redis-benchmark进行压测的时候可以发现影响redis的QPS峰值的一个重要因素是pipeline批次指令的数目。 Redis的同步机制了解么? Redis可以使用主从同步,从从同步。第一次同步时,主节点做一次bgsave,并同时将后续修改操作记录到内存buffer,待完成后将RDB文件全量同步到复制节点,复制节点接受完成后将RDB镜像加载到内存。加载完成后,再通知主节点将期间修改的操作记录同步到复制节点进行重放就完成了同步过程。后续的增量数据通过AOF日志同步即可,有点类似数据库的binlog。 是否使用过Redis集群,集群的高可用怎么保证,集群的原理是什么? Redis Sentinal着眼于高可用,在master宕机时会自动将slave提升为master,继续提供服务。 Redis Cluster着眼于扩展性,在单个redis内存不足时,使用Cluster进行分片存储。 面试结束 小伙子你可以的,什么时候有时间来上班啊,要不明天就来吧? 你强装镇定,这么急啊我还需要租房,要不下礼拜一吧。 好的 心想这小子这么NB是不是很多Offer在手上,不行我得叫hr给他加钱。 能撑到最后,你自己都忍不住自己给自己点个赞了(暗示点赞,每次都看了不点赞,你们想白嫖我么?你们好坏喲,不过我喜欢⁄(⁄ ⁄•⁄ω⁄•⁄ ⁄)⁄)。 总结 在技术面试的时候,不管是Redis还是什么问题,如果你能举出实际的例子,或者是直接说自己开发过程的问题和收获会给面试官的印象分会加很多,回答逻辑性也要强一点,不要东一点西一点,容易把自己都绕晕的。 还有一点就是我问你为啥用Redis你不要一上来就直接回答问题了,你可以这样回答: 帅气的面试官您好,首先我们的项目DB遇到了瓶颈,特别是秒杀和热点数据这样的场景DB基本上就扛不住了,那就需要缓存中间件的加入了,目前市面上有的缓存中间件有 Redis 和 Memcached ,他们的优缺点......,综合这些然后再结合我们项目特点,最后我们在技术选型的时候选了谁。 如果你这样有条不紊,有理有据的回答了我的问题而且还说出这么多我问题外的知识点,我会觉得你不只是一个会写代码的人,你逻辑清晰,你对技术选型,对中间件对项目都有自己的理解和思考,说白了就是你的offer有戏了。 好了 以上就是这篇文章的全部内容了,我后面会不断更新《吊打面试官》系列和Java技术栈相关的文章。如果你有什么想知道的,也可以留言给我,我一有时间就会写出来,我们共同进步。 非常感谢您能看到这里,如果这个文章写得还不错的话 求点赞 求关注 求分享 求留言 各位的支持和认可,就是我创作的最大动力,OK各位我们下期见! 敖丙 | 文 【原创】 后面会持续更新《吊打面试官》系列可以关注我的公众号第一时间阅读,也会有朋友一线大厂的内推机会不定期推出(字节跳动,阿里,网易,PDD,滴滴,蘑菇街等),就业上有什么问题也可以直接微信滴滴我,我也是个新人,不过不影响我们一起进步,作为渣男,我给不了你工作,还给不了你温暖嘛?

优秀的个人博客,低调大师

Linux基础命令---host域名查询工具

host host是一个常用的DNS查询工具,经常用来查询域名、检查域名解析是否正确。 此命令的适用范围:RedHat、RHEL、Ubuntu、CentOS、Fedora。 1、语法 host [选项] name [server] 2、选项列表 -a 查询所有的信息 -c 设置查询类型 -C 查询完整的SOA记录 -d | -v 显示详细过程 -l 列表模式 -t 选择查询类型:CNAME NS SOA SIG KEY AXFR -w 永久等待 -W 设置等待超时 3、实例1)查询域名 [root@localhost ~]# host www.baidu.com //查询域名信息,显示别名和ip www.baidu.com is an alias for www.a.shifen.com. www.a.shifen.com has address 111.13.100.91 www.a.shifen.com has address 111.13.100.92 2)查询所有信息 [root@localhost ~]# host -a www.baidu.com //查询域名的所有信息 Trying "www.baidu.com" ;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 51953 ;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 1, ADDITIONAL: 0 ;; QUESTION SECTION: ;www.baidu.com. IN ANY ;; ANSWER SECTION: www.baidu.com. 696 IN CNAME www.a.shifen.com. www.a.shifen.com. 22 IN A 111.13.100.91 www.a.shifen.com. 22 IN A 111.13.100.92 ;; AUTHORITY SECTION: a.shifen.com. 60 IN SOA ns1.a.shifen.com. baidu_dns_master.baidu.com. 1810060004 5 5 2592000 3600 Received 147 bytes from 172.20.10.1#53 in 10 ms 做了一个Linux学习的平台,目前出来一个雏形,各位可以参考使用 链接:https://pan.baidu.com/s/1GOLVU2CbpBNGtunztVpaCQ 密码:n7bk

优秀的个人博客,低调大师

Docker入门基础之容器使用

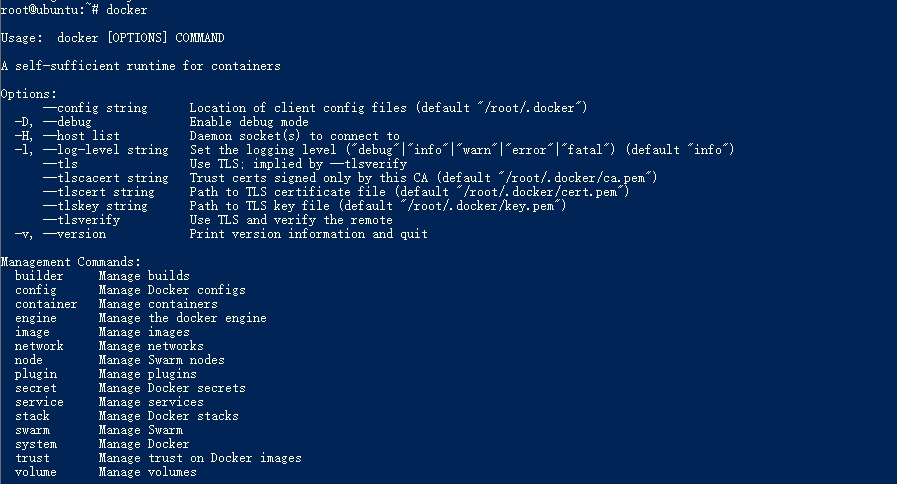
Docker简介 Docker 是一个开源的应用容器引擎,基于Go语言并遵从Apache2.0协议开源。 Docker 可以让开发者打包他们的应用以及依赖包到一个轻量级、可移植的容器中,然后发布到任何流行的 Linux 机器上,也可以实现虚拟化。 容器是完全使用沙箱机制,相互之间不会有任何接口(类似 iPhone 的 app),更重要的是容器性能开销极低。 Ubuntu Docker 安装 1、Docker官方安装方法 Docker 要求 Ubuntu 系统的内核版本高于 3.10 ,查看本页面的前提条件来验证你的 Ubuntu 版本是否支持 Docker。获取安装包: root@ubuntu:~# wget -qO- https://get.docker.com/ | sh 安装完成后有提示: If you would like to use Docker as a non-root user, you should now consider adding your user to the "docker" group with something like: ​ sudo usermod -aG docker runoob Remember that you will have to log out and back in for this to take effect! 启动docker服务 root@ubuntu:~# sudo service docker start 2、通过安装URLOS获得 URLOS基于Docker运行,安装了URLOS,就等于安装了Docker,我们可以使用URLOS官方安装命令: curl -LO www.urlos.com/iu && sh iu 或 curl -O https://www.urlos.com/install && chmod 544 install && ./install Docker容器使用Docker客户端Docker 客户端非常简单 ,可以直接输入 Docker 命令来查看到 Docker 客户端的所有命令选项。 root@ubuntu:~# docker 可以通过命令docker command --help更深入的了解指定的 Docker 命令使用方法。例如我们要查看docker stats指令的具体使用方法: root@ubuntu:~# docker stats --help 启动容器(交互模式)我们如果要使用版本为16.04的ubuntu系统镜像来运行容器时,命令如下: root@ubuntu:~# docker run -it ubuntu:16.04 sh 如果要使用版本为15.04的ubuntu系统镜像,则命令如下: root@ubuntu:~# docker run -it ubuntu:15.04 sh 各个参数解析: docker: Docker 的二进制执行文件。 run:与前面的 docker 组合来运行一个容器。 -it:其实是两个参数组成, -i 和 -t,-i:允许你对容器内的标准输入 (STDIN) 进行交互。-t:在新容器内指定一个伪终端或终端。 ubuntu:15.04:指定要运行的镜像,Docker首先从本地主机上查找镜像是否存在,如果不存在,Docker 就会从镜像仓库 Docker Hub 下载公共镜像。 sh:执行命令。 将上面的命令稍作修改,在结尾处加上一句命令,执行后: root@ubuntu:~# docker run -it ubuntu:16.04 sh -c "while true; do echo hello urlos; sleep 1; done" hello urlos hello urlos hello urlos hello urlos hello urlos hello urlos ^Croot@ubuntu:~# 我们可以看到终端上不断输出 hello urlos ,这时按键盘Ctrl+c来终止输出。启动容器(后台模式)我们将上面的命令再稍作修改,把 -it 替换为 -d 看看结果: root@ubuntu:~# docker run -d ubuntu:16.04 sh -c "while true; do echo hello urlos; sleep 1; done" 0cf141fd0745fb4dc104bec1a3238a1bd8dad7aa72926dea0a39ddc7ba54fe32 在输出中,我们没有看到期望的"hello world",而是一串长字符0cf141fd0745fb4dc104bec1a3238a1bd8dad7aa72926dea0a39ddc7ba54fe32 这个长字符串叫做容器ID,对每个容器来说都是唯一的,我们可以通过容器ID来查看对应的容器发生了什么。首先,我们需要确认容器有在运行,可以通过 docker ps 来查看: root@ubuntu:~# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 0cf141fd0745 ubuntu:16.04 "sh -c 'while true; …" 2 minutes ago Up 2 minutes hopeful_matsumoto 然后使用 docker logs [ID或者名字]命令,查看容器内的标准输出: root@ubuntu:~# docker logs hopeful_matsumoto hello urlos hello urlos hello urlos hello urlos hello urlos hello urlos hello urlos hello urlos 我们可以看到,在容器内部已经输出了非常多的hello urlos,这说明容器处于后台运行模式。 运行一个WEB应用容器现在我们将在docker容器中运行一个 nginx 应用来运行一个web应用。 首先从Docker Hub公共镜像源中拉取镜像: root@ubuntu:~# docker pull nginx 然后运行这个镜像: root@ubuntu:~# docker run -d -p 8080:80 nginx 参数说明: -d:让容器在后台运行。 -p:让宿主机的8080端口映射给容器内部的80端口。 查看WEB应用容器 使用 docker ps 来查看我们正在运行的容器: root@ubuntu:~# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES b394756b6c5d nginx "nginx -g 'daemon of…" 3 seconds ago Up 2 seconds 0.0.0.0:8080->80/tcp elastic_babbage 我们看到端口信息 0.0.0.0:8080->80/tcp,意思是宿主机的8080端口映射给容器内部的80端口。 这时我们可以通过浏览器访问WEB应用: 查看端口的快捷方法通过docker ps命令可以查看到容器的端口映射,docker还提供了另一个快捷方式 docker port,使用 docker port 可以查看指定 (ID 或者名字)容器的某个确定端口映射到宿主机的端口号。 上面我们创建的 web 应用容器 ID 为 b394756b6c5d 容器名为 elastic_babbage。 我可以使用 docker port b394756b6c5d 或 docker port elastic_babbage 来查看容器端口的映射情况。 root@ubuntu:~# docker port b394756b6c5d 80/tcp -> 0.0.0.0:8080 root@ubuntu:~# docker port affectionate_montalcini 80/tcp -> 0.0.0.0:8080 查看 WEB 应用程序日志使用docker logs [ID或者名字]可以查看容器内部的标准输出。 root@ubuntu:~# docker logs b394756b6c5d 192.168.43.131 - - [04/Jun/2019:06:28:42 +0000] "GET / HTTP/1.1" 200 612 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:67.0) Gecko/20100101 Firefox/67.0" "-" 2019/06/05 06:28:42 [error] 6#6: *1 open() "/usr/share/nginx/html/favicon.ico" failed (2: No such file or directory), client: 192.168.43.131, server: localhost, request: "GET /favicon.ico HTTP/1.1", host: "192.168.43.122:8080" 192.168.43.131 - - [04/Jun/2019:06:28:42 +0000] "GET /favicon.ico HTTP/1.1" 404 153 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:67.0) Gecko/20100101 Firefox/67.0" "-" 查看WEB应用程序容器的进程我们还可以使用 docker top 来查看容器内部运行的进程 root@ubuntu:~# docker top b394756b6c5d UID PID PPID C STIME TTY TIME CMD root 2069 2050 0 23:24 ? 00:00:00 nginx: master process nginx -g daemon off; systemd+ 2100 2069 0 23:24 ? 00:00:00 nginx: worker process 停止 WEB 应用容器使用 docker stop [ID或者名字] 命令停止容器 root@ubuntu:~# docker stop b394756b6c5d b394756b6c5d 启动 WEB 应用容器使用 docker start [ID或者名字] 命令启动已经停止的容器 root@ubuntu:~# docker start b394756b6c5d b394756b6c5d 重新启动WEB应用容器我们能还可以使用 docker restart [ID或者名字] 命令重新启动正在运行的容器 root@ubuntu:~# docker restart b394756b6c5d b394756b6c5d docker ps -l 查询最后一次创建的容器: root@ubuntu:~# docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES b394756b6c5d nginx "nginx -g 'daemon of…" 12 minutes ago Up 12 minutes 0.0.0.0:8080->80/tcp elastic_babbage 删除WEB应用容器我们可以使用 docker rm [ID或者名字] 命令来删除不需要的容器注意:删除容器时,容器必须是停止状态,否则会报如下错误: root@ubuntu:~# docker rm b394756b6c5d Error response from daemon: You cannot remove a running container b394756b6c5d95f1d43f11393c169cc73de40938d8f09db81077c8bce6e5881a. Stop the container before attempting removal or force remove 如果要删除正在运行的容器,这时我们只需要加入 -f 参数即可: root@ubuntu:~# docker rm -f b394756b6c5d b394756b6c5d

优秀的个人博客,低调大师

Python3入门(一)基础语法

Python 是一个高层次的结合了解释性、编译性、互动性和面向对象的脚本语言。Python 的设计具有很强的可读性,相比其他语言经常使用英文关键字,其他语言的一些标点符号,它具有比其他语言更有特色语法结构 Python 是一种解释型语言: 这意味着开发过程中没有了编译这个环节。类似于PHP和Perl语言 Python 是交互式语言: 这意味着,您可以在一个 Python 提示符 >>> 后直接执行代码 Python 是面向对象语言: 这意味着Python支持面向对象的风格或代码封装在对象的编程技术 Python 是初学者的语言:Python 对初级程序员而言,是一种伟大的语言,它支持广泛的应用程序开发,从简单的文字处理到 WWW 浏览器再到游戏。 接下来一段时间我将和大家一起学习python,现在开始吧 一、Python标识符 在Python里,标识符由字母、数字、下划线组成。 在Python中,所有标识符可以包括英文、数字、以及下划线(_),但不能以数字开头。 Python中标识符是区分大小写的。 以下划线开头的标识符是有特殊意义的。以单下划线开头_foo的代表不能直接访问的类属性,需要通过类提供的接口进行访问,不能用from xxx或者import * 导入。以双下划线开头的__foo代表类的si'you'che'g私有成员,以双下划线开头和结尾的__foo__代表Python里特殊方法专用的表示,如__init__()代表类的构造函数。 二、Python保留字符 and exec not assert finally or break for pass class from print continue global raise def if return del import try elif in while else is with except lambda yield 三、行和缩进 Python和其他语言最大的区别就是,Python的代码块不使用大括号{}来控制类,函数以及其他逻辑判断,Python最具特色的就是用缩进来写模块。缩进的空白数量是可变的,但是所有代码块语句必须包含相同的缩进空白数量,必须严格执行,比如 if True: print("hello") else: print("no hello") 以下代码会执行错误,提示格式不对 if True: print("hello") else: print("no hello") print("error") 四、多行语句 Python中一般以新的一行作为语句的结束符,但是我们可以使用斜杠\将一行的语句分为多行显示,如下: a = "a" + "b" + "c" + \ "d" + \ "e" print(a) # 输出结果为abcde 语句中包含[]、{}或者()就不用使用多行连接符,如下 days = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday'] print(days) # 输出['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday'] 五、Python引号 python可以用单引号'、双引号"、三引号"'或"""来表示字符串,其中三引号可以由多行组成,编写多行文本的快捷语法,常用于文档字符串,在文件的特定地点,被当作注释。 word = 'word' sentence = '这是句子' paragraph = """这是一个段落。 包含了多个语句""" 六、Python注释 Python中单行注释采用#开头 # 第一个注释 print('hello') 多行注释采用三个单引号或者三个双引号 ''' 这是多行注释 这是多行注释 ''' 七、Python空行 函数之间或类的方法之间用空行分隔,表示一段新的代码的开始。类和函数入口之间也用一行空行分隔,以突出函数入口的开始。空行与代码缩进不同,空行并不是Python语法的一部分。书写时不插入空行,Python解释器运行也不会出错。但是空行的作用在于分隔两段不同功能或含义的代码,便于日后代码的维护或重构。记住:空行也是程序代码的一部分 八、等待用户输入 下面程序将等待用户输入,按下回车键退出 name = input("Please input your name: ") print("Hello "+name) 八、一行显示多条语句 Python中可以在同一行中使用多条语句,语句直接用;分隔,但是个人不建议这么写,感觉不美观 name = input("Please input your name: "); a = "nihao" print("Hello " + name+", a = "+a) 九、输出语句 Python中通过print输出,这样是换行的,如果不想换行,可以使用逗号 a = "nihao" b = "hello" print(name, a) 本文到此结束啦,如果发现内容有误欢迎指正哦,也希望大家持续关注哦!!!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册