深入理解 WKWebView (渲染篇) —— DOM 树的构建
全文12003字,预计阅读时间24分钟 当客户端 App 主进程创建 WKWebView 对象时,会创建另外两个子进程:渲染进程与网络进程。主进程 WKWebView 发起请求时,先将请求转发给渲染进程,渲染进程再转发给网络进程,网络进程请求服务器。如果请求的是一个网页,网络进程会将服务器的响应数据 HTML 文件字符流吐给渲染进程。渲染进程拿到 HTML 文件字符流,首先要进行解析,将 HTML 文件字符流转换成 DOM 树,然后在 DOM 树的基础上,进行渲染操作,也就是布局、绘制。最后渲染进程通知主进程 WKWebView 创建对应的 View 展现视图。整个流程如下图所示: 一、什么是DOM树 渲染进程获取到 HTML 文件字符流,会将HTML文件字符流转换成 DOM 树。下图中左侧是一个 HTML 文件,右边就是转换而成的 DOM 树。 可以看到 DOM 树的根节点是 HTMLDocument,代表整个文档。根节点下面的子节点与 HTML 文件中的标签是一一对应的,比如 HTML 中的 <head> 标签就对应 DOM 树中的 head 节点。同时 HTML 文件中的文本,也成为 DOM 树中的一个节点,比如文本 'Hello, World!',在 DOM 树中就成为div节点的子节点。 在 DOM 树中每一个节点都是具有一定方法与属性的对象,这些对象由对应的类创建出来。比如 HTMLDocument 节点,它对应的类是 class HTMLDocument,下面是 HTMLDocument 的部分源码: class HTMLDocument : public Document { // 继承自 Document ... WEBCORE_EXPORT int width(); WEBCORE_EXPORT int height(); ... } 从源码中可以看到,HTMLDocument 继承自类 Document,Document 类的部分源码如下: class Document : public ContainerNode // Document继承自 ContainerNode,ContainerNode继承自Node , public TreeScope , public ScriptExecutionContext , public FontSelectorClient , public FrameDestructionObserver , public Supplementable<Document> , public Logger::Observer , public CanvasObserver { WEBCORE_EXPORT ExceptionOr<Ref<Element>> createElementForBindings(const AtomString& tagName); // 创建Element的方法 WEBCORE_EXPORT Ref<Text> createTextNode(const String& data); // 创建文本节点的方法 WEBCORE_EXPORT Ref<Comment> createComment(const String& data); // 创建注释的方法 WEBCORE_EXPORT Ref<Element> createElement(const QualifiedName&, bool createdByParser); // 创建Element方法 .... } 上面源码可以看到 Document 继承自 Node,而且还可以看到前端十分熟悉的 createElement、createTextNode 等方法,JavaScript 对这些方法的调用,最后都转换为对应 C++ 方法的调用。 类 Document 有这些方法,并不是没有原因的,而是 W3C 组织给出的标准规定的,这个标准就是 DOM(DocumentObjectModel,文档对象模型)。DOM 定义了 DOM 树中每个节点需要实现的接口和属性,下面是 HTMLDocument、Document、HTMLDivElement 的部分 IDL(InteractiveDataLanguage,接口描述语言,与具体平台和语言无关)描述,完整的 IDL 可以参看 W3C 。 在 DOM 树中,每一个节点都继承自类 Node,同时 Node 还有一个子类 Element,有的节点直接继承自类 Node,比如文本节点,而有的节点继承自类 Element,比如 div 节点。因此针对上面图中的 DOM 树,执行下面的 JavaScript 语句返回的结果是不一样的: document.childNodes; // 返回子Node集合,返回DocumentType与HTML节点,都继承自Node document.children; // 返回子Element集合,只返回HTML节点,DocumentType不继承自Element 下图给出部分节点的继承关系图: 二、DOM树构建 DOM 树的构建流程可以分为4个步骤:解码、分词、创建节点、添加节点。 2.1 解码 渲染进程从网络进程接收过来的是 HTML 字节流,而下一步分词是以字符为单位进行的。由于各种编码规范的存在,比如 ISO-8859-1、UTF-8 等,一个字符常常可能对应一个或者多个编码后的字节,解码的目的就是将 HTML 字节流转换成 HTML 字符流,或者换句话说,就是将原始的 HTML 字节流转换成字符串。 2.1.1 解码类图 从类图上看,类 HTMLDocumentParser 处于解码的核心位置,由这个类调用解码器将 HTML 字节流解码成字符流,存储到类 HTMLInputStream 中。 2.1.2 解码流程 整个解码流程当中,最关健的是如何找到正确的编码方式。只有找到了正确的编码方式,才能使用对应的解码器进行解码。解码发生的地方如下面源代码所示,这个方法在上图第3个栈帧被调用: // HTMLDocumentParser是DecodedDataDocumentParser的子类 void DecodedDataDocumentParser::appendBytes(DocumentWriter& writer, const uint8_t* data, size_t length) { if (!length) return; String decoded = writer.decoder().decode(data, length); // 真正解码发生在这里 if (decoded.isEmpty()) return; writer.reportDataReceived(); append(decoded.releaseImpl()); } 上面代码第7行 writer.decoder() 返回一个 TextResourceDecoder 对象,解码操作由 TextResourceDecoder::decode 方法完成。下面逐步查看 TextResourceDecoder::decode 方法的源码: // 只保留了最重要的部分 StringTextResourceDecoder::decode(constchar*data,size_tlength) { ... //如果是HTML文件,就从head标签中寻找字符集 if((m_contentType==HTML||m_contentType==XML)&&!m_checkedForHeadCharset)//HTMLandXML if(!checkForHeadCharset(data,length,movedDataToBuffer)) returnemptyString(); ... //m_encoding存储者从HTML文件中找到的编码名称 if(!m_codec) m_codec=newTextCodec(m_encoding);//创建具体的编码器 ... //解码并返回 Stringresult=m_codec->decode(m_buffer.data()+lengthOfBOM,m_buffer.size()-lengthOfBOM,false,m_contentType==XML&&!m_useLenientXMLDecoding,m_sawError); m_buffer.clear();//清空存储的原始未解码的HTML字节流 returnresult; } 从源码中可以看到,TextResourceDecoder 首先从 HTML 的 <head> 标签中去找编码方式,因为 <head> 标签可以包含 <meta> 标签,<meta> 标签可以设置 HTML 文件的字符集: <head> <meta http-equiv="Content-Type" content="text/html; charset=utf-8" /> <!-- 字符集指定--> <title>DOM Tree</title> <script>window.name = 'Lucy';</script> </head> 如果能找到对应的字符集,TextResourceDeocder 将其存储在成员变量 m_encoding 当中,并且根据对应的编码创建真正的解码器存储在成员变量 m_codec 中,最终使用 m_codec 对字节流进行解码,并且返回解码后的字符串。如果带有字符集的 <meta> 标签没有找到,TextResourceDeocder 的 m_encoding 有默认值 windows-1252(等同于ISO-8859-1)。 下面看一下 TextResourceDecoder 寻找 <meta> 标签中字符集的流程,也就是上面源码中第8行对 checkForHeadCharset 函数的调用: // 只保留了关健代码 bool TextResourceDecoder::checkForHeadCharset(const char* data, size_t len, bool& movedDataToBuffer) { ... // This is not completely efficient, since the function might go // through the HTML head several times. size_t oldSize = m_buffer.size(); m_buffer.grow(oldSize + len); memcpy(m_buffer.data() + oldSize, data, len); // 将字节流数据拷贝到自己的缓存m_buffer里面 movedDataToBuffer = true; // Continue with checking for an HTML meta tag if we were already doing so. if (m_charsetParser) return checkForMetaCharset(data, len); // 如果已经存在了meta标签解析器,直接开始解析 .... m_charsetParser = makeUnique<HTMLMetaCharsetParser>(); // 创建meta标签解析器 return checkForMetaCharset(data, len); } 上面源代码中第11行,类 TextResourceDecoder 内部存储了需要解码的 HTML 字节流,这一步骤很重要,后面会讲到。先看第17行、21行、22行,这3行主要是使用<meta>标签解析器解析字符集,使用了懒加载的方式。下面看下 checkForMetaCharset 这个函数的实现: bool TextResourceDecoder::checkForMetaCharset(const char* data, size_t length) { if (!m_charsetParser->checkForMetaCharset(data, length)) // 解析meta标签字符集 return false; setEncoding(m_charsetParser->encoding(), EncodingFromMetaTag); // 找到后设置字符编码名称 m_charsetParser = nullptr; m_checkedForHeadCharset = true; return true; } 上面源码第3行可以看到,整个解析 <meta> 标签的任务在类 HTMLMetaCharsetParser::checkForMetaCharset 中完成。 // 只保留了关健代码 bool HTMLMetaCharsetParser::checkForMetaCharset(const char* data, size_t length) { if (m_doneChecking) // 标志位,避免重复解析 return true; // We still don't have an encoding, and are in the head. //Thefollowingtagsareallowedin<head>: // SCRIPT|STYLE|META|LINK|OBJECT|TITLE|BASE // // We stop scanning when a tag that is not permitted in <head> // is seen, rather when </head> is seen, because that more closely // matches behavior in other browsers; more details in // <http://bugs.webkit.org/show_bug.cgi?id=3590>. // // Additionally, we ignore things that looks like tags in <title>, <script> // and <noscript>; see <http://bugs.webkit.org/show_bug.cgi?id=4560>, // <http://bugs.webkit.org/show_bug.cgi?id=12165> and // <http://bugs.webkit.org/show_bug.cgi?id=12389>. // // Since many sites have charset declarations after <body> or other tags // that are disallowed in <head>, we don't bail out until we've checked at // least bytesToCheckUnconditionally bytes of input. constexpr int bytesToCheckUnconditionally = 1024; // 如果解析了1024个字符还未找到带有字符集的<meta>标签,整个解析也算完成,此时没有解析到正确的字符集,就使用默认编码windows-1252(等同于ISO-8859-1) bool ignoredSawErrorFlag; m_input.append(m_codec->decode(data,length,false,false,ignoredSawErrorFlag));//对字节流进行解码 while (auto token = m_tokenizer.nextToken(m_input)) { // m_tokenizer进行分词操作,找meta标签也需要进行分词,分词操作后面讲 bool isEnd = token->type() == HTMLToken::EndTag; if (isEnd || token->type() == HTMLToken::StartTag) { AtomString tagName(token->name()); if (!isEnd) { m_tokenizer.updateStateFor(tagName); if (tagName == metaTag && processMeta(*token)) { // 找到meta标签进行处理 m_doneChecking = true; return true; // 如果找到了带有编码的meta标签,直接返回 } } if(tagName!=scriptTag&&tagName!=noscriptTag && tagName != styleTag && tagName != linkTag && tagName != metaTag && tagName != objectTag && tagName != titleTag && tagName != baseTag && (isEnd || tagName != htmlTag) && (isEnd || tagName != headTag)) { m_inHeadSection = false; } } if (!m_inHeadSection && m_input.numberOfCharactersConsumed() >= bytesToCheckUnconditionally) { // 如果分词已经进入了<body>标签范围,同时分词数量已经超过了1024,也算成功 m_doneChecking = true; return true; } } return false; } 上面源码第29行,类 HTMLMetaCharsetParser 也有一个解码器 m_codec,解码器是在 HTMLMetaCharsetParser 对象创建时生成,这个解码器的真实类型是 TextCodecLatin1(Latin1编码也就是ISO-8859-1,等同于windows-1252编码)。之所以可以直接使用 TextCodecLatin1 解码器,是因为 <meta> 标签如果设置正确,都是英文字符,完全可以使用 TextCodecLatin1 进行解析出来。这样就避免了为了找到 <meta> 标签,需要对字节流进行解码,而要解码就必须要找到 <meta> 标签这种鸡生蛋、蛋生鸡的问题。 代码第37行对找到的 <meta> 标签进行处理,这个函数比较简单,主要是解析 <meta> 标签当中的属性,然后查看这些属性名中有没有 charset。 bool HTMLMetaCharsetParser::processMeta(HTMLToken& token) { AttributeList attributes; for (auto& attribute : token.attributes()) { // 获取meta标签属性 String attributeName = StringImpl::create8BitIfPossible(attribute.name); String attributeValue = StringImpl::create8BitIfPossible(attribute.value); attributes.append(std::make_pair(attributeName, attributeValue)); } m_encoding = encodingFromMetaAttributes(attributes); // 从属性中找字符集设置属性charset return m_encoding.isValid(); } 上面分析 TextResourceDecoder::checkForHeadCharset 函数时,讲过第11行 TextResourceDecoder 类存储 HTML 字节流的操作很重要。原因是可能整个 HTML 字节流里面可能确实没有设置 charset 的 <meta> 标签,此时 TextResourceDecoder::checkForHeadCharset 函数就要返回 false,导致 TextResourceDecoder::decode 函数返回空字符串,也就是不进行任何解码。是不是这样呢?真实的情况是,在接收HTML字节流整个过程中由于确实没有找到带有 charset 属性的 <meta> 标签,那么整个接收期间都不会解码。但是完整的 HTML 字节流会被存储在 TextResourceDecoder 的成员变量 m_buffer 里面,当整个 HTML 字节流接收结束的时,会有如下调用栈: 从调用栈可以看到,当 HTML 字节流接收完成,最终会调用 TextResourceDecoder::flush 方法,这个方法会将 TextResourceDecoder 中有 m_buffer 存储的 HTML 字节流进行解码,由于在接收 HTML 字节流期间未成功找到编码方式,因此 m_buffer 里面存储的就是所有待解码的 HTML 字节流,然后在这里使用默认的编码 windows-1252 对全部字节流进行解码。因此,如果 HTML 字节流中包含汉字,那么如果不指定字符集,最终页面就会出现乱码。解码完成后,会将解码之后的字符流存储到 HTMLDocumentParser 中。 void DecodedDataDocumentParser::flush(DocumentWriter& writer) { String remainingData = writer.decoder().flush(); if (remainingData.isEmpty()) return; writer.reportDataReceived(); append(remainingData.releaseImpl()); // 解码后的字符流存储到HTMLDocumentParser } 2.1.3 解码总结 整个解码过程可以分为两种情形: 第一种情形是 HTML 字节流可以解析出带有 charset 属性的 <meta> 标签,这样就可以获取相应的编码方式,那么每接收到一个 HML 字节流,都可以使用相应的编码方式进行解码,将解码后的字符流添加到 HTMLInputStream 当中;第二种是 HTML 字节流不能解析带有 charset 属性的 <meta> 标签,这样每接收到一个 HTML 字节流,都缓存到 TextResourceDecoder 的 m_buffer 缓存,等完整的 HTML 字节流接收完毕,就会使用默认的编码 windows-1252 进行解码。 2.2 分词 接收到的 HTML 字节流经过解码,成为存储在 HTMLInputStream 中的字符流。分词的过程就是从 HTMLInputStream 中依次取出每一个字符,然后判断字符是否是特殊的 HTML 字符' <'、'/'、'>'、'=' 等。根据这些特殊字符的分割,就能解析出 HTML 标签名以及属性列表,类 HTMLToken 就是存储分词出来的结果。 2.2.1 分词类图 从类图中可以看到,分词最重要的是类 HTMLTokenizer 和类 HTMLToken。下面是类 HTMLToken 的主要信息: // 只保留了主要信息 classHTMLToken{ public: enumType{//Token的类型 Uninitialized,//Token初始化时的类型 DOCTYPE,//代表Token是DOCType标签 StartTag,//代表Token是一个开始标签 EndTag,//代表Token是一个结束标签 Comment,//代表Token是一个注释 Character,//代表Token是文本 EndOfFile,//代表Token是文件结尾 }; structAttribute{//存储属性的数据结构 Vector<UChar,32>name;//属性名 Vector<UChar,64>value;//属性值 //UsedbyHTMLSourceTracker. unsignedstartOffset; unsignedendOffset; }; typedefVector<Attribute,10>AttributeList;//属性列表 typedefVector<UChar,256>DataVector;//存储Token名 ... private: Typem_type; DataVectorm_data; //ForStartTagandEndTag boolm_selfClosing;//Token是注入<img>一样自结束标签 AttributeListm_attributes; Attribute*m_currentAttribute;//当前正在解析的属性 }; 2.2.2 分词流程 上面分词流程中 HTMLDocumentParser::pumpTokenizerLoop 方法是最重要的,从方法名字可以看出这个方法里面包含循环逻辑: // 只保留关健代码 bool HTMLDocumentParser::pumpTokenizerLoop(SynchronousMode mode, bool parsingFragment, PumpSession& session) { do { // 分词循环体开始 ... if (UNLIKELY(mode == AllowYield && m_parserScheduler->shouldYieldBeforeToken(session))) // 避免长时间处于分词循环中,这里根据条件暂时退出循环 return true; if (!parsingFragment) m_sourceTracker.startToken(m_input.current(), m_tokenizer); auto token = m_tokenizer.nextToken(m_input.current()); // 进行分词操作,取出一个token if (!token) return false; // 分词没有产生token,就跳出循环 if (!parsingFragment) m_sourceTracker.endToken(m_input.current(), m_tokenizer); constructTreeFromHTMLToken(token); // 根据token构建DOM树 } while (!isStopped()); return false; } 上面代码中第7行会有一个 yield 退出操作,这是为了避免长时间处于分词循环,占用主线程。当退出条件为真时,会从分词循环中返回,返回值为 true。下面是退出判断代码: // 只保留关健代码 bool HTMLParserScheduler::shouldYieldBeforeToken(PumpSession& session) { ... // numberOfTokensBeforeCheckingForYield是静态变量,定义为4096 // session.processedTokensOnLastCheck表示从上一次退出为止,以及处理过的token个数 // session.didSeeScript表示在分词过程中是否出现过script标签 if (UNLIKELY(session.processedTokens > session.processedTokensOnLastCheck + numberOfTokensBeforeCheckingForYield || session.didSeeScript)) return checkForYield(session); ++session.processedTokens; return false; } bool HTMLParserScheduler::checkForYield(PumpSession& session) { session.processedTokensOnLastCheck = session.processedTokens; session.didSeeScript = false; Seconds elapsedTime = MonotonicTime::now() - session.startTime; return elapsedTime > m_parserTimeLimit; // m_parserTimeLimit的值默认是500ms,从分词开始超过500ms就要先yield } 如果命中了上面的 yield 退出条件,那么什么时候再次进入分词呢?下面的代码展示了再次进入分词的过程: // 保留关键代码 void HTMLDocumentParser::pumpTokenizer(SynchronousMode mode) { ... if (shouldResume) // 从pumpTokenizerLoop中yield退出时返回值为true m_parserScheduler->scheduleForResume(); } void HTMLParserScheduler::scheduleForResume() { ASSERT(!m_suspended); m_continueNextChunkTimer.startOneShot(0_s); // 触发timer(0s后触发),触发后的响应函数为HTMLParserScheduler::continueNextChunkTimerFired } // 保留关健代码 void HTMLParserScheduler::continueNextChunkTimerFired() { ... m_parser.resumeParsingAfterYield(); // 重新Resume分词过程 } void HTMLDocumentParser::resumeParsingAfterYield() { // pumpTokenizer can cause this parser to be detached from the Document, // but we need to ensure it isn't deleted yet. Ref<HTMLDocumentParser> protectedThis(*this); // We should never be here unless we can pump immediately. // Call pumpTokenizer() directly so that ASSERTS will fire if we're wrong. pumpTokenizer(AllowYield); // 重新进入分词过程,该函数会调用pumpTokenizerLoop endIfDelayed(); } 从上面代码可以看出,再次进入分词过程是通过触发一个 Timer 来实现的,虽然这个 Timer 在0s后触发,但是并不意味着 Timer 的响应函数会立刻执行。如果在此之前主线程已经有其他任务到达了执行时机,会有被执行的机会。 继续看 HTMLDocumentParser::pumpTokenizerLoop 函数的第13行,这一行进行分词操作,从解码后的字符流中分出一个 token。实现分词的代码位于 HTMLTokenizer::processToken: // 只保留关键代码 bool HTMLTokenizer::processToken(SegmentedString& source) { ... if (!m_preprocessor.peek(source, isNullCharacterSkippingState(m_state))) // 取出source内部指向的字符,赋给m_nextInputCharacter return haveBufferedCharacterToken(); UChar character = m_preprocessor.nextInputCharacter(); // 获取character // https://html.spec.whatwg.org/#tokenization switch (m_state) { // 进行状态转换,m_state初始值为DataState ... } return false; } 这个方法由于内部要做很多状态转换,总共有1200多行,后面会有4个例子来解释状态转换的逻辑。 首先来看 InputStreamPreprocessor::peek 方法: // Returns whether we succeeded in peeking at the next character. // The only way we can fail to peek is if there are no more // characters in |source| (after collapsing \r\n, etc). ALWAYS_INLINE bool InputStreamPreprocessor::peek(SegmentedString& source, bool skipNullCharacters = false) { if (UNLIKELY(source.isEmpty())) return false; m_nextInputCharacter = source.currentCharacter(); // 获取字符流source内部指向的当前字符 // Every branch in this function is expensive, so we have a // fast-reject branch for characters that don't require special // handling. Please run the parser benchmark whenever you touch // this function. It's very hot. constexpr UChar specialCharacterMask = '\n' | '\r' | '\0'; if (LIKELY(m_nextInputCharacter & ~specialCharacterMask)) { m_skipNextNewLine = false; return true; } return processNextInputCharacter(source, skipNullCharacters); // 跳过空字符,将\r\n换行符合并成\n } bool InputStreamPreprocessor::processNextInputCharacter(SegmentedString& source, bool skipNullCharacters) { ProcessAgain: ASSERT(m_nextInputCharacter == source.currentCharacter()); // 针对\r\n换行符,下面if语句处理\r字符并且设置m_skipNextNewLine=true,后面处理\n就直接忽略 if (m_nextInputCharacter == '\n' && m_skipNextNewLine) { m_skipNextNewLine = false; source.advancePastNewline(); // 向前移动字符 if (source.isEmpty()) return false; m_nextInputCharacter = source.currentCharacter(); } // 如果是\r\n连续的换行符,那么第一次遇到\r字符,将\r字符替换成\n字符,同时设置标志m_skipNextNewLine=true if (m_nextInputCharacter == '\r') { m_nextInputCharacter = '\n'; m_skipNextNewLine = true; return true; } m_skipNextNewLine = false; if (m_nextInputCharacter || isAtEndOfFile(source)) return true; // 跳过空字符 if (skipNullCharacters && !m_tokenizer.neverSkipNullCharacters()) { source.advancePastNonNewline(); if (source.isEmpty()) return false; m_nextInputCharacter = source.currentCharacter(); goto ProcessAgain; // 跳转到开头 } m_nextInputCharacter = replacementCharacter; return true; } 由于 peek 方法会跳过空字符,同时合并 \r\n 字符为 \n 字符,所以一个字符流 source 如果包含了空格或者 \r\n 换行符,实际上处理起来如下图所示: HTMLTokenizer::processToken 内部定义了一个状态机,下面以四种情形来进行解释。 Case1:标签 BEGIN_STATE(DataState) // 刚开始解析是DataState状态if (character == '&') ADVANCE_PAST_NON_NEWLINE_TO(CharacterReferenceInDataState);if (character == '<') {// 整个字符流一开始是'<',那么表示是一个标签的开始if (haveBufferedCharacterToken()) RETURN_IN_CURRENT_STATE(true); ADVANCE_PAST_NON_NEWLINE_TO(TagOpenState); // 跳转到TagOpenState状态,并取去下一个字符是'!" }if (character == kEndOfFileMarker)return emitEndOfFile(source); bufferCharacter(character); ADVANCE_TO(DataState);END_STATE()// ADVANCE_PAST_NON_NEWLINE_TO定义#define ADVANCE_PAST_NON_NEWLINE_TO(newState) \do { \if (!m_preprocessor.advancePastNonNewline(source, isNullCharacterSkippingState(newState))) { \ // 如果往下移动取不到下一个字符 m_state = newState; \ // 保存状态return haveBufferedCharacterToken(); \ // 返回 } \ character = m_preprocessor.nextInputCharacter(); \ // 先取出下一个字符 goto newState; \ // 跳转到指定状态 } while (false)BEGIN_STATE(TagOpenState)if (character == '!') // 满足此条件 ADVANCE_PAST_NON_NEWLINE_TO(MarkupDeclarationOpenState); // 同理,跳转到MarkupDeclarationOpenState状态,并且取出下一个字符'D'if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(EndTagOpenState);if (isASCIIAlpha(character)) { m_token.beginStartTag(convertASCIIAlphaToLower(character)); ADVANCE_PAST_NON_NEWLINE_TO(TagNameState); }if (character == '?') { parseError();// The spec consumes the current character before switching// to the bogus comment state, but it's easier to implement// if we reconsume the current character. RECONSUME_IN(BogusCommentState); } parseError(); bufferASCIICharacter('<'); RECONSUME_IN(DataState);END_STATE()BEGIN_STATE(MarkupDeclarationOpenState)if (character == '-') { auto result = source.advancePast("--");if (result == SegmentedString::DidMatch) { m_token.beginComment(); SWITCH_TO(CommentStartState); }if (result == SegmentedString::NotEnoughCharacters) RETURN_IN_CURRENT_STATE(haveBufferedCharacterToken()); } else if (isASCIIAlphaCaselessEqual(character, 'd')) { // 由于character == 'D',满足此条件 auto result = source.advancePastLettersIgnoringASCIICase("doctype"); // 看解码后的字符流中是否有完整的"doctype"if (result == SegmentedString::DidMatch) SWITCH_TO(DOCTYPEState); // 如果匹配,则跳转到DOCTYPEState,同时取出当前指向的字符,由于上面source字符流已经移动了"doctype",因此此时取出的字符为'>'if (result == SegmentedString::NotEnoughCharacters) // 如果不匹配 RETURN_IN_CURRENT_STATE(haveBufferedCharacterToken()); // 保存状态,直接返回 } else if (character == '[' && shouldAllowCDATA()) { auto result = source.advancePast("[CDATA[");if (result == SegmentedString::DidMatch) SWITCH_TO(CDATASectionState);if (result == SegmentedString::NotEnoughCharacters) RETURN_IN_CURRENT_STATE(haveBufferedCharacterToken()); } parseError(); RECONSUME_IN(BogusCommentState);END_STATE()#define SWITCH_TO(newState) \do { \if (!m_preprocessor.peek(source, isNullCharacterSkippingState(newState))) { \ m_state = newState; \return haveBufferedCharacterToken(); \ } \ character = m_preprocessor.nextInputCharacter(); \ // 取出下一个字符 goto newState; \ // 跳转到指定的state } while (false)#define RETURN_IN_CURRENT_STATE(expression) \do { \ m_state = currentState; \ // 保存当前状态return expression; \ } while (false)BEGIN_STATE(DOCTYPEState)if (isTokenizerWhitespace(character)) ADVANCE_TO(BeforeDOCTYPENameState);if (character == kEndOfFileMarker) { parseError(); m_token.beginDOCTYPE(); m_token.setForceQuirks();return emitAndReconsumeInDataState(); } parseError(); RECONSUME_IN(BeforeDOCTYPENameState);END_STATE()#define RECONSUME_IN(newState) \do { \ // 直接跳转到指定state goto newState; \ } while (false) BEGIN_STATE(BeforeDOCTYPENameState)if (isTokenizerWhitespace(character)) ADVANCE_TO(BeforeDOCTYPENameState);if (character == '>') { // character == '>',匹配此处,到此DOCTYPE标签匹配完毕 parseError(); m_token.beginDOCTYPE(); m_token.setForceQuirks();return emitAndResumeInDataState(source); }if (character == kEndOfFileMarker) { parseError(); m_token.beginDOCTYPE(); m_token.setForceQuirks();return emitAndReconsumeInDataState(); } m_token.beginDOCTYPE(toASCIILower(character)); ADVANCE_PAST_NON_NEWLINE_TO(DOCTYPENameState);END_STATE()inline bool HTMLTokenizer::emitAndResumeInDataState(SegmentedString& source){ saveEndTagNameIfNeeded(); m_state = DataState; // 重置状态为初始状态DataState source.advancePastNonNewline(); // 移动到下一个字符return true;} DOCTYPE Token 经历了6个状态最终被解析出来,整个过程如下图所示: 当 Token 解析完毕之后,分词状态又被重置为 DataState,同时需要注意的时,此时字符流 source 内部指向的是下一个字符 '<'。 上面代码第61行在用字符流 source 匹配字符串 "doctype" 时,可能出现匹配不上的情形。为什么会这样呢?这是因为整个 DOM 树的构建流程,并不是先要解码完成,解码完成之后获取到完整的字符流才进行分词。从前面解码可以知道,解码可能是一边接收字节流,一边进行解码的,因此分词也是这样,只要能解码出一段字符流,就会立即进行分词。整个流程会出现如下图所示: 由于这个原因,用来分词的字符流可能是不完整的。对于出现不完整情形的 DOCTYPE 分词过程如下图所示: 上面介绍了解码、分词、解码、分词处理 DOCTYPE 标签的情形,可以看到从逻辑上这种情形与完整解码再分词是一样的。后续介绍时都会只针对完整解码再分词的情形,对于一边解码一边分词的情形,只需要正确的认识 source 字符流内部指针的移动,并不难分析。 Case2:标签 <html> 标签的分词过程和 <!DOCTYPE> 类似,其相关代码如下: BEGIN_STATE(TagOpenState) if (character == '!') ADVANCE_PAST_NON_NEWLINE_TO(MarkupDeclarationOpenState); if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(EndTagOpenState); if (isASCIIAlpha(character)) { // 在开标签状态下,当前字符为'h' m_token.beginStartTag(convertASCIIAlphaToLower(character)); // 将'h'添加到Token名中 ADVANCE_PAST_NON_NEWLINE_TO(TagNameState); // 跳转到TagNameState,并移动到下一个字符't' } if (character == '?') { parseError(); // The spec consumes the current character before switching // to the bogus comment state, but it's easier to implement // if we reconsume the current character. RECONSUME_IN(BogusCommentState); } parseError(); bufferASCIICharacter('<'); RECONSUME_IN(DataState); END_STATE() BEGIN_STATE(TagNameState) if (isTokenizerWhitespace(character)) ADVANCE_TO(BeforeAttributeNameState); if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(SelfClosingStartTagState); if (character == '>') // 在这个状态下遇到起始标签终止字符 return emitAndResumeInDataState(source); // 当前分词结束,重置分词状态为DataState if (m_options.usePreHTML5ParserQuirks && character == '<') return emitAndReconsumeInDataState(); if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); } m_token.appendToName(toASCIILower(character)); // 将当前字符添加到Token名 ADVANCE_PAST_NON_NEWLINE_TO(TagNameState); // 继续跳转到当前状态,并移动到下一个字符 END_STATE() Case3:带有属性的标签 <div> HTML 标签可以带有属性,属性由属性名和属性值组成,属性之间以及属性与标签名之间用空格分隔: <!-- div标签有两个属性,属性名为class和align,它们的值都带有引号 --> <div class="news" align="center">Hello,World!</div> <!-- 属性值也可以不带引号 --> <div class=news align=center>Hello,World!</div> 整个 <div> 标签的解析中,标签名 div 的解析流程和上面的 <html> 标签解析一样,当在解析标签名的过程中,碰到了空白字符,说明要开始解析属性了,下面是相关代码: BEGIN_STATE(TagNameState)if (isTokenizerWhitespace(character)) // 在解析TagName时遇到空白字符,标志属性开始 ADVANCE_TO(BeforeAttributeNameState);if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(SelfClosingStartTagState);if (character == '>')return emitAndResumeInDataState(source);if (m_options.usePreHTML5ParserQuirks && character == '<')return emitAndReconsumeInDataState();if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); } m_token.appendToName(toASCIILower(character)); ADVANCE_PAST_NON_NEWLINE_TO(TagNameState);END_STATE()#define ADVANCE_TO(newState) \do { \if (!m_preprocessor.advance(source, isNullCharacterSkippingState(newState))) { \ // 移动到下一个字符 m_state = newState; \return haveBufferedCharacterToken(); \ } \ character = m_preprocessor.nextInputCharacter(); \ goto newState; \ // 跳转到指定状态 } while (false)BEGIN_STATE(BeforeAttributeNameState)if (isTokenizerWhitespace(character)) // 如果标签名后有连续空格,那么就不停的跳过,在当前状态不停循环 ADVANCE_TO(BeforeAttributeNameState);if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(SelfClosingStartTagState);if (character == '>')return emitAndResumeInDataState(source);if (m_options.usePreHTML5ParserQuirks && character == '<')return emitAndReconsumeInDataState();if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); }if (character == '"' || character == '\'' || character == '<' || character == '=') parseError(); m_token.beginAttribute(source.numberOfCharactersConsumed()); // Token的属性列表增加一个,用来存放新的属性名与属性值 m_token.appendToAttributeName(toASCIILower(character)); // 添加属性名 ADVANCE_PAST_NON_NEWLINE_TO(AttributeNameState); // 跳转到AttributeNameState,并且移动到下一个字符END_STATE()BEGIN_STATE(AttributeNameState)if (isTokenizerWhitespace(character)) ADVANCE_TO(AfterAttributeNameState);if (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(SelfClosingStartTagState);if (character == '=') ADVANCE_PAST_NON_NEWLINE_TO(BeforeAttributeValueState); // 在解析属性名的过程中如果碰到=,说明属性名结束,属性值就要开始if (character == '>')return emitAndResumeInDataState(source);if (m_options.usePreHTML5ParserQuirks && character == '<')return emitAndReconsumeInDataState();if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); }if (character == '"' || character == '\'' || character == '<' || character == '=') parseError(); m_token.appendToAttributeName(toASCIILower(character)); ADVANCE_PAST_NON_NEWLINE_TO(AttributeNameState);END_STATE()BEGIN_STATE(BeforeAttributeValueState)if (isTokenizerWhitespace(character)) ADVANCE_TO(BeforeAttributeValueState);if (character == '"') ADVANCE_PAST_NON_NEWLINE_TO(AttributeValueDoubleQuotedState); // 有的属性值有引号包围,这里跳转到AttributeValueDoubleQuotedState,并移动到下一个字符if (character == '&') RECONSUME_IN(AttributeValueUnquotedState);if (character == '\'') ADVANCE_PAST_NON_NEWLINE_TO(AttributeValueSingleQuotedState);if (character == '>') { parseError();return emitAndResumeInDataState(source); }if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); }if (character == '<' || character == '=' || character == '`') parseError(); m_token.appendToAttributeValue(character); // 有的属性值没有引号包围,添加属性值字符到Token ADVANCE_PAST_NON_NEWLINE_TO(AttributeValueUnquotedState); // 跳转到AttributeValueUnquotedState,并移动到下一个字符END_STATE()BEGIN_STATE(AttributeValueDoubleQuotedState)if (character == '"') { // 在当前状态下如果遇到引号,说明属性值结束 m_token.endAttribute(source.numberOfCharactersConsumed()); // 结束属性解析 ADVANCE_PAST_NON_NEWLINE_TO(AfterAttributeValueQuotedState); // 跳转到AfterAttributeValueQuotedState,并移动到下一个字符 }if (character == '&') { m_additionalAllowedCharacter = '"'; ADVANCE_PAST_NON_NEWLINE_TO(CharacterReferenceInAttributeValueState); }if (character == kEndOfFileMarker) { parseError(); m_token.endAttribute(source.numberOfCharactersConsumed()); RECONSUME_IN(DataState); } m_token.appendToAttributeValue(character); // 将属性值字符添加到Token ADVANCE_TO(AttributeValueDoubleQuotedState); // 跳转到当前状态END_STATE()BEGIN_STATE(AfterAttributeValueQuotedState)if (isTokenizerWhitespace(character)) ADVANCE_TO(BeforeAttributeNameState); // 属性值解析完毕,如果后面继续跟着空白字符,说明后续还有属性要解析,调回到BeforeAttributeNameStateif (character == '/') ADVANCE_PAST_NON_NEWLINE_TO(SelfClosingStartTagState);if (character == '>')return emitAndResumeInDataState(source); // 属性值解析完毕,如果遇到'>'字符,说明整个标签也要解析完毕了,此时结束当前标签解析,并且重置分词状态为DataState,并移动到下一个字符if (m_options.usePreHTML5ParserQuirks && character == '<')return emitAndReconsumeInDataState();if (character == kEndOfFileMarker) { parseError(); RECONSUME_IN(DataState); } parseError(); RECONSUME_IN(BeforeAttributeNameState);END_STATE()BEGIN_STATE(AttributeValueUnquotedState)if (isTokenizerWhitespace(character)) { // 当解析不带引号的属性值时遇到空白字符(这与带引号的属性值不一样,带引号的属性值可以包含空白字符),说明当前属性解析完毕,后面还有其他属性,跳转到BeforeAttributeNameState,并且移动到下一个字符 m_token.endAttribute(source.numberOfCharactersConsumed()); ADVANCE_TO(BeforeAttributeNameState); }if (character == '&') { m_additionalAllowedCharacter = '>'; ADVANCE_PAST_NON_NEWLINE_TO(CharacterReferenceInAttributeValueState); }if (character == '>') { // 解析过程中如果遇到'>'字符,说明整个标签也要解析完毕了,此时结束当前标签解析,并且重置分词状态为DataState,并移动到下一个字符 m_token.endAttribute(source.numberOfCharactersConsumed());return emitAndResumeInDataState(source); }if (character == kEndOfFileMarker) { parseError(); m_token.endAttribute(source.numberOfCharactersConsumed()); RECONSUME_IN(DataState); }if (character == '"' || character == '\'' || character == '<' || character == '=' || character == '`') parseError(); m_token.appendToAttributeValue(character); // 将遇到的属性值字符添加到Token ADVANCE_PAST_NON_NEWLINE_TO(AttributeValueUnquotedState); // 跳转到当前状态,并且移动到下一个字符END_STATE() 从代码中可以看到,当属性值带引号和不带引号时,解析的逻辑是不一样的。当属性值带有引号时,属性值里面是可以包含空白字符的。如果属性值不带引号,那么一旦碰到空白字符,说明这个属性就解析结束了,会进入下一个属性的解析当中。 Case4:纯文本解析 这里的纯文本指起始标签与结束标签之间的任何纯文字,包括脚本文、CSS 文本等等,如下所示: <!-- div标签中的纯文本 Hello,Word! --> <divclass=newsalign=center>Hello,World!</div> <!-- script标签中的纯文本 window.name = 'Lucy'; --> <script>window.name = 'Lucy';</script> 纯文本的解析过程比较简单,就是不停的在 DataState 状态上跳转,缓存遇到的字符,直到遇见一个结束标签的 '<' 字符,相关代码如下: BEGIN_STATE(DataState) if (character == '&') ADVANCE_PAST_NON_NEWLINE_TO(CharacterReferenceInDataState); if (character == '<') { // 如果在解析文本的过程中遇到开标签,分两种情况 if (haveBufferedCharacterToken()) // 第一种,如果缓存了文本字符就直接按当前DataState返回,并不移动字符,所以下次再进入分词操作时取到的字符仍为'<' RETURN_IN_CURRENT_STATE(true); ADVANCE_PAST_NON_NEWLINE_TO(TagOpenState); // 第二种,如果没有缓存任何文本字符,直接进入TagOpenState状态,进入到起始标签解析过程,并且移动下一个字符 } if (character == kEndOfFileMarker) return emitEndOfFile(source); bufferCharacter(character); // 缓存遇到的字符 ADVANCE_TO(DataState); // 循环跳转到当前DataState状态,并且移动到下一个字符 END_STATE() 由于流程比较简单,下面只给出解析div标签中纯文本的结果: 2.3 创建节点与添加节点 2.3.1 相关类图 2.3.2 创建、添加流程 上面的分词循环中,每分出一个 Token,就会根据 Token 创建对应的 Node,然后将 Node 添加到 DOM 树上(HTMLDocumentParser::pumpTokenizerLoop 方法在上面分词中有介绍)。 上面方法中首先看 HTMLTreeBuilder::constructTree,代码如下: // 只保留关健代码 void HTMLTreeBuilder::constructTree(AtomHTMLToken&& token) { ... if (shouldProcessTokenInForeignContent(token)) processTokenInForeignContent(WTFMove(token)); else processToken(WTFMove(token)); // HTMLToken在这里被处理 ... m_tree.executeQueuedTasks(); // HTMLContructionSiteTask在这里被执行,有时候也直接在创建的过程中直接执行,然后这个方法发现队列为空就会直接返回 // The tree builder might have been destroyed as an indirect result of executing the queued tasks. } void HTMLConstructionSite::executeQueuedTasks() { if (m_taskQueue.isEmpty()) // 队列为空,就直接返回 return; // Copy the task queue into a local variable in case executeTask // re-enters the parser. TaskQueue queue = WTFMove(m_taskQueue); for (auto& task : queue) // 这里的task就是HTMLContructionSiteTask executeTask(task); // 执行task // We might be detached now. } 上面代码中 HTMLTreeBuilder::processToken 就是处理 Token 生成对应 Node 的地方,代码如下所示: void HTMLTreeBuilder::processToken(AtomHTMLToken&& token) { switch (token.type()) { case HTMLToken::Uninitialized: ASSERT_NOT_REACHED(); break; case HTMLToken::DOCTYPE: // HTML中的DOCType标签 m_shouldSkipLeadingNewline = false; processDoctypeToken(WTFMove(token)); break; case HTMLToken::StartTag: // 起始HTML标签 m_shouldSkipLeadingNewline = false; processStartTag(WTFMove(token)); break; case HTMLToken::EndTag: // 结束HTML标签 m_shouldSkipLeadingNewline = false; processEndTag(WTFMove(token)); break; case HTMLToken::Comment: // HTML中的注释 m_shouldSkipLeadingNewline = false; processComment(WTFMove(token)); return; case HTMLToken::Character: // HTML中的纯文本 processCharacter(WTFMove(token)); break; case HTMLToken::EndOfFile: // HTML结束标志 m_shouldSkipLeadingNewline = false; processEndOfFile(WTFMove(token)); break; } } 可以看到上面代码对7类 Token 做了处理,由于处理的流程都是类似的,这里分析5个节点case的创建添加过程,分别是<!DOCTYPE> 标签,<html>起始标签,<title> 起始标签,<title> 文本,<title> 结束标签,剩下的过程都使用图表示。 Case1:!DOCTYPE 标签 // 只保留关健代码 void HTMLTreeBuilder::processDoctypeToken(AtomHTMLToken&& token) { ASSERT(token.type() == HTMLToken::DOCTYPE); if (m_insertionMode == InsertionMode::Initial) { // m_insertionMode的初始值就是InsertionMode::Initial m_tree.insertDoctype(WTFMove(token)); // 插入DOCTYPE标签 m_insertionMode = InsertionMode::BeforeHTML; // 插入DOCTYPE标签之后,m_insertionMode设置为InsertionMode::BeforeHTML,表示下面要开是HTML标签插入 return; } ... } // 只保留关健代码 void HTMLConstructionSite::insertDoctype(AtomHTMLToken&& token) { ... // m_attachmentRoot就是Document对象,文档根节点 // DocumentType::create方法创建出DOCTYPE节点 // attachLater方法内部创建出HTMLContructionSiteTask attachLater(m_attachmentRoot, DocumentType::create(m_document, token.name(), publicId, systemId)); ... } // 只保留关健代码 void HTMLConstructionSite::attachLater(ContainerNode& parent, Ref<Node>&& child, bool selfClosing) { ... HTMLConstructionSiteTask task(HTMLConstructionSiteTask::Insert); // 创建HTMLConstructionSiteTask task.parent = &parent; // task持有当前节点的父节点 task.child = WTFMove(child); // task持有需要操作的节点 task.selfClosing = selfClosing; // 是否自关闭节点 // Add as a sibling of the parent if we have reached the maximum depth allowed. // m_openElements就是HTMLElementStack,在这里还看不到它的作用,后面会讲。这里可以看到这个stack里面加入的对象个数是有限制的,最大不超过512个。 // 所以如果一个HTML标签嵌套过多的子标签,就会触发这里的操作 if (m_openElements.stackDepth() > m_maximumDOMTreeDepth && task.parent->parentNode()) task.parent = task.parent->parentNode(); // 满足条件,就会将当前节点添加到爷爷节点,而不是父节点 ASSERT(task.parent); m_taskQueue.append(WTFMove(task)); // 将task添加到Queue当中 } 从代码可以看到,这里只是创建了 DOCTYPE 节点,还没有真正添加。真正执行添加的操作,需要执行 HTMLContructionSite::executeQueuedTasks,这个方法在一开始有列出来。下面就来看下每个 Task 如何被执行。 // 方法位于HTMLContructionSite.cpp static inline void executeTask(HTMLConstructionSiteTask& task) { switch (task.operation) { // HTMLConstructionSiteTask存储了自己要做的操作,构建DOM树一般都是Insert操作 case HTMLConstructionSiteTask::Insert: executeInsertTask(task); // 这里执行insert操作 return; // All the cases below this point are only used by the adoption agency. case HTMLConstructionSiteTask::InsertAlreadyParsedChild: executeInsertAlreadyParsedChildTask(task); return; case HTMLConstructionSiteTask::Reparent: executeReparentTask(task); return; case HTMLConstructionSiteTask::TakeAllChildrenAndReparent: executeTakeAllChildrenAndReparentTask(task); return; } ASSERT_NOT_REACHED(); } // 只保留关健代码,方法位于HTMLContructionSite.cpp static inline void executeInsertTask(HTMLConstructionSiteTask& task) { ASSERT(task.operation == HTMLConstructionSiteTask::Insert); insert(task); // 继续调用插入方法 ... } // 只保留关健代码,方法位于HTMLContructionSite.cpp static inline void insert(HTMLConstructionSiteTask& task) { ... ASSERT(!task.child->parentNode()); if (task.nextChild) task.parent->parserInsertBefore(*task.child, *task.nextChild); else task.parent->parserAppendChild(*task.child); // 调用父节点方法继续插入 } // 只保留关健代码 void ContainerNode::parserAppendChild(Node& newChild) { ... executeNodeInsertionWithScriptAssertion(*this, newChild, ChildChange::Source::Parser, ReplacedAllChildren::No, [&] { if (&document() != &newChild.document()) document().adoptNode(newChild); appendChildCommon(newChild); // 在Block回调中调用此方法继续插入 ... }); } // 最终调用的是这个方法进行插入 void ContainerNode::appendChildCommon(Node& child) { ScriptDisallowedScope::InMainThread scriptDisallowedScope; child.setParentNode(this); if (m_lastChild) { // 父节点已经插入子节点,运行在这里 child.setPreviousSibling(m_lastChild); m_lastChild->setNextSibling(&child); } else m_firstChild = &child; // 如果父节点是首次插入子节点,运行在这里 m_lastChild = &child; // 更新m_lastChild } 经过执行上面方法之后,原来只有一个根节点的 DOM 树变成了下面的样子: Case2:html 起始标签 // processStartTag内部有很多状态处理,这里只保留关健代码 void HTMLTreeBuilder::processStartTag(AtomHTMLToken&& token) { ASSERT(token.type() == HTMLToken::StartTag); switch (m_insertionMode) { case InsertionMode::Initial: defaultForInitial(); ASSERT(m_insertionMode == InsertionMode::BeforeHTML); FALLTHROUGH; case InsertionMode::BeforeHTML: if (token.name() == htmlTag) { // html标签在这里处理 m_tree.insertHTMLHtmlStartTagBeforeHTML(WTFMove(token)); m_insertionMode = InsertionMode::BeforeHead; // 插入完html标签,m_insertionMode = InsertionMode::BeforeHead,表明即将处理head标签 return; } ... } } // 只保留关健代码 void HTMLConstructionSite::insertHTMLHtmlStartTagBeforeHTML(AtomHTMLToken&& token) { auto element = HTMLHtmlElement::create(m_document); // 创建html节点 setAttributes(element, token, m_parserContentPolicy); attachLater(m_attachmentRoot, element.copyRef()); // 同样调用了attachLater方法,与DOCTYPE类似 m_openElements.pushHTMLHtmlElement(HTMLStackItem::create(element.copyRef(), WTFMove(token))); // 注意这里,这里向HTMLElementStack中压入了正在插入的html起始标签 executeQueuedTasks(); // 这里在插入操作直接执行了task,外面HTMLTreeBuilder::constructTree方法调用的executeQueuedTasks方法就会直接返回 ... } 执行上面代码之后,DOM 树变成了如下图所示: Case3:title 起始标签 当插入 <title> 起始标签之后,DOM 树以及 HTMLElementStack m_openElements 如下图所示: Case4:title 标签文本 <title> 标签的文本作为文本节点插入,生成文本节点的代码如下: // 只保留关健代码 void HTMLConstructionSite::insertTextNode(const String& characters, WhitespaceMode whitespaceMode) { HTMLConstructionSiteTask task(HTMLConstructionSiteTask::Insert); task.parent = ¤tNode(); // 直接取HTMLElementStack m_openElements的栈顶节点,此时节点是title unsigned currentPosition = 0; unsigned lengthLimit = shouldUseLengthLimit(*task.parent) ? Text::defaultLengthLimit : std::numeric_limits<unsigned>::max(); // 限制文本节点最大包含的字符个数为65536 // 可以看到如果文本过长,会将分割成多个文本节点 while (currentPosition < characters.length()) { AtomString charactersAtom = m_whitespaceCache.lookup(characters, whitespaceMode); auto textNode = Text::createWithLengthLimit(task.parent->document(), charactersAtom.isNull() ? characters : charactersAtom.string(), currentPosition, lengthLimit); // If we have a whole string of unbreakable characters the above could lead to an infinite loop. Exceeding the length limit is the lesser evil. if (!textNode->length()) { String substring = characters.substring(currentPosition); AtomString substringAtom = m_whitespaceCache.lookup(substring, whitespaceMode); textNode = Text::create(task.parent->document(), substringAtom.isNull() ? substring : substringAtom.string()); // 生成文本节点 } currentPosition += textNode->length(); // 下一个文本节点包含的字符起点 ASSERT(currentPosition <= characters.length()); task.child = WTFMove(textNode); executeTask(task); // 直接执行Task插入 } } 从代码可以看到,如果一个节点后面跟的文本字符过多,会被分割成多个文本节点插入。下面的例子将 <title> 节点后面的文本字符个数设置成85248,使用 Safari 查看确实生成了2个文本节点: 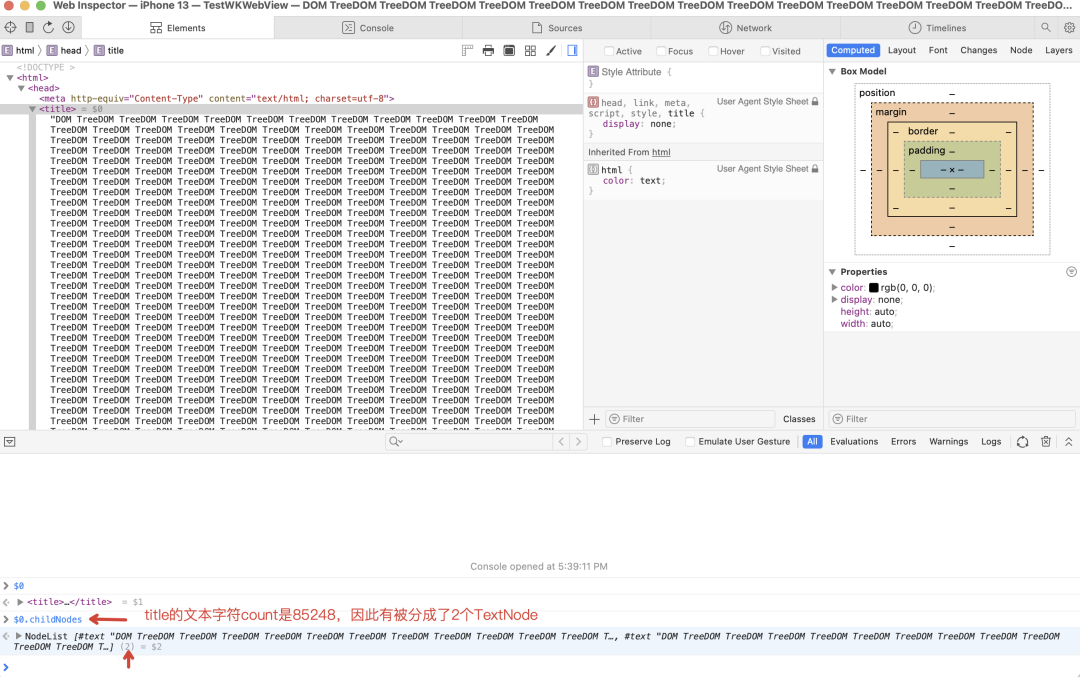 **Case5:结束标签** 当遇到 <title> 结束标签,代码处理如下: // 代码内部有很多状态处理,这里只保留关健代码 void HTMLTreeBuilder::processEndTag(AtomHTMLToken&& token) { ASSERT(token.type() == HTMLToken::EndTag); switch (m_insertionMode) { ... case InsertionMode::Text: // 由于遇到title结束标签之前插入了文本,因此此时的插入模式就是InsertionMode::Text m_tree.openElements().pop(); // 因为遇到了title结束标签,整个标签已经处理完毕,从HTMLElementStack栈中弹出栈顶元素title m_insertionMode = m_originalInsertionMode; // 恢复之前的插入模式 break; } 每当遇到一个标签的结束标签,都会像上面一样将 HTMLElementStack m_openElementsStack 的栈顶元素弹出。执行上面代码之后,DOM 树与 HTMLElementStack 如下图所示: 三、内存中的DOM树 当整个 DOM 树构建完成之后,DOM 树和 HTMLElementStack m_openElements 如下图所示: 从上图可以看到,当构建完 DOM,HTMLElementStack m_openElements 并没有将栈完全清空,而是保留了2个节点: html 节点与 body 节点。这可以从 Xcode 的控制台输出看到: 同时可以看到,内存中的 DOM 树结构和文章开头画的逻辑上的 DOM 树结构是不一样的。逻辑上的 DOM 树父节点有多少子节点,就有多少指向子节点的指针,而内存中的 DOM 树,不管父节点有多少子节点,始终只有2个指针指向子节点: m_firstChild 与 m_lastChild。同时,内存中的 DOM 树兄弟节点之间也相互有指针引用,而逻辑上的 DOM 树结构是没有的。 举个例子,如果一棵 DOM 树只有1个父节点,100个子节点,那么使用逻辑上的 DOM 树结构,父节点就需要100个指向子节点的指针。如果一个指针占8字节,那么总共占用800字节。使用上面内存中 DOM 树的表示方式,父节点需要2个指向子节点的指针,同时兄弟节点之间需要198个指针,一共200个指针,总共占用1600字节。相比逻辑上的 DOM 树结构,内存上并不占优势,但是内存中的 DOM 树结构,无论父节点有多少子节点,只需要2个指针就可以了,不需要添加子节点时,频繁动态申请内存,创建新的指向子节点的指针。 ---------- END ---------- 百度 Geek 说 百度官方技术公众号上线啦! 技术干货 · 行业资讯 · 线上沙龙 · 行业大会 招聘信息 · 内推信息 · 技术书籍 · 百度周边