首页 文章 精选 留言 我的

精选列表

搜索[Pixel设备],共10000篇文章
优秀的个人博客,低调大师

【Skyeye 云 V2.6.8 重磅更新】商城,设备,MES,导入导出等模块全面升级

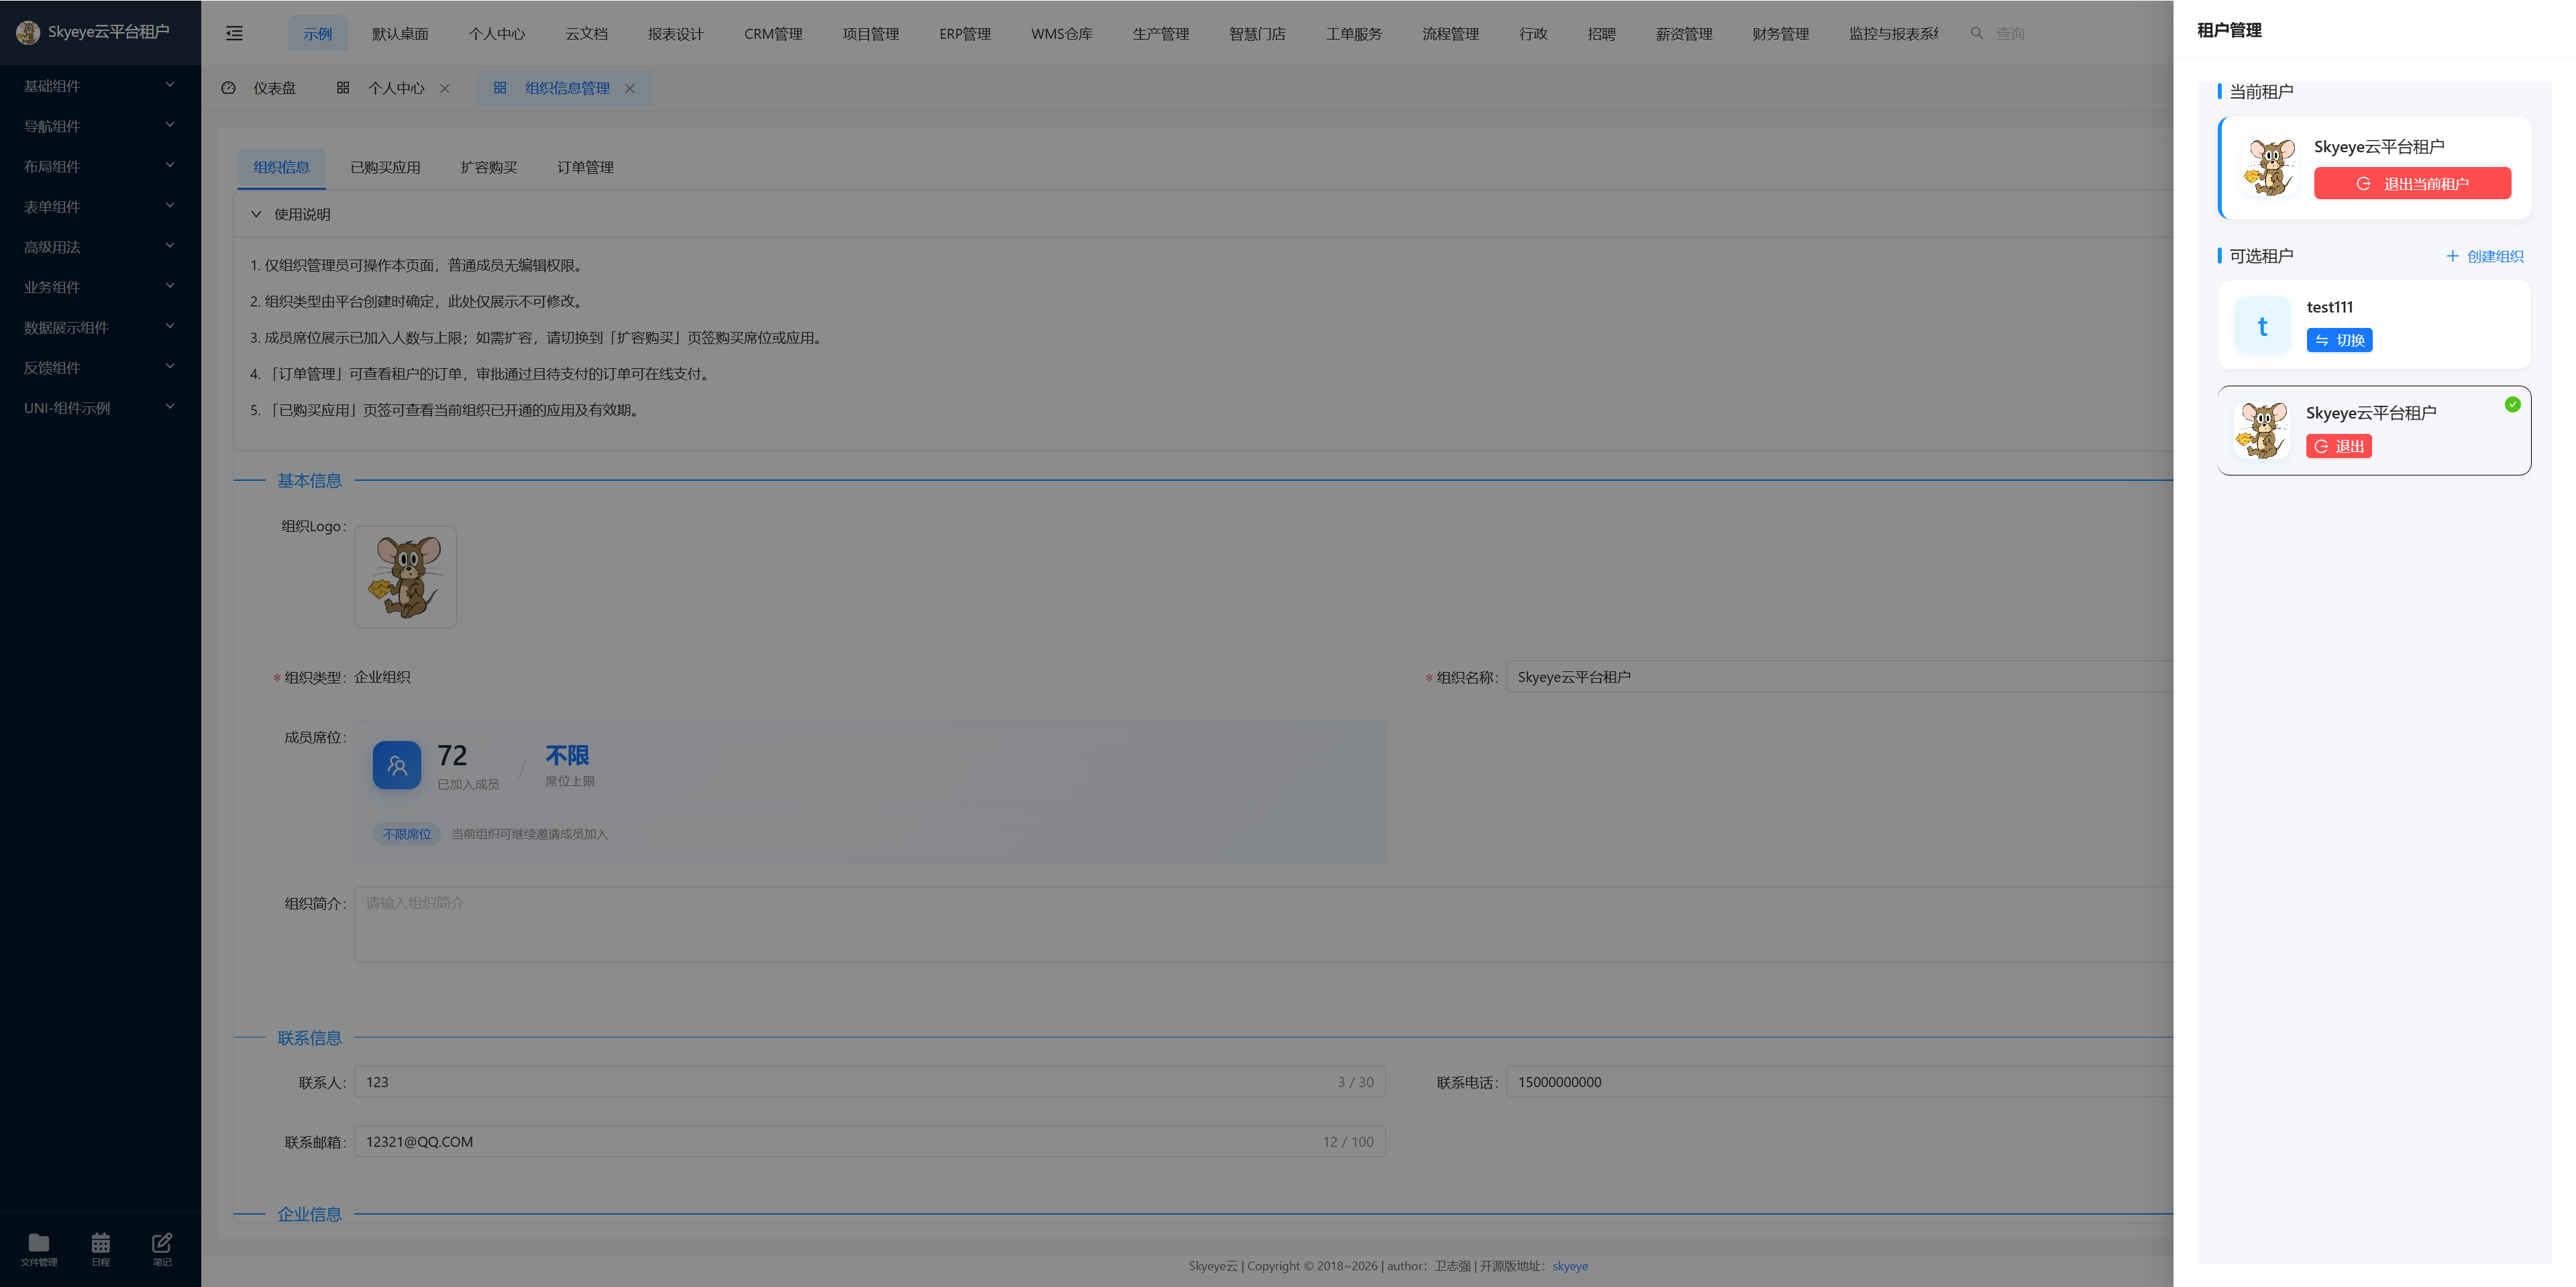
Skyeye 云智能制造,智能制造一体化,采用 SpringBoot+ UNI-APP + Ant Design Vue 的零代码平台开发模式。包含 100 多种电子流程,CRM、PM、ERP、MES、ADM、OA、EHR、AI、项目、商城、财务、多班次考勤、薪资、招聘、云售后、论坛、问卷、报表设计、工作流、Saas 等功能。打造全网首套零代码、功能最全的智能制造行业供应链一体化管理软件。 官方网站 开发文档 视频教程 功能清单 Skyeye云【源代码】针对 {Skyeye 会员} 开源。拿到源码后可进行学习、毕设、企业等使用。 🚀核心场景提效指南 🔥生产部门:数据权限精细化与排班自动化 对于生产部门而言,领料、补料等单据的权限管控直接影响数据安全与流程合规。本次版本为领料单、补料单、退料单等6类核心单据新增数据权限配置,支持「所有数据」「当前部门」「指定车间」三级权限分配,同时部门加工单仅开放本部门操作权限,从源头避免数据越权访问。 生产主管李工:“之前跨车间领料时经常看到其他部门的敏感数据,现在通过指定车间权限,既能保障数据安全,又不影响本车间的领料效率,这个功能很实用!” 🔥数据权限精细化 6类生产单据支持三级数据权限分配 部门加工单实现部门级数据隔离 排班管理新增自动计算与明细展示(含工位、车间信息) 🔥IT运维:操作日志管控与定时任务自动化 IT管理员常面临操作审计与数据冗余的双重挑战。本次版本新增操作日志管理功能,支持操作行为全记录与定时清理策略配置;同时新增删除用户登录日志、文档会员登录日志的定时任务,无需手动清理即可维持系统性能。 运维工程师王工:“之前日志数据量太大导致数据库卡顿,现在通过定时清理策略,系统负载明显降低,而且操作日志的统计报表能快速定位异常行为,运维效率提升了不少。” 🔥操作日志全生命周期管理 操作日志支持定时清理,可自定义清理周期 新增操作日志统计报表,可视化展示操作趋势 2类登录日志的定时删除任务,减少数据冗余 🔥文档管理:云文档独立与社区互动升级 文档管理模块拆分出独立「云文档」模块,同时新增问答社区功能——会员在文档门户提交问题后,管理员可标记为“bug”或“需求”,会员能实时查看标记状态,实现文档反馈的闭环管理。 文档管理员张工:“之前文档反馈分散在各个渠道,现在通过问答社区集中处理,还能标记问题类型,会员也能及时了解进度,文档管理的协同性大大增强。” 🔥云文档独立与社区互动 文档管理拆分独立「云文档」模块,聚焦云端协作 问答社区支持bug/需求标记,会员可查看标记信息 新增文档统计与浏览历史统计功能,掌握文档使用情况 🚀全模块功能更新列表 🔥基础模块 ✅新增操作日志管理功能,支持定时清理策略配置 ✅新增操作日志统计报表,可视化展示操作行为 ✅创建/编辑布局:下拉框、单选框支持数据联动;部门组件新增选项配置 ✅多租户登录优化:若账号加入多个租户,默认切换至第一个租户 ✅PC端聊天功能完善:支持消息提醒、未读数计数、群组聊天;WebSocket适配微服务 ✅移动端支持国际化,逐步替换硬编码中文 ✅高级搜索配置升级:支持枚举、数据字典类型;日期支持格式筛选,用户支持范围筛选 ✅新增工作日志撤销操作的基础设置管理 ✅新增平台信息设置(多租户版本),支持租户计费配置 ✅新增仪表盘设计器,可视化搭建数据看板 ✅公共导入导出功能 🔥文档管理 ✅拆分独立「云文档」模块,业务聚焦云端文档协作 ✅新增问答社区管理:管理员可标记bug/需求,会员查看标记状态 ✅新增文档统计、文档浏览历史统计功能 🔥报表设计 ✅报表布局新增deleteFlag字段,支持逻辑删除与数据恢复 ✅小卡片组件:新增多种科技风格,支持默认值属性 ✅文字组件:新增多种风格样式,支持一键替换 🔥商城模块 ✅PC端架构重构:由uniapp切换为antdesign框架,提升交互体验 ✅门店管理列表默认按创建时间排序 ✅新增门店产品调拨功能 ✅优惠券领取后直接跳转可买商品页面 🔥自动化模块 ✅PC端架构重构:由uniapp切换为antdesign框架 ✅模块维护与自动化流程均支持树状结构展示 🔥MES生产模块 ✅6类单据(领料单、补料单等)新增数据权限配置 ✅部门加工单仅支持本部门操作 ✅排班管理优化:新增自动计算与明细展示(工位、车间等) 🔥OA办公模块 ✅考勤打卡:新增网站端/移动端打卡开关;通知记录打卡方式;支持跨天打卡、请假/销假/加班跨天;考勤与薪资计算支持跨天 ✅考勤班次列表新增工时、线上打卡状态、网站端打卡状态展示 ✅考勤报表优化:支持查看多关联信息 ✅我的附件新增单个/批量移动至指定分类功能 ✅移动端:新增考勤月历;新增我的收藏功能(常用功能收藏排序、快速入口) 🔥Saas模块 ✅新增组织信息管理(PC+移动端):租户可购买席位/应用,查看已购应用、订单历史 ✅租户应用新增年费单价字段 ✅租户订单新增支付状态字段 ✅新增组织创建功能:支持个人组织与企业组织 ✅新增组织申请加入功能:包含加入历史、组织审批流程 🌟bug修复 解决项目管理中其他租户操作项目方案时的无权限提示问题 解决移动端部分功能重复请求问题 解决租户购买订单后可被删除的问题 解决业务对象属性名称修改后无法搜索的问题 解决移动端退款订单详情会员字段不显示问题 解决顶部菜单搜索「API接口文档」时目录路径显示异常问题 解决我的薪资发放历史无发放日期问题 解决报表设计中单个图表透明度修改影响其他图表的问题 解决生产计划转加工单时部门id不能为空的提示问题 解决布局设计器人员需求组件加载失败问题 解决学校管理校园规划新增路线显示空白问题 解决表单布局小卡片编辑时部分参数不回显问题 解决多租户下考勤「缺勤」定时任务重复计算用户的问题 解决生命周期模板流程结束后无法加载其他操作的问题 解决部分输入框提示语显示为object的问题 解决我的考勤班次排班考勤最后一页列表为空的问题 Skyeye 具备低代码、快捷开发、可视化设计、微服务等特点,方便客户二次开发,极大的提高了开发效率 项目地址: Gitee: https://gitee.com/doc_wei01/skyeye https://gitee.com/dromara/skyeye GitCode: https://gitcode.com/doc_wei-dev/erp-pro Saas 多租户部分效果图 效果图 效果图 Skyeye 云各种设计器效果图 效果图 效果图 管理端移动端效果图 效果图 效果图 效果图 效果图 商城 PC 端效果图 效果图 效果图 效果图 效果图 商城移动端效果图 效果图 效果图 效果图 效果图

优秀的个人博客,低调大师

用 nebula_dart_gdbc 在移动设备玩图数据库,泰酷辣!

nebula_dart_gdbc,是访问 NebulaGraph 的 Dart 语言客户端,在 dart_gdbc 的规范下进行开发。 dart_gdbc 是一套使用 Dart 语言定义的图数据库标准数据接口,整体思路参考了 JDBC 的规范。目前已经实现了对 NebulaGraph 的支持。 在先前写 GraphDesk 的过程中,曾使用过 nebula-java(Socket)+ Spring Boot(HTTP)的方式实现了 Flutter 应用对 NebulaGraph 的访问。这无异于一辆可以高速行驶的汽车(Socket),进出家门的时候非要用人推(HTTP)的方式,这一点很难让人接受。而使用 Dart Socket 访问图数据库无疑是 Flutter 应用一个不错的选择。不过,因为 Dart 相比其他编程语言来说,目前相对小众,需求量小,并且是个偏前端的语言,纵观现有的图数据库生态,它们都不支持 Dart。 于是,dart_gdbc 与 nebula_dart_gdbc 应运而生。 随着 Dart 客户端的打通,对于拥有图数据库的朋友来说,通过 Dart 在手机上,甚至嵌入式平台上进行 NebulaGraph 的图探索,已经成为可能。而对于 Flutter 开发者来说,可以试试创建自己的图数据库,使用 nebula_dart_gdbc 直连数据库来实现自己的应用,也是一种奇妙体验。虽然,数据库的常规操作还是经过服务端做数据转发合理一点,但不影响大家尝试这种新玩法。 如果一切顺利的话,Dart 这一环节补上之后,之前我做的 GraphDesk,将会有以下变化: 从程序启动来看,将挣脱 Java 环境的束缚,不再需要等待本地 Java 服务的启动过程,运行体验上会有一个质的变化; 从查询性能的角度上来看,也会更加流畅; 条件允许的情况下,未来将推出 App 版本。 意义层面的内容就说到这,接下来聊聊 nebula_dart_gdbc 的诞生历程,下文带有很强的技术色彩,非业内人士可以选择性跳过。 nebula_dart_gdbc 的设计实现 nebula_dart_gdbc 的大概实现思路同其他语言的客户端一致,按照了下面这个步骤: 通过 thrift 文件,生成 NebulaGraph 数据访问接口; 将生成的数据访问接口与 Thrift 结合,完成对 NebulaGraph 的访问; 封装数据库连接。 显然,真正的开发并没有这么简单。在实际的过程中,我遇到了很多问题,也做了很多尝试,最终才有了现在的 nebula_dart_gdbc。下面来记录下开发一个 Dart 客户端,有哪些操作步骤以及相关问题的解决方案。 生成 NebulaGraph 数据访问接口 第一步,先下载数据接口的 thrift 文件,这是 NebulaGraph 给出的链接:https://github.com/vesoft-inc/nebula/tree/master/src/interface,包含下面这些文件: common.thrift graph.thrift meta.thrift storage.thrift 注意:下载完之后,需要往文件添加对应的包名,如:namespace dart nebula.graph 第二步,下载完接口所需的 NebulaGraph thrift 文件之后,我们再来下载 Thrift,这是 Thrift 的官方下载地址:https://thrift.apache.org/download,这里使用的是最新版本 0.18.1(如果你阅读本文的时候,0.18.1 不是最新版本,下载最新版本即可)。 第三步,逐个文件生成 Dart 代码。使用下面的命令就行: thrift --gen dart common.thrift thrift --gen dart graph.thrift thrift --gen dart meta.thrift thrift --gen dart storage.thrift 这个过程中,我们会遇到一些问题,这里记录了它们的解决方法。 问题 1:文件会遇到“非语言中立性的标记编译”问题; 解决方案:按报错将文件中的语言标记删除即可。 问题 2:这里使用的 Dart 版本是 2.19.0,由 thrift-0.18.1 生成的 Dart 代码与现今的版本语法并不兼容,而且版本差异很大。报错如下图所示,当然这只是当中的一部分,实际报错的文件有 300 个左右。 (这是一张散户欢呼,码农落泪的图) 解决方案:根据编辑器的报错,逐个文件改。可能是最笨的办法,花了好几个小时。更好的方式,应该是让 thrift 的 compiler 支持最新的 Dart 版本,但这个办法可能需要花费更多的时间,而且不一定能成功。(退堂鼓震天响,退散...) 第四步,将生成的 Dart 代码,放到项目中。 至此,完成“通过 thrift 文件,生成 NebulaGraph 数据访问接口”。 数据访问接口与 Thrift 结合 这里,先插播一条广告(请耐心读下去)。 给大家介绍一家的烧烤摊。这家店的特点是,一个服务员有一个托盘,并且这个服务员只服务一桌。服务员很庄重地用托盘,端着一张空白的纸来到顾客面前,由顾客们轮流写上自己喜欢的牛肉串、烤面筋、烤花菜...,再选择调料黑胡椒、孜然...等信息。将纸放到托盘中后,由服务员送到烧烤师傅手中,烧烤师傅按照纸上的要求,烤好后将菜品装到碟子里,放在原来的托盘上。由服务员再端到顾客面前,顾客们分别拿走自己点的菜品。 这家烧烤摊名字叫:Thrift。 这可能是一段迄今为止对 Thrift 最奇怪的比喻。Thrift 是一个 RPC 框架,可将接口的参数转换成二进制数据。下面,介绍 Thrift 两个重要的接口:TProtocol 跟 TTransport。以刚刚烧烤摊为例子,大致可以有以下对应关系(可能有些许不恰当): TProtocol:可以有很多不同的顾客,负责写内容 TTransport:托盘 + 服务员,负责传递内容 TSocketTransport:服务员 THeaderTransport:托盘 Socket 连接的 IP 跟端口:桌号 传递给服务器的输出流:纸 调用接口的入参:纸上的内容 传递给客户端的输入流:碟子 调用接口的返回值:牛肉串、烤面筋、烤花菜...黑胡椒、孜然... 服务器:烧烤师傅 好了,广告结束。相信机智的你看到这里,对 Thrift 有了一定的了解。下面继续我们的 Dart 之旅: 首先要参考 nebula-java 源码,对 GraphServiceClient 进行调用。 这个环节我遇到了两个问题: 问题 1:nebula-java 使用的是 fbthrift,而 fbthrift 并没有 Dart 的实现。 解决方案:使用 Apache Thrift 的 Dart 实现。 问题 2:两个实现方案有着比较大的差异,比如说 Apache Thrift 没有 THeaderTransport,共同之处是,都有 Socket 的方式。 解决方案:这里先埋个雷,建立用 Socket 连接再说。 搞定上面两个问题后,我们可以通过 Dart Socket 连接,实现对 NebulaGraph 的访问。 这个步骤怎么说呢?就好像又来了一桌,现在两桌,一桌顾客和服务员都只会闽南语,一桌顾客和服务员都只会普通话。而烧烤师傅啥也不管,只看菜单。新来的这桌只有一个要求,跟隔壁桌点的要一模一样...在两桌语言不通的情况下,没有意外的话,这里要出意外。 好的,我们现在遇到了几个问题: 问题 1:返回了空数据,报错信息无从得知 解决思路:先使用 nebula-java,并对 Socket 发送数据的位置进行断点,将数据拷贝下来,通过 Dart Socket 直接发送,卒。到这个地方,我意识到不得不建立一个可以调试的环境。根据我朴素的直觉,客户端跟服务端应该是一个类似湖面倒影的结构。于是,参考过 nebula-java 客户端的代码后,我决定开了个小灶,建立了一个服务端 Mock,并使用返回伪造数据的方式,实现了 GraphService 接口。此时,服务端就具备了调试的条件。 问题 2:怎么确定 Mock 的结构是正确的? 解决思路:使用 nebula-java 客户端,连接 Mock 服务端,看看是否能够正常返回数据。如果能够正常返回数据,Mock 的结构上的准确性也就可以确定。这边调试使用的是不需要太多条件的 verifyClientVersion 接口。 至此,建立如图所示的结构: 对应关系如下: C1:nebula-java S1:NebulaGraph 数据库 C2:nebula_dart_gdbc S2:Mock 测试 整体思路如下: L1 是可靠的,可以发送准确数据,也能接收准确数据; L2 可以发送准确数据,用 L2 的连通性来确保 S2 的准确性; 通过 L3 对 C2 进行调试,当 L2 跟 L3 返回的数据一样时,说明此时的 C2 发送的数据是正确; 执行 L4,当 L4 跟 L1 返回的数据一样时,说明 C2 通过 Socket,连接到了数据库。 基本思路确定之后,开始了漫长的翻译(Java 代码变 Dart 代码)、调试,再翻译、再调试...,在 L2 跟 L3 中反复横跳。每个环节的数据表现形式都是纯数字数组,数组长度、下标对应的值错一个都可能功亏一篑。这里需要细心跟耐心。特别是数字操作上涉及到反码、补码、移位的操作,不同的参数有不同的字节长度,按位读写。以下,再列几个 L2、L3 反复横跳的过程中几个让人比较头大的问题: 问题 1:Apache 的 Thrift 版本,相比 fbthrift 版本缺了很多类,这里就不一一列举。 解决方案:将缺失的类,从 nebula-java 中的 fbthrift 中翻译,连同所依赖的第三方类也要跟着翻译(所幸依赖的并不多,只有 IO 相关的几个类。所幸做数据压缩的 zip 包有依赖,但实际没用到)。 问题 2:结构一样了,但发送的数据还是不一样,Apache 版本中,包括 Socket,用来写数据的容器是 Uint8List,所有放进去的数字都会被强行转成正数,但 fbthrift 中的数据是带正负号的。 解决方案:对所有类型进行修改,全部使用 Int8List 声明跟传输,包括 thrift 生成的类。 问题 3:在 Dart 中并没有 byte、short、int、long 的区分,所有的整型都是 int。 解决方案:同样是整数型,需要特别注意,根据实际的情况手动降低整型精度,从而达到与 Java 中声明类型后赋值时自动舍弃精度的效果。 到这里,L3 已经走通,C1 跟 C2 访问 S2,返回的数据一致,拿下模拟考!继续迎接挑战: 问题 4:调用 L4,通过 C2 连接到 S1,返回的数据还是空数据,明明 L2 跟 L3 从 S2 拿到的数据都是一样的,这让人很费解。 解决方法 1:改写 Apache 版本下 Socket 的机制,放弃使用创建时就指定消息回调,直接使用 async/await 的方式,使得调试更符合顺序思维。然后,对返回结果进行等待读取。虽然读到的数据依然是空的,不过在 Socket 使用方式上还是保留了这个写法。 解决方法 2:后来,我发现这个问题的原因是,Java Socket 跟 Dart Socket 之间写入的方式不同。在 nebula-java 中,接口间的数据传输使用了 THeaderTransport,数据会分为两段发送的,不确定是不是断点的位置不对,服务端拿到的都是一份两段合并后的数据。而 Dart 中的做法是将两个 List<int> 拼接成一段合并发送,在 S2 的表现完全一致,这个问题就很隐蔽,过了相当长一段一行代码不写还不得不保持干活状态的时间。到最后改成在 Dart Socket 的一次传输中,强行将两个 List<int> 剥离,使用两个 Stream 进行传输。至此,L4 成功,连通性问题解决,说实话,最后这点带有一丝运气成分。 封装数据库连接 在这个环节,实现思路中断的情况比较少碰到,整体算流畅,比较花时间的是结果集的处理。 nebula_dart_gdbc,并没有沿用 NebulaGraph 其他客户端的写法。而是整体上参考了 JDBC 的思路,将数据库连接、执行、结果集等进行了封装,形成 dart_gdbc。在这套接口标准下,对 nebula_dart_gdbc 进行实现。 熟悉 JDBC 的朋友,对以下流程就不陌生了,dart_gdbc 的调用流程如下: 注册驱动 获取连接 创建语句 执行语句 处理结果集 关闭连接 以下是 nebula_dart_gdbc 在 dart_gdbc 的规范下的代码示例: import 'package:nebula_dart_gdbc/nebula_dart_gdbc.dart'; void main() async { // 注册驱动 DriverManager.registerDriver(NgDriver()); // 获取连接 var conn = await DriverManager.getConnection( 'gdbc.nebula://127.0.0.1:9669/?space=test', username: 'root', // username is optional password: 'nebula', // password is optional ); // 创建语句 var stmt = await conn.createStatement(); // 执行语句 var rs = await stmt.executeQuery(gql: 'SHOW SPACES;'); // 打印结果 print(rs); // 关闭连接 conn.close(); } 就目前而言,拿到结果集之后,还需要自行按数组下标位进行数据组装。结果集的结构采用“头部数组”+“数据数组”的形式。在实际的开发中,处理上可能会麻烦一些。目前,我正在考虑在 dart_gdbc 未来的版本中,加入对象图映射的埋点回调。或者再开一个 OGM 的项目。关于这一点,目前只是一个还不太成熟的想法。 结尾 在文章结束部分,跟大家分享下写这个项目的心路历程。 起初,我对工作量大有一定的心理准备,铁了心想试一试。上手之后,才意识到并不仅仅是语法翻译一下这么简单,特别是不同语言的生态不同,引用的第三方也就随之不同,即使是相同的功能,运行机制也有所不同,这一部分的工作量会比想象中的要大。 再一个就是没有办法对数据库直接断点调试,算是一种黑盒调用,如同凭借着微弱的光线在黑夜中前行,对毫无头绪的问题有时候会产生一种无力感,只能凭借着经验做一些猜测,然后一点点去验证。但当连上实际的数据库,并拿到数据的那一刻,即使多年来已经习惯了被 bug 吊打再消灭 bug 的流程,但还是激动了一下。当开始着手建立 dart_gdbc 规范的时候,在《序》里写到的“责无旁贷”在脑海里回荡。直到今天发布第一个版本,这份热情算多了一份实实在在的兑现。 最后,当然是希望这个项目能够对基础软件生态有所帮助。个人也会不断修复 bug,完善功能,希望能够成为一个稳定可靠的项目。对项目感兴趣的话,欢迎参与开发。另外,dart_gdbc 与 nebula_dart_gdbc 目前收录在【图社区】(https://github.com/graph-cn),以后有新的关于图的开源项目,也会在这里发布,欢迎围观。 最后的最后,这篇文章及项目的背后有思为和想念小鱼干的清蒸两位老师的帮助,感谢。 传送门 dart_gdbc:https://github.com/graph-cn/dart_gdbc nebula_dart_gdbc:https://github.com/graph-cn/nebula_dart_gdbc fbthrift: https://github.com/dudu-ltd/fbthrift 谢谢你读完本文 (///▽///) 如果你想尝鲜图数据库 NebulaGraph,记得去 GitHub 下载、使用、(^з^)-☆ star 它 -> GitHub;和其他的 NebulaGraph 用户一起交流图数据库技术和应用技能,留下「你的名片」一起玩耍呀~ 2023 年 NebulaGraph 技术社区年度征文活动正在进行中,来这里领取华为 Meta 60 Pro、Switch 游戏机、小米扫地机器人等等礼品哟~ 活动链接:https://discuss.nebula-graph.com.cn/t/topic/13970

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册