首页 文章 精选 留言 我的

精选列表

搜索[Harness工程],共10000篇文章
优秀的个人博客,低调大师

Python全栈工程师(异常(高级)、运算符重载)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 对象的属性管理函数: getattr(obj, name[,default) 从对象得到对象的属性,getattr(x, “y”) 等同于x, y 当属性 不存在时 如果给出default参数则返回default 如果没有给出default ,则产生一个AttributeError错误 hasattr(obj, name)用给定的name返回对象obj是否有此属性 此种做法可以避免在getattr(obj,name)时引发错误 setattr(obj, name, value) 给对象obj的名为name的 属性设置相应的值value, set(x, 'y', v) 等同于 x.y = v delattr(obj, name) 删除对象obj中的name属性 , delattr(x, 'y') 等同于 del x.y 示例: class Dog: pass d = Dog() d.color = "白色" v = getattr(d, "color") # 等同于 v = d.color v = getattr(d, "kinds") # 出错,没有d.kinds属性 v = getattr(d, "kinds", "没有这个属性") # v= '没有这个属性' hasattr(d, 'color') # True hasattr(d, 'kinds') # False setattr(d, 'kinds', '京巴') # 等同于d.kinds ='京巴' hasattr(d, 'kinds') # True delattr(d, 'kinds') # 等同于 del d.kinds hasattr(d, 'kinds') # False 异常(高级): 可以用于异常的语句 try-except # 捕获异常,得到通知 try-finally # 左任何流程(正常/异常)都必须执行要执行的语句 raise # 发送异常 assert # 根据条件发送异常通知with 语句: 语法: with 表达式1[as 变量1], 表达式2[as 变量2].... 作用: 使用与对资源进行访问的场合,确保使用过程中不管 是否发生异常都会执行必要的“清理操作”,并释放资源 (如: 文件使用后自动关闭,线程中锁的自动获取和释放等) 说明: 执行表达式,as子句中的变量绑定生成的对象 with语句并不改变异常的状态示例: # with语句打开文件和自动关闭 try: with open("a.txt") as f: for x in f: print(x) int("abc") # 出现异常 except OSError: print("文件打开失败") except ValueError: print("文件操作过程中错误") # try-finally语句打开文件和关闭 try: f = open("a.txt") for x in f: print(x) except OSError: print("打开文件失败") except ValueError: print("文件操作过程中错误") finally: f.close() # 修改原来的copy文件功能 src_filename = input("请输入源文件路径名: ") dst_filename = input('请输入目标文件路径名: ') try: with open(src_filename, 'rb') as src,\ open(dst_filename, 'wb') as dst: # 打开源文件用来读数据 while True: b = src.read(4096) if not b: # 已经再也读不到数据了 break dst.write(b) print("复制成功") except OSError: print("复制失败") 环境管理器: 类内有__enter__和__exit__实例方法的类被称为环境管理器 能够用with进行管理的对象必须是环境管理器 说明: __enter__将在进入with语句时被调用并返回由as变量绑定的对象 __exit__将在离开with语句时被调用,且可以用参数来判断在 离开with语句时是否有异常发生并作出相应的处理示例: # 一个自定义的类创建的对象能够使用with语句 class A: '''此类的对象可用于with语句进行管理''' def __enter__(self): print("已经进入with语句中,资源分配成功") return self # <<<-- 此处返回的对象将由as变量绑定 def __exit__(self, exc_type, exc_val, exc_tb): print("离开with语句,资源释放成功") if exc_type is None: print("当离开with语句时没有异常") else: print("有异常发生 异常类型:",exc_type , "异常值:", exc_val) with A() as a: print("这是with语句中的语句") raise ValueError("故意制造的异常") 运算符重载: 什么是运算符重载 让自定义的类生成的对象(实例)能够使用运算符进行操作 作用: 1.让自定义的类的实例能够运行运算符操作 2.让程序简洁易读 3.对定义对象将运算符赋予新的运算规则 说明: 运算符重载方法的参数已经有固定含义,不建议改变原有的含义 算数运算符重载: 方法名 运算符和表达式 说明__add__(self, rhs) self + rsh 加法__sub__(self, rhs) self - rsh 减法__mul__(self, rhs) self * rsh 乘法__truediv__(self, rhs) self / rsh 除法__floordiv__(self, rhs) self // rsh 地板除__mod__(self, rhs) self % rsh 求模__pow__(self, rhs) self ** rsh 幂 rhs(self hand side) 右手边 示例: class MyNumber: def __init__(self, val): self.data = val def __repr__(self): return "%d" % self.data def __add__(self, rsh): v = self.data + rsh.data return MyNumber(v) def __sub__(self, rsh): return MyNumber(self.data - rsh.data) n1 = MyNumber(100) n2 = MyNumber(200) n3 = n1 + n2 # 等同于 n3 = n1.__add__(n2) # n3 = n1.__add__(n2) print(t(n1, "-", n2, "=", n1 - n2) 反向算术运算符的重载 当运算符的左侧为内建类型,右侧为自义类型的对象进行算术运算符运算时,会出现TypeError错误, 因无法修改内建类的代码来实现运算符重载,此时需要使用反向算术运算符重载 反向算术运算符重载 方法名 运算符和表达式 说明__radd__(self, lhs) lhs + self 加法__rsub__(self, lhs) lhs - self 减法__rmul__(self, lhs) lhs * self 乘法__rtruediv__(self, lhs) lhs / self 除法__rfloordiv__(self, lhs) lhs // self 地板除__rmod__(self, lhs) lhs % self 取模(求余)__rpow__(self, lhs) lhs ** self 幂 lhs(left hand side) 右手边 示例: # 此示例示意返向算述运算符的重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __mul__(self, rhs): return MyList(self.beta * rhs) print("__mul__ 被到调用") def __rmul__(self, lhs): print("__rmul__ 被到调用") return MyList(self.beta * lhs) # 反向传参 L1 = MyList([1, 2, 3]) L2 = MyList(range(4, 7)) L3 = 2 * L1 # L1.__rmul__(2) print(L3) L5 = L1 * 2 # L5 = L1.__mul__(2) print(L5) # MyList([1, 2, 3, 1, 2, 3]) 复合赋值算术运算符的重载 以复合赋值算术运算符 x += y 为例,此运算会优先调用x.__iadd__(y) 方法, 如果没有__iadd__方法时会将复合赋值运算拆解为 x = x + y,然后调用x = x.__add__(y) 方法 如果再不存在 __add__方法则会触发TypeError异常 其它复合赋值运算符也具有相同的规则 复合赋值算术运算符重载 方法名 运算符和表达式 说明__iadd__(self, lhs) lhs += self 加法__isub__(self, lhs) lhs -= self 减法__imul__(self, lhs) lhs *= self 乘法__itruediv__(self,lhs) lhs /= self 除法__ifloordiv__(self, lhs) lhs //= self 地板除__imod__(self, lhs) lhs %= self 取模(求余)__ipow__(self, lhs) lhs **= self 幂 示例: class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' # self.beta = [x for x in lst] self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __iadd__(self, rhs): self.beta += rhs.beta # id不变 return self def __add__(self, rhs): return MyList(self.beta + rhs.beta) # id会不变 L = MyList([1, 2, 3]) def f1(lst): lst += MyList([4, 5, 6]) f1(L) print(L) 复合赋值算术运算符重载 方法名 运算符和表达式 说明__lt__(self, rhs) self < rhs 小于__le__(self, rhs) self <= rhs 小于等于__gt__(self, rhs) self > rhs 大于__ge__(self, rhs) self >= rhs 大于等于__eq__(self, rhs) self == rhs 等于__ne__(self, rhs) self != rhs 不等于示例: # 此示例示意比较运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __eq__(self, rhs): return self.data == rhs.data def __gt__(self, rhs): return self.data > rhs.data L1 = MyList([1, 2, 3]) L2 = MyList([1, 2, 3]) print(L1 == L2) # True print(L1 > L2) # False # print(L1 == L2) # 如果没有__eq__ 方法判断两个对象的id # print(L1 > L2) # 如果没有__gt__ 方法报错 位运算符重载 方法名 运算符和表达式 说明 __invert__(self) ~ self 取反(一元运算符) __and__(self, rhs) self & rhs 位与 __or__(self, rhs) self | rhs 位或 __xor__(self, rhs) self ^ rhs 位异或 __lshift__(self, rhs) self << rhs 左移 __rshift__(self, rhs) self >> rhs 右移 反向位运算符重载 方法名 运算符和表达式 说明 __rand__(self, lhs) lhs & self 位与 __ror__(self, lhs) lhs | self 位或 __rxor__(self, lhs) lhs ^ self 位异或 __rlshift__(self, lhs) lhs << self 左移 __rrshift__(self, lhs) lhs >> self 右移 复合赋值位运算符重载 方法名 运算符和表达式 说明 __iand__(self, rhs) self &= rhs 位与 __ior__(self, rhs) self |= rhs 位或 __ixor__(self, rhs) self ^= rhs 位异或 __ilshift__(self, rhs) self <<= rhs 左移 __irshift__(self, rhs) self >>= rhs 右移 一元运算符重载 方法名 运算符和表达式 说明 __invert__(self) ~ self 取反(一元运算符) __pos__(self) + self 正号 __neg__(self) - self 负号 语法: def __xxx__(self): 示例: # 此示例示意一元运算符的重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __neg__(self): return MyList((-x for x in self.beta)) def __pos__(self): return MyList((abs(x) for x in self.beta)) # L = [] # for x in self.beta: # if x > 0: # L.append(x) # else: # L.append(-x) # return MyList(L) L1 = MyList([1, -2, 3, -4, 5]) L2 = -L1 print(L2) # MyList([-1, 2, -3, 4, -5]) # 实现用正号运算符返回全部元素为正数的自定义列表 L3 = + L1 print(L3) # MyList([1, 2, 3, 4, 5]) in / not in 运算符重载重载方法:def __contains__(self, e):....示例: # in not in 重载 class MyList: def __init__(self, lst=[]): '''在初始化方法内为每个对象都创建一个bata属性 bata 用来绑定每个对象自己的列表 ''' self.beta = [x for x in lst] # self.bata = list(lst) def __repr__(self): return "%s" % self.beta def __contains__(self, e): return e in self.beta L1 = MyList([1, 2, -3, 4, -5]) print(2 in L1) print(3 in L1) print(4 in L1) print(5 in L1) 索引和切片运算符的重载 方法名 运算符和表达式 说明 __getitem__(self, i) x = self[i] 索引/切片取值 __setitem__(self, i, val) self[i] = val 索引/切片赋值 __delitem__(self, i) del self[i] 删除索引/切片 作用:让自定义的类的对象能够支持索引和切片操作示例: # 此示例示意 索引/切片 运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __getitem__(self, i): print("索引i的值是:", i) return self.data[i] def __setitem__(self, i, v): print("__setitem__被调用, i=", i, 'v=', v) self.data[i] = v def __delitem__(self, i): del self.data[i] L1 = MyList([1, -2, 3, -4, 5]) v = L1[2] # v = 3 print(v) # 3 L1[1] = 2 print(L1) # MyList([1, 2, 3, -4, 5]) del L1[3] print(L1) # MyList([1, 2, 3, 5]) slice 函数: 作用: 用于创建一个slice切片对象,此对象存储切片的信息 格式: slice(start=None, stop=None, step=None) slice对象的属性 s.start 切片的起始值, 默认为None s.stop 切片的终止值, 默认为None s.step 切片的步长, 默认为None示例: # 此示例示意 索引/切片 运算符的重载 class MyList: def __init__(self, iterable): self.data = list(iterable) def __repr__(self): return 'MyList(%s)' % self.data def __getitem__(self, i): print("索引i的值是:", i) if type(i) is int: print("正在进行索引操作") elif type(i) is slice: print("正在进行切片操作") print("起始值是:", i.start) print("终止值是:", i.stop) print("步长值是:", i.step) return self.data[i] def __setitem__(self, i, v): print("__setitem__被调用, i=", i, 'v=', v) self.data[i] = v def __delitem__(self, i): del self.data[i] L1 = MyList([1, -2, 3, -4, 5]) L2 = L1[::2] print(L2) 特性属性 @property 实现其它语言所拥有的 getter 和 setter 的功能 作用: 用来模拟一个属性 通过@property 装饰器可以对模拟属性的取值和赋值加以控制 示例见: 示例: class Student: def __init__(self, s): self.__score = s # 私有属性,不让其它人任意修改成绩 @property def score(self): '''伪装模拟私有一个成绩属性 并返回成绩''' return self.__score @score.setter def score(self, v): '''实现设置者setter , 对用户的复制加以限制''' assert 0 <= v <= 100, "成绩不合法" self.__score = v s = Student(59) print(s.score) # 希望有一个属性能得到成绩 虚拟属性不能复制 s.score = 80 # 通过s.score 来修改成绩 print(s.score) # 修改成功 s.score看似属性 是模拟属性 实际内部已经被替换 问题: L = [1, 2, 3] def f1(lst): lst += [4, 5, 6] f1(L) print(L) # [1, 2, 3, 4, 5, 6] 为什么 L = (1, 2, 3) def f1(lst): lst += (4, 5, 6) # lst = lst + (4, 5, 6) f1(L) print(L) # (1, 2, 3) 为什么 练习: 1. 实现两个自定义的列表相加 class MyList: .... 此处自己实现 L1 = MyList([1, 2, 3]) L2 = MyList(range(4, 7)) L3 = L1 + L2 print(L3) # MyList([1, 2, 3, 4, 5, 6]) L4 = L2 + L1 print(L4) # MyList([4, 5, 6, 1, 2, 3]) L5 = L1 * 2 print(L5) # MyList([1, 2, 3, 1, 2, 3]) 练习: 实现有序集合类 OrderSet() 能实现两个集合的交集 &,全集 |, 补集 - 对称补集 ^, ==/!= , in/ not in 等操作 要求集合内部用 list 存储 class OrderSet: ... s1 = OrderSet([1, 2, 3, 4]) s2 = OrderSet([3, 4, 5]) print(s1 & s2) # OrderSet([3, 4]) print(s1 | s2) # OrderSet([1, 2, 3, 4, 5]) print(s1 ^ s2) # OrderSet([1, 2, 5]) if OrderSet([1, 2, 3]) != OrderSet([3, 4, 5]): print("不相等") if s2 == OrderSet(3, 4, 5): print('s2 == OrderSet(3, 4, 5) is True') if 2 in s1: print("2在 s1中")

优秀的个人博客,低调大师

阿里Java研发工程师实习面经,附面试技巧

作者:如何进阿里链接:https://www.nowcoder.com/discuss/72899?type=0&order=0&pos=17&page=1来源:牛客网 前言 十分幸运 拿到阿里云的offer,感谢周围无数人对我的支持和鼓励,所以写篇面经希望可以帮助大家。 面试中,运气占很大一部分的,所以你们若是没有通过,一定不要气馁,继续加油。 一个学习技巧分享 每个努力的人 都值得钦佩,无论结果如何。我说点面试中的小技巧,可以帮助你更好发挥: 完全可以将学到的知识讲给自己(或者讲给别人),若是自己(别人)听你的讲述 能够听懂(使用自己的话去讲,而不要有专业术语),那么说明 你已经学好了。其原理就是 费曼学习法。感兴趣的人可以去了解下。我个人习惯于 将一个知识点 分解为 xxx是什么,xxx有什么用,如何实现这个功能的(核心的工作流程),缺点是什么(以及为什么有这个缺点,缺点如何补救)。 举个例子: CMS垃圾回收器回收时为什么有内存碎片 , 首先分解为CMS是什么,内存碎片是什么?CMS垃圾回收器有什么用和Serial ParNew Parallel 等比较,优势,CMS是如何工作的,来实现尽可能降低响应时间的,为什么CMS有这个缺点,它是如何取舍的,如何补救这个缺点。 这些子问题都回答好,那么基本上这个问题就学的可以了。 这样可以检测你是否学好,而且,若是你都没法条理清晰地讲给自己,那怎么条理清晰地讲给面试官呢? 接下来就写下三次面试题目: 阿里一面: 1.个人介绍 2.项目介绍,项目介绍首先讲最好的项目,因为后面的项目可能都没时间去讲。 3.数据库 联合索引 用法 4.Spring IOC初始化过程 5.ConcurrentHashMap实现原理 6.CAS操作 7.ReentrantLock和Synchronized区别 8.CMS垃圾回收过程 9.Full GC次数太多了,如何优化。 10.直接内存 如何 管理的 11.线程池 参数。 线程创建的过程。有几种方法。 线程资源如何回收的。 一个题目:如何将一个二叉树,转为有序的双向链表。 阿里二面 1.自我介绍 2.项目介绍 3.堆和栈介绍 4.线程安全 5.乐观锁悲观锁 6.TCP三次握手 7.socket通信有关,select epoll 8.项目中的难点有哪些 我答得是:使用一个组合的设计模式 去解决文章多级分类的问题。 交叉面 1.自我介绍 2.项目介绍 3.做这个项目的动机 4.TCP UDP IP ICMP 5.知不知道一个应用层协议,运输层既没有使用TCP,也没有使用UDP 6.二叉树中求最长路径。 递归的方式去实现。 先求左子树深度,后求右子树深度。相加减一,那么就是以当前结点为转折点的解。 然后递归求左子树的解,和右子树的解。返回当前解,左子树解,右子树解中最大的解。时间复杂度为O(n*logn) 其实可以优化到O(n) ,其实不必求两个子树的解,只需要求较深子树的解即可。 7.有什么想问我的吗? //您觉得成为一个顶尖高手,最重要的是什么呢? 兴趣。做自己感兴趣的事,就不会很疲惫,也会很开心。 //这一点我深有同感。 抓住你的兴趣,做你想做的事,自己驱动自己进步。 //很感谢您的建议。 HR面试 1.自我介绍。 2.项目介绍。项目中难点。得过啥奖没。 3.项目有什么不足? 4.前面的面试 发挥怎么样? 5.前面的面试难度怎样? 愿大家都能拿到自己理想的offer! 欢迎关注我的微信公众号:“Java面试通关手册”(坚持原创,分享美文,分享各种Java学习资源,面试题,以及企业级Java实战项目回复关键字免费领取):

优秀的个人博客,低调大师

在 React 工程中利用 Mota 编写面向对象的业务模型

简述 React 是一个「视图层」的 UI 框架,以常见的 MVC 来讲 React 仅是 View,而我们在编写应用时,通常还需要关注更加重要的 model,对于 React 来讲,我们常常需要一个「状态管理」库。然而,目前大多数针对 React 的状态管理库都是「强依赖」过多的侵入本应该独立的业务模型中,导致「业务逻辑」对应的代码并不能轻易在其它地方重用,往往这些框架还具有「强排它性」,但是「业务模型」应该是没有过多依赖,应该是无关框架的,它应该随时可以被用在任何合适的 JavaScript 环境中,使用 mota 你可以用原生的普通的 JavaScript 代码编写你的「业务模型」,并让你的「业务模型」在不同框架、不同运行环境下重用更为容易。 mota 是一个主张「面向对象」的、支持「双向绑定」的 React 应用辅助库,基于

优秀的个人博客,低调大师

2018最新java工程师面试笔试题集锦(一)

找工作有一段时间啦,走了不少弯路;特此提醒,基础很重要,笔试题是打开大门的钥匙;机会虽然很多,但一定要牢牢把握住每一次;拥有选择的权利,不论是心情还是未来都将是无怨无悔的! struts2: Struts2是一个基于MVC设计模式的Web应用框架,它本质上相当于一个servlet,在MVC设计模式中,Struts2作为控制器(Controller)来建立模型与视图的数据交互。Struts 2的Action是一个请求对应一个实例(每次请求时都新new出一个对象),没有线程安全方面的问题。 Struts 2 相比Struts 1的优点: 1、在软件设计上Struts 2 没有像Struts 1那样跟Servlet API 和 struts API 有着紧密的耦合。 Struts 2的应用可以不依赖于Servlet API和Struts API 。 2、Struts 2 提供了拦截器,利用拦截器可以进行AOP编程。 3、Struts 2 提供了类型转换器。 4、Struts 2 提供支持多种表现层技术,如:JSP 、 freeMarker等。 5、Struts 2 的输入校验可以指定方法进行校验。 6、Struts 2 提供了全局范围、包范围和Action范围的国际化资源文件管理实现。 JSP: Jsp包含三个编译指令和七个动作指令。 三个编译指令为:page、include、taglib。 七个动作指令为:jsp:forward、jsp:param、jsp:include、jsp:plugin、jsp:useBean、jsp:setProperty、jsp:getProperty。 〈% @page [language=”Java”] [extends=”package.class”] [import= “package. class I package. *},…”] [session=”true I false”] [buffer=”none I 8kb I size kb” 1 [autoFlush=”true I false”] [isThreadSafe=”true I false”] [info=”text”] [errorPage=”relativeURL”] [contentType=”mimeType[ ;charset=characterSet]” I”text/html;charset= “808859-1”] [isErrorPage=” true I false”] %〉 JSP中有三种形式的脚本,要理解这三种脚本,应该先理解JSP的运行模式,JSP文件有两种形态:设计时的JSP文件和运行时态的Servlet,当用户访问一个JSP文件的时候,这个JSP文件首先会被编译生成Servlet代码,然后这个Servlet会被编译运行,从而产生动态页面,所以JSP中的JAVA脚本都会被作为Servlet类中的代码存在。 1.声明式脚本。jsp中编写方式如下:<%! %>。在<%! %>中的的变量和方法都是作为()类的成员存在的,所以这种脚本称作声明式脚本,用来声明类的成员属性和方法的。 2.普通脚本。又称作Jsp ScriptLet,jsp中编写方式如下:<% %>。在脚本<% %>中的代码是作为servlet类的service方法的一部分存在的,即在<%%>中的变量是局部变量,而不能编写方法,因为java中不允许在方法中再直接定义方法,所以这种脚本称作普通脚本,因为就是普通的java代码。 3.表达式脚本。编写方式如下:<%= %>。在jsp对应的servlet类的service方法中<%= %>中的内容是作为out.print()方法的参数存在的,作用是在浏览器页面上输出内容,所以<%= %>中必须是有结果的表达式用于输出,所以这种脚本称作表达式脚本。 一、String,StringBuffer, StringBuilder 的区别是什么?String为什么是不可变的? 1. String是字符串常量,StringBuffer和StringBuilder是字符串变量。StringBuffer是线程安全的,StringBuilder是非线程安全的。具体来说String是一个不可变的对象,每次修改String对象实际上是创新新对象,并将引用指向新对象。效率很低。StringBuffer是可变的,即每次修改只是针对其本身,大部分情况下比String效率高,StringBuffer保证同步(synchronized),所以线程安全。StringBuilder没有实现同步,所以非线程安全。但效率应该比StringBuffer高。StringBuffer使用时最好指定容量,这样会比不指定容量快30%-40%,甚至比不指定容量的StringBuilder还快。 二、VECTOR,ARRAYLIST, LINKEDLIST的区别是什么? vector是同步的,arraylist和linkedlist不是同步的。底层方面,vector与arraylist都是基于object[]array实现的,但考虑vector线程安全,所以arraylist效率上回比vector较快。元素随机访问上,vector与arraylist是基本相同的,时间复杂度是O(1),linkedlist的随机访问元素的复杂度为O(n)。但在插入删除数据上,linkedlist则比arraylist要快很多。linkedlist比arraylist更占内存,因为linkedlist每个节点上还要存储对前后两个节点的引用。 四、ConcurrentHashMap和HashTable的区别 两者均应用于多线程中,但当HashTable增大到一定程度时,其性能会急剧下降。因为迭代时会被锁很长时间。但ConcurrentHashMap则通过引入分割来保证锁的个数不会很大。简而言之就是HashTable会锁住真个map,而ConcurrentHashMap则只需要锁住map的一个部分。 五、Tomcat,apache,jboss的区别 Tomcat是servlet容器,用于解析jsp,servlet。是一个轻量级的高效的容器;缺点是不支持EJB,只能用于Java应用。 Apache是http服务器(web服务器),类似于IIS可以用来建立虚拟站点,编译处理静态页面。支持SSL技术,支持多个虚拟主机等功能。 Jboss是应用服务器,运行EJB的javaee应用服务器,遵循javaee规范,能够提供更多平台的支持和更多集成功能,如数据库连接,JCA等。其对servlet的支持是通过集成其他servlet容器来实现的。如tomcat。 七、SESSION, COOKIE区别 session数据放在服务器上,cookie则放在客户浏览器上。cookie不太安全,因为可以分析出本地cookie,并进行cookie欺骗,考虑安全应使用session。session会在一定时间内保存在服务器上,当访问增多时,会比较占用服务器的性能,考虑减轻服务器压力则应该使用cookie。单个cookie保持的数据不超过4k,很多浏览器都限制要给站点最多保存20个cookie。 八、Servlet的生命周期 主要分三个阶段:初始化——调用init()方法,响应客户请求阶段——调用service()方法,终止阶段——调用destroy方法。工作原理:客户发送一个请求,servlet调用service方法对请求进行响应,即对请求方式进行匹配,选择调用doGet、doPost方法等,然后进入对于的方法中调用逻辑层的方法,实现对客户的响应。自定义的servlet必须首先servlet接口。 具体生命周期包括:装载Servlet、服务器创建Servlet实例、服务器调用Servlet的init()方法、客户请求到达服务器、服务器创建请求对象、服务创建相应对象、服务器激活Servlet的service方法,请求对象和响应对象作为service()方法的参数、service()方法获得关于请求对象的信息,处理请求,访问其他资源,获得需要的信息、service()方法可能激活其他方法以处理请求,如doGet(),doPost() 九、HTTP 报文包含内容 (请求行,请求头部,请求正文) 请求方法包括GET,POST,HEAD,PUT,TRACE,OPTIONS,DELETE。请求头如:Host、User-Agent、Connection、Accept-Charset等。请求头部的最后会有一个空行,表示请求头部结束,接下来为请求正文,这一行非常重要,必不可少。请求正文为可选部分,如get就没有。 十、Statement与PreparedStatement的区别,什么是SQL注入,如何防止SQL注入 使用PreparedStatement可以提升代码的可读性和可维护性,可以尽最大可能提高性能。因为Statement每次执行一个SQL命令都会对其编译,但PreparedStatement则只编译一次。PreparedStatement就类似于流水线生产。另一方面PreparedStatement可以极大提高安全性:它对传递过来的参数进行了强制参数类型转换,确保插入或查询数据时,与底层数据库格式匹配。 SQL注入:就是通过将sql命令插入到web表单递交或输入域名或页面请求的查询字符串,最终达到欺骗服务器执行恶意SQL命令。如sql命令:select id from test where name=’1’ or 1=1; drop table test,但用PreparedStatement就可以避免这种问题。 十一、redirect, forward区别 redirect:服务器根据逻辑,发送一个状态码,告诉浏览器重新去请求那个地址。所以地址栏显示是新的url。forward是指服务器请求资源,直接访问目标地址url,把响应的内容读取过来并再发送给浏览器,浏览器并不知道资源从哪里来,所以地址栏不变。 redirect不能共享数据,forward转发页面和转发到页面可以贡献request中的数据。redirect用于注销,forward用于登陆。forward效率高于redirect。 十、Statement与PreparedStatement的区别,什么是SQL注入,如何防止SQL注入 使用PreparedStatement可以提升代码的可读性和可维护性,可以尽最大可能提高性能。因为Statement每次执行一个SQL命令都会对其编译,但PreparedStatement则只编译一次。PreparedStatement就类似于流水线生产。另一方面PreparedStatement可以极大提高安全性:它对传递过来的参数进行了强制参数类型转换,确保插入或查询数据时,与底层数据库格式匹配。 SQL注入:就是通过将sql命令插入到web表单递交或输入域名或页面请求的查询字符串,最终达到欺骗服务器执行恶意SQL命令。如sql命令:select id from test where name=’1’ or 1=1; drop table test,但用PreparedStatement就可以避免这种问题。 十二、关于JAVA内存模型,一个对象(两个属性,四个方法)实例化100次,现在内存中的存储状态,几个对象,几个属性,几个方法。 Java新建的对象都放在堆里,如果实例化100次,堆中产生100个对象,一般对象与其属性和方法属于一个整体,但如果属性和方法是静态的,则属性和方法只在内存中存一份。 mysql连接数据库 Class.forName(“com.sql.jdbc.Driver”); Connection ct=DriverManager.getConnection (“jdbc:mysql://127.0.0.1:3360/first”,”root”,”123”); PreparedStatement ps=ct.preparedStatement(sql); ResultSet rs=ps.executeQuery(); float型float f=3.4是否正确? 不正确。精度不准确,应该用强制类型转换,如下所示:float f=(float)3.4 或float f = 3.4f 在java里面,没小数点的默认是int,有小数点的默认是double; structs 1.是一个框架(基于mvc的一个web框架) 2. (规范化,效率高,可读性好,可维护性增加;) mvc模式(模式是一种思想)(model view control) 将数据的输入,处理(model)和显示分开(jsp) 对mvc的理解不同,写程序时规范不统一,不利维护扩展效率,所以 有了统一的规范structs structs运行原理: 用户登录: 浏览器 web服务器 ActionServlet(struts-config.xml) actionform Loginaction model jsp static表示不要实例化就可以使用。被static修饰的成员变量和成员方法不依赖类特定的实例,被类的所有实例共享。 对于静态变量在内存中只有一个拷贝(节省内存),JVM只为静态分配一次内存,在加载类的过程中完成静态变量的内存分配,可用类名直接访问(方便),当然也可以通过对象来访问(但是这是不推荐的)。 一般在需要实现以下两个功能时使用静态变量: 在对象之间共享值时(多个变量共享一个值:如所有学生公用一个变量学费) 方便访问变量时 类变量是该类的所有对象共享的变量,任何一个该类的对象去访问它时,取到的都是相同的值,任何一个该类的对象去修改它时,修改的也是同一个变量。 静态区域块只被执行一次,且自动执行不需实例化。利用静态代码块可以对一些static变量进行赋值。 类变量原则上用类方法去访问;类方法中不许访问非静态变量,反之可以;静态方法中不能用this和super关键字。 类方法属于类相关的、公共的方法 static方法独立于任何实例,static方法必须被实现,而不能是抽象的abstract。 一般类内部的static方法也是方便其它类对该方法的调用。 如果一个成员被声明为static,它就能够在它的类的任何对象创建之前被访问,而不必引用任何对象。 spring Spring是全面的和模块化的。Spring有分层的体系结构,你能选择使用它孤立的任何部分,它的架构仍然是内在稳定的。 Spring作为开源的中间件,独立于各种应用服务器,甚至无须应用服务器的支持,也能提供应用服务器的功能,如声明式事务、事务处理等。 Spring致力于J2EE应用的各层的解决方案,而不是仅仅专注于某一层的方案。可以说Spring是企业应用开发的“一站式”选择,并贯穿表现层、业务层及持久层。然而,Spring并不想取代那些已有的框架,而是与它们无缝地整合。 轻量、控制反转ioc、面向切面、容器、框架、mvc servlet生命周期:创建实例,init初始化,service方法处理,destroy方法销毁。 int 是基本类型,直接存数值 integer是对象,用一个引用指向这个对象(一个类) int i =1; Integer i= new Integer(1);(要把integer 当做一个类看) Integer 是一个类,是int的扩展,定义了很多的转换方法 类似的还有:float Float;double Double;string String等 举个例子:当需要往ArrayList,HashMap中放东西时,像int,double这种内建类型是放不进去的,因为容器都是装object的,这是就需要这些内建类型的外覆类了。 Java中每种内建类型都有相应的外覆类。 Java中int和Integer关系是比较微妙的。关系如下: 1.int是基本的数据类型; 2.Integer是int的封装类; 3.int和Integer都可以表示某一个数值; 4.int和Integer不能够互用,因为他们两种不同的数据类型; 引入的原因:为了在各种类型间转化,通过各种方法的调用。否则 你无法直接通过变量转化。 比如,现在int要转为String int a=0; String result=Integer.toString(a); 在java中包装类,比较多的用途是用在于各种数据类型的转化中。 JVM是一个”桥梁“,是一个”中间件“,是实现跨平台的关键,Java代码首先被编译成字节码文件,再由JVM将字节码文件翻译成机器语言,从而达到运行Java程序的目的。 JVM 有一个选项,可以将使用最频繁的字节码翻译成机器码并保存,这一过程被称为即时编译。这种方式确实很有效, JVM 自己的命令集,JVM 的命令集则是可以到处运行的,因为 JVM 做了翻译,根据不同的CPU ,翻译成不同的机器语言。 Java 中的所有类,必须被装载到 JVM 中才能运行,这个装载工作是由 JVM 中的类装载器完成的,类装载器所做的工作实质是把类文件从硬盘读取到内存中。 2. Java中的类大致分为三种: a) 系统类 b) 扩展类 c) 由程序员自定义的类 3. 类装载方式,有两种: a) 隐式装载,程序在运行过程中当碰到通过 new 等方式生成对象时,隐式调用类装载器加载对应的类到jvm中。 b) 显式装载,通过 class.forName() 等方法,显式加载需要的类。 原文地址http://www.bieryun.com/691.html

优秀的个人博客,低调大师

Web开发工程师转型机器学习的实战经验

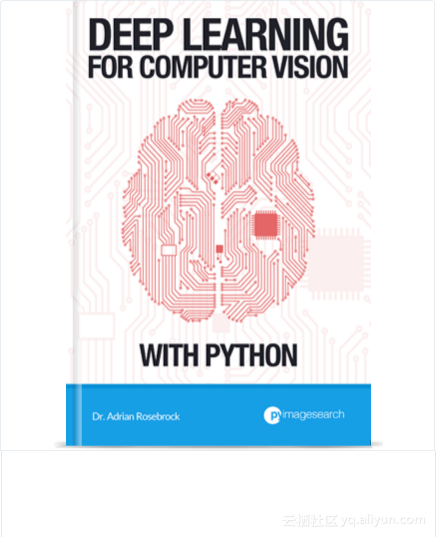
作为一名Web开发人员,我发现计算机视觉和机器学习领域的快速发展是让人感到兴奋,但是我没有任何使用这些技术的背景经验。最终,我决定用两年的时间来转型。 开始学习 在一本涵盖深度学习和计算机视觉的书出版的时候,我开始了这段转型之旅。来自PyImageSearch.com的作者Adrian Rosebrock编写了一个三卷巨著,它涵盖了计算机视觉和深度学习的高层思想和低层应用。在探索深度学习的同时,我遇到了对线性回归、朴素贝叶斯(Naive Bayesian)应用、随机森林/决策树学习等诸多新的算法。 我花了几个星期的时间阅读这本书,并且把所有已经读过的各种博文和数学概念的队列、抽象思维的概念以及它实际的编程应用联系起来。我很快就读完了这本书,从而更好地理解了如何从整体上走进这个领域。我获得的最大的结论:筹备自己

优秀的个人博客,低调大师

Linux运维工程师笔试题第十三套

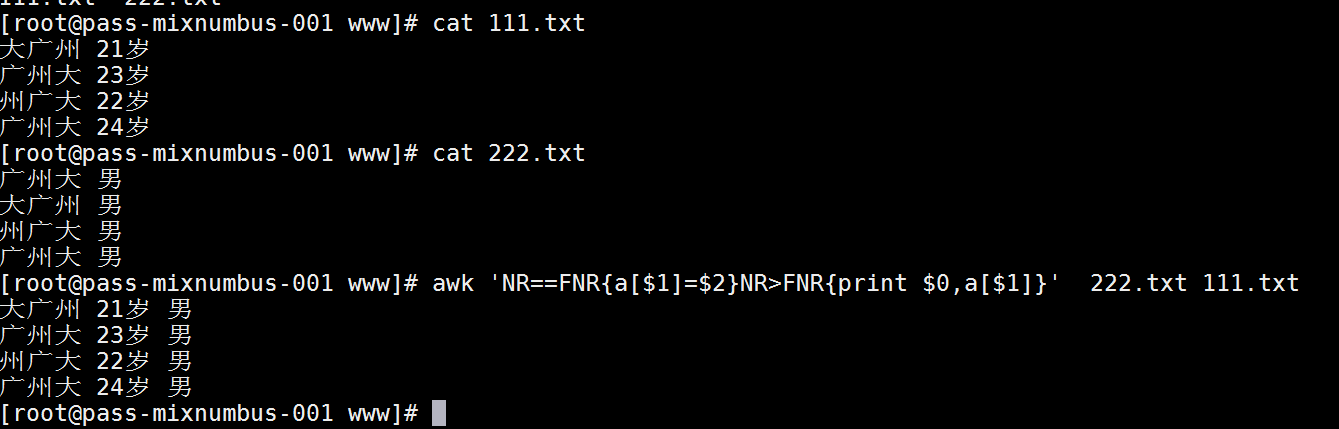
这套题的出处是http://blog.51cto.com/nolinux/1670406 ,看到了周末闲着没事就做一做,答案都是我结合自己的工作得到的,不一定百分百准确,现在拿出来跟各位分享一番。 1、请写出五种系统性能分析工具,并简述其作用和特点 [我的答案] top、free、vmstat、iostat、perf等等等等,如果你想装逼,可以回答fio,blktrace,oprofile。 具体的作用和特点这里不多说了,但是我着重要推荐vmstat,很实用很棒的一个命令。可以去移步看看https://rorschachchan.github.io/2018/01/03/从vmstat命令里看服务器瓶颈/这篇文章。 2、请写出web服务器的调优要点 [我的答案]以nginx为例,个人总结有如下几个要点: 1)尽可能的少用http,因为http是有开销的; 2)尽可能的使用CDN; 3)添加Expire/Cache-Control头,这个头是缓存用的,可以缓存图片和flash那样不轻易更改的文件,减少访问时间; 4)启动gzip压缩,这个没啥好说的了; 5)尽可能少的重定向,重定向是需要时间的,增加一次重定向就会多一次web需求; 6)如果可以,把ajax也做缓存; 7)减少dns查询,很多网页会有外站的广告,这些广告也是会启动dns查询的,所以如果不缺钱,减少这种广告; 8)调好服务器里的TCP协议栈,这个无论是web服务器还是应用服务器都是必须的; 3、请写出你知道或使用过的nginx扩展模块(注意标注知道和使用) [我的答案] 随便说几个我使用过的,这玩意到时候结合工作过的情况说说吧: Nginx负载均衡模块:nginx-upstream-fair 非阻塞访问redis模块:redis2-nginx-module 分布式图片实时动态压缩:ngx-fastdfs4、请简述你了解的自动化配置管理工具特点和运行原理 [我的答案]我用的最多的就是ansible和saltstack,这俩都是python的,对于我这个半路出家的更亲切。 ansible基于SSH协议传输数据,不用装agent,配置比较简单,对windows支持惨不忍睹; saltstack使用消息队列zeroMQ传输数据,如果1000台以上的话它速度比ansible还要快,要安装agent,对windows支持同样惨不忍睹; 5、目前,有一个文件,内容如下:172.16.100.1172.16.100.2172.16.100.3172.16.100.4 请使用while和ssh命令,登录文件内的ip并执行hostname命令 [我的答案]这个还真没有什么思路,不过我觉得是要搭配“<”输入重定向的吧。 PS,为啥不用ansible...哪怕pssh也可以啊! 6、请使用awk命令将如下两份文件中名字相同的两行合并起来 A文件:大广州 21岁广州大 23岁州广大 22岁广州大 24岁 B文件:广州大 男大广州 男州广大 男广州大 男 输出效果:`大广州 21岁 男` [我的答案]#awk 'NR==FNR{a[$1]=$2}NR>FNR{print $0,a[$1]}'B文件名A文件名 PS,做完这道题,我已经不认识“广”“州”这两个字了...7、请使用绘图的方式简述TCP/IP三次握手和四次断开的交互过程 [我的答案]这种图满大街都是了,我这个灵魂画师在这里就不污染各位的眼睛,不过这里推荐各位去看一篇文章:https://mp.weixin.qq.com/s?__biz=MjM5NzA1MTcyMA==&mid=2651160450&idx=2&sn=1128438fa5287b6cee503880698642b2&scene=21 对原理讲的浅显易懂。 多说一句,网易招聘java的时候也问这个问题,不过他们问的是“为什么要三次握手?” 8、请根据你的理解,简述高可用服务体系的相关组件,并列举该组件的具体实现服务名字 [我的答案] 我觉得这个题是要问一些架构上的东西,以我工作环境为例: 统一配置:zookeeper、Consul、Etcd+Confd(这俩比较常见于动态管理nginx) 前端展示:nginx 消息队列:activemq、kafka 读写分离中间件:atlas 日志分析:elk 简述我就不简了,自己百度一下。9、请根据你的理解,简述负载均衡的实现方式 [我的答案]负载均衡主要分为两种,硬件(F5)和软件(NGINX、Haproxy、LVS),硬件效果比较牛逼,它是把4-7层的负载均衡功能做到一个硬件里面,但是价格昂贵最近用的越来越少了。 软件的负载均衡又分两种,四层和七层:四层是在IP/TCP协议栈上把网络包的IP地址和端口进行修改,达到转发的目的;七层就是在应用层里把HTTP请求、URL等具体的应用数据发送到具体的服务器上。四层的效率比七层的高,四层一般安排在架构的前端,七层一般就是在具体服务器的前端。 软件负载均衡比较常见的几个分配方式如下: 轮询:访问请求依序分发给后端服务器; 加权轮询:访问请求依序分发后端服务器,服务器权重越高被分发的几率也越大; 最小连接数: 将访问请求分发给当前连接数最小的一台后端服务器,服务器权重越高被分发的几率也越大;10、请根据你的理解,简述数据迁移工具和数据存储服务有哪些以及相关特点 [我的答案]由于我公司主要都放在了阿里云,数据库用过的就这么几个:mysql、redis和elasticsearch。对于Storm和Hadoop这俩我还是初学者。 mysql:关系型数据库; elasticsearch:全文检索框架,这玩意逐渐向一个数据库靠拢了; redis:键值储存数据库; mysql的数据迁移最常见的就是mysqldump,但是要注意使用不当会锁表; redis的数据迁移最稳妥的方法就是主从同步:在slave端启动redis,然后执行#slaveof master机器IP地址 6379,然后使用#info的时候查看#master_link_status如果是up那就是OK了,再执行#slaveof no one,提示OK就是OK了; Elasticsearch的数据迁移工具就是Elasticsearch-Exporter,不过我对它仅仅只是了解,用的并不多; 最后的最后,如果您觉得本文对您升职加薪有帮助,那么请不吝赞助之手,刷一下下面的二维码,赞助本人继续写更多的博文! 本文转自 苏幕遮618 51CTO博客,原文链接:http://blog.51cto.com/chenx1242/2058818

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册