首页 文章 精选 留言 我的

精选列表

搜索[内核发布],共10000篇文章
优秀的个人博客,低调大师

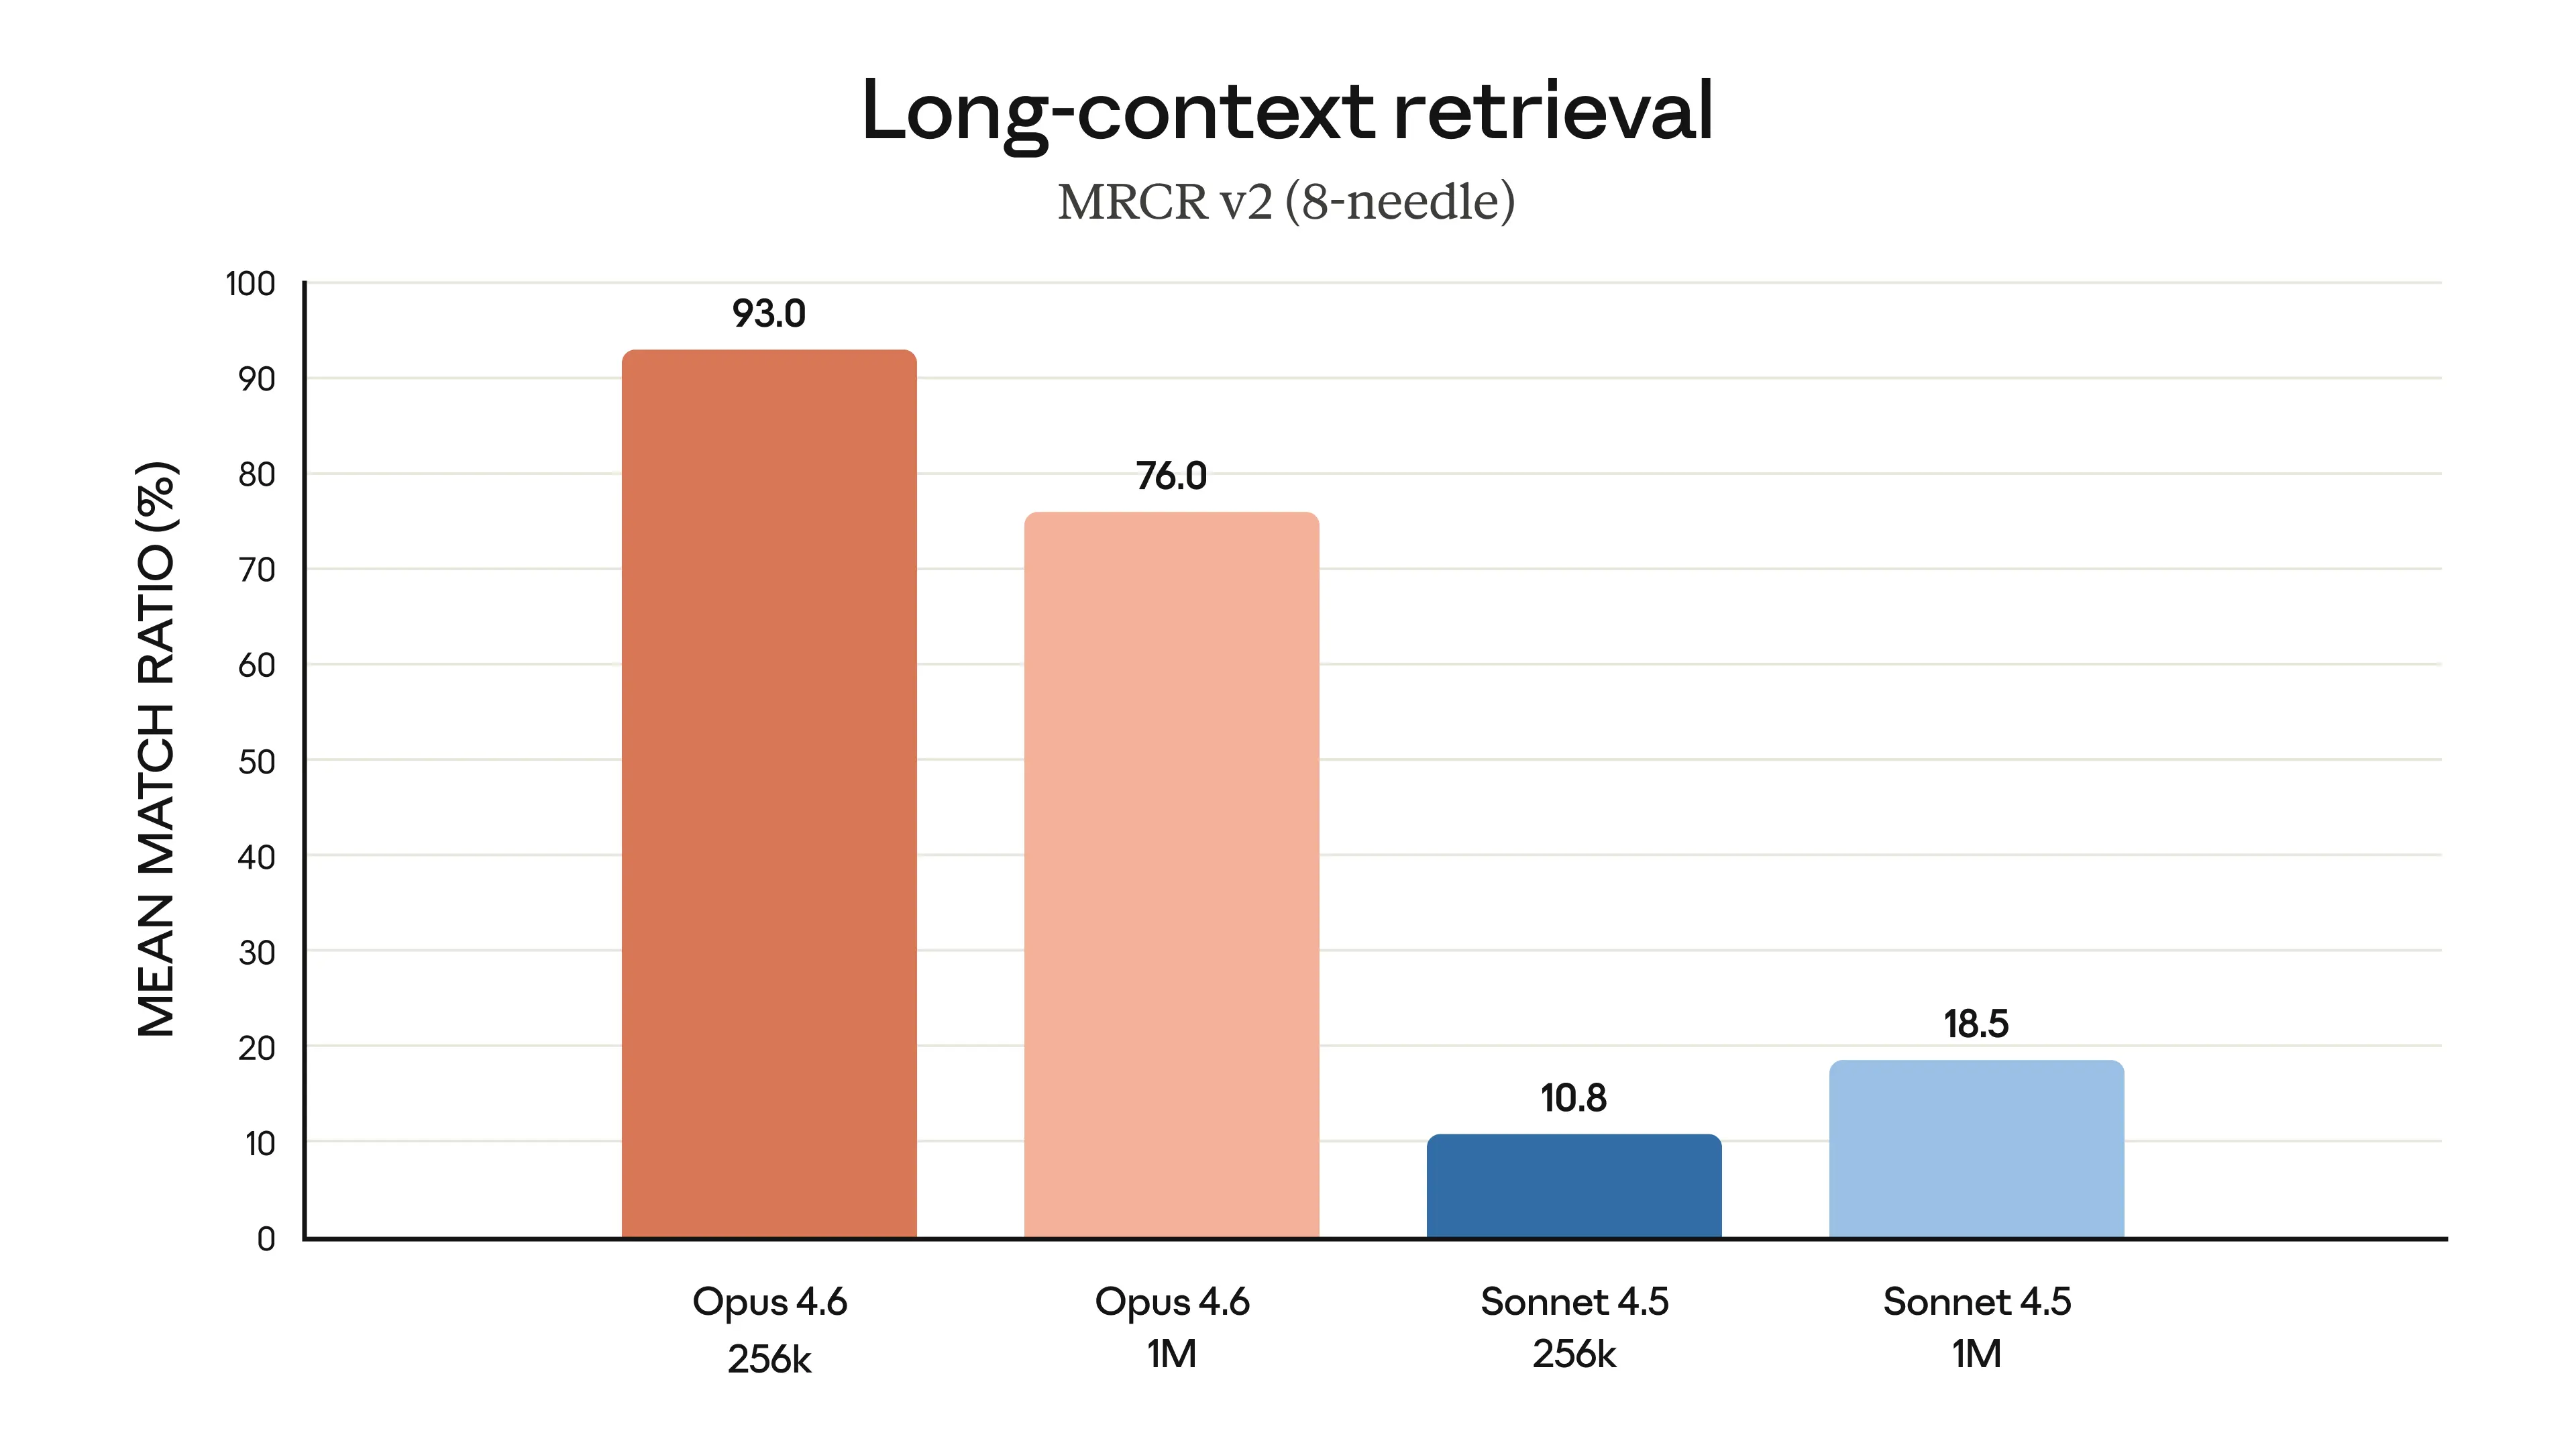
Anthropic 发布全新旗舰模型 Claude Opus 4.6

Anthropic 于 2026 年 2 月 5 日正式推出其最新一代旗舰 AI 模型 Claude Opus 4.6,这是继 4.5 之后的又一重大更新,定位为更强大的通用智能引擎,面向开发者、企业和专业工作场景。 更新亮点如下: 增强复杂推理与任务执行 Opus 4.6 在任务规划和深入推理能力上显著提升,能更稳健地拆分和完成复杂、多步骤的自动化任务。 1 百万 Token 长上下文支持(Beta) 首次引入 1,000,000 Token 的大规模上下文窗口,让模型能一次性处理更大篇幅的文本、代码仓库或复杂分析任务,这是当前少数支持如此规模上下文的主流大模型之一。 多智能体协作(Agent Teams) 新的 “Agent Teams” 支持将大型任务拆分给多个 AI 子代理并行工作,提高效率和可靠性,尤其适合工程项目和复杂自动化流程。 自适应思考模式 引入 adaptive thinking(自适应思考),使模型根据问题难度在深入推理与快速响应之间动态调整,提高效率同时减少不必要的计算成本。 大幅提升编程与审查能力 在代码生成、调试、复杂代码库审查和长期自动化任务能力方面,Opus 4.6 在多项行业基准上均刷新最高成绩,远超前代版本。 Claude Opus 4.6 是 Anthropic 迄今为止最强大的 AI 模型,在上下文理解、复杂规划、自动化代理协作以及跨领域应用方面实现显著突破。它不仅针对开发者和工程任务进行了优化,还进一步扩展到办公自动化、金融分析和专业知识工作场景,展示了通用人工智能技术在实际生产力中的落地潜力。 Claude Opus 4.6 目前已上线 Claude.ai、API 及主流云平台,支持多场景应用。定价保持原有标准:每百万 token 输入/输出,价格是 5 美元 / 25 美元。不过在 10M token 上下文测试版本中,提示词超过 200k token 的话会有额外付费。 开发者如需接入 Claude Opus 4.6,请注意在调用 API 的时候明确模型标识claude-opus-4-6。
优秀的个人博客,低调大师

阿里云全新发布的 UModel 是什么

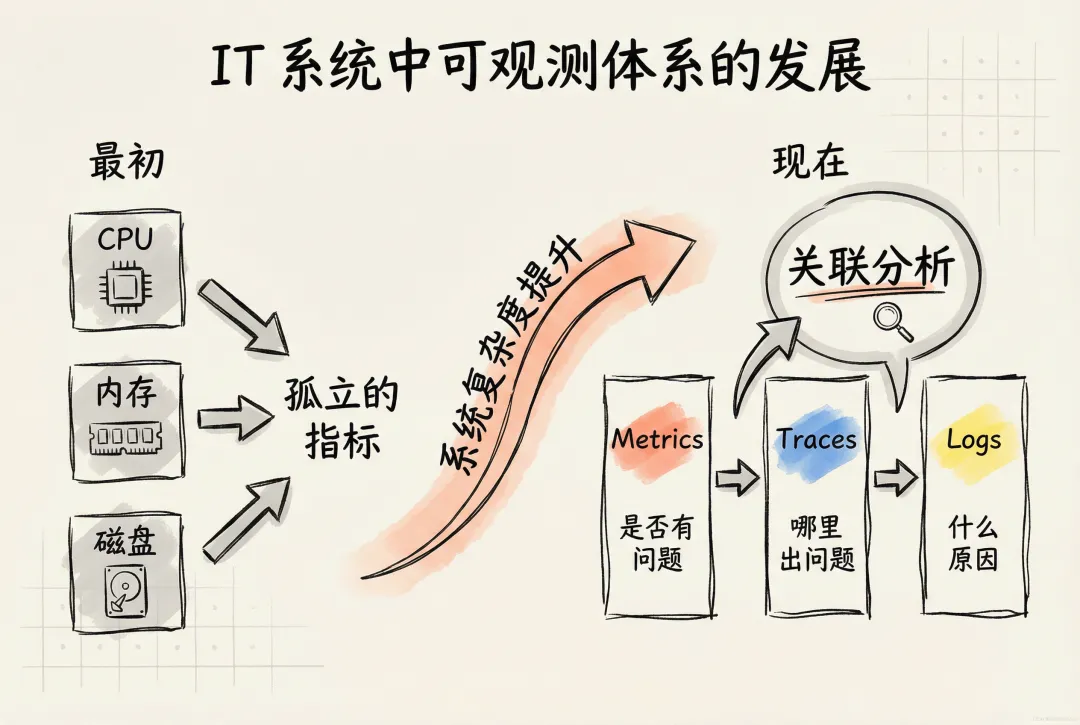
作者:望宸 每个时代基础设施的变革,都始于对"混乱"的优雅重组。19 世纪,钢铁把不可控的垂直空间变成工程秩序,城市才得以向上生长;20 世纪,电网将分散的能源重新编排,工业生产才不再被河流左右。而如今的 IT 领域,我们正面临一场新的秩序重建,即如何让海量、碎片化、动态变化的观测数据,不再是噪音,而成为可理解、可推理、可优化智能体行为的燃料? 要回答这个问题,我们先简单回溯下:IT 系统的可观测体系是如何走到今天的? IT 系统中可观测体系的发展 最初,企业面向单一数据类型构建监控体系,CPU 使用率、内存占用、磁盘 I/O......一个个孤立的指标就像烽火台,只能通过局部视角告诉我们"什么地方出了问题"。 但随着微服务、容器技术的普及,系统复杂度呈指数级增长。企业开始意识到:单点指标无法解释全局。于是开始对孤立的数据进行抽象,抽象出 Metrics(指标)、Traces(链路追踪)和 Logs(日志),并进行关联分析: Metrics: IT 系统是否有问题; Traces: 哪里出了问题; Logs: 问题是由什么原因导致的。 发展至今,成为观测体系的三大数据支柱。 但从海量、异构、动态变化的数据中准确推理并定位问题,本质上是一个极其困难的逆向工程。数据只是现象,而现象与本质之间往往存在巨大的认知鸿沟 [ 1] 。 Metrics、Traces 和 Logs 这看似完整的三角,实则仍停留在现象观测层面,是 L1 级智能体的典型工作流,人工设计流程节点、人工配置触发、人工调用 API,再把指标、链路、日志喂给 AI,期望它自己找出因果,结果往往是幻觉式归因:把时间上的巧合当作逻辑上的因果。为什么?因为在 AI 面前,缺少对系统本质的建模。 在 AI 时代,加剧了这种模式的挑战。一是 LLM 驱动的应用带来了上下文的碎片化。运维工程师每天要在不同的控制台之间切换,手动拼凑"发生了什么"。这就像在信息高速公路上骑自行车,工具很先进,但认知方式仍是人力驱动。二是相比由工程师写的代码定义的传统 IT 系统,AI 带来了更多的不确定性,指数级提升了原始数据自动化关联的难度,给准确推理并定位问题的挑战添了堵。 总结起来,原本的认知鸿沟,被进一步分化成三层新的鸿沟 [ 2] : 数据鸿沟:原始数据混杂、碎片化、噪声多,99% 以上可能是无效信息,难以从中有效提取信号。 模型鸿沟:AI 模型存在"黑盒"特性,推理过程难以解释;还可能出现"幻觉",生成看似合理但不符合事实的结果。 工程鸿沟:每天数 PB 级的数据采集、清洗、存储、计算,对性能、成本、安全性提出极高要求。 数据到建模 让一个没见过电路图的人,从一堆电压表读数中定位并恢复故障服务器,是不现实的。 当前市面上大多数的 AI 运维助手,本质上仍是 L1 级智能体:它们被封装在一个封闭的对话框里,被动响应用户提问,背后是一连串预设的 if-else 规则或简单 RAG 检索。它们没有对系统结构的内生理解,无法主动推理依赖路径,更谈不上安全执行修复操作。 而要迈向 L2 甚至 L3 级智能体,即能自主感知、规划、行动并持续学习的数字员工,就必须为其构建一个结构化的运行时上下文,不然只能靠人的经验来排查、定位和解决问题。这个上下文是经过建模、带有语义、支持查询与推理的图谱。有了这张图,智能体就能避免在数据海洋中盲目打捞,而是在一个有路标、有规则、有边界的城市中穿行。 因此,出路不在更多的数据,而在更好的建模。先为 IT 系统建立一张认知地图。这张图要包含实体(主机、服务、数据库)、关系(调用、依赖、部署)、行为(日志事件、性能指标)以及它们之间的语义约束。只有在这张图上,智能体才能像经验丰富的老运维一样,快速定位故障并恢复生产。 UModel 正是这张图的建模语言。我们需要从"数据驱动"转向"建模驱动",从面向现象的观测,转向面向本质的建模,构建一个统一的上下文图谱,这正是 UModel 的使命。 什么是 UModel UModel(Universal Observability Model)是基于图模型的可观测数据建模方法。 又是图模型,又是建模,一听就很学术。通俗易懂的讲,就是用"画图"的方式,把一堆随机事件之间的概率关系理清楚,让复杂变简单,让模糊变清晰。因此,UModel 旨在通过标准化的数据建模方式,实现可观测数据的统一表示、数据建模与具体存储的解耦,从而实现智能分析。有了 UModel,智能体才能像经验丰富的老运维那样快速定位故障并恢复生产,成为可能。UModel 可以看成是阿里云可观测体系的数据建模基础。 总的来讲,UModel 的核心思想,是为可观测领域打造一个认知操作系统,是一套标准化的数据建模方法,旨在弥合前文所述的三重鸿沟,为 AIOps 提供可解释、可扩展、可自动化的基础。 接下来,我们从 UModel 的构成和使用方式来看看它是如何把零散、杂乱的可观测数据,画成一张结构清晰、智能体能理解的图。 UModel 的构成和使用方式 企业习惯于将系统中的每个组件,例如应用、容器、中间件、网关、数据库,视为独立的实体进行监控和管理,并为它们配置仪表盘,设置告警,追踪性能表现。传统的监控和查询工具,无论是基于 SQL 还是 SPL,其核心都是处理二维的、表格化的数据。它们擅长回答关于个体的问题(这个 Pod 的 CPU 使用率是多少?),但在回答关于关系的问题时却显得力不从心。 当面对"这个服务的故障会影响哪些下游业务?"或"要访问到核心数据库,需要经过哪些中间服务?"这类问题时,传统工具往往需要复杂的 JOIN 操作、多步查询,甚至需要工程师结合线下架构图进行人脑拼凑。这种方式不仅效率低下,而且在关系复杂、层级深的情况下几乎无法完成。我们拥有了所有"点"的数据,却失去了一张看清"线"的地图 [ 3] 。 因此,UModel 将要解决以下四个关键问题: 1. 重新定义系统里有什么 通过 Entity 来统一定义所有可观测实体的实例,包括容器实例、服务实例等,例如服务实例 "order-service"、Pod 实例 "web-pod-001"。 2. 对实例进行建模 通过 EntitySet 建立实体集,并进行实体建模。将系统组件抽象为 EntitySet,一个 EntitySet 可对应多个 Entity: 基础设施实体:主机、容器、网络设备、存储系统; 应用层实体:微服务、API 接口、数据库实例、消息队列; 业务实体:用户会话、业务流程、交易订单; 运维实体:部署环境、代码仓库、运维人员。 除了进行实体建模,还需要进行: 数据集建模:将日志、指标、链路追踪、事件和性能剖析等多种可观测数据类型抽象为 TelemetryDataSet,由此衍生出 LogSet、TraceSet、EventSet、ProfileSet、MetricSet 等更具体的观测数据集。 存储建模:Storage 是 UModel 中数据集底层存储的抽象,定义了数据的实际存储位置和访问方式。通过存储建模,UModel 能够统一对接多种存储后端,为用户提供一致的数据访问体验。 3. 对这些实体&实体集进行建联 通过 Link,连接不同的数据集: EntitySetLink 定义 EntitySet 实体间的关系(如服务 A 调用服务 B); DataLink 定义 EntitySet 与 DataSet 之间的关联(如某 Pod 产生哪些日志); StorageLink 定义 DataSet 与 Storage 之间的关联。 在此基础之上,自动生成实体拓扑图和数据关系图。 4. 图查询 图查询可以认为是发挥 UModel 这一可观测基建的关键能力。因为系统的真实形态本就是一张图,那么对它的查询和分析,也应该使用最符合其本质的方式------图查询。 为了实现这一点,我们在 UModel 体系的核心构建了 EntityStore。它采用了创新的双存储架构,同时维护了 entity 日志库(存储实体的详细属性)和 topo 日志库(存储实体间的拓扑关系)。这相当于我们为整个可观测系统建立了一个实时更新的、可查询的数字孪生图谱 [ 3] 。 基于这个图谱,我们提供了从易到难、层层递进的三种图查询能力,以满足不同用户的需求: graph-match: 为最常见的路径查询场景设计,语法直观,让用户能像描述一句话一样("A 经过 B 调用了 C")来快速查找特定链路。 graph-call: 封装了最高频的图算法(如邻居查找、直接关系查询),通过函数式接口提供,用户只需关心意图("找 A 的 3 跳邻居")而无需关心实现细节。 Cypher: 引入业界标准的图查询语言,提供最完整、最强大的图查询能力,支持任意复杂的模式匹配、多级跳跃、聚合分析,是处理复杂图问题的终极武器。 这一整套解决方案,旨在将强大的图分析能力,以一种低门槛、产品化的方式,让智能体实现自主发现、定位故障,并恢复生产成为可能。 过去,运维靠人脑串联孤立的数据和几十个工具;未来,UModel 希望能作为可观测的基础设施,支撑智能体在统一上下文图谱中工作。当可观测数据被建模为可理解、可行动的上下文图谱,AIOps 才真正拥有了落地的土壤。 相关阅读: [1] UModel 数据治理:运维世界模型构建实践 [2] 从数据孤岛到智能洞察:构建面向未来的 Operation intelligence 体系 [2] 打通可观测性的"任督二脉":实体与关系的终极融合

优秀的个人博客,低调大师

智谱发布 GLM Coding Plan 限售公告

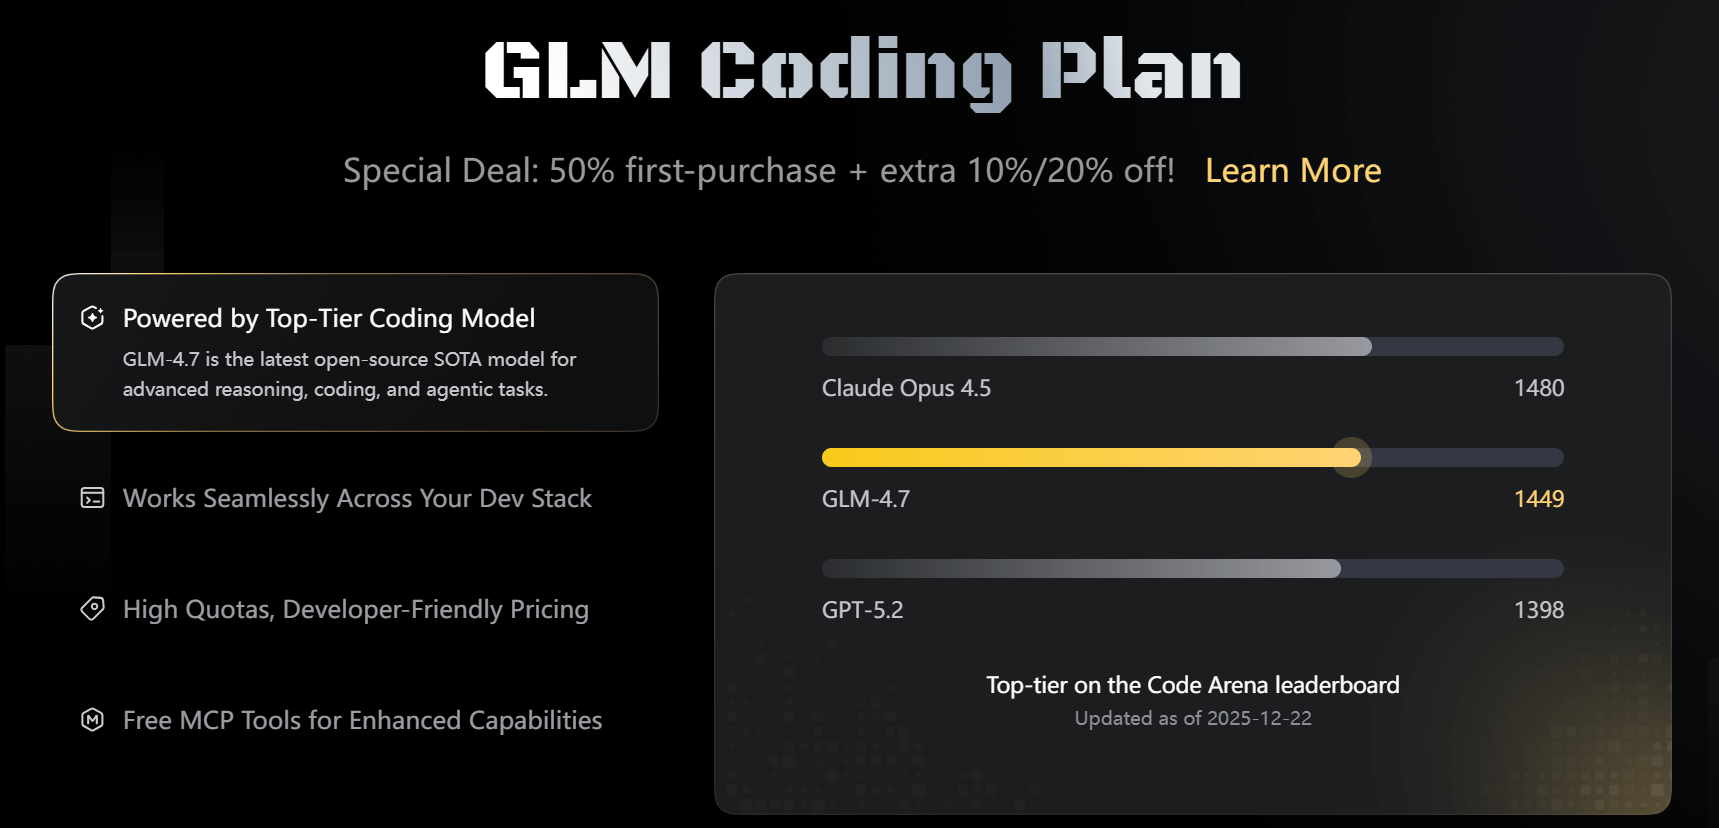
智谱官方发文称,随着 GLM-4.7 上线,GLM Coding Plan 用户数迎来高速增长,使得其算力资源出现阶段性紧张问题。导致近期部分用户在模型调用高峰期(工作日15:00-18:00)遇到了不同程度的并发限流报错、模型速度变慢等问题。 针对此问题,团队已经第一时间启动扩容。但保险起见,同时决定采取以下措施: 暂时限量发售GLM Coding Plan,限售后每日可销售量降为当前的20%,从而为老用户腾出更多算力资源,提供更流畅的编程体验。限售将从1月23日10:00开启,后续每日10:00刷新额度。已有的自动续订将不受影响。停止限售的时间将另行通知。 治理恶意流量,加强对违规账号的监测与打击,制止不合理占用算力资源的行为。 “我们正在研发更强大而高效的模型,同时也在加速算力扩容,更好的GLM Coding Plan将在不久后与大家见面。暂时的限量,是为了长久的高质量服务。在奔赴 AGI 的道路上,感谢大家一直以来的陪伴。”

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册