首页 文章 精选 留言 我的

精选列表

搜索[php扩展],共10000篇文章
优秀的个人博客,低调大师

Vitess 10 发布,MySQL 数据库集群水平扩展系统

Vitess 10 发布了。Vitess 是一个分布式 MySQL 工具集,它可以自动分片存储 MySQL 数据表,将单个 SQL 查询改写为分布式发送到多个 MySQL Server 上,支持行缓存(比 MySQL 本身缓存效率高)与复制容错等。 此版本主要新特性包括: Major Themes 在这个版本中,Vitess 的维护者仍继续专注于兼容性。它仍然是 Vitess 成为 MySQL 生态系统一部分的最关键的组成部分。开发团队也已经开始着手进行基准测试和性能优化。这些改进让其对 Vitess 的哪些方面可以在性能上有所提高有了清晰的认识。 兼容性(MySQL、框架) 随着 V10.0 的发布,Vitess(unsharded) 通过了 Ruby on Rails 框架的所有自动化端到端测试。现在,即使你使用得不是 Rails,这些改进也可能使你受益。接下来,开发团队还计划继续增加对更多框架的测试。 Migration Freno-style throttling 已添加到 VReplication 工作流程中。source 和 target tablets 都可以根据 corresponding shards 的 replication lag 来 throttled。 通过新的安装和迁移命令,你可以从另一个 Vitess cluster 导入数据。 该版本还包括还包括 VReplication V2 用户指令的改进指标、错误修复和微调。 Schema Management Online DDL在第 9 版的基础上继续发展,一些新的和值得注意的内容有: 改进的 SQL语法 通过@@ddl_strategy='online'VReplication 引入基于 VReplication 的迁移是 resharding、materialized views、MoveTables 等背后的基础机制。现在,它可以运行架构迁移 Revertible Online DDL:对已完成的迁移进行无损、online revert Declarative schema更改 性能优化 为 query plans 添加了一个新的、性能更好的缓存实现。新的缓存使用 LFU 驱逐算法,使其对 pollution 有更强的适应性,所以它在 pathological cases 下表现得特别好(比如大量插入活动数据库),同时在正常操作中具有更快的响应时间和更好的命中率。 Vitess SQL Parser 的性能在解析速度和减少内存分配方面都得到了极大的提高。这将减少 vtgate 实例的 CPU 使用率,缩短查询时间,并减少 GC 流失。如果依赖 Vites 解析器的第三方应用程序升级到最新版本,它们也将获得这些好处-外部 API 基本上保持不变。 Vitess 在 SQL 语法树上执行的许多 AST 操作已经过重新设计,因此除非绝对必要,否则它们不会分配内存。这将导致 vtgate 进程的内存使用量明显减少,尤其是在 busy Vitess clusters 中。 大多数改进是在 vtgate 的 CPU 和内存使用方面。开发团队正在努力对延迟和吞吐量的影响进行基准测试,一旦有结果就会公布。 User Interface Vitess 10.0 引入了一个实验性的 multi-cluster admin API 和 Web UI,称为 VTAdmin。部署 vtadmin-api 和 vtadmin-web 组件是完全自愿的。值得注意的是,VTAdmin 依赖于新的 VtctldServer API,所以你必须在你的 vtctlds 上运行新的 grpc-vtctld 服务才能使用它。 Benchmarking 为了确保 Vitess 为用户提供高性能,自 Vitess 9.0 以来,开发团队一直在改进基准测试和性能监控技术。项目arewefastyet是这些技术的核心,目前仍在开发中,其目标是自动测量和观察 Vitess 的性能。 详情可查看:https://vitess.io/blog/2021-04-27-announcing-vitess-10/

优秀的个人博客,低调大师

GitOps初阶指南:将DevOps扩展至K8S

本文转自Rancher Labs 在过去十年的编程中,出现了一些革命性的转变。其中之一是源于围绕DevOps的实践,它将开发和运维团队整合到一个共享的工作流程中,此外还有持续集成和持续交付(CI/CD),通过CI/CD,Devops团队可以向代码库提供持续的更新。另一个变革来自于从单体代码库到基于云的微服务的迁移,这些微服务运行在由Kubernetes等编排平台管理的容器中。 即使有Kubernetes这样的平台来编排协调,在集群系统或云端运行的基于容器的应用程序依旧可能是复杂的、难以调配和管理的。GitOps是一套新兴的实践,旨在通过应用Devops和CI/CD世界的技术来简化这一管理任务。 GitOps的关键是基础设施即代码(IaC)的理念,它采用与DevOps用于提供应用程序一样的方法来提供基础设施。所以,不仅是应用,还有底层的主机和网络都被描述在文件中,这些文件可以像版本控制系统中的其他代码一样,然后由自动化流程来将现实世界的应用与这些文件中描述的应用进行融合。 用GitOps的说法,版本控制系统中的代码是关于应用在生产中应该是什么样子的唯一真相来源(single source of truth)。 定义GitOps Weaveworks是在GitOps概念普及方面贡献最大的公司。稍后我们会详细介绍Weaveworks在其中扮演的角色,但首先,我们先来看看该公司对GitOps的定义,它有两个方面: Kubernetes和其他云原生技术的运维模式,为统一部署、管理和监控容器化集群和应用提供了一套最佳实践。 GitOps是一条通往管理应用的开发者体验之路;在这里,端到端的CI/CD流水线和Git workflow可以同时应用于运维和开发。 换句话说,GitOps是一套特定的实践,旨在管理Kubernetes和类似的平台。随着越来越多的开发团队采用DevOps实践,并将代码迁移到云端,GitOps也将会适合更广泛的应用。但要了解GitOps的秘诀和它所能解决的问题,我们需要谈谈它的组成部分。 Git定义 在GitOps中Git指的是由Linus Torvalds在2005年开发的极为流行的分布式版本控制系统。Git是一个工具,它允许开发者团队在一个应用程序代码库上共同工作,存储各种代码分支,在将它们合并到生产代码之前,他们可以对这些代码进行修补。Git 的一个关键概念是拉取请求,即开发人员正式要求将他们正在编写的一些代码整合到代码库的另一个分支中。 Git 拉取请求为团队成员提供了一个协作和讨论的机会,然后再就是否应该将新代码添加到应用程序中达成共识。Git 还会存储旧版本的代码,如果出了问题,可以很容易地回滚到上一个好的版本,并可以让你快速查看两次修改之间的变化。Git 最为人所知的部分可能是作为GitHub 这一云端托管版本控制系统的底层,但 Git 本身也是一个开源软件,可以部署在任何地方,无论是公司内部的服务器还是你的PC。 需要注意的是,虽然我们通常认为Git是一个计算机编程工具,但实际上取决于你如何使用它。Git 很乐意将任何文本文件作为你的 “代码库”,例如,它可以被作者用来记录合作作品的编辑情况。这一点很重要,因为GitOps的核心代码库大多由声明式配置文件而非可执行代码组成。 在我们继续之前,最后要强调一件事——尽管名字中就有 “Git”,但GitOps实际上并不必要使用Git。 已经投入使用其他版本控制软件(如Subversion)的团队也可以实现GitOps。但在Devops领域,Git被广泛用于实现CI/CD,所以大多数GitOps项目最终都会使用Git。 什么是CI/CD流程? 关于CI/CD的完整解释其实不在本文讨论的范围内,但是因为CI/CD是 GitOps 工作的核心,因此我们需要对其进行简单的介绍。CI/CD中的一半持续集成是由版本控制仓库(如Git)实现的。开发者可以对代码库进行持续的小改进,而不是每隔几个月或几年就推出巨大的、单一的新版本。持续部署这一块是通过被称为流水线(pipeline)的自动化系统来实现的,这些流水线可以构建、测试和部署新的代码到生产中。 同样,我们在这里一直在谈论代码,这通常会让人联想到用C语言、Java或JavaScript等编程语言编写的可执行代码。但在GitOps中,我们所管理的 “代码” 主要是由配置文件组成的。这不是一个小细节,而是GitOps工作的核心。正如我们所说,这些配置文件是描述我们的系统应该是什么样子的 “唯一真理来源(single source of truth)”。它们是声明式的,而不是指导性的。这意味着,配置文件不会说 “启动十台服务器”,而会简单地说 “这个系统包括十台服务器”。 GitOps方程中的CI那一半允许开发人员快速推出对这些配置文件的调整和改进;当自动化软件代理竭尽全力确保应用程序的实时版本能够反映配置文件中的描述时,CD这一部分会以GitOps语言趋向于声明式模型。 GitOps和Kubernetes 正如我们所提到的,GitOps的概念最初是围绕管理Kubernetes应用而出现的。通过我们现在对GitOps的了解,让我们重温一下Weaveworks的GitOps讨论,看看他们是如何描述如何对基于GitOps原则管理的Kubernetes进行更新的。下面是对整个流程的总结: 一个开发者为一个新功能提出Git 拉取请求。 审查和批准代码,然后将其合并到主代码库中。 合并会触发 CI/CD 流水线、自动测试和重建新代码,并将其部署到仓库。 软件代理注意到更新,从仓库中提取新代码,并更新配置仓库中的配置文件(用YAML编写)。 Kubernetes集群中的软件代理根据配置文件,检测到集群已经过时,拉取更改,并部署新功能。 Weaveworks和GitOps 显然,这里的第4步和第5步做了很多繁重的工作。将Git仓库中的 "真理来源 "与现实世界中的Kubernetes应用进行神奇同步的软件代理,就是让GitOps成为可能的魔法。正如我们所说,在GitOps术语中,让实时系统更像配置文件中描述的理想系统的过程叫做融合。当实时系统和理想系统不同步时,那就是分歧。理想情况下,融合可以通过自动化流程来实现,但自动化所能做的事情是有限度的,有时人工干预是必要的。 我们在这里用通用术语描述了这个过程,但事实上,如果你真的去看Weaveworks的页面,我们提到的 “软件代理” 是该公司Weave Cloud平台的一部分。“GitOps” 这个词是由Weaveworks的CEO Alexis Richardson创造的,它的部分作用是让Weaveworks平台对已经沉浸在DevOps和CI/CD世界的开发者有吸引力。 但Weaveworks从未宣称自己垄断了GitOps,GitOps更多的是一种理念和一套最佳实践,而不是某种具体的产品。 正如提供CI/CD解决方案的公司CloudBees的博客所指出的那样,GitOps代表了一种开放的、厂商中立的模式,它是针对亚马逊、谷歌和微软等大型云厂商推出的管理型专有Kubernetes解决方案而开发的。CloudBees提供了自己的GitOps解决方案,这个领域的另一些玩家也是如此。 GitOps和DevOps Atlassian是一家为敏捷开发者制造了许多工具的公司,它有一篇关于GitOps的历史和目的的深度博文(https://www.atlassian.com/git/tutorials/gitops ),值得你花时间去了解。在他们看来,GitOps代表了作为devops的理念的逻辑延伸。具体来说,GitOps是对基础架构即代码(IaC)这一概念的阐述,而基础架构本身就是DevOps环境下产生的一种思想。在Atlassian看来,GitOps弥补了现有DevOps技术与分布式、云托管应用的特殊需求之间的关键差距,现有DevOps技术是为了解决系统管理问题而发展起来的。各个云厂商提供的自动融合是GitOps的特别之处。 虽然GitOps今天仍然专注于Kubernetes,但我们希望我们已经明确了它如何适用于更广泛的分布式、基于云的应用世界。开源安全厂商WhiteSource的一篇博文概述了GitOps的优势: 可观察性:GitOps系统为复杂的应用提供了监控、日志、跟踪和可视化功能,因此开发人员可以看到什么地方出现了故障,在哪里出现了故障。 版本控制和变更管理:很明显,这是使用Git这样的版本控制系统的一个关键优势。有缺陷的更新可以轻松回滚。 易于采用:GitOps建立在许多开发人员已经掌握的开发技能之上。 提高生产力:GitOps 可以像开发项目和 CI/CD 那样提高工作效率。 审计:有了Git,每一个操作都可以追踪到一个特定的提交,这样就可以很容易地追踪到错误的原因。 即使你不使用Kubernetes,GitOps也很有可能迟早会成为你工作流程的一部分。

优秀的个人博客,低调大师

轻松扩展机器学习能力:如何在Rancher上安装Kubeflow

随着机器学习领域不断发展,对于处理机器学习的团队来说,在1台机器上训练1个模型已经有些难以为继,并且现在业界的共识是机器学习已经不仅仅是简单的模型训练。 在模型训练之前、过程中和之后,需要进行许多活动,对于要生成自己的ML模型的团队来说尤其如此。下图常常被引用来说明此类情况: 对于许多团队来说,将机器学习的模型从研究环境应用到生产环境这一过程困难重重,背负很大的压力。糟糕的是,市面上处理每类问题的工具都数量惊人,而这些海量工具都有望解决你所有的机器学习难题。 但是整个团队学习新工具通常很耗时,并且将这些工具集成到你当前的工作流程中也并不容易。这时,或许可以考虑Kubeflow,这是为需要建立机器学习流水线的团队而打造的一个机器学习平台,它包括许多其他工具,可以用于服务模型和调整超参数。Kubeflow尝试做的是将同类最好用的ML工具整合在一起,并将它们集成到一个平台中。 来源:https://www.kubeflow.org/docs/started/kubeflow-overview/ 顾名思义,Kubeflow应该部署在Kubernetes上,既然你是通过Rancher的平台阅读到这篇文章,那么你大概率已经在某个地方部署了Kubernetes集群。 值得注意的是,Kubeflow中的“flow”并不是表示Tensorflow。Kubeflow也能够与PyTorch一起使用,甚至可以与任何ML框架一起使用(不过支持得最好的框架还是Tensorflow和PyTorch)。 在本文中,我将向你展示如何尽可能简单地安装Kubeflow。如果在你的集群上已经有GPU设置,则过程将更为简单。如果尚未设置,那么你需要执行一些额外的设置步骤,因为许多机器学习需要运行在NVIDIA GPU上。 在Kubeflow上设置GPU支持 假设你已经安装了Docker 19.x。 1、 安装NVIDIA 容器运行时 在所有带有GPU的节点上: % distribution=$(. /etc/os-release;echo $ID$VERSION_ID) % curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | sudo apt-key add - % curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | sudo tee /etc/apt/sources.list.d/nvidia-docker.list % sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit % sudo apt-get install nvidia-container-runtime 现在,修改Docker守护进程(Daemon)运行时字段: % sudo vim /etc/docker/daemon.json 粘贴以下内容: { "default-runtime": "nvidia", "runtimes": { "nvidia": { "path": "/usr/bin/nvidia-container-runtime", "runtimeArgs": [] } } } 现在重启Docker守护进程: % sudo systemctl restart docker 2、 安装NVIDIA设备插件 在master节点上,创建NVIDIA设备插件: % kubectl create -f https://raw.githubusercontent.com/NVIDIA/k8s-device-plugin/1.0.0-beta/nvidia-device-plugin.yml 接下来,正式开始安装Kubeflow。 安装Kubeflow 注意:在撰写本文时,Kubeflow的最新版本是1.0。它与Kubernetes 1.14和1.15版本兼容。 Step0:设置动态Volume配置 在我们安装Kubeflow之前,我们需要设置动态配置。 一种方法是使用Rancher的local-path-provisioner,其中使用了基于hostPath的节点持久卷。设置非常简单:将其指向节点上的路径并部署YAML文件。缺点是无法控制volume容量限制。 另一种方法是使用网络文件系统(NFS),我将在下文展示具体步骤。 在Master节点上设置网络文件系统 假设你将大部分数据存储在本地,那么你需要设置NFS。在这里,我假设 NFS server位于master节点10.64.1.163上。 首先,为NFS安装依赖项: % sudo apt install -y nfs-common nfs-kernel-server 然后,创建一个根目录: % sudo mkdir /nfsroot 将以下条目添加到/etc/exports: /full/path/to/nfsroot 10.64.0.0/16(rw,no_root_squash,no_subtree_check) 请注意,10.64.0.0是节点的CIDR,而不是Kubernetes Pod CIDR。 接下来,通过以下命令将共享目录导出为sudo: % sudo exportfs -a 最后,要使所有配置生效,请按如下所示重新启动NFS内核服务器: % sudo systemctl restart nfs-kernel-server 另外,确保nfs-kernel-server在服务器(重新)启动时启动: % sudo update-rc.d nfs-kernel-server enable 在worker节点上设置NFS 为NFS安装依赖项: % sudo apt install -y nfs-common 安装NFS Client Provisioner 现在,我们可以安装NFS Client Provisioner——并且终于可以向你们安利我最爱的Rancher功能之一:应用商店! 默认情况下,Rancher自带了许多已经经过测试的应用程序。此外,我们还可以自行添加整个Helm Chart到应用商店里。 点击Apps,然后点击【Manage Catalogs】 然后选择【Add Catalog】: 填写以下值: 点击【Create】,回到【Apps】页面。稍微等待一会儿,你将看到helm部分有了许多应用程序。你可以点击【Refresh】来查看进程: 现在,在搜索框内输入nfs,然后你将看到2个条目: 其中一个正是我们要找的:nfs-client-provisioner。点击它,然后你将看到: 这是可用于nfs-client-provisioner的chart的所有选项,你将需要使用它们来填写以下内容: 填写完毕后,你可以点击【Launch】按钮。等待一会儿,让Kubernetes下载Docker镜像,并将一切设置完毕。所有操作都完成后,你将看到以下页面: 我真的太喜欢应用商店这个功能了,它是我最喜欢的功能之一,因为它的存在,使得在集群上安装和监控应用程序变得简单和方便。 Step1:下载并安装kfctl 这是Kubeflow的控制工具,与kubectl类似。你可以从Kubeflow的release页面下载它。 然后,解压文件并将二进制文件放入你的$PATH中。 Step2:安装Kubeflow 首先,指定一个文件夹存储所有的Kubeflow YAML文件。 $ export KFAPP=~/kfapp 下载kfctl配置文件: wget https://raw.githubusercontent.com/kubeflow/manifests/v1.0-branch/kfdef/kfctl_k8s_istio.v1.0.2.yaml 请注意:如果你已经安装了Istio,则需要编辑kfctl_k8s_istio.v1.0.2.yaml并删除istio-crds和istio-install应用程序条目。 然后,导出CONFIG_URI: $ export CONFIG_URI="/path/to/kfctl_k8s_istio.v1.0.2.yaml" 接下来,你需要指定一堆环境变量,这些环境变量将指示Kubeflow配置文件下载到的位置: export KF_NAME=kubeflow-deployment export BASE_DIR=/opt export KF_DIR=${BASE_DIR}/${KF_NAME} 安装Kubeflow: % mkdir -p ${KF_DIR} % cd ${KF_DIR} % kfctl apply -V -f ${CONFIG_URI} 你需要一些时间等待一切都设置完毕。 访问Kubeflow UI 要访问UI,我们需要知道Web UI所在的端口: % kubectl -n istio-system get svc istio-ingressgateway 返回以下内容: NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE istio-ingressgateway NodePort 10.43.197.63 <none> 15020:30585/TCP,**80:31380/TCP**,443:31390/TCP,31400:31400/TCP,15029:32613/TCP,15030:32445/TCP,15031:30765/TCP,15032:32496/TCP,15443:30576/TCP 61m 在本例中,它是80:31380,这意味着你可以通过http://localhost:31380 访问Kubeflow UI: 如果你成功地看到了这个页面,那么恭喜你,你已经成功设置Kubeflow🎉 结 论 在本文中,我们首先探讨了为什么需要诸如Kubeflow这类工具——以控制机器学习本身的复杂性。接下来,我们按照步骤为集群进行机器学习工作做好了准备,尤其需要确保该集群可以利用可用的NVIDIA GPU。 在设置NFS时,我们探索了Rancher的应用商店,并将Helm Chart添加到应用商店中。它为我们提供了在Kubernetes集群上可以安装的所有Kubernetes应用程序。最后,我们完成了在集群上安装Kubeflow的步骤。
优秀的个人博客,低调大师

Java并发编程(02):线程核心机制,基础概念扩展

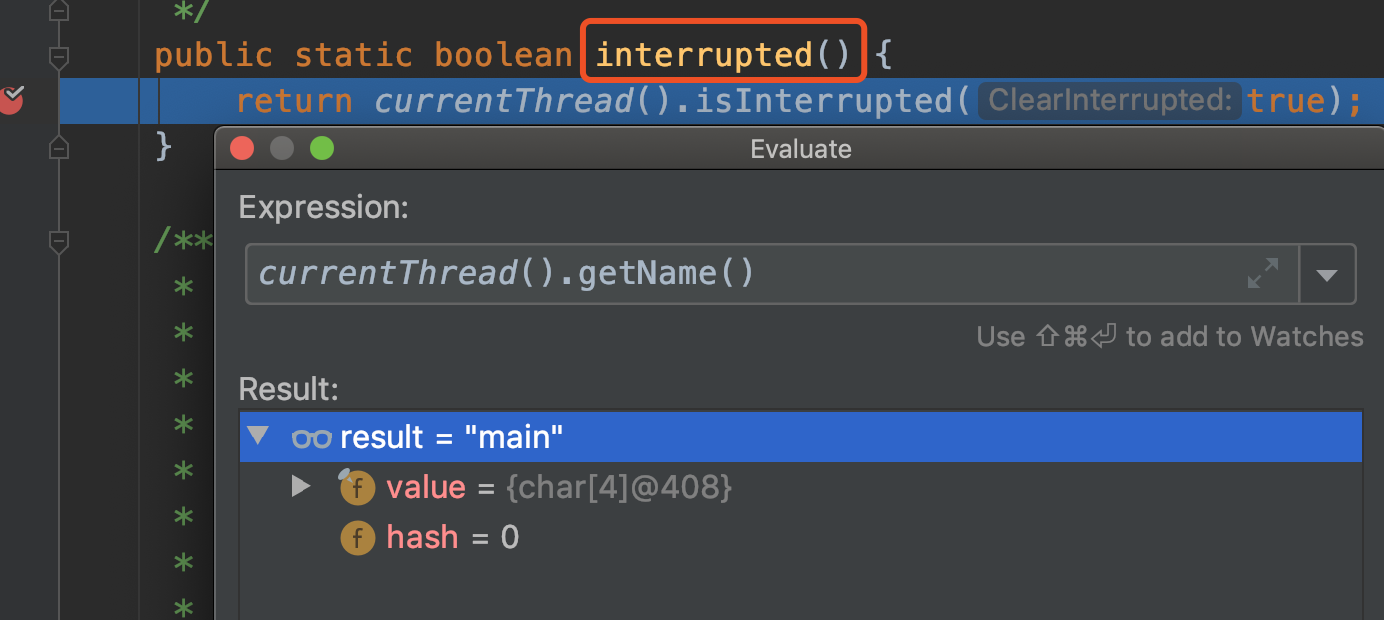
一、线程基本机制 1、概念描述 并发编程的特点是:可以将程序划分为多个分离且独立运行的任务,通过线程来驱动这些独立的任务执行,从而提升整体的效率。下面提供一个基础的演示案例。 2、应用案例 场景:假设有一个容器集合,需要拿出容器中的每个元素,进行加工处理,一般情况下直接遍历就好,如果数据偏大,可以根据线程数量对集合切割,每个线程处理一部分数据,这样处理时间就会减少很多。 public class ExtendThread01 { public static void main(String[] args) { List<Object> dataList = new ArrayList<>() ; dataList.add("A"); dataList.add("B"); dataList.add("C"); // 把一个大的集合按照每个子集合的2个元素切割 List<List<Object>> splitList = splitList(dataList,2); for (List<Object> list:splitList){ System.out.println(list); } // 多线程处理 for (List<Object> childList:splitList){ ListTask listTask = new ListTask(childList) ; Thread runThread = new Thread(listTask); runThread.start(); } } /** * List 集合切割 */ private static List<List<Object>> splitList (List<Object> list, int childSize) { if (list == null || list.size() == 0 || childSize < 1) { return null; } List<List<Object>> result = new ArrayList<>(); int size = list.size(); int count = (size + childSize - 1) / childSize ; for (int i = 0; i < count; i++) { List<Object> subList = list.subList(i * childSize, ((i + 1) * childSize > size ? size : childSize * (i + 1))); result.add(subList); } return result; } } class ListTask implements Runnable { private List<Object> list ; public ListTask (List<Object> list){this.list=list;} @Override public void run() { for (Object object:list){ System.out.println(Thread.currentThread().getName()+"=="+object); } } } 注意:这里案例只是对场景原理的实现,在开发中,是不允许这种操作的,需要使用线程池处理,后续会说。如果集合没有控制好,导致大量创建Thread线程,导致内存溢出。 二、线程停止启动 1、基础流程 线程启动后执行任务方法,在执行过程中可以被阻塞,休眠,唤醒,停止等一系列状态操作。 线程休眠作用:当线程一部分任务执行完毕后进入休眠(阻塞)状态,线程调度器可以切换到另外线程,这对分布任务的执行相对公平。 2、使用案例 public class ExtendThread02 { public static void main(String[] args) { StopThread stopThread = new StopThread() ; stopThread.start(); // 标记当前线程停止信号,且抛出中断异常,但没有停止 stopThread.interrupt(); // 判断当前线程是否已经是终止状态 System.out.println("1=="+stopThread.isInterrupted()); // 清除当前线程的终止信号 System.out.println("2=="+stopThread.interrupted()); // 再次判断当前线程状态 System.out.println("3=="+stopThread.isInterrupted()); System.out.println("main end ..."); } } class StopThread extends Thread { @Override public void run() { for (int i = 0 ; i < 10 ; i++){ try { System.out.println(Thread.currentThread().getId()+"="+i); // 线程阻塞1秒 Thread.sleep(1000); } catch (InterruptedException e){ e.printStackTrace(); } } } } 3、核心方法 sleep(long millis):线程休眠指定的时间,进入阻塞状态; interrupt():切换线程为中断状态,抛出中断异常,不会停止线程,可以监视线程的中断状态并定义执行策略。 interrupted():清除调用该方法线程的中断状态,也不会影响线程的执行,且返回当前执行‘stopThread.interrupted()’的线程是否中断,这里就是指main线程是否中断。 isInterrupted():判断调用该方法的线程是否已经是中断状态。 补刀一句:线程的这几个方法极其容易混淆,需要断点源码追踪一下看看,进入源码方法,调用相关API查看一下状态。(附断点图一张:) 三、线程优先级 1、基础概念 CPU执行和处理线程的顺序是不确定的,但是线程调度器倾向执行线程优先级高的线程,线程优先级高说明获取CPU资源的概率高,或者获取的执行时间分片多,但不代表优先级低的一定最后执行。 2、使用案例 public class ExtendThread03 { public static void main(String[] args) { Priority01 priority01 = new Priority01(); priority01.start(); System.out.println("priority01="+priority01.getPriority()); Priority02 priority02 = new Priority02(); priority02.start(); System.out.println("priority02="+priority02.getPriority()); priority01.setPriority(10); priority02.setPriority(1); } } class Priority01 extends Thread { @Override public void run() { for (int i = 0 ; i < 100 ; i++){ System.out.println(Thread.currentThread().getName()+";i="+i); } } } class Priority02 extends Thread { @Override public void run() { for (int a = 0 ; a < 100 ; a++){ System.out.println(Thread.currentThread().getName()+";a="+a); } } } 注意:优先级范围[MAX_PRIORITY=10,MIN_PRIORITY=1],如果超出范围会抛出IllegalArgumentException异常。 建议:通常实际开发中,是不允许轻易修改线程运行的参数,容易引发认知之外的异常。 四、线程加入 1、基本概念 如果在线程A中,执行线程B的加入方法,那么A线程就会等待线程B执行完毕再返回继续执行。 2、使用案例 public class ExtendThread04 { public static void main(String[] args) { JoinThreadA joinThreadA = new JoinThreadA() ; joinThreadA.start(); } } class JoinThreadA extends Thread { @Override public void run() { System.out.println("缺水中..."); JoinThreadB joinThreadB = new JoinThreadB() ; joinThreadB.start(); try{ joinThreadB.join(); } catch (Exception e){ e.printStackTrace(); } System.out.println("喝水中..."); } } class JoinThreadB extends Thread { @Override public void run() { System.out.println("买水中..."); try{ TimeUnit.SECONDS.sleep(2); } catch (Exception e){ e.printStackTrace(); } System.out.println("买到水..."); } } 注意:可以设置线程的加入时间join(long),毕竟等不到雪月风花,人生都是有时差,只能后会无期了。 五、本地线程 1、基本概念 本地的线程变量,底层维护ThreadLocalMap存储值: static class Entry extends WeakReference<ThreadLocal<?>> { Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } 即以Key-Value键值对的方式存储数据。如果对集合容器的源码熟悉的话,这个Entry就是似曾相识感觉。 2、使用案例 public class ExtendThread05 { private static final ThreadLocal<Long> threadLocal = new ThreadLocal<>() ; private static void initBegin (){ threadLocal.set(System.currentTimeMillis()); } private static Long overTime (){ return System.currentTimeMillis()-threadLocal.get(); } public static void main(String[] args) throws Exception { ExtendThread05.initBegin(); TimeUnit.SECONDS.sleep(3); System.out.println(ExtendThread05.overTime()); } } ThreadLocal提供线程内存储变量的能力,并且绑定到当前线程,通过get和set方法就可以得到和设置当前线程对应的值。这个在web开发中是常见的应用。 六、守护线程 1、基本概念 守护线程是支持辅助型线程,主要在程序中起到调度和支持性作用,当Jvm中非守护线程全部结束,守护线程也就会结束。 2、使用案例 public class ExtendThread06 { public static void main(String[] args) throws Exception { InputStreamReader is = new InputStreamReader(System.in); BufferedReader br = new BufferedReader(is); String value = br.readLine(); CheckThread checkThread = new CheckThread(value) ; checkThread.setDaemon(true); checkThread.start(); System.out.println("Main End ..."); } } class CheckThread extends Thread { private String spell ; public CheckThread (String spell){ this.spell = spell ; } @Override public void run() { if (spell.startsWith("cs")){ System.out.println(spell+":输入正确"); } else { System.out.println(spell+":输入错误"); } try { TimeUnit.SECONDS.sleep(10); } catch (InterruptedException e){ e.printStackTrace(); } } } 注意:守护线程需要显式调用setDaemon(true);方法,这里可以看到main线程结束,整合程序就结束了,丝毫理会休眠中的守护线程。如果打断非守护线程的休眠,试试会不会抛你一脸异常? 七、线程异常处理 1、机制描述 按照Java中异常处理机制,抛异常逐级降低,线程的任务方法run没有抛异常,那重写或者实现的方法自然不能直接throws异常出去。多线程中推荐捕获异常,可以针对性处理机制。 2、使用案例 public class ExtendThread07 { public static void main(String[] args) { TryThread tryThread = new TryThread(); tryThread.setName("try-name"); // 定义运行中异常处理策略 MyExe myExe = new MyExe() ; tryThread.setUncaughtExceptionHandler(myExe); tryThread.start(); } } class TryThread extends Thread { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e){ e.printStackTrace(); } // 如何处理这里异常? Integer.parseInt("cicada") ; } } class MyExe implements Thread.UncaughtExceptionHandler { @Override public void uncaughtException(Thread t, Throwable e) { System.out.println(t.getName()+";异常:"+e.getMessage()); } } 通过实现UncaughtExceptionHandler接口,并且线程要指定自定义异常处理对象,也可以处理未检查的异常。 八、源代码地址 GitHub·地址 https://github.com/cicadasmile/java-base-parent GitEE·地址 https://gitee.com/cicadasmile/java-base-parent

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册