DC学院学习笔记(十七):分类及逻辑回归
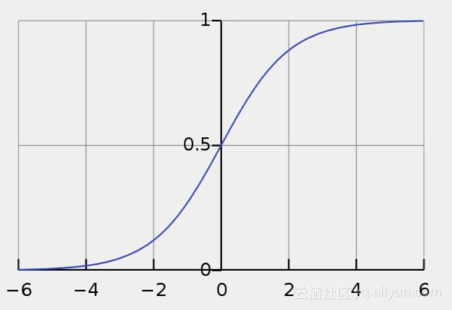
回归和分类的区别 分类:对离散型变量进行预测(二分类、多分类) 回归:对数值型变量进行预测 区别:回归的y为数值连续型变量;分类的y是类别离散型变量 分类问题 1. 分类问题示例:信用卡 从x1:职业,x2:收入等等信用卡申请人不同的信息维度,来判断y:是否发放信用卡,发放哪一类信用卡 2. 分类经典方法:logistic回归(二分类) 虽然名字里有回归二字,但logistic回归解决的是分类的问题 回归得到的数值y可以看做属于类别1的概率: 下图为logistic函数(也叫sigmoid函数)图像 二分类到多分类:通过One vs. Rest 使用logistic进行多分类,scikit-learn 会默认采用OvR方法: 为每个类别分别建立一个二分类器 训练中正例为该类别样本,负例为所有其他样本 在所有分类中,选择概率最高的那个类别 如iris数据集中有三个类别,选择使用logistic回归进行分类,则需要训练三个分类器,根据每个样本隶属不同类的概率大小来进行分类 3. scikit learn 实现logistic回归 载入iris数据集 import pandas iris = pandas.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data',header=None) iris.columns=['SepalLengthCm','SepalWidthCm','PetalLengthCm','PetalWidthCm','Species'] 实现logistic回归 import sklearn import numpy as np from sklearn import linear_model lm=linear_model.LogisticRegression() features=['PetalLengthCm'] X=iris[features] #需要讲Species这个字段由字符串类型转变为数值类型,以表示不同的类别 from sklearn.preprocessing import LabelEncoder #初始化label le=LabelEncoder() le.fit(iris['Species']) #用离散值转化标签值 y=le.transform(iris['Species']) print(y) [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2] #通过交叉检验,得到分类准确率 from sklearn.model_selection import cross_val_score #logistic中的scoring参数指定为accuracy scores=cross_val_score(lm,X,y,cv=5,scoring='accuracy') print(np.mean(scores)) 0.786666666667 往Feature中添加特征,看看准确率的变化 features=['PetalLengthCm','SepalWidthCm','PetalLengthCm'] X=iris[features] #需要讲Species这个字段由字符串类型转变为数值类型,以表示不同的类别 from sklearn.preprocessing import LabelEncoder #初始化label le=LabelEncoder() le.fit(iris['Species']) #用离散值转化标签值 y=le.transform(iris['Species']) ##print(y) #通过交叉检验,得到分类准确率 from sklearn.model_selection import cross_val_score #logistic中的scoring参数指定为accuracy scores=cross_val_score(lm,X,y,cv=5,scoring='accuracy') print(np.mean(scores)) 0.906666666667 果然好了很多!