首页 文章 精选 留言 我的

精选列表

搜索[运维自动化],共10001篇文章
优秀的个人博客,低调大师

BigOps自动化运维安装以及所遇故障处理

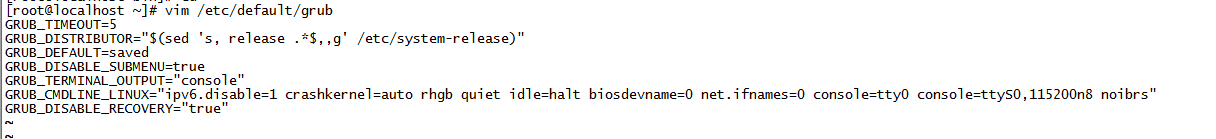
本文参考官方文档进行安装,以及在安装中所遇到的问题呈现给大家。废话就不说了,开始安装。一、准备工作:本机系统环境是CentOS 7 x86 64位 硬件配置建议物理内存8G+、CPU 4 cores+、硬盘20G+。内存低于6G无法安装BigOps程序,所以内存必须6+。1.操作系统CentOS 7 x86 64位 (推荐使用7以上版本,使用7以下版本请参考官网文档)官方文档URL:http://docs.bigops.com/er-jin-zhi-an-zhuang/zhun-bei-huan-jing.html 服务 端口 统一认证 30000、30001 work后端 30002、30003 预留 30004、30005 dv后端 30006、30007 confluence 30008、30009 jira 30010、30011 jenkins 30012、30013 kibana 5601 cerebro 9000 elasticsearch-head 9100 elasticsearch 9200、9300 2.准备2域名(1)sso.xxxx.com,用于统一认证(2)work.xxxx.com,用于主站如果没有注册域名,需要给服务器和笔记本都配置hosts。Linux位置/etc/hosts。Windows位置C:\Windows\System32\drivers\etc\hosts,如果不能直接编辑,可以先拷贝到桌面,编辑完在拷贝回原位置。配置内容,例如:192.168.100.2 sso.bigops.com (换成你服务器IP和你自己的域名)192.168.100.2 work.bigops.com (换成你服务器IP和你自己的域名)切记2个域名都要设置!切记!切记!切记!切记服务器和你的笔记本都要设置!切记!切记!切记!3.初始化环境[root@localhost ~]#cd /usr/local/src[root@localhost src]# wget -O centos_init_env.sh https://raw.githubusercontent.com/yunweibang/bigops-install/master/centos_init_env.sh[root@localhost src]# chmod +x centos_init_env.sh[root@localhost src]# sh centos_init_env.sh 注:建议将所需下载的文件统一放在一个目录下,好管理也好处理。4.关闭IPv6(可选)centos 7编辑/etc/default/grub,在GRUB_CMDLINE_LINUX的值里添加ipv6.disable=1,例如:GRUB_CMDLINE_LINUX="ipv6.disable=1 crashkernel=auto rhgb quiet idle=halt biosdevname=0 net.ifnames=0 console=tty0 console=ttyS0,115200n8 noibrs"再运行命令[root@localhost ~]#grub2-mkconfig -o /boot/grub2/grub.cfg重启系统[root@localhost ~]#reboot5.获取安装包百度网盘地址:地址:https://pan.baidu.com/s/1y8JyQJIUWnzDiH0fX2EpcQ密码:76cm二、安装待初始化系统完成以后,我们进行BigOps环境和BigOps软件安装(1)安装MySQL(推荐使用)[root@localhost src]# wget -O mysql80.sh https://raw.githubusercontent.com/yunweibang/bigops-install/master/mysql80.sh[root@localhost src]#chmod +x mysql80.sh[root@localhost src]# sh mysql80.sh看到下面提示,输入root@127.0.0.1用户密码,保存好一会使用。另外root@localhost密码为空 please input root@127.0.0.1 password, default bigops/>输入你的密码优化MySQL,修改/etc/my.cnf里innodb_buffer_pool_size的值,用命令计算:说明:BigOps系统占用4G,所以innodb_buffer_pool_size等于总内存减去4G后的70%到80% [root@localhost ~]# free -g|egrep -i ^mem|awk '{if($2<7) print "memory is too small";else print int(($2-4)*0.8)"G"}' 比如上面命令返回8G,就这样设置:innodb_buffer_pool_size=8G修改完后需要重启MySQL(2) 安装BigOps程序[root@localhost src]#tar -zxvf bigops-1.0.1.tar.gz[root@localhost src]# mv bigops-1.0.1 bigops[root@localhost src]# cd bigops/bin/[root@localhost bin]# chmod +x bigserver.sh[root@localhost bin]# sh bigserver.sh根据提示填写相关信息,设置完后服务会自动启动。dbhost不要填localhost,填127.0.0.1或对应IP 检查BigOps数据库的tables是否是大小写组合拼写。如果表名都是小写就有问题如果不是请根据官方常见问题文档进行修改。URL:http://docs.bigops.com/er-jin-zhi-an-zhuang/an-zhuang-chang-jian-wen-ti.html检查服务端口有无启动[root@localhost bin]# netstat -nptl | grep 3000检查Nginx状态检查Nginx域名是否配置正确[root@localhost ~]#cat /etc/nginx/conf.d/sso.conf[root@localhost ~]#cat /etc/nginx/conf.d/work.conf[root@localhost bin]# ps aux|grep nginx.conf注:问题在此处我遇到sso.conf和work.conf、default.conf、zabbix.conf文件是空白的,服务重启后Nginx服务无法启动。解决下载配置文件,替换并修改sso.conf、default.conf、work.conf、zabbix.conf里的域名为你网站的域名[root@localhost ~]#wget -O /etc/nginx/nginx.conf https://raw.githubusercontent.com/yunweibang/bigops-install/master/nginx/nginx.conf [root@localhost ~]#wget -O /etc/nginx/conf.d/default.conf https://raw.githubusercontent.com/yunweibang/bigops-install/master/nginx/conf.d/default.conf [root@localhost ~]#wget -O /etc/nginx/conf.d/sso.conf https://raw.githubusercontent.com/yunweibang/bigops-install/master/nginx/conf.d/sso.conf [root@localhost ~]#wget -O /etc/nginx/conf.d/work.conf https://raw.githubusercontent.com/yunweibang/bigops-install/master/nginx/conf.d/work.conf [root@localhost ~]#wget -O /etc/nginx/conf.d/zabbix.conf https://raw.githubusercontent.com/yunweibang/bigops-install/master/nginx/conf.d/zabbix.conf替换修改后Nginx服务正常启动 检查sso服务是否正常启动[root@localhost bin]# curl 127.0.0.1:30001/signin/login如果返回值包括「sso系统正常」,说明运行正常,如果没有返回值说明有问题,需要详细检查数据库配置。检查work服务是否正常启动[root@localhost bin]# curl 127.0.0.1:30003/api/common/ssourl/{"code":0,"message":"ok","data":{"url":"http://sso.swwbigops.com"}}[root@localhost bin]# 如果返回「message」为ok就是正常启动bigserver,bigserver服务用于执行一些内置任务[root@localhost ~]#/usr/local/src/bigops/bin/bigserver.sh restartbigserver配置文件在/usr/local/src/bigops/bin/bigserver.properties可以根据需要调整轮询时间设置定时清理日志[root@localhost ~]#crontab -e 00 01 * /bin/sh /opt/bigops/bin/clean_log.sh 添加开机启动服务 [root@localhost ~]#wget -O /usr/lib/systemd/system/bigweb.service https://raw.githubusercontent.com/yunweibang/bigops-install/master/bigweb.service [root@localhost ~]#systemctl enable bigweb [root@localhost ~]#chmod 754 /usr/lib/systemd/system/bigweb.service [root@localhost ~]#wget -O /usr/lib/systemd/system/bigserver.service https://raw.githubusercontent.com/yunweibang/bigops-install/master/bigserver.service [root@localhost ~]#systemctl enable bigserver [root@localhost ~]#chmod 754 /usr/lib/systemd/system/bigserver.service [root@localhost ~]#systemctl enable nginx [root@localhost ~]#systemctl enable mysqld登录测试访问域名:http://work.swwbigops.com (就是你刚才设置的home url) 默认账号:admin 默认密码:bigops 登陆后请尽快修改密码。软件登录界面展示

优秀的个人博客,低调大师

python linux 系统管理与自动化运维

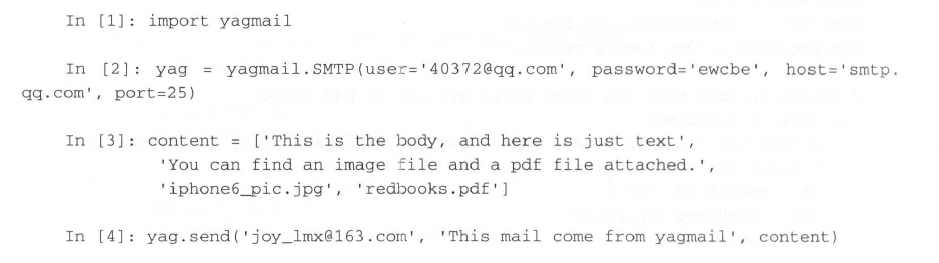
pypdf2 图片:pillow 邮件:smtplib yagmail:简单发送邮件 image.png image.png 接收邮件:imapclient image.png settools打包 python-nmap image.png image.png ipy。。。。。。 dnspython... 同时处理多台服务器:polysh wget http://guichaz.free.fr/polysh/files/polysh-0.4.tar.gz tar -zxvf polysh-0.4.tar.gz cd polysh-0.4 python setup.py install 获取用户输入:pexcept paramiko:https://blog.csdn.net/l1028386804/article/details/79029041 脚本操作ssh fabric from fabric.api import * #导入fabric.api模块 env.hosts= ['192.168.122.101','192.168.122.102','192.168.122.103'] #指定远端服务器的ip地址。如果有dns解析的也可以写主机名。 env.password='indionce' #指定远端主机的密码,如果各个密码不相同可以使用一个字典指定,例如:env.password={“root@192.168.122.101”:"indionce"} @runs_once def local_uname(): #定义一个本地任务的函数 local('uname -r') def remote_uname(): #定义一个远程任务的函数 run('uname -r') def uname(): #定义一个函数,将本地与远端组合起来使用 local_uname() remote_uname() 查看列表 from fabric.api import * @runs_once #一定要指定这一条,否则会让你输入多次路径 def input(): return prompt("input path:") #prompt函数,让用户输入自己想要的路径,将输入的值返回到函数。 def ls_path(dirname): #在定义函数的时候指定形参。 run("ls -l "+dirname) def go(): ls_path(input()) #使用input返回的值,用于ls_path()的参数 处理异常 from fabric.api import * from fabric.contrib.console import * #这个模块中包含confirm def backup(): with settings(warn_only=True): #with命令表示执行这句后,执行下面的命令。使用settings命令来设置警告模式 state=local('mkdir /root/zz') #创建一个文件夹 if state.failed and not confirm("/root/zz is already exist,continue?"): #使用failed来判断state这条命令是否失败,失败了为真。confirm向用户确认是否继续,继续为真。如果命令失败了,并且用户希望停止,便通过if判断。 abort("退出任务") #abort是退出任务,有些类似python的exit。退出并且时返回给用户一串字符串 local('tar cavf /root/zz/etc.tar.gz /etc') #将etc的文件备份到/root/zz文件夹中 并行执行与顺序执行 @parallel #将下面的函数设为并行执行。 def runs_parallel(): run('uname -r') @serial #将下面的函数设为顺序执行(默认即为顺序执行 ) def runs_serially(): pass @parallel(pool_size=5) #将下面的函数设为并行执行,并且限制最多5个线程。 def runs_parallel(): pass

优秀的个人博客,低调大师

CrazyWing:Python自动化运维开发实战 十七、Python异常

导语: 在写代码的时候,经常会遇到异常。python提供了两个功能来处理程序在运行中出现的异常和错误,可以使用该功能来调试python程序。 异常处理 断言(Assertions) 常用异常: Exception 它可以捕获任意(绝大部分)异常。 AttributeError 试图访问一个对象没有的树形,比如foo.x,但是foo没有属性x IOError 输入/输出异常;基本上是无法打开文件 ImportError 无法引入模块或包;基本上是路径问题或名称错误 IndentationError 语法错误(的子类),代码没有正确对齐 IndexError 下标索引超出序列边界,比如当x只有三个元素,却试图访问x[5] KeyError 试图访问字典里不存在的键 KeyboardInterrupt Ctrl+C被按下 NameError 使用一个还未被赋予对象的变量 SyntaxError Python代码非法,代码不能编译(个人认为这是语法错误,写错了) TypeError 传入对象类型与要求的不符合 UnboundLocalError 试图访问一个还未被设置的局部变量,基本上是由于另有一个同名的全局变量,导致你以为正在访问它 ValueError 传入一个调用者不期望的值,即使值的类型是正确的 python标准异常: 什么是异常? 异常即是一个事件,该事件会在程序执行过程中发生,影响程序的正常执行。 一般情况下,在Python无法正常处理程序时就会发生一个异常,异常是Python对象,表示一个错误。 当Python脚本发生异常时我们需要捕获处理它,否则程序会终止执行。 #!/usr/bin/env python try: print "%d" % (5 / 0) except ZeroDivisionError: print "除数不能为零" else: print "没有报错" print "这是异常之后的代码" #如果没有上面的异常处理,下面的代码是不会执行的 for i in range(10): print i 捕捉异常: try/except语句用来检测try语句块中的错误,从而让except语句捕获异常信息并处理。 如果你不想在异常发生时结束你的程序,只需在try里捕获它。 语法: try: <语句> #运行别的代码 except <名字>: <语句> #如果在try部份引发了'name'异常 except <名字>,<数据>: <语句> #如果引发了'name'异常,获得附加的数据 else: <语句> #如果没有异常发生 try的工作原理 当开始一个try语句后,python就在当前程序的上下文中作标记,这样当异常出现时就可以回到这里,try子句先执行,接下来会发生什么依赖于执行时是否出现异常。 1. 如果当try后的语句执行时发生异常,python就跳回到try并执行第一个匹配该异常的 except子句,异常处理完毕,控制流就通过整个try语句(除非在处理异常时又引发新的异 常)。 2. 如果在try后的语句里发生了异常,却没有匹配的except子句,异常将被递交到上层的 try,或者到程序的最上层(这样将结束程序,并打印缺省的出错信息)。 3. 如果在try子句执行时没有发生异常,python将执行else语句后的语句(如果有else的 话),然后控制流通过整个try语句。 例 打开一个文件,在该文件中的写入内容,且并未发生异常: try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") except IOError: print "Error: 没有找到文件或读取文件失败" else: print "内容写入文件成功" fh.close() 结果: # python test.py 内容写入文件成功 # cat testfile # 查看写入的内容 这是一个测试文件,用于测试异常!! 例 打开一个文件,在该文件中的内容写入内容,但文件没有写入权限,发生了异常: try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") except IOError: print "Error: 没有找到文件或读取文件失败" else: print "内容写入文件成功" fh.close() 在执行代码前为了测试方便,先去掉 testfile 文件的写权限 再执行以上代码: $ python test.py #注意这里用的是普通用户 Error: 没有找到文件或读取文件失败 使用except不带任何异常类型 你可以不带任何异常类型使用except,如下实例: try: 正常的操作 ...................... except: 发生异常,执行这块代码 ...................... else: 如果没有异常执行这块代码 以上方式try-except语句捕获所有发生的异常。但这不是一个很好的方式,我们不能通过该程序识别出具体的异常信息。因为它捕获所有的异常。 使用except带多种异常类型 也可以使用相同的except语句来处理多个异常信息: try: 正常的操作 ................ except(Exception1[, Exception2[,...ExceptionN]]]): 发生以上多个异常中的一个,执行这块代码 ...................... else: 如果没有异常执行这块代码 try-finally 语句 try-finally 语句无论是否发生异常都将执行最后的代码。 try: <语句> finally: <语句> #退出try时总会执行 例1: try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") finally: print "Error: 没有找到文件或读取文件失败" 例2: import time try: f=file("文件.py") while True: line = f.read() if len(line)==0: break time.sleep(2) print line, finally: f.close() print "hello" 例3: try: fh = open("testfile", "w") try: fh.write("这是一个测试文件,用于测试异常!!") finally: print "关闭文件" fh.close() except IOError: print "Error: 没有找到文件或读取文件失败" 异常的参数: 一个异常可以带上参数,可作为输出的异常信息参数。你可以通过except语句来捕获异常的参数,如下所示: try: 正常的操作 ...................... except ExceptionType, Argument: 你可以在这输出 Argument 的值... 变量接收的异常值通常包含在异常的语句中。在元组的表单中变量可以接收一个或者多个值。元组通常包含错误字符串,错误数字,错误位置。 例以下为单个异常的实例: #!/usr/bin/python def temp_convert(var): try: return int(var) except ValueError, Argument: print "参数没 有包含数字\n", Argument # 调用函数 temp_convert("xyz") 以上程序执行结果如下: $ python test.py 参数没有包含数字 invalid literal for int() with base 10: 'xyz' 触发异常 可以使用raise语句自己触发异常raise语法格式: raise [Exception [, args [, traceback]]] 语句中Exception是异常的类型(例如,NameError)参数是一个异常参数值。该参数是可选的,如果不提供,异常的参数是"None"。最后一个参数是可选的(在实践中很少使用),如果存在,是跟踪异常对象。 例一个异常可以是一个字符串,类或对象。 Python的内核提供的异常,大多数都是实例化的类,这是一个类的实例的参数。定义一个异常: def functionName( level ): if level < 1: raise Exception("Invalid level!", level) # 触发异常后,后面的代码就不会再执行 注意:为了能够捕获异常,"except"语句必须有用相同的异常来抛出类对象或者字符串。例如我们捕获以上异常,"except"语句如下: try: 正常逻辑 except "Invalid level!": 触发自定义异常 else: 其余代码 例 #!/usr/bin/python def mye( level ): if level < 1: raise Exception("Invalid level!", level) # 触发异常后,后面的代码就不会再执行 try: mye(0) # 触发异常 except "Invalid level!": print 1 else: print 2 输出结果: $ python test.py Traceback (most recent call last): File "test.py", line 11, in <module> mye(0) File "test.py", line 7, in mye raise Exception("Invalid level!", level) Exception: ('Invalid level!', 0) 用户自定义异常: 通过创建一个新的异常类,程序可以命名它们自己的异常。异常应该是典型的继承自Exception类,通过直接或间接的方式。以下为与RuntimeError相关的实例,实例中创建了一个类,基类为RuntimeError,用于在异常触发时输出更多的信息。在try语句块中,用户自定义的异常后执行except块语句,变量 e 是用于创建Networkerror类的实例。 class Networkerror(RuntimeError): def __init__(self, arg): self.args = arg 在你定义以上类后,你可以触发该异常,如下所示: try: raise Networkerror("Bad hostname") except Networkerror,e: print e.args 万能异常 在python的异常中,有一个万能异常:Exception,它可以捕获任意异常。例: #cat aa.py s1 = 'hello' try: int(s1) except Exception,e: print e 执行结果: #python aa.py invalid literal for int() with base 10: 'hello' 既然有这个万能异常,其他异常是不是就可以忽略了?当然不是,对于特殊处理或提醒的异常需要先定义,最后定义Exception来确保程序正常运行。例: s1 = 'hello' try: int(s1) except KeyError,e: print '键错误' except IndexError,e: print '索引错误' except Exception, e: print '错误' ====================================== assert断言 使用assert断言是学习python一个非常好的习惯,assert断言句语格式及用法很简单。在没完善一个程序之前,我们不知道程序在哪里会出错,与其让它在运行最崩溃,不如在出现错误条件时就崩溃,这时候就需要assert断言的帮助。 assert断言的作用 assert断言是声明其布尔值必须为真的判定,如果发生异常就说明表达示为假。可以理解assert断言语句为raise-if-not,用来测试表示式,其返回值为假,就会触发异常。assert断言语句的语法格式assert expression 一些assert用法的语句供参考: assert 1==1 assert 2+2==2*2 assert len(['my boy',12])<10 assert range(4)==[0,1,2,3] 如何为assert断言语句添加异常参数 assert的异常参数,其实就是在断言表达式后添加字符串信息,用来解释断言并更好的知道是哪里出了问题。格式如下: assert expression [, arguments] 何时使用断言 Python的assert是用来检查一个条件,如果它为真,就不做任何事。如果它为假,则会抛出AssertError并且包含错误信息。例如: py> x = 23 py> assert x > 0, "x is not zero or negative" py> assert x%2 == 0, "x is not an even number" Traceback (most recent call last): File "", line 1, in .... AssertionError: x is not an even number 很多人用assert作为一个很快和容易的方法来在参数错误的时候抛出异常。但这样做是错的,非常错误,有两个原因。首先AssertError不是在测试参数时应该抛出的错误。你不应该像这样写代码: if not isinstance(x, int): raise AssertionError("not an int") 你应该抛出TypeError的错误,assert会抛出错误的异常。 但是,更危险的是,有一个关于assert的困扰:它可以被编译好然后从来不执行,如果你用 –O 或 –oo 选项运行Python,结果不保证assert表达式会运行到。当适当的使用assert时,这是未来,但是当assert不恰当的使用时,它会让代码用-O执行时出错。 那什么时候应该使用assert?没有特定的规则,断言应该用于: 防御型的编程 运行时检查程序逻辑 检查约定 程序常量 检查文档 (在测试代码的时候使用断言也是可接受的,是一种很方便的单元测试方法,你接受这些测试在用-O标志运行时不会做任何事。我有时在代码里使用assert False来标记没有写完的代码分支,我希望这些代码运行失败。尽管抛出NotImplementedError可能会更好。) 关于断言的意见有很多,因为它能确保代码的正确性。如果你确定代码是正确的,那么就没有用断言的必要了,因为他们从来不会运行失败,你可以直接移除这些断言。如果你确定检查会失败,那么如果你不用断言,代码就会通过编译并忽略你的检查。 在以上两种情况下会很有意思,当你比较肯定代码但是不是绝对肯定时。可能你会错过一些非常古怪的情况。在这个情况下,额外的运行时检查能帮你确保任何错误都会尽早地被捕捉到。 另一个好的使用断言的方式是检查程序的不变量。一个不变量是一些你需要依赖它为真的情况,除非一个bug导致它为假。如果有bug,最好能够尽早发现,所以我们为它进行一个测试,但是又不想减慢代码运行速度。所以就用断言,因为它能在开发时打开,在产品阶段关闭。 一个非变量的例子可能是,如果你的函数希望在它开始时有数据库的连接,并且承诺在它返回的时候仍然保持连接,这就是函数的不变量: def some_function(arg): assert not DB.closed() ... # code goes here assert not DB.closed() return result 断言本身就是很好的注释,胜过你直接写注释: # when we reach here, we know that n > 2 你可以通过添加断言来确保它: assert n > 2 断言也是一种防御型编程。你不是让你的代码防御现在的错误,而是防止在代码修改后引发的错误。理想情况下,单元测试可以完成这样的工作,可是需要面对的现实是,它们通常是没有完成的。人们可能在提交代码前会忘了运行测试代码。有一个内部检查是另一个阻挡错误的防线,尤其是那些不明显的错误,却导致了代码出问题并且返回错误的结果。 加入你有一些if…elif 的语句块,你知道在这之前一些需要有一些值: # target is expected to be one of x, y, or z, and nothing else. if target == x: run_x_code() elif target == y: run_y_code() else: run_z_code() 假设代码现在是完全正确的。但它会一直是正确的吗?依赖的修改,代码的修改。如果依赖修改成 target = w 会发生什么,会关系到run_w_code函数吗?如果我们改变了代码,但没有修改这里的代码,可能会导致错误的调用 run_z_code 函数并引发错误。用防御型的方法来写代码会很好,它能让代码运行正确,或者立马执行错误,即使你在未来对它进行了修改。 在代码开头的注释很好的一步,但是人们经常懒得读或者更新注释。一旦发生这种情况,注释会变得没用。但有了断言,我可以同时对代码块的假设书写文档,并且在它们违反的时候触发一个干净的错误 assert target in (x, y, z) if target == x: run_x_code() elif target == y: run_y_code() else: assert target == z run_z_code() 这样,断言是一种防御型编程,同时也是一种文档。我想到一个更好的方案: if target == x: run_x_code() elif target == y: run_y_code() elif target == z: run_z_code() else: # This can never happen. But just in case it does... raise RuntimeError("an unexpected error occurred") 按约定进行设计是断言的另一个好的用途。我们想象函数与调用者之间有个约定,比如下面的: “如果你传给我一个非空字符串,我保证传会字符串的第一个字母并将其大写。” 如果约定被函数或调用这破坏,代码就会出问题。我们说函数有一些前置条件和后置条件,所以函数就会这么写: def first_upper(astring): assert isinstance(astring, str) and len(astring) > 0 result = astring[0].upper() assert isinstance(result, str) and len(result) == 1 assert result == result.upper() return result 按约定设计的目标是为了正确的编程,前置条件和后置条件是需要保持的。这是断言的典型应用场景,因为一旦我们发布了没有问题的代码到产品中,程序会是正确的,并且我们能安全的移除检查。 建议不要用断言的场景: 不要用它测试用户提供的数据 不要用断言来检查你觉得在你的程序的常规使用时会出错的地方。断言是用来检查非常罕见的问题。你的用户不应该看到任何断言错误,如果他们看到了,这是一个bug,修复它。 有的情况下,不用断言是因为它比精确的检查要短,它不应该是懒码农的偷懒方式。 不要用它来检查对公共库的输入参数,因为它不能控制调用者,所以不能保证调用者会不会打破双方的约定。 不要为你觉得可以恢复的错误用断言。换句话说,不用改在产品代码里捕捉到断言错误。 不要用太多断言以至于让代码很晦涩。

优秀的个人博客,低调大师

《Oracle高性能自动化运维》一一3.4 Redo优化

3.4 Redo优化从前面的内容可以知道,Oracle Redo的产生主要是由DML事务引起的,与DML事务相关的数据库更改主要包含:数据块更改;回滚段数据块镜像更新;数据库内部信息更新(数据字典表更新)。可以通过日志挖掘获取数据库更改的相关信息,如下: 可以看到,Redo中记录了DML事物的数据块更改、回滚段更新等信息。因此,可以考虑采取以下措施来减少Redo的产生,从而达到优化Redo的目的:减少索引键更新操作;减少大表(键)更新操作;使用Direct Load加载数据;使用Nologging进行特定操作;使用临时表(Temporary Table);;使用外部表(External Table);批量化处理DML业务程序;减少事务Commit次数,采用组提交的方式;减少Select For Update显示锁定,可以明显减少Re

优秀的个人博客,低调大师

自动化运维工具Ansible-playbook详解和案例实战(四)

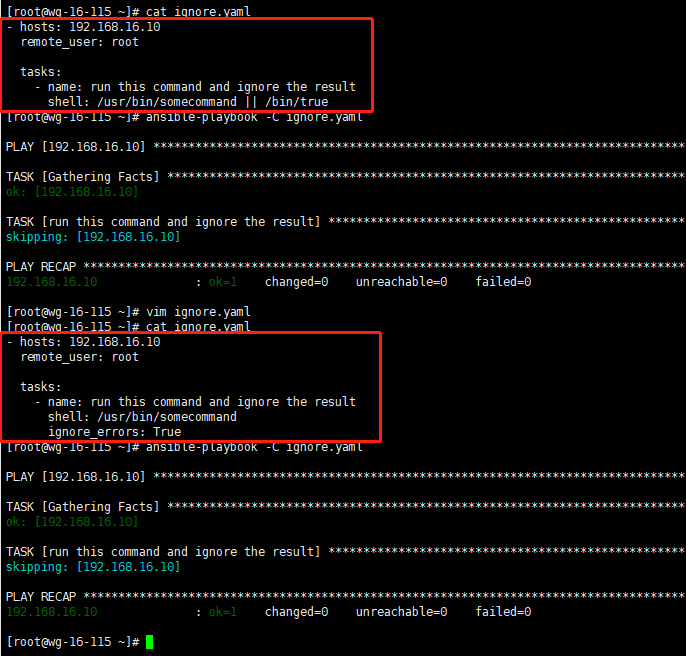
1、playbook-剧本介绍 playbooks是 一个不同于使用Ansible命令行执行方式的模式,其功能更强大灵活。简单来说,playbook是一个非常简单的配置管理和多主机部署系统,不同于任何已经存在的模式,可作为一个适合部署复杂应用程序的基础。Playbook可以定制配置,可以按照指定的操作步骤有序执行,支持同步和异步方式。值得注意的是playbook是通过YAML格式来进行描述定义的。 1.1、核心元素 hosts:执行的远程主机列表 tasks:任务,由模板定义的操作列表 variables:变量,内置变量或者自定义变量在playboook中调用 templates:模板,即 使用模板语法的文件;可替换模板中的变量并实现一些简单逻辑的而文件 handlers:处理器,和notify结合使用 ;当某条件满足时,触发执行的操作 tags:标签,指定某条件下,用于选择运行playbook中的部分代码。Ansible具有幂等性,因此会自动跳过没有变化的部分,即便如此,有些代码为测试其确实没有发生变化的时间依然会非常的长。此时,如果确信其没有变化,就可以通过tags跳过这些代码片段 roles:角色 1.2、基础组件 hosts:playbook中的每个play的目的都是为了让某个或者某些主机在某个指定的用户身份执行任务。hosts用于指定任务的主机,须事先定义在主机清单中形式如下: hosts: websrvs remote_user:可用于hosts和tasks中,也可以通过指定sudo的方式在远程主机上执行,其可用于paly全局或某任务;此外甚至可以在sudo时使用sudo_user指定sudo时切换的用户形式如下: hosts: 192.168.16.10 remote_user: root tasks:name: test connectionping:remote_user: rootsudo: yessudo_user: root 3. tasks:任务列表;格式有两种: action: module argument module: argument 建议使用 注意:shell和command模块后面跟命令,而非key=value 某任务的状态在运行后changed时,可通过‘notify’通知给相应的handlers 任务可以通过‘tags’打标签,而后可在absible-playbook命令上使用-t指定进行调用 示例: ```bash tasks: - name: disable selinux command: /sbin/setenforce 0 如果命令或者脚本的退出码不为零,可以使用一下方式替代 tasks: - name: run this command and ignore the result shell: /usr/bin/somecommand || /bin/true 或者 tasks: - name: run this command and ignore the result shell: /usr/bin/somecommand ignore_errors: True 1.3、yaml语法 YAML的语法和其他高阶语言类似并且可以简单表达清单、散列表、标量等数据结构,其结构通过空格来展示。(列表用横杆表示,键值对用冒号分割,键值对里又可以嵌套另外的键值对)YAML文件扩展名通常为.yaml或者.yml。下面为示例一定要对齐,只能使用空格 name: wkx #冒号后有空格 age: 28 gender: male spouse: name: rlt age: 27 gender: female children: - name: dabao #横杠后有空格 age: 4 gender: femle - name: xiaobao age: 1 gender: male 1.4、playbook的运行方式 ansible-playbook <filename.yaml> ... [options]常用选项:--check 只检测可能会发生的改变,但不真正执行操作--list-hosts 列出运行任务的主机--limit 主机列表,只针对主机列表中的主机执行-v 显示过程 -vv -vvv 更详细ansible-playbook file.yaml --check 只检测Ansible-playbook file.yaml 执行Ansible-playbook file.yaml --limit websevs 仅websevs主机执行 1.5、Playbook VS shellscript Shell脚本 #!/bin/bash # install apache yum -y install httpd #copy conf file cp /tmp/http.conf /etc/httpd/conf/httpd.conf #start service systemctl enable httpd systemctl start httpd Palybook - hosts: wensevs remote_user: root tasks: - name: install apache yum: name=httpd - name: copy conf file copy: src=/tmp/http.conf dest=/etc/httpd/conf/httpd.conf - name: start service service: name=httpd state=started enabled=yes 2、handles和notify结合条件使用 Handlers:是task列表,这些task与前述的task并没有本质的区别,用于当关注的资源发生变化时,才会采取一定的操作Notify:此action被用于每个play的最后被触发,这样可以避免多次有改变发生时每次都执行指定的操作,尽在所有变化发生后完成一次性的执行指定操作。在notify中列出的操作称为handler,也即notify中调用handler中定义的操作。示例:Handles和notify的使用: - hosts: websrvs remote_user: root tasks: - name: add group nginx tags: user user: name=nginx state=present - name: add user nginx group: name=nginx state=present group=nginx - name: install nginx yum: name=nginx state=present - name: copy file copy: src=/tmp/nginx.conf dest=/etc/nginx/nginx.conf notify: - restart nginx - check nginx process handlers: - name: restart nginx #必须和notify中定义的名字一致 service: name=nginx status=restarted enabled=yes - check nginx process shell: killall -0 nginx > /tmp/nginx.log Tags的使用 1. hosts: wensrvs remote_user: root tasks: 2. name: install httpd yum: name=httpd status=present 3. name: copy conf file copy: src=files/httpd.conf dest=/etc/httpd/conf/httpd.conf tags: conf 4. name: start service tags: service service: name=httpd state=started enabled=yes 3、playbook中变量使用 3.1、变量 变量名:仅能由字母、数字和下划线组成,且只能以字母开头变量来源: ansible setup 模块下的变量都可以使用 /etc/ansible/hosts中定义的普通变量:主机组中主机单独定义,优先级高于公共变量公共组变量:针对主机组中所有的主机定义统一变量 通过命令行指定变量,优先级最好ansible-playbook -e varname=value 在playbook中定义var:var1: value1var2: value2 在role中定义 3.2、变量的调用方式 通过{{ variable_name }}调用变量,且变量名前后必须有空格,有时候使用”{{ variable_name }}”才能生效 anible-playbook -e 选项指定ansible-playbook -e "hosts=www user=wkx" test.yaml 3.3、使用变量 使用变量文件 cat vars.yaml var1: httpd var2: nginx cat var.yaml - hosts: 192.168.16.115 remote_user: root vars_files: - vars.yaml tasks: - name: touch httpd.txt file: name={{var1}}.txt state=touch #默认创建在当前用户下 - name: touch nginx.log file: name={{var2}}.log state=touch 使用setup变量 cat var.yaml - hosts: 192.168.16.115 remote_user: root tasks: - name: create log file file: name=/root/ansible-test/{{ ansible_fqdn }} state=touch #{{ ansible_fqdn }}为setup模块中域名的一个内置变量 命令行使用变量 cat var.yaml - hosts: 192.168.16.115 remote_user: root tasks: - name: create log file file: name=/root/ansible-test/{{ pkg }} state=touch ansible-playbook -e pkg=haha var.yaml hosts中的变量(/etc/asible/hosts) [websrvs:vars] #公共(组)变量 mark="-" [websrvs] #普通变量 192.168.16.115 hname=wg sname=115 192.168.16.118 hname=wg sname=118 ansible websrvs -m hostname -a 'name= {{ hname }}{{ mark }}16{{ mark }}{{sname}}' 3.4、模板文件templetes 文本文件,嵌套有脚本(使用模板编程语言编写)Jinja2语音,使用 字面量,有下面形式字符串:使用单引号或者双引号数字:整数、浮点数列表:[haha,xixi,hehe,lele]元组:(haha,xixi,hehe,lele)字典:{name:wkx,gender:male}布尔型:true、false算术运算:+、-、*、/、//、%、** 分别是加减乘除整除求余幂比较操作:==,!=,>,<,>=,<=逻辑运算:and,or,not流表达式:for,if,when When条件测试:如果需要根据变量、facts或此前任务的执行结果来作为某task执行与否的前提时要用到条件测试,通过when语句实现,在task中使用,jinja2的语法格式示例: cat var.yaml - hosts: 192.168.16.115 remote_user: root tasks: - name: "create file" file: name="/root/ansible-test/xixi" state=touch when: ansible_os_family == "RedHat" 迭代嵌套自变量示例1: - hosts: 192.168.16.115 remote_user: root tasks: - name: "create some file" file: name=/root/ansible-test/{{ item }} state=touch #创建文件,嵌套变量在下面 when: ansible_distribution_major_version == "7" #匹配条件,条件满足时执行 with_items: - haha - xixi - lele - name: install some packages yum: name={{ item }} with_items: - lrzsz - net-tools 示例2: cat user.yaml - hosts: 192.168.16.115 remote_user: root tasks: - name: "create some group" group: name={{ item }} when: ansible_distribution_major_version == "7" with_items: - g1 - g2 - g3 - name: cerate user user: name={{ item.name }} group={{ item.group }} with_items: - { name: "user1",group: "g1"} - { name: "user2",group: "g2"} - { name: "user3",group: "g3"} Playbook中template for if {% for vhost in nginx_vhosts %} server{ listen {{ vhost.listen | default(‘80 default_server’)}}; {% if vhost.server_name is defined %} Server_name{{ vhost.server_name }}; {% endif %} {% if vhost.root is defined %} root {{ vhost.root }} {% endif %} 示例1: cat temnginx.yaml --- - hosts: websrvs remote_user: root vars: nginx_hosts: - 80 - 8088 - tasks: - name: templete config template: src=/root/ansible-test/nginx.conf.j2 dest=/root/nginx.conf cat nginx.conf.j2 {% for vhost in nginx_hosts %} server { listen {{ vhost }} } {% endfor %} 生成为文件为 cat /root/nginx.conf server { listen 80 } server { listen 8088 } 示例2: cat temnginx.yaml --- - hosts: websrvs remote_user: root vars: nginx_hosts: - web1: listen: 8080 root: "/var/www/nginx/web1/" - web2: listen: 8080 server_name: "www.wkx.com" root: "/var/www/nginx/web2/" tasks: - name: templete config template: src=/root/ansible-test/nginx.conf.j2 dest=/root/nginx.conf cat nginx.conf.j2 {% for vhost in nginx_hosts %} server { listen {{ vhost.listen }} {% if vhost.server_name is defined %} server_name {{ vhost.server_name }} {% endif %} root {{ vhost.root }} } {% endfor %} 4、通过ansible-playbook实现对zabbix-agent批量安装 cat zabbix-agent.yml - hosts: agent remote_user: root tasks: - name: copy zabbix-agent copy: src=/mnt/zabbix-agent-4.4.0-1.el7.x86_64.rpm dest=/tmp - name: install zabbix-agent yum: name=/tmp/zabbix-agent-4.4.0-1.el7.x86_64.rpm - name: copy config copy: src=/etc/zabbix/zabbix_agentd.conf dest=/etc/zabbix/zabbix_agentd.conf - name: modify conf hostname lineinfile: path: /etc/zabbix/zabbix_agentd.conf regexp: "^Hostname" line: "Hostname={{ansible_hostname}}" - name: start zabbix-agent service: name=zabbix-agent state=started enabled=yes 5、role ansible自1.2版本后引入的新特性。用于层次性、结构性的组织playbook。Roles能够根据层次型结构自动装载变量文件、tasks以及handlers等。要使用roles只需要在playbook中使用include指令即可。简单来说,roles就是通过分别将变量、文件、任务、模板以及处理器放置于单独的目录中,并可以便捷的include他们的一种机制。角色一般基于主机结构构建服务的场景中,但也可以是用于构建守护进程等场景中。 复杂场景:建议使用roles,代码复用度高变更主机及主机组如命名不规范维护或传承成本高某些功能需要多个playbook,通过include实现Ansible的roles目录结构每个角色,以特定的层级目录结构进行组织 Roles目录结构: playbook.yaml roles/ project/ 项目名称,有以下子目录 tasks/ 定义task、role的基本元素,至少包含一个名为main.yaml的文件;其他需要的文件在此通过include进行包含 files/ 存放由copy或者script模块调用的文件 vars/ 不常用,定义变量;至少包含一个名为main.yaml的文件;其他需要的文件在此通过include进行包含 default/ 不常用,设定默认变量时使用此目录中的main.yaml templates/ template模块查找所需要的模板问文件的目录 handlers/ meta/ 不常用,定义当前角色的特殊设定以及依赖关系;至少包含一个名为main.yaml的文件;其他需要的文件在此通过include进行包含

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册