首页 文章 精选 留言 我的

精选列表

搜索[手动],共10007篇文章
优秀的个人博客,低调大师

Centos0S7手动安装OpenStack Pike版--(keystone)

OpenStack安装指南_Mitakahttp://down.51cto.com/data/2331199 Openstack管理手册-Newton版-CentOS7.2http://down.51cto.com/data/2331201 #Configure Keystone mysql -uroot -ppasswd123 -e "CREATE DATABASE keystone" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON keystone.TO 'keystone'@'localhost' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON keystone.TO 'keystone'@'%' IDENTIFIED BY 'passwd123'" vim /etc/keystone/keystone.conf [database] connection = mysql+pymysql://keystone:passwd123@controller/keystone [token] provider = fernet su -s /bin/sh -c "keystone-manage db_sync" keystone keystone-manage fernet_setup --keystone-user keystone --keystone-group keystone keystone-manage credential_setup --keystone-user keystone --keystone-group keystone keystone-manage bootstrap --bootstrap-password ADMIN_PASS \ --bootstrap-admin-urlhttp://controller:35357/v3/\ --bootstrap-internal-urlhttp://controller:5000/v3/\ --bootstrap-public-urlhttp://controller:5000/v3/\ --bootstrap-region-id RegionOne Configure the Apache HTTP server vim /etc/httpd/conf/httpd.conf ServerName controller ln -s /usr/share/keystone/wsgi-keystone.conf /etc/httpd/conf.d/ systemctl start httpd.service systemctl enable httpd.service systemctl status httpd.service export OS_USERNAME=admin export OS_PASSWORD=passwd123 export OS_PROJECT_NAME=admin export OS_USER_DOMAIN_NAME=Default export OS_PROJECT_DOMAIN_NAME=Default export OS_AUTH_URL=http://controller:35357/v3 export OS_IDENTITY_API_VERSION=3 openstack project create --domain default --description "Service Project" service openstack project create --domain default --description "Demo Project" demo openstack user create --domain default --password passwd123 demo openstack role create user openstack role add --project demo --user demo user unset OS_AUTH_URL OS_PASSWORD openstack --os-auth-urlhttp://controller:35357/v3\ --os-project-domain-name Default --os-user-domain-name Default \ --os-project-name admin --os-username admin token issue openstack --os-auth-urlhttp://controller:5000/v3\ --os-project-domain-name Default --os-user-domain-name Default \ --os-project-name demo --os-username demo token issue vim admin-openrc export OS_PROJECT_DOMAIN_NAME=Default export OS_USER_DOMAIN_NAME=Default export OS_PROJECT_NAME=admin export OS_USERNAME=admin export OS_PASSWORD=passwd123 export OS_AUTH_URL=http://controller:35357/v3 export OS_IDENTITY_API_VERSION=3 export OS_IMAGE_API_VERSION=2 source admin-openrc openstack token issue 本文转自 OpenStack2015 博客,原文链接: http://blog.51cto.com/andyliu/2069163 如需转载请自行联系原作者
优秀的个人博客,低调大师

Centos0S7手动安装OpenStack Pike版--(Evironment)

OpenStack安装指南_Mitakahttp://down.51cto.com/data/2331199 Openstack管理手册-Newton版-CentOS7.2http://down.51cto.com/data/2331201 [root@controller ~]# cat /etc/hosts 127.0.0.1 localhost localhost.localdomain localhost4 localhost4.localdomain4 192.168.137.145 controller 192.168.137.146 compute 192.168.137.149 storage #Install ALL Packages and Configure Evironment yum install centos-release-openstack-pike -y yum install python-openstackclient -y yum install openstack-selinux -y yum install mariadb mariadb-server python2-PyMySQL -y yum install rabbitmq-server -y yum install memcached python-memcached -y yum install etcd -y yum install openstack-keystone httpd mod_wsgi -y yum install openstack-glance -y yum install -y openstack-nova-api openstack-nova-conductor \ openstack-nova-console openstack-nova-novncproxy \ openstack-nova-scheduler openstack-nova-placement-api yum install -y openstack-neutron openstack-neutron-ml2 \ openstack-neutron-linuxbridge ebtables #Configure RabbitMQ systemctl enable rabbitmq-server.service systemctl start rabbitmq-server.service systemctl status rabbitmq-server.service rabbitmqctl add_user openstack passwd123 rabbitmqctl set_permissions openstack "." "." ".*" #Configure Memcached vim /etc/sysconfig/memcached OPTIONS="-l 127.0.0.1,::1,controller" systemctl enable memcached.service systemctl start memcached.service OpenStack服务可以使用户可靠,分布式键值存储的分布式密钥锁定,存储配置,跟踪服务活性等情况。 #Configure Etcd vim /etc/etcd/etcd.conf [root@controller ~]# vim /etc/etcd/etcd.conf #[Member] ETCD_DATA_DIR="/var/lib/etcd/default.etcd" ETCD_LISTEN_PEER_URLS="http://192.168.137.145:2380" ETCD_LISTEN_CLIENT_URLS="http://192.168.137.145:2379" ETCD_NAME="controller" #[Clustering] ETCD_INITIAL_ADVERTISE_PEER_URLS="http://192.168.137.145:2380" ETCD_ADVERTISE_CLIENT_URLS="http://192.168.137.145:2379" ETCD_INITIAL_CLUSTER="controller=http://192.168.137.145:2380" ETCD_INITIAL_CLUSTER_TOKEN="etcd-cluster-01" ETCD_INITIAL_CLUSTER_STATE="new" systemctl enable etcd systemctl start etcd systemctl status etcd 本文转自 OpenStack2015 博客,原文链接:http://blog.51cto.com/andyliu/2069162 如需转载请自行联系原作者

优秀的个人博客,低调大师

Centos0S7手动安装OpenStack Pike版--(nova)

OpenStack安装指南_Mitakahttp://down.51cto.com/data/2331199 Openstack管理手册-Newton版-CentOS7.2http://down.51cto.com/data/2331201 #Configure Nova mysql -uroot -ppasswd123 -e "CREATE DATABASE nova_api" mysql -uroot -ppasswd123 -e "CREATE DATABASE nova" mysql -uroot -ppasswd123 -e "CREATE DATABASE nova_cell0" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova_api.TO 'nova'@'localhost' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova_api.TO 'nova'@'%' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova.TO 'nova'@'localhost' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova.TO 'nova'@'%' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova_cell0.TO 'nova'@'localhost' IDENTIFIED BY 'passwd123'" mysql -uroot -ppasswd123 -e "GRANT ALL PRIVILEGES ON nova_cell0.TO 'nova'@'%' IDENTIFIED BY 'passwd123'" source admin-openrc openstack user create --domain default --password passwd123 nova openstack role add --project service --user nova admin openstack service create --name nova --description "OpenStack Compute" compute openstack endpoint create --region RegionOne compute publichttp://controller:8774/v2.1 openstack endpoint create --region RegionOne compute internalhttp://controller:8774/v2.1 openstack endpoint create --region RegionOne compute adminhttp://controller:8774/v2.1 openstack user create --domain default --password paswd123 placement openstack role add --project service --user placement admin openstack service create --name placement --description "Placement API" placement openstack endpoint create --region RegionOne placement publichttp://controller:8778 openstack endpoint create --region RegionOne placement internalhttp://controller:8778 openstack endpoint create --region RegionOne placement adminhttp://controller:8778 Edit the /etc/nova/nova.conf openstack-config --set /etc/nova/nova.conf DEFAULT enabled_apis osapi_compute,metadata openstack-config --set /etc/nova/nova.conf api_database connection mysql+pymysql://nova:passwd123@controller/nova_api openstack-config --set /etc/nova/nova.conf database connection mysql+pymysql://nova:passwd123@controller/nova openstack-config --set /etc/nova/nova.conf DEFAULT transport_url rabbit://openstack:passwd123@controller openstack-config --set /etc/nova/nova.conf api auth_strategy keystone openstack-config --set /etc/nova/nova.conf keystone_authtoken auth_urihttp://controller:5000 openstack-config --set /etc/nova/nova.conf keystone_authtoken auth_urlhttp://controller:35357 openstack-config --set /etc/nova/nova.conf keystone_authtoken memcached_servers controller:11211 openstack-config --set /etc/nova/nova.conf keystone_authtoken auth_type password openstack-config --set /etc/nova/nova.conf keystone_authtoken project_domain_name default openstack-config --set /etc/nova/nova.conf keystone_authtoken user_domain_name default openstack-config --set /etc/nova/nova.conf keystone_authtoken project_name service openstack-config --set /etc/nova/nova.conf keystone_authtoken username nova openstack-config --set /etc/nova/nova.conf keystone_authtoken password passwd123 openstack-config --set /etc/nova/nova.conf DEFAULT my_ip 192.168.137.145 openstack-config --set /etc/nova/nova.conf DEFAULT use_neutron True openstack-config --set /etc/nova/nova.conf DEFAULT firewall_driver nova.virt.firewall.NoopFirewallDriver openstack-config --set /etc/nova/nova.conf vnc enabled true openstack-config --set /etc/nova/nova.conf vnc vncserver_listen 192.168.137.145 openstack-config --set /etc/nova/nova.conf vnc vncserver_proxyclient_address 192.168.137.145 openstack-config --set /etc/nova/nova.conf glance api_servershttp://controller:9292 openstack-config --set /etc/nova/nova.conf oslo_concurrency lock_path /var/lib/nova/tmp openstack-config --set /etc/nova/nova.conf placement os_region_name RegionOne openstack-config --set /etc/nova/nova.conf placement project_domain_name Default openstack-config --set /etc/nova/nova.conf placement project_name service openstack-config --set /etc/nova/nova.conf placement auth_type password openstack-config --set /etc/nova/nova.conf placement user_domain_name Default openstack-config --set /etc/nova/nova.conf placement auth_urlhttp://controller:35357/v3 openstack-config --set /etc/nova/nova.conf placement username placement openstack-config --set /etc/nova/nova.conf placement password passwd123 vim /etc/httpd/conf.d/00-nova-placement-api.conf <Directory /usr/bin> <IfVersion >= 2.4> Require all granted </IfVersion> <IfVersion < 2.4> Order allow,deny Allow from all </IfVersion> </Directory> systemctl restart httpd systemctl status httpd su -s /bin/sh -c "nova-manage api_db sync" nova su -s /bin/sh -c "nova-manage cell_v2 map_cell0" nova su -s /bin/sh -c "nova-manage cell_v2 create_cell --name=cell1 --verbose" nova su -s /bin/sh -c "nova-manage db sync" nova nova-manage cell_v2 list_cells systemctl enable openstack-nova-api.service openstack-nova-consoleauth.service openstack-nova-scheduler.service \ openstack-nova-conductor.service openstack-nova-novncproxy.service systemctl start openstack-nova-api.service openstack-nova-consoleauth.service openstack-nova-scheduler.service \ openstack-nova-conductor.service openstack-nova-novncproxy.service systemctl status openstack-nova-api.service openstack-nova-consoleauth.service openstack-nova-scheduler.service \ openstack-nova-conductor.service openstack-nova-novncproxy.service openstack service list 本文转自 OpenStack2015 博客,原文链接: http://blog.51cto.com/andyliu/2069165 如需转载请自行联系原作者

优秀的个人博客,低调大师

Python 的“怪异”设计:bool 竟是 int 的子类,垃圾回收还能手动关闭

波兰开发者 Maciej Kowalski 近日在其个人博客整理了一系列关于 Python 的"怪异"设计。这些特性看似反直觉,实则反映了 Python 作为一门纯面向对象语言的核心哲学——一切皆对象。 Python 比俄罗斯联邦还老。这是文章给出的第一个冷知识。Python 诞生于 1991 年 2 月 20 日,而苏联解体发生在同年 12 月 26 日。这意味着 Python 实际上比俄罗斯联邦还要"年长"近 10 个月。尽管近年来 Python 因人工智能和数据科学的爆发而风靡全球,甚至波兹南工业大学都已用 Python 取代 Delphi 作为教学语言,但它本质上是一门有着 30 多年历史的成熟语言。 更让人感到意外的是,在 Python 中 bool 竟然是 int 的子类。查看 CPython 的 builtins.pyi 定义可以清楚地看到 class bool(int) 这样的继承关系。因此 True + True 的结果是 2,而不是报错。这与 Java 等语言形成鲜明对比——Java 中 true + true 会直接触发编译错误。Python 的设计者认为这种多态更加优雅,而且它允许开发者通过继承 int 来创建自定义数值类型。例如,作者展示了一个 modulo10 类,继承自 int 并对加法运算取模,可以直接赋值给 int 类型的变量而不会触发类型检查错误。 class modulo10(int): def __add__(self, other): return super().__add__(other) % 10 x: int = modulo10(5) # no errors, types match assert x + 6 == 1 # pas Python 中的 None、True、False 都是单例对象(singleton),在解释器启动时就被创建,垃圾回收器永远不会触碰它们。反复调用 id(None) 会得到完全相同的内存地址。更实用的是小整数缓存机制:CPython 会预先分配 -5 到 256 之间的整数对象。这本质上是计算机科学中经典的 interning 模式,可以显著减少内存分配开销。 文章还提到了一个容易被忽视的"陷阱"——Python 的循环垃圾回收是可选的。只需四行代码就能人为制造内存泄漏:导入 gc 模块,调用 gc.disable() 禁用循环垃圾回收器,然后创建一个自引用的列表 a = []; a.append(a)。由于 Python 主要依赖引用计数来管理内存,而循环引用会导致引用计数永远无法归零,如果同时关闭了循环垃圾回收器,这段内存就真的泄漏了。 import gc gc.disable() a = [] a.append(a) 此外,文章还提到了 GIL(全局解释器锁)这一老生常谈的话题。由于 GIL 的存在,Python 的多线程程序在任意时刻只有一个线程在执行 Python 字节码,无论你的 CPU 有多少核心。对于 I/O 密集型任务,多线程依然有意义;但对于 CPU 密集型任务,多线程不仅无益,甚至可能适得其反。值得庆幸的是,Python 3.13 已经引入了实验性的自由线程模式,未来 GIL 有望被彻底移除。 文章还简要提及了 slots 内存优化、可变对象作为默认参数的经典陷阱,以及元类(metaclass)等高级特性。这些设计共同构成了 Python"一切皆对象"的语言哲学——函数是对象、类型是对象、甚至类本身也是对象。 参考来源:https://kowal.dev/blog/python-is-weird/

优秀的个人博客,低调大师

走进JavaWeb技术世界12:从手动编译打包到项目构建工具Maven

本系列文章将整理到我在GitHub上的《Java面试指南》仓库,更多精彩内容请到我的仓库里查看 https://github.com/h2pl/Java-Tutorial 喜欢的话麻烦点下Star哈 文章首发于我的个人博客: www.how2playlife.com 本文是微信公众号【Java技术江湖】的《走进JavaWeb技术世界》其中一篇,本文部分内容来源于网络,为了把本文主题讲得清晰透彻,也整合了很多我认为不错的技术博客内容,引用其中了一些比较好的博客文章,如有侵权,请联系作者。 该系列博文会告诉你如何从入门到进阶,从servlet到框架,从ssm再到SpringBoot,一步步地学习JavaWeb基础知识,并上手进行实战,接着了解JavaWeb项目中经常要使用的技术和组件,包括日志组件、Maven、Junit,等等内容,以便让你更完整地了解整个JavaWeb技术体系,形成自己的知识框架。 如果对本系列文章有什么建议,或者是有什么疑问的话,也可以关注公众号【Java技术江湖】联系作者,欢迎你参与本系列博文的创作和修订。 文末赠送8000G的Java架构师学习资料,需要的朋友可以到文末了解领取方式,资料包括Java基础、进阶、项目和架构师等免费学习资料,更有数据库、分布式、微服务等热门技术学习视频,内容丰富,兼顾原理和实践,另外也将赠送作者原创的Java学习指南、Java程序员面试指南等干货资源) maven简介 1.1 Maven是什么 Maven是一个项目管理和综合工具。 Maven提供了开发人员构建一个完整的生命周期框架。开发者团队可以自动完成项目的基础工具建设, Maven使用标准的目录结构和默认构建生命周期。 在多个开发者团队环境时, Maven可以设置按标准在非常短的时间里完成配置工作。 由于大部分项目的设置都很简单, 并且可重复使用, Maven让开发人员的工作更轻松, 同时创建报表, 检查, 构建和测试自动化设置。 用过GitHub的同学看到这里应该感觉似曾相识,对,Maven和git的作用很相似,都是为了方便项目的创建与管理。 概括地说, Maven简化和标准化项目建设过程。 处理编译, 分配, 文档, 团队协作和其他任务的无缝连接。 Maven增加可重用性并负责建立相关的任务。 1.2 Maven发展史 Maven设计之初, 是为了简化Jakarta Turbine项目的建设。 在几个项目, 每个项目包含了不同的Ant构建文件。 JAR检查到CVS。 Apache组织开发Maven可以建立多个项目, 发布项目信息, 项目部署, 在几个项目中JAR文件提供团队合作和帮助。 Maven的经历了Maven-> Maven2 -> Maven3的发展。 1.3 为什么要用Maven Maven之前我们经常使用Ant来进行Java项目的构建, 然后Ant仅是一个构建工具, 它并未对项目的中的工程依赖以及项目本身进行管理, 并且Ant作为构建工具未能消除软件构建的重复性, 因为不同的项目需要编写对应的Ant任务。 Maven作为后来者, 继承了Ant的项目构建功能, 并且提供了依赖关系, 项目管理的功能, 因此它是一个项目管理和综合工具, 其核心的依赖管理, 项目信息管理, 中央仓库, 约定大于配置的核心功能使得Maven成为当前Java项目构建和管理工具的标准选择。 学习Maven的理由是非常多: 主流IDE(Eclipse,IDEA,Netbean) 够内置了Maven SpringFramework已经不再提供jar的下载, 直接通过Maven进行依赖下载。 在github, 开源社区几乎所有流行的Java项目都是通过Maven进行构建和管理的。 Maven 新手入门 Maven概念 Maven作为一个构建工具,不仅能帮我们自动化构建,还能够抽象构建过程,提供构建任务实现;它跨平台,对外提供了一致的操作接口,这一切足以使它成为优秀的、流行的构建工具。 Maven不仅是构建工具,还是一个依赖管理工具和项目管理工具,它提供了中央仓库,能帮我自动下载构件。 maven的安装 一:因为本人是window系统,所以这里只介绍window下如何安装,在安装Maven之前,先确认已经安装了JDK. 二:接着去Maven官网下载界面下载想要的版本解压到你想要的目录就行 三:最后设置一下环境变量,将Maven安装配置到操作系统环境中,主要就是配置M2_HOME和PATH两项,如图 都搞定后,验证一下,打开doc输入 mvn -v如何得到下面信息就说明配置成功了 maven目录 bin目录: 该目录包含了mvn运行的脚本,这些脚本用来配置java命令,准备好classpath和相关的Java系统属性,然后执行Java命令。 boot目录: 该目录只包含一个文件,该文件为plexus-classworlds-2.5.2.jar。plexus-classworlds是一个类加载器框架,相对于默认的java类加载器,它提供了更加丰富的语法以方便配置,Maven使用该框架加载自己的类库。 conf目录: 该目录包含了一个非常重要的文件settings.xml。直接修改该文件,就能在机器上全局地定制Maven的行为,一般情况下,我们更偏向于复制该文件至~/.m2/目录下(~表示用户目录),然后修改该文件,在用户范围定制Maven的行为。 lib目录: 该目录包含了所有Maven运行时需要的Java类库,Maven本身是分模块开发的,因此用户能看到诸如maven-core-3.0.jar、maven-model-3.0.jar之类的文件,此外这里还包含一些Maven用到的第三方依赖如commons-cli-1.2.jar、commons-lang-2.6.jar等等。 Maven常用命令说明 mvn clean:表示运行清理操作(会默认把target文件夹中的数据清理)。 mvn clean compile:表示先运行清理之后运行编译,会将代码编译到target文件夹中。 mvn clean test:运行清理和测试。 mvn clean package:运行清理和打包。 mvn clean install:运行清理和安装,会将打好的包安装到本地仓库中,以便其他的项目可以调用。 mvn clean deploy:运行清理和发布(发布到私服上面)。 上面的命令大部分都是连写的,大家也可以拆分分别执行,这是活的,看个人喜好以及使用需求,Eclipse Run as对maven项目会提供常用的命令。 Maven使用 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.tengj</groupId> <artifactId>springBootDemo1</artifactId> <version>0.0.1-SNAPSHOT</version> <name>springBootDemo1</name> </project> 代码的第一行是XML头,指定了该xml文档的版本和编码方式。project是所有pom.xml的根元素,它还声明了一些POM相关的命名空间及xsd元素。根元素下的第一个子元素modelVersion指定了当前的POM模型的版本,对于Maven3来说,它只能是4.0.0代码中最重要是包含了groupId,artifactId和version了。这三个元素定义了一个项目基本的坐标,在Maven的世界,任何的jar、pom或者jar都是以基于这些基本的坐标进行区分的。 groupId定义了项目属于哪个组,随意命名,比如谷歌公司的myapp项目,就取名为 com.google.myapp artifactId定义了当前Maven项目在组中唯一的ID,比如定义hello-world。 version指定了项目当前的版本0.0.1-SNAPSHOT,SNAPSHOT意为快照,说明该项目还处于开发中,是不稳定的。 name元素生命了一个对于用户更为友好的项目名称,虽然这不是必须的,但还是推荐为每个POM声明name,以方便信息交流 [](http://tengj.top/2018/01/01/maven/#%E4%BE%9D%E8%B5%96%E7%9A%84%E9%85%8D%E7%BD%AE "依赖的配置")依赖的配置 <project> ... <dependencies> <dependency> <groupId>实际项目</groupId> <artifactId>模块</artifactId> <version>版本</version> <type>依赖类型</type> <scope>依赖范围</scope> <optional>依赖是否可选</optional> <!—主要用于排除传递性依赖--> <exclusions> <exclusion> <groupId>…</groupId> <artifactId>…</artifactId> </exclusion> </exclusions> </dependency> <dependencies> ... </project> 根元素project下的dependencies可以包含一个或者多个dependency元素,以声明一个或者多个项目依赖。每个依赖可以包含的元素有: grounpId、artifactId和version:以来的基本坐标,对于任何一个依赖来说,基本坐标是最重要的,Maven根据坐标才能找到需要的依赖。 type:依赖的类型,对于项目坐标定义的packaging。大部分情况下,该元素不必声明,其默认值为jar scope:依赖的范围 optional:标记依赖是否可选 exclusions:用来排除传递性依赖 [](http://tengj.top/2018/01/01/maven/#%E4%BE%9D%E8%B5%96%E8%8C%83%E5%9B%B4 "依赖范围")依赖范围 依赖范围就是用来控制依赖和三种classpath(编译classpath,测试classpath、运行classpath)的关系,Maven有如下几种依赖范围: compile:编译依赖范围。如果没有指定,就会默认使用该依赖范围。使用此依赖范围的Maven依赖,对于编译、测试、运行三种classpath都有效。典型的例子是spring-code,在编译、测试和运行的时候都需要使用该依赖。 test:测试依赖范围。使用次依赖范围的Maven依赖,只对于测试classpath有效,在编译主代码或者运行项目的使用时将无法使用此依赖。典型的例子是Jnuit,它只有在编译测试代码及运行测试的时候才需要。 provided:已提供依赖范围。使用此依赖范围的Maven依赖,对于编译和测试classpath有效,但在运行时候无效。典型的例子是servlet-api,编译和测试项目的时候需要该依赖,但在运行项目的时候,由于容器以及提供,就不需要Maven重复地引入一遍。 runtime:运行时依赖范围。使用此依赖范围的Maven依赖,对于测试和运行classpath有效,但在编译主代码时无效。典型的例子是JDBC驱动实现,项目主代码的编译只需要JDK提供的JDBC接口,只有在执行测试或者运行项目的时候才需要实现上述接口的具体JDBC驱动。 system:系统依赖范围。该依赖与三种classpath的关系,和provided依赖范围完全一致,但是,使用system范围的依赖时必须通过systemPath元素显示地指定依赖文件的路径。由于此类依赖不是通过Maven仓库解析的,而且往往与本机系统绑定,可能构成构建的不可移植,因此应该谨慎使用。systemPath元素可以引用环境变量,如: <dependency> <groupId>javax.sql</groupId> <artifactId>jdbc-stdext</artifactId> <Version>2.0</Version> <scope>system</scope> <systemPath>${java.home}/lib/rt.jar</systemPath> </dependency> import:导入依赖范围。该依赖范围不会对三种classpath产生实际的影响。 上述除import以外的各种依赖范围与三种classpath的关系如下: 传递性依赖 比如一个account-email项目为例,account-email有一个compile范围的spring-code依赖,spring-code有一个compile范围的commons-logging依赖,那么commons-logging就会成为account-email的compile的范围依赖,commons-logging是account-email的一个传递性依赖 有了传递性依赖机制,在使用Spring Framework的时候就不用去考虑它依赖了什么,也不用担心引入多余的依赖。Maven会解析各个直接依赖的POM,将那些必要的间接依赖,以传递性依赖的形式引入到当前的项目中。 依赖范围 假设A依赖于B,B依赖于C,我们说A对于B是第一直接依赖,B对于C是第二直接依赖,A对于C是传递性依赖。第一直接依赖和第二直接依赖的范围决定了传递性依赖的范围,如下图所示,最左边一行表示第一直接依赖范围,最上面一行表示第二直接依赖范围,中间的交叉单元格则表示传递依赖范围。 从上图中,我们可以发现这样的规律: 当第二直接依赖的范围是compile的时候,传递性依赖的范围与第一直接依赖的范围一致; 当第二直接依赖的范围是test的时候,依赖不会得以传递; 当第二直接依赖的范围是provided的时候,只传递第一直接依赖范围也为provided的依赖,切传递依赖的范围同样为provided; 当第二直接依赖的范围是runtime的时候,传递性依赖的范围与第一直接依赖的范围一致,但compile列外,此时传递性依赖范围为runtime. Maven和Gradle的比较 Java生态体系中有三大构建工具:Ant、Maven和Gradle。其中,Ant是由Apache软件基金会维护;Maven这个单词来自于意第绪语(犹太语),意为知识的积累,最初在Jakata Turbine项目中用来简化构建过程;Gradle是一个基于Apache Ant和Apache Maven概念的项目自动化构建开源工具,它使用一种基于Groovy的特定领域语言(DSL)来声明项目设置,抛弃了基于XML的各种繁琐配置。 经过几年的发展,Ant几乎销声匿迹,而Maven由于较为不灵活的配置也渐渐被遗忘,而由于Gradle是基于Ant和Maven的一个优化版本,变得如日中天。 Maven的主要功能主要分为依赖管理系统、多模块构建、一致的项目结构、一致的构建模型和插件机制。这里通过这五个方面介绍两者的不同: 依赖管理系统 在Maven的管理体系中,用GroupID、ArtifactID和Version组成的Coordination唯一标识一个依赖项。任何基于Maven构建的项目自身也必须定义这三项属性,生成的包可以是Jar包,也可以是War包或Ear包。 一个典型的引用如下: <dependencies> <dependency> <groupId>org.springframework.boot</groupId> spring-boot-starter-data-jpa </dependency> <dependency> <groupId>org.springframework.boot</groupId> spring-boot-starter-thymeleaf </dependency> <dependency> <groupId>org.springframework.boot</groupId> spring-boot-starter-test <scope>test</scope> </dependency> </dependencies> 这里 GroupID类似于C#中的namespace或者Java中的package,而ArtifactID相当于Class,Version相当于不同版本,如果Version忽略掉,将选择最新的版本链接。 同时,存储这些组件的仓库有远程仓库和本地仓库之分,远程仓库可以是使用世界公用的central仓库,也可以使用Apache Nexus自建的私有仓库;本地仓库则在本地计算机上。通过Maven安装目录下的settings.xml文件可以配置本地仓库的路径,以及采用的远程仓库地址。Gradle在设计时沿用了Maven这种依赖管理体系,同时也引入了改进,让依赖变得更加简洁: dependencies { // This dependency is exported to consumers, that is to say found on their compile classpath. api 'org.apache.commons:commons-math3:3.6.1' // This dependency is used internally, and not exposed to consumers on their own compile classpath. implementation 'com.google.guava:guava:23.0' // Use JUnit test framework testImplementation 'junit:junit:4.12' compile 'org.hibernate:hibernate-core:3.6.7.Final' testCompile ‘junit:junit:4.+' } 另外,Maven和Gradle对依赖项的审视也有所不同。在Maven中,一个依赖项有6种scope,分别是compile、provided、runtime、test、system、import。其中compile为默认。而gradle将其简化为4种,compile、runtime、testCompile、testRuntime。如上述代码“testCompile ‘junit:junit:4.+'”,在Gradle中支持动态的版本依赖,在版本号后面使用+号可以实现动态的版本管理。在解决依赖冲突方面Gradle的实现机制更加明确,两者都采用的是传递性依赖,而如果多个依赖项指向同一个依赖项的不同版本时可能会引起依赖冲突,Maven处理起来较为繁琐,而Gradle先天具有比较明确的策略。 多模块构建 在面向服务的架构中,通常将一个项目分解为多个模块。在Maven中需要定义parent POM(Project Object Model)作为一组module的通用配置模型,在POM文件中可以使用标签来定义一组子模块。parent POM中的build配置以及依赖配置会自动继承给子module。 Gradle也支持多模块构建,在parent的build.gradle中可以使用allprojects和subprojects代码块分别定义应用于所有项目或子项目中的配置。对于子模块中的定义放置在settings.gradle文件中,每一个模块代表project的对象实例,在parent的build.gradle中通过allproject或subprojects对这些对象进行操作,相比Maven更显灵活。 allprojects { task nice << { task -> println "I'm $task.project.name" } } 执行命令gradle -q nice会依次打印出各模块的项目名称。 一致的项目结构 Maven指定了一套项目目录结构作为标准的java项目结构,Gradle也沿用了这一标准的目录结构。如果在Gradle项目中使用了Maven项目结构的话,在Gradle中无需进行多余的配置,只需在文件中包括apply plugin:'java',系统会自动识别source、resource、test source、test resource等相应资源。 同时,Gradle作为JVM上的构建工具,也支持Groovy、Scala等源代码的构建,同样功能Maven通过一些插件也能达到目的,但配置方面Gradle更灵活。 一致的构建模型 为了解决Ant中对项目构建缺乏标准化的问题,Maven设置了标准的项目周期,构建周期:验证、初始化、生成原始数据、处理原始数据、生成资源、处理资源、编译、处理类、生成测试原始数据、处理测试原始数据、生成测试资源、处理测试资源、测试编译、处理测试类、测试、预定义包、生成包文件、预集成测试、集成测试、后集成测试、核实、安装、部署。但这种构建周期也是Maven应用的劣势。因为Maven将项目的构建周期限制过严,无法在构建周期中添加新的阶段,只能将插件绑定到已有的阶段上。而Gradle在构建模型上非常灵活,可以创建一个task,并随时通过depends建立与已有task的依赖关系。 插件机制 两者都采用了插件机制,Maven是基于XML进行配置,而在Gradle中更加灵活。 参考文章 http://www.pianshen.com/article/4537698845https://www.jianshu.com/p/7248276d3bb5https://www.cnblogs.com/lykbk/p/erwerwerwerwerwerwe.htmlhttps://blog.csdn.net/u012131888/article/details/78209514https://blog.csdn.net/belvine/article/details/81073365https://blog.csdn.net/u012131888/article/details/78209514 微信公众号 个人公众号:黄小斜 黄小斜是跨考软件工程的 985 硕士,自学 Java 两年,拿到了 BAT 等近十家大厂 offer,从技术小白成长为阿里工程师。 作者专注于 JAVA 后端技术栈,热衷于分享程序员干货、学习经验、求职心得和程序人生,目前黄小斜的CSDN博客有百万+访问量,知乎粉丝2W+,全网已有10W+读者。 黄小斜是一个斜杠青年,坚持学习和写作,相信终身学习的力量,希望和更多的程序员交朋友,一起进步和成长! 原创电子书:关注公众号【黄小斜】后回复【原创电子书】即可领取我原创的电子书《菜鸟程序员修炼手册:从技术小白到阿里巴巴Java工程师》 程序员3T技术学习资源: 一些程序员学习技术的资源大礼包,关注公众号后,后台回复关键字 “资料” 即可免费无套路获取。 考研复习资料: 计算机考研大礼包,都是我自己考研复习时用的一些复习资料,包括公共课和专业的复习视频,这里也推荐给大家,关注公众号后,后台回复关键字 “考研” 即可免费获取。 技术公众号:Java技术江湖 如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号【Java技术江湖】一位阿里 Java 工程师的技术小站,作者黄小斜,专注 Java 相关技术:SSM、SpringBoot、MySQL、分布式、中间件、集群、Linux、网络、多线程,偶尔讲点Docker、ELK,同时也分享技术干货和学习经验,致力于Java全栈开发! Java工程师必备学习资源: 一些Java工程师常用学习资源,关注公众号后,后台回复关键字 “Java” 即可免费无套路获取。 ​

优秀的个人博客,低调大师

手动为托管版K8S集群添加多可用区的节点

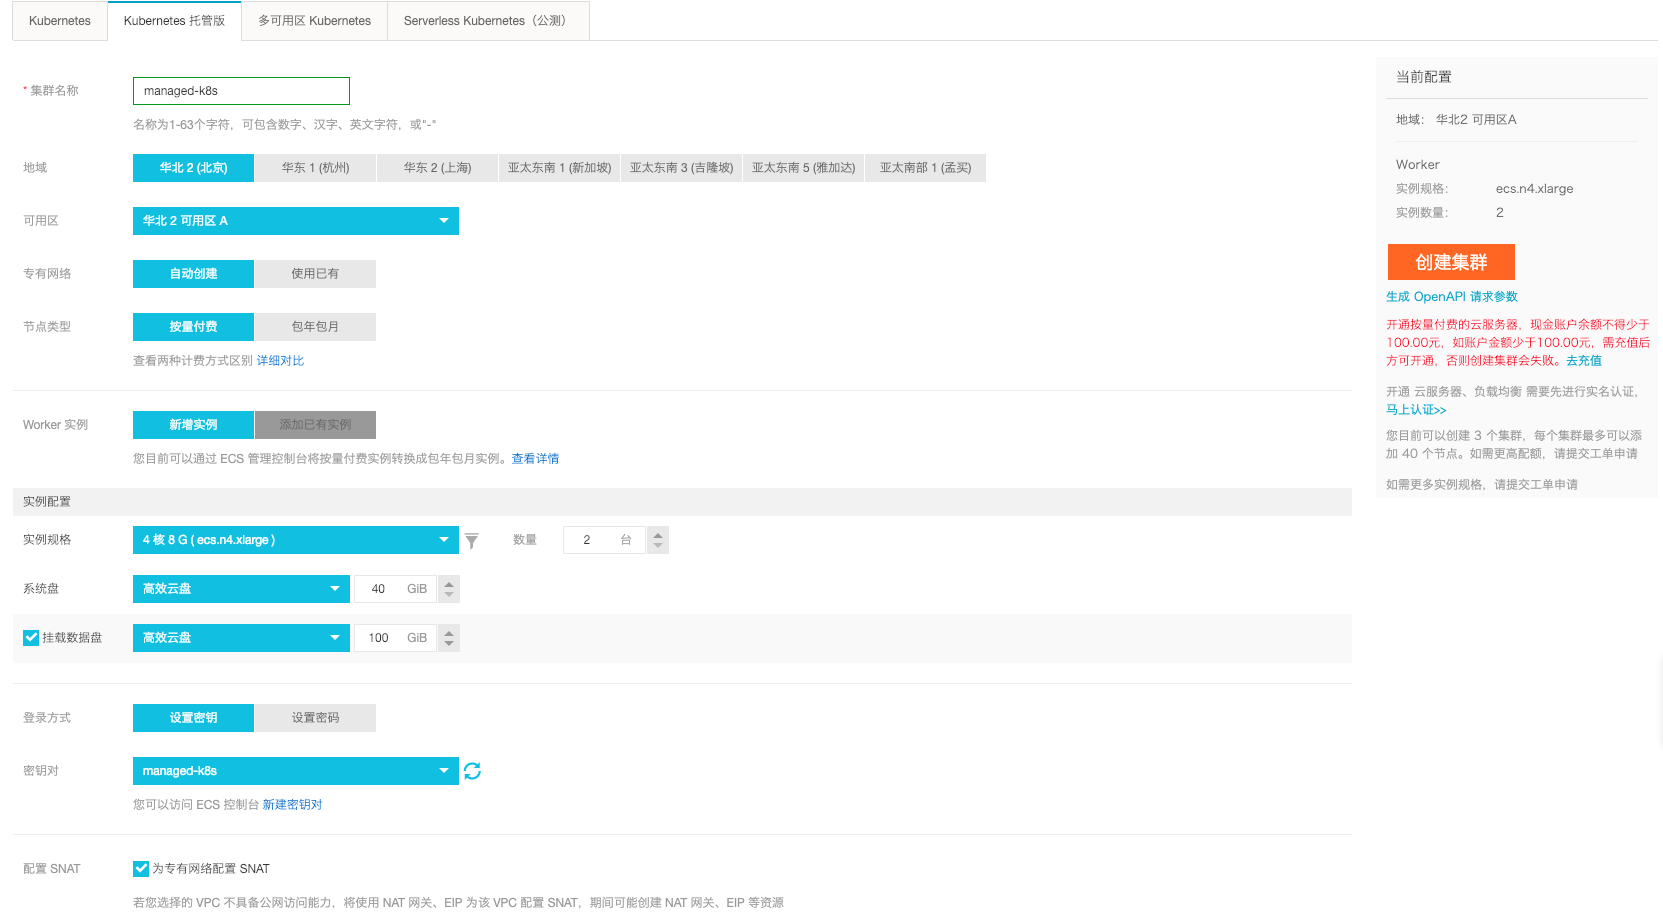
概述 当前阿里云线上如果要创建多可用区k8s集群,界面上只支持专属k8s集群的模式,那么,我们是否可以为托管版k8s集群(managed k8s)实现类似的能力从而达成高可用k8s集群呢?答案是肯定的,本文将以实操的方式进行说明。 具体步骤 新建一个managed k8s集群,此处自动添加的worker节点位于同一个可用区(选择当前可选的最小节点数2,或选择自己规划好的每az需要的ecs节点数量),本例中选择“自动创建“专有网络,以及选择“为专有网络配置SNAT” managed k8s集群创建成功后,查看并记录当前集群所在的vpc,以及当前worker所在的az和vswitch 当前已有worker在az A 在该managed k8s集群所在的同一个vpc下,在另一个az中新建一个vswitch,注意这个vswtich所在网段不和之前的已

优秀的个人博客,低调大师

还能手动改细节(附论文、代码)

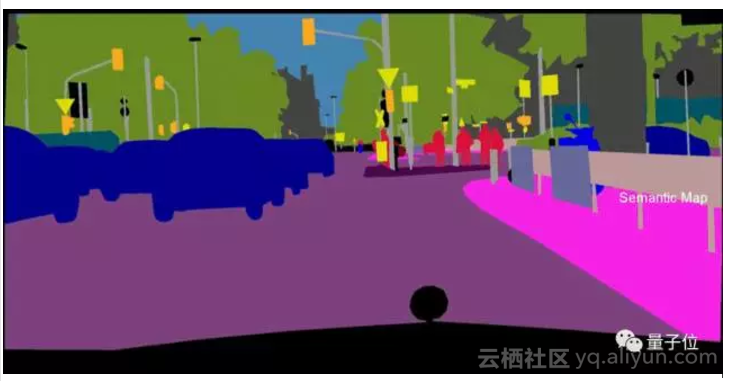
输入一张语义地图—— 就能为你还原整个世界: 输入一张亲妈都认不出来的语义标注图—— 为你合成一张真实的人脸。 聪明的你可能已经发现,这个名为pix2pixHD的神奇算法,可以用条件生成式对抗网络(conditionalGAN),将一张语义标注的图像还原成现实世界的样子。pix2pixHD合成的图像分辨率可高达2048x1024,和CRN、pix2pix等其他图像合成工具相比可以发现,pix2pixHD的效果显然领先了好几条街! △pix2pixHD与pix2pix、CRN对比图 有趣的是,连李飞飞高徒、现特斯拉人工智能与自动驾驶视觉部门主管Andrej Karpathy也在Twitter上大呼“非常鹅妹子嘤!” 到底是怎么一回事?上车,我们前去看看论文。 效果惊人 有一个官方演示视频—— pix2pixHD具有通过语义标注的图像还原到现实世界的

优秀的个人博客,低调大师

Objective-C:MRC手动释放对象内存举例(引用计数器)

手机内存下的类的设计练习: 设计Book类, 1.三个成员变量: title(书名)author(作者)、price(价格) 2.不使用@property,自己完成存取方法(set方法,get方法) 3、加入必要其他的方法 4、并对Book类进行测试 .h声明文件 1 // Book.h 2 // 引用计数器 3 // 4 // Created by ma c on 15/8/13. 5 // Copyright (c) 2015年. All rights reserved. 6 // 7 8 #import <Foundation/Foundation.h> 9 10 @interface Book : NSObject 11 { 12 NSString *_title; 13 NSString *_author; 14 CGFloat _price; 15 } 16 -(id)initWithTitle:(NSString*)title andAuthor:(NSString*)author 17 AndPrice:(CGFloat)price; 18 -(void)setTitle:(NSString*) title; 19 -(void)setAuthor:(NSString*) author; 20 -(void)setPrice:(CGFloat) price; 21 -(NSString*) title; 22 -(NSString*) author; 23 -(CGFloat) price; 24 -(void) show; 25 @end .m声明文件 1 // Book.m 2 // 引用计数器 3 // 4 // Created by ma c on 15/8/13. 5 // Copyright (c) 2015年. All rights reserved. 6 // 7 8 #import "Book.h" 9 10 @implementation Book 11 -(id)initWithTitle:(NSString*)title andAuthor:(NSString*)author 12 AndPrice:(CGFloat)price 13 { 14 self = [super init]; 15 if(self) 16 { 17 _title = [title retain]; 18 _author = [author retain]; 19 _price = price; 20 } 21 return self; 22 } 23 -(void)setTitle:(NSString*) title 24 { 25 if(_title != title) 26 { 27 [_title release];//释放上一次拥有的对象所有权 28 _title = [title retain];//获取这一次的对象所有权 29 } 30 } 31 -(void)setAuthor:(NSString*) author 32 { 33 if(_author != author) 34 { 35 [_author release];//释放上一次拥有的对象所有权 36 _author = [author retain];//获取这一次的对象所有权 37 } 38 } 39 -(void)setPrice:(CGFloat) price 40 { 41 _price = price; 42 } 43 -(NSString*) title 44 { 45 return _title; 46 } 47 -(NSString*) author 48 { 49 return _author; 50 } 51 -(CGFloat) price 52 { 53 return _price; 54 } 55 -(void) show 56 { 57 NSLog(@"title:%@,author:%@,price:%.2f",_title,_author,_price); 58 } 59 -(void)dealloc 60 { 61 [_title release]; 62 [_author release]; 63 NSLog(@"title retainCount:0"); 64 NSLog(@"author retainCount:0"); 65 NSLog(@"book retainCount:0"); 66 NSLog(@"book is dealloc!"); 67 [super dealloc]; 68 } 69 @end 测试Book类 1 // main.m 2 // 引用计数器 3 // 4 // Created by ma c on 15/8/13. 5 // Copyright (c) 2015年. All rights reserved. 6 // 7 8 #import <Foundation/Foundation.h> 9 #import "Book.h" 10 int main(int argc, const char * argv[]) 11 { 12 //@autoreleasepool { 13 14 //创建书对象book并初始化 15 Book *book = [[Book alloc]initWithTitle:@"OC" andAuthor:@"Jobs" AndPrice:35.6];//book count:1 16 NSLog(@"book retainCount:%lu",[book retainCount]); 17 18 //创建书名对象title 19 NSMutableString *title = [NSMutableString stringWithString:@"IOS"];//title count:1 20 NSLog(@"title retainCount:%lu",[title retainCount]); 21 22 //设置书名 23 [book setTitle: title];//title count:2 24 NSLog(@"title retainCount:%lu",[title retainCount]); 25 26 //创建书的作者对象author 27 NSMutableString *author = [NSMutableString stringWithString:@"Bill"];//author count:1 28 NSLog(@"author retainCount:%lu",[author retainCount]); 29 30 //设置书的作者名 31 [book setAuthor:author];//author count:2 32 NSLog(@"author retainCount:%lu",[author retainCount]); 33 34 35 //设置书的价格 36 [book setPrice:58.9]; 37 38 39 //释放title对象所有权----与上面的创建title对象相对应 40 [title release];//title count:1 41 NSLog(@"title retainCount:%lu",[title retainCount]); 42 43 //释放author对象所有权----与上面的创建author对象相对应 44 [author release];//author count:1 45 NSLog(@"author retainCount:%lu",[author retainCount]); 46 47 48 //释放在book类中的成员实例变量title和author对象的所有权,并销毁book对象 49 [book show]; 50 [book release];//title count:0, author count:0 ,book count:0, dealloc book 51 //} 52 return 0; 53 } 运行结果: 2015-08-13 16:56:49.608 引用计数器[1527:94167] book retainCount:1 2015-08-13 16:56:49.609 引用计数器[1527:94167] title retainCount:1 2015-08-13 16:56:49.610 引用计数器[1527:94167] title retainCount:2 2015-08-13 16:56:49.610 引用计数器[1527:94167] author retainCount:1 2015-08-13 16:56:49.610 引用计数器[1527:94167] author retainCount:2 2015-08-13 16:56:49.610 引用计数器[1527:94167] title retainCount:1 2015-08-13 16:56:49.610 引用计数器[1527:94167] author retainCount:1 2015-08-13 16:56:49.610 引用计数器[1527:94167] title:IOS,author:Bill,price:58.90 2015-08-13 16:56:49.611 引用计数器[1527:94167] title retainCount:0 2015-08-13 16:56:49.611 引用计数器[1527:94167] author retainCount:0 2015-08-13 16:56:49.611 引用计数器[1527:94167] book retainCount:0 2015-08-13 16:56:49.611 引用计数器[1527:94167] book is dealloc! Program ended with exit code: 0 可以看出: 计数器:retainCount 对象中存储被引用的次数, 当被引用的时候,计数器加1; 不在引用的时候,计数器减1; 当计数器为0的时候,真正去销毁对象。 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 本文转自当天真遇到现实博客园博客,原文链接:http://www.cnblogs.com/XYQ-208910/p/4727911.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册