2026AI面试题-Prompt 写长了为什么效果反而变差?应该怎样定位和优化?
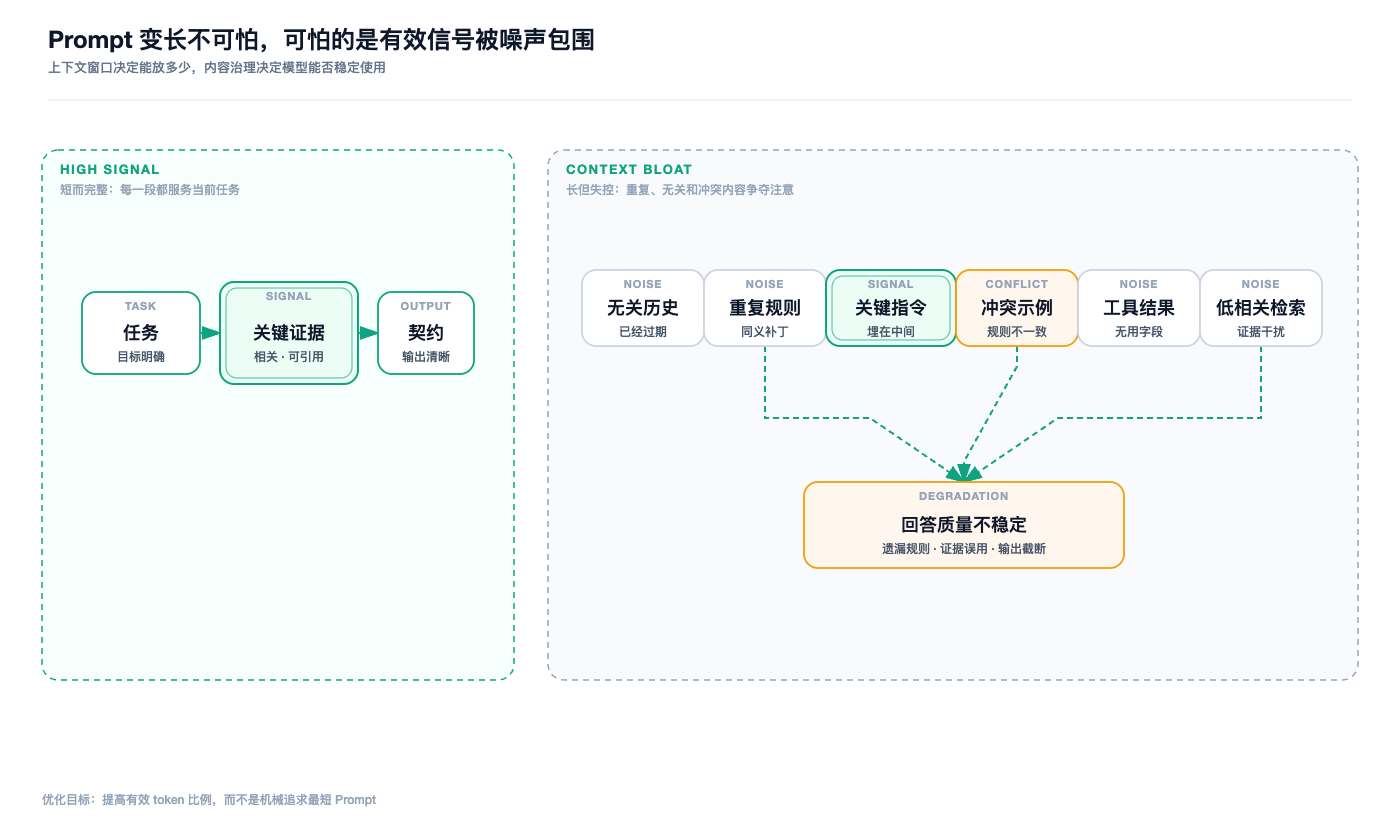
### 题目分类 - 方向:Prompt 工程 ### 考察点 - 能否说明 Prompt 长度不是直接原因,真正影响效果的是相关性、冲突、位置和任务复杂度 - 能否解释长上下文中的信噪比下降、位置效应、截断和输出预算竞争 - 能否区分必要上下文与无效堆料,避免把“缩短 Prompt”当成通用答案 - 能否通过消融、位置交换、固定评测集和失败分桶定位具体问题 - 能否给出检索、去重、分层指令、结构化边界、摘要和上下文治理方案 ### 知识讲解 #### 1. 长度不是根因 Prompt 变长后效果下降,不是因为模型看到的字越多就一定越笨。更准确的说法是:上下文窗口只规定模型最多能接收多少 token,不保证模型能同等稳定地利用其中每一段信息。 有些任务必须使用长 Prompt,例如长文档问答、多轮 Agent、代码仓库分析和复杂规则审核。真正的问题通常是无关信息变多、约束互相冲突、关键证据位置不合理,或者一个请求里塞入了太多不同目标。Prompt 长度只是这些问题的外在表现。 #### 2. 为什么会退化 **指令冲突**是最常见的原因。Prompt 在迭代中不断追加补丁,前面要求“回答简洁”,后面又要求“完整解释所有细节”;一个示例允许缺字段,另一个示例要求字段必填。模型需要在冲突目标之间猜测优先级,输出自然会变得不稳定。 **有效信号被噪声包围**也会影响结果。历史对话、重复规则、低相关检索片段和大段工具返回都会占据上下文。模型虽然能读取这些 token,但更难判断哪一段才是当前决策依据,错误证据还可能把答案带偏。 **位置效应**说明上下文利用并不均匀。`Lost in the Middle` 研究发现,在长上下文问答和检索任务中,关键信息位于开头或结尾时通常更容易被利用,放在中间时性能可能下降。这不是所有模型、所有任务都遵循的固定公式,但足以说明“放得下”不等于“找得到”。 **上下文预算会被共同消耗**。系统提示词、历史消息、RAG 文档、工具定义、工具结果和模型输出都可能共享窗口。输入过长可能直接越界,也可能压缩留给回答或推理的空间;输出达到限制时还会被截断。Prompt caching 可以降低重复前缀的成本和延迟,但缓存后的 token 仍然占用上下文,并不会改善信息质量。 图解:左侧的短 Prompt 让任务、证据和输出契约保持清晰;右侧虽然信息更多,但关键规则被重复指令、无关历史和冲突示例包围。  #### 3. 怎样定位是哪一部分有问题 不要凭感觉直接删 Prompt。先准备一组固定评测样本,记录任务成功率、字段正确率、引用准确率、拒答率、输出长度、延迟和 token 成本,再对 Prompt 做单变量实验。 消融测试可以逐段删除历史、示例、检索结果或补充规则,观察哪部分删除后指标反而上升。位置测试把同一份关键证据放到开头、中间和结尾,判断是否存在位置敏感。冲突测试专门检查系统指令、用户输入、few-shot 示例和工具描述是否表达了不同规则。 还可以按失败类型分桶:没找到证据、找到但没有使用、遵循了错误指令、输出格式错误、回答被截断。不同失败对应不同修复方式;只看“最终答错了”很难判断应该优化检索、Prompt 还是模型。 #### 4. 优化重点是上下文治理 稳定规则放在明确的 system 层,当前任务、参考资料、示例和输出契约使用清晰边界隔开。规则应去重并定义优先级,避免用十条近义句反复强调同一件事。Few-shot 示例宁可少而一致,也不要多而互相矛盾。 动态上下文应按当前任务选择。RAG 结果先做相关性过滤和 rerank;历史对话保留仍影响当前决策的状态,其他内容摘要或移除;大型工具集按需加载工具定义;工具返回只保留模型下一步真正需要的字段。 长文档场景可以把资料与问题分区,并要求模型先定位或引用证据再回答。关键信息放在哪里与模型和任务有关,有些模型对“文档在前、问题在后”的结构表现更好,因此位置调整也应通过评测确定,不能当成跨模型定律。 #### 5. 什么时候不该继续缩短 Prompt 优化的目标不是 token 越少越好,而是每个进入上下文的 token 都有明确作用。删除必要背景会让模型只能猜,过度摘要会丢失限定条件,删掉边界案例又可能让分类标准变模糊。 判断是否应该保留一段内容,可以问三个问题:它是否改变模型的决策;它能否由检索或工具按需提供;删除后固定评测集是否退化。只有基于评测的压缩,才不是把偶然变短误认为效果变好。 ### 代码示例 下面的 TypeScript 示例把 Prompt 组装和上下文选择分开。重点不是字符串模板本身,而是让每一类信息都有来源、预算和可测试边界。 ```ts type Evidence = { id: string; text: string; score: number; }; type PromptInput = { task: string; evidence: Evidence[]; maxEvidenceChars?: number; }; export function buildPrompt({ task, evidence, maxEvidenceChars = 6_000, }: PromptInput): string { const selected: Evidence[] = []; let used = 0; for (const item of [...evidence].sort((a, b) => b.score - a.score)) { if (item.score maxEvidenceChars) continue; selected.push(item); used += item.text.length; } return [ `${task}`, ` 1. 只依据 evidence 回答。 2. 证据不足时返回 insufficient_evidence。 3. 每个结论必须附 evidence_id。 `, `${JSON.stringify(selected)}`, `{"status":"ok | insufficient_evidence","claims":[]}`, ].join("\n\n"); } ``` ### 代码讲解 `buildPrompt` 没有把所有召回内容直接拼进去,而是先按相关性排序、过滤低分证据,并设置上下文预算。这只是简化示例;生产环境通常使用 token 数而不是字符数,并在截断前保证一个证据块完整。 任务、规则、证据和输出契约被明确分区,可以降低变量内容与固定指令混在一起的风险。证据带有稳定 ID,模型输出可以被应用程序校验和追踪。真正上线时还需要对不同阈值、Top-K 和 Prompt 版本运行固定评测集,而不是因为模板看起来更整齐就认为效果更好。 ### 面试回答 Prompt 写长后效果下降,通常不是长度本身造成的,而是有效上下文质量下降了。上下文窗口代表模型能接收多少 token,不代表它能稳定、均匀地利用所有内容。长 Prompt 只要信息相关、结构清楚、约束一致,完全可能比短 Prompt 更好。 最常见的问题是持续追加规则后产生冲突,历史和检索内容引入噪声,或者关键证据埋在长上下文中没有被正确使用。长上下文还会增加输入成本和延迟,占用输出预算,并带来截断风险。Prompt caching 只能降低重复计算成本,不能解决噪声和位置问题。 定位时不会直接凭经验删字,而是先固定评测集,再做消融实验。分别删除 few-shot、历史消息、检索片段和补充规则,观察任务成功率、事实准确率、格式通过率和成本变化;同时交换关键证据的位置,检查是否存在位置敏感或指令优先级问题。 优化重点是上下文治理:稳定规则集中管理,任务、资料、示例和输出契约明确分区;RAG 结果先过滤和重排,历史对话做摘要或状态提取,工具定义和结果按需注入。每增加一段上下文,都要能说明它解决什么失败样本。 因此目标不是把 Prompt 压到最短,而是提高有效 token 比例。删掉一段内容后,如果固定评测集没有退化,成本和延迟又下降,这次压缩才有价值。 ### 面试官追问 1. 什么是 `Lost in the Middle`,它是否适用于所有模型? 2. Prompt caching 能不能解决长上下文效果下降? 3. 如何发现 system prompt 和 few-shot 示例存在冲突? 4. RAG 的 Top-K 越大为什么可能让答案更差? 5. 多轮对话中的历史消息应该怎样压缩? 6. 长文档应该放在问题前还是问题后? 7. 如何设计 Prompt 的离线评测集和线上指标? 8. 什么情况下应该拆成多阶段调用,而不是继续扩充一个 Prompt? ### 高分回答要点 - 不把长度当作唯一根因,能说明相关性、冲突、位置和预算的共同影响 - 理解长上下文容量与长上下文利用能力之间的区别 - 能通过消融、位置交换和失败分桶定位问题 - 给出检索过滤、去重、摘要、分层指令和按需注入等具体策略 - 用效果、成本和延迟共同评价 Prompt 版本,而不是只追求更短 ### 常见扣分回答 - 简单归因于“模型记忆力不够”,没有解释具体机制 - 认为上下文窗口足够大就不会退化 - 把所有历史、文档和工具结果完整塞入 Prompt,认为信息越多越保险 - 直接删除内容,没有固定样本和消融实验验证 - 认为 Prompt caching 能减少上下文占用或提升答案准确率 - 只关注 token 成本,不检查必要信息是否被过度压缩 ### 项目结合话术 Prompt 会作为版本化的数据管道管理,而不是不断追加补丁的长字符串。固定规则、动态证据、历史状态和输出契约分别组装;每次改动都在同一组样本上做消融和回归,并同时记录任务成功率、格式通过率、输入 token、延迟和降级率。 ### 参考来源 - [Lost in the Middle: How Language Models Use Long Contexts](https://arxiv.org/abs/2307.03172) - [Claude Context Windows 官方文档](https://platform.claude.com/docs/en/build-with-claude/context-windows) - [Claude Prompting Best Practices](https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices)