首页 文章 精选 留言 我的

精选列表

搜索[事件发布],共10000篇文章
优秀的个人博客,低调大师

DeepSeek-V4 预览版开源发布

DeepSeek-V4 的预览版本现已正式上线并同步开源。DeepSeek-V4 拥有百万字超长上下文,模型按大小分为两个版本: 即日起登录官网chat.deepseek.com或官方App,即可与最新的 DeepSeek-V4 对话,探索 1M 超长上下文记忆的全新体验。API 服务已同步更新,通过修改 model_name 为 deepseek-v4-pro 或 deepseek-v4-flash 即可调用。 Agent 能力大幅提高:相比前代模型,DeepSeek-V4-Pro 的 Agent 能力显著增强。在 Agentic Coding 评测中,V4-Pro 已达到当前开源模型最佳水平,并在其他 Agent 相关评测中同样表现优异。目前 DeepSeek-V4 已成为该公司内部员工使用的 Agentic Coding 模型,评测反馈使称用体验优于 Sonnet 4.5,交付质量接近 Opus 4.6 非思考模式,但仍与 Opus 4.6 思考模式存在一定差距。 丰富的世界知识:DeepSeek-V4-Pro 在世界知识测评中,大幅领先其他开源模型,仅稍逊于顶尖闭源模型 Gemini-Pro-3.1。 世界顶级推理性能:在数学、STEM、竞赛型代码的测评中,DeepSeek-V4-Pro 超越当前所有已公开评测的开源模型,取得了比肩世界顶级闭源模型的优异成绩。 相比 DeepSeek-V4-Pro,DeepSeek-V4-Flash 在世界知识储备方面稍逊一筹,但展现出了接近的推理能力。而由于模型参数和激活更小,相较之下 V4-Flash 能够提供更加快捷、经济的 API 服务。 在 Agent 测评中,DeepSeek-V4-Flash 在简单任务上与 DeepSeek-V4-Pro 旗鼓相当,但在高难度任务上仍有差距。 根据介绍,DeepSeek-V4 开创了一种全新的注意力机制,在 token 维度进行压缩,结合 DSA 稀疏注意力(DeepSeek Sparse Attention),实现了全球领先的长上下文能力,并且相比于传统方法大幅降低了对计算和显存的需求。从现在开始,1M(一百万)上下文将是 DeepSeek 所有官方服务的标配。 DeepSeek-V4 针对 Claude Code 、OpenClaw、OpenCode、CodeBuddy 等主流的 Agent 产品进行了适配和优化,在代码任务、文档生成任务等方面表现均有提升。 目前,DeepSeek API已同步上线V4-Pro与V4-Flash,支持OpenAI ChatCompletions接口与Anthropic接口。访问新模型时,base_url不变, model参数需要改为 deepseek-v4-pro或 deepseek-v4-flash。 V4-Pro 与 V4-Flash 最大上下文长度为 1M,均同时支持非思考模式与思考模式,其中思考模式支持 reasoning_effort 参数设置思考强度(high/max)。对于复杂的 Agent 场景建议使用思考模式,并设置强度为 max。模型调用与参数调整方法ke 参考 API 文档。 注意:旧有的 API 接口的两个模型名 deepseek-chat 与deepseek-reasoner 将于三个月后(2026-07-24)停止使用。当前阶段内,这两个模型名分别指向deepseek-v4-flash 的非思考模式与思考模式。

优秀的个人博客,低调大师

蚂蚁百灵 Ling-2.6-flash 发布

蚂蚁百灵宣布正式推出Ling-2.6-flash—— 一款总参数量 104B、激活参数 7.4B的 Instruct 模型。 API 定价方面,Ling-2.6-flash 输入每百万tokens定价0.1美元,输出0.3美元。目前,Ling-2.6-flash的API已正式向用户开放,并提供为期一周的限时免费试用。 根据介绍,面对持续攀升的 Token 压力,Ling-2.6-flash 选择了一条不同的技术路径:不是单纯依赖更长输出换取更高分数,而是围绕推理效率、Token 效率与 Agent 场景表现进行系统性优化,在保持竞争力智能水平的同时,尽可能做到更快、更省、更适合真实业务场景。 具体来看,Ling-2.6-flash 的核心能力体现在三个方面: 混合线性架构,释放推理效率:通过引入混合线性架构,模型从底层优化计算效率,在 4 卡 H20 条件下推理速度最快可达到340 tokens/s,Prefill 吞吐达到Nemotron-3-Super的 2.2 倍,以更高的“费效比”完成任务。 Token 效率优化,提升智效比:在训练过程中对 Token 效率进行了针对性校准,力求以更精简的输出完成既定目标。在 Artificial Analysis 的完整评测中,Ling-2.6-flash 仅消耗15M tokens,约为 Nemotron-3-Super 等模型的1/10, 以更高的“智效比”完成任务。 面向 Agent 场景进行定向增强:针对当前需求最旺盛的 Agent 应用,在工具调用、多步规划与任务执行能力上持续打磨,使模型在BFCL-V4、TAU2-bench、SWE-bench Verified、Claw-Eval、PinchBench等评测中,即使面对激活参数更大的模型,依然能够取得相近甚至 SOTA 级别的表现。 Ling-2.6-flash 延用了 Ling 2.5 的模型架构设计:在 Ling 2.0 架构基础上引入了混合线性注意力机制。通过增量训练方式,将 Ling 2.0 架构的 GQA 注意力机制升级为 1:7 的 MLA + Lightning Linear 高效混合架构。 得益于混合注意力机制与高度稀疏化的 MoE 架构,Ling-2.6-flash 在推理效率上展现出显著优势。与同尺寸级别的主流 SOTA 模型相比,Ling-2.6-flash 不仅首字响应更快,长输出场景下的生成效率也更高,Prefill 吞吐与 Decode 吞吐最高均可达到约 4 倍提升。 从下图中可以看到,随着上下文长度和生成长度持续增加,Ling-2.6-flash 的吞吐优势进一步放大。同时,Ling-2.6-flash 的优势并不只体现在静态指标上,而是在真实部署环境中,能够随着任务复杂度提升持续释放更强的速度收益。无论是长上下文理解,还是长文本连续生成,Ling-2.6-flash 都能在保持模型能力的同时,带来更快的响应、更高的吞吐,以及更具优势的实际部署效率。 在Ling-2.6-flash的预训练阶段,项目团队通过大规模算子融合显著提升了训练效率;在推理侧,则进一步围绕真实部署场景进行了深度适配,使融合算子在融合粒度、实现路径与数值行为上尽可能与训练侧保持一致。这样的设计不仅带来了更高的推理效率,也在RL Rollout阶段进一步增强了训推一致性。相关推理算子将随linghe陆续开源。 针对不同精度场景,对推理链路进行了系统性优化。 针对BF16推理,实现了QK Norm + RoPE、Group RMSNorm + Sigmoid Gate等关键算子的深度融合,并在MoE Router GEMM与LM Head GEMM中采用BF16 Input + FP32 Output的计算方式,同时优化了MLA RoPE与Top-K的实现。 针对FP8推理,进一步将RMSNorm、SwiGLU与量化算子进行融合,并针对小 Batch Size 场景引入Split-K 的 Blockwise FP8 GEMM,进一步释放吞吐潜力。从算子融合、缓存机制到多 token生成的一整套系统级协同优化。最终带来的,不只是更高的系统吞吐,也包括更高的单用户 TPS、更短的等待时间,以及在真实交互场景下更稳定、更流畅的使用体验。 在Artificial Analysis 榜单的 Output Speed 维度的官方测评中,对比同参数量级别的主流模型,Ling-2.6-flash 以 215 tokens/s 的输出速度处于第一梯队,展现出领先的生成效率。 在 Artificial Analysis(AA)的Intelligence vs. Output Tokens对比中,Ling-2.6-flash展现了突出的token efficiency优势。 从下图中可以看到,Ling-2.6-flash 以15M output tokens实现了26 分的 Intelligence Index,在保持较强智能水平的同时,将输出消耗控制在相对更低的位置。相比部分依赖更长输出换取更高分数的模型,Ling-2.6-flash 在“智能表现”与“输出成本”之间取得了更优平衡。这意味着,Ling-2.6-flash 的竞争力并不只体现在单点能力上,更体现在面向真实应用的整体效率优化上。它并非通过更冗长的输出堆叠分数,而是以更精炼的生成完成任务,在保证竞争力智能表现的同时,显著降低 token 消耗。 对于开发者和企业场景而言,这种能力带来的价值是直接且明确的:更低的推理开销、更快的首字响应、更短的整体生成时延,以及更流畅的交互体验。无论是 Agent 调用、复杂任务执行,还是高频线上服务,Ling-2.6-flash 都更适合真实部署环境下对速度、成本与体验的综合要求。 从 Token 消耗看,Ling-2.6-flash 的智效比显著提升。 在 Artificial Analysis Intelligence Index 的完整评测中,Ling-2.6-flash 展现出显著更优的 Token 效率:其总消耗仅为 15M tokens,而 Nemotron-3-Super 等模型达到或超过 110M tokens。换言之,Ling-2.6-flash 仅用约 1/10 的 token 消耗完成同类评测任务,体现出更精简的输出方式与更高的智效比。 为增强模型 Agent 能力,团队显著扩展了 Ling-2.6-flash 训练数据的难度与广度,以优化其在复杂长程任务中的表现。依托自研的大规模高保真交互环境,团队对 Ling-2.6-flash 进行了针对性的 General Agent 与 Coding Agent 的强化学习(RL)训练。 显著提升了模型在指令遵循、工具调用、多步规划及长程执行方面的表现,保障模型听懂指令、准确执行,Ling-2.6-flash 在 BFCL-V4、TAU2-bench、SWE-bench Verified、PinchBench 等代表性榜单上表现优异; 通过 RL 优化模型在不同 Agent 场景下的泛化性与稳定性,大幅改进其在实际场景的应用体验,Ling-2.6-flash 在 Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClaw 等框架中均展现了良好的使用体验。 Ling-2.6-flash 模型在通用知识、数学推理、指令遵循及长文本解析等维度保持优秀水准,各项指标均对齐同尺寸 SOTA 模型,保障全场景下稳健、优质的性能产出。 不过,在部分高复杂度场景中,受限于推理深度,模型仍可能出现一定的工具幻觉;此外,在中英双语自然切换、复杂指令遵循等方面,Ling-2.6-flash 仍有进一步优化空间。 面向后续迭代,项目团队计划将继续探索智效比的更优边界,在保持高效推理特性的同时,进一步推动智能产出质量与 Token 效率之间的深度平衡,持续提升模型在全场景下的稳定性、可用性与交互体验。

优秀的个人博客,低调大师

优化兼容性 | gpress v1.2.4 发布

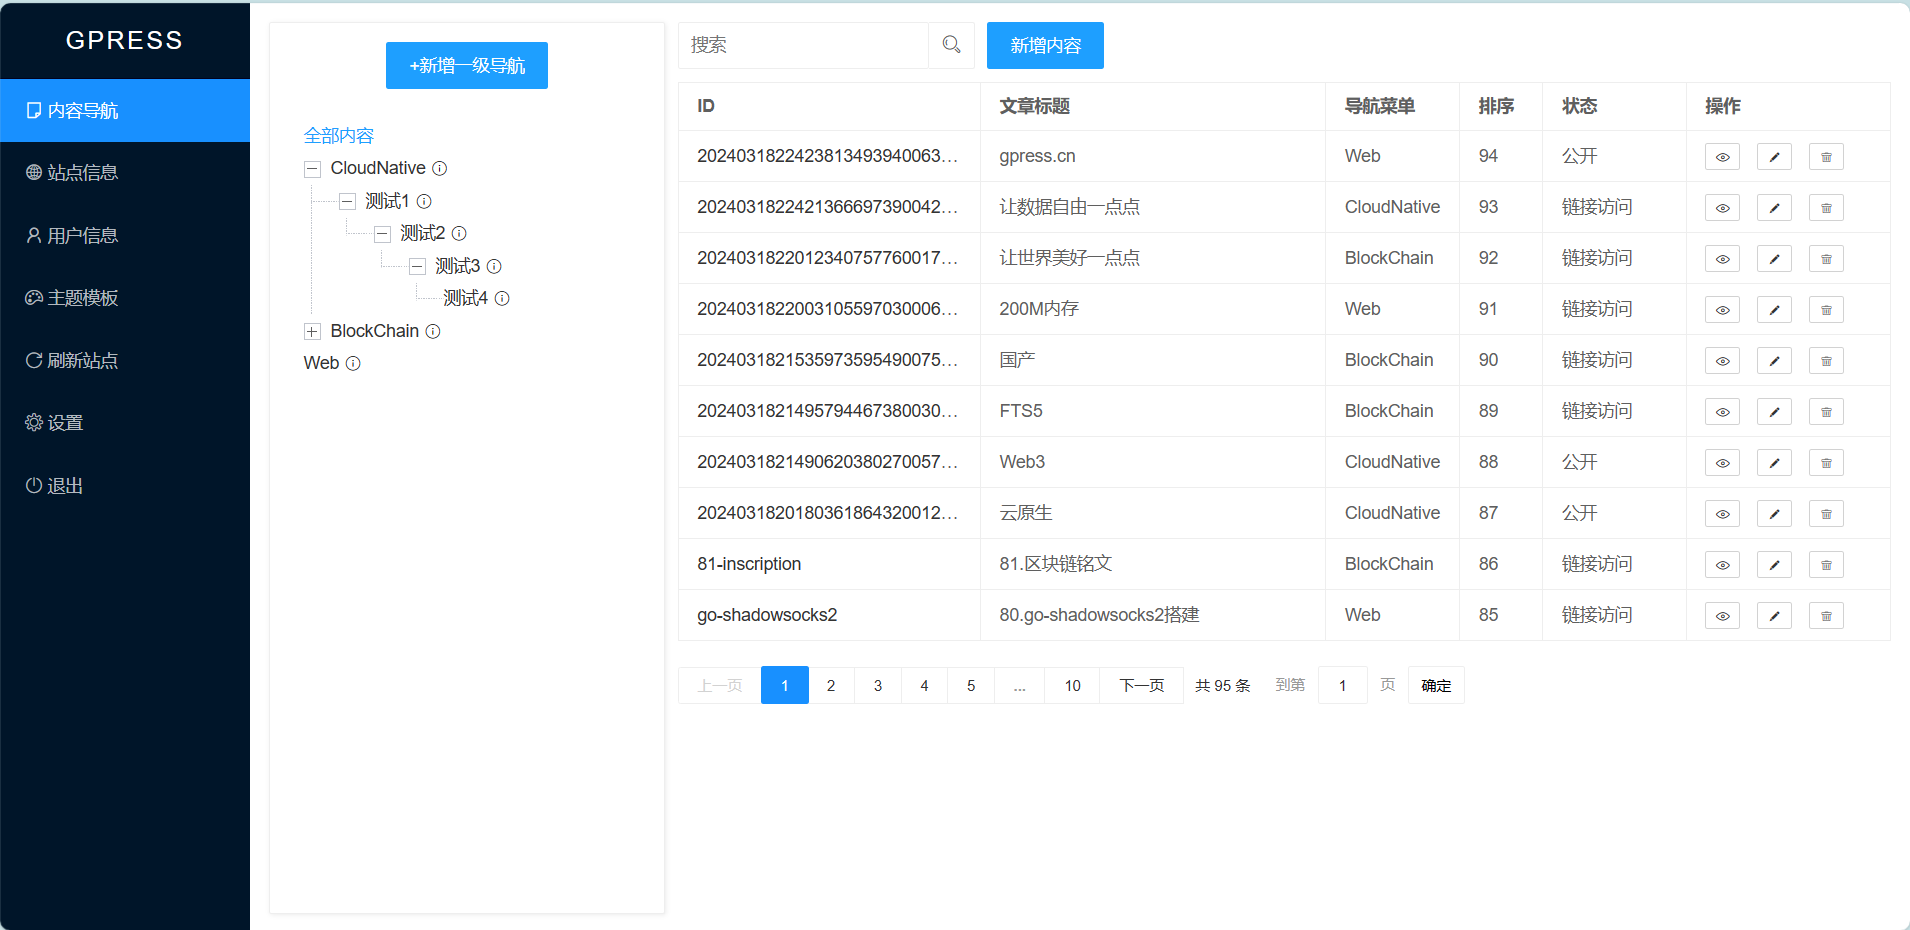
gpress 是 Web3 内容平台,Hertz + Go template + FTS5 全文检索,支持以太坊和百度超级链,兼容 Hugo、WordPress 生态,使用 Wasm 扩展插件,只需 200M 内存. 作为静态站点:gpress 生成的静态文件和 Hugo 一致,也可以简单认为 gpress 是 Hugo 的后台管理,兼容 Hugo 主题生态,已迁移多款 Hugo 主题:even、doks、book、geekdoc...... 作为动态站点:gpress 功能简单,只有 7 个菜单,5 张表,5000 行代码,使用 SQLite, 一键启动,只需 200M 内存,支持全文检索。兼容 WordPress 主题生态,已迁移多款 WordPress 主题:generatepress、astra...... 作为 Web3:gpress 已支持以太坊和百度超级链账户体系,会基于 Wasm 持续迭代去中心功能,让数据自由一点点...... 作为后浪:相对于 Hugo、WordPress 等优秀的内容平台,gpress 还有很多不足,功能简单而又稚嫩...... 帮助文档:点击查看帮助文档 个人博客jiagou.com使用 gpress 搭建,搜索和后台管理是动态,其他是静态页面。 更新: 修复postgresql兼容性问题 优化内部markdown文件链接 完善文档,注释

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册