给 Antd Table 组件编写缩进指引线、子节点懒加载等功能,如何二次封装开源组件?
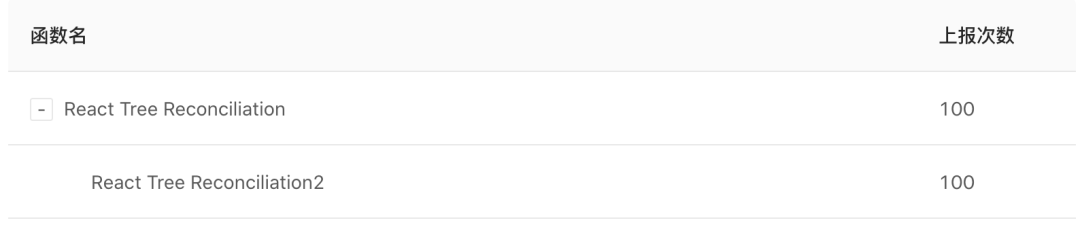
在业务需求中,有时候我们需要基于 antd 之类的组件库定制很多功能,本文就以我自己遇到的业务需求为例,一步步实现和优化一个树状表格组件,这个组件会支持: ✨ 每个层级 缩进指示线 ✨ 远程 懒加载子节点 ✨ 每个层级支持 分页 本系列分为两篇文章,这篇只是讲这些业务需求如何实现。 而下一篇,我会讲解怎么给组件也设计一套简单的插件机制,来解决代码耦合,难以维护的问题。 功能实现 层级缩进线 antd 的 Table 组件默认是没有提供这个功能的,它只是支持了树状结构: consttreeData=[ { function_name:`ReactTreeReconciliation`, count:100, children:[ { function_name:`ReactTreeReconciliation2`, count:100 } ] } ] 展示效果如下: antd-table 可以看出,在展示大量的函数堆栈的时候,没有缩进线就会很难受了,业务方也确实和我提过这个需求,可惜之前太忙了,就暂时放一边了。😁 参考 VSCode 中的缩进线效果,可以发现,缩进线是和节点的层级紧密相关的。 vscode 比如 src 目录对应的是第一级,那么它的子级 client 和 node 就只需要在 td 前面绘制一条垂直线,而 node 下的三个目录则绘制两条垂直线。 第 1 层:| text 第 2 层:|| text 第 3 层:||| text 只需要在自定义渲染单元格元素的时候,得到以下两个信息。 当前节点的层级信息。 当前节点的父节点是否是展开状态。 所以思路就是对数据进行一次递归处理,把层级写在节点上,并且要把父节点的引用也写上,之后再通过传给 Table 的 expandedRowKeys 属性来维护表格的展开行数据。 这里我是直接改写了原始数据,如果需要保证原始数据干净的话,也可以参考 React Fiber 的思路,构建一颗替身树进行数据写入,只要保留原始树节点的引用即可。 /** *递归树的通用函数 */ consttraverseTree=( treeList, childrenColumnName, callback )=>{ consttraverse=(list,parent=null,level=1)=>{ list.forEach(treeNode=>{ callback(treeNode,parent,level); const{[childrenColumnName]:next}=treeNode; if(Array.isArray(next)){ traverse(next,treeNode,level+1); } }); }; traverse(treeList); }; functionrewriteTree({dataSource}){ traverseTree(dataSource,childrenColumnName,(node,parent,level)=>{ //记录节点的层级 node[INTERNAL_LEVEL]=level //记录节点的父节点 node[INTERNAL_PARENT]=parent }) } 之后利用 Table 组件提供的 components 属性,自定义渲染 Cell 组件,也就是 td 元素。 constcomponents={ body:{ cell:(cellProps)=>( <TreeTableCell {...props} {...cellProps} expandedRowKeys={expandedRowKeys} /> ) } } 之后,在自定义渲染的 Cell 中,只需要获取两个信息,只需要根据层级和父节点的展开状态,来决定绘制几条垂直线即可。 constisParentExpanded=expandedRowKeys.includes( record?.[INTERNAL_PARENT]?.[rowKey] ) //只有当前是展示指引线的列且父节点是展开节点才会展示缩进指引线 if(dataIndex!==indentLineDataIndex||!isParentExpanded){ return<tdclassName={className}>{children}</td> } //只要知道层级就知道要在 td 中绘制几条垂直指引线举例来说: //第 2 层:|| text //第 3 层:||| text constlevel=record[INTERNAL_LEVEL] constindentLines=renderIndentLines(level) 这里的实现就不再赘述,直接通过绝对定位画几条垂直线,再通过对 level 进行循环时的下标 index 决定 left 的偏移值即可。 效果如图所示: 缩进线 远程懒加载子节点 这个需求就需要用比较 hack 的手段实现了,首先观察了一下 Table 组件的逻辑,只有在有 children 的子节点上才会展示「展开更多」的图标。 所以思路就是,和后端约定一个字段比如 has_next,之后预处理数据的时候先遍历这些节点,加上一个假的占位 children。 之后在点击展开的时候,把节点上的这个假 children 删除掉,并且把通过改写节点上一个特殊的 is_loading 字段,在自定义渲染 Icon 的代码中判断,并且展示 Loading Icon。 又来到递归树的逻辑中,我们加入这样的一段代码: functionrewriteTree({dataSource}){ traverseTree(dataSource,childrenColumnName,(node,parent,level)=>{ if(node[hasNextKey]){ //树表格组件要求next必须是非空数组才会渲染「展开按钮」 //所以这里手动添加一个占位节点数组 //后续在onExpand的时候再加载更多节点并且替换这个数组 node[childrenColumnName]=[generateInternalLoadingNode(rowKey)] } }) } 之后我们要实现一个 forceUpdate 函数,驱动组件强制渲染: const[_,forceUpdate]=useReducer((x)=>x+1,0) 再来到 onExpand 的逻辑中: constonExpand=async(expanded,record)=>{ if(expanded&&record[hasNextKey]&&onLoadMore){ //标识节点的loading record[INTERNAL_IS_LOADING]=true //移除用来展示展开箭头的假children record[childrenColumnName]=null forceUpdate() constchildList=awaitonLoadMore(record) record[hasNextKey]=false addChildList(record,childList) } onExpandProp?.(expanded,record) } functionaddChildList(record,childList){ record[childrenColumnName]=childList record[INTERNAL_IS_LOADING]=false rewriteTree({ dataSource:childList, parentNode:record }) forceUpdate() } 这里 onLoadMore 是用户传入的获取更多子节点的方法, 流程是这样的: 节点展开时,先给节点写入一个正在加载的标志,然后把子数据重置为空。这样虽然节点会变成展开状态,但是不会渲染子节点,然后强制渲染。 在加载完成后赋值了新的子节点 record[childrenColumnName] = childList 后,我们又通过 forceUpdate 去强制组件重渲染,展示出新的子节点。 需要注意,我们递归树加入逻辑的所有逻辑都在 rewriteTree 中,所以对于加入的新的子节点,也需要通过这个函数递归一遍,加入 level, parent 等信息。 新加入的节点的 level 需要根据父节点的 level 相加得出,不能从 1 开始,否则渲染的缩进线就乱掉了,所以这个函数需要改写,加入 parentNode 父节点参数,遍历时写入的 level 都要加上父节点已有的 level。 functionrewriteTree({ dataSource, //在动态追加子树节点的时候需要手动传入parent引用 parentNode=null }){ //在动态追加子树节点的时候需要手动传入父节点的level否则level会从1开始计算 conststartLevel=parentNode?.[INTERNAL_LEVEL]||0 traverseTree(dataSource,childrenColumnName,(node,parent,level)=>{ parent=parent||parentNode; //记录节点的层级 node[INTERNAL_LEVEL]=level+startLevel; //记录节点的父节点 node[INTERNAL_PARENT]=parent; if(node[hasNextKey]){ //树表格组件要求next必须是非空数组才会渲染「展开按钮」 //所以这里手动添加一个占位节点数组 //后续在onExpand的时候再加载更多节点并且替换这个数组 node[childrenColumnName]=[generateInternalLoadingNode(rowKey)] } }) } 自定义渲染 Loading Icon 就很简单了: //传入给Table组件的expandIcon属性即可 exportconstTreeTableExpandIcon=({ expanded, expandable, onExpand, record })=>{ if(record[INTERNAL_IS_LOADING]){ return<IconLoadingstyle={iconStyle}/> } } 功能完成,看一下效果: 远程懒加载 每个层级支持分页 这个功能和上一个功能也有点类似,需要在 rewriteTree 的时候根据外部传入的是否开启分页的字段,在符合条件的时候往子节点数组的末尾加入一个占位 Pagination 节点。 之后在 column 的 render 中改写这个节点的渲染逻辑。 改写 record: functionrewriteTree({ dataSource, //在动态追加子树节点的时候需要手动传入parent引用 parentNode=null }){ //在动态追加子树节点的时候需要手动传入父节点的level否则level会从1开始计算 conststartLevel=parentNode?.[INTERNAL_LEVEL]||0 traverseTree(dataSource,childrenColumnName,(node,parent,level)=>{ //加载更多逻辑 if(node[hasNextKey]){ //树表格组件要求next必须是非空数组才会渲染「展开按钮」 //所以这里手动添加一个占位节点数组 //后续在onExpand的时候再加载更多节点并且替换这个数组 node[childrenColumnName]=[generateInternalLoadingNode(rowKey)] } //分页逻辑 if(childrenPagination){ const{totalKey}=childrenPagination; constnodeChildren=node[childrenColumnName]||[]; const[lastChildNode]=nodeChildren.slice?.(-1); //渲染分页器,先加入占位节点 if( node[totalKey]>nodeChildren?.length&& //防止重复添加分页器占位符 !isInternalPaginationNode(lastChildNode,rowKey) ){ nodeChildren?.push?.(generateInternalPaginationNode(rowKey)); } } }) } 改写 columns: functionrewriteColumns(){ /** *根据占位符渲染分页组件 */ constrewritePaginationRender=(column)=>{ column.render=functionColumnRender(text,record){ if( isInternalPaginationNode(record,rowKey)&& dataIndex===indentLineDataIndex ){ return<Pagination/> } returnrender?.(text,record)??text } } columns.forEach((column)=>{ rewritePaginationRender(column) }) } 来看一下实现的分页效果: 重构和优化 随着编写功能的增多,逻辑被耦合在 Antd Table 的各个回调函数之中, 指引线的逻辑分散在 rewriteColumns, components中。 分页的逻辑被分散在 rewriteColumns 和 rewriteTree 中。 加载更多的逻辑被分散在 rewriteTree 和 onExpand 中 至此,组件的代码行数也已经来到了 300 行,大概看一下代码的结构,已经是比较混乱了: exportconstTreeTable=(rawProps)=>{ functionrewriteTree(){ //🎈加载更多逻辑 //🔖分页逻辑 } functionrewriteColumns(){ //🔖分页逻辑 //🏁缩进线逻辑 } constcomponents={ //🏁缩进线逻辑 } constonExpand=async(expanded,record)=>{ //🎈加载更多逻辑 } return<Table/> } 有没有一种机制,可以让代码按照功能点聚合,而不是散落在各个函数中? //🔖分页逻辑 constusePaginationPlugin=()=>{} //🎈加载更多逻辑 constuseLazyloadPlugin=()=>{} //🏁缩进线逻辑 constuseIndentLinePlugin=()=>{} exportconstTreeTable=(rawProps)=>{ usePaginationPlugin() useLazyloadPlugin() useIndentLinePlugin() return<Table/> } 没错,就是很像 VueCompositionAPI 和 React Hook 在逻辑解耦方面所做的改进,但是在这个回调函数的写法形态下,好像不太容易做到? 下一篇文章,我会聊聊如何利用自己设计的插件机制来优化这个组件的耦合代码。 记得关注后加我好友,我会不定期分享前端知识,行业信息。2021 陪你一起度过。 感谢大家 欢迎关注 ssh,前端潮流趋势、原创面试热点文章应有尽有。 记得关注后加我好友,我会不定期分享前端知识,行业信息。2021 陪你一起度过。 点赞并分享给你的朋友是最好的支持~ 本文分享自微信公众号 - 前端从进阶到入院(code_with_love)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。