首页 文章 精选 留言 我的

精选列表

搜索[内核发布],共10000篇文章
优秀的个人博客,低调大师

“豆包手机助手”消费者版本正式发布

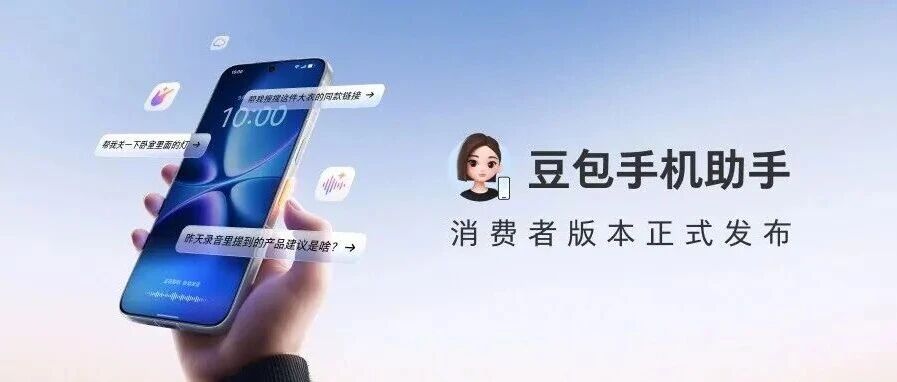
打开一个装修设计图,不用截图、不用切换应用,直接对着手机问"根据这个装修风格,帮我选一个一米二以内、价格不超过一千元的柜子"——这是豆包手机助手消费者版正式版演示的示例场景之一。 相比5月上线的预览版,这次消费者版拉上了努比亚NaviX Ultra作为首个量产载体,9月16日开售。字节跳动的思路很清楚:预览版验证能力边界,消费者版把体验磨到可日常使用。 语音唤醒和专属AI键是两种交互入口。AI键做了指纹鉴权——按下去、验证指纹、唤起助手,三步合一。这解决了手机助手的第一个物理问题:怎么让用户快速触达,同时不误触。 屏幕问答是这次最直观的升级。不需要截屏,不需要跳转应用,模型直接理解当前屏幕内容并回答相关问题。技术上看是上下文感知能力的工程化落地,体验上看则是"助手从语音工具变成了真正能看屏幕的协作者"。 本地数据搜索更实用一些。相册、短信、便签——这些隐私数据不出本地,但模型能理解和检索。一个具体例子是问"我的港澳通行证什么时候到期",助手在本地数据里找到答案,不需要用户翻相册或搜聊天记录。 录音能力接入了飞书妙记,语音输入、三指上滑、AI键加音量键都能保存屏幕内容。这些是功能补全,不是核心差异点。 真正有信号意义的是两件事。 第一件是"操作手机"功能以Beta形式开放。模型不再只是回答问题,而是帮你执行操作。这在行业里不是新概念,但字节做了一件事别的厂商没做——同时推出了SAEP协议(屏幕自动化操作声明协议)。 SAEP本质上是一套应用层的声明机制:第三方应用可以声明自己允许哪些AI自动化操作、拒绝哪些操作。协议给了30天规则公示期,让开发者和公众有时间审阅和反馈。这意味着字节绕开了"AI能不能操作我的银行App"这种无解的全民辩论,直接把它变成了应用开发者自己说了算的工程问题。 你可以允许AI帮你发微信,但银行App可以声明"不允许AI操作转账"。这个边界不再由大模型厂商划,而是由被操作的应用自己划。 配合SAEP的是一套Agent防护体系,分层分级管理。具体细节没公布,但和SAEP放在一起看,这是一个"先立规则、再放能力"的策略——比先上线后补安全方案要务实得多。 豆包手机助手的叙事一直在变。预览版强调的是"能做什么",消费者版开始讲"怎么做得稳"。SAEP的推出说明字节想把这个赛道做成一个平台级的东西——不只做一个助手,而是定义一套规则。 努比亚NaviX Ultra 9月16日开售。SAEP 30天公示期也差不多在那之后结束。到时候看第三方应用的实际响应,比看字节的宣传更有意思。 来源: 豆包手机助手消费者版 — 微信公众平台

优秀的个人博客,低调大师

WIKI 知识库 v1.1.2 正式发布

这个功能有什么作用呢? 以前调 top_k、相似度阈值、切块长度都要改 conf/config.json 然后再重启服务,要做对比实验就很慢,也容易「改了配置但进程还在用旧值」。KB-20 检索配置(含固定长度分片调整)将该功能做成控制台里的功能: 1.知识库管理 「检索与分片」:直接改 default_k、max_search_results、min_source_similarity、chunk_size、chunk_overlap。 2.保存即热更新:检索参数修改后即可生效 /api/query(未显式传 k 时走新的 default_k),不用在重启服务了。 3.分片参数对新导入生效:新上传 / 文本写入按新块长切分;不过已有文档则需要点「重建分片」才会按新规则重切。 4.当前生效值可读:GET /api/kb/settings 返回进程里真正在用的数据,避免「文件写了、内存没改就」的错觉。 不过社区版仍只提供固定长度切分;语义 / 递归分片是商业专属本页不会出现语义策略下拉。 整体架构如下图 ┌──────────── 用户 ────────────┐│ 知识库管理 · 检索与分片 ││ 检索问答 /api/query ││ 新导入 / 重建分片 │└──────────────┬───────────────┘ │ GET/PUT ▼┌──────────── 后端 ────────────┐│ /api/kb/settings ││ → retrieval_settings.py ││ ├→ conf/config.json ││ └→ 运行时 kb.default_k ││ / chunk_* / _search │└──────────────────────────────┘ 层次 路径 说明 校验 / 落盘辅助 src/kb/retrieval_settings.py 范围校验、写 config 字典、热更新运行时属性 API handlers/kb.py + KnowledgeBaseApi GET/PUT /api/kb/settings 查询默认 k handlers/query.py 请求未带 k 时用 api.default_search_k() 页面 frontend/src/views/kb/KbManagement.vue 「检索与分片」表单 前端 API frontend/src/api/kb.ts getKbSettings / updateKbSettings 怎么用使用? 1、 打开面板 启动服务后进入控制台「知识库管理」→「检索与分片」即可看到当前生效值。建议参数(也是当前本版默认配置): 参数 默认 说明 default_k 5 问答未指定 k 时的召回数;检索问答页挂载时会同步该值 max_search_results 10 召回上限,须 ≥ default_k min_source_similarity 0.0 0 = 关闭硬阈值,减少长尾被误杀 chunk_size 800 固定长度块大小(字符) chunk_overlap 120 相邻块重叠 修改完配置后耍要刷新「检索问答」页即可,工具栏召回数会跟新的 default_k 对齐(仍可临时手动调)。 2、 改检索参数 将 default_k 参数调整到 8 后点击「保存并生效」按钮,再去检索问答提问(先不带 k 调 /api/query)召回参数会立刻改变。 # 读当前生效值curl -s http://127.0.0.1:8000/api/kb/settings | python -m json.tool# 热更新(示例)curl -s -X PUT http://127.0.0.1:8000/api/kb/settings \ -H "Content-Type: application/json" \ -d "{\"default_k\":8,\"max_search_results\":12,\"min_source_similarity\":0,\"chunk_size\":800,\"chunk_overlap\":120}" \ | python -m json.tool 接口 说明 GET /api/kb/settings 当前生效参数 + 使用说明 notes PUT /api/kb/settings 校验后写配置文件并热更新进程 3. 改分片参数(新导入 / 重建) 改 chunk_size / chunk_overlap 后: -新导入的文档按新规则切; -旧文档的不会自动重新分片需在左侧选中文档后点「重建分片」。 4. 和评测 / 看板一起用 同一套参数下用 KB-10 跑分用 KB-11 看板看结果,对比实验才可复现。python -m src.eval.cli省略 --top-k时会跟当前知识库 default_k(并至少覆盖指标所需的 k),报告 config 会带上 default_k、chunk_size、chunk_overlap、top_k_source 等方便对账。 python -m src.eval.cli # top_k 跟 KB-20python -m src.eval.cli --top-k 10 # 显式覆盖 是怎么实现的,数据流如下图 KbManagement │ PUT /api/kb/settings ▼retrieval_settings.normalize_settings │ ├─→ 写 conf/config.json(search / chunking) └─→ 热更新 KnowledgeBase 运行时 (default_k / chunk_* / _search_cfg) │ ▼ /api/query search(k=default_k) 后端的重点有如下四点 校验集中在 normalize_settings 越界、max < default_k、overlap ≥ size 都会直接返回400。 写文件用现有 _config_write_path(),只会修改 search.* 与 knowledge_base.chunking.*,不会动密钥等其它部分。 _search_cfg 与 kb.* 会同步更新避免「若只改了其中一个」。 社区切分仍会走固定长度,语义分片只会在商业版本支持 business/chunking。 前端重点有如下两点 在中间栏新增 Tab「检索与分片」el-input-number 编辑五项等参数。 在分片策略展示为只读「固定长度(社区)」。 重点代码示例 读 / 写设置(Python) from src.kb.retrieval_settings import normalize_settings, snapshot_from_runtime# 假定 api 已启动snap = api.get_retrieval_settings()updated = api.update_retrieval_settings({"default_k": 8, "max_search_results": 12})assert updated["default_k"] == 8 响应的配置片段 { "ok": true, "settings": { "default_k": 8, "max_search_results": 12, "min_source_similarity": 0.0, "chunk_size": 800, "chunk_overlap": 120, "chunking_strategy": "fixed", "notes": { "search": "检索参数保存后立即生效,无需重启服务。", "chunk": "分片参数仅对新导入或「重建分片」生效;旧文档不会自动重切。" } }} 如何测试呢?如下方式 # 单元:校验、热更新、路径识别python -m unittest tests.test_kb_settings -v# 静态路由仍把 /api/kb/settings 当 API(不 SPA fallback)python -m unittest tests.test_p6_static_ui -v 如何手动验收方式如下三点: 打开「检索与分片」改 default_k 保存 不用重启服务,直接问答召回条数变化。 修改小 chunk_size 后新导入一段长文 → 分片数变多,旧文档需要重建分片。 min_source_similarity 设为 0 与设为 0.55 各跑一轮评测,在对比 Recall 是否按预期变化。 关于维基框架 维基本地知识库是一个本地优先的开源知识库系统,融合向量检索、重排与对话式问答,支持多种主流大模型 API,具备高性能本地存储与灵活扩展能力,适合智能问答、知识管理、企业知识中台等场景。MulanPSL2 许可证,欢迎共建! 官网:framewiki.com Gitee:https://gitee.com/cdkjframework/knowledge-base 📄 许可证:MulanPSL-2.0(木兰宽松许可证,第2版)

优秀的个人博客,低调大师

🔥🔥ApiGo 智能开发平台 6.2 发布

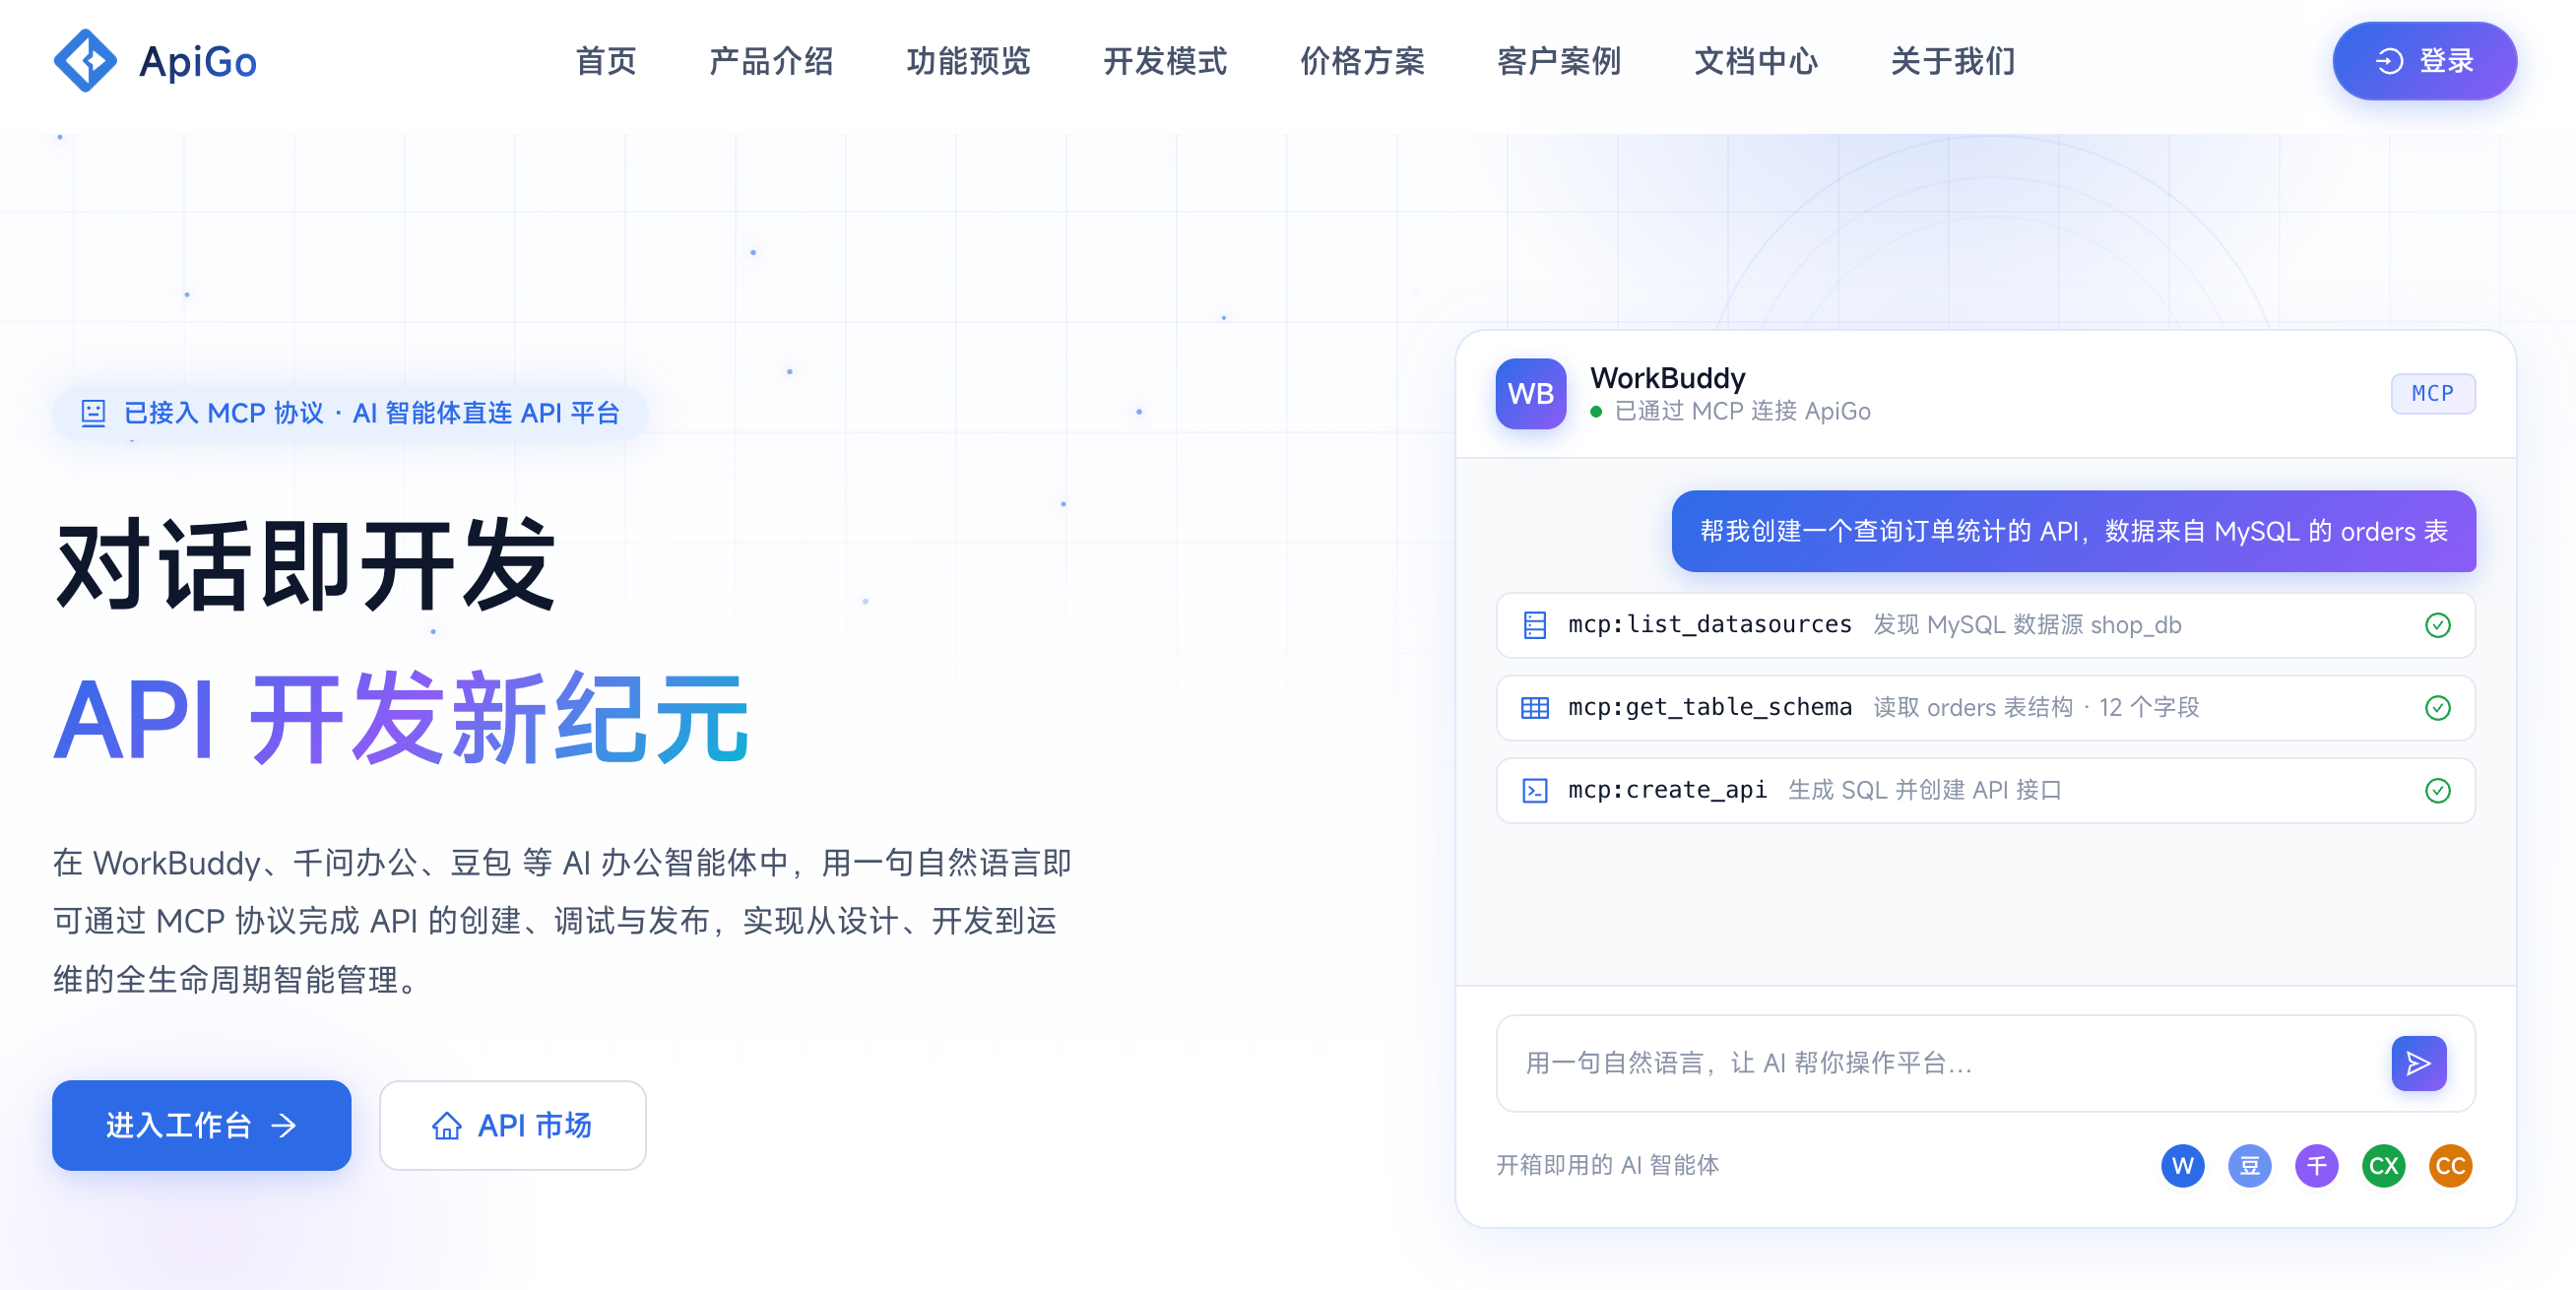
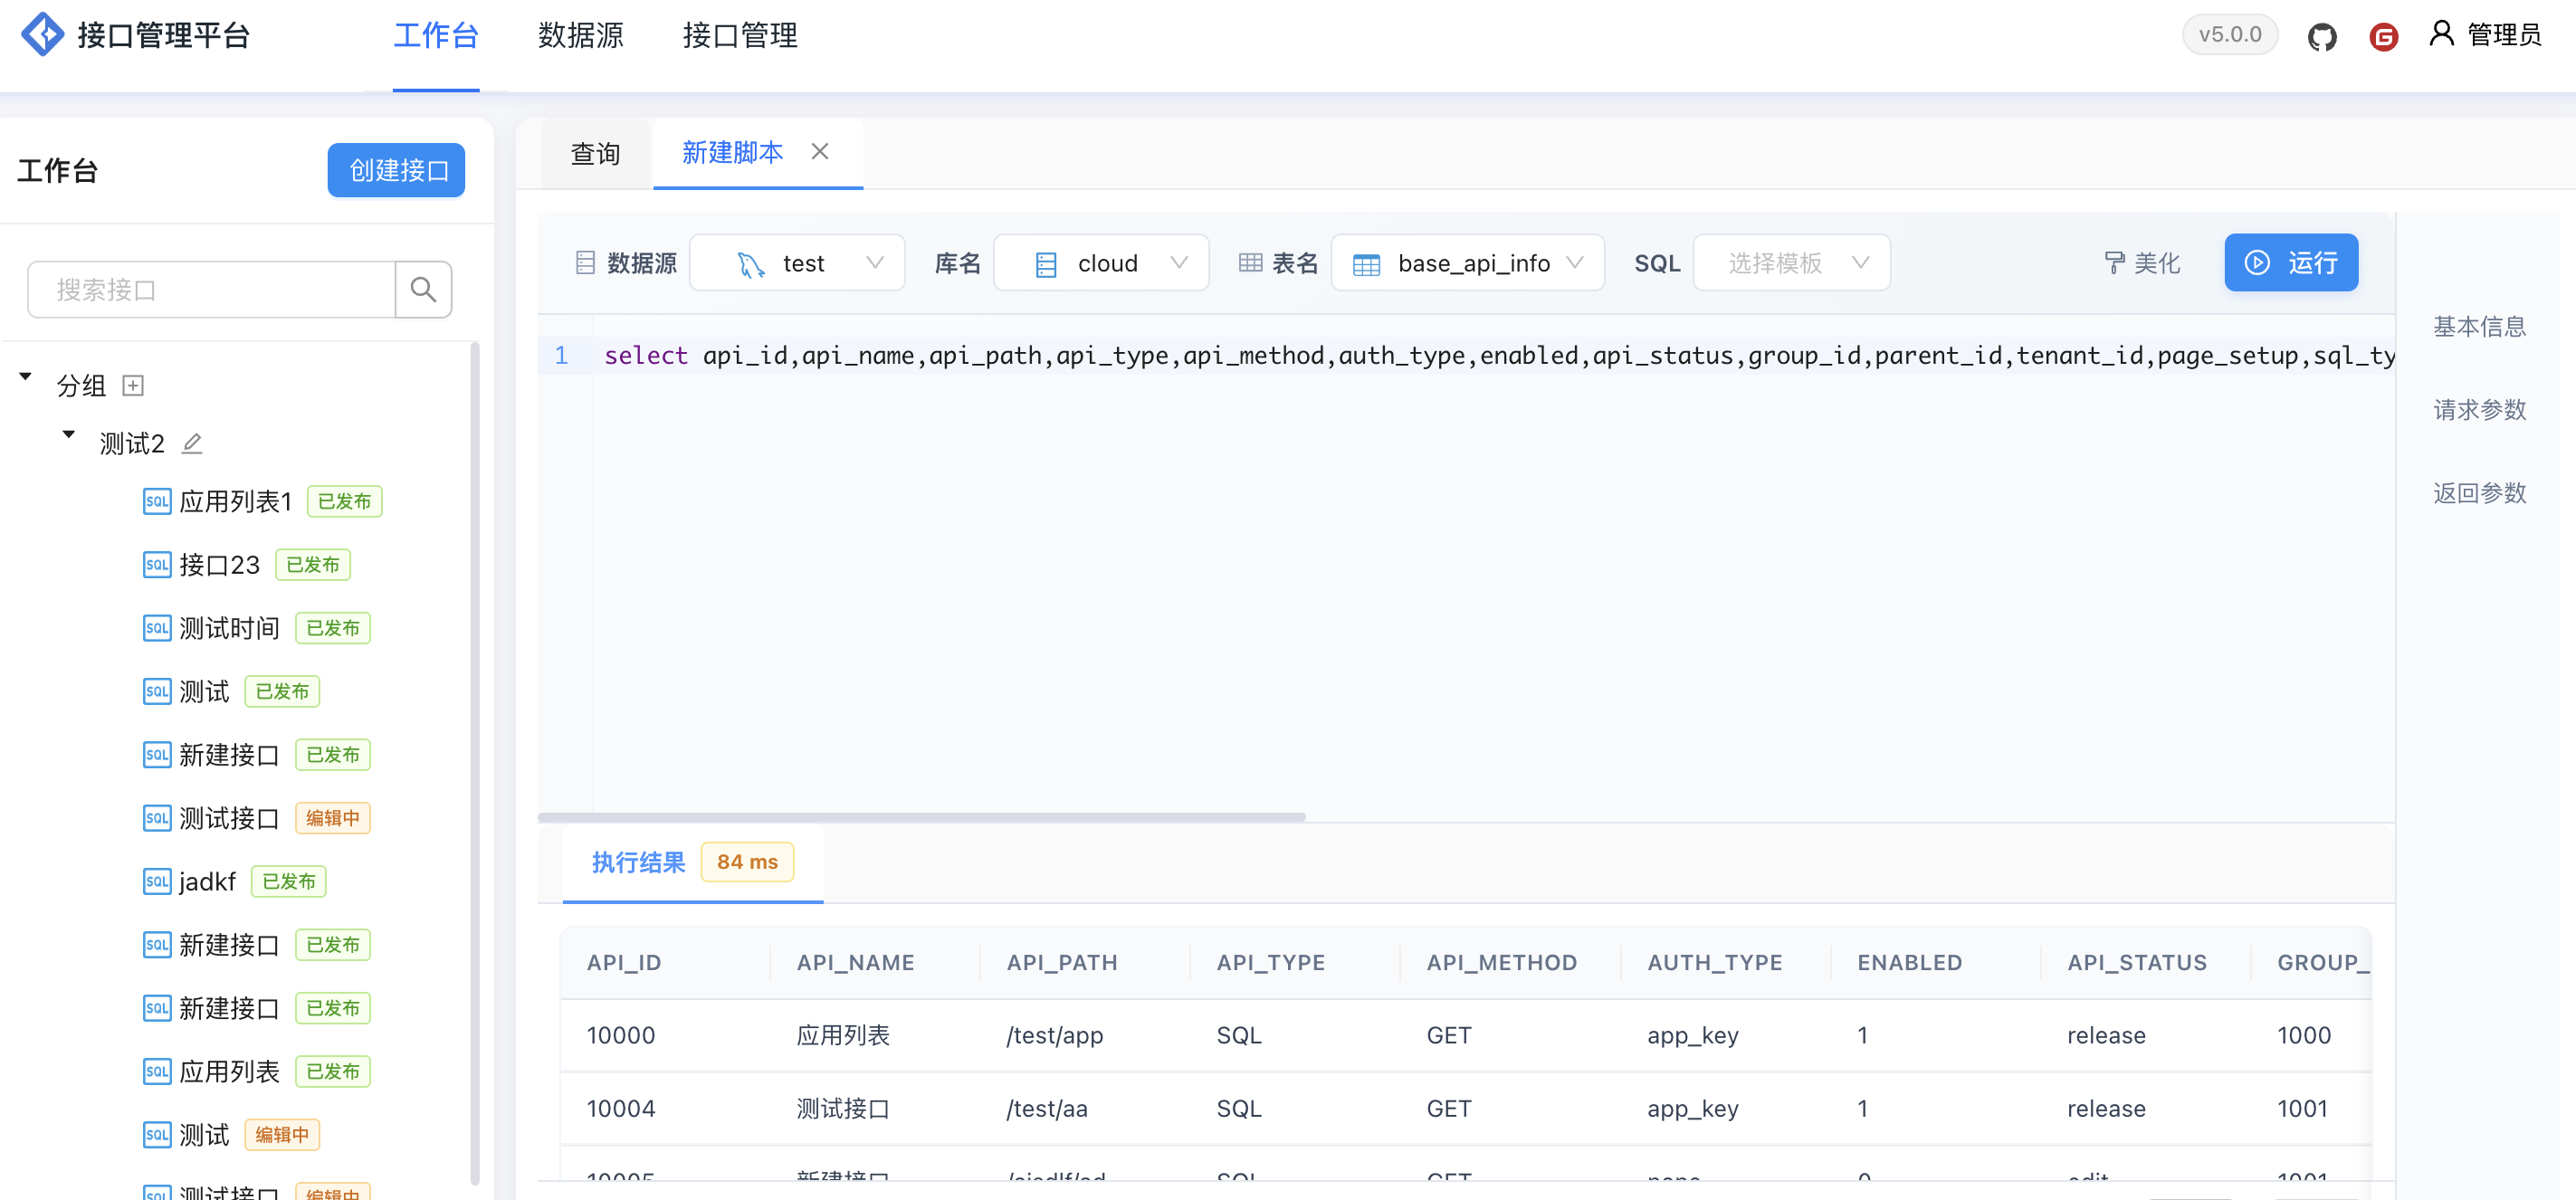
ApiGo(www.apigo.cn) 是一款基于 AI 技术的企业级低代码 API 开发与治理平台。 通过 AI 办公智能体使用自然语言对话即可将数据变成标准 REST API 和MCP服务, 实现从设计、开发到运维的全生命周期AI智能化管理。支持WorkBuddy、千问办公、豆包等AI办公平台MCP接入。平台内置支持多数据源(mysql、oracle 、postgresql、Kingbase、达梦、TiDB、Hive、DolphinDB)等;支持实时接口开发、接口文档、数据脱敏、数据插件、权限认证、限流熔断、指标统计、代理转发、接口编排、告警通知、项目隔离、版本回滚、接口订阅、MCP链接、环境隔离等,让开发人员专注更复杂的业务逻辑实现,助力于企业数据资产价值升级,成为企业 AI 智能化转型的重要推动力. 6.2 更新内容 1、新增个人信息卡片页面 2、AI 问数升级为智能助理,支持多轮上下文对话和自定义语义层 3、智能助理新增支持调用平台内置的MCP 通过对话操作业务流程 4、优化接口请求日志响应结果解析 5、修复接口日志存储结果过大问题 官网地址: ApiGo 开源地址: ApiGo

优秀的个人博客,低调大师

WIKI 知识库 v1.1.1 正式发布

这个功能有什么作用 调整了 top_k、更换了 embedding 或修改了分片参数之后,检索到底是变好了还是变差了?本功能把这件事做成可重复、看得见的流程: 命令行跑评测(python -m src.eval.cli):用固定内容逐题调用检索,算出 Recall、NDCG、延迟等,结果写入文件 kb_store/eval/latest.json。 控制台指标看板:打开页面时读取上面的文件,把里面的数字展示成 KPI 卡片、历史记录和趋势图,并支持导出 CSV。 前端看板只负责展示,不会在浏览器里重新跑检索,也不会重新计算指标。所以只的先跑完评测再打开看板,两边看到的就才是同一份结果;还没跑过时看板则会提示你先执行评测命令,不会用默认就验收线来冒充实测值。 整体架构如下图 flowchart TB subgraph 用户 U1[命令行 / wiki-eval] U2[控制台 · 指标看板] end subgraph 后端 E1[src/eval<br/>内容 · 跑分 · 指标] E2[kb_store/eval/latest.json] E3[src/metrics<br/>KPI 整形] E4[GET /api/metrics] E1 --> E2 E2 --> E3 --> E4 end subgraph 前端 F1[MetricsDashboard.vue] F2[/api/stats 运行时统计] end U1 --> E1 U2 --> F1 E4 --> F1 F2 --> F1 标题 目录路径 说明 内容 conf/eval/golden-default.jsonl 固定配置「问法 → 应命中文档」 跑分 src/eval/ 调检索、算指标、写报告等等 报告 kb_store/eval/latest.json 跑评测后生成的结果文件,看板展示的就是读它 看板 API src/metrics/ + handlers/metrics.py 读取报告、对照验收线、给出 JSON对象 看板页面 frontend/src/views/metrics/MetricsDashboard.vue KPI 卡片、历史、趋势、CSV等 如何使用 1. 准备内容 默认内容 conf/eval/golden-default.jsonl(64 题),UTF-8 JSONL,一行就是一个测试内容: {"id": "kb-001", "query": "怎么从 v1.0.0 升级到 v1.1.0", "positives": ["升级迁移指南.md"], "tags": ["部署运维"]} 更换成自己的语料时,整体替换内容或设置环境变量 KB_EVAL_DATASET【建议替换内容设置环境变量我没有成功过】。内容需先把对应文档导入到知识库中。 2. 后端跑分 # 校验内容格式,不加载模型 python -m src.eval.cli --validate # 跑分并刷新 latest.json python -m src.eval.cli 当然也可使用 wiki-eval。报告会落在 kb_store/eval/目录下,同时生成带时间戳的 report-*.json 文件与固定的 latest.json文件。 3. 前端看板 启动服务后打开控制台 「指标看板」: 四项 KPI:Recall@5、Recall@3、NDCG@10、检索 p95,标注达标 / 未达标 / 无数据 最近一次评测摘要:内容、题量、跑分时间、核心指标 历史列表 + Recall@5 趋势线 CSV 导出 运行时统计(文档数、分片数、模型、内存等,中文标签) 当还未跑分则显示空状态和跑分提示不会用验收线代替实测值。 4. 调接口(可选) curl -s http://127.0.0.1:8000/api/metrics | python -m json.tool curl -s "http://127.0.0.1:8000/api/metrics/reports?limit=20" 接口 说明 GET /api/metrics KPI + 最近报告 + 历史(看板用这个) GET /api/metrics/reports 仅历史列表 默认验收线:Recall@5 ≥ 0.85、Recall@3 ≥ 0.75、NDCG@10 ≥ 0.70、检索 p95 ≤ 300ms。可在 conf/config.json 覆盖: { "metrics": { "targets": { "recall@5": 0.85, "recall@3": 0.75, "ndcg@10": 0.70, "latency_p95_ms": 300 } } } 具体是怎么实现的,数据流如下图 sequenceDiagram participant CLI as 跑分 CLI participant RN as runner.py participant KB as 检索 participant FS as latest.json participant API as /api/metrics participant UI as 指标看板 CLI->>RN: run_evaluation(search_fn) loop 每道题 RN->>KB: search(query, top_k) KB-->>RN: 文档名列表 RN->>RN: metrics.py 算 Recall/NDCG/MRR end RN->>FS: save_report UI->>API: GET /api/metrics API->>FS: load_latest + list_reports API->>API: dashboard.py 对照验收线 API-->>UI: kpis + latest + history 后端重点 检索通过回调注入run_evaluation(search_fn, cases) 不会绑死 KnowledgeBase,单元测可以给假数据。 指标在 metrics.py 用标准库来实现,基于「命中标记序列」算 Recall@k、NDCG@k、MRR 等。 单题失败记 0 分写 cases[].error不会中断整轮。 dashboard.build_dashboard() 读取报告里的 summary 字段,转成 KPI 卡片并按配置判断是否达标。 前端重点 MetricsDashboard.vue 调用/api/metrics 接口渲染 KPI与历史,Recall@5 趋势用 SVG 折线实现。 /api/stats 的运行时字段经 STAT_LABELS 显示为中文。 对接知识库跑分、示例代码 from src.eval import load_dataset, make_kb_searcher, run_evaluation, save_report from src.knowledge_base import KnowledgeBase kb = KnowledgeBase() report = run_evaluation(make_kb_searcher(kb), load_dataset()) save_report(report) # → kb_store/eval/latest.json 自定义检索器(测试与二次开发) from src.eval import load_dataset, run_evaluation, save_report def my_search(query: str, top_k: int) -> list[str]: return ["升级迁移指南.md"][:top_k] save_report(run_evaluation(my_search, load_dataset())) 报告内容部分(看板展示的数据就来自这里) { "schema": "kb-eval-report/1", "summary": { "case_count": 64, "recall@5": 0.91, "ndcg@10": 0.78, "latency_ms": { "p95": 120.0 } } } 接口返回部分重点内容 { "ok": true, "available": true, "kpis": [ { "key": "recall@5", "value": 0.912, "status": "pass", "target_display": "≥ 0.85" } ], "latest": { "generated_at": "...", "case_count": 64 }, "history": [] } 那怎么测试呢、如何实现自动化。 python -m unittest tests.test_eval tests.test_metrics -v test_eval 覆盖了内容、指标算法、跑分与报告;test_metrics 覆盖了报告读取、KPI 与报告数值一致、接口结构等。 那如何手工走通呢(前后端一条链路) ① 将 docs/ 目录下的内容导入知识库 ② python -m src.eval.cli --validate ③ python -m src.eval.cli ④ 启动服务然后打开「指标看板」 ⑤ 核对 KPI 与 kb_store/eval/latest.json 的 summary 是否一致 ⑥ 再跑第二次评测然后刷新,历史就多了一条、趋势线的变化 ⑦ 导出 CSV 格式文档字段与列表是一致的 ⑧ 删除 latest.json 文件后刷新页面这时会是空态 + 跑分提示 调试看板整形层 from pathlib import Path from src.metrics.dashboard import build_dashboard print(build_dashboard(report_dir=Path("kb_store/eval"))) 关于维基框架 维基本地知识库 是一个本地优先的开源知识库系统,融合向量检索、重排与对话式问答,支持多种主流大模型 API,具备高性能本地存储与灵活扩展能力,适合智能问答、知识管理、企业知识中台等场景。MulanPSL2 许可证,欢迎共建! 官网:framewiki.com Gitee:https://gitee.com/cdkjframework/knowledge-base 📄 许可证:MulanPSL-2.0(木兰宽松许可证,第 2 版)

优秀的个人博客,低调大师

WIKI 知识库 v1.1.0 正式发布

WIKI 本地知识库 v1.1.0 更新说明 本次更新主要聚焦于工程目录结构与控制台的调整,方便后续使用与后续迭代;主要变化如下。 1. 项目目录结构的调整 按业务重新梳理了后端与配置,例如将 HTTP 能力调整到 src/api/,运行配置统一放到 conf/ 等。这样结构更加清晰了,功能定位更加直观,对后续维护和扩展降低了成本。 2. 前端技术栈升级 将原来 HTML 静态控制台已迁移为 Vue3 + TypeScript + Element Plus 工程,前端工程位于仓库 frontend/ 目录。新技术栈带来更好的约束、组件复用与工程化能力,也为页面的重构打下基础。 3. 控制台页面的全面重构 检索问答、知识库 管理、模型管理等能力已统一纳入新的控制台:左侧导航 + 顶栏布局,更加的清晰和风格一致性。所有操作可在同一界面完成,无需再在旧页面间跳转。 4. 启用新项目 Logo 对于控制台侧栏与相关入口已启用新的项目 Logo,品牌与视觉识别加更清晰。 对于升级建议 在拉取或下载最新版本代码后,即可按 README 内容完成依赖的安装与配置。 前端则需在 frontend/ 下构建(或开发模式启动),也可由后端托管构建预览。 调整了业务接口统一使用 /api 前缀(例如 /api/query);API 说明调整到了控制台顶栏打开【API文档】。 如在使用中遇到问题,欢迎通过仓库 Issue 反馈。感谢对 WIKI 本地知识库 的支持。 关于维基框架 维基本地知识库是一个本地优先的开源知识库系统,融合向量检索、重排与对话式问答,支持多种主流大模型 API,具备高性能本地存储与灵活扩展能力,适合智能问答、知识管理、企业知识中台等场景。MulanPSL2 许可证,欢迎共建! 官网:framewiki.com Gitee:https://gitee.com/cdkjframework/knowledge-base 📄 许可证:MulanPSL-2.0(木兰宽松许可证,第2版)

优秀的个人博客,低调大师

腾讯混元 Hy ASR3.0preview 发布

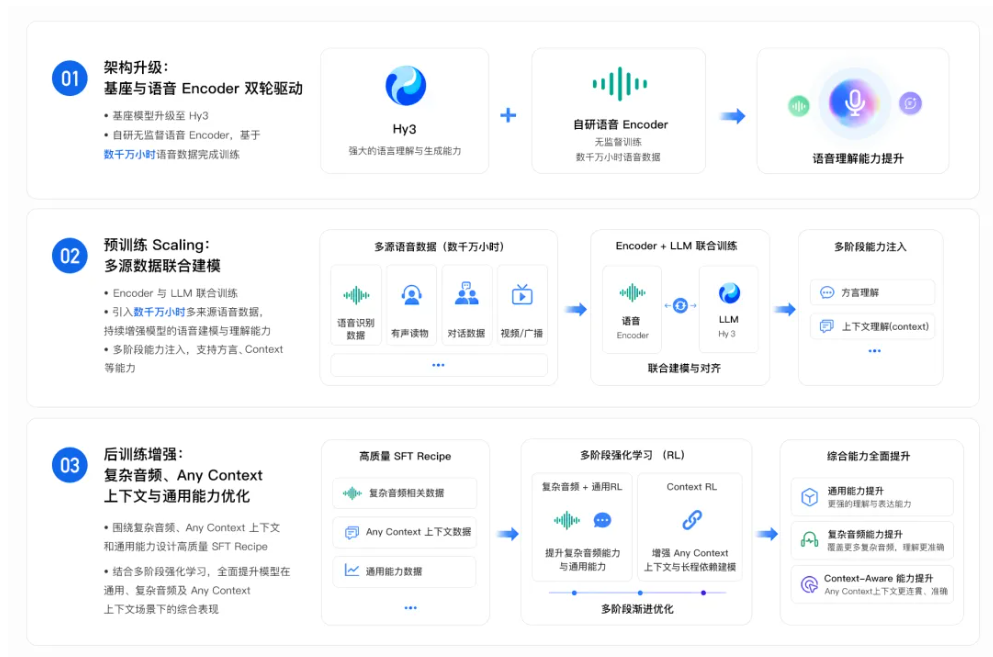
腾讯混元正式推出新一代语音识别模型 Hy ASR3.0preview。基于最新一代大语言模型 Hy3 的语言理解能力,以及融合了高精度语音识别与深度语义理解能力,实现了语音识别能力的全面升级。 根据介绍,Hy ASR3.0preview 目标在于:让语音识别不再只是听清,而是真正听懂。通过先理解你的语境和意图,再把准确的文字直接给到你。从“逐字转写、单点优化”演进为“理解语境、兼容场景、一键直出”。 Hy ASR 3.0 preview 不要求标准普通话,方言识别覆盖粤语、吴语等 10 大方言片区和 20 余个二级小片区。在开源评测集中,Hy ASR 3.0 preview 在多语种的WER(Word Error Rate, 词错误率)上控制在 3% 左右,其中中文普通话 WER 3.34%、英语 WER 2.62%、粤语 WER 3.12%。 结合 Hy3 的语言理解能力,结合上下文 Context 精准捕捉用户语境,Hy ASR 3.0 preview 可消除歧义,智能纠错同音词。在转写难度较大的会议纪要、访谈转写等长音频场景中却尤为有优势。 技术层面上,Hy ASR3.0preview 在模型架构层面:采用兼顾效率与性能的MoE架构,基座模型升级至Hy3。在语音侧,混元团队自研了无监督语音Encoder,通过数千万小时级的无监督语音数据训练,使其能够从各种复杂音频中提取高质量的声学表征。Encoder负责听得好,Hy3负责理解对。 数据Scaling层面:团队对语音 Encoder 和大语言模型进行联合训练,引入数千万小时级、多来源的语音数据,持续增强模型的语音建模与理解能力。并通过多阶段能力注入,使其具备上下文感知、复杂场景适应和方言识别等能力。 后训练优化上:围绕通用识别、上下文理解和复杂场景鲁棒性,构建了高质量的 SFT recipe,覆盖上下文Context、专业名词、不同声学环境以及多样人群语音等。团队还进一步引入多阶段强化学习,分别针对通用转写准确性、Any-context 上下文能力和复杂长尾场景进行优化,降低模型在复杂声学环境中的误识别和漏识别问题。 目前,Hy ASR3.0preview已上线腾讯云官网对外开放API,可广泛应用于智能客服、内容理解、语音搜索等领域。腾讯旗下AI助手“元宝”已完成首发接入,用户可通过语音输入体验方言识别、上下文智能纠错、复杂环境稳定转写等功能,相关能力免费开放;WorkBuddy等产品也在陆续接入中。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册