CrewAI 角色驱动:我给 AI 分配了 3 个角色,效果惊人
# 第13章 评估与评测:如何衡量Agent的好坏 前面十二章我们完成了AI Agent**底层原理、工具开发、交互可视化、四大垂直场景实战项目**的全流程落地。很多开发者会遇到一个核心问题:**Agent功能能跑,但如何证明它跑得好、跑得稳、跑得高效?** 大模型与Agent开发区别于传统软件最大的痛点:**无明确编译报错、无固定输出结果、效果不可量化、迭代无法对标**。传统单元测试无法适配AI智能体,仅凭人工主观判断,会导致上线风险高、迭代盲目、版本退化无法感知。 本章聚焦**Agent工程化最后一道关卡——标准化评测体系**,从零搭建工业级评估方案:从核心指标定义、自动化评测框架、LLM智能打分、回归测试集搭建,到人工审核规范,同时区分**客户端本地轻量评测**与**云端规模化持续评测**,所有代码极简可运行、附带原理图例、官方溯源,可直接接入项目CI/CD流水线。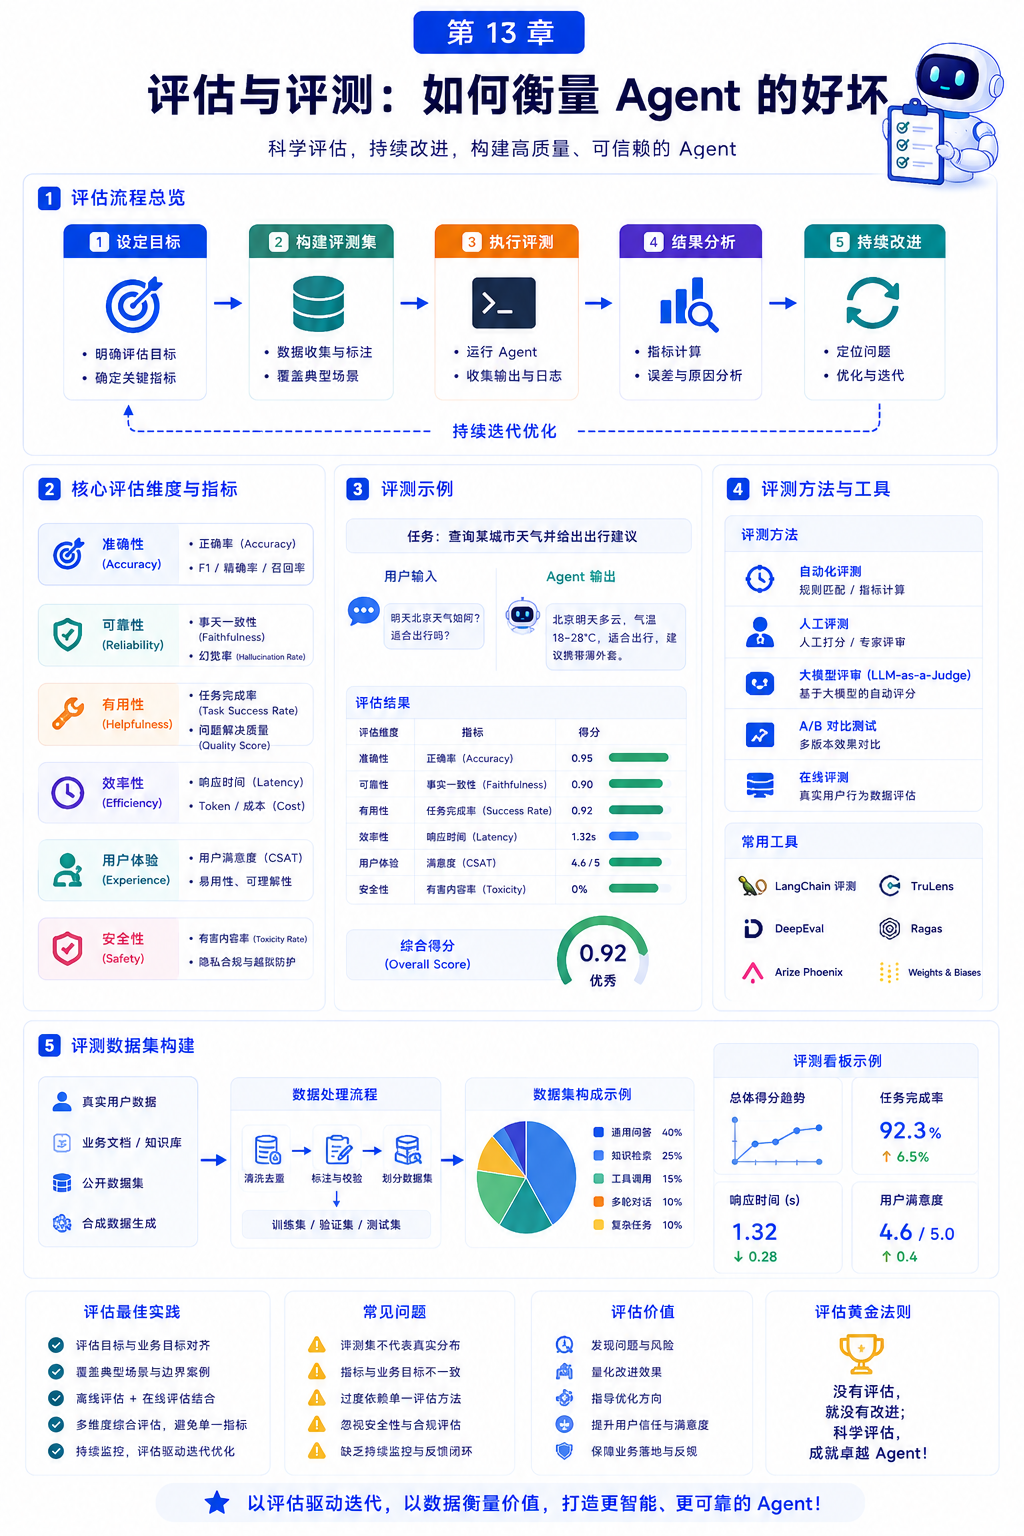 ## 13\.1 评估指标体系:准确性、鲁棒性与效率 想要科学衡量Agent好坏,首先要建立**可量化、可落地、可对比**的指标体系。业界通用Agent评测三大核心维度:**准确性(效果好不好)、鲁棒性(稳不稳定)、效率(成本高不高)**,覆盖研发、测试、上线、运维全生命周期。 ### 13\.1\.1 准确性指标:任务效果核心标尺 用于衡量Agent推理、工具调用、任务执行的正确性,是最核心的业务指标,分为步骤级与任务级两层评估标准: - **任务完成率**:完整达成用户最终诉求的任务占比,核心业务指标; - **工具调用准确率**:是否正确选择工具、参数是否合规、调用逻辑是否合理; - **回答事实准确率**:无幻觉、无错误信息、结论贴合真实数据与业务规则; - **步骤合规率**:复杂任务多步骤执行逻辑是否符合预期流程。 ### 13\.1\.2 鲁棒性指标:上线稳定性保障 鲁棒性决定Agent能否应对**异常输入、模糊提问、对抗干扰、长时间运行**,是生产环境可用性的关键,直接规避线上事故: - **异常容错率**:乱码、空输入、歧义提问、超长文本的处理能力,不崩溃、不瞎答; - **对抗抗干扰性**:面对诱导提问、越权请求、恶意试探的拦截能力; - **上下文稳定性**:多轮对话中不遗忘信息、不前后矛盾、逻辑一致; - **长时间运行稳定性**:长任务、多轮迭代无内存泄漏、逻辑漂移。 ### 13\.1\.3 效率指标:规模化落地成本关键 效果再好的Agent,效率过低、成本过高也无法规模化上线,效率指标兼顾体验与成本: - **首Token时延\(TTFT\)**:用户感知最直观的体验指标,决定交互流畅度; - **整体推理延迟**:单任务完整执行耗时,包含思考、工具调用、结果生成全链路; - **Token消耗成本**:输入输出Token总量,直接关联API计费成本; - **资源利用率**:CPU/内存占用、并发承载能力,适配云端高并发场景。 ### 13\.1\.4 双端指标适配差异 - **客户端Agent**:优先保障鲁棒性与本地响应速度,弱化高并发效率指标,适配单机离线场景; - **云端Agent**:全指标严格考核,重点监控并发效率、成本消耗、长期稳定性,适配规模化商用。 ## 13\.2 自动化评测框架:Ragas 与 TruLens 实战 人工评测效率极低、主观偏差大、无法持续回归。工业级Agent开发必须依托**专业自动化评测框架**。目前业界两大主流开源方案:**Ragas**轻量化快速评测、**TruLens**全链路可观测评测,分别适配本地调试与云端生产环境。 ### 13\.2\.1 两大框架选型对比 |框架|核心优势|适配场景|端侧适配| |---|---|---|---| |Ragas|轻量易用、开箱即用、指标丰富、部署零成本|快速迭代评测、版本对比、回归测试|客户端首选| |TruLens|全链路追踪、可视化溯源、支持Agent链路评测|生产环境监控、问题定位、持续评测|云端首选| **官方溯源**:[Ragas 官方文档](https://ragas.io/)、[TruLens 官方文档](https://www.trulens.org/) ### 13\.2\.2 Ragas 客户端轻量化评测实战 几行代码快速实现RAG与Agent自动打分,适配本地版本迭代、快速效果验证。 ```python # 安装依赖:pip install ragas openai from ragas import evaluate from ragas.metrics import faithfulness, answer_relevancy from datasets import Dataset # 构造Agent问答样本 sample_data = { "question": ["AI Agent的核心组成是什么?"], "answer": ["AI Agent包含大模型底座、记忆系统、工具调用、规划推理四大核心模块。"], "contexts": [["记忆、规划、工具、大模型是Agent基础核心能力"]] } # 构建评测数据集 dataset = Dataset.from_dict(sample_data) # 自动化评测 result = evaluate( dataset=dataset, metrics=[faithfulness, answer_relevancy] ) print("Ragas自动评测结果:") print(result) ``` ### 13\.2\.3 TruLens 云端全链路评测实战 适配云端Agent,支持追踪Agent思考、工具调用、检索链路,精准定位低分问题节点。 ```python # 安装依赖:pip install trulens-eval from trulens_eval import Tru, TruBasicApp from langchain_openai import ChatOpenAI tru = Tru() llm = ChatOpenAI(model="gpt-3.5-turbo") # 封装可追踪的Agent应用 def agent_qa(query: str) -> str: return llm.invoke(query).content # 开启全链路观测 tru_app = TruBasicApp(agent_qa) # 评测调用 with tru_app as recording: res = agent_qa("简述Agent鲁棒性的定义") # 自动生成可视化评测报告 tru.run_dashboard() ``` ## 13\.3 基于 LLM 的评估:用 GPT\-5 给 Agent 打分 传统固定指标评测存在局限性,无法评估**话术流畅度、逻辑合理性、业务贴合度、共情能力**等软性体验指标。当前工业界主流方案:**以大模型评测大模型**,使用更强的基座模型(GPT\-5)作为评测裁判,实现全方位、拟人化、精细化打分。 ### 13\.3\.1 LLM评测核心优势 - 突破传统规则限制,理解语义、逻辑、语境与业务场景; - 统一打分标准,规避人工主观偏差,支持批量自动化评测; - 可输出具体扣分原因、优化建议,不仅打分、还能指导迭代。 ### 13\.3\.2 标准化LLM打分Prompt范式 固定打分维度与评分规则,保证每次评测口径一致,支持版本横向对比。 ```python from openai import OpenAI client = OpenAI() # 标准化评测Prompt EVAL_PROMPT = """ 你是专业的AI Agent评测裁判,基于以下5个维度对Agent回答打分(满分10分): 1. 准确性:信息无错误、无幻觉(2分) 2. 逻辑性:推理连贯、步骤清晰(2分) 3. 完整性:覆盖用户问题全部诉求(2分) 4. 鲁棒性:应对提问合理、无错乱应答(2分) 5. 实用性:答案可落地、贴合业务场景(2分) 用户问题:{query} Agent回答:{response} 输出格式:总分、各维度得分、扣分原因、优化建议 """ def llm_agent_score(query: str, response: str) -> str: res = client.chat.completions.create( model="gpt-5", messages=[{"role": "user", "content": EVAL_PROMPT.format(query=query, response=response)}] ) return res.choices[0].message.content # 测试打分 if __name__ == "__main__": score_res = llm_agent_score("如何排查Agent工具调用失败问题?", "检查网络和密钥即可。") print("GPT-5评测打分结果:\n", score_res) ``` ### 13\.3\.3 双端评测策略差异 - **客户端**:低频单次评测,用于本地功能验证、单样本效果校验; - **云端**:批量定时评测、版本对比评测、全量用例回归评测,自动生成版本质量报告。 ## 13\.4 构建黄金测试集:回归测试与持续集成 自动化评测的基石是**黄金测试集(Golden Dataset)**。没有标准测试集,每次迭代效果好坏全凭感觉。黄金测试集是经过人工校验、标准答案确定、覆盖核心场景的基准用例,用于每次版本迭代的回归测试,杜绝模型退化、功能降级。 ### 13\.4\.1 黄金测试集构建规范 企业级Agent测试集必须覆盖四类核心用例: - **正向标准用例**:常规标准提问,验证基础能力准确性; - **边界极限用例**:超长文本、极简提问、模糊语义、多轮复杂推理; - **异常对抗用例**:乱码、诱导、越权、恶意提问,验证鲁棒性; - **业务核心用例**:贴合项目真实业务高频场景,保障核心功能稳定。 ### 13\.4\.2 轻量化黄金测试集\+回归测试代码 ```python import json # 本地黄金测试集(云端存入数据库持续迭代) GOLDEN_TEST_SET = [ { "query": "简述AI Agent的规划能力作用", "standard_score": 9.0, "scene_type": "标准业务用例" }, { "query": "@@@@测试乱码提问123!@#", "standard_score": 8.5, "scene_type": "异常鲁棒性用例" } ] def regression_test(agent_func, eval_func): """批量回归测试,对比版本得分差异""" report = [] for case in GOLDEN_TEST_SET: res = agent_func(case["query"]) score = eval_func(case["query"], res) report.append({"case": case, "current_score": score}) return report ``` ### 13\.4\.3 CI/CD持续集成评测流程 云端生产级流程:代码提交触发CI流水线 → 自动执行黄金测试集回归 → 批量LLM打分 → 对比历史版本分数 → 分数下降则阻断合并、触发告警 → 输出版本质量报告。真正实现**每次迭代必评测、每次更新必回归**。 ## 13\.5 人工评估流程:众包标注与专家审核规范 自动化评测无法覆盖所有软性体验、复杂业务场景,**自动化评测\+人工审核**才是完整闭环。业界通用方案:众包批量初评\+专家终审校验,兼顾评测效率与结果准确性,同时持续沉淀优质评测数据反向优化自动打分模型。 ### 13\.5\.1 三级人工评估流程规范 标准化企业级审核链路,规避主观随意打分: 1. **众包批量初评**:基于统一打分维度,批量标注日常样本、覆盖海量场景; 2. **算法异常筛选**:自动筛选人机打分差异大、低分、争议样本; 3. **技术专家终审**:核心业务样本、异常样本人工复核,确定最终分数与优化方向。 ### 13\.5\.2 人工评估统一打分维度 统一对齐自动化LLM评测维度,保证人机评测口径一致:准确性、逻辑性、完整性、鲁棒性、实用性,每项0\-2分,总分10分,同时必填扣分说明与优化建议。 ### 13\.5\.3 双端人工评估适配 - **客户端**:开发者单人人工抽检,用于个人项目迭代验证; - **云端**:团队标准化众包\+专家审核,形成评测SOP,沉淀企业级评测数据集,持续优化Agent效果。 ## 本章小结 本章完整落地了**AI Agent工业级评测体系**,补齐Agent开发最后一块工程化短板,彻底解决「效果无法量化、迭代无法对标、上线无法兜底」的行业痛点,核心知识点汇总: - 搭建三维核心指标体系,从准确性、鲁棒性、效率全方位量化Agent能力; - 实战Ragas、TruLens双评测框架,区分客户端轻量评测与云端全链路观测; - 落地GPT\-5大模型自动打分方案,实现精细化、拟人化、可迭代的智能评测; - 构建黄金测试集与CI/CD回归体系,保障版本迭代不退化、效果可对标; - 标准化众包\+专家人工审核流程,形成「自动评测\+人工校验」的完整评测闭环。 至此,AI Agent**原理、开发、实战、交互、评测**全链路技术体系全部闭环,具备从0到1开发、落地、上线、迭代工业级Agent产品的完整能力。