首页 文章 精选 留言 我的

精选列表

搜索[动态代码分析],共10000篇文章
优秀的个人博客,低调大师

20【在线日志分析】之记录一次Spark Streaming+Spark SQL的数据倾斜

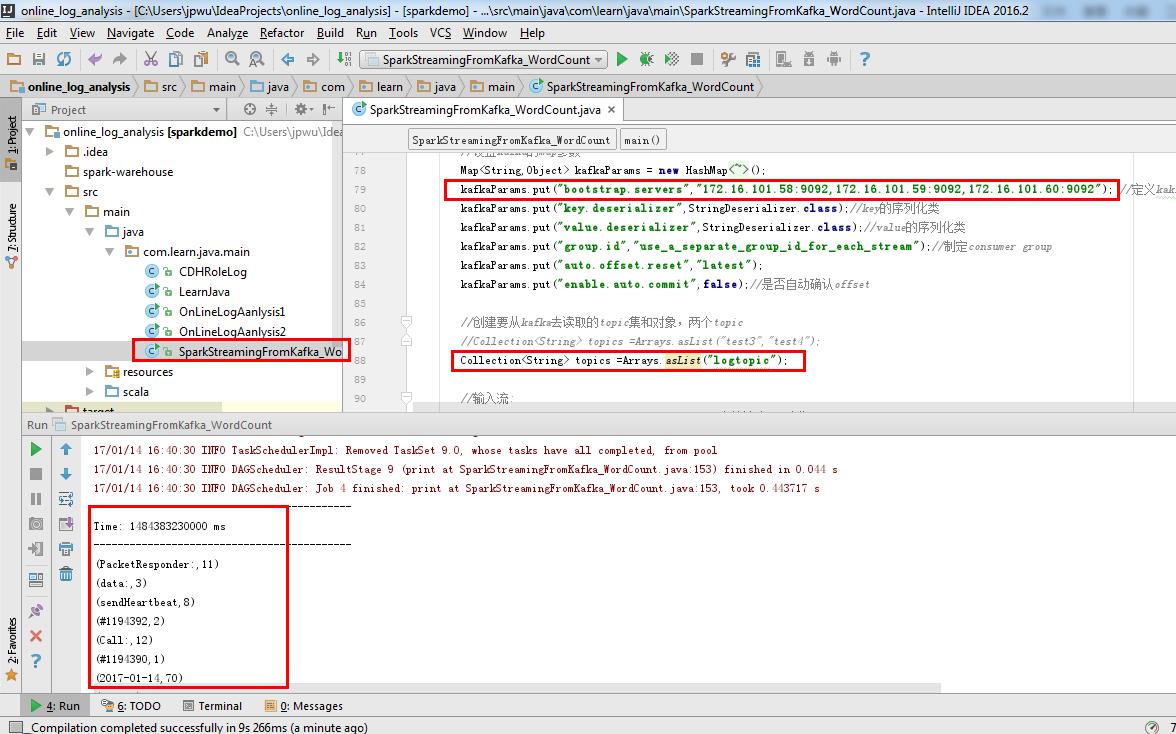
1.现象 三台机器都有产生executor,每台都会产生tasks,但是其中只有一台的task有input数据,其他机器的tasks都没有数据。 2.猜想 2.1是不是数据倾斜? 是 2.2是数据量过大,group by时,导致key分布不均? 比如key1 有98万,key2有2万,那么shuffle时,肯定数据倾斜。但是我刚开始数据量不是很大,所以pass (就算数据量大,也很简单处理,一般处理时key加上随机前缀数) 2.3是不是数据量太少 不够分区的? 也怀疑过,不过还没去验证 2.4 flume流到kafka,是snappy压缩格式,而spark作为kafka的消费者,虽然能够自动识别压缩格式,但是这种snappy格式不支持切分 也怀疑过,不过还没去修改支持spilt的压缩格式,也还没去验证 2.5 spark streaming分区数目是有谁决定的? 使用direct这种模式是由kafka的分区数目决定, 使用receiver这种模式由流的数目决定也就是由receiver数目决定。 3.修改分区数 [root@sht-sgmhadoopdn-02 kafka]#bin/kafka-topics.sh --alter --zookeeper 172.16.101.58:2181,172.16.101.59:2181,172.16.101.60:2181/kafka --topic logtopic --partitions 3 [root@sht-sgmhadoopdn-02 kafka]# bin/kafka-topics.sh --describe --zookeeper 172.16.101.58:2181,172.16.101.59:2181,172.16.101.60:2181/kafka --topic logtopic Topic:logtopic PartitionCount:3 ReplicationFactor:3 Configs: Topic: test Partition: 0 Leader: 3 Replicas: 3,1,2 Isr: 3,1,2 Topic: test Partition: 1 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Topic: test Partition: 2 Leader: 2 Replicas: 2,3,1 Isr: 2,3,1 [root@sht-sgmhadoopdn-02 kafka]#4.验证(每个executor都有input数据)

优秀的个人博客,低调大师

03【在线日志分析】之hadoop-2.7.3编译和搭建集群环境(HDFS HA,Yarn HA)

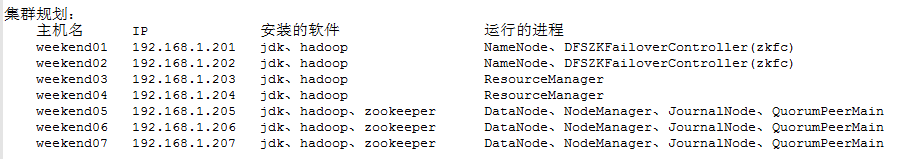
环境:CentOS6.5 1.下载hadoop2.7.3最新源码[root@sht-sgmhadoopnn-01 ~]# mkdir -p learnproject/compilesoft[root@sht-sgmhadoopnn-01 ~]# cd learnproject/compilesoft[root@sht-sgmhadoopnn-01 compilesoft]# wget http://www-eu.apache.org/dist/hadoop/common/hadoop-2.7.3/hadoop-2.7.3-src.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# tar -xzvf hadoop-2.7.3-src.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# cd hadoop-2.7.3-src[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cat BUILDING.txt Build instructions for Hadoop ----------------------------------------------------------------------------------Requirements: * Unix System* JDK 1.7+* Maven 3.0 or later* Findbugs 1.3.9 (if running findbugs)* ProtocolBuffer 2.5.0* CMake 2.6 or newer (if compiling native code), must be 3.0 or newer on Mac* Zlib devel (if compiling native code)* openssl devel ( if compiling native hadoop-pipes and to get the best HDFS encryption performance )* Linux FUSE (Filesystem in Userspace) version 2.6 or above ( if compiling fuse_dfs )* Internet connection for first build (to fetch all Maven and Hadoop dependencies)----------------------------------------------------------------------------------Installing required packages for clean install of Ubuntu 14.04 LTS Desktop: * Oracle JDK 1.7 (preferred) $ sudo apt-get purge openjdk* $ sudo apt-get install software-properties-common $ sudo add-apt-repository ppa:webupd8team/java $ sudo apt-get update $ sudo apt-get install oracle-java7-installer* Maven $ sudo apt-get -y install maven* Native libraries $ sudo apt-get -y install build-essential autoconf automake libtool cmake zlib1g-dev pkg-config libssl-dev* ProtocolBuffer 2.5.0 (required) $ sudo apt-get -y install libprotobuf-dev protobuf-compiler Optional packages: * Snappy compression $ sudo apt-get install snappy libsnappy-dev* Bzip2 $ sudo apt-get install bzip2 libbz2-dev* Jansson (C Library for JSON) $ sudo apt-get install libjansson-dev* Linux FUSE $ sudo apt-get install fuse libfuse-dev 2.安装依赖包[root@sht-sgmhadoopnn-01 compilesoft]# yum install svn autoconf automake libtool cmake ncurses-devel openssl-devel gcc* 3.安装jdk[root@sht-sgmhadoopnn-01 compilesoft]# vi /etc/profileexport JAVA_HOME=/usr/java/jdk1.7.0_67-clouderaexport PATH=$JAVA_HOME/bin:$PATH [root@sht-sgmhadoopnn-01 compilesoft]# source /etc/profile[root@sht-sgmhadoopnn-01 compilesoft]# java -versionjava version "1.7.0_67"Java(TM) SE Runtime Environment (build 1.7.0_67-b01)Java HotSpot(TM) 64-Bit Server VM (build 24.65-b04, mixed mode)You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 compilesoft]# 4.安装maven[root@sht-sgmhadoopnn-01 compilesoft]# wget http://ftp.cuhk.edu.hk/pub/packages/apache.org/maven/maven-3/3.3.9/binaries/apache-maven-3.3.9-bin.tar.gz -O apache-maven-3.3.9-bin.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# tar xvf apache-maven-3.3.9-bin.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# vi /etc/profile export JAVA_HOME=/usr/java/jdk1.7.0_67-clouderaexport MAVEN_HOME=/root/learnproject/compilesoft/apache-maven-3.3.9# 在编译过程中为了防止Java内存溢出,需要加入以下环境变量export MAVEN_OPTS="-Xmx2048m -XX:MaxPermSize=512m" export PATH=$MAVEN_HOME/bin:$JAVA_HOME/bin:$PATH [root@sht-sgmhadoopnn-01 compilesoft]# source /etc/profile[root@sht-sgmhadoopnn-01 compilesoft]# mvn -versionApache Maven 3.3.9 (bb52d8502b132ec0a5a3f4c09453c07478323dc5; 2015-11-11T00:41:47+08:00)Maven home: /root/learnproject/compilesoft/apache-maven-3.3.9Java version: 1.7.0_67, vendor: Oracle CorporationJava home: /usr/java/jdk1.7.0_67-cloudera/jreDefault locale: en_US, platform encoding: UTF-8OS name: "linux", version: "2.6.32-431.el6.x86_64", arch: "amd64", family: "unix"You have new mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 apache-maven-3.3.9]# 5.编译安装protobuf[root@sht-sgmhadoopnn-01 compilesoft]# wget ftp://ftp.netbsd.org/pub/pkgsrc/distfiles/protobuf-2.5.0.tar.gz -O protobuf-2.5.0.tar.gz[root@hadoop-01 compilesoft]# tar -zxvf protobuf-2.5.0.tar.gz[root@hadoop-01 compilesoft]# cd protobuf-2.5.0/[root@hadoop-01 protobuf-2.5.0]# ./configure [root@hadoop-01 protobuf-2.5.0]# make[root@hadoop-01 protobuf-2.5.0]# make install # 查看protobuf版本以测试是否安装成功[root@hadoop-01 protobuf-2.5.0]# protoc --versionprotoc: error while loading shared libraries: libprotobuf.so.8: cannot open shared object file: No such file or directory[root@hadoop-01 protobuf-2.5.0]# export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/lib[root@hadoop-01 protobuf-2.5.0]# protoc --versionlibprotoc 2.5.0[root@hadoop-01 protobuf-2.5.0]# 6.安装snappy[root@sht-sgmhadoopnn-01 compilesoft]# wget http://pkgs.fedoraproject.org/repo/pkgs/snappy/snappy-1.1.1.tar.gz/8887e3b7253b22a31f5486bca3cbc1c2/snappy-1.1.1.tar.gz# 用root用户执行以下命令[root@sht-sgmhadoopnn-01 compilesoft]#tar -zxvf snappy-1.1.1.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# cd snappy-1.1.1/[root@sht-sgmhadoopnn-01 snappy-1.1.1]# ./configure[root@sht-sgmhadoopnn-01 snappy-1.1.1]# make[root@sht-sgmhadoopnn-01 snappy-1.1.1]# make install #查看snappy库文件[root@sht-sgmhadoopnn-01 snappy-1.1.1]# ls -lh /usr/local/lib |grep snappy-rw-r--r-- 1 root root 229K Jun 21 15:46 libsnappy.a-rwxr-xr-x 1 root root 953 Jun 21 15:46 libsnappy.lalrwxrwxrwx 1 root root 18 Jun 21 15:46 libsnappy.so -> libsnappy.so.1.2.0lrwxrwxrwx 1 root root 18 Jun 21 15:46 libsnappy.so.1 -> libsnappy.so.1.2.0-rwxr-xr-x 1 root root 145K Jun 21 15:46 libsnappy.so.1.2.0[root@sht-sgmhadoopnn-01 snappy-1.1.1]# 7.编译[root@sht-sgmhadoopnn-01 compilesoft]# cd hadoop-2.7.3-src mvn clean package -Pdist,native -DskipTests -Dtar或mvn package -Pdist,native -DskipTests -Dtar [root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# mvn clean package –Pdist,native –DskipTests –Dtar[INFO] Executing tasksmain: [exec] $ tar cf hadoop-2.7.3.tar hadoop-2.7.3 [exec] $ gzip -f hadoop-2.7.3.tar [exec] [exec] Hadoop dist tar available at: /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-2.7.3.tar.gz [exec] [INFO] Executed tasks[INFO] [INFO] --- maven-javadoc-plugin:2.8.1:jar (module-javadocs) @ hadoop-dist ---[INFO] Building jar: /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-dist-2.7.3-javadoc.jar[INFO] ------------------------------------------------------------------------[INFO] Reactor Summary:[INFO] [INFO] Apache Hadoop Main ................................. SUCCESS [ 14.707 s][INFO] Apache Hadoop Build Tools .......................... SUCCESS [ 6.832 s][INFO] Apache Hadoop Project POM .......................... SUCCESS [ 12.989 s][INFO] Apache Hadoop Annotations .......................... SUCCESS [ 14.258 s][INFO] Apache Hadoop Assemblies ........................... SUCCESS [ 0.411 s][INFO] Apache Hadoop Project Dist POM ..................... SUCCESS [ 4.814 s][INFO] Apache Hadoop Maven Plugins ........................ SUCCESS [ 23.566 s][INFO] Apache Hadoop MiniKDC .............................. SUCCESS [02:31 min][INFO] Apache Hadoop Auth ................................. SUCCESS [ 29.587 s][INFO] Apache Hadoop Auth Examples ........................ SUCCESS [ 13.954 s][INFO] Apache Hadoop Common ............................... SUCCESS [03:03 min][INFO] Apache Hadoop NFS .................................. SUCCESS [ 9.285 s][INFO] Apache Hadoop KMS .................................. SUCCESS [ 45.068 s][INFO] Apache Hadoop Common Project ....................... SUCCESS [ 0.049 s][INFO] Apache Hadoop HDFS ................................. SUCCESS [03:49 min][INFO] Apache Hadoop HttpFS ............................... SUCCESS [01:08 min][INFO] Apache Hadoop HDFS BookKeeper Journal .............. SUCCESS [ 28.935 s][INFO] Apache Hadoop HDFS-NFS ............................. SUCCESS [ 4.599 s][INFO] Apache Hadoop HDFS Project ......................... SUCCESS [ 0.044 s][INFO] hadoop-yarn ........................................ SUCCESS [ 0.043 s][INFO] hadoop-yarn-api .................................... SUCCESS [02:49 min][INFO] hadoop-yarn-common ................................. SUCCESS [ 40.792 s][INFO] hadoop-yarn-server ................................. SUCCESS [ 0.041 s][INFO] hadoop-yarn-server-common .......................... SUCCESS [ 15.750 s][INFO] hadoop-yarn-server-nodemanager ..................... SUCCESS [ 25.311 s][INFO] hadoop-yarn-server-web-proxy ....................... SUCCESS [ 6.415 s][INFO] hadoop-yarn-server-applicationhistoryservice ....... SUCCESS [ 12.274 s][INFO] hadoop-yarn-server-resourcemanager ................. SUCCESS [ 27.555 s][INFO] hadoop-yarn-server-tests ........................... SUCCESS [ 7.751 s][INFO] hadoop-yarn-client ................................. SUCCESS [ 11.347 s][INFO] hadoop-yarn-server-sharedcachemanager .............. SUCCESS [ 5.612 s][INFO] hadoop-yarn-applications ........................... SUCCESS [ 0.038 s][INFO] hadoop-yarn-applications-distributedshell .......... SUCCESS [ 4.029 s][INFO] hadoop-yarn-applications-unmanaged-am-launcher ..... SUCCESS [ 2.611 s][INFO] hadoop-yarn-site ................................... SUCCESS [ 0.077 s][INFO] hadoop-yarn-registry ............................... SUCCESS [ 8.045 s][INFO] hadoop-yarn-project ................................ SUCCESS [ 5.456 s][INFO] hadoop-mapreduce-client ............................ SUCCESS [ 0.226 s][INFO] hadoop-mapreduce-client-core ....................... SUCCESS [ 28.462 s][INFO] hadoop-mapreduce-client-common ..................... SUCCESS [ 25.872 s][INFO] hadoop-mapreduce-client-shuffle .................... SUCCESS [ 6.697 s][INFO] hadoop-mapreduce-client-app ........................ SUCCESS [ 14.121 s][INFO] hadoop-mapreduce-client-hs ......................... SUCCESS [ 9.328 s][INFO] hadoop-mapreduce-client-jobclient .................. SUCCESS [ 23.801 s][INFO] hadoop-mapreduce-client-hs-plugins ................. SUCCESS [ 2.412 s][INFO] Apache Hadoop MapReduce Examples ................... SUCCESS [ 8.876 s][INFO] hadoop-mapreduce ................................... SUCCESS [ 4.237 s][INFO] Apache Hadoop MapReduce Streaming .................. SUCCESS [ 14.285 s][INFO] Apache Hadoop Distributed Copy ..................... SUCCESS [ 19.759 s][INFO] Apache Hadoop Archives ............................. SUCCESS [ 3.069 s][INFO] Apache Hadoop Rumen ................................ SUCCESS [ 7.446 s][INFO] Apache Hadoop Gridmix .............................. SUCCESS [ 5.765 s][INFO] Apache Hadoop Data Join ............................ SUCCESS [ 3.752 s][INFO] Apache Hadoop Ant Tasks ............................ SUCCESS [ 2.771 s][INFO] Apache Hadoop Extras ............................... SUCCESS [ 5.612 s][INFO] Apache Hadoop Pipes ................................ SUCCESS [ 10.332 s][INFO] Apache Hadoop OpenStack support .................... SUCCESS [ 7.131 s][INFO] Apache Hadoop Amazon Web Services support .......... SUCCESS [01:32 min][INFO] Apache Hadoop Azure support ........................ SUCCESS [ 10.622 s][INFO] Apache Hadoop Client ............................... SUCCESS [ 12.540 s][INFO] Apache Hadoop Mini-Cluster ......................... SUCCESS [ 1.142 s][INFO] Apache Hadoop Scheduler Load Simulator ............. SUCCESS [ 7.354 s][INFO] Apache Hadoop Tools Dist ........................... SUCCESS [ 12.269 s][INFO] Apache Hadoop Tools ................................ SUCCESS [ 0.035 s][INFO] Apache Hadoop Distribution ......................... SUCCESS [ 58.051 s][INFO] ------------------------------------------------------------------------[INFO] BUILD SUCCESS[INFO] ------------------------------------------------------------------------[INFO] Total time: 26:29 min[INFO] Finished at: 2016-12-24T21:07:09+08:00[INFO] Final Memory: 214M/740M[INFO] ------------------------------------------------------------------------You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# [root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cp /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-2.7.3.tar.gz ../../You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cd ../../[root@sht-sgmhadoopnn-01 learnproject]# lltotal 193152drwxr-xr-x 5 root root 4096 Dec 24 20:24 compilesoft-rw-r--r-- 1 root root 197782815 Dec 24 21:16 hadoop-2.7.3.tar.gz[root@sht-sgmhadoopnn-01 learnproject]# 8.搭建HDFS HA,YARN HA集群(5个节点)参考:http://blog.itpub.net/30089851/viewspace-1994585/https://github.com/Hackeruncle/Hadoop 9.搭建集群,验证版本和支持的压缩信息[root@sht-sgmhadoopnn-01 app]# hadoop versionHadoop 2.7.3Subversion Unknown -r UnknownCompiled by root on 2016-12-24T12:45ZCompiled with protoc 2.5.0From source with checksum 2e4ce5f957ea4db193bce3734ff29ff4This command was run using /root/learnproject/app/hadoop/share/hadoop/common/hadoop-common-2.7.3.jar[root@sht-sgmhadoopnn-01 app]# hadoop checknative16/12/25 15:55:43 INFO bzip2.Bzip2Factory: Successfully loaded & initialized native-bzip2 library system-native16/12/25 15:55:43 INFO zlib.ZlibFactory: Successfully loaded & initialized native-zlib libraryNative library checking:hadoop: true /root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0zlib: true /lib64/libz.so.1snappy: true /usr/local/lib/libsnappy.so.1lz4: true revision:99bzip2: true /lib64/libbz2.so.1openssl: true /usr/lib64/libcrypto.so[root@sht-sgmhadoopnn-01 app]# file /root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0/root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0: ELF 64-bit LSB shared object, x86-64, version 1 (SYSV), dynamically linked, not stripped[root@sht-sgmhadoopnn-01 app]# 【参考】:http://happyshome.cn/blog/deploy/centos/hadoop2.7.2.htmlhttp://blog.csdn.net/haohaixingyun/article/details/52800048

优秀的个人博客,低调大师

《高可用云架构实战与混合云项目分析》大型选题火热进行中!

【1123更新】社区将联合更多伙伴进行年度CTO评选,《高可用云架构实战与混合云项目总结》将合并到新的选题中。已参加本选题的朋友们,我们组建了钉组,同步升级。有建议欢迎留言或邮件,谢谢。 云计算、大数据、人工智能、物联网等技术在持续深入,企业业务场景和系统架构也越加复杂,很多伙伴反馈:希望组建一个实时交流的钉钉小组,或一场彼此经验分享的在线技术峰会,也可以是一场深入讨论的线下闭门聚会,最好是一个可以保持紧密联系并沉淀交流的平台,来共同深入讨论云上的高可用实战经验,架构优化方案,以及遇到棘手(特殊)问题时的最优解法。 于是有了这期将跨越2016-17年,包括:征集、采访、直播、在线峰会、特刊以及线下会议等在内的大型选题——2016云栖社区年度盛典之《高可用云架构实战与混合云项目总结》(报名链接)。我们相信:只有互相帮助,才能帮助更多伙伴

优秀的个人博客,低调大师

MapReduce源码分析之Task中关于对应TaskAttempt存储Map方案的一些思考

我们知道,MapReduce有三层调度模型,即Job——>Task——>TaskAttempt,并且: 1、通常一个Job存在多个Task,这些Task总共有Map Task和Redcue Task两种大的类型(为简化描述,Map-Only作业、JobSetup Task等复杂的情况这里不做考虑); 2、每个Task可以尝试运行1-n此,而且通常很多情况下都是1次,只有当开启了推测执行原理且存在拖后腿Task,或者Task之前执行失败时,Task才执行多次。 而TaskImpl中存在一个成员变量attempts,用来存储Task所包含TaskAttempt中TaskAttemptId与TaskAttempt的映射关系,定义及初始化如下: private Map<TaskAttemptId, TaskAttempt> attempts; this.attempts = Collections.emptyMap(); 也就是说,attempts一开始被初始化为Collections.emptyMap(),我们看下其实现: @SuppressWarnings("unchecked") public static final <K,V> Map<K,V> emptyMap() { return (Map<K,V>) EMPTY_MAP; } @SuppressWarnings("unchecked") public static final Map EMPTY_MAP = new EmptyMap<>(); /** * @serial include */ private static class EmptyMap<K,V> extends AbstractMap<K,V> implements Serializable { private static final long serialVersionUID = 6428348081105594320L; public int size() {return 0;} public boolean isEmpty() {return true;} public boolean containsKey(Object key) {return false;} public boolean containsValue(Object value) {return false;} public V get(Object key) {return null;} public Set<K> keySet() {return emptySet();} public Collection<V> values() {return emptySet();} public Set<Map.Entry<K,V>> entrySet() {return emptySet();} public boolean equals(Object o) { return (o instanceof Map) && ((Map<?,?>)o).isEmpty(); } public int hashCode() {return 0;} // Preserves singleton property private Object readResolve() { return EMPTY_MAP; } } 可以看出,EmptyMap就是一个空的Map,大小为0,isEmpty为true,containsKey和containsValue等针对任何key或value均为false。 而在生成TaskAttempt后将其添加至attempts的逻辑如下: // 将创建的任务运行尝试TaskAttemptImpl实例attempt与其ID的对应关系添加到TaskImpl的任务运行尝试集合attempts中, // attempts先被初始化为Collections.emptyMap() // this.attempts = Collections.emptyMap(); switch (attempts.size()) { case 0: // 如果attempts大小为0,即为Collections.emptyMap(),则将其更换为Collections.singletonMap(),并加入该TaskAttemptImpl实例attempt attempts = Collections.singletonMap(attempt.getID(), (TaskAttempt) attempt); break; case 1: // 如果attempts大小为1,即为Collections.singletonMap(),则将其替换为LinkedHashMap,并加入之前和现在的TaskAttemptImpl实例attempt Map<TaskAttemptId, TaskAttempt> newAttempts = new LinkedHashMap<TaskAttemptId, TaskAttempt>(maxAttempts); newAttempts.putAll(attempts); attempts = newAttempts; attempts.put(attempt.getID(), attempt); break; default: // 如果attempts大小大于1,说明其实一个LinkedHashMap,直接put吧 attempts.put(attempt.getID(), attempt); break; } 当Task第一次生成TaskAttempt,并将其加入attempts时,attempts为Collections.emptyMap(),其大小肯定为0,此时将TaskAttempt加入attempts时,会将attempts转换成Collections.singletonMap,即只含有一个Key-Value对的Map。而Collections.singletonMap定义如下: public static <K,V> Map<K,V> singletonMap(K key, V value) { return new SingletonMap<>(key, value); } private static class SingletonMap<K,V> extends AbstractMap<K,V> implements Serializable { private static final long serialVersionUID = -6979724477215052911L; private final K k; private final V v; SingletonMap(K key, V value) { k = key; v = value; } public int size() {return 1;} public boolean isEmpty() {return false;} public boolean containsKey(Object key) {return eq(key, k);} public boolean containsValue(Object value) {return eq(value, v);} public V get(Object key) {return (eq(key, k) ? v : null);} private transient Set<K> keySet = null; private transient Set<Map.Entry<K,V>> entrySet = null; private transient Collection<V> values = null; public Set<K> keySet() { if (keySet==null) keySet = singleton(k); return keySet; } public Set<Map.Entry<K,V>> entrySet() { if (entrySet==null) entrySet = Collections.<Map.Entry<K,V>>singleton( new SimpleImmutableEntry<>(k, v)); return entrySet; } public Collection<V> values() { if (values==null) values = singleton(v); return values; } } 由此可以看出,SingletonMap是只包含一对Key-Value的Map,其size大小固定为1,containsKey和containsValue返回入参key、value是否与SingletonMap内部的k、v相等,get会根据入参是否为k,来确定返回v还是null,等等。 而当attempts大小为1,即为Collections.singletonMap时,再添加TaskAttempt的话,就需要将attempts更换为LinkedHashMap,将之前的和新添加的TaskAttempt加入,此后,如果再有TaskAttempt要加入的话,直接put即可。LinkedHashMap初始化时,其容量已被确定,为maxAttempts,这个maxAttempts取自方法getMaxAttempts(),它在TaskImpl中是一个抽象方法,由其两个子类MapTaskImpl、ReduceTaskImpl分别实现,如下: TaskImpl.java // No override of this method may require that the subclass be initialized. protected abstract int getMaxAttempts(); MapTaskImpl.java @Override protected int getMaxAttempts() { return conf.getInt(MRJobConfig.MAP_MAX_ATTEMPTS, 4); } ReduceTaskImpl.java @Override protected int getMaxAttempts() { return conf.getInt(MRJobConfig.REDUCE_MAX_ATTEMPTS, 4); } 可见,Map和Reduce任务的TaskAttempt都有一个限制,分别取自参数mapreduce.map.maxattempts、mapreduce.reduce.maxattempts,参数未配置的话,均默认为4。既然有了TaskAttempt个数的上限,那么我们初始化LinkedHashMap指定容量即可,其构造如下: /** * Constructs an empty insertion-ordered <tt>LinkedHashMap</tt> instance * with the specified initial capacity and a default load factor (0.75). * * @param initialCapacity the initial capacity * @throws IllegalArgumentException if the initial capacity is negative */ public LinkedHashMap(int initialCapacity) { super(initialCapacity); accessOrder = false; } 调用父类HashMap的构造函数,如下: /** * Constructs an empty <tt>HashMap</tt> with the specified initial * capacity and the default load factor (0.75). * * @param initialCapacity the initial capacity. * @throws IllegalArgumentException if the initial capacity is negative. */ public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } 确定其初始容量为指定的initialCapacity。 思考: MapReduce为什么要这么设计呢?我想了想,大体有关于业务逻辑和性能等方面的两个原因: 1、Task的调度执行是有顺序的,而Task的抽象类TaskImpl的实现类,无论是MapTaskImpl,还是ReduceTaskImpl的构造,都是必须先进行的,这样就有一个问题,如果attempts上来就被构造为指定大小的LinkedHashMap,势必会造成空间的浪费,还有性能的消耗,况且,作业执行成功与否,还是后话,而如果我们初始化为Collections.emptyMap(),则很容易解决上面两个问题; 2、按照常理来说,理想情况下,每个Task应该有且只有一个TaskAttempt,只有当任务运行失败后重试,或开启推测执行机制后为有效加快拖后腿任务的执行而开启的备份任务等情况时,才会存在多个TaskAttempt,而在第一个TaskAttempt被构造时,将attempts由Collections.emptyMap()升级为Collections.singletonMap(),无论是在空间利用、性能上,还是业务逻辑上,都比较贴合实际情况; 3、再需要重试任务或开启备份任务时,才将attempts由Collections.singletonMap()升级为指定容量的LinkedHashMap,里面有延迟加载的理念; 4、占用资源越少,性能越高,对于其他作业或任务来说,是一种福音,能够整体提高集群的资源利用效率。 上述性能和业务逻辑方面的考虑,您或许不以为然,可能觉得性能提升不大,但是如果在大规模集群中,当作业数量庞大、任务数目数量庞大时,这种优势就愈发明显,而它带来的好处,于已,于别的作业来说,都会是一种福音!这种设计上的细节,值得我们学习、借鉴与反思!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册