首页 文章 精选 留言 我的

精选列表

搜索[镜像构建工具],共10000篇文章
优秀的个人博客,低调大师

基于Web的Kafka管理器工具之Kafka-manager启动时出现Exception in thread "main" java.lan...

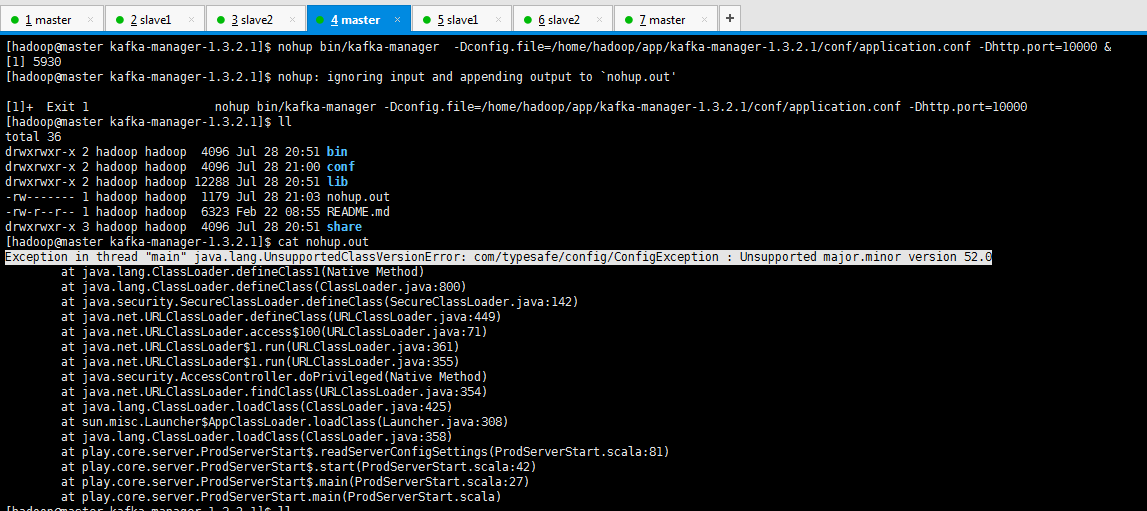
问题详情 我在Kafka-manager启动时出现 [hadoop@master kafka-manager-1.3.2.1]$ nohup bin/kafka-manager -Dconfig.file=/home/hadoop/app/kafka-manager-1.3.2.1/conf/application.conf -Dhttp.port=10000 & [1] 5930 [hadoop@master kafka-manager-1.3.2.1]$ nohup: ignoring input and appending output to `nohup.out' [1]+ Exit 1 nohup bin/kafka-manager -Dconfig.file=/home/hadoop/app/kafka-manager-1.3.2.1/conf/application.conf -Dhttp.port=10000 [hadoop@master kafka-manager-1.3.2.1]$ ll total 36 drwxrwxr-x 2 hadoop hadoop 4096 Jul 28 20:51 bin drwxrwxr-x 2 hadoop hadoop 4096 Jul 28 21:00 conf drwxrwxr-x 2 hadoop hadoop 12288 Jul 28 20:51 lib -rw------- 1 hadoop hadoop 1179 Jul 28 21:03 nohup.out -rw-r--r-- 1 hadoop hadoop 6323 Feb 22 08:55 README.md drwxrwxr-x 3 hadoop hadoop 4096 Jul 28 20:51 share [hadoop@master kafka-manager-1.3.2.1]$ cat nohup.out Exception in thread "main" java.lang.UnsupportedClassVersionError: com/typesafe/config/ConfigException : Unsupported major.minor version 52.0 at java.lang.ClassLoader.defineClass1(Native Method) at java.lang.ClassLoader.defineClass(ClassLoader.java:800) at java.security.SecureClassLoader.defineClass(SecureClassLoader.java:142) at java.net.URLClassLoader.defineClass(URLClassLoader.java:449) at java.net.URLClassLoader.access$100(URLClassLoader.java:71) at java.net.URLClassLoader$1.run(URLClassLoader.java:361) at java.net.URLClassLoader$1.run(URLClassLoader.java:355) at java.security.AccessController.doPrivileged(Native Method) at java.net.URLClassLoader.findClass(URLClassLoader.java:354) at java.lang.ClassLoader.loadClass(ClassLoader.java:425) at sun.misc.Launcher$AppClassLoader.loadClass(Launcher.java:308) at java.lang.ClassLoader.loadClass(ClassLoader.java:358) at play.core.server.ProdServerStart$.readServerConfigSettings(ProdServerStart.scala:81) at play.core.server.ProdServerStart$.start(ProdServerStart.scala:42) at play.core.server.ProdServerStart$.main(ProdServerStart.scala:27) at play.core.server.ProdServerStart.main(ProdServerStart.scala) [hadoop@master kafka-manager-1.3.2.1]$ ll 解决办法 若大家,还不会建立软连接,则见我下面的博客 大数据各子项目的环境搭建之建立与删除软连接(博主推荐) drwxrwxr-x. 8 hadoop hadoop 4096 Jul 26 08:14 hive-1.0.0 lrwxrwxrwx. 1 hadoop hadoop 11 Apr 12 10:18 jdk -> jdk1.7.0_79 drwxr-xr-x. 8 hadoop hadoop 4096 Apr 11 2015 jdk1.7.0_79 drwxr-xr-x. 8 hadoop hadoop 4096 Aug 5 2015 jdk1.8.0_60 lrwxrwxrwx 1 hadoop hadoop 19 Jul 27 17:27 kafka -> kafka_2.10-0.9.0.1/ drwxr-xr-x 7 hadoop hadoop 4096 Jul 28 19:55 kafka_2.10-0.9.0.1 drwxr-xr-x 6 hadoop hadoop 4096 May 3 22:01 kafka_2.11-0.8.2.2 drwxrwxr-x 6 hadoop hadoop 4096 Jul 28 21:03 kafka-manager-1.3.2.1 lrwxrwxrwx 1 hadoop hadoop 26 Apr 21 22:18 kibana -> kibana-4.6.3-linux-x86_64/ drwxrwxr-x 11 hadoop hadoop 4096 Nov 4 2016 kibana-4.6.3-linux-x86_64 lrwxrwxrwx 1 hadoop hadoop 37 Jul 3 22:18 phoenix -> apache-phoenix-4.10.0-HBase-0.98-bin/ lrwxrwxrwx 1 hadoop hadoop 13 Jun 8 09:44 scala -> scala-2.11.8/ drwxrwxr-x 9 hadoop hadoop 4096 Feb 27 2015 scala-2.10.5 drwxrwxr-x 6 hadoop hadoop 4096 Mar 4 2016 scala-2.11.8 lrwxrwxrwx 1 hadoop hadoop 12 May 1 19:35 snappy -> snappy-1.1.3 drwxr-xr-x 6 hadoop hadoop 4096 May 1 19:40 snappy-1.1.3 lrwxrwxrwx 1 hadoop hadoop 26 Jun 8 00:39 spark -> spark-1.6.1-bin-hadoop2.6/ drwxr-xr-x 12 hadoop hadoop 4096 Feb 27 2016 spark-1.6.1-bin-hadoop2.6 lrwxrwxrwx. 1 hadoop hadoop 11 Apr 12 11:28 sqoop -> sqoop-1.4.6 drwxr-xr-x. 9 hadoop hadoop 4096 May 19 10:31 sqoop-1.4.6 lrwxrwxrwx 1 hadoop hadoop 19 May 21 17:21 storm -> apache-storm-1.0.2/ lrwxrwxrwx 1 hadoop hadoop 34 Jun 8 11:20 zeppelin -> zeppelin-0.5.6-incubating-bin-all/ drwxr-xr-x 11 hadoop hadoop 4096 Jun 8 11:33 zeppelin-0.5.6-incubating-bin-all lrwxrwxrwx. 1 hadoop hadoop 15 Apr 12 11:28 zookeeper -> zookeeper-3.4.6 drwxr-xr-x. 10 hadoop hadoop 4096 Apr 12 17:13 zookeeper-3.4.6 [hadoop@master app]$ rm -rf jdk [hadoop@master app]$ ln -s jdk1.8.0_60/ jdk [hadoop@master app]$ 然后,再次打开,即可 http://192.168.80.145:10000/ 或者 http://master:10000/ 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/7252702.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

一脸懵逼学习Hive的安装(将sql语句翻译成MapReduce程序的一个工具)

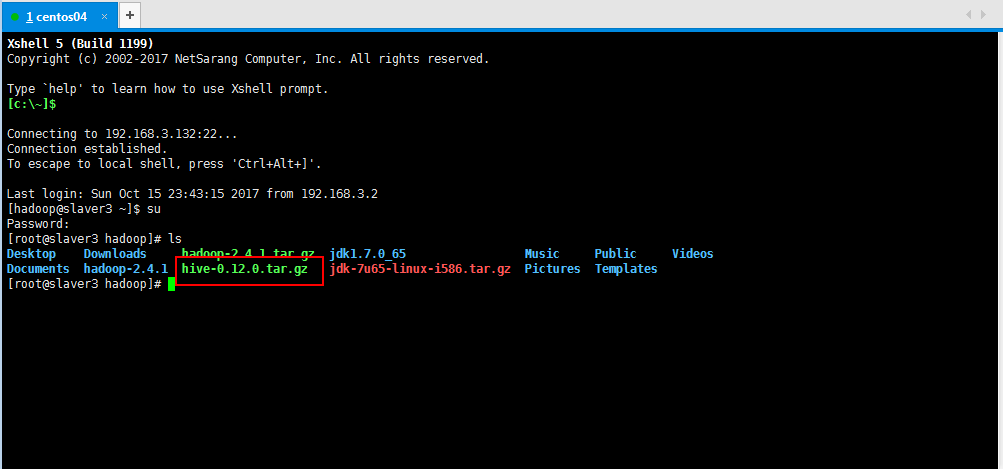
Hive只在一个节点上安装即可: 1.上传tar包:这个上传就不贴图了,贴一下上传后的,看一下虚拟机吧: 2.解压操作: [root@slaver3 hadoop]# tar -zxvf hive-0.12.0.tar.gz 解压后贴一下图: 3:解压缩以后启动一下hive: 4:开始操作sql: 好吧,开始没有启动集群,输入mysql创建数据库命令,直接不屌我,我也是苦苦等待啊; 5:启动我的集群,如下所示,这里最后帖一遍部署以后集群关了,重新开启集群的步骤,不能按照部署集群的时候进行格式化一些操作,如下所示: 第一先:启动zookeeper集群(分别在master、slaver1、slaver2上启动zookeeker) 第二步:启动journalnode(分别在master、slaver1、slaver2上启动): 运行jps命令检验,master、slaver1、slaver2上多了JournalNode进程; 第三步:启动HDFS(在slaver3上执行): 第四步:启动YARN(#####注意#####:是在weekend03上执行start-yarn.sh,把namenode和resourcemanager分开是因为性能问题,因为他们都要占用大量资源,所以把他们分开了,他们分开了就要分别在不同的机器上启动) 6:然后操作hive,开始居然还报错了,对于一个小白来说,每一个错都是刻骨铭心啊,下面贴一下错误,也许能帮助到他人; 错误如下所示: hive> create database user; FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.DDLTask. MetaException(message:Got exception: org.apache.hadoop.ipc.RemoteException org.apache.hadoop.hdfs.server.namenode.SafeModeException: Cannot create directory /user/hive/warehouse/user.db. Name node is in safe mode. The reported blocks 0 needs additional 27 blocks to reach the threshold 0.9990 of total blocks 27. The number of live datanodes 0 has reached the minimum number 0. Safe mode will be turned off automatically once the thresholds have been reached. at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.checkNameNodeSafeMode(FSNamesystem.java:1211) at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirsInt(FSNamesystem.java:3590) at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirs(FSNamesystem.java:3566) at org.apache.hadoop.hdfs.server.namenode.NameNodeRpcServer.mkdirs(NameNodeRpcServer.java:754) at org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolServerSideTranslatorPB.mkdirs(ClientNamenodeProtocolServerSideTranslatorPB.java:558) at org.apache.hadoop.hdfs.protocol.proto.ClientNamenodeProtocolProtos$ClientNamenodeProtocol$2.callBlockingMethod(ClientNamenodeProtocolProtos.java) at org.apache.hadoop.ipc.ProtobufRpcEngine$Server$ProtoBufRpcInvoker.call(ProtobufRpcEngine.java:585) at org.apache.hadoop.ipc.RPC$Server.call(RPC.java:928) at org.apache.hadoop.ipc.Server$Handler$1.run(Server.java:2013) at org.apache.hadoop.ipc.Server$Handler$1.run(Server.java:2009) at java.security.AccessController.doPrivileged(Native Method) at javax.security.auth.Subject.doAs(Subject.java:415) at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1556) at org.apache.hadoop.ipc.Server$Handler.run(Server.java:2007) Caused by: org.apache.hadoop.hdfs.server.namenode.SafeModeException: Cannot create directory /user/hive/warehouse/user.db. Name node is in safe mode. The reported blocks 0 needs additional 27 blocks to reach the threshold 0.9990 of total blocks 27. The number of live datanodes 0 has reached the minimum number 0. Safe mode will be turned off automatically once the thresholds have been reached. at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.checkNameNodeSafeMode(FSNamesystem.java:1207) ... 13 more ) 然后百度了一下,大眼一瞄,可能是防火墙的原因,先关防火墙,先从这种解决问题的方向为入口,不然都是大问题了,然后七台机器的防火墙都关了: 然后就可以了,具体的HIVE学习,待慢慢深学,至少现在入门了; 6:可以将hive配置环境变量,这样就可以在任何位置启动它了,不用每次都要切换到hive的目录了: 7:启动好hive可以查看数据库(show databases;),创建数据库(create database test;),删除数据库(drop database test;),使用数据库(use test;),创建数据表(create table tb_user(id int,name string);),将数据传输到hadoop分布式集群上面: 创建vim tb_user文件,写上几行数据: 然后将测试数据上传到集群上面:[root@master data_hadoop]# hadoop fs -put tb_user /user/hive/warehouse/test.db/tb_user可以在浏览器查看到已经上传成功了: 下面可以使用hive命令进行查询操作: 由于上传数据格式的差异化,这里查询需要注意对数据进行定义数据格式;不然无法解析 hive> select * from tb_user; OK NULL NULL NULL NULL NULL NULL NULL NULL NULL NULL Time taken: 5.338 seconds, Fetched: 5 row(s) hive> 清空一张表(清空以后还可以继续进行查询,看看是否清空即可):hive> truncate table tb_user; 详细hive的学习见下篇博客,完结; 待续......

优秀的个人博客,低调大师

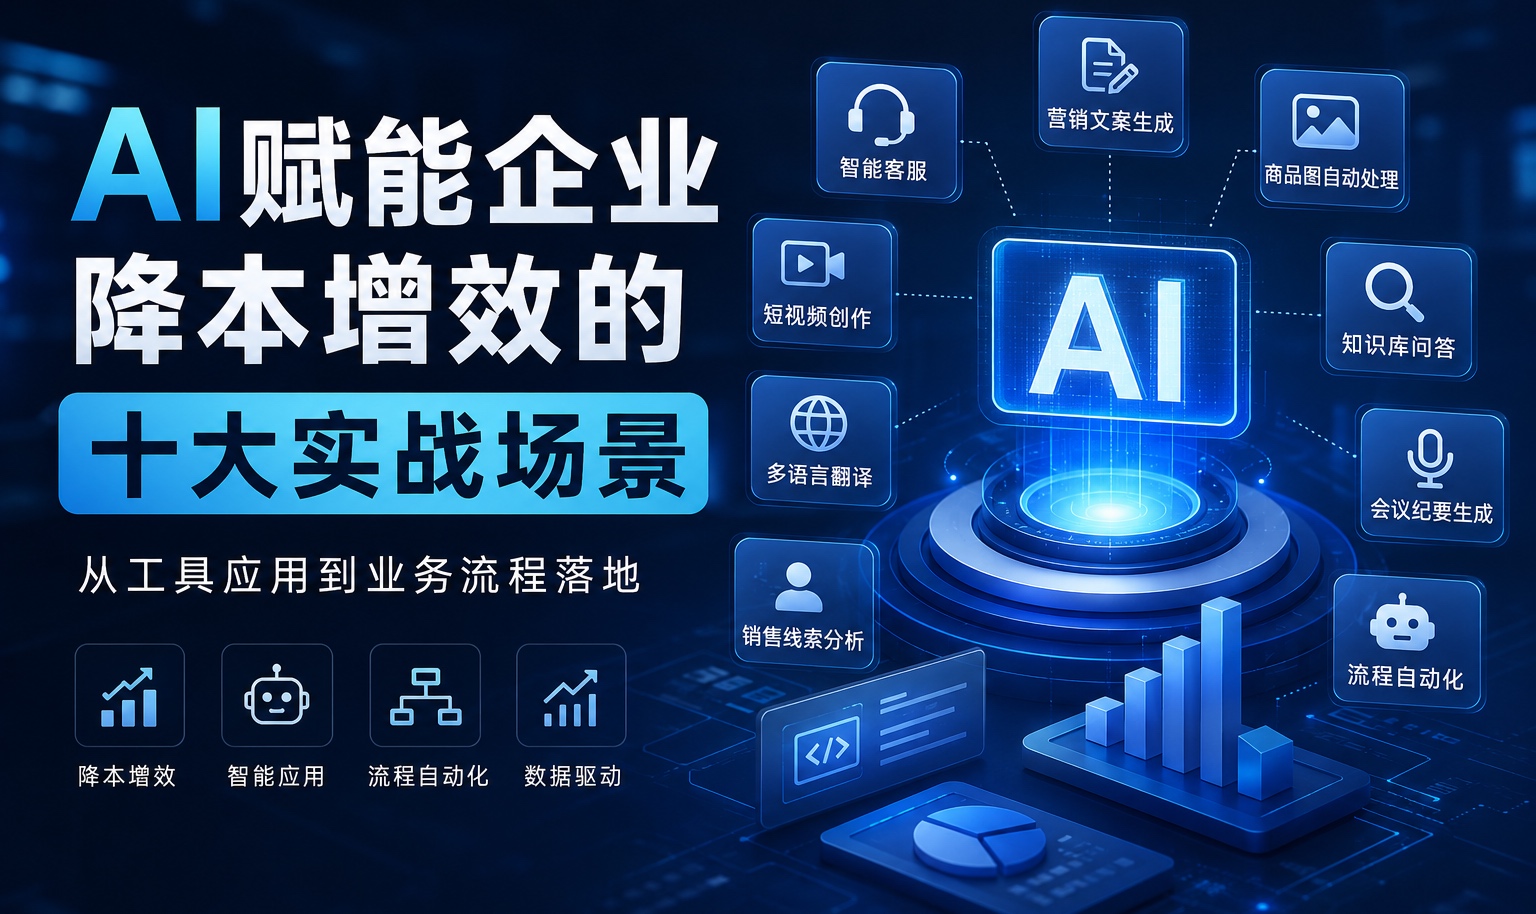
AI赋能企业降本增效的十大实战场景:从工具应用到业务流程落地

摘要: 本文围绕“AI如何真正帮企业降本增效”展开,指出AI落地的关键在于从具体业务环节切入,而非追求复杂平台。文章拆解了智能客服、营销文案、电商商品图、企业知识库、会议纪要、代码辅助、短视频内容、销售线索、多语言翻译、业务流程自动化共10个适合AI落地的场景,并强调每个场景都应遵循“AI处理标准化工作、人工负责复杂判断与审核”的协作模式。最后提出企业落地AI的路径:先找痛点、再选场景、建立指标、小范围试点、验证ROI,再规模化推广,核心是找到高频、刚需、可量化、能快速验证ROI的业务环节。

优秀的个人博客,低调大师

WorkBuddy 企业版套件化升级,一个酒店人聊聊:酒店的"工具孤岛"怎么一锅端

9 月 23 日,腾讯 WorkBuddy 企业版发布套件化升级最新进展:腾讯文档、腾讯乐享、腾讯网盘、安全与效能运营平台,以及腾讯 AI 设计智能体 Ardot 首批接入。企业按原价格订阅,就能统一使用这套办公能力,并进一步打通账号、积分、记忆与数据体系——一个订阅、一个 Agent 底座、一个管理后台。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册