首页 文章 精选 留言 我的

精选列表

搜索[TDP云声计划],共10000篇文章
优秀的个人博客,低调大师

解密Elasticsearch:深入探究这款搜索和分析引擎 | 京东云技术团队

作者:京东保险管顺利 开篇 最近使用Elasticsearch实现画像系统,实现的dmp的数据中台能力。同时调研了竞品的架构选型。以及重温了redis原理等。特此做一次es的总结和回顾。网上没看到有人用Elasticsearch来完成画像的。我来做第一次尝试。 背景说完,我们先思考一件事,使用内存系统做数据库。他的优点是什么?他的痛点是什么? 一、原理 这里不在阐述全貌。只聊聊通讯、内存、持久化三部分。 通讯 es集群最小单元是三个节点。两个从节点搭配保证其高可用也是集群化的基础。那么节点之间RPC通讯用的是什么?必然是netty,es基于netty实现了Netty4Transport的通讯包。初始化Transport后建立Bootstrap,通过MessageChannelHandler完成接收和转发。es里区分server和client,如图1。序列化使用的json。es在rpc设计上偏向于易用、通用、易理解。而不是单追求性能。 图1 有了netty的保驾护航使得es放心是使用json序列化。 内存 图2 es内存分为两部分【on heap】和【off heap】。on heap这部分由es的jvm管理。off heap则是由lucene管理。on heap 被分为两部分,一部分可以回收,一部分不能回收。 能回收的部分index buffer存储新的索引文档。当被填满时,缓冲区的文档会被写入到磁盘segment上。node上共享所有shards。 不能被回收的有node query cache、shard request cache、file data cache、segments cache node query cache是node级缓存,过滤后保存在每个node上,被所有shards共享,使用bitset数据结构(布隆优化版)关掉了评分。使用的LRU淘汰策略。GC无法回收。 shard request cache是shard级缓存,每个shard都有。默认情况下该缓存只存储request结果size等于0的查询。所以该缓存不会被hits,但却缓存hits.total,aggregations,suggestions。可以通过clear cache api清除。使用的LRU淘汰策略。GC无法回收。 file data cache 是把聚合、排序后的data缓存起来。初期es是没有doc values的,所以聚合、排序后需要有一个file data来缓存,避免磁盘IO。如果没有足够内存存储file data,es会不断地从磁盘加载数据到内存,并删除旧的数据。这些会造成磁盘IO和引发GC。所以2.x之后版本引入doc values特性,把文档构建在indextime上,存储到磁盘,通过memory mapped file方式访问。甚至如果只关心hits.total,只返回doc id,关掉doc values。doc values支持keyword和数值类型。text类型还是会创建file data。 segments cache是为了加速查询,FST永驻堆内内存。FST可以理解为前缀树,加速查询。but!!es 7.3版本开始把FST交给了堆外内存,可以让节点支持更多的数据。FST在磁盘上也有对应的持久化文件。 off heap 即Segments Memory,堆外内存是给Lucene使用的。 所以建议至少留一半的内存给lucene。 es 7.3版本开始把tip(terms index)通过mmp方式加载,交由系统的pagecache管理。除了tip,nvd(norms),dvd(doc values), tim(term dictionary),cfs(compound)类型的文件都是由mmp方式加载传输,其余都是nio方式。tip off heap后的效果jvm占用量下降了78%左右。可以使用_cat/segments API 查看 segments.memory内存占用量。 由于对外内存是由操作系统pagecache管理内存的。如果发生回收时,FST的查询会牵扯到磁盘IO上,对查询效率影响比较大。可以参考linux pagecache的回收策略使用双链策略。 持久化 es的持久化分为两部分,一部分类似快照,把文件缓存中的segments 刷新(fsync)磁盘。另一部分是translog日志,它每秒都会追加操作日志,默认30分钟刷到磁盘上。es持久化和redis的RDB+AOF模式很像。如下图 图3 上图是一个完整写入流程。磁盘也是分segment记录数据。这里濡染跟redis很像。但是内部机制没有采用COW(copy-on-write)。这也是查询和写入并行时load被打满的原因所在。 小结 es内存和磁盘的设计上非常巧妙。零拷贝上采用mmap方式,磁盘数据映射到off heap,也就是lucene。为了加速数据的访问,es每个segment都有会一些索引数据驻留在off heap里;因此segment越多,瓜分掉的off heap也越多,这部分是无法被GC回收! 结合以上两点可以清楚知道为什么es非常吃内存了。 二、应用 用户画像系统中有以下难点需要解决。 1.人群预估:根据标签选出一类人群,如20-25岁的喜欢电商社交的男性。20-25岁∩电商社交∩男性。通过与或非的运算选出符合特征的clientId的个数。这是一组。 我们组与组之前也是可以在做交并差的运算。如既是20-25岁的喜欢电商社交的男性,又是北京市喜欢撸铁的男性。(20-25岁∩电商社交∩男性)∩(20-25岁∩撸铁∩男性)。对于这样的递归要求在17亿多的画像库中,秒级返回预估人数。 2.人群包圈选:上述圈选出的人群包。 要求分钟级构建。 3.人包判定:判断一个clientId是否存在若干个人群包中。要求10毫秒返回结果。 我们先尝试用es来解决以上所有问题。 人群预估,最容易想到方案是在服务端的内存中做逻辑运算。但是圈选出千万级的人群包人数秒级返回的话在服务端做代价非常大。这时候可以吧计算压力抛给es存储端,像查询数据库一样。使用一条语句查出我们想要的数据来。 例如mysql select a.age from a where a.tel in (select b.age from b); 对应的es的dsl类似于 {"query":{"bool":{"must":[{"bool":{"must":[{"term":{"a9aa8uk0":{"value":"age18-24","boost":1.0}}},{"term":{"a9ajq480":{"value":"male","boost":1.0}}}],"adjust_pure_negative":true,"boost":1.0}},{"bool":{"adjust_pure_negative":true,"boost":1.0}}],"adjust_pure_negative":true,"boost":1.0}}} 这样使用es的高检索性能来满足业务需求。无论所少组,组内多少的标签。都打成一条dsl语句。来保证秒级返回结果。 使用官方推荐的RestHighLevelClient,实现方式有三种,一种是拼json字符串,第二种调用api去拼字符串。我使用第三种方式BoolQueryBuilder来实现,比较优雅。它提供了filter、must、should和mustNot方法。如 /** * Adds a query that <b>must not</b> appear in the matching documents. * No {@code null} value allowed. */ public BoolQueryBuilder mustNot(QueryBuilder queryBuilder) { if (queryBuilder == null) { throw new IllegalArgumentException("inner bool query clause cannot be null"); } mustNotClauses.add(queryBuilder); return this; } /** * Gets the queries that <b>must not</b> appear in the matching documents. */ public List<QueryBuilder> mustNot() { return this.mustNotClauses; } 使用api的可以大大的show下编代码的能力。 构建人群包。目前我们圈出最大的包有7千多万的clientId。想要分钟级别构建完(7千万数据在条件限制下35分钟构建完)需要注意两个地方,一个是es深度查询,另一个是批量写入。 es分页有三种方式,深度分页有两种,后两种都是利用游标(scroll和search_after)滚动的方式检索。 scroll需要维护游标状态,每一个线程都会创建一个32位唯一scroll id,每次查询都要带上唯一的scroll id。如果多个线程就要维护多个游标状态。search_after与scroll方式相似。但是它的参数是无状态的,始终会针对对新版本的搜索器进行解析。它的排序顺序会在滚动中更改。scroll原理是将doc id结果集保留在协调节点的上下文里,每次滚动分批获取。只需要根据size在每个shard内部按照顺序取回结果即可。 写入时使用线程池来做,注意使用的阻塞队列的大小,还要选择适的拒绝策略(这里不需要抛异常的策略)。批量如果还是写到es中(比如做了读写分离)写入时除了要多线程外,还有优化写入时的refresh policy。 人包判定接口,由于整条业务链路非常长,这块检索,上游服务设置的熔断时间是10ms。所以优化要优化es的查询(也可以redis)毕竟没负责逻辑处理。使用线程池解决IO密集型优化后可以达到1ms。tp99高峰在4ms。 三、优化、瓶颈与解决方案 以上是针对业务需求使用es的解题方式。还需要做响应的优化。同时也遇到es的瓶颈。 1.首先是mapping的优化。画像的mapping中fields中的type是keyword,index要关掉。人包中的fields中的doc value关掉。画像是要精确匹配;人包判定只需要结果而不需要取值。es api上人包计算使用filter去掉评分,filter内部使用bitset的布隆数据结构,但是需要对数据预热。写入时线程不易过多,和核心数相同即可;调整refresh policy等级。手动刷盘,构建时index.refresh_interval 调整-1,需要注意的是停止刷盘会加大堆内存,需要结合业务调整刷盘频率。构建大的人群包可以将index拆分成若干个。分散存储可以提高响应。目前几十个人群包还是能支撑。如果日后成长到几百个的时候。就需要使用bitmap来构建存储人群包。es对检索性能很卓越。但是如遇到写操作和查操作并行时,就不是他擅长的。比如人群包的数据是每天都在变化的。这个时候es的内存和磁盘io会非常高。上百个包时我们可以用redis来存。也可以选择使用MongoDB来存人包数据。 四、总结 以上是我们使用Elasticsearch来解决业务上的难点。同时发现他的持久化没有使用COW(copy-on-write)方式。导致在实时写的时候检索性能降低。 使用内存系统做数据源有点非常明显,就是检索块!尤其再实时场景下堪称利器。同时痛点也很明显,实时写会拉低检索性能。当然我们可以做读写分离,拆分index等方案。 除了Elasticsearch,我们还可以选用ClickHouse,ck也是支持bitmap数据结构。甚至可以上Pilosa,pilosa本就是BitMap Database。 参考 贝壳DMP平台建设实践 Mapping parameters | Elasticsearch Reference [7.10] | Elastic Elasticsearch 7.3 的 offheap 原理

优秀的个人博客,低调大师

从不均匀性角度浅析AB实验 | 京东云技术团队

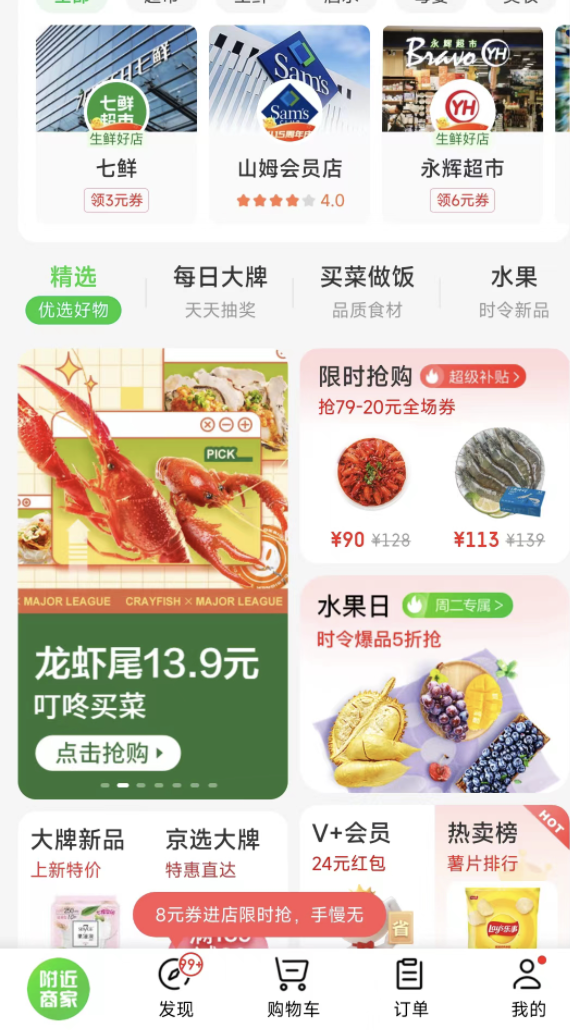
作者:京东零售 路卫强 本篇的目的是从三个不均匀性的角度,对AB实验进行一个认知的普及,最终着重讲述AB实验的一个普遍的问题,即实验准确度问题。 一、AB实验场景 在首页中,我们是用红色基调还是绿色基调,是采用门店小列表外+商品feed(左图),还是采用门店大列表囊括商品feed(右图),哪种更吸引用户浏览下单呢,简单来处理让50%的用户看到左图效果,让50%的用户看到右图效果,最终通过点击量,单量等指标进行比对得出结论,这是典型的AB实验场景 二、AB实验的定义 A/B实验就是针对想迭代的产品功能,提供两种不同的备选解决方案,然后让一部分用户使用方案A,另一部分用户使用方案B,最终通过实验数据对比来确定最优方案。 从定义里我们就可以看出来,最直观的一个概念,就是用户的分流,此时就涉及到分流人数是否均匀的问题,即人数比例的均匀性。 三、AB中的三个不均匀 1、人数比例的不均匀 目前AB实验的分流核心算法是通过的哈希算法,假设我们按用户名做为分流因子,使用murmurhash算法,以100桶制为例,确定一个人的位置的算法就是 //将用户名通过hash算法计算出一个整数 int hashNum = MurmurHash3.murmurhash3_x86_32(useName) //整数值对100取模 int bucket = hashNum % 100; 当我们定义一个实验两个策略的人数均为50%时,那么 bucket为0-49的用户由AB系统标记为A,业务系统根据A标记,使得用户使用方案A bucket为50-99的用户由AB系统标记为B,业务系统根据B标记,使得用户使用方案B。 可是我们都知道哈希算法并不是绝对均匀的,当100人时,基本上不会出现有50个人走A,50个人走B,但是1万个人的时候,两部分流量可能就接近了1:1,10万人的时候可能更接近1:1。 之前有位运营的同学问过,为什么不能用一种很均匀的算法,比如第一个人来了,放入A,第二个人来了放入B,第三个人来了放入A,第四个人来了放入B....,这样一天1W个人来,5000个取A策略,5000个取B策略。 假设我们真的这么做了,第一天是OK的,第二天进A只来了4000人,这样还是不均匀的,如果你第二天仍然按第一天的规则重新分配,这样会有一部分人乱了策略,不符合我们固定人群走固定策略的实验目的。 所以说这个不均匀是无解的,HASH算法是目前最理想的解决方案,前提是你需要一定的流量,流量越大,分流相对就比较准确。 2、人群素质的不均匀 我们假设流量足够大,人数比例很均匀了,但是还有个问题就是人群素质的均匀问题。这里的素质包括消费能力,活跃度,年龄等各种人群因素。 假设现在我们的活动统一采用的A策略(现状),我们想验证一下B策略(新策略)会不会带来客单价的提升,就直接做了AB实验,还按1:1比例来分流,发现使用A方案的人群客单价是100,使用客单价B的人群是96,此时我们能认为原有A方案优于B方案吗?其实是不能的,怎样确定这种人群素质的差异呢,可以采用AA实验,就是两部分人都走A,进行分开统计,可能会发现,位于0-49桶的人群本身客单价就是100,而位于50-99桶的人群可能只有94,这么看来B方案是能提升客单价的,因为位于50-99桶的人群本身指标就差一些。 当然AA不是必须的,可能你有整体的客单价指标,上了B策略后发现整体提升了,这种情况相当于灰度验证了,但实际情况是比较复杂的,整体指标你是不清楚的(因为这里的整体可能只是你取的业务中的一部分流量)。 所以解决素质不均匀的手段就是采用AA提前确定差异性,再在这个差异性基础上看差异的变化。 3、实验间影响的不均匀 这个不均匀性是最复杂的,一般做实验我们走两种极端: 第一种是完全不复用人群,每个实验人群都是独立的,这样的话效果比较准确,但是弊端是,当所有流量都被用去后,不能有新实验开始,必须等待有结束的实验后才能继续做。 第二种,所有实验都用全部流量,此时我们认为实验虽然互相之间有影响,但是这种影响是正交的,量大的时候应该是均匀的,如下图所示,P实验的两个策略人群,到Q实验时,对Q的两个策略影响是均匀的。 这种可以满足无限个实验,想做多少实验都可以,但弊端是,实验太多,必然有影响不均匀的,且我们无法消除这种不均匀。 所以我们想能不能结合以上两种情况来处理呢,结合google的Overlapping Experiment Infrastructure文章我们设计出分层的实验管理模型 首先我们将总流量分成两部分,正交域,垂直域(含对比区) 我们假设如图取80%的流量用做正交阈,20%用作垂直域,垂直域中有5%用做对比区。 上图正交域下4个层,层内实验流量互斥,层间实验流量正交,我们将可能会互相影响的实验放到同一层内进行流量互斥,而影响不大的实验可以放到不同层内。 垂直域中的实验流量只能互斥,且不与任何实验正交,可以理解用最纯正的流量做实验,可以I1和I2两个策略间对比,也可以I1或I2和对比域(现状)比对。 那此时有一个很重要的问题需要解决,我们怎么确定哪些实验互相影响较大,需要放到同一层下。 有一些简单标准,比如入口不一样,目标不一样等等,这种可以放到不同层,我们可以忽略正交不均匀的问题,反之就不行。 比如活动页劵对单量提升度的实验和会员页面入会效果的实验,就可以放到不同层。 而首页上满减活动实验对客单价提升的实验和同样首页买赠活动对客单价提升的实验,最好是不共用用户,放到同层比较合适。 但对于很多实验是不太容易通过简单规则来确定的,需要大数据的同学和产品,甚至研发来共同决定实验放到哪些层和哪些实验互斥,这确实在实际的运作中是最难的点。 总之采用这种策略,可以复用流量的同时还可以降低不必要的互相影响,比较综合考虑了流量和准确度问题。 四、总结 现在我们对以上问题进行总结,从问题到解决方案上来认识ab实验 1、人群做不到绝对的均匀,只能通过HASH算法,结合一定的流量来解决。 2、通过AA实验,来提前确定人群素质的不均匀。最终的实验数据结合AA实验数据来确定最终效果。 3、设计出正交垂直域,正交阈内多个层,每个层内放可能相互影响的实验,层内互斥,层间正交,保留垂直域,为要求精准的实验留出流量,来解决实验间相互影响的问题。 本篇从核心分流与实验间相互影响角度讲解ab实验,希望能引起大家在做实验前能有更多的思考,来更准确的验证自己想要的效果,希望大家有兴趣的可以留言讨论。

优秀的个人博客,低调大师

虚拟云网络系列 | Antrea 应用于 VMware 方案功能简介(八)

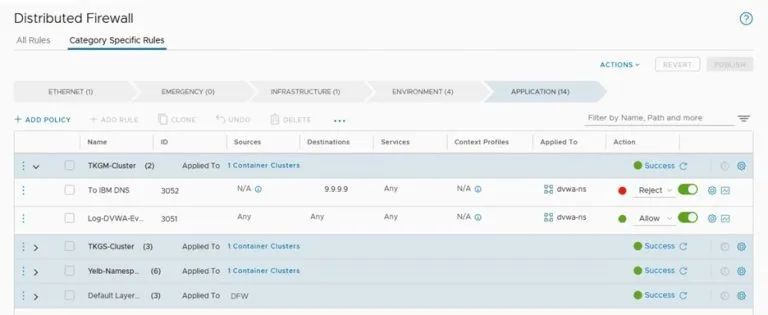
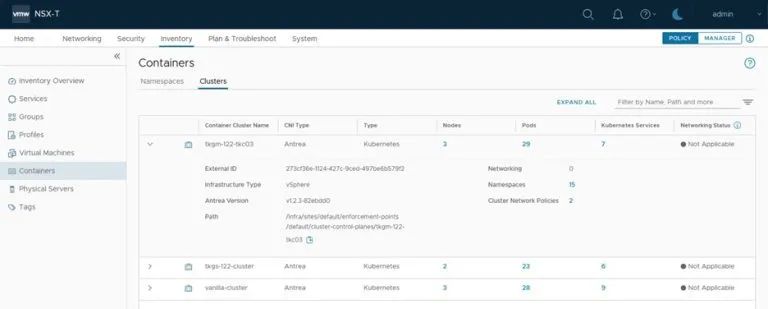
我们在前几篇文章讨论并展示了使用 Antrea 搭配 NSX Manager 来提供便利且企业等级的容器网络安全机制,以及与原生 Kubernetes Network Policies 的运作方式比较。采用 Antrea 搭配 NSX Manager 是我们在各个不同企业客户介绍容器方案时的主打功能之一,也受到很多客户青睐希望在生产环境内进行部署。因此接下来我想将重点放在如何进行 Antrea 与 NSX Manager 的链接整合流程。但开始前,这里要特别用一篇推文来讨论 Antrea 与 NSX Manager 的方案架构。 下面这张图是在 Kubernetes Cluster 内运用 Antrea 作为 Container Network Interface 元件,并且与 NSX Manager 进行整合的架构: 相关重点构件讨论如下: Antrea 构件 与我们之前在讨论 Antrea 本身的架构相同,在每个 Kubernetes Nodes 内都会有一个 Antrea Pod 来负责。 接收来自 Kubernetes API Server 的指示,编写相关的网络与安全需求如 Pod 之间的网络连接; 由 Antrea Controller 端接收 Antrea Network Policy 的要求,提供 Pod 上的安全策略; 透过本地上的 Open vSwitch 来实现上述功能。 而 Kubernetes Cluster 内在 Master Nodes 内也会部署一个 Antrea Controller Pod,这个 Controller Pod 是 Antrea 的安全控制端,负责要与 K8S API Server 那边抓取 K8S Inventories 的相关信息,并取得对应 Antrea Network Policy 的 CRD(Customized Resource Definition)要求。 上述构件都和我们之前描述标准 Antrea 方案一模一样,唯一要注意的是 Antrea 至 少必须采用 1.2.3 的社群版本,或 1.3.1-1.2.3 的商用版本,才会支持与 NSX 整合的功能,这是大家需要特别在使用此功能前注意的。下图是 VMware Container Networking with Antrea 1.3.1-1.2.3 的 release note(注:标注红框部分就是对于 NSX 整合新功能的描述。) 安特里亚 NSX 适配器 在进行 NSX 集成时,Kubernetes Cluster 内会配置一个独立的 Pod ,在上面架构图内叫做 Antrea NSX Adapter。这个 Pod 一方面负责与 Kubernetes 内的 API Server 以及 Antrea Controller Pod 通信,包含抓取 Kubernetes 相关 Inventory 信息,以及送出从 NSX 那边取得的群组与防火墙政策配置。另一方面则是与 NSX Manager 进行连接,提供上述的信息。 下图内大家看到在做完 Antrea + NSX 整合后, Kubernetes Cluster 内会出现一个开头是 interworking 的这个 pod,就是我们这边讨论的 Antrea NSX Adapter。 单纯安装 Antrea 作为 K8S Cluster CNI 时不会有上面这个 Pod 出现,只有在进行 NSX 整合时才需要。在后面我们讨论 Antrea+NSX 的安装步骤时会看到相关的配置流程。 NSX 管理器 这里的 NSX Manager 就是我们熟悉的 NSX Data Center 内的 Manager 构件,可以是一台或三台做丛集均可。这边就是我们真正通过 UI 界面进行群组配置以及防火墙政策的地方。几个重点: NSX Manager 作为管理/控制层来使用,不是数据/转发层。在此架构内,我们通过 NSX Manager 的 UI 界面进行安全政策配置以及查询 Kubernetes Inventory 信息,但是真正的防火墙实现是由 Antrea 呼叫 OVS 来进行。 因此,在此架构内,NSX 仅仅作为管理 / 控制层。不需要连接 vSphere 做 Transport Node Preparation,不需要建 TEP 接口启用 Overlay 网络。各位想要用同一组 NSX Manager 同时管理 SDDC 虚机环境与 Kubernetes 环境当然没问题,但单纯讨论 Antrea + NSX 的整合时,NSX 就只需要安装 Manager 而已。 也因为所有“真正的功能”都是在 Antrea 内通过 OVS 实现,因此 Antrea + NSX 这个安全方案能够或不能够做到什么,重点其实是在 Antrea 内有没有开发出此功能,而不是 NSX 本身有没有支持。比如说我们需要 Pod 之间不仅有 L4 防火墙,还想要 L7 的检查功能,IDPS 方案的整合等等。在方案架构内,这些功能会需要在 Antrea 端先做出来,然后才是于 NSX Manager 端来提供管理的接口。 这里多说一句,在前面我们讨论到 Antrea+NSX 可以提供较传统 Network Policies 更完善的功能,架构上其实要分成两部分: NSX Manager 是管理层,提供简易使用与维运的 UI 界面。 Antrea 在转发层实作比传统 Network Policies 更强的安全策略功能。在 Antrea 内这个功能是通过 CRD(Customized Resource Definition)来实现,叫做 Antrea Network Policy。 透过这个强化的 CRD 构件,Antrea 可以提供日志、基于 Tier 的防火墙配置顺序、设定明确的 Deny 规则等等。 因此整个内部作业流程是管理者在 NSX UI 内进行了需求的群组及规则配置,在 Kubernetes Cluster 内的 Antrea NSX Adapter Pod 取得这些配置要求,送给 Antrea Controller 后交给每个 K8S Node 里面的 Antrea Agent,编写 Open vSwitch 来实现防火墙配置,大概是这样。 架构讨论完,下一篇开始我们会详细讨论如何进行 Antrea 整合 NSX 的安装步骤。 内容来源|公众号:VMware 中国研发中心 本文作者:Colin Jao (饶康立), VMware 资深技术顾问,主要负责 VMware NSX 产品线,目前致力于网络虚拟化、分布式安全防护技术与新应用递送方案的介绍与推广。

优秀的个人博客,低调大师

虚拟云网络系列 | Antrea 应用于 VMware 方案功能简介(四)

本篇我们专门要讨论一下 Antrea 的社群版本与商用版本。特别用一篇讲这方面是因为包含在 VMware 内部文件,这都是一个很容易让人混淆的事情,但偏偏在我们要说明相关 Antrea 功能「是在哪个版本开始支持」,或是「必须安装哪个版本」的时候,也都避不开这个问题,不如一次在这边说清楚。 下面此表格来自 VMware Container Networking with Antrea 的 Datasheet: (注:不是完整的表格,只是截取部分用来说明,完整功能列表请大家至上列网址下载。) 这张表里最上面大家可以看到,Project Antrea 这边指的就是 Antrea 社群版本。若使用的是 Antrea 社群版本: 可直接透过 Internet 由 Antrea Github 下载使用; VMware「没有」提供技术支持服务; 具备除了与 NSX 以及 Wavefront 等 VMware 产品整合外的绝大部分功能。 因此如果是要在测试环境尝新,确认 Antrea 的新功能,使用社群版本当然是没有问题的。采用 Antrea 社群版本时,没有区分不同的功能版本(standard/advance/enterprise 这类的),功能都一样。但大家应该要确认自己是下载第几版(产品版本),因为我们讨论的功能会是在某一个产品版本才开始支持。比如说后面会与大家介绍的 Egress 功能是在产品版本 1.2 版才开始支持,Antrea-IPAM 功能是在产品版本 1.4 版才开始支持。下图内是写作当时 Antrea 的文件页面,大家可以看到最新版本是 1.8 版。 VMware 支持的 Antrea 商用版本正式名称叫做 VMware Container Networking with Antrea。当客户购买/由其他产品取得 VMware Container Networking with Antrea 时: VMware 提供技术支持服务; 客户可通过 VMware 官网进行下载,或已经内含于 Tanzu 建置的 TKC(Tanzu Kubernetes Cluster)内。 VMware Container Networking with Antrea 有三种功能版本,很快与大家进行说明: Standard 版在客户购买 Tanzu Basic/Standard 版本时提供,具备与社群版本几乎完全相同的功能; Advanced 版在客户购买 Tanzu Advanced 版本时提供,增加在安全功能上的角色权限控管,以及 Wavefront 整合; Enterprise版在客户购买 NSX Advanced/Enterprise Plus 版本时提供,或客户可以单独购买 VMware Container Networking with Antrea Enterprise 的授权。Enterprise 版增加与 NSX 整合进行 Pod 间的微分段控管,并提供于 Openshift 环境的安装机制。 简单用下面这几句话进行总结: 社群版本没有 VMware Support,商用版本(VMware Container Networking with Antrea)才有 VMware Support; 若客户已经购买了 Tanzu,TKC 内的Container Network Interface 就已经使用Antrea的商用版本了( VMware Support ); 若客户想要像是以 NSX UI 来进行虚机微分段一样来进行 Kubernetes 环境内的 Pod 安全政策管理,需要购买 NSX Advanced / Enterprise Plus 版本,或是独立购置 VMware Container Networking with Antrea Enterprise 版。 最后我们还要讨论一个很让人混淆的议题:VMware Container Networking with Antrea 是有自己的产品版号,而且与 Antrea 社群版本不同。在 VMware Container Networking with Antrea 的 Release Notes 内: 大家可以看到 VMware Container Networking with Antrea 的 1.4 版是对应到社群的 1.5.2 版: 在之前比较友善,会将社群的版号直接写在产品版号内。下图内,VMware Container Networking with Antrea 的 1.3.1-1.2.3 的这个产品版号就直接把对应的社群版号 1.2.3 写在里面了。 原则上,商用版本与社群版本会是一对一的对应。举个例子:我们在后面的功能展示安装的是vSphere with Tanzu 里面 TKC 1.22.9 的版本,使用的商用版本是 VMware Container Networking with Antrea 的 1.3.1-1.2.3,此时, 在 VMware Container Networking with Antrea 的 1.3.1-1.2.3 的 release note 内,会明确列出这里 CNI 有支持的各项新功能; 对于这些新功能若想要了解细节,可以到Antrea 的网站找 1.2.3 版本内的各项功能描述。 这篇就先写到这边,希望能对 Antrea 的社群版本与商用版本上的差异,以及一些容易混淆的版本对应问题提供厘清。接下来我想要和大家说明目前与客户常在介绍,反应相当好的重要功能:如何使用 NSX 搭配 Antrea 进行 Kubernetes Pod 的微分段防火墙管理。 内容来源|公众号:VMware 中国研发中心 本文作者:Colin Jao (饶康立), VMware 资深技术顾问,主要负责 VMware NSX 产品线,目前致力于网络虚拟化、分布式安全防护技术与新应用递送方案的介绍与推广。

优秀的个人博客,低调大师

虚拟云网络系列 | Antrea 应用于 VMware 方案功能简介(三)

通常一个新产品我们简述了功能,讨论了架构,接下来也应该和大家说明一下安装。但 Antrea 的安装就是很直接很简单。如果大家是自行建立 Native Kubernetes,在做完 kubeadm init ,然后用 kubeadm join 把各台 worker nodes 加入到这个 K8S Cluster 的步骤后,在有 Internet 的状况下,只要一行指令就可以安装 Antrea 完成。 首先,使用下面的指令直接进行 Antrea 安装: # kubectl apply -f https://github.com/antrea-io/antrea/releases/download//antrea.yml4 上述指令内的可以指定要安装的社群版本号。而如果确定就是要安装最新稳定版本,也可以直接用下列指令: # kubectl apply -f https://raw.githubusercontent.com/antrea-io/antrea/main/build/yamls/antrea.yml 很简单吧。上面就是对应到原生的 Kubernetes 与社群版本的 Antrea 的手动安装方式。这边特别要说明一下,由于 Antrea 底层要使用到 Open vSwitch,务必要确认 Linux Kernel 内是否已经包含,或是需要特别手动安装 OVS。如果各位采用的 Linux Kernel 已经在 4.6 版以上,那默认就有包含 OVS 功能。如果低于此版,请预先查询相关的文件,安装 OVS 到 2.6.0 版以上。 但如果我们要装的是 Antrea 商业版本像是运作在 vSphere with Tanzu 或是 Tanzu Kubernetes Grid,环境内也可能没有 Internet连线,是不是很麻烦?反过来,其实更单纯。在 Tanzu 各方案内管理者产出的 Kubernetes 丛集(TKC,Tanzu Kubernetes Cluster),默认内建就是使用 Antrea 的商用版本(VMware Container Networking with Antrea)。比如说在 vSphere with Tanzu 内要建立一个新的 TKC,下面是我用来装 NAPP(NSX Application Platform)的一个配置文件: 可以看到 Container Network Interface 选择是 Antrea(默认值)并且配置了 Pod 使用的网络范围。此时使用这个配置文件来建立新的 Tanzu Kubernetes Cluster 时,Antrea 会自动安装在内直接可使用,不需要大家进一步进行任何动作。下图内是我用前面的配置文件产出的TKC,建立完成后可以在 kube-system namespaces 内看到 Antrea 相关构件已经配置完成: 同时以 kubectl describe pod 指令看 antrea-controller 的内容,可以看到对应到这个 TKC 版本(安装的是 v1.21.6),Antrea 是 0.13.5版(这是社群功能版本,对应到的是 VMware Container Networking with Antrea 的 1.2.0-0.13.1 企业版本)。 小结: 以上是关于安装的说明,大家可以看到非常简单。如果是在原生 Kubernetes 内安装,只需要手动配置一行指令。如果是在 Tanzu 内,不需要安装,Tanzu Kubernetes Cluster 配置完成时就自动建好了。但我相信大家在前面的叙述看到“版本”二字,有些谈到的是社群版本,有时谈到的是 VMware 支持的商用版本,彼此间又有对应,看起来很混乱。下一篇我们专门来讨论这个议题:Antrea 的社群版本与商用版本对应与差异。 内容来源|公众号:VMware 中国研发中心 本文作者:Colin Jao (饶康立), VMware 资深技术顾问,主要负责 VMware NSX 产品线,目前致力于网络虚拟化、分布式安全防护技术与新应用递送方案的介绍与推广。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册