首页 文章 精选 留言 我的

精选列表

搜索[阿里云],共10000篇文章
优秀的个人博客,低调大师

阿里JAVA手册之MySQL数据库 (建表规约、索引规约、SQL语句、ORM映射)

码出高效、码出质量。 代码的字里行间流淌的是软件生命中的血液,质量的提升是尽可能少踩坑,杜绝踩重复的坑,切实提升质量意识。另外,现代软件架构都需要协同开发完成,高效协作即降低协同成本,提升沟通效率,所谓无规矩不成方圆,无规范不能协作。众所周知,制订交通法规表面上是要限制行车权,实际上是保障公众的人身安全。试想如果没有限速,没有红绿灯,谁还敢上路行驶。对软件来说,适当的规范和标准绝不是消灭代码内容的创造性、优雅性,而是限制过度个性化,以一种普遍认可的统一方式一起做事,提升协作效率。 MySQL数据库 (一) 建表规约 1. 【强制】表达是与否概念的字段,必须使用is_xxx的方式命名,数据类型是unsigned tinyint( 1表示是,0表示否)。 说明:任何字段如果为非负数,必须是unsigned。 正例:表达逻辑删除的字段名is_deleted,1表示删除,0表示未删除。 【点评】规则存疑,更愿意用类似deletedflag这样的字段,便于扩展数据类型用【unsigned tinyint】,遵循 2. 【强制】表名、字段名必须使用小写字母或数字,禁止出现数字开头,禁止两个下划线中间只出现数字。数据库字段名的修改代价很大,因为无法进行预发布,所以字段名称需要慎重考虑。 正例:getter_admin,task_config,level3_name 反例:GetterAdmin,taskConfig,level_3_name 【点评】规则好,严格遵循 3.【强制】表名不使用复数名词。 说明:表名应该仅仅表示表里面的实体内容,不应该表示实体数量,对应于DO类名也是单数形式,符合表达习惯。 【点评】规则好,严格遵循 4.【强制】禁用保留字,如desc、range、match、delayed等,请参考MySQL官方保留字。 【点评】规则好,严格遵循 5. 【强制】主键索引名为pk_字段名;唯一索引名为uk_字段名;普通索引名则为idx_字段名。 说明:pk_ 即primary key;uk_ 即 unique key;idx_ 即index的简称。 【点评】规则好,严格遵循 6. 【强制】小数类型为decimal,禁止使用float和double。 说明:float和double在存储的时候,存在精度损失的问题,很可能在值的比较时,得到不正确的结果。如果存储的数据范围超过decimal的范围,建议将数据拆成整数和小数分开存储。 【点评】规则好,严格遵循 7. 【强制】如果存储的字符串长度几乎相等,使用char定长字符串类型。 【点评】规则好,严格遵循 8. 【强制】varchar是可变长字符串,不预先分配存储空间,长度不要超过5000, 如果存储长度大于5000,定义字段类型为text,独立出来一张表,用主键来对应,避免影响其它字段索引效率。 【点评】规则好,严格遵循 9. 【强制】表必备三字段:id, gmt_create, gmt_modified。 说明:其中id必为主键,类型为unsigned bigint、单表时自增、步长为1。gmt_create, gmt_modified的类型均为date_time类型。 【点评】规则好,严格遵循 ,更喜欢用create_time和modify_time 10.【推荐】表的命名最好是加上“业务名称_表的作用”。 正例:tiger_task / tiger_reader / mpp_config 【点评】规则好,严格遵循 11.【推荐】库名与应用名称尽量一致。 【点评】规则好,严格遵循 12.【推荐】如果修改字段含义或对字段表示的状态追加时,需要及时更新字段注释。 【点评】规则好,严格遵循 13.【推荐】字段允许适当冗余,以提高查询性能,但必须考虑数据一致。冗余字段应遵循: 1)不是频繁修改的字段。 2)不是varchar超长字段,更不能是text字段。 正例:商品类目名称使用频率高,字段长度短,名称基本一成不变,可在相关联的表中冗余存储类目名称,避免关联查询。 【点评】规则好,严格遵循 14.【推荐】单表行数超过500万行或者单表容量超过2GB,才推荐进行分库分表。 说明:如果预计三年后的数据量根本达不到这个级别,请不要在创建表时就分库分表。 【点评】规则好,严格遵循 15.【参考】合适的字符存储长度,不但节约数据库表空间、节约索引存储,更重要的是提升检索速度。 正例:如下表,其中无符号值可以避免误存负数,且扩大了表示范围。 对象 年龄区间 类型 表示范围 人 150岁之内 unsigned tinyint 无符号值:0到255 龟 数百岁 unsigned smallint 无符号值:0到65535 恐龙化石 数千万年 unsigned int 无符号值:0到约42.9亿 太阳 约50亿年 unsigned bigint 无符号值:0到约10的19次方 【点评】规则好,严格遵循 (二) 索引规约 1.【强制】业务上具有唯一特性的字段,即使是多个字段的组合,也必须建成唯一索引。 说明:不要以为唯一索引影响了insert速度,这个速度损耗可以忽略,但提高查找速度是明显的; 另外,即使在应用层做了非常完善的校验控制,只要没有唯一索引,根据墨菲定律,必然有脏数据产生。 【点评】规则好,严格遵循 2. 【强制】 超过三个表禁止join。需要join的字段,数据类型必须绝对一致;多表关联查询时,保证被关联的字段需要有索引。 说明:即使双表join也要注意表索引、SQL性能。 【点评】规则好,严格遵循 3. 【强制】在varchar字段上建立索引时,必须指定索引长度,没必要对全字段建立索引,根据实际文本区分度决定索引长度即可。 说明:索引的长度与区分度是一对矛盾体,一般对字符串类型数据,长度为20的索引,区分度会高达90%以上, 可以使用count(distinct left(列名, 索引长度))/count(*)的区分度来确定。 【点评】规则好,严格遵循 4. 【强制】页面搜索严禁左模糊或者全模糊,如果需要请走搜索引擎来解决。 说明:索引文件具有B-Tree的最左前缀匹配特性,如果左边的值未确定,那么无法使用此索引。 【点评】规则好,严格遵循 5. 【推荐】如果有order by的场景,请注意利用索引的有序性。 order by 最后的字段是组合索引的一部分,并且放在索引组合顺序的最后,避免出现file_sort的情况,影响查询性能。 正例:where a=? and b=? order by c; 索引:a_b_c 反例:索引中有范围查找,那么索引有序性无法利用,如:WHERE a>10 ORDER BY b; 索引a_b无法排序。 【点评】规则好,严格遵循 6. 【推荐】利用覆盖索引来进行查询操作,避免回表。 说明:如果一本书需要知道第11章是什么标题,会翻开第11章对应的那一页吗?目录浏览一下就好,这个目录就是起到覆盖索引的作用。 正例:能够建立索引的种类:主键索引、唯一索引、普通索引,而覆盖索引是一种查询的一种效果,用explain的结果,extra列会出现:using index。 【点评】规则好,严格遵循 参考:http://www.cnblogs.com/zl0372/articles/mysql_32.html 话说有这么一个表: 复制代码 CREATE TABLE `user_group` ( `id` int(11) NOT NULL auto_increment, `uid` int(11) NOT NULL, `group_id` int(11) NOT NULL, PRIMARY KEY (`id`), KEY `uid` (`uid`), KEY `group_id` (`group_id`), ) ENGINE=InnoDB AUTO_INCREMENT=750366 DEFAULT CHARSET=utf8 复制代码 看AUTO_INCREMENT就知道数据并不多,75万条。然后是一条简单的查询: SELECT SQL_NO_CACHE uid FROM user_group WHERE group_id = 245; 很简单对不对?怪异的地方在于: 如果换成MyISAM做存储引擎的时候,查询耗时只需要0.01s,用InnoDB却会是0.15s左右 如果只是就这么点差距其实不是什么大不了的事,但是真实的业务需求比这个复杂,造成的差距也很大:MyISAM只需要0.12s,InnoDB则需要2.2s.,最终定位到问题症结是在这条SQL。 Explain的结果是: +----+-------------+------------+------+---------------+----------+---------+-------+------+-------+ | id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra | +----+-------------+------------+------+---------------+----------+---------+-------+------+-------+ | 1 | SIMPLE | user_group | ref | group_id | group_id | 4 | const | 5544 | | +----+-------------+------------+------+---------------+----------+---------+-------+------+-------+ 看起来已经用上索引了,而这条SQL语句已经简单到让我无法再优化了。最后请前同事Gaston诊断了一下,他认为:数据分布上,group_id相同的比较多,uid散列的比较均匀,加索引的效果一般,但是还是建议我试着加了一个多列索引: ALTER TABLE user_group ADD INDEX group_id_uid (group_id, uid); 然后,不可思议的事情发生了……这句SQL查询的性能发生了巨大的提升,居然已经可以跑到0.00s左右了。经过优化的SQL再结合真实的业务需求,也从之前2.2s下降到0.05s。 再Explain一次: +----+-------------+------------+------+-----------------------+--------------+---------+-------+------+-------------+ | id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra | +----+-------------+------------+------+-----------------------+--------------+---------+-------+------+-------------+ | 1 | SIMPLE | user_group | ref | group_id,group_id_uid | group_id_uid | 4 | const | 5378 | Using index | +----+-------------+------------+------+-----------------------+--------------+---------+-------+------+-------------+ 原来是这种叫覆盖索引(covering index),MySQL只需要通过索引就可以返回查询所需要的数据,而不必在查到索引之后再去查询数据,所以那是相当的快!!但是同时也要求所查询的字段必须被索引所覆盖到,在Explain的时候,输出的Extra信息中如果有“Using Index”,就表示这条查询使用了覆盖索引。 不过,还有一个无法解释的问题就是,不用覆盖索引的情况下,为什么用MyISAM就快那么多,而InnoDB就慢这么多呢? 7. 【推荐】利用延迟关联或者子查询优化超多分页场景。 说明:MySQL并不是跳过offset行,而是取offset+N行,然后返回放弃前offset行,返回N行,那当offset特别大的时候,效率就非常的低下, 要么控制返回的总页数,要么对超过特定阈值的页数进行SQL改写。 正例:先快速定位需要获取的id段,然后再关联: SELECT a.* FROM 表1 a, (select id from 表1 where 条件 LIMIT 100000,20 ) b where a.id=b.id 【点评】规则好,严格遵循 8. 【推荐】 SQL性能优化的目标:至少要达到 range 级别,要求是ref级别,如果可以是consts最好。 说明:1)consts 单表中最多只有一个匹配行(主键或者唯一索引),在优化阶段即可读取到数据。 2) ref 指的是使用普通的索引(normal index)。 3)range 对索引进行范围检索。 反例:explain表的结果,type=index,索引物理文件全扫描,速度非常慢,这个index级别比较range还低,与全表扫描是小巫见大巫。 【点评】规则好,严格遵循 9. 【推荐】建组合索引的时候,区分度最高的在最左边。 正例:如果where a=? and b=? ,a列的几乎接近于唯一值,那么只需要单建idx_a索引即可。 说明:存在非等号和等号混合判断条件时,在建索引时,请把等号条件的列前置。 如:where a>? and b=? 那么即使a的区分度更高,也必须把b放在索引的最前列。 【点评】规则好,严格遵循 10. 【推荐】防止因字段类型不同造成的隐式转换,导致索引失效。 【点评】规则好,严格遵循 11. 【参考】创建索引时避免有如下极端误解: 1)宁滥勿缺。误认为一个查询就需要建一个索引。 2)宁缺勿滥。误认为索引会消耗空间、严重拖慢更新和新增速度。 3)抵制惟一索引。误认为业务的惟一性一律需要在应用层通过“先查后插”方式解决。 【点评】规则好,严格遵循 (三) SQL语句 1. 【强制】不要使用count(列名)或count(常量)来替代count(*),count(*)是SQL92定义的标准统计行数的语法,跟数据库无关,跟NULL和非NULL无关。 说明:count(*)会统计值为NULL的行,而count(列名)不会统计此列为NULL值的行。 【点评】规则好,严格遵循 2. 【强制】count(distinct col) 计算该列除NULL之外的不重复行数, 注意 count(distinct col1, col2) 如果其中一列全为NULL,那么即使另一列有不同的值,也返回为0。 【点评】规则好,严格遵循 3.【强制】当某一列的值全是NULL时,count(col)的返回结果为0,但sum(col)的返回结果为NULL,因此使用sum()时需注意NPE问题。 正例:可以使用如下方式来避免sum的NPE问题:SELECT IF(ISNULL(SUM(g)),0,SUM(g)) FROM table; 【点评】规则好,严格遵循 4. 【强制】使用ISNULL()来判断是否为NULL值。注意:NULL与任何值的直接比较都为NULL。 说明: 1) NULL<>NULL的返回结果是NULL,而不是false。 2) NULL=NULL的返回结果是NULL,而不是true。 3) NULL<>1的返回结果是NULL,而不是true。 【点评】规则好,严格遵循 5. 【强制】 在代码中写分页查询逻辑时,若count为0应直接返回,避免执行后面的分页语句。 【点评】规则好,严格遵循 6. 【强制】不得使用外键与级联,一切外键概念必须在应用层解决。 说明:(概念解释)学生表中的student_id是主键,那么成绩表中的student_id则为外键。 如果更新学生表中的student_id,同时触发成绩表中的student_id更新,则为级联更新。 外键与级联更新适用于单机低并发,不适合分布式、高并发集群; 级联更新是强阻塞,存在数据库更新风暴的风险;外键影响数据库的插入速度。 【点评】规则好,严格遵循 7. 【强制】禁止使用存储过程,存储过程难以调试和扩展,更没有移植性。 【点评】规则好,严格遵循 8. 【强制】数据订正时,删除和修改记录时,要先select,避免出现误删除,确认无误才能执行更新语句。 【点评】规则好,严格遵循 9. 【推荐】in操作能避免则避免,若实在避免不了,需要仔细评估in后边的集合元素数量,控制在1000个之内。 【点评】规则好,严格遵循 10. 【参考】如果有全球化需要,所有的字符存储与表示,均以utf-8编码,注意字符统计函数的区别。 说明: SELECT LENGTH("轻松工作"); 返回为12; SELECT CHARACTER_LENGTH("轻松工作"); 返回为4 如果要使用表情,那么使用utfmb4来进行存储,注意它与utf-8编码的区别。 【点评】规则好,严格遵循 11. 【参考】 TRUNCATE TABLE 比 DELETE 速度快,且使用的系统和事务日志资源少,但TRUNCATE无事务且不触发trigger,有可能造成事故,故不建议在开发代码中使用此语句。 说明:TRUNCATE TABLE 在功能上与不带 WHERE 子句的 DELETE 语句相同。 【点评】规则好,严格遵循 (四) ORM映射 1. 【强制】在表查询中,一律不要使用 * 作为查询的字段列表,需要哪些字段必须明确写明。 说明:1)增加查询分析器解析成本。 2)增减字段容易与resultMap配置不一致。 【点评】规则好,严格遵循 2. 【强制】POJO类的布尔属性不能加is,而数据库字段必须加is_,要求在resultMap中进行字段与属性之间的映射。 说明:参见定义POJO类以及数据库字段定义规定,在<resultMap>中增加映射,是必须的。 在MyBatis Generator生成的代码中,需要进行对应的修改。 【点评】规则存疑,用flag结尾字段 3. 【强制】不要用resultClass当返回参数,即使所有类属性名与数据库字段一一对应,也需要定义; 反过来,每一个表也必然有一个与之对应。 说明:配置映射关系,使字段与DO类解耦,方便维护。 【点评】规则好,严格遵循 4. 【强制】sql.xml配置参数使用:#{},#param# 不要使用${} 此种方式容易出现SQL注入。 【点评】规则好,严格遵循 5. 【强制】iBATIS自带的queryForList(String statementName,int start,int size)不推荐使用。 说明:其实现方式是在数据库取到statementName对应的SQL语句的所有记录,再通过subList取start,size的子集合。 正例:Map<String, Object> map = new HashMap<String, Object>(); map.put("start", start); map.put("size", size); 【点评】规则好,严格遵循 6. 【强制】不允许直接拿HashMap与Hashtable作为查询结果集的输出。 说明:resultClass=”Hashtable”,会置入字段名和属性值,但是值的类型不可控。 【点评】规则好,严格遵循 7. 【强制】更新数据表记录时,必须同时更新记录对应的gmt_modified字段值为当前时间。 【点评】规则好,严格遵循 8. 【推荐】不要写一个大而全的数据更新接口,传入为POJO类,不管是不是自己的目标更新字段,都进行update table set c1=value1,c2=value2,c3=value3; 这是不对的。执行SQL时,不要更新无改动的字段, 一是易出错; 二是效率低; 三是增加binlog存储。 【点评】规则好,严格遵循 9. 【参考】@Transactional事务不要滥用。 事务会影响数据库的QPS, 另外使用事务的地方需要考虑各方面的回滚方案,包括缓存回滚、搜索引擎回滚、消息补偿、统计修正等。 【点评】规则好,严格遵循 10.【参考】<isEqual>中的compareValue是与属性值对比的常量,一般是数字,表示相等时带上此条件; <isNotEmpty>表示不为空且不为null时执行;<isNotNull>表示不为null值时执行。
优秀的个人博客,低调大师

阿里高级技术专家的5点思考

扫码或点我直达 免费领取! 我们对于研发效能的讨论,本质上是提高整个技术生态中的协同效率。如果仅从研发角度出发,技术团队要实现的终极目标是7*24小时的灵活发布窗口,以及更快的业务迭代能力。 7*24小时发布窗口的实现其实并不简单,受限于很多因素。我简单的进行了分解。 一、系统 先从最基础的开始说,当一个创业团队只有几个人,一两个系统的情况下,是可以不考虑研发效率这回事的。因为不存在系统间的依赖,系统内的依赖也完全在一个可控的范围内,本地起一个 Tomcat 或 Apache 就能开发、调试。另外再加上团队成员之间的高频交流,基本上可以实现随时随地,想发就发的要求。 当业务逐渐复杂,开发人数扩展到10几人时。提效的第一步是理清系统内的依赖关系,并促进角色的专业化。这也是大家所熟知的MVC,通过对视图、模型、控制器的分离,对系统内的逻辑

优秀的个人博客,低调大师

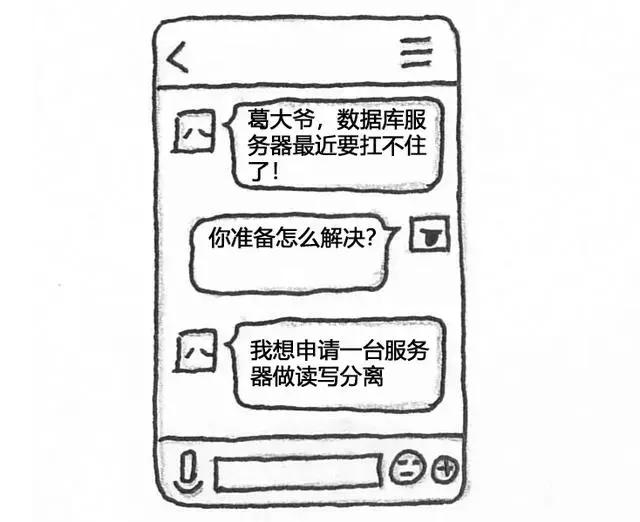
阿里P8架构师带你玩转数据库 “读写分离”

想用数据库“读写分离” 请先明白“读写分离”解决什么问题 有一些技术同学可能对于“读写分离”了解不多,认为数据库的负载问题都可以使用“读写分离”来解决。 这其实是一个非常大的误区,我们要用“读写分离”,首先应该明白“读写分离”是用来解决什么样的问题的,而不是仅仅会用这个技术。 什么是读写分离? 其实就是将数据库分为了主从库,一个主库用于写数据,多个从库完成读数据的操作,主从库之间通过某种机制进行数据的同步,是一种常见的数据库架构。 一个组从同步集群,通常被称为是一个“分组”。 数据库分组架构解决什么问题? 大多数互联网业务,往往读多写少,这时候,数据库的读会首先称为数据库的瓶颈,这时,如果我们希望能够线性的提升数据库的读性能,消除读写锁冲突从而提升数据库的写性能,那么就可以使用“分组架构”(读写分离架构)。 用一句话概括,读写分离是用来解决数据库的读性能瓶颈的。 但是,不是任何读性能瓶颈都需要使用读写分离,我们还可以有其他解决方案。 在互联网的应用场景中,常常数据量大、并发量高、高可用要求高、一致性要求高,如果使用“读写分离”,就需要注意这些问题: 数据库连接池要进行区分,哪些是读连接池,哪个是写连接池,研发的难度会增加; 为了保证高可用,读连接池要能够实现故障自动转移; 主从的一致性问题需要考虑。 在这么多的问题需要考虑的情况下,如果我们仅仅是为了解决“数据库读的瓶颈问题”,为什么不选择使用缓存呢? 为什么用缓存 缓存,也是互联网中常常使用到的一种架构方式,同“读写分离”不同,读写分离是通过多个读库,分摊了数据库读的压力,而存储则是通过缓存的使用,减少了数据库读的压力。他们没有谁替代谁的说法,但是,如果在缓存的读写分离进行二选一时,还是应该首先考虑缓存。 为什么呢? 缓存的使用成本要比从库少非常多; 缓存的开发比较容易,大部分的读操作都可以先去缓存,找不到的再渗透到数据库。 当然,如果我们已经运用了缓存,但是读依旧还是瓶颈时,就可以选择“读写分离”架构了。简单来说,我们可以将读写分离看做是缓存都解决不了时的一种解决方案。 当然,缓存也不是没有缺点的 对于缓存,我们必须要考虑的就是高可用,不然,如果缓存一旦挂了,所有的流量都同时聚集到了数据库上,那么数据库是肯定会挂掉的。 对于常见的数据库瓶颈是什么呢? 其实是数据容量的瓶颈。例如订单表,数据量只增不减,历史数据又必须要留存,非常容易成为性能的瓶颈,而要解决这样的数据库瓶颈问题,“读写分离”和缓存往往都不合适,最适合的是什么呢? 数据库水平切分 什么是数据库水平切分? 数据库水平切分,也是一种常见的数据库架构,是一种通过算法,将数据库进行分割的架构。一个水平切分集群中的每个数据库,通常称为一个“分片”。每一个分片中的数据没有重合,所有分片中的数据并集组成全部数据。 水平切分架构解决什么问题呢? 大部分的互联网业务,数据量都非常大,单库容量最容易成为瓶颈,当单库的容量成为了瓶颈,我们希望提高数据库的写性能,降低单库容量的话,就可以采用水平切分了。 而有少部分程序员,会没有分析数据库的性能瓶颈是什么,就贸贸然的使用“读写分离”,殊不知“水平切分”才是正道。 欢迎工作一到五年的Java工程师朋友们加入Java填坑之路:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

直击系统领域顶会OSDI'18现场,探秘阿里集团基础设施团队

作为系统领域顶会双星之一的OSDI(USENIX Symposium on Operating Systems Design andImplementation),当地时间今年10月8日-10日在在美国加州Carlsbad的Omni La Costa Resort & Spa酒店举办了其第13次会议OSDI'18。 本次大会参会人数达到了创纪录的650多人,投递论文257篇,收录47篇,录取率不到20%。另外有83个Poster和6个Demo。本届OSDI三篇BestPaper分别来自: ● UnderstandingFailures (REPT:Reverse Debugging of Failures in Deployed Software, Weidong Cui et al) ● OperatingSystem(

优秀的个人博客,低调大师

阿里P8架构师谈:高并发架构解决方案总结

一、关于高并发 高并发是指在同一个时间点,有很多用户同时访问URL地址,比如:淘宝的双11、双12,就会产生高并发。又如贴吧的爆吧,就是恶意的高并发请求,也就是DDOS攻击。 1 高并发会来带的后果 服务端:导致站点服务器/DB服务器资源被占满崩溃,数据的存储和更新结果和理想的设计是不一样的,比如:出现重复的数据记录,多次添加了用户积分等。 用户角度:网站打不开 服务器雪崩: 2 并发下的数据处理 通过表设计,如:记录表添加唯一约束,数据处理逻辑使用事物防止并发下的数据错乱问题。通过服务端锁进程防止包并发下的数据错乱问题。 这里主要讲述的是在并发请求下的数据逻辑处理的接口,如何保证数据的一致性和完整性,这里的并发可能是大量用户发起的,也可能攻击者通过并发工具发起的并发请求。 例子1:通过表设计防止并发导致数据错乱 需求点: 【签到功能】一天一个用户只能

优秀的个人博客,低调大师

会这133个Java面试题进阿里还是问题吗?(内含答案解析)

Java 面试随着时间的改变而改变。在过去的日子里,当你知道 String 和 StringBuilder 的区别就能让你直接进入第二轮面试,但是现在问题变得越来越高级,面试官问的问题也更深入。 在我初入职场的时候,类似于 Vector 与 Array 的区别、HashMap 与 Hashtable 的区别是最流行的问题,只需要记住它们,就能在面试中获得更好的机会,但这种情形已经不复存在。如今,你将会被问到许多 Java 程序员都没有看过的领域,如 NIO,设计模式,成熟的单元测试,或者那些很难掌握的知识,如并发、算法、数据结构及编码。 由于我喜欢研究面试题,因此我已经收集了许多的面试问题,包括许多许多不同的主题。我已经为这众多的问题准备一段时间了,现在我将它们分享给你们。这里面不但包含经典的面试问题,如线程、集合、equals 和 hashcode、socket,而且还包含了 NIO、数组、字符串、Java 8 等主题。 该列表包含了入门级 Java 程序员和多年经验的高级开发者的问题。无论你是 1、2、3、4、5、6、7、8、9 还是 10 年经验的开发者,你都能在其中找到一些有趣的问题。这里包含了一些超级容易回答的问题,同时包含经验丰富的 Java 程序员也会棘手的问题。 当然你们也是非常幸运的,当今有许多好的书来帮助你准备 Java 面试,其中有一本我觉得特别有用和有趣的是 Markham 的 Java 程序面试揭秘(Java Programming Interview Exposed)。 这本书会告诉你一些 Java 和 JEE 面试中最重要的主题,即使你不是准备 Java 面试,也值得一读。 该问题列表特别长,我们有各个地方的问题,所以,答案必须要短小、简洁、干脆,不拖泥带水。因此,除了这一个段落,你只会听到问题与答案,再无其他内容,没有反馈,也没有评价。为此,我已经写好了一些博文,在这些文章中你可以找到我对某些问题的观点,如我为什么喜欢这个问题,这个问题的挑战是什么?期望从面试者那获取到什么样的答案? 这个列表有一点不同,我鼓励你采用类似的方式去分享问题和答案,这样容易温习。我希望这个列表对面试官和候选人都有很好的用处,面试官可以对这些问题上做一些改变以获取新奇和令人惊奇的元素,这对一次好的面试来说非常重要。而候选者,可以扩展和测试 Java 程序语言和平台关键领域的知识。2015 年,会更多的关注并发概念,JVM 内部,32 位 JVM 和 64 JVM的区别,单元测试及整洁的代码。我确信,如果你读过这个庞大的 Java 面试问题列表,无论是电话面试还是面对面的面试,你都能有很好的表现。 Java 面试中的重要话题 除了你看到的惊人的问题数量,我也尽量保证质量。我不止一次分享各个重要主题中的问题,也确保包含所谓的高级话题,这些话题很多程序员不喜欢准备或者直接放弃,因为他们的工作不会涉及到这些。Java NIO 和 JVM 底层就是最好的例子。你也可以将设计模式划分到这一类中,但是越来越多有经验的程序员了解 GOF 设计模式并应用这些模式。我也尽量在这个列表中包含 2015 年最新的面试问题,这些问题可能是来年关注的核心。为了给你一个大致的了解,下面列出这份 Java 面试问题列表包含的主题: 多线程,并发及线程基础 数据类型转换的基本原则 垃圾回收(GC) Java 集合框架 数组 字符串 GOF 设计模式 SOLID (单一功能、开闭原则、里氏替换、接口隔离以及依赖反转)设计原则 抽象类与接口 Java 基础,如 equals 和 hashcode 泛型与枚举 Java IO 与 NIO 常用网络协议 Java 中的数据结构和算法 正则表达式 JVM 底层 Java 最佳实践 JDBC Date, Time 与 Calendar Java 处理 XML JUnit 编程 关注我:私信回复“架构资料”获取往期Java高级架构资料、源码、笔记、视频 Dubbo、Redis、Netty、zookeeper、Spring cloud、分布式、高并发等架构技术 120 大 Java 面试题及答案 现在是时候给你展示我近 5 年从各种面试中收集来的 120 个问题了。我确定你在自己的面试中见过很多这些问题,很多问题你也能正确回答。 多线程、并发及线程的基础问题 1)Java 中能创建 volatile 数组吗? 能,Java 中可以创建 volatile 类型数组,不过只是一个指向数组的引用,而不是整个数组。我的意思是,如果改变引用指向的数组,将会受到 volatile 的保护,但是如果多个线程同时改变数组的元素,volatile 标示符就不能起到之前的保护作用了。 2)volatile 能使得一个非原子操作变成原子操作吗? 一个典型的例子是在类中有一个 long 类型的成员变量。如果你知道该成员变量会被多个线程访问,如计数器、价格等,你最好是将其设置为 volatile。为什么?因为 Java 中读取 long 类型变量不是原子的,需要分成两步,如果一个线程正在修改该 long 变量的值,另一个线程可能只能看到该值的一半(前 32 位)。但是对一个 volatile 型的 long 或 double 变量的读写是原子。 3)volatile 修饰符的有过什么实践? 一种实践是用 volatile 修饰 long 和 double 变量,使其能按原子类型来读写。double 和 long 都是64位宽,因此对这两种类型的读是分为两部分的,第一次读取第一个 32 位,然后再读剩下的 32 位,这个过程不是原子的,但 Java 中 volatile 型的 long 或 double 变量的读写是原子的。volatile 修复符的另一个作用是提供内存屏障(memory barrier),例如在分布式框架中的应用。简单的说,就是当你写一个 volatile 变量之前,Java 内存模型会插入一个写屏障(write barrier),读一个 volatile 变量之前,会插入一个读屏障(read barrier)。意思就是说,在你写一个 volatile 域时,能保证任何线程都能看到你写的值,同时,在写之前,也能保证任何数值的更新对所有线程是可见的,因为内存屏障会将其他所有写的值更新到缓存。 4)volatile 类型变量提供什么保证?(答案) volatile 变量提供顺序和可见性保证,例如,JVM 或者 JIT为了获得更好的性能会对语句重排序,但是 volatile 类型变量即使在没有同步块的情况下赋值也不会与其他语句重排序。 volatile 提供 happens-before 的保证,确保一个线程的修改能对其他线程是可见的。某些情况下,volatile 还能提供原子性,如读 64 位数据类型,像 long 和 double 都不是原子的,但 volatile 类型的 double 和 long 就是原子的。 5) 10 个线程和 2 个线程的同步代码,哪个更容易写? 从写代码的角度来说,两者的复杂度是相同的,因为同步代码与线程数量是相互独立的。但是同步策略的选择依赖于线程的数量,因为越多的线程意味着更大的竞争,所以你需要利用同步技术,如锁分离,这要求更复杂的代码和专业知识。 6)你是如何调用 wait()方法的?使用 if 块还是循环?为什么?(答案) wait() 方法应该在循环调用,因为当线程获取到 CPU 开始执行的时候,其他条件可能还没有满足,所以在处理前,循环检测条件是否满足会更好。下面是一段标准的使用 wait 和 notify 方法的代码: // The standard idiom for using the wait method synchronized(obj) { while(condition does not hold) obj.wait(); // (Releases lock, and reacquires on wakeup) ... // Perform action appropriate to condition } 参见 Effective Java 第 69 条,获取更多关于为什么应该在循环中来调用 wait 方法的内容。 7)什么是多线程环境下的伪共享(false sharing)? 伪共享是多线程系统(每个处理器有自己的局部缓存)中一个众所周知的性能问题。伪共享发生在不同处理器的上的线程对变量的修改依赖于相同的缓存行,如下图所示: 有经验程序员的 Java 面试题 伪共享问题很难被发现,因为线程可能访问完全不同的全局变量,内存中却碰巧在很相近的位置上。如其他诸多的并发问题,避免伪共享的最基本方式是仔细审查代码,根据缓存行来调整你的数据结构。 8)什么是 Busy spin?我们为什么要使用它? Busy spin 是一种在不释放 CPU 的基础上等待事件的技术。它经常用于避免丢失 CPU 缓存中的数据(如果线程先暂停,之后在其他CPU上运行就会丢失)。所以,如果你的工作要求低延迟,并且你的线程目前没有任何顺序,这样你就可以通过循环检测队列中的新消息来代替调用 sleep() 或 wait() 方法。它唯一的好处就是你只需等待很短的时间,如几微秒或几纳秒。LMAX 分布式框架是一个高性能线程间通信的库,该库有一个 BusySpinWaitStrategy 类就是基于这个概念实现的,使用 busy spin 循环 EventProcessors 等待屏障。 9)Java 中怎么获取一份线程 dump 文件? 在 Linux 下,你可以通过命令 kill -3 PID (Java 进程的进程 ID)来获取 Java 应用的 dump 文件。在 Windows 下,你可以按下 Ctrl + Break 来获取。这样 JVM 就会将线程的 dump 文件打印到标准输出或错误文件中,它可能打印在控制台或者日志文件中,具体位置依赖应用的配置。如果你使用Tomcat。 10)Swing 是线程安全的?(答案) 不是,Swing 不是线程安全的。你不能通过任何线程来更新 Swing 组件,如 JTable、JList 或 JPanel,事实上,它们只能通过 GUI 或 AWT 线程来更新。这就是为什么 Swing 提供 invokeAndWait() 和 invokeLater() 方法来获取其他线程的 GUI 更新请求。这些方法将更新请求放入 AWT 的线程队列中,可以一直等待,也可以通过异步更新直接返回结果。你也可以在参考答案中查看和学习到更详细的内容。 11)什么是线程局部变量?(答案) 线程局部变量是局限于线程内部的变量,属于线程自身所有,不在多个线程间共享。Java 提供 ThreadLocal 类来支持线程局部变量,是一种实现线程安全的方式。但是在管理环境下(如 web 服务器)使用线程局部变量的时候要特别小心,在这种情况下,工作线程的生命周期比任何应用变量的生命周期都要长。任何线程局部变量一旦在工作完成后没有释放,Java 应用就存在内存泄露的风险。 12)用 wait-notify 写一段代码来解决生产者-消费者问题?(答案) 请参考答案中的示例代码。只要记住在同步块中调用 wait() 和 notify()方法,如果阻塞,通过循环来测试等待条件。 13) 用 Java 写一个线程安全的单例模式(Singleton)?(答案) 请参考答案中的示例代码,这里面一步一步教你创建一个线程安全的 Java 单例类。当我们说线程安全时,意思是即使初始化是在多线程环境中,仍然能保证单个实例。Java 中,使用枚举作为单例类是最简单的方式来创建线程安全单例模式的方式。 14)Java 中 sleep 方法和 wait 方法的区别?(答案) 虽然两者都是用来暂停当前运行的线程,但是 sleep() 实际上只是短暂停顿,因为它不会释放锁,而 wait() 意味着条件等待,这就是为什么该方法要释放锁,因为只有这样,其他等待的线程才能在满足条件时获取到该锁。 15)什么是不可变对象(immutable object)?Java 中怎么创建一个不可变对象?(答案) 不可变对象指对象一旦被创建,状态就不能再改变。任何修改都会创建一个新的对象,如 String、Integer及其它包装类。详情参见答案,一步一步指导你在 Java 中创建一个不可变的类。 16)我们能创建一个包含可变对象的不可变对象吗? 是的,我们是可以创建一个包含可变对象的不可变对象的,你只需要谨慎一点,不要共享可变对象的引用就可以了,如果需要变化时,就返回原对象的一个拷贝。最常见的例子就是对象中包含一个日期对象的引用。 数据类型和 Java 基础面试问题 17)Java 中应该使用什么数据类型来代表价格?(答案) 如果不是特别关心内存和性能的话,使用BigDecimal,否则使用预定义精度的 double 类型。 18)怎么将 byte 转换为 String?(答案) 可以使用 String 接收 byte[] 参数的构造器来进行转换,需要注意的点是要使用的正确的编码,否则会使用平台默认编码,这个编码可能跟原来的编码相同,也可能不同。 19)Java 中怎样将 bytes 转换为 long 类型? 这个问题你来回答 :-) 20)我们能将 int 强制转换为 byte 类型的变量吗?如果该值大于 byte 类型的范围,将会出现什么现象? 是的,我们可以做强制转换,但是 Java 中 int 是 32 位的,而 byte 是 8 位的,所以,如果强制转化是,int 类型的高 24 位将会被丢弃,byte 类型的范围是从 -128 到 128。 21)存在两个类,B 继承 A,C 继承 B,我们能将 B 转换为 C 么?如 C = (C) B 22)哪个类包含 clone 方法?是 Cloneable 还是 Object? java.lang.Cloneable 是一个标示性接口,不包含任何方法,clone 方法在 object 类中定义。并且需要知道 clone() 方法是一个本地方法,这意味着它是由 c 或 c++ 或 其他本地语言实现的。 23)Java 中 ++ 操作符是线程安全的吗? 23)不是线程安全的操作。它涉及到多个指令,如读取变量值,增加,然后存储回内存,这个过程可能会出现多个线程交差。 24)a = a + b 与 a += b 的区别(答案) += 隐式的将加操作的结果类型强制转换为持有结果的类型。如果两这个整型相加,如 byte、short 或者 int,首先会将它们提升到 int 类型,然后在执行加法操作。如果加法操作的结果比 a 的最大值要大,则 a+b 会出现编译错误,但是 a += b 没问题,如下: byte a = 127; byte b = 127; b = a + b; // error : cannot convert from int to byte b += a; // ok (译者注:这个地方应该表述的有误,其实无论 a+b 的值为多少,编译器都会报错,因为 a+b 操作会将 a、b 提升为 int 类型,所以将 int 类型赋值给 byte 就会编译出错) 25)我能在不进行强制转换的情况下将一个 double 值赋值给 long 类型的变量吗?(答案) 不行,你不能在没有强制类型转换的前提下将一个 double 值赋值给 long 类型的变量,因为 double 类型的范围比 long 类型更广,所以必须要进行强制转换。 26)3*0.1 == 0.3 将会返回什么?true 还是 false?(答案) false,因为有些浮点数不能完全精确的表示出来。 27)int 和 Integer 哪个会占用更多的内存?(答案) Integer 对象会占用更多的内存。Integer 是一个对象,需要存储对象的元数据。但是 int 是一个原始类型的数据,所以占用的空间更少。 28)为什么 Java 中的 String 是不可变的(Immutable)?(answer答案) Java 中的 String 不可变是因为 Java 的设计者认为字符串使用非常频繁,将字符串设置为不可变可以允许多个客户端之间共享相同的字符串。更详细的内容参见答案。 29)我们能在 Switch 中使用 String 吗?(answer答案) 从 Java 7 开始,我们可以在 switch case 中使用字符串,但这仅仅是一个语法糖。内部实现在 switch 中使用字符串的 hash code。 30)Java 中的构造器链是什么?(answer答案) 当你从一个构造器中调用另一个构造器,就是Java 中的构造器链。这种情况只在重载了类的构造器的时候才会出现。 JVM 底层 与 GC(Garbage Collection) 的面试问题 31)64 位 JVM 中,int 的长度是多数? Java 中,int 类型变量的长度是一个固定值,与平台无关,都是 32 位。意思就是说,在 32 位 和 64 位 的Java 虚拟机中,int 类型的长度是相同的。 32)Serial 与 Parallel GC之间的不同之处?(答案) Serial 与 Parallel 在GC执行的时候都会引起 stop-the-world。它们之间主要不同 serial 收集器是默认的复制收集器,执行 GC 的时候只有一个线程,而 parallel 收集器使用多个 GC 线程来执行。 33)32 位和 64 位的 JVM,int 类型变量的长度是多数?(答案) 32 位和 64 位的 JVM 中,int 类型变量的长度是相同的,都是 32 位或者 4 个字节。 34)Java 中 WeakReference 与 SoftReference的区别?(答案) 虽然 WeakReference 与 SoftReference 都有利于提高 GC 和 内存的效率,但是 WeakReference ,一旦失去最后一个强引用,就会被 GC 回收,而软引用虽然不能阻止被回收,但是可以延迟到 JVM 内存不足的时候。 35)WeakHashMap 是怎么工作的?(答案) WeakHashMap 的工作与正常的 HashMap 类似,但是使用弱引用作为 key,意思就是当 key 对象没有任何引用时,key/value 将会被回收。 36)JVM 选项 -XX:+UseCompressedOops 有什么作用?为什么要使用?(答案) 当你将你的应用从 32 位的 JVM 迁移到 64 位的 JVM 时,由于对象的指针从 32 位增加到了 64 位,因此堆内存会突然增加,差不多要翻倍。这也会对 CPU 缓存(容量比内存小很多)的数据产生不利的影响。因为,迁移到 64 位的 JVM 主要动机在于可以指定最大堆大小,通过压缩 OOP 可以节省一定的内存。通过 -XX:+UseCompressedOops 选项,JVM 会使用 32 位的 OOP,而不是 64 位的 OOP。 37)怎样通过 Java 程序来判断 JVM 是 32 位 还是 64 位?(答案) 你可以检查某些系统属性如 sun.arch.data.model 或 os.arch 来获取该信息。 38)32 位 JVM 和 64 位 JVM 的最大堆内存分别是多数?(答案) 理论上说上 32 位的 JVM 堆内存可以到达 2^32,即 4GB,但实际上会比这个小很多。不同操作系统之间不同,如 Windows 系统大约 1.5 GB,Solaris 大约 3GB。64 位 JVM允许指定最大的堆内存,理论上可以达到 2^64,这是一个非常大的数字,实际上你可以指定堆内存大小到 100GB。甚至有的 JVM,如 Azul,堆内存到 1000G 都是可能的。 39)JRE、JDK、JVM 及 JIT 之间有什么不同?(答案) JRE 代表 Java 运行时(Java run-time),是运行 Java 引用所必须的。JDK 代表 Java 开发工具(Java development kit),是 Java 程序的开发工具,如 Java 编译器,它也包含 JRE。JVM 代表 Java 虚拟机(Java virtual machine),它的责任是运行 Java 应用。JIT 代表即时编译(Just In Time compilation),当代码执行的次数超过一定的阈值时,会将 Java 字节码转换为本地代码,如,主要的热点代码会被准换为本地代码,这样有利大幅度提高 Java 应用的性能。 3 年工作经验的 Java 面试题 40)解释 Java 堆空间及 GC?(答案) 当通过 Java 命令启动 Java 进程的时候,会为它分配内存。内存的一部分用于创建堆空间,当程序中创建对象的时候,就从对空间中分配内存。GC 是 JVM 内部的一个进程,回收无效对象的内存用于将来的分配。 JVM 底层面试题及答案 41)你能保证 GC 执行吗?(答案) 不能,虽然你可以调用 System.gc() 或者 Runtime.gc(),但是没有办法保证 GC 的执行。 42)怎么获取 Java 程序使用的内存?堆使用的百分比? 可以通过 java.lang.Runtime 类中与内存相关方法来获取剩余的内存,总内存及最大堆内存。通过这些方法你也可以获取到堆使用的百分比及堆内存的剩余空间。Runtime.freeMemory() 方法返回剩余空间的字节数,Runtime.totalMemory() 方法总内存的字节数,Runtime.maxMemory() 返回最大内存的字节数。 43)Java 中堆和栈有什么区别?(答案) JVM 中堆和栈属于不同的内存区域,使用目的也不同。栈常用于保存方法帧和局部变量,而对象总是在堆上分配。栈通常都比堆小,也不会在多个线程之间共享,而堆被整个 JVM 的所有线程共享。 关于内存的的面试问题和答案 Java 基本概念面试题 44)“a==b”和”a.equals(b)”有什么区别?(答案) 如果 a 和 b 都是对象,则 a==b 是比较两个对象的引用,只有当 a 和 b 指向的是堆中的同一个对象才会返回 true,而 a.equals(b) 是进行逻辑比较,所以通常需要重写该方法来提供逻辑一致性的比较。例如,String 类重写 equals() 方法,所以可以用于两个不同对象,但是包含的字母相同的比较。 45)a.hashCode() 有什么用?与 a.equals(b) 有什么关系?(答案) hashCode() 方法是相应对象整型的 hash 值。它常用于基于 hash 的集合类,如 Hashtable、HashMap、LinkedHashMap等等。它与 equals() 方法关系特别紧密。根据 Java 规范,两个使用 equal() 方法来判断相等的对象,必须具有相同的 hash code。 46)final、finalize 和 finally 的不同之处?(答案) final 是一个修饰符,可以修饰变量、方法和类。如果 final 修饰变量,意味着该变量的值在初始化后不能被改变。finalize 方法是在对象被回收之前调用的方法,给对象自己最后一个复活的机会,但是什么时候调用 finalize 没有保证。finally 是一个关键字,与 try 和 catch 一起用于异常的处理。finally 块一定会被执行,无论在 try 块中是否有发生异常。 47)Java 中的编译期常量是什么?使用它又什么风险? 公共静态不可变(public static final )变量也就是我们所说的编译期常量,这里的 public 可选的。实际上这些变量在编译时会被替换掉,因为编译器知道这些变量的值,并且知道这些变量在运行时不能改变。这种方式存在的一个问题是你使用了一个内部的或第三方库中的公有编译时常量,但是这个值后面被其他人改变了,但是你的客户端仍然在使用老的值,甚至你已经部署了一个新的jar。为了避免这种情况,当你在更新依赖 JAR 文件时,确保重新编译你的程序。 Java 集合框架的面试题 这部分也包含数据结构、算法及数组的面试问题 48) List、Set、Map 和 Queue 之间的区别(答案) List 是一个有序集合,允许元素重复。它的某些实现可以提供基于下标值的常量访问时间,但是这不是 List 接口保证的。Set 是一个无序集合。 49)poll() 方法和 remove() 方法的区别? poll() 和 remove() 都是从队列中取出一个元素,但是 poll() 在获取元素失败的时候会返回空,但是 remove() 失败的时候会抛出异常。 50)Java 中 LinkedHashMap 和 PriorityQueue 的区别是什么?(答案) PriorityQueue 保证最高或者最低优先级的的元素总是在队列头部,但是 LinkedHashMap 维持的顺序是元素插入的顺序。当遍历一个 PriorityQueue 时,没有任何顺序保证,但是 LinkedHashMap 课保证遍历顺序是元素插入的顺序。 51)ArrayList 与 LinkedList 的不区别?(答案) 最明显的区别是 ArrrayList 底层的数据结构是数组,支持随机访问,而 LinkedList 的底层数据结构书链表,不支持随机访问。使用下标访问一个元素,ArrayList 的时间复杂度是 O(1),而 LinkedList 是 O(n)。更多细节的讨论参见答案。 52)用哪两种方式来实现集合的排序?(答案) 你可以使用有序集合,如 TreeSet 或 TreeMap,你也可以使用有顺序的的集合,如 list,然后通过 Collections.sort() 来排序。 53)Java 中怎么打印数组?(answer答案) 你可以使用 Arrays.toString() 和 Arrays.deepToString() 方法来打印数组。由于数组没有实现 toString() 方法,所以如果将数组传递给 System.out.println() 方法,将无法打印出数组的内容,但是 Arrays.toString() 可以打印每个元素。 54)Java 中的 LinkedList 是单向链表还是双向链表?(答案) 是双向链表,你可以检查 JDK 的源码。在 Eclipse,你可以使用快捷键 Ctrl + T,直接在编辑器中打开该类。 55)Java 中的 TreeMap 是采用什么树实现的?(答案) Java 中的 TreeMap 是使用红黑树实现的。 56) Hashtable 与 HashMap 有什么不同之处?(答案) 这两个类有许多不同的地方,下面列出了一部分: a) Hashtable 是 JDK 1 遗留下来的类,而 HashMap 是后来增加的。 b)Hashtable 是同步的,比较慢,但 HashMap 没有同步策略,所以会更快。 c)Hashtable 不允许有个空的 key,但是 HashMap 允许出现一个 null key。 57)Java 中的 HashSet,内部是如何工作的?(answer答案) HashSet 的内部采用 HashMap来实现。由于 Map 需要 key 和 value,所以所有 key 的都有一个默认 value。类似于 HashMap,HashSet 不允许重复的 key,只允许有一个null key,意思就是 HashSet 中只允许存储一个 null 对象。 58)写一段代码在遍历 ArrayList 时移除一个元素?(答案) 该问题的关键在于面试者使用的是 ArrayList 的 remove() 还是 Iterator 的 remove()方法。这有一段示例代码,是使用正确的方式来实现在遍历的过程中移除元素,而不会出现 ConcurrentModificationException 异常的示例代码。 59)我们能自己写一个容器类,然后使用 for-each 循环码? 可以,你可以写一个自己的容器类。如果你想使用 Java 中增强的循环来遍历,你只需要实现 Iterable 接口。如果你实现 Collection 接口,默认就具有该属性。 60)ArrayList 和 HashMap 的默认大小是多数?(答案) 在 Java 7 中,ArrayList 的默认大小是 10 个元素,HashMap 的默认大小是16个元素(必须是2的幂)。这就是 Java 7 中 ArrayList 和 HashMap 类的代码片段: // from ArrayList.java JDK 1.7 privatestaticfinalintDEFAULT_CAPACITY = 10; //from HashMap.java JDK 7 staticfinalintDEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16 61)有没有可能两个不相等的对象有有相同的 hashcode? 有可能,两个不相等的对象可能会有相同的 hashcode 值,这就是为什么在 hashmap 中会有冲突。相等 hashcode 值的规定只是说如果两个对象相等,必须有相同的hashcode 值,但是没有关于不相等对象的任何规定。 62)两个相同的对象会有不同的的 hash code 吗? 不能,根据 hash code 的规定,这是不可能的。 63)我们可以在 hashcode() 中使用随机数字吗?(答案) 不行,因为对象的 hashcode 值必须是相同的。参见答案获取更多关于 Java 中重写 hashCode() 方法的知识。 64)Java 中,Comparator 与 Comparable 有什么不同?(答案) Comparable 接口用于定义对象的自然顺序,而 comparator 通常用于定义用户定制的顺序。Comparable 总是只有一个,但是可以有多个 comparator 来定义对象的顺序。 65)为什么在重写 equals 方法的时候需要重写 hashCode 方法?(答案) 因为有强制的规范指定需要同时重写 hashcode 与 equal 是方法,许多容器类,如 HashMap、HashSet 都依赖于 hashcode 与 equals 的规定。 Java IO 和 NIO 的面试题 IO 是 Java 面试中一个非常重要的点。你应该很好掌握 Java IO,NIO,NIO2 以及与操作系统,磁盘 IO 相关的基础知识。下面是 Java IO 中经常问的问题。 66)在我 Java 程序中,我有三个 socket,我需要多少个线程来处理? 67)Java 中怎么创建 ByteBuffer? 68)Java 中,怎么读写 ByteBuffer ? 69)Java 采用的是大端还是小端? 70)ByteBuffer 中的字节序是什么? 71)Java 中,直接缓冲区与非直接缓冲器有什么区别?(答案) 72)Java 中的内存映射缓存区是什么?(answer答案) 73)socket 选项 TCP NO DELAY 是指什么? 74)TCP 协议与 UDP 协议有什么区别?(answer答案) 75)Java 中,ByteBuffer 与 StringBuffer有什么区别?(答案) Java 最佳实践的面试问题 包含 Java 中各个部分的最佳实践,如集合,字符串,IO,多线程,错误和异常处理,设计模式等等。 76)Java 中,编写多线程程序的时候你会遵循哪些最佳实践?(答案) 这是我在写Java 并发程序的时候遵循的一些最佳实践: a)给线程命名,这样可以帮助调试。 b)最小化同步的范围,而不是将整个方法同步,只对关键部分做同步。 c)如果可以,更偏向于使用 volatile 而不是 synchronized。 d)使用更高层次的并发工具,而不是使用 wait() 和 notify() 来实现线程间通信,如 BlockingQueue,CountDownLatch 及 Semeaphore。 e)优先使用并发集合,而不是对集合进行同步。并发集合提供更好的可扩展性。 77)说出几点 Java 中使用 Collections 的最佳实践(答案) 这是我在使用 Java 中 Collectionc 类的一些最佳实践: a)使用正确的集合类,例如,如果不需要同步列表,使用 ArrayList 而不是 Vector。 b)优先使用并发集合,而不是对集合进行同步。并发集合提供更好的可扩展性。 c)使用接口代表和访问集合,如使用List存储 ArrayList,使用 Map 存储 HashMap 等等。 d)使用迭代器来循环集合。 e)使用集合的时候使用泛型。 78)说出至少 5 点在 Java 中使用线程的最佳实践。(答案) 这个问题与之前的问题类似,你可以使用上面的答案。对线程来说,你应该: a)对线程命名 b)将线程和任务分离,使用线程池执行器来执行 Runnable 或 Callable。 c)使用线程池 79)说出 5 条 IO 的最佳实践(答案) IO 对 Java 应用的性能非常重要。理想情况下,你不应该在你应用的关键路径上避免 IO 操作。下面是一些你应该遵循的 Java IO 最佳实践: a)使用有缓冲区的 IO 类,而不要单独读取字节或字符。 b)使用 NIO 和 NIO2 c)在 finally 块中关闭流,或者使用 try-with-resource 语句。 d)使用内存映射文件获取更快的 IO。 80)列出 5 个应该遵循的 JDBC 最佳实践(答案) 有很多的最佳实践,你可以根据你的喜好来例举。下面是一些更通用的原则: a)使用批量的操作来插入和更新数据 b)使用 PreparedStatement 来避免 SQL 异常,并提高性能。 c)使用数据库连接池 d)通过列名来获取结果集,不要使用列的下标来获取。 81)说出几条 Java 中方法重载的最佳实践?(答案) 下面有几条可以遵循的方法重载的最佳实践来避免造成自动装箱的混乱。 a)不要重载这样的方法:一个方法接收 int 参数,而另个方法接收 Integer 参数。 b)不要重载参数数量一致,而只是参数顺序不同的方法。 c)如果重载的方法参数个数多于 5 个,采用可变参数。 Date、Time 及 Calendar 的面试题 82)在多线程环境下,SimpleDateFormat 是线程安全的吗?(答案) 不是,非常不幸,DateFormat 的所有实现,包括 SimpleDateFormat 都不是线程安全的,因此你不应该在多线程序中使用,除非是在对外线程安全的环境中使用,如 将 SimpleDateFormat 限制在 ThreadLocal 中。如果你不这么做,在解析或者格式化日期的时候,可能会获取到一个不正确的结果。因此,从日期、时间处理的所有实践来说,我强力推荐 joda-time 库。 83)Java 中如何格式化一个日期?如格式化为 ddMMyyyy 的形式?(答案) Java 中,可以使用 SimpleDateFormat 类或者 joda-time 库来格式日期。DateFormat 类允许你使用多种流行的格式来格式化日期。参见答案中的示例代码,代码中演示了将日期格式化成不同的格式,如 dd-MM-yyyy 或 ddMMyyyy。 84)Java 中,怎么在格式化的日期中显示时区? 85)Java 中 java.util.Date 与 java.sql.Date 有什么区别? 86)Java 中,如何计算两个日期之间的差距?(程序) 87)Java 中,如何将字符串 YYYYMMDD 转换为日期? 单元测试 JUnit 面试题 89)如何测试静态方法?(答案) 可以使用 PowerMock 库来测试静态方法。 90)怎么利用 JUnit 来测试一个方法的异常? 91)你使用过哪个单元测试库来测试你的 Java 程序? 92)@Before 和 @BeforeClass 有什么区别? 编程和代码相关的面试题 93)怎么检查一个字符串只包含数字?(解决方案) 94)Java 中如何利用泛型写一个 LRU 缓存? 95)写一段 Java 程序将 byte 转换为 long? 95)在不使用 StringBuffer 的前提下,怎么反转一个字符串?(解决方案) 97)Java 中,怎么获取一个文件中单词出现的最高频率?(解决方案) 98)如何检查出两个给定的字符串是反序的?(解决方案) 99)Java 中,怎么打印出一个字符串的所有排列?(解决方案) 100)Java 中,怎样才能打印出数组中的重复元素?(解决方案) 101)Java 中如何将字符串转换为整数?(解决方案) 102)在没有使用临时变量的情况如何交换两个整数变量的值?(解决方案) 关于 OOP 和设计模式的面试题 这部分包含 Java 面试过程中关于 SOLID 的设计原则,OOP 基础,如类,对象,接口,继承,多态,封装,抽象以及更高级的一些概念,如组合、聚合及关联。也包含了 GOF 设计模式的问题。 103)接口是什么?为什么要使用接口而不是直接使用具体类? 接口用于定义 API。它定义了类必须得遵循的规则。同时,它提供了一种抽象,因为客户端只使用接口,这样可以有多重实现,如 List 接口,你可以使用可随机访问的 ArrayList,也可以使用方便插入和删除的 LinkedList。接口中不允许写代码,以此来保证抽象,但是 Java 8 中你可以在接口声明静态的默认方法,这种方法是具体的。 104)Java 中,抽象类与接口之间有什么不同?(答案) Java 中,抽象类和接口有很多不同之处,但是最重要的一个是 Java 中限制一个类只能继承一个类,但是可以实现多个接口。抽象类可以很好的定义一个家族类的默认行为,而接口能更好的定义类型,有助于后面实现多态机制。关于这个问题的讨论请查看答案。 105)除了单例模式,你在生产环境中还用过什么设计模式? 这需要根据你的经验来回答。一般情况下,你可以说依赖注入,工厂模式,装饰模式或者观察者模式,随意选择你使用过的一种即可。不过你要准备回答接下的基于你选择的模式的问题。 106)你能解释一下里氏替换原则吗? 107) 什么情况下会违反迪米特法则?为什么会有这个问题? 迪米特法则建议“只和朋友说话,不要陌生人说话”,以此来减少类之间的耦合。 108)适配器模式是什么?什么时候使用? 适配器模式提供对接口的转换。如果你的客户端使用某些接口,但是你有另外一些接口,你就可以写一个适配去来连接这些接口。 109)什么是“依赖注入”和“控制反转”?为什么有人使用? 110)抽象类是什么?它与接口有什么区别?你为什么要使用过抽象类? 111)构造器注入和 setter 依赖注入,那种方式更好?(答案) 每种方式都有它的缺点和优点。构造器注入保证所有的注入都被初始化,但是 setter 注入提供更好的灵活性来设置可选依赖。如果使用 XML 来描述依赖,Setter 注入的可读写会更强。经验法则是强制依赖使用构造器注入,可选依赖使用 setter 注入。 112)依赖注入和工程模式之间有什么不同?(答案) 虽然两种模式都是将对象的创建从应用的逻辑中分离,但是依赖注入比工程模式更清晰。通过依赖注入,你的类就是 POJO,它只知道依赖而不关心它们怎么获取。使用工厂模式,你的类需要通过工厂来获取依赖。因此,使用 DI 会比使用工厂模式更容易测试。关于这个话题的更详细讨论请参见答案。 113)适配器模式和装饰器模式有什么区别?(答案) 虽然适配器模式和装饰器模式的结构类似,但是每种模式的出现意图不同。适配器模式被用于桥接两个接口,而装饰模式的目的是在不修改类的情况下给类增加新的功能。 114)适配器模式和代理模式之前有什么不同?(答案) 这个问题与前面的类似,适配器模式和代理模式的区别在于他们的意图不同。由于适配器模式和代理模式都是封装真正执行动作的类,因此结构是一致的,但是适配器模式用于接口之间的转换,而代理模式则是增加一个额外的中间层,以便支持分配、控制或智能访问。 115)什么是模板方法模式?(答案) 模板方法提供算法的框架,你可以自己去配置或定义步骤。例如,你可以将排序算法看做是一个模板。它定义了排序的步骤,但是具体的比较,可以使用 Comparable 或者其语言中类似东西,具体策略由你去配置。列出算法概要的方法就是众所周知的模板方法。 116)什么时候使用访问者模式?(答案) 访问者模式用于解决在类的继承层次上增加操作,但是不直接与之关联。这种模式采用双派发的形式来增加中间层。 117)什么时候使用组合模式?(答案) 组合模式使用树结构来展示部分与整体继承关系。它允许客户端采用统一的形式来对待单个对象和对象容器。当你想要展示对象这种部分与整体的继承关系时采用组合模式。 118)继承和组合之间有什么不同?(答案) 虽然两种都可以实现代码复用,但是组合比继承共灵活,因为组合允许你在运行时选择不同的实现。用组合实现的代码也比继承测试起来更加简单。 119)描述 Java 中的重载和重写?(答案) 重载和重写都允许你用相同的名称来实现不同的功能,但是重载是编译时活动,而重写是运行时活动。你可以在同一个类中重载方法,但是只能在子类中重写方法。重写必须要有继承。 120)Java 中,嵌套公共静态类与顶级类有什么不同?(答案) 类的内部可以有多个嵌套公共静态类,但是一个 Java 源文件只能有一个顶级公共类,并且顶级公共类的名称与源文件名称必须一致。 121) OOP 中的 组合、聚合和关联有什么区别?(答案) 如果两个对象彼此有关系,就说他们是彼此相关联的。组合和聚合是面向对象中的两种形式的关联。组合是一种比聚合更强力的关联。组合中,一个对象是另一个的拥有者,而聚合则是指一个对象使用另一个对象。如果对象 A 是由对象 B 组合的,则 A 不存在的话,B一定不存在,但是如果 A 对象聚合了一个对象 B,则即使 A 不存在了,B 也可以单独存在。 122)给我一个符合开闭原则的设计模式的例子?(答案) 开闭原则要求你的代码对扩展开放,对修改关闭。这个意思就是说,如果你想增加一个新的功能,你可以很容易的在不改变已测试过的代码的前提下增加新的代码。有好几个设计模式是基于开闭原则的,如策略模式,如果你需要一个新的策略,只需要实现接口,增加配置,不需要改变核心逻辑。一个正在工作的例子是 Collections.sort() 方法,这就是基于策略模式,遵循开闭原则的,你不需为新的对象修改 sort() 方法,你需要做的仅仅是实现你自己的 Comparator 接口。 123)抽象工厂模式和原型模式之间的区别? 124)什么时候使用享元模式? 享元模式通过共享对象来避免创建太多的对象。为了使用享元模式,你需要确保你的对象是不可变的,这样你才能安全的共享。JDK 中 String 池、Integer 池以及 Long 池都是很好的使用了享元模式的例子。 Java 面试中其他各式各样的问题 这部分包含 Java 中关于 XML 的面试题,JDBC 面试题,正则表达式面试题,Java 错误和异常及序列化面试题 125)嵌套静态类与顶级类有什么区别?(答案) 一个公共的顶级类的源文件名称与类名相同,而嵌套静态类没有这个要求。一个嵌套类位于顶级类内部,需要使用顶级类的名称来引用嵌套静态类,如 HashMap.Entry 是一个嵌套静态类,HashMap 是一个顶级类,Entry是一个嵌套静态类。 126)你能写出一个正则表达式来判断一个字符串是否是一个数字吗?(解决方案) 一个数字字符串,只能包含数字,如 0 到 9 以及 +、- 开头,通过这个信息,你可以下一个如下的正则表达式来判断给定的字符串是不是数字。 127)Java 中,受检查异常 和 不受检查异常的区别?(答案) 受检查异常编译器在编译期间检查。对于这种异常,方法强制处理或者通过 throws 子句声明。其中一种情况是 Exception 的子类但不是 RuntimeException 的子类。非受检查是 RuntimeException 的子类,在编译阶段不受编译器的检查。 128)Java 中,throw 和 throws 有什么区别?(答案) throw 用于抛出 java.lang.Throwable 类的一个实例化对象,意思是说你可以通过关键字 throw 抛出一个 Error 或者 一个Exception,如: throw new IllegalArgumentException(“size must be multiple of 2″) 而throws 的作用是作为方法声明和签名的一部分,方法被抛出相应的异常以便调用者能处理。Java 中,任何未处理的受检查异常强制在 throws 子句中声明。 129)Java 中,Serializable 与 Externalizable 的区别?(答案) Serializable 接口是一个序列化 Java 类的接口,以便于它们可以在网络上传输或者可以将它们的状态保存在磁盘上,是 JVM 内嵌的默认序列化方式,成本高、脆弱而且不安全。Externalizable 允许你控制整个序列化过程,指定特定的二进制格式,增加安全机制。 130)Java 中,DOM 和 SAX 解析器有什么不同?(答案) DOM 解析器将整个 XML 文档加载到内存来创建一棵 DOM 模型树,这样可以更快的查找节点和修改 XML 结构,而 SAX 解析器是一个基于事件的解析器,不会将整个 XML 文档加载到内存。由于这个原因,DOM 比 SAX 更快,也要求更多的内存,不适合于解析大 XML 文件。 131)说出 JDK 1.7 中的三个新特性?(答案) 虽然 JDK 1.7 不像 JDK 5 和 8 一样的大版本,但是,还是有很多新的特性,如 try-with-resource 语句,这样你在使用流或者资源的时候,就不需要手动关闭,Java 会自动关闭。Fork-Join 池某种程度上实现 Java 版的 Map-reduce。允许 Switch 中有 String 变量和文本。菱形操作符(<>)用于类型推断,不再需要在变量声明的右边申明泛型,因此可以写出可读写更强、更简洁的代码。另一个值得一提的特性是改善异常处理,如允许在同一个 catch 块中捕获多个异常。 132)说出 5 个 JDK 1.8 引入的新特性?(答案) Java 8 在 Java 历史上是一个开创新的版本,下面 JDK 8 中 5 个主要的特性: Lambda 表达式,允许像对象一样传递匿名函数 Stream API,充分利用现代多核 CPU,可以写出很简洁的代码 Date 与 Time API,最终,有一个稳定、简单的日期和时间库可供你使用 扩展方法,现在,接口中可以有静态、默认方法。 重复注解,现在你可以将相同的注解在同一类型上使用多次。 133)Java 中,Maven 和 ANT 有什么区别?(答案) 虽然两者都是构建工具,都用于创建 Java 应用,但是 Maven 做的事情更多,在基于“约定优于配置”的概念下,提供标准的Java 项目结构,同时能为应用自动管理依赖(应用中所依赖的 JAR 文件),Maven 与 ANT 工具更多的不同之处请参见答案。 这就是所有的面试题,如此之多,是不是?我可以保证,如果你能回答列表中的所有问题,你就可以很轻松的应付任何核心 Java 或者高级 Java 面试。虽然,这里没有涵盖 Servlet、JSP、JSF、JPA,JMS,EJB 及其它 Java EE 技术,也没有包含主流的框架如 Spring MVC,Struts 2.0,Hibernate,也没有包含 SOAP 和 RESTful web service,但是这份列表对做 Java 开发的、准备应聘 Java web 开发职位的人还是同样有用的,因为所有的 Java 面试,开始的问题都是 Java 基础和 JDK API 相关的。如果你认为我这里有任何应该在这份列表中而被我遗漏了的 Java 流行的问题,你可以自由的给我建议。我的目的是从最近的面试中创建一份最新的、最优的 Java 面试问题列表。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册