首页 文章 精选 留言 我的

精选列表

搜索[物联网平台],共10000篇文章
优秀的个人博客,低调大师

ELK实时日志分析平台(elk+kafka+metricbeat)-搭建说明(一)

数据流向: metricbeat->kafka->logstash->elasticsearch->kibana. 应用分布: 主机 应用 备注 192.168.30.121 java version "1.8.0_144" zookeeper-3.4.10.tar.gz kafka_2.12-0.11.0.0.tgz elasticsearch-5.5.1.tar.gz logstash-5.5.1.tar.gz kibana-5.5.1-linux-x86_64.tar.gz 192.168.30.122 java version "1.8.0_144" zookeeper-3.4.10.tar.gz kafka_2.12-0.11.0.0.tgz elasticsearch-5.5.1.tar.gz 192.168.30.123 java version "1.8.0_144" zookeeper-3.4.10.tar.gz kafka_2.12-0.11.0.0.tgz elasticsearch-5.5.1.tar.gz 192.168.30.125 客户端 metricbeat-5.5.1-linux-x86_64 本文转自 zhuxtqw 51CTO博客,原文链接:http://blog.51cto.com/1054054/1963636,如需转载请自行联系原作者

优秀的个人博客,低调大师

RabbitMQ 高可用集群搭建及电商平台使用经验总结

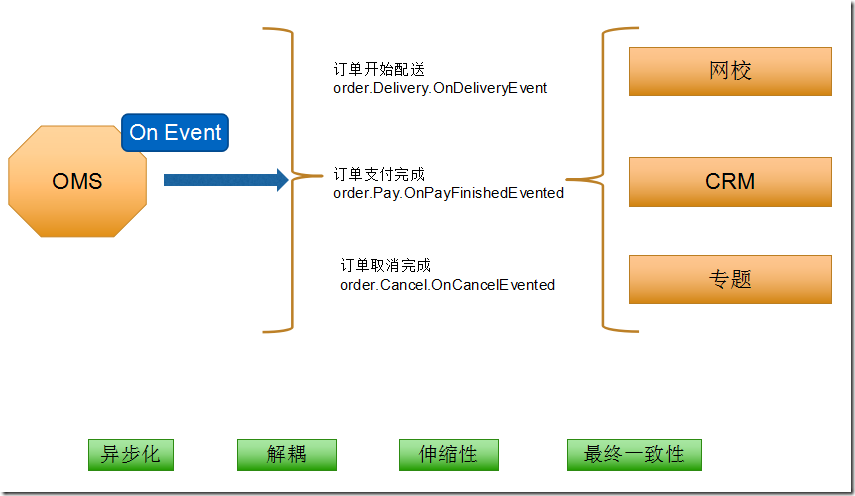
面向EDA(事件驱动架构)的方式来设计你的消息 AMQP routing key的设计 RabbitMQ cluster搭建 Mirror queue policy设置 两个不错的RabbitMQ plugin 大型应用插件(Sharding、Rederation) Queue镜像失败手动同步 各集群配置同步方式(RabbitMQ export\import) 客户端连接方式(尽量采用AMQP组来动态链接) RabbitMQ 产线二次产品化封装(消息补偿、发送消息持久化、异常处理、监控页面、重复消息剔除) 1.面向EDA(事件驱动架构)的方式来设计你的消息 在通常情况下你在使用消息中间件的时候,都是未经设计的使用,你没有把应用架构和系统架构边界搞清楚。消息中间件只是一个纯粹的技术工具,当你引入的时候是站在应用架构的角度引入的。这是架构的角度,也是架构的上帝视角,这样你就不会用到最后发现越来越混乱,而且也无法结合软件模式、方法论、最佳实践来综合提升系统的架构能力。 EDA(Event Driven Architecture,EDA) 事件驱动架构,它是一种用来在SOA或者Micro service中进行的架构模式。它的好处有几个,柔性具有很高的伸缩性。 (具体参考本人的SOA架构文章:SOA架构设计经验分享—架构、职责、数据一致性) 既然要EDA就要规划好你当前的系统边界之内有多少业务实体,这些实体是围绕着领域模型而得来。所以这里不要很主观的就定义一些你认为的事件,这些事件要根据业务实体中的对象来设计。业务实体起码是有唯一Identity的。比如,订单、商品,围绕着这些实体展开,订单可能有几个状态是比较常用的,创建、支付、配送、取消。商品可能有价格、关键属性修改等等。这些实体的抽象和提炼取决于你当前的业务。 (有关这方面内容可以参考:《领域驱动设计》、《探索CQRS和事件源》) 这些是相对理论的指导思想,有了这些之后你可以落地你的Rabbitmq,这样你就不会跑偏了。比如,你的消息名称不会是看起来没结构和层次的,deliveryMssage(配送消息)。而是应该,order.delivery.ondeliveryEvented(订单.配送.配送完成事件)这样的结构。 当你的层次结构不满足业务需求的时候,你可能还需要进一步明确事件范围,order.viporder.delivery.ondeliveryEvented(订单.VIP订单.配送.配送完成事件)。 上图是一个事件驱动的基本场景,它最瞩目的几个特性就是这几个,首先是异步化的,可以大大提高系统的抗峰值能力。然后就是解耦,这不用说了,设计模式里的观察者模式没有人不知道它的好处。伸缩性,可以按需scaleout,比如rabbitmq的node可以很方便的加入。最终一致性解决了分布式系统的CAP定理的问题。 2.AMQP routing key的设计 AMQP协议中约定了routing key的设计和交互。为了实现订阅发布功能,我们需要某种方式能够订阅自己所感兴趣的事件。所以在AMQP中的Binding中,可以根据routing key来进行模式匹配。所以,这里可以结合amqp routingkey与领域事件,发出来的事件就相当于amqp中的routingkey,这样可以完美的结合起来。 你的事件肯定是随着业务发展逐渐增加的,而这个事件集合也没办法在一开始就定义清楚,所以这里有一个需要注意的就是,绑定的时候千万不要写死具体的routing key。比如,order.delivery.OnDeliveryEvented,这是订单配送,此时你Binding的时候routingkey就写成了”order.delivery.OnDeliveryEvented”。未来订单事件一扩展,就会很麻烦,不相关的事件都被订阅到,无法细化或者事件你无法获取到,因为routingkey改变了。所以在绑定的时候记住具体点绑定,也就是借助字符串的模式匹配绑定,比如,*.delivery.*,*.onDeliveryEvented”这样。将来越来越多的routingkey和event出来都不会影响你的绑定。你只需要根据自己的关心程度,绑定在事件的不同层级上即可。 上图中,orderBinding绑定了order事件,它订阅了顶级事件,也就是说未来任何类型的订单都可以被订阅到,比如,order.normalorder.delivery.onDeliveryEvent也可以被订阅到。而viporderBinding订阅了viporder事件,如果发送了一个order.normalorder.delivery.onDeliveryEvent就跟它没关系了。 3.RabbitMQ cluster搭建 搞清楚了应用架构的事情,我们开始着手搭建RabbitMQ cluster。rabbitmq这款AMQP产品是用erlang开发的,那么我们稍微介绍下erlang。 我第一次正式接触erlang就是从rabbitmq开始的,一开始并没有太多感觉到特别的地方,后来才明白越明白越发现挺喜欢这门语言的。喜欢的理由就是,它是天然的分布式语言。这句话说起来好像挺平常的,但是当你明白了.erlang.cookie机制之后才恍然大悟。瞬间顿悟了,为什么要用erlang来搞rabbitmq,而是它真的很适合信息交换之类的软件。erlang是爱立信公司开发的专门用来开发高性能信息交换机的,想想也会觉得那些软件的性能和稳定性要求是极高的。RabbitMQ的节点发现和互连真的很方便,这在erlang的虚拟机中就集成了,而且具有高度容错能力。反正我对它很有好感。 还有一点值得骄傲的是RabbitMQ是伟大的pivotal公司的,你应该知道pivotal公司是干什么的,如果你还不清楚建议你立刻google下。 一开始我并没有太关注他们的copyright,后来对pivotal公司越来越佩服之后突然看到原来RabbitMQ也是他们家的,突然信心倍增。这就是影响力和口碑,看看人家公司的spring、springboot、spring cloud,佩服的五体投地。(RabbtiMQ 官网:http://www.rabbitmq.com/) 3.1.安装erlang & RabbitMQ 要想安装RabbitMQ,首先需要安装和配置好它的宿主环境erlang。去erlang官网下载好erlang otp_src源码包,然后在本地执行源码安装。(erlang官网:http://www.erlang.org/) 由于我本机已经下载好了otp_src源码包,我是使用的otp_src_19.1版本。下载好之后解压缩,然后进入目录,执行./configure --prefix=/usr/erlang/,进行环境的检查和安装路径的选择。如果你提示“No curses library functions found”错误,是因为缺少curses库,yum install –y ncurses-devel。安装后在进行configure。 如果没有报错的话,就说明安装成功了。你还需要配置下环境变量: export PATH=$PATH:/usr/erlang/bin source /etc/profile 此时使用erl命令检查下erlang是否能正常工作了。 接下来安装RabbitMQ,去官网下载运行的包就行了。 同样要配置下环境变量,这样你的命令才能被系统查找到。然后运行rabbitmq实例。 这里有一个需要注意,记得配置下hosts,在127.0.0.1里加上本机的名称。erlang进程需要host来进行连接,所以它会检查你的hosts配置。还需要设置下防火墙,三个端口要打开。15672是管理界面用的,25672是集群之间使用的端口,4369是erlang进程epmd用来做node连接的。 我配置了两个节点,192.168.0.105、192.168.0.107,现在已经全部就绪。我们添加原始账号进入rabbitmq管理界面。 3.2.配置RabbitMQ cluster 先保证你的各个rabbitmq节点都是可以访问的,且打开rabbitmq_management plugin,这样可以当出现某个节点挂掉之后可以切换到其他管理界面查看情况或者管理。 打开管理界面插件: rabbitmq-plugins enable rabbitmq_management 添加账号: rabbitmqctl add_user admin admin 添加 权限tag rabbitmqctl set_user_tags admin administrator 保证两个节点都是可以正常工作的。下面我们就将这两个节点连接起来形成高可用的cluster,这样我们就可以让我们的exchange、queue在这两个节点之间复制,形成高可用的queue。 cd 到你的home目录下,我是在root下,里面有一个隐藏的.erlang.cookie文件,这就是我在前面介绍erlang时候提到的,这个文件是erlang用来发现和互连的基础。我们需要做的很简单,将两个节点中的.erlang.cookie设置成一样的。这是erlang的约定,一样的cookie hash key他认为是合法和正确的连接。 .erlang.cookie默认是只读的,你需要修改下写入权限,然后复制粘贴下cookie 字符串即可。 chmod u+w .erlang.cookie 配置好了之后接下来配置hosts文件,erlang会使用hosts文件里的配置去发现节点。 vim /etc/hosts 192.168.0.107 rabbitmq_node2 192.168.0.105 rabbitmq_node1 保证同样的配置在所有的节点上都是相同的。验证你配置的正确不正确你只需要在你的机器上ping rabbitmq_node1,试下请求的ip是不是你配置的即可。按照DNS的请求原理,hosts是最高优先权,除非浏览器有缓存,你直接用ping就不会有问题的。 选择一个节点stop,然后连接到另外节点。 rabbitmqctl stop_app rabbitmqctl join_cluster rabbit@rabbitmq_node2 Clustering node rabbit@rabbitmq_node1 with rabbit@rabbitmq_node2 ... rabbitmqctl start_app 节点已经连接成功。 默认情况下节点占用的memory是总内存的40%,可以根据自己的用途仔细研究rabbitmq的配置项。为了提高性能,不需要两个节点都是disc的节点,所以我们需要启动一个节点为RAM模式。 rabbitmqctl change_cluster_node_type ram 改变rabbitmq_node1为内存节点模式。 4.Mirror queue policy设置 节点是准备好了,接下来我们需要设置exchange、queue 高可用策略,这样才能真的做到高可用。现在是物理上的机器或者说虚拟机节点是高可用的,但是里面的对象需要我们进行配置策略。 RabbitMQ支持很好的策略模式,需要管理员才能操作。 首先我们需要创建一个属于自己业务范围内的vhost,标示一个逻辑上的独立空间,所有的账号、策略、队列都是强制在某个虚拟机里的。我创建了一个common vhost。 开始添加policie。 最主要是Apply to ,可以作用在exchange或者queues上,当然也可以包含这两个。策略选择还是比较丰富的,最常用的是HAmode,还有MessageTTL(消息的过期时间)。这些策略按照几个维度分组了,有跟高可用相关的,有Federation(集群之间同步消息)相关的 ,有Queue相关的,还有Exchange相关的。可以根据的业务场景进行调整。 我们定义了策略的匹配模式.order.,这样可以避免将所有的exchange、queue都镜像了。 我们新建了一个ex.order.topic exchange,它的features中应用了exchange_queue_ha策略。(相同的策略是无法叠加使用的。)其他的exchange并没有应用这个策略,是因为我们的pattern限定了只匹配.order.的名称。 创建一个qu.order.crm queue,注意看它的node属性里有一个”Synchronised mirrors:rabbit@rabbitmq_node2“镜像复制。features里也应用了exchange_queue_ha策略。这个时候,队列其实在两个节点里都是有的,虽然我们创建的时候是在rabbit@rabbitmq_node1里的,但是它会复制到集群里的其他节点。在创建HAmode的时候可以提供HA params参数,来限定复制节点的个数,这通常用来提高性能和HA之间的平衡。 5.两个不错的RabbitMQ plugin 大型应用插件(Sharding、Rederation) 在rabbitmq-plugins中有两个plugin还是可以试着研究研究的。rabbitmq-plugins list。 rabbitmq-plugins list Configured: E = explicitly enabled; e = implicitly enabled | Status: * = running on rabbit@rabbitmq_node1 |/ [e*] amqp_client 3.6.5 [ ] cowboy 1.0.3 [ ] cowlib 1.0.1 [e*] mochiweb 2.13.1 [ ] rabbitmq_amqp1_0 3.6.5 [ ] rabbitmq_auth_backend_ldap 3.6.5 [ ] rabbitmq_auth_mechanism_ssl 3.6.5 [ ] rabbitmq_consistent_hash_exchange 3.6.5 [ ] rabbitmq_event_exchange 3.6.5 [ ] rabbitmq_federation 3.6.5 [ ] rabbitmq_federation_management 3.6.5 [ ] rabbitmq_jms_topic_exchange 3.6.5 [E*] rabbitmq_management 3.6.5 [e*] rabbitmq_management_agent 3.6.5 [ ] rabbitmq_management_visualiser 3.6.5 [ ] rabbitmq_mqtt 3.6.5 [ ] rabbitmq_recent_history_exchange 1.2.1 [ ] rabbitmq_sharding 0.1.0 [ ] rabbitmq_shovel 3.6.5 [ ] rabbitmq_shovel_management 3.6.5 [ ] rabbitmq_stomp 3.6.5 [ ] rabbitmq_top 3.6.5 [ ] rabbitmq_tracing 3.6.5 [ ] rabbitmq_trust_store 3.6.5 [e*] rabbitmq_web_dispatch 3.6.5 [ ] rabbitmq_web_stomp 3.6.5 [ ] rabbitmq_web_stomp_examples 3.6.5 [ ] sockjs 0.3.4 [e*] webmachine 1.10.3 rabbitmq_sharding、rabbitmq_federation,rabbitmq_sharding的版本有点低了,github地址:https://github.com/rabbitmq/rabbitmq-sharding Rederation 可以用来进行跨cluster或者node之间同步消息。http://www.rabbitmq.com/federated-exchanges.html 这个用来在不同的domain之间传递消息还是个不错的解决方案,跨机房或者跨网络区域,订阅别人的rabbitmq消息始终不太稳定,可以用这种方式来传递消息。 6.Queue镜像失败手动同步 有时候可能由于各种原因导致queue mirror失败,这个时候可以手动进行同步,而不是像其他分布式系统来重启节点或者重建数据。 这个还是比较方便的,有时候总有那么几个小问题需要你手动处理的。 7.各集群配置同步方式(RabbitMQ export\import) 各个环境的集群配置同步也是个日常运维的问题,还好RabbitMQ也提供了相关工具。 8.客户端连接方式(尽量采用AMQP组来动态链接) 由于RabbitMQ是AMQP协议的实现,所以在进行远程连接的时候尽量采用amqp协议的方式连接。 var amqpList = new List<AmqpTcpEndpoint> { new AmqpTcpEndpoint(new Uri("amqp://192.168.0.105:5672")), new AmqpTcpEndpoint(new Uri("amqp://192.168.0.107:5672")) }; 关于集群的vip方案其实也是需要综合考虑的,如果是统一的地址会面临三个问题,DNS、LoadBalance、VIP,这三个点都有可能导致集群连接不上。现在越来越多的方案倾向于在客户端做负载和故障转移,这有很多好处,消除了中间节点带来的故障概率。如果这三个点加在一起出现的可用性指标肯定是比直接在客户端连接的低的多。 我们碰到最多就是VIP的问题,这类系统的VIP不同于数据库,数据库的master\slave大多都是要人工check后才切换,不会随便自动的切换主从库。而非数据库的VIP大多都是Keepalived自动检测切换,这带来一些列问题,包括连接重试、心跳保持。这只是VIP的出错场景之一。还有LoadBalance带来的问题,DNS出错的可能性也是很大。所以我倾向于使用客户端来做这些。 有几个地方很重要,第一个就是消息的Persistent持久化状态要带上,第二个就是ContentType,这个属性很实用,方便你查看消息的正文。 如果没设置,默认是null。 第三个就是AutomaticRecoveryEnabled,自动连接重试,这致命重要。当上面的VIP切换之后这个可以保命。第四个就是TopologyRecoveryEnabled,重新恢复Exchange、queue、binding。在出现网络断开之后,一旦恢复连接就会恢复这些设置以保证是最新的设置。 9.RabbitMQ 产线二次产品化封装(消息补偿、发送消息持久化、异常处理、监控页面、重复消息剔除) 不管rabbitmq保证的多么强壮,多么高可用,记住一定要有备用方案。 在之前我写了一篇文章,WebAPi的可视化输出模式(RabbitMQ、消息补偿相关)——所有webapi似乎都缺失的一个功能 说了就是消息的持久化和补偿。 一旦将发送和接受的消息持久化之后我们能做到事情就比较多了。消息补偿是可以做的,异常也不用担心。但是在发送消息的时候一定要注意,是先持久化消息在业务逻辑处理。为了应对特殊活动的监控,还可以开发一定的业务来监控消息的接受和处理的数量,然后自动补偿。 在开发补偿程序的时候有一个逻辑挺饶人的,当你对某一个消息进行补偿的时候会多出发送消息,而接受的消息肯定是比你发送的少。所以你在统计的时候记得DISTINCT下。 本文转自 王清培 51CTO博客,原文链接:http://blog.51cto.com/wangqingpei557/1881540,如需转载请自行联系原作者

优秀的个人博客,低调大师

zabbix详解:(一)使用docker搭建安装zabbix3.2监控平台

docker是什么,还有怎么用,请看我另一篇博客,希望你们看懂了,然后还能用得上. 至于zabbix,应该是挺出名的服务器监控软件了,简单灵活而又智能化,还能调用API,比起我以前用的nagios感觉还简单一些,下面来介绍在docker环境安装zabbix3.2. 首先说说3.2这个版本是最新版,这个版本和之前2.X的差异,主要在于UI优化,还有加强了一些自动发现的功能,性能优化等,很多人担心太新稳定性不行,但是我这边稳定性暂时没发现问题. 安装前要准备一套LNMP环境,因为zabbix本身也是web系统,怎么安装LNMP,我就不在这里详细说了,也不应再篇幅之内,各位自行安装. 启动docker容器: 我标题写的是使用docker搭建,所以先用docker启动一个容器来实现,不过比较遗憾,我并不打算详细说docker的事情,各位就请看我另一篇文章了,我这边直接用自己已经定义好的模板来做了,命令如下: 1 dockerrun-ti--namezabbix-test1--restart=on-failure:3-c256-m1g--memory-swap=-1-p25001:22-p10050:10050-p10051:10051- v /data/zabbix : /data - v /mnt/soft : /soft centos /test :zabbix-test1 /bin/init .sh 具体意思还是得说说的,不然真的云里雾里,这里创建了一个叫zabbix-test1的容器,分配了256份cpu,1G内存,把22端口映射到25001,把10050和10051映射到母机相同的端口,并挂载相关要使用的文件夹. 里面已经有安装好的LNMP环境,端口映射也直接能用,我不用装服务器了,也不用拉一大堆依赖包,相当方便,所以LNMP环境也不准备细说了,没错,docker就是这点爽. 安装: 安装前嘛,当然是先下载软件了,可以去这个网站: http://www.zabbix.com/download 其他不用研究了,我们只看Zabbix Sources源码包系列和Zabbix pre-compiled agents监控节点程序 监控节点稍后再说,现在来看用源码安装zabbix server和agent,zabbix的源码包已经有了一整套的环境,按着流程来做就完全没问题了 创建、导入zabbix数据库: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 #进入软件包下载目录,没有定性,只是我喜欢放到这里 cd /opt/ #解压 tar xfzabbix-3.2.1. tar .gz #里面有几种数据库,但是我们用mysql,所以进入mysql数据库创建脚本目录, cd /opt/zabbix-3 .2.1 /database/mysql #列出文件,可以看到有schema.sql、images.sql、data.sql这三个文件 ls -l total3064 -rw-r--r--1wwwwww1032494Sep3017:47data.sql -rw-r--r--1wwwwww1978341Sep3017:43images.sql -rw-r--r--1wwwwww122134Sep3017:47schema.sql #进入准备好的mysql数据库,输入密码,进入MySQL控制台 mysql-uroot-pXXXXXX #创建数据库zabbix,并且数据库编码使用utf8 createdatabasezabbixcharacter set utf8; #刷新系统授权表 #新建账户zabbix,密码zabbix,一般情况下,直接用下面一种方法就可以 insertintomysql.user(Host,User,Password)values( 'localhost' , 'zabbix' ,password( 'zabbix' )); flushprivileges; #允许账户zabbix能从本机连接到数据库zabbix grantallonzabbix.*to 'zabbix' @ 'localhost' identifiedby 'zabbix' flushprivileges; #进入数据库,准备导库 usezabbix #注意:请按照以上顺序进行导入,否则会出错。 #导入脚本文件到zabbix数据库 source /opt/zabbix-3 .2.1 /database/mysql/schema .sql #导入脚本文件到zabbix数据库 source /opt/zabbix-3 .2.1 /database/mysql/images .sql #导入脚本文件到zabbix数据库 source /opt/zabbix-3 .2.1 /database/mysql/data .sql #退出 exit #也可以或者这样导入 mysql-uzabbix-p123456-hlocalhostzabbix< /opt/zabbix-3 .2.1 /database/mysql/schema .sql mysql-uzabbix-p123456-hlocalhostzabbix< /opt/zabbix-3 .2.1 /database/mysql/images .sql mysql-uzabbix-p123456-hlocalhostzabbix< /opt/zabbix-3 .2.1 /database/mysql/data .sql 安装zabbix: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 1、添加用户: #创建用户组zabbix groupaddzabbix #创建用户zabbix,并且把用户zabbix加入到用户组zabbix中 useradd zabbix-gzabbix-s /bin/false 2、安装依赖包 #CentOS使用yum命令安装,如果在安装Web环境LAMP或者LNMP时已经安装过,此步骤可忽略 yum install net-snmp-develcurlcurl-develmysql-devel apt-get install -ylibsnmp-devlibmysqld-devcurl 3、安装zabbix #进入安装目录 cd /opt/zabbix-3 .2.1 #配置, . /configure --prefix= /usr/local/zabbix -- enable -server-- enable -agent--with-net-snmp--with-libcurl-- enable -proxy--with-mysql= /usr/bin/mysql_config #如果报错,那就要:find/-namemysql_config查找位置,如果没有mysql_config,需要安装yuminstallmysql-devel或者查看mysqlclinet.so库文件 #完成后编译 make #最后安装 make install #添加命令软连接 ln -s /usr/local/zabbix/sbin/ * /usr/local/sbin/ #添加命令软连接 ln -s /usr/local/zabbix/bin/ * /usr/local/bin/ 4、添加zabbix服务对应的端口 #编辑,在最后添加以下代码,一般系统会自带,不过多添加也不影响 vi /etc/services #Zabbix zabbix-agent10050 /tcp #ZabbixAgent zabbix-agent10050 /udp #ZabbixAgent zabbix-trapper10051 /tcp #ZabbixTrapper zabbix-trapper10051 /udp #ZabbixTrapper #保存退出 :wq! 5、修改zabbix配置文件 cd /usr/local/zabbix/etc #修改zabbixserver端的配置 vi /usr/local/zabbix/etc/zabbix_server .conf #数据库名称 DBName=zabbix #数据库用户名 DBUser=zabbix #数据库密码 DBPassword=zabbix #数据库ip地址,如果是远程地址,要记得改 ListenIP=localhost #数据库端口,同上配合 DBPort=3306 #zabbix运行脚本存放目录,如果是自定义脚本,就自己考虑要怎么改 AlertScriptsPath= /usr/local/zabbix/share/zabbix/alertscripts #保存退出 :wq! #修改zabbixagent端的配置,因为是本机,要改的地方很少 vi /usr/local/zabbix/etc/zabbix_agentd .conf #额外自定义监控配置文件的存放位置,有自定义监控就一定要设置了 Include= /usr/local/zabbix/etc/zabbix_agentd .conf.d/ #启用自定义key UnsafeUserParameters=1 #保存退出 :wq! 6、添加开机启动脚本 #服务端,如果只是需要客户端,可以忽略这个 cp /usr/local/src/zabbix-3 .2.1 /misc/init .d /fedora/core/zabbix_server /etc/init .d /zabbix_server #客户端 cp /usr/local/src/zabbix-3 .2.1 /misc/init .d /fedora/core/zabbix_agentd /etc/init .d /zabbix_agentd #添加脚本执行权限 chmod +x /etc/init .d /zabbix_server #添加脚本执行权限 chmod +x /etc/init .d /zabbix_agentd #添加开机启动,centos7之后会不一样,各位自己看情况 chkconfigzabbix_serveron #添加开机启动,如果只是需要客户端,可以忽略这个 chkconfigzabbix_agentdon 7、修改zabbix开机启动脚本中的zabbix安装目录 #编辑服务端配置文件 vi /etc/init .d /zabbix_server #zabbix安装目录 BASEDIR= /usr/local/zabbix/ #保存退出 :wq! #编辑客户端配置文件 vi /etc/init .d /zabbix_agentd #zabbix安装目录 BASEDIR= /usr/local/zabbix/ #保存退出 :wq! 配置web站点(php代码): 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #进入zabbix源码包目录 cd /opt/zabbix-3 .2.1 #拷贝zabbix的php文件到已经安装并定义好的LNMP代码目录 cp -r /usr/local/src/zabbix-3 .2.1 /frontends/php /data/htdocs/www/zabbix #更改好属主权限,是nginx的权限,我这里是www用户 chown www:www-R /data/htdocs/www/zabbix 备注: /data/htdocs/www 为我自己设置的Nginx默认站点目录www为Nginx运行账户 #启动zabbix服务端 servicezabbix_serverstart #启动zabbix客户端 servicezabbix_agentdstart #编辑修改php配置,不然会用不了 vi /etc/php .ini post_max_size=16M max_execution_time=300 max_input_time=300 #保存退出 :wq! #编辑修改 vi /usr/local/php/etc/php-fpm .conf request_terminate_timeout=300 #保存退出 :wq! #重启php-fpm servicephp-fpmreloa 不过,还要多做一个事,修改web界面为中文,因为虽然zabbix自带中文语言包,但是翻译效果惨不忍睹(谁叫电脑是美国发明的呢),有很多乱码,所以需要改善一下, 1、修改系统配置文件,让web页面支持简体中文显示,新版本其实已经改好,但是还是要注意这个地方,别被坑 1 2 3 4 5 6 7 #编辑修改 vi /data/htdocs/www/zabbix/include/locales .inc.php 'zh_CN' =>array( 'name' =>_( 'Chinese(zh_CN)' ), 'display' => false ), #修改为 'zh_CN' =>array( 'name' =>_( 'Chinese(zh_CN)' ), 'display' => true ), #保存退出 :wq! 2、替换监控图像上系统默认的字体,默认字体如果不替换,图像上会显示乱码 在Windows系统中的C:\Windows\Fonts目录中复制出一个中文字体文件,例如msyh.ttf是微软雅黑 1 2 3 4 5 6 #把字体文件msyh.ttf上传到zabbix站点根目录下fonts文件夹中 cp -armsyh.ttf /data/htdocs/www/zabbix/fonts/msyh .ttf #备份默认的字体文件: mv DejaVusSans.ttfDejaVusSans.ttf.bak #修改msyh.ttf名称为DejaVusSans.ttf mv msyh.ttfDejaVusSans.ttf 最后,在web界面修改配置信息,把默认语言修改为简体中文,这个后面再说明在哪里改 Language:Chinese(zh_CN) 安装web: 这个步骤主要是在web运行,zabbix的web和zabbix_server是两回事,和zabbix_agent是三回事,所以配置都是不一样的,下面来看看. 先打开已经配置好的web站点,你的LNMP环境没问题就可以正常了. 进入http://10.27.X.X/zabbix看到欢迎界面,直接右下角下一步: 这里全是ok的话,你就可以下一步了.这里是否ok取决于你LNMP的配置环境符不符合他的要求,有一个不ok,你就不能下一步了,这里也看到了,php要5.4以上,还有一些特定的php配置.不过,如果不ok也会有提示的,只要不是软件版本不兼容的问题,按着他提示的来改配置,也是能过的: 这一步就是配置数据库了,你的zabbix_server是怎么配置的,就怎么配置吧,然后下一步就行,当然你要保证数据库能连得上是吧: 这一步是确认你自己的地址和端口,要不是你自己闲的蛋疼做了什么特殊的网络配置,直接下一步就可以了: 这一步就是确认你之前提交过的数据,生成表单,然后提交,属于检查吧,检查过没问题就下一步吧: 这步就是完成配置了,直接点finish就行了,你的zabbix就配置完成了. 登录使用: 详细的使用方法会在下一篇深入探讨,这里只说明怎么登录和简单使用 默认的账号:admin 默认的密码:zabbix Sign in 登录进去 当然你是可以改的,进去再改吧 进去了就是这样,当然这是我有一些机器了,不要紧张为什么和我不一样: 修改密码和语言就点右上角的小人头然后就出来一个修改框让你改了,改成什么你们随意: 想要添加用户,就点击管理--用户,去添加和修改用户,你也可以添加用户群组,还可以配置特定权限,这个自己摸索,不想详细说明了 然后,这就能用了,当然还要添加机器了,不然还看啥,不过要下一篇再详细说明,敬请期待. 本文转自arthur376 51CTO博客,原文链接:http://blog.51cto.com/arthur376/1875442,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册