首页 文章 精选 留言 我的

精选列表

搜索[openstack],共3159篇文章
优秀的个人博客,低调大师

访问 Neutron 外部网络 - 每天5分钟玩转 OpenStack(143)

前面我们学习了位于不同 Neutron subnet 的 instance 可以通过 router 通信,今天开始讨论 instance 如何访问外部网络。 这里的外部网络是指的租户网络以外的网络。租户网络是由 Neutron 创建和维护的网络。 外部网络不由 Neutron 创建。如果是私有云,外部网络通常指的是公司 intranet;如果是公有云,外部网络通常指的是 internet。 具体到我们的实验网络环境: 计算节点和控制节点 eth1 提供的是租户网络,IP 段租户可以自由设置。 控制节点 eth2 连接的就是外部网络,IP 网段为 10.10.10.2/24。如下图所示: 配置准备 为了连接外部网络,需要预先在配置文件中告诉 Neutron 外部网络的类型以及对应的 Open vSwitch 网桥。 外部网络是已经存在的物理网络,一般都是 flat 或者 vlan 类型。 这里我们将外部网络的 label 命名为 “external”,网桥为 br-ex。 如果类型为 flat,控制节点 /etc/neutron/plugins/ml2/ml2_conf.ini 配置如下: 如果类型为 vlan,配置如下: 在我们的网络环境中,外部网络是 flat 类型。 修改配置后,需要重启 neutron 的相关服务。另外,我们需要提前准备好 br-ex,将 eth2 添加到 br-ex。 br-ex 已经存在,我们只需要添加 eth2。 下一节我们演示如何创建外部网络 ext_net。

优秀的个人博客,低调大师

Neutron Router 工作原理 - 每天5分钟玩转 OpenStack(142)

上一节我们创建了 router 连通了 vlan100 和 vlan101, 今天分析router是如何工作的。首先查看控制节点的网络结构发生了什么变化: br-int 上多了两个 port: 1. qr-d295b258-45,从命名上可以推断该 interface 对应 router_100_101 的 interface (d295b258-4586),是 subnet_172_16_100_0 的网关。2. qr-2ffdb861-73,从命名上可以推断该 interface 对应 router_100_101 的 interface (2ffdb861-731c),是 subnet_172_16_101_0 的网关。 与 linux bridge 实现方式一样, router_100_101 运行在自己的 namespace 中。 如上所示,qrouter-a81cc110-16f4-4d6c-89d2-8af91cec9714 为 router 的 namespace,两个 Gateway IP 分别配置在 qr-2ffdb861-73 和 qr-d295b258-45 上。 当前网络结构如图所示: route_101_101 上配置了 vlan100 和 vlan101 的网关,两个网络在三层上就通了。 下一节我们讨论 neutron 网络中的 instance 如何访问外网。

优秀的个人博客,低调大师

创建 OVS flat network - 每天5分钟玩转 OpenStack(134)

上一节完成了 flat 的配置工作,今天创建 OVS flat network。Admin -> Networks,点击 “Create Network” 按钮。 显示创建页面。 Provider Network Type 选择 “Flat”。 Physical Network 填写 “default”,与 ml2_conf.ini 中 flat_networks 参数值保持一致。 点击 “Create Network”,flat_net 创建成功。 点击 flat_net 链接,进入 network 配置页面,目前还没有 subnet,点击 “Create Subnet” 按钮。 设置 IP 地址为 “172.16.1.0/24”。 点击 “Next”,勾选 “Enable DHCP”。 点击 “Create”,subnet 创建成功。 底层网络发生了什么变化 查看控制节点的网络结构,执行 ovs-vsctl show: Neutron 自动在 br-int 网桥上创建了 flat-net dhcp 的接口 “tap83421c44-93”。 此时 flat_net 结构如图所示: 下一节部署 instance 并验证 flat 网络的连通性。

优秀的个人博客,低调大师

创建 OVS Local Network - 每天5分钟玩转 OpenStack(129)

上一节我们完成了 OVS 的准备工作,本节从最基础的 local network 开始学习。local network 不会与宿主机的任何物理网卡连接,流量只被限制在宿主机内,同时也不关联任何的 VLAN ID。 创建第一个 local network 下面我们通过 Web GUI 创建 local network。 进入菜单 Admin -> Networks,点击 “Create Network” 按钮。 显示创建页面。 “Provider Network Type” 选择 “Local”,点击 “Create Network”,first_local_net 创建成功。 点击 first_local_net 链接,进入 network 配置页面,目前还没有 subnet,点击 “Create Subnet” 按钮。 设置 IP 地址为 “172.16.1.0/24”。 点击 “Next”。 勾选 “Enable DHCP”,IP 池设置为 “172.16.1.2,172.16.1.99”。 点击 “Create”,subnet 创建成功。 同时 devstack-controler 针对此 subnet 的 DHCP 服务也已经 Active。 底层网络发生了什么变化? 创建 OVS local network 的过程与 Linux Bridge 没有什么区别。这是因为 Neutron 已经对不同 driver 进行了抽象,但底层实现肯定是有区别的。所以,接下来我们要搞清楚底层网络有了哪些变化? 打开控制节点的 shell 终端,用 ovs-vsctl show 查看当前 Open vSwitch 的状态。 可以看到 Neutron 自动在 br-int 网桥上创建了 port “tap7970bdcd-f2”。 从命名可知,该 port 对应 local_net 的 dhcp 接口。 与 linux bridge driver 一样,dhcp 设备也是放在命名空间里的。 目前网络结构如下图所示: 下节我们会部署 instance 到 first_local_network 并再次观察这张网络拓扑图的变化。

优秀的个人博客,低调大师

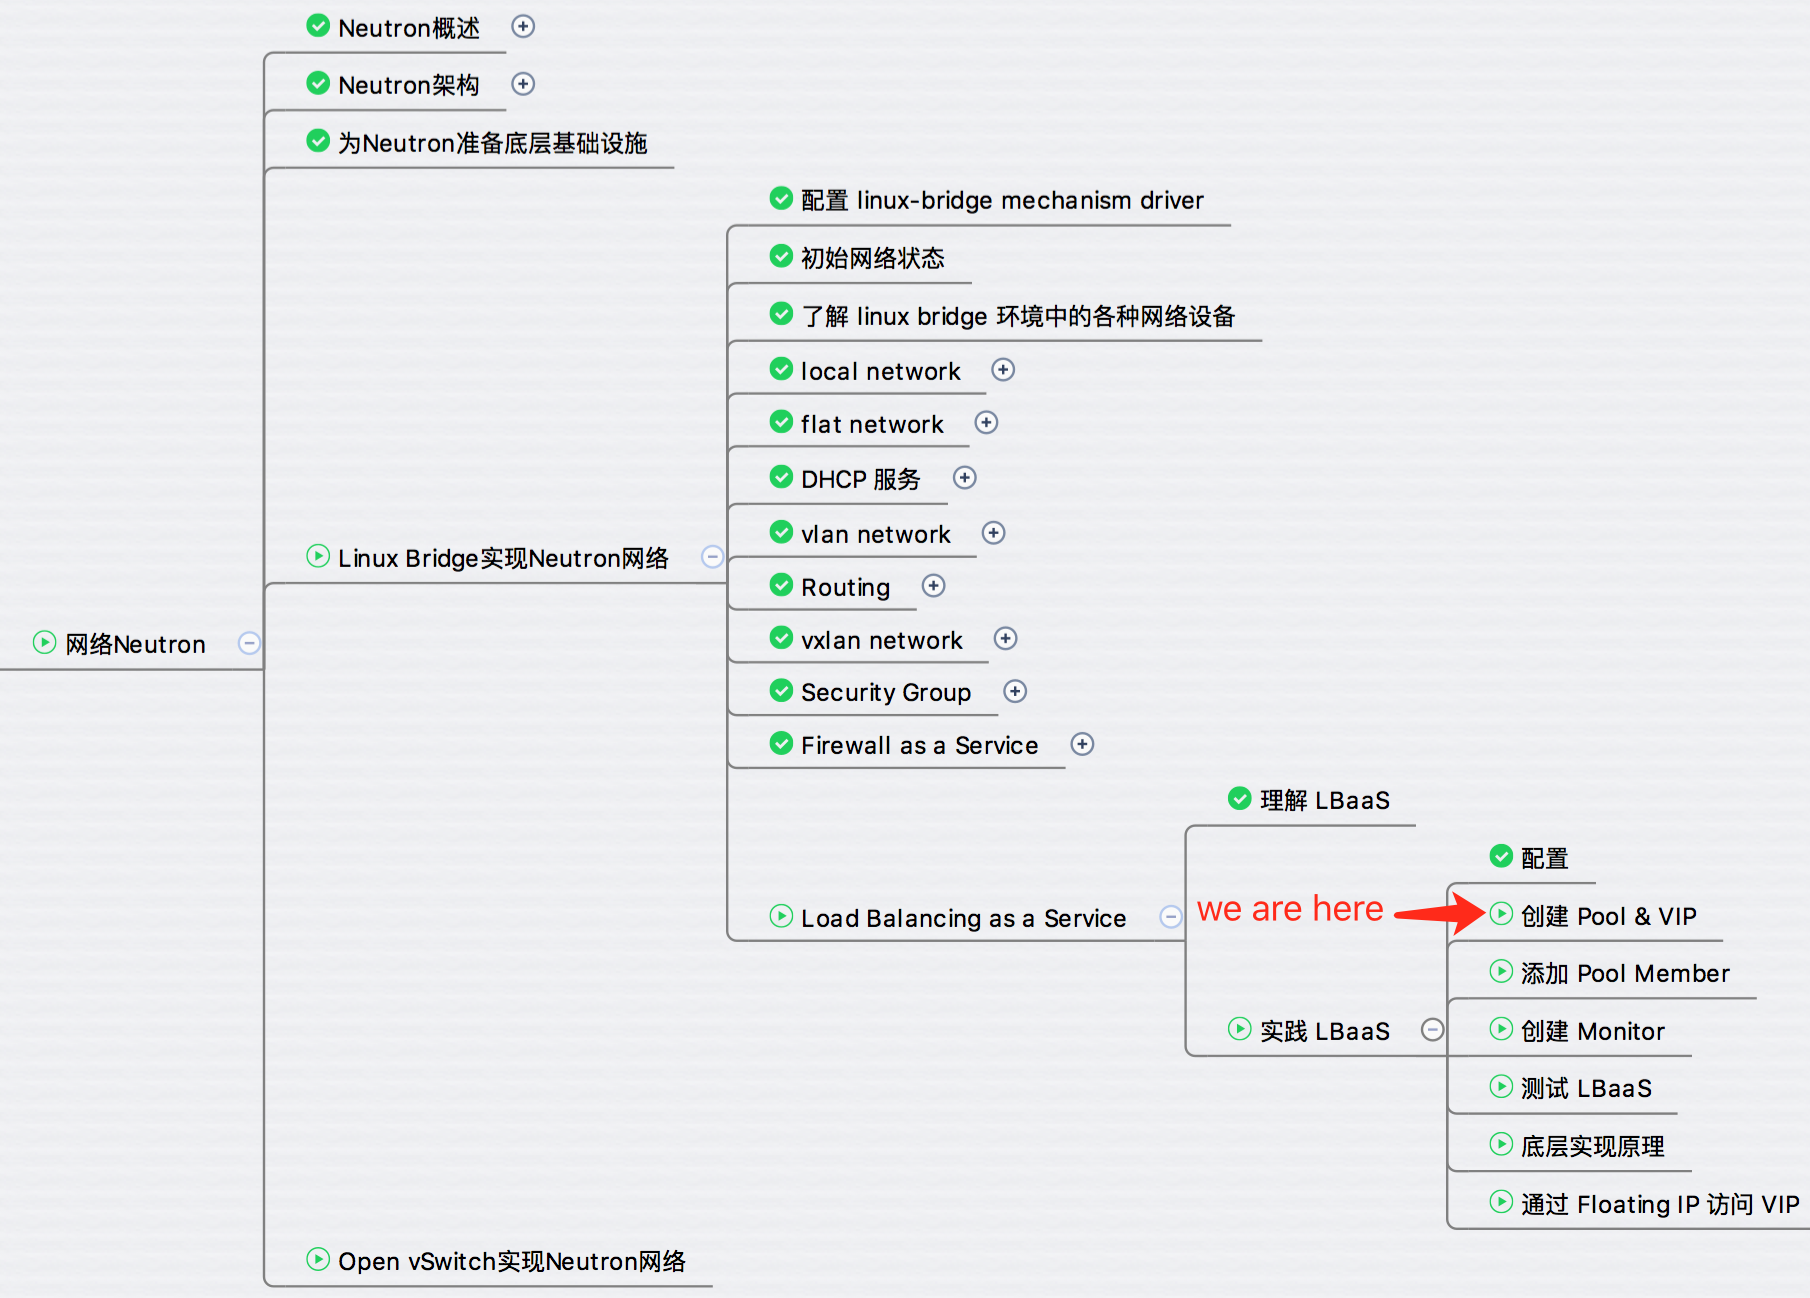
创建 Monitor 并测试 - 每天5分钟玩转 OpenStack(124)

前面我们创建了 Pool,VIP 并添加了 Member。今天将创建 Monitor,然后测试 LBaaS 是否能够正常工作。 创建 Monitor LBaaS 可以创建 monitor,用于监控 Pool Member 健康状态。 如果某个 member 不能正常工作,monitor 会将其状态设置为 down,从而避免将后续请求转发给它。 下面我们为 Pool 添加一个 monitor。 在 Monitors 标签页中点击 “Add Monitor” 按钮 Type 选择 “HTTP”,含义是通过 HTTP 检查 member 的健康状态。 Delay 设置为 “10”,含义是 10 秒检查一次 member 的状态。 Timeout 设置为 “5”,含义是如果 member 在 5 秒内无法应答,则超时。 Max Reties 设置为 “3”,含义是如果尝试 3 次都超时或者失败,则将 member 状态设置为 down。 HTTP Method 设置为 “GET” URL 设置为 “/” Expected HTTP Status Codes 设置为 “200” 上面三项的含义是通过 HTTP GET 请求 member “/” URL,如果返回码为 200,则认为 member 状态正常。 点击 “Add”,monitor 创建成功。 下面将新建的 monitor 添加到 pool 。 在 “web servers” 的操作列表中点击 “Associate Monitor” 选择我们刚刚创建的 monitor。 点击 “Associate”。 测试 LBaaS 经过上面的设置,我们创建了包含 member “Web1” 和 “Web2” 的 Pool “web servers”,并添加了 monitor。 准备就绪,可以测试 load balancer 是否正常工作了。 首先在 Web1 和 Web2 中启动 HTTP 服务,在 80 端口监听 这里我们使用 python 提供的 SimpleHTTPServer 模块启动了 HTTP 服务。 web server 的 index.html 显示当前访问的是哪个 member。 在 router 的 namespace 上多次执行 curl 172.16.100.11(VIP) 测试结果显示每次访问的都是 Web2 这个 member。 为什么没有访问到 Web1 呢? 还记得我们前面讨论的内容吗: Load Balance Method -- ROUND_ROUBIN Session Persistence -- SOURCE_IP 在这种配置下,第一个 curl 请求 HAProxy 通过 ROUND_ROUBIN 选择了 Web2。而后续的请求,HAProxy 则会应用 SOURCE_IP 机制,仍然选择 Web2。 下面我们修改一下配置。 在 “web servers” 的操作列表中点击 “Edit VIP”。 选择 “No session persistence” 并保存。 再进行 curl 测试。 可以看到已经在 “Web1” 和 “Web2” 之间 round robin 了。 下一节我们将分析 LBaaS 的内部实现和工作机制。

优秀的个人博客,低调大师

创建 Pool & VIP - 每天5分钟玩转 OpenStack(122)

上节完成了 LBaaS 配置,今天我们开始实现如下 LBaaS 环境。 环境描述如下: 1. 创建一个 Pool “web servers”。 2. 两个 pool member “WEB1” 和 “WEB2”,均为运行 Ubuntu cloud image 的 instance。 3. load balancer VIP 与 floating IP 关联。 4. 位于外网的 client 通过 floating IP 外网访问 web server 我们从第一步开始。 创建 Pool 点击菜单 Project -> Network -> Load Balancers,点击 Pools 标签页中的 “Add Pool” 按钮。 显示 Pool 创建页面。 将 Pool 命名为“web servers”。 Provider 选择默认的 “haproxy”。 Subnet 选择 “172.16.100.0/24”。 Protocol 选择 “HTTP”。 Load Balancing Method 选择 “ROUND_ROBIN”。 点击 “Add” 按钮,“web servers” 创建成功。 这里对 Pool 的几个属性进行一下说明。 LBaaS 支持如下几种 Protocol: 因为我们用 web server 做实验,所以这里需要选择 “HTTP” LBaaS 支持多种 load balance method: ROUND_ROUBIN 如果采用 round robin 算法,load balancer 按固定的顺序从 pool 中选择 member 相应 client 的连接请求。 这种方法的不足是缺乏机制检查 member 是否负载过重。 有可能出现某些 member 由于处理能力弱而不得不继续处理新连接的情况。 如果所有 pool member 具有相同处理能力、内存容量,并且每个连接持续的时间大致相同,这种情况非常适合 round robin,每个 member 的负载会很均衡。 LEAST_CONNECTIONS 如果采用 least connections 算法,load balancer 会挑选当前连接数最少的 pool member。 这是一种动态的算法,需要实时监控每个 member 的连接数量和状态。 计算能力强的 member 能够更快的处理连接进而会分配到更多的新连接。 SOURCE_IP 如果采用 source IP 算法,具有相同 source IP 的连接会被分发到同一个 pool member。 source IP 算法对于像购物车这种需要保存状态的应用特别有用,因为我们希望用同一 server 来处理某个 client 连续的在线购物操作。 在我们的实验中选择的是 ROUND_ROUBIN 算法。 为 Pool 添加 VIP 现在 Pool 已经就绪,接下需要为其设置 VIP。 在 “web servers” 的操作列表中点击 “Add VIP”。 VIP 命名为 “VIP for web servers”。 VIP Subnet 选择 “172.16.100.0/24”,与 pool 一致。 指定 VIP 为 172.16.100.11,如果不指定,系统会自动从 subnet 中分配。 指定 HTTP 端口 80。 Session Persistence 选择 “SOURCE IP”。 可以通过 Connection Limit 限制连接的数量,如果不指定则为不加限制。 点击 “Add”,VIP 创建成功。 通常我们希望让同一个 server 来处理某个 client 的连续请求。 否则 client 可能会由于丢失 session 而不得不重新登录。 这个特性就是 Session Persistence。 VIP 支持如下几种 Session Persistence 方式: SOURCE_IP 这种方式与前面 load balance 的 SOURCE_IP 效果一样。 初始连接建立后,后续来自相同 source IP 的 client 请求会发送给同一个 member。 当大量 client 通过同一个代理服务器访问 VIP 时(比如在公司和学校上网),SOURCE_IP 方式会造成 member 负载不均。 HTTP_COOKIE HTTP_COOKIE 的工作方式如下: 当 client 第一次连接到 VIP 时,HAProxy 从 pool 中挑选出一个 member。 当此 member 响应请求时,HAProxy 会在应答报文中注入命名为 “SRV” 的 cookie,这个 cookie 包含了该 member 的唯一标识。 client 的后续请求都会包含这个 “SRV” cookie。 HAProxy 会分析 cookie 的内容,并将请求转发给同一个 member。 HTTP_COOKIE 优于 SOURCE_IP,因为它不依赖 client 的 IP。 APP_COOKIE app cookie 依赖于服务器端应用定义的 cookie。 比如 app 可以通过在 session 中创建 cookie 来区分不同的 client。 HAProxy 会查看报文中的 app cookie,确保将包含 app cookie 的请求发送到同一个 member。 如果没有 cookie(新连接或者服务器应用不创建 cookie),HAProxy 会采用 ROUND_ROUBIN 算法分配 member。 比较 Load Balance Method 和 Session Persistence 前面我们介绍了三种 Load Balance Method: 这里还有三种 Session Persistence: 因为两者都涉及到如何选择 pool member,所以很容易混淆。 它们之间的最大区别在于选择 pool member 的阶段不同: Load Balance Method 是为新连接选择 member 的方法 Session Persistence 是为同一个 client 的后续连接选择 member 的方法 例如这里我们的设置为: Load Balance Method -- ROUND_ROUBIN Session Persistence -- SOURCE_IP 当 client A 向 VIP 发送第一个请求时,HAProxy 通过 ROUND_ROUBIN 选择 member1。对于 client A 后续的请求,HAProxy 则会应用 SOURCE_IP 机制,仍然选择 member1 来处理请求。 Pool 创建完毕,下一节我们向 Pool 添加 Member。

优秀的个人博客,低调大师

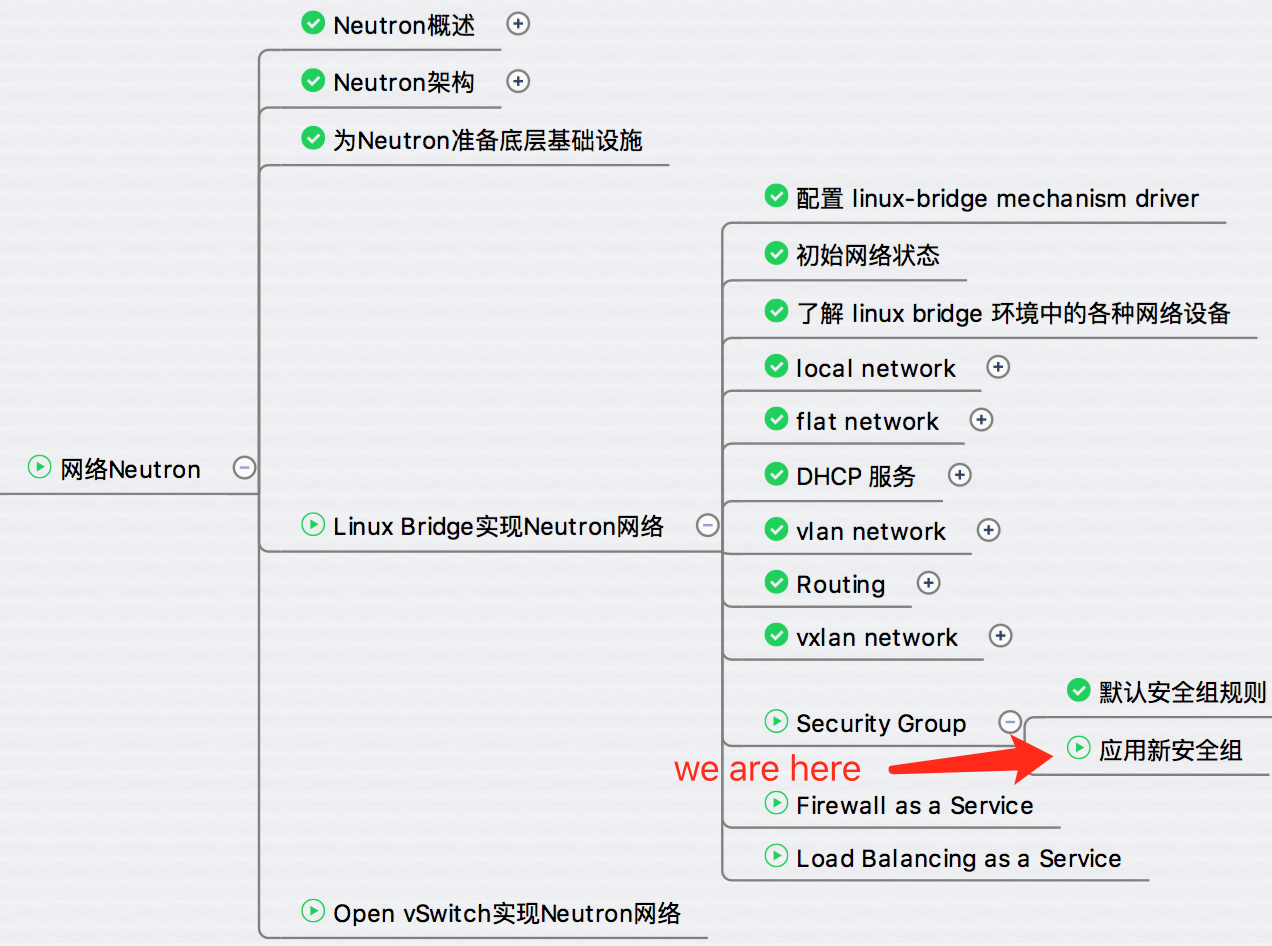
应用新安全组 - 每天5分钟玩转 OpenStack(116)

Neutron 默认的安全组规则会禁止掉所有从外面访问 instance 的流量。 本节我们会修改安全组的配置,允许 ping 和 ssh instance。有两种方法可以达到这个目的: 1. 修改 “default” 安全组。 2. 为 cirros-vm1 添加新的安全组。 这里我们采用第二种方法。 在安全组列表页面点击按钮。 为安全组命名并点击 “Create Security Group”。 新的安全组 “allow ping & ssh” 创建成功。 点击按钮,查看 “allow ping & ssh” 的规则。 系统默认定义了两条规则,运行所有的外出流量。 为清晰起见,可以点击按钮删除这两条规则。 点击按钮,添加允许 ping 的规则。 “Rule” 选择 “All ICMP”,“Direction” 选择 “Ingress”,然后点击 “Add” 按钮。 同样的方式添加 ssh 规则。 在列表中查看添加成功的规则。 接下来设置 cirros-vm1,使用新的安全组。 进入 instance 列表页面,点击 cirros-vm1 下拉操作列表中的 “Edit Security Groups” 可以看到 cirros-vm1 当前使用的安全组为 “default”,可选安全组为 “allow ping & ssh”。 点击安全组 “allow ping & ssh” 后面的 “+” 按钮。 点击 “Save” 保存。 iptables 会立即更新,下面通过 vimdiff 查看 iptables 前后的变化。 “allow ping & ssh” 安全组引入了下面两条 iptables 规则。 作用是运行 ingress 的 ssh 和 ping 流量。 -A neutron-linuxbri-i8bca5b86-2 -p tcp -m tcp --dport 22 -j RETURN -A neutron-linuxbri-i8bca5b86-2 -p icmp -j RETURN 测试一下,现在能够 ping 和 ssh cirros-vm1 了。 小结 安全组有以下特性: 1. 通过宿主机上 iptables 规则控制进出 instance 的流量。 2. 安全组作用在 instance 的 port 上。 3. 安全组的规则都是 allow,不能定义 deny 的规则。 4. instance 可应用多个安全组叠加使用这些安全组中的规则。 安全组学习完了,下节我们讨论 Neutron 的另一个安全机制 -- 虚拟防火墙。

优秀的个人博客,低调大师

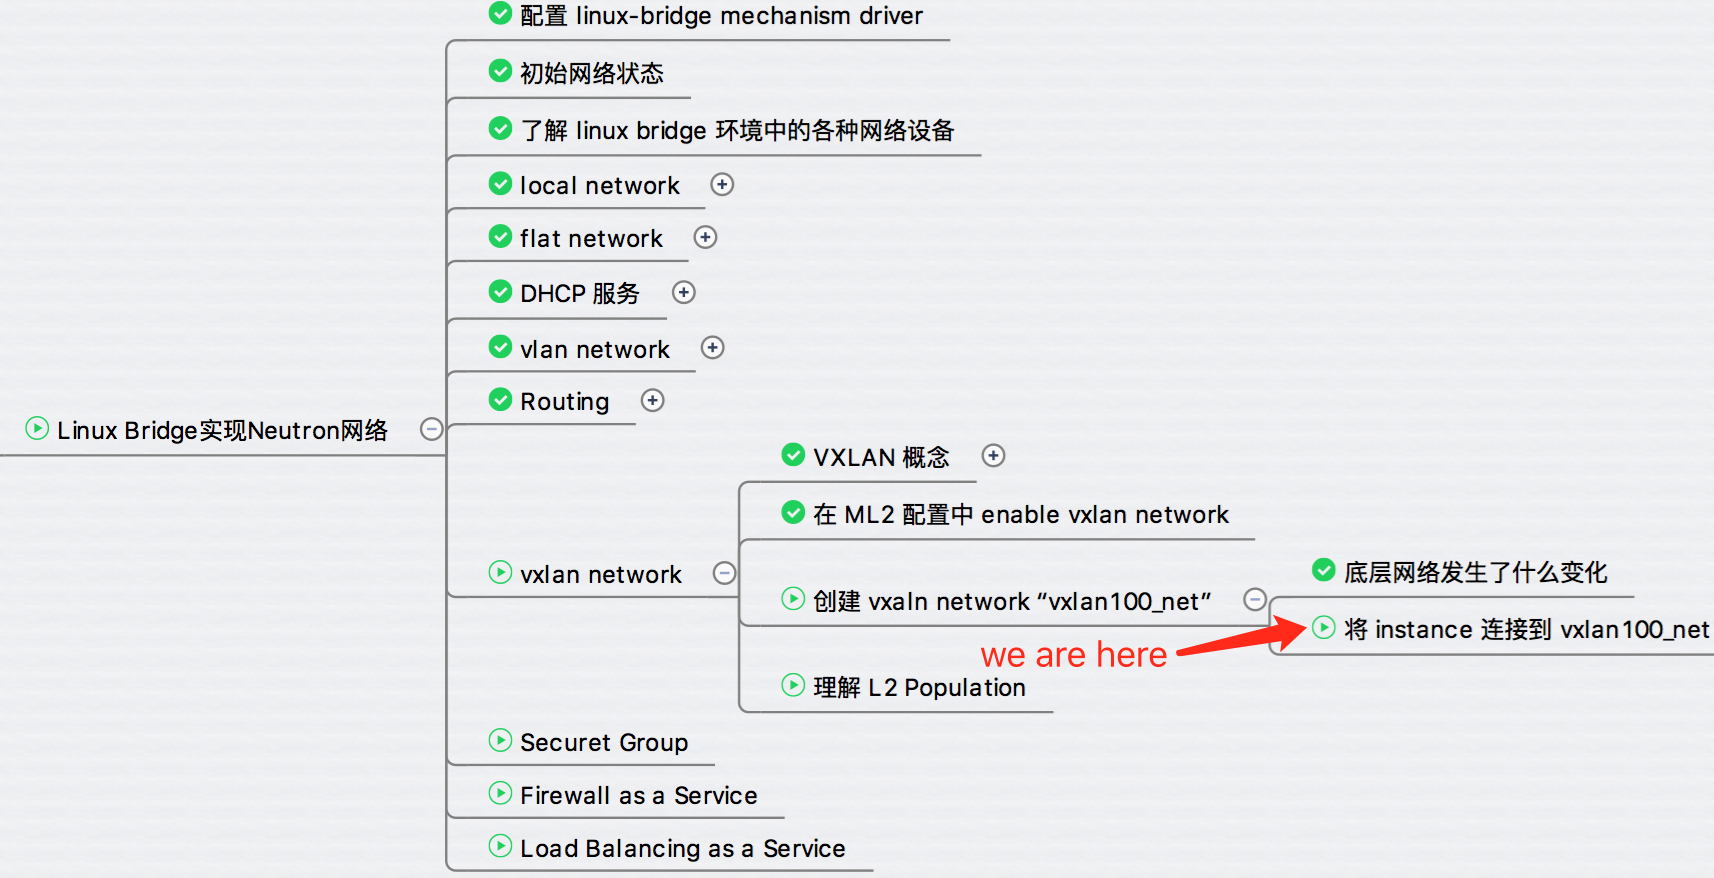
部署 instance 到 VXLAN - 每天5分钟玩转 OpenStack(112)

上一节我们创建了 vxlan 100_net,今天将部署 instance 并分析网络的连通性。 launch 新的 instance “cirros-vm1”,网络选择 vxlan100。 cirros-vm1 分配到的 IP 为 172.16.100.3。 cirros-vm1 被 schedule 到控制节点,对应的 tap 设备为 tap099caa87-cd,并且连接到 bridge brq1762d312-d4。 当前 vxlan100 的结构如下: 继续用同样的方式 launch instance cirros-vm2,分配到的 IP 为 172.16.100.4。 cirros-vm2 被 schedule 到计算节点,对应的 tap 设备为 tap457cc048-aa,并且连接到 bridge brq1762d312-d4。 因为计算节点上没有 hdcp 服务,所以没有相应的 tap 设备。 另外,bridge 的名称与控制节点上一致,都是 brq1762d312-d4,表明是同一个 network。 当前 vxlan100 的结构如下: cirros-vm1(172.16.100.3) 与 cirros-vm2(172.16.100.4) 位于不同节点,通过 vxlan100 相连,下面执行 PING 验证连通性。 在 cirros-vm1 控制台中执行 ping 172.16.100.4 如我们预料,ping 成功。 对于多 vxlan 之间的 routing 以及 floating ip,实现方式与 vlan 非常类似,这里不再赘述,请参看前面 vlan 相关章节。 下节我们讨论提高 VXLAN 工作效率的机制 - L2 Population。

优秀的个人博客,低调大师

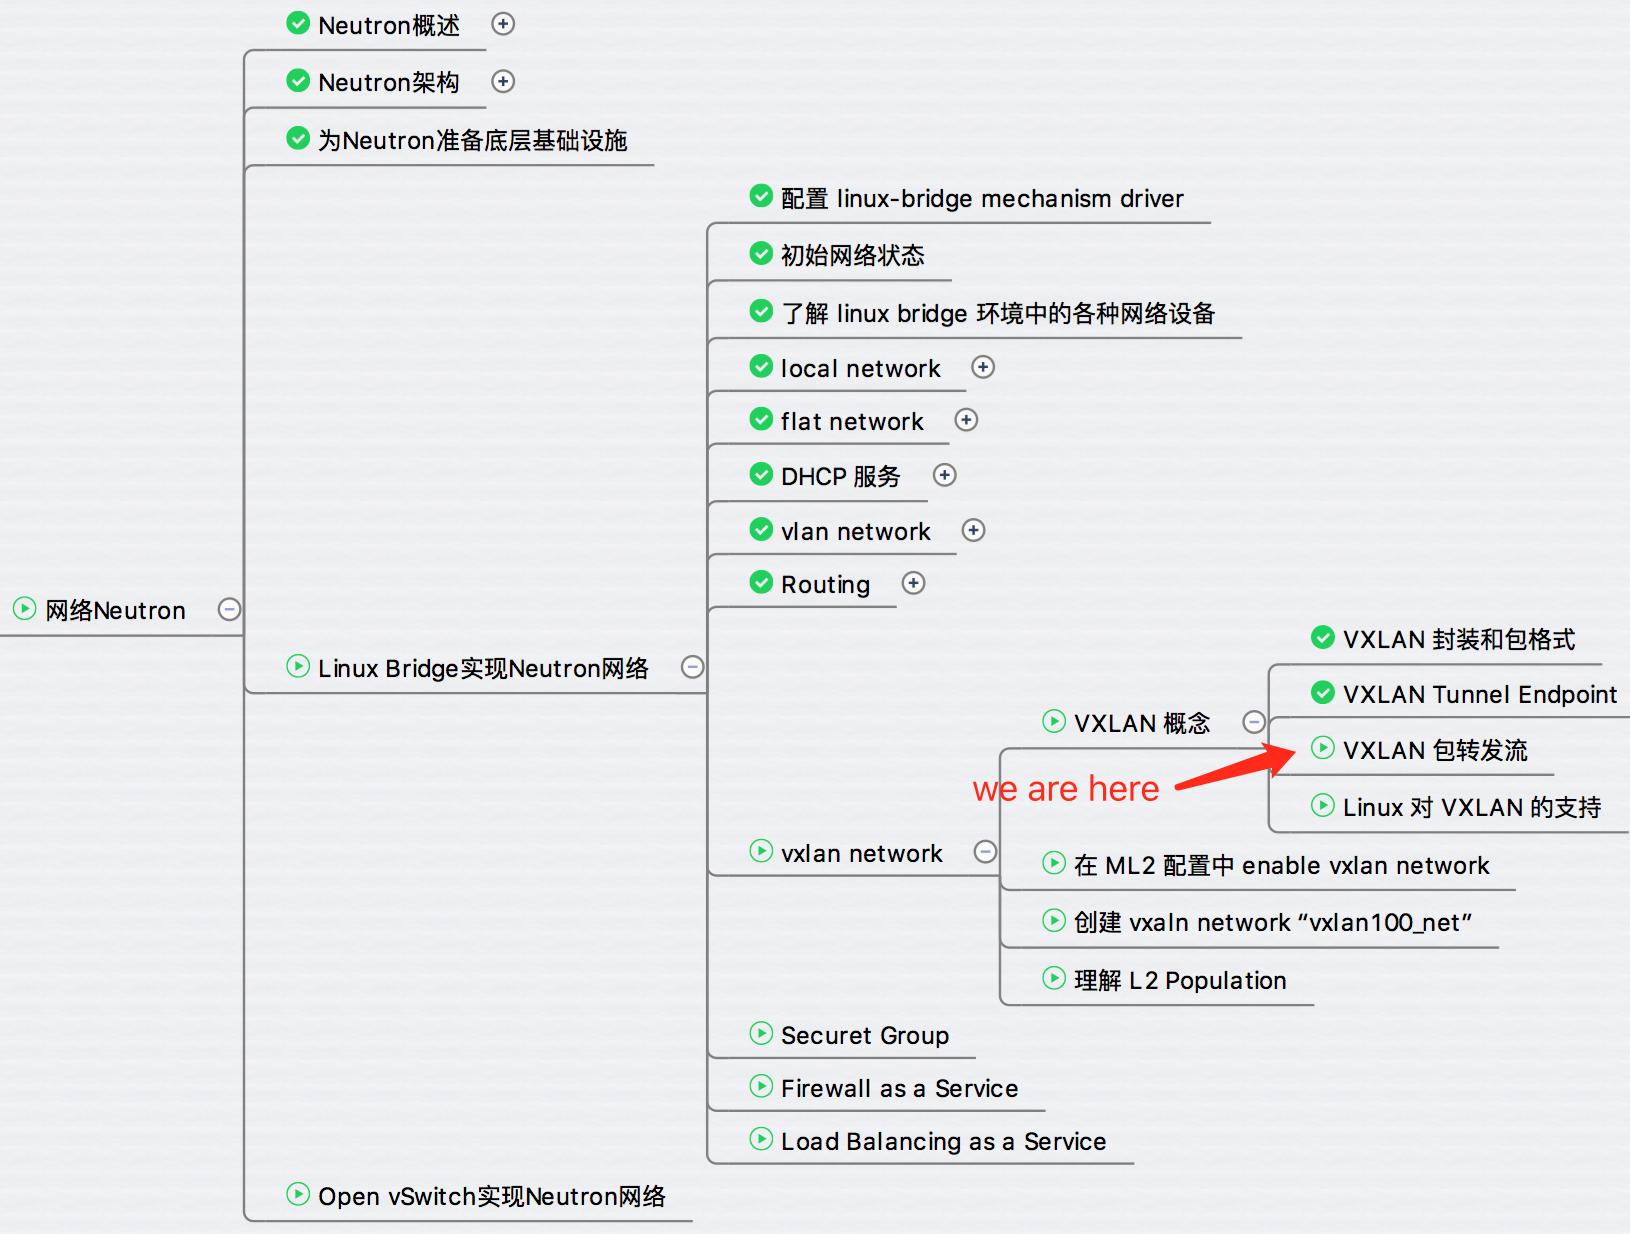
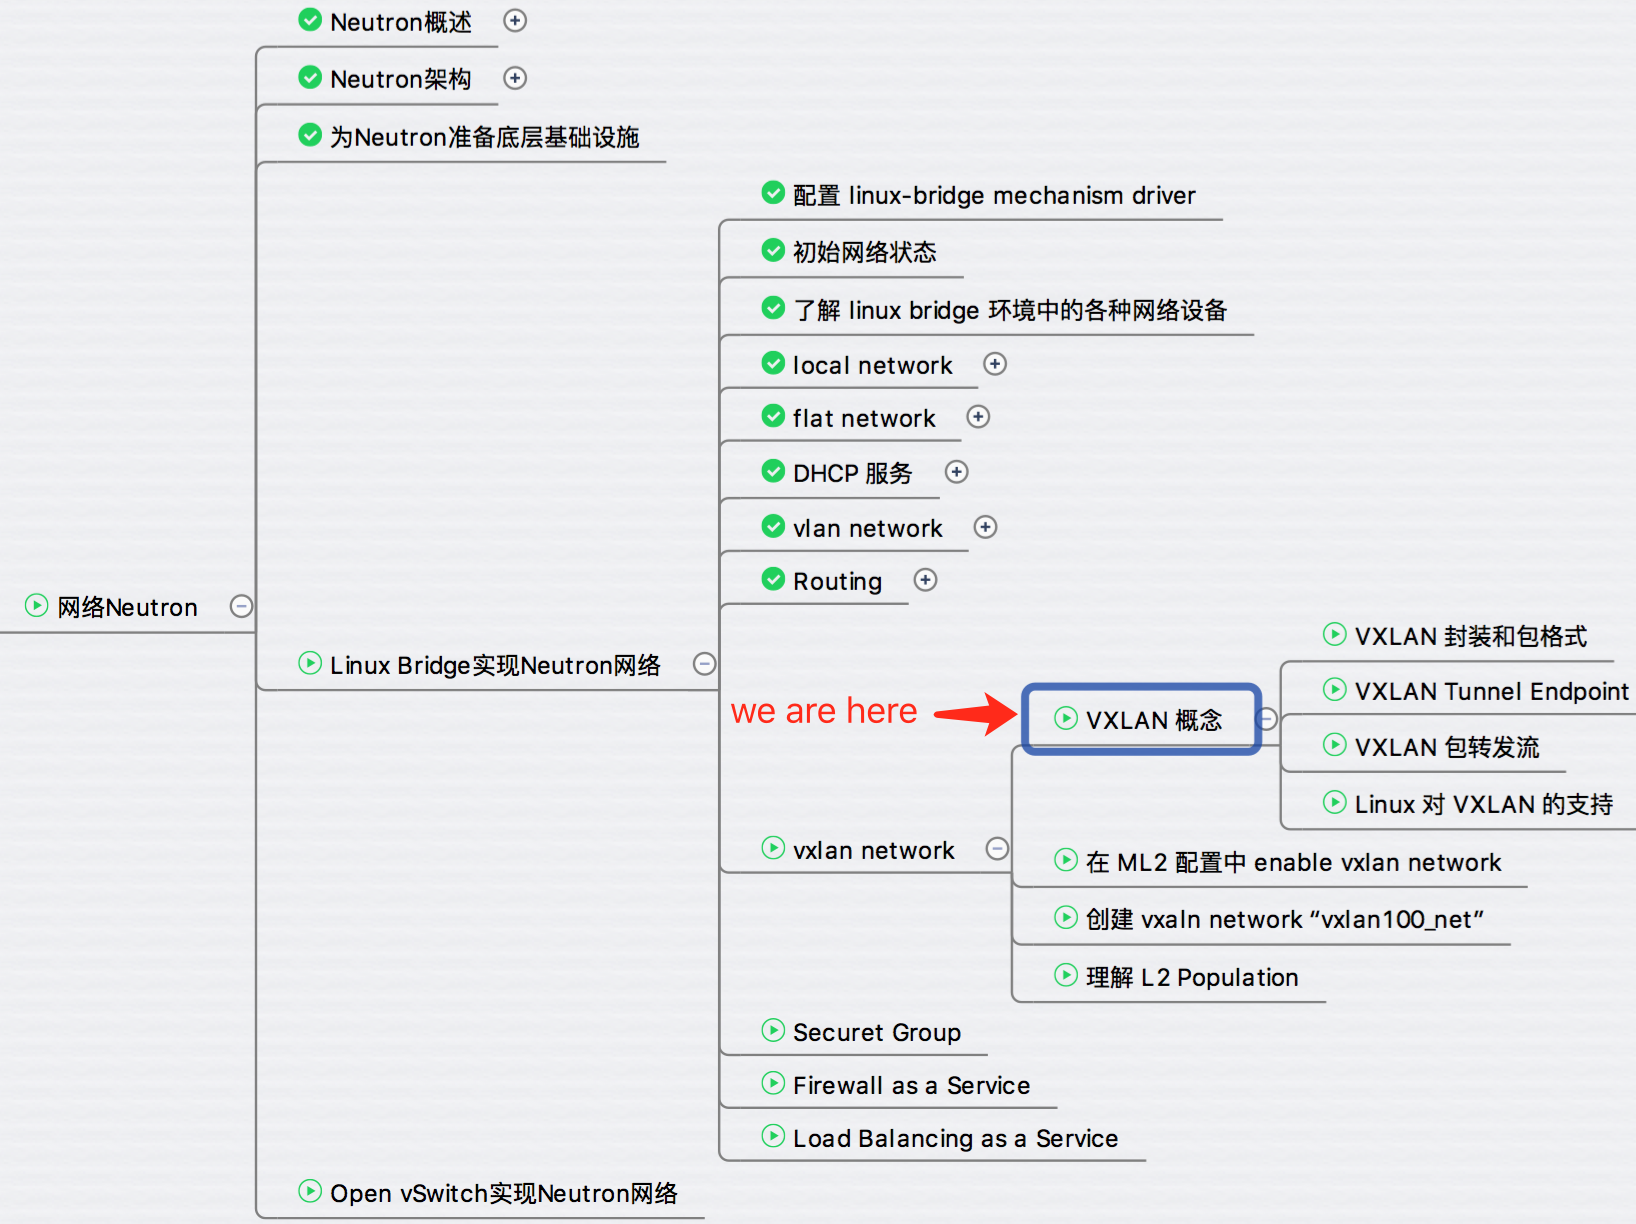
VXLAN 概念(Part II)- 每天5分钟玩转 OpenStack(109)

上一节我们介绍了 VXLAN 的封装格式以及 VTEP。今天我们将通过例子讨论 VXLAN 封装和转发包的过程,以及 Linux 对 VXLAN 的原生支持。 VXLAN 包转发流程 VXLAN 在 VTEP 间建立隧道,通过 Layer 3 网络传输封装后的 Layer 2 数据。下面的例子演示了数据如何在 VXLAN 上传输: 图中 Host-A 和 Host-B 位于 VNI 10 的 VXLAN,通过 VTEP-1 和 VTEP-2 之间建立的 VXLAN 隧道通信。数据传输过程如下: Host-A 向 Host-B 发送数据时,Host-B 的 MAC 和 IP 作为数据包的目标 MAC 和 IP,Host-A 的 MAC 作为数据包的源 MAC 和 IP,然后通过 VTEP-1 将数据发送出去。 VTEP-1 从自己维护的映射表中找到 MAC-B 对应的 VTEP-2,然后执行 VXLAN 封装,加上 VXLAN 头,UDP 头,以及外层 IP 和 MAC 头。此时的外层 IP 头,目标地址为 VTEP-2 的 IP,源地址为 VTEP-1 的 IP。同时由于下一跳是 Router-1,所以外层 MAC 头中目标地址为 Router-1 的 MAC。 数据包从 VTEP-1 发送出去后,外部网络的路由器会依据外层 IP 头进行包路由,最后到达与 VTEP-2 连接的路由器 Router-2。 Router-2 将数据包发送给 VTEP-2。VTEP-2 负责解封数据包,依次去掉外层 MAC 头,外层 IP 头,UDP 头 和 VXLAN 头。 VTEP-2 依据目标 MAC 地址将数据包发送给 Host-B。 上面的流程我们看到 VTEP 是 VXLAN 的最核心组件,负责数据的封装和解封。 隧道也是建立在 VTEP 之间的,VTEP 负责数据的传送。 Linux 对 VXLAN 的支持 VTEP 可以由专有硬件来实现,也可以使用纯软件实现。 目前比较成熟的 VTEP 软件实现包括: 带 VXLAN 内核模块的 Linux Open vSwitch 我们先来看 Linux 如何支持 VXLAN,Open vSwitch 方式将在后面章节讨论。 实现方式: Linux vxlan 创建一个 UDP Socket,默认在 8472 端口监听。 Linux vxlan 在 UDP socket 上接收到 vxlan 包后,解包,然后根据其中的 vxlan ID 将它转给某个 vxlan interface,然后再通过它所连接的 linux bridge 转给虚机。 Linux vxlan 在收到虚机发来的数据包后,将其封装为多播 UDP 包,从网卡发出。 到这里,相信大家对 VXLAN 的原理已经有了大致的了解。 下节我们将学习如何在 Neutron 中配置和实施 VXLAN。

优秀的个人博客,低调大师

floating IP 原理分析 - 每天5分钟玩转 OpenStack(107)

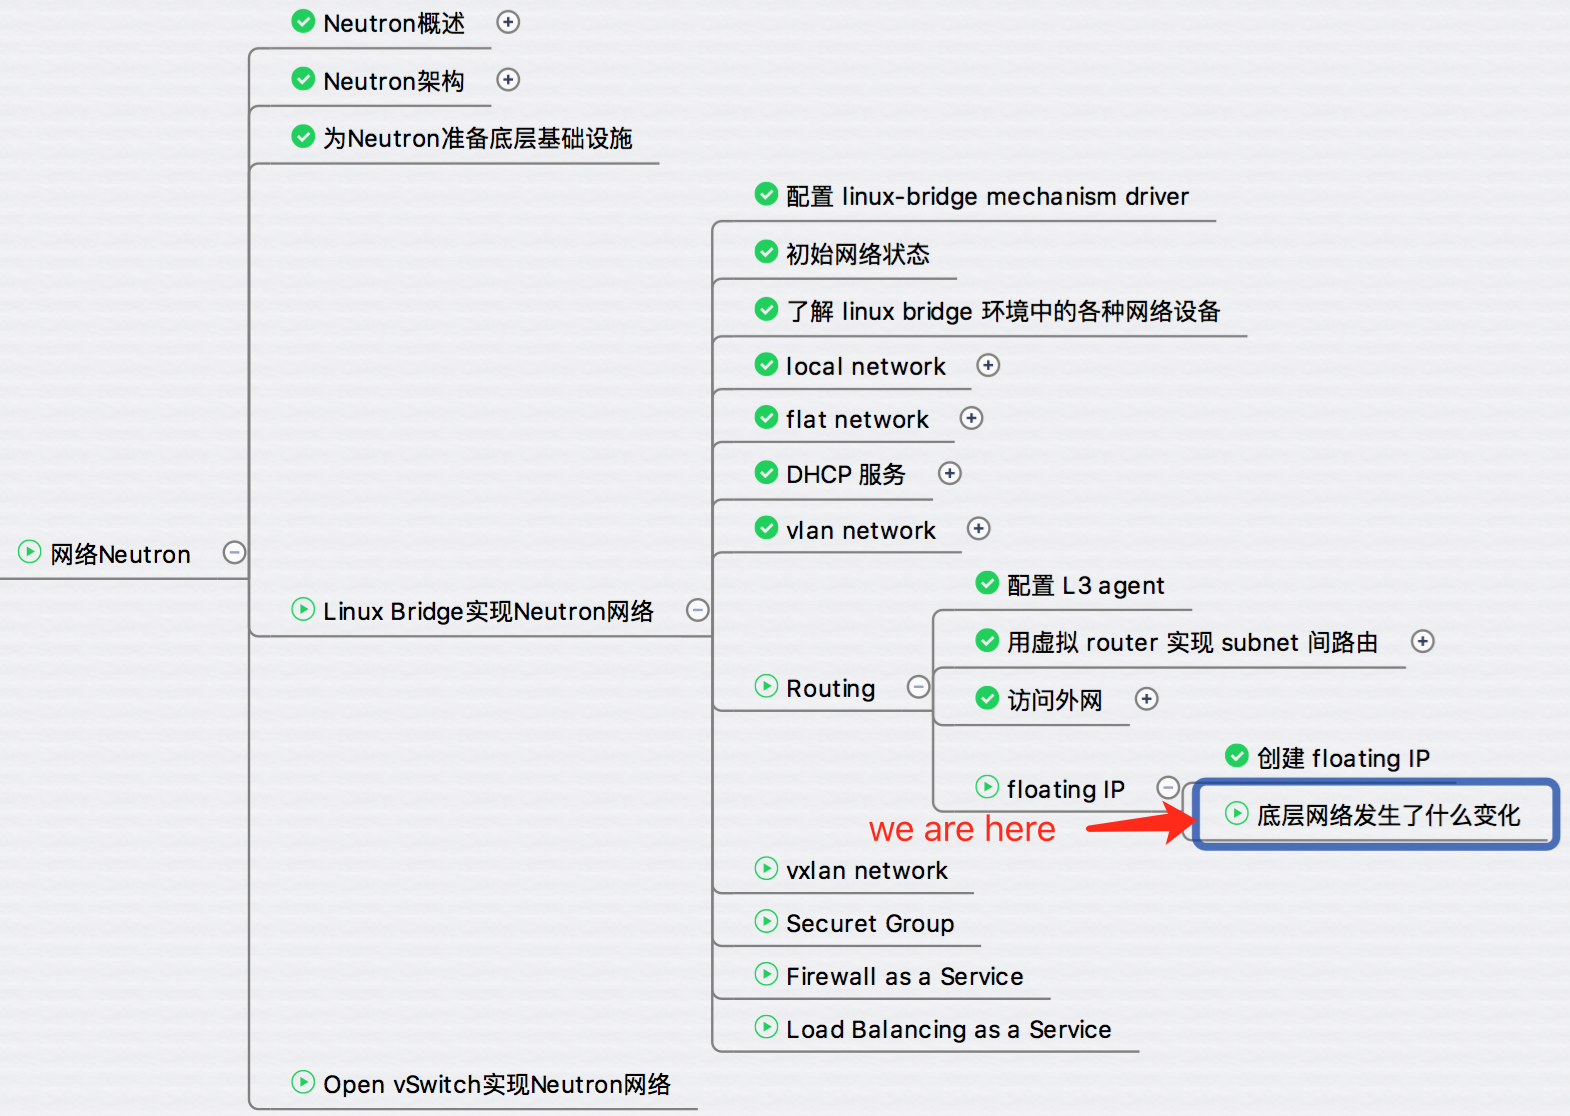
上一节我们通过 Web UI 创建为 cirros-vm3分配了浮动 IP,今天将分析其工作原理。 首先查看 router 的 interface 配置: 可以看到,floating IP 已经配置到 router 的外网 interface qg-b8b32a88-03 上。 查看 router 的 NAT 规则: iptables 增加了两条处理 floating IP 的规则: 1. 当 router 接收到从外网发来的包,如果目的地址是 floating IP 10.10.10.3,将目的地址修改为 cirros-vm3 的 IP 172.16.101.3。这样外网的包就能送达到 cirros-vm3。 2. 当 cirros-vm3 发送数据到外网,源地址 172.16.101.3 将被修改为 floating IP 10.10.10.3。 下面我们通过 PING 测试一下。 在我的实验环境中,10.10.10.1 是外网中的物理交换机,现在让它 PING cirros-vm3。 能够 PING 通。 我们通过 tcpdump 可用在 router 的 interface 上观察 floating IP 的行为。 ext_net interface qg-b8b32a88-03 的 tcpdump 输出: 可见,在外网接口 qg-b8b32a88-03 上,始终是通过 floating IP 10.10.10.3 与外网通信。 vlan101 interface qr-e17162c5-00 的 tcpdump 输出: 当数据转发到租户网络,地址已经变为 cirros-vm3 的租户 IP 172.16.101.3 了。 小结一下: 1. floating IP 能够让外网直接访问租户网络中的 instance。这是通过在 router 上应用 iptalbes 的 NAT 规则实现的。 2. floating IP 是配置在 router 的外网 interface 上的,而非 instance,这一点需要特别注意。 至此,我们已经完成了 Neutron L3 服务连接不同 subnet,访问外网,以及 floating IP 的学习。下节开始,我们将学习 Neutron 如何支持 VxLAN 网络类型。

优秀的个人博客,低调大师

外网访问原理分析 - 每天5分钟玩转 OpenStack(105)

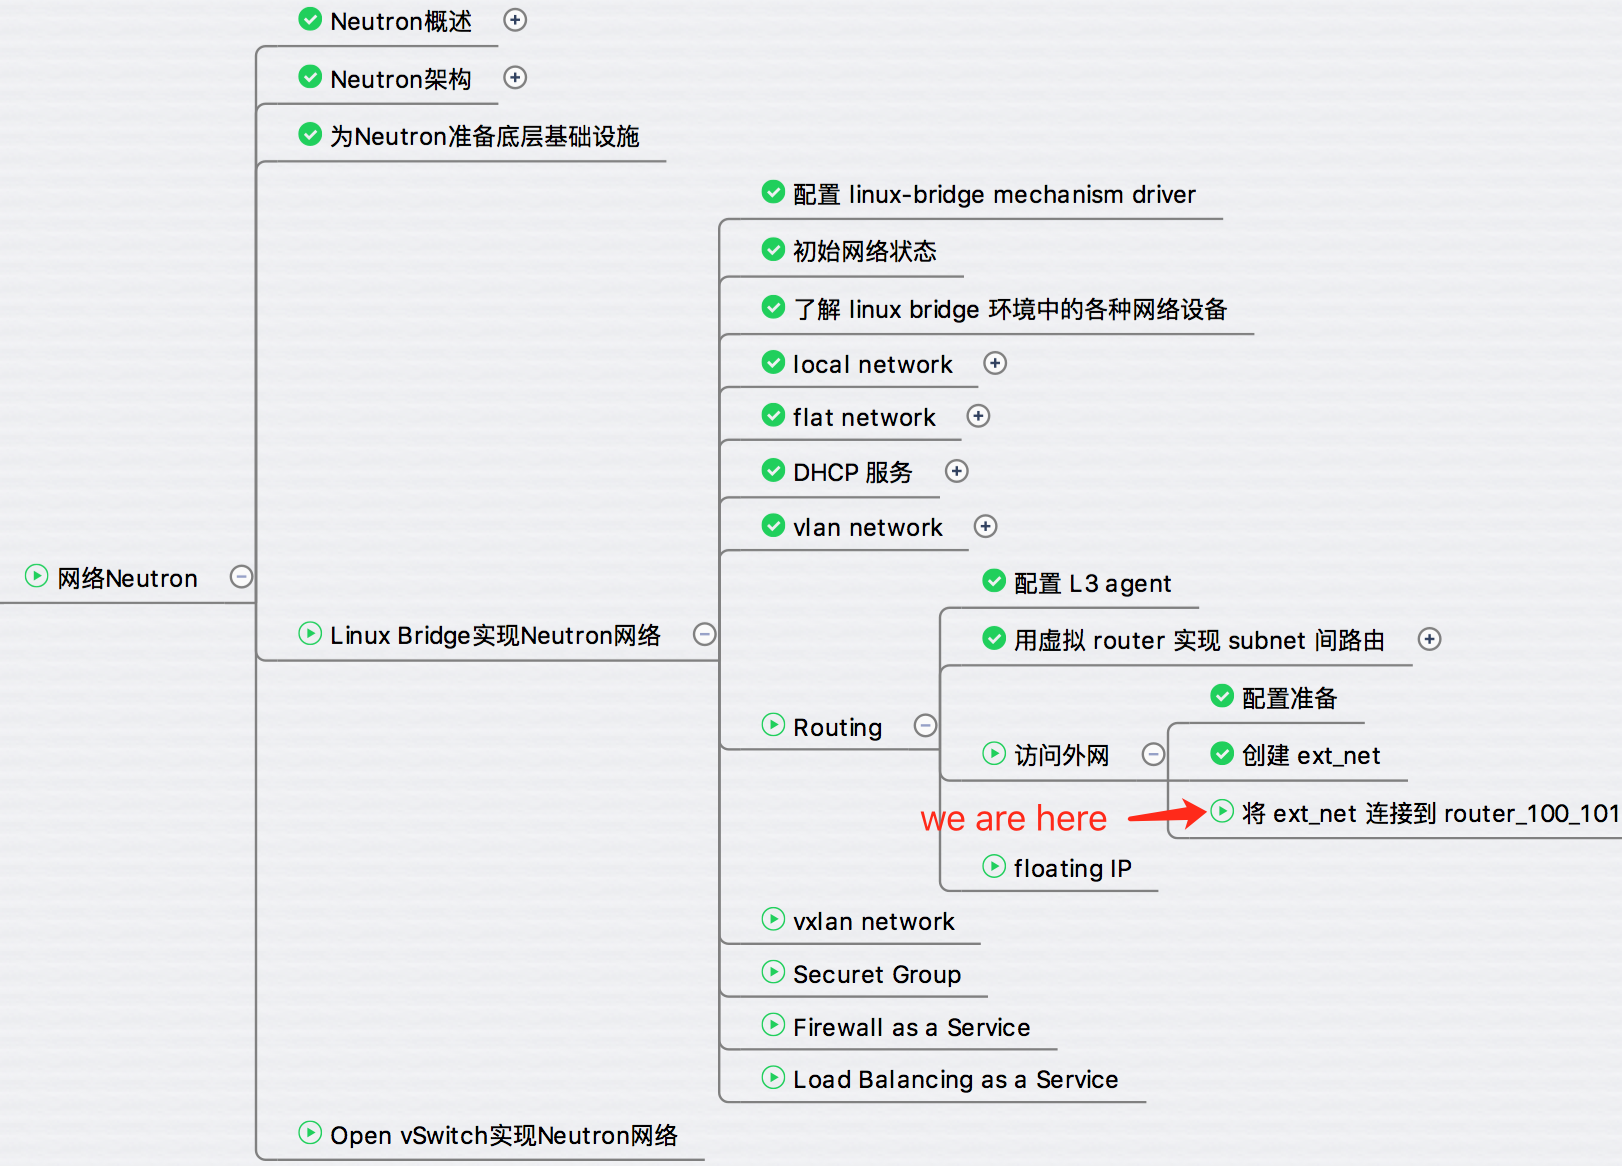
本节我们会将上节创建的 ext_net 连接到 router,并验证内外网的连通性。 更重要的,我们会分析隐藏在表象之下的原理。 将外网连接到 Neutron 的虚拟路由器,这样 instance 才能访问外网。 点击菜单 Project -> Network -> Routers 进入 router 列表。 点击 router_100_101 的 “Set Gateway” 按钮。 在 “External Network” 下拉列表中选择 ext_net,点击 “Set Gateway”。 外网设置成功。 我们需要看看 router 发生了什么变化。 点击 “router_100_101” 链接,打开 “Interfaces” 标签页 router 多了一个新的 interface,IP 为 10.10.10.2。 该 interface 用于连接外网 ext_net。 查看控制节点的网络结构,外网 bridge 上已经连接了 router 的 tap 设备 tapb8b32a88-03。 在 router 的 namespace 中查看 tapb8b32a88-03 的 veth pair 设备。 该 veth pair 命名为 qg-b8b32a88-03,上面配置了 IP 10.10.10.2。 router 的每个 interface 在 namespace 中都有对应的 veth。 如果 veth 用于连接租户网络,命名格式为 qr-xxx,比如 qr-d568ba1a-74 和 qr-e17162c5-00。 如果 veth 用于连接外部网络,命名格式为 qg-xxx,比如 qg-b8b32a88-03。 查看 router 的路由表信息。 可以看到默认网关为 10.10.10.1。 意味着对于访问 vlan100 和 vlan101 租户网络以外的所有流量,router_100_101 都将转发给 ext_net 的网关 10.10.10.1。 现在 router_100_101 已经同时连接了 vlan100, vlan101 和 ext_net 三个网络,如下图所示: 下面我们在 cirros-vm3 上测试一下。 cirros-vm3 位于计算节点,现在已经可以 Ping 到 ext_net 网关 10.10.10.1 了。 通过 traceroute 查看一下 cirros-vm3 到 10.10.10.1 的路径 数据包经过两跳到达 10.10.10.1 网关。 1. 数据包首先发送到 router_100_101 连接 vlan101 的 interface(172.16.101.1)。 2. 然后通过连接 ext_net 的 interface(10.10.10.2) 转发出去,最后到达 10.10.10.1。 当数据包从 router 连接外网的接口 qg-b8b32a88-03 发出的时候,会做一次 Source NAT,即将包的源地址修改为 router 的接口地址 10.10.10.2,这样就能够保证目的端能够将应答的包发回给 router,然后再转发回源端 instance。 可以通过 iptables 命令查看 SNAT 的规则。 当 cirros-vm3(172.16.101.3) Ping 10.10.10.1 时,可用通过 tcpdump 分别观察 router 两个 interface 的 icmp 数据包来验证 SNAT 的行为。 vlan101 interface qr-e17162c5-00 的 tcpdump 输出: ext_net interface qg-b8b32a88-03 的 tcpdump 输出: SNAT 让 instance 能够直接访问外网,但外网还不能直接访问 instance。因为 instance 没有外网 IP。 这里 “直接访问 instance” 是指通信连接由外网发起,例如从外网 SSH cirros-vm3。 这个问题可以通过 floating IP 解决,下一节我们将讨论浮动 IP。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册