首页 文章 精选 留言 我的

精选列表

搜索[个人博客],共10000篇文章
优秀的个人博客,低调大师

【个人学习JAVA---学后的梳理】三、浅纳Java的数据类型

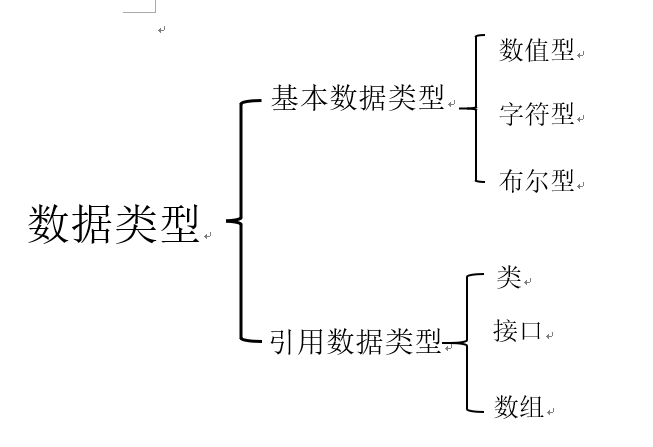
Java数据类型的简单归纳打理,顺带补上 常量与变量 1. 编程元素---常量与变量 1.1:常量 顾名思义,常量就是固定不变的量(不变的是其直接对象地址),即:定义完成就无法被改变。 声明常量的语法如下: final <数据类型> <常量名>[=赋值]; 进一步说明,常量的名称就采用全大写字母,以便区分于其他变量。其中定义的关键字final,不仅定义于变量,还用于定义类的成员方法,这就意味着被final定义的方法将不会再被改变。 1.2: 变量 变量是利用声明的方式,将内存中的某个块保留下来供该程序使用。 不管变量的值如何更改,所指向的,使用的,都是同一内存空间。变量的作用范围:作用范围,也就是意味着在范围内,该变量名才会有意义、有作用。 那么,不同范围内的变量名是可以存在重名的,程序的运行时访问原则是就近原则,向上查找该变量名。 在一个类中,变量根据范围,有两种类型: 成员变量类主体中定义的变量为成员变量。其作用范围是在整个类都能访问到。 局部变量在某个方法,某个代码块,某个循环里所定义的变量,其只在这些局部的范围内有意义。 2. Java的数据类型 在Java中规定了8种基本数据类型,也存在引用类型的数据类型。如下图示: 图1-Java数据类型图 2.1:8种基本数据类型 数据类型 说明 位 可表示的数据范围 默认初值 long 长整数 64 能保存宇宙中最大的整数(正负) 0L int 整数 32 -2147483648 ~ 2147483647 0 short 短整数 16 -32768 ~ 32767 (short)0 byte 位 8 -128 ~ 127 (byte)0 char 字符 2 0~255 u000(空) float 单精度 32 可有6、7个小数位的精确度 0.0f double 双精度 64 可有15个小数位的精确度 0.0d 2.1.1: byte类型 1个字节有8位。 byte类型数据占据1个字节的内存空间。 2.1.2. short类型 赋值整数前以"(short)"表示该整数类型是short类型,否则是int型。 short类型数据占据2个字节的内存空间。 2.1.3: int类型 Java中默认的整数数据类型就是int型。数据溢出时,溢出的数值将与该类型的最小数值相加后再赋值。也就是说,MAX_VALUE+n后的值是MIN_VALUE+[n-1]。 int类型数据占据4个字节的内存空间。 2.1.4: long类型 long类型数据占据8个字节的内存空间。 2.1.5: char类型 char类型数据占据2个字节的内存空间。 2.1.6: float类型 float类型数据占据4个字节的内存空间。 2.1.7: double类型 double类型数据占据8个字节的内存空间。 2.1.8: boolean类型 boolean类型数据只有true、false两个值,默认初值为false。 明显,布尔值是确定判断的真假。当然,真假的表示不仅仅是true与false,还能用数字,也就是说:非正数表false,正数表true。 2.2:引用数据类型 引用,就是一个指向了类的实例化对象的变量,那么该变量就属于引用数据类型。 3. 数据类型的转换 数据类型的有着严格的限制,实现类型转换须经过严格的步骤和规定。 转换方式有着两种。 3.1. 自动类型转换 自动转换即是向上类型转换。 自动转换的两个前提条件: 转换前的数据类型与转换后的类型兼容; 转换后的数据类型的表示范围比转换前的类型大(向上)。 3.2. 强制类型转换 强制转换须以“(转换后的类型)oldData”格式进行。如果强制向下转换,转换后的数据可能相比转换前,会丢失精度。 结束 2019年8月6日 15:49:58

优秀的个人博客,低调大师

Keras快速上手——打造个人的第一个“圣诞老人”图像分类模型

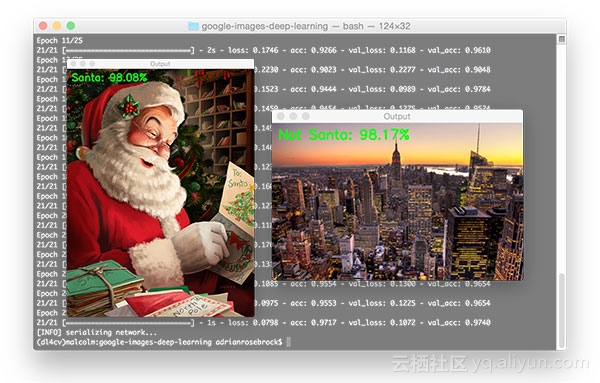
首发地址:https://yq.aliyun.com/articles/288077 2017年已到最后一个月的尾巴,那圣诞节还会远吗?不知道各位对于圣诞节有什么安排或一些美好的回忆,我记得最清楚的还是每年圣诞节前一晚那些包装好的苹果,寓意平平安安。那谈到圣诞节,不可或缺的主角——“圣诞老人”会出现在各地的大街小巷、各种画册上,本文将带领读者使用Keras完成“圣诞老人”图像的分类,算是圣诞节前的预热活动吧。 在介绍正式内容前,读者可以先看这篇内容: 如何利用谷歌图片获得训练数据 在本教程的第一部分,将介绍本文使用的数据集;其次使用Python和Keras训练一个卷积神经网络模型,该模型能够检测一个图像中是否存在圣诞老人, 所选的网络结构类似于LeNet网络;最后,在一系列的图像上评估本文搭建的模型,然后讨论一下本文方法的局限性以及如何拓展等。 “圣诞老人”和“非圣诞老人”数据集 为了训练搭建的模型,本文需要两类图像集: 图像含圣诞老人(“圣诞老人”); 图像不包含圣诞老人(“不是圣诞老人”) 上周我们用谷歌图片迅速获取训练图像数据集,数据集中包含461张有圣诞老人的图像中,如图1(左)所示;此外从UKBench数据集中随机获取461张不包含圣诞老人,如图1(右)所示。 基于卷积神经网络和Keras搭建的第一个图像分类器 如图2所示,该图是一个典型的Lenet网络结构,最初被用来数字手写体的分类,现将其扩展到其他类型的图像。 本教程主要是介绍如何将深度学习应用于图像分类中,所以不会对Keras和Python语句介绍得非常详细,感兴趣的读者可以看下Deep Learning for Computer Vison with Python这本书。 首先先定义网络架构。创建一个新文件并命名为lenetpy,并插入以下代码: 第2-8行是需要导入的Python包,其中conv2d表示执行卷积,maxpooling2d表示执行最大池化,Activation表示特定的激活函数类型,Flatten层用来将输入“压平”,用于卷积层到全连接层的过渡,Dense表示全连接层。 真正创建Lenet网络结构是代码的第10-12行,每当定义了一个新的卷积神经网络结构时,我喜欢: 把它放在自己的类中(为了命名空间及便于组织) 创建一个静立建造函数,来完成整个模型的建立 建立的模型时需要大量的参数: weight:输入图像的宽度 height:输入图像的高度 depth:输入图像的通道数(1表示单通道图像灰度,3表示标准的RGB图像) claclasses:想要组织的层类别总数 第1第4行定义我们的模型,第15行初始化inputshape,第18-19行正常更新inputshape 现在我们已经初始化我们的模型,可以开始添加其它层,代码如下: 第21-25行创建第一个CONV->RELU->POOL层,卷积层使用20个大小5x5的滤波器,之后紧跟RELU激活函数,最后使用窗口大小为2x2的最大池化操作; 之后定义第二个CONV->RELU->POOL层: 这次卷积层使用50个滤波器,滤波器个数的增加加深整个网络体系结构。 最终的代码块是将数据“压平”以连接全连接层: 第33行能将maxpooling2d层的输出压扁成一个单向量; 第34行显示全连接层包含500个节点,然后紧跟一个ReLU激活函数; 第38行定义另一个全连接层,该层的节点数等于分类的类别数,Dense 层送入softmax分类器输出每类的概率值; 第42行返回模型的调用函数; 使用Keras训练卷积神经网络图像分类器 打开一个新的文件并命名为train_networkpy,并插入以下代码打开 第2 - 18行导入程序需要的数据包; 下面开始解析命令行参数: 这里有两个需要命令行参数,--dataset和--model,以及accuracy/loss图的路径选择。其中--dataset表示模型的训练集,--model表示训练分类器后保存的模型,如果--plot未指定,则默认为plot.PNG。 接下来,设置一些训练变量、初始化列表并设置图像路径: 第32-34行定义模型的训练次数、初始学习率以及批量大小; 第38和39行初始化数据和标签列表,这些列表对应存储图像以及类别标签; 第42-44行获取输入图像路径并将图像随机打乱; 现在对图像进行预处理: 该循环简单的将每个图像的尺寸重新调整为28×28大小(为LeNet所需要的空间尺寸) 能够提取标签是由于我们的数据目录结构如下所示: 因此,imagePath的一个例子为: 从ImagePath提取标签,结果为: 下一步,将数据集分为训练数据集和测试数据集: 第61行进一步预处理输入数据,按比例将数据点[ 0, 255 ]缩放到[ 0, 1 ]范围内; 然后第66-67行将75%数据作为训练集,25%数据作为测试集;第70-71行对标签进行独热编码;随后,通过以下操作增加数据量: 第74-76行创建一个图像发生器,对数据集图像进行随机旋转、移动、翻转、剪切等,通过这种操作允许我们能用一个较小的数据集实现好的结果。 继续深入学习Keras训练图像分类器: 第80-83行使用Adam优化器,由于本文是一个二分类问题,可以使用二进制交叉熵损失函数(binary cross-entropy)。但如果执行的分类任务多于两类,损失函数更换为类别交叉熵(categorical_crossentropy) 第87-89行调用model.fit_generator开始训练网络,第93行保存模型参数,最后画出图像分类器的性能结果: 为了训练网络模型,需要打开一个终端执行以下命令: 可以看到,当网络训练了25个回合后,模型的测试精度为97.40%,损失函数也很低,如下图所示: 评估卷积神经网络图像分类器 打开一个新的文件并命名为test_networkpy,然后开始进行评估: 第2-7行导入需要的数据包,另外注意导入的load_model是训练过程中保存的模型。 下一步,解析命令行参数: 需要两个命令行参数:--model和输入--image,然后加载图像预处理: 预处理与前面几乎一模一样,这里不做过多的解释,只是第25行通过np.expand_dims对数据额外添加了一个维度,如果忘记添加维度,它将导致调用model.predict时出现错误。现在加载图像分类器模型并进行预测: 第29行加载模型,第32行做出预测。最后画出头像以及预测标签: 第35行建立标签,第36行选择对应的概率值,第37行将标签文本显示在图像的左上角,第40-42行调整图像大小为标准的宽度以确保它适应电脑屏幕,最后,第45行显示输出图像,第46行表示当一个键被按下结束显示。 以下是包含圣诞老人图像的实验结果: 以下是不包含圣诞老人图像的实验结果: 本文图像分类模型的局限性 本文图像分类器有一些局限性: 第一个是输入图像尺寸28×28很小。一些示例图像(图像中圣诞老人本身已经很小)调整尺寸为28×28后大大降低圣诞老人的尺寸。 最优的卷积神经网络正常接受输入图像大小一般为200-300像素,因此一些较大尺寸的图像将帮助我们建立一个更强大的图像分类器。然而,使用更大的分辨率的图像会加深网络模型的深度和复杂度,这将意味着需要收集更多的训练数据,以及昂贵的计算训练过程。 因此,如果各位读者想提高本文模型的精度话,有以下四点建议: 收集更多的训练数据(超过5000幅“圣诞老人”图像); 利用高分辨率的图像在训练。64×64、128×128像素的图像可能效果会更理想; 在训练过程中使用一个更深层次的网络体系结构; 阅读Deep Learning for Computer Vision with Python,里面有更多关于自定义数据集等内容的细节; 总结 本文教你学会利用Keras和Pyhton训练LeNet模型,并用来完成是否含有圣诞老人形象的图像分类,最终目标可以是建立一个应用程序类似于Not Hotdog; “圣诞老人”图像数据集(460幅)是按照之前的教程——通过谷歌图片采集深度学习的图像获得,而“没有圣诞老人”的图像数据集是由从UKBench数据集中挑选得到; 在一系列的测试图像上评估本文搭建的网络模型,在每一种情况下,本文模型都能对输入图像分类正确。 作者信息 Adrain Rosebrock,企业家、博士,专注于图像搜索引擎。 Linkedin:https://www.linkedin.com/in/adrian-rosebrock-59b8732a/ 本文由北邮@爱可可-爱生活老师推荐,阿里云云栖社区组织翻译。 文章原标题《Image classification with Keras and deep learning》,作者:Adrain Rosebrock,译者:海棠,审阅:董邵男。 文章为简译,更为详细的内容,请查看原文 翻译者: 海棠 Wechat:269970760 weibo:Uncle_LLD Email:duanzhch@tju.edu.cn 微信公众号:AI科技时讯

优秀的个人博客,低调大师

精选博客系列|VMware发布下一代Workspace ONE SaaS平台,性能提升了10倍!

我们很高兴地宣布下一代Workspace ONE SaaS平台面世了!日前公布的Workspace ONE架构的根本变化已经包含了我们最近的一些进展,例如自由式编排器,而且将成为未来VMware终端用户计算(EUC)创新的基石。 现代化的架构将为客户解锁显著的性能和规模增长——应用和配置文件交付至少提高10倍,设备管理更加流畅,管理起来也更加容易。 新的云原生Workspace ONE SaaS架构旨在满足现代企业需要高性能、可扩展性和安全性的需求,同时也帮助VMware显著提升功能开发速度——以更高的质量向我们的客户提供新的令人兴奋的功能。 为什么我们需要进行架构现代化改进? 我们认为,我们使用工作设备的地点和方式的不断演进以及相关挑战的出现,导致了需要进一步改进Workspace ONE架构, 原因如下: 1.多样化终端设备的爆炸式增长和Workspace ONE在企业中的采用率 我们生活在一个多设备世界,终端设备已经成为保持员工满意和提高生产力的重要因素。在过去的十年里,我们看到由Workspace ONE管理和安全保护的移动设备和桌面设备得到了巨大的增长。虽然终端设备的多样性水平扩展,但我们的每个客户的终端数量也垂直增长。这显然需要一种更强大的架构,以实现规模化性能,并在不断增长的终端复杂性中蓬勃发展。 2.新的业务挑战需要新的解决方案 多年来,Workspace ONE在终端用户计算方面不断推动创新:从MDM到EMM再到UEM的演进,到满足数字员工体验和零信任安全需求的不断增加,Workspace ONE解决方案始终保持领先。但为了在未来继续如此,我们必须从使我们到达这里的道路上向新的、无限的工程规模和创新可能性的道路继续前行。 3.不断演变的终端技术领域 随着UEM市场的成熟,我们认识到基本设备管理功能的商品化,并迅速通过更快的特性交付速度和质量来解决更高级别的功能,以按照优先级创建客户价值。一个例子是从“命令式”到“声明式”云管理模型的管理范式的转变。 我们做了什么? 我们的 EUC 团队开始了一项艰巨但有意义的探索,旨在重新定义未来几十年的现代架构愿景。 这一愿景将使 Workspace ONE 能够提供前所未有的客户价值。部署 Workspace ONE 的组织将能够将其部署规模扩展到数百万台设备,同时在资源工作负载方面获得超强的性能,以及自动化和分析功能,使业务结果优先于 IT 任务。 1.重构单体应用成现代微服务 整个过程的第一步涉及重新塑造 Workspace ONE UEM 的单体架构。这需要提取传统的功能,创建新的自包含、模块化、松散耦合的微服务,以提供高性能、可扩展性和质量。 实际上,正是这种对微服务的“底层”重构推动了我们几年前推出的第一批“现代”解决方案之一:Workspace ONE Freestyle Orchestrator。 但这仅仅是个开始。新服务架构的愿景是成为 Workspace ONE 平台未来所有创新的基石。作为客户,你将在端点管理、体验和安全性等诸方面看到这一点,例如 Windows 桌面多用户管理、Linux 端点管理、新的操作系统更新、漏洞管理等等。 2.拥抱期望状态管理:一种新的管理和安全范例 传统上,端点管理主要是基于“命令式”的,需要一系列不同的指令来实现设备最终的期望状态。简单地说,为了在设备上安装一个应用程序,需要一系列按顺序传递的指令,以达到应用程序被安装的最终状态。随着平台现代化的推进,我们走上了一条不同的期望状态管理(DSM, Desired State Management)的道路。 DSM并不是一个新概念。事实上,在服务器配置管理中,它是一种成熟的模型,其中管理的重点不在指令集上,而是在设备本身的高级状态上。 Workspace ONE现在被设计成能够了解设备的期望状态,当它检测到设备偏离了期望状态时,它会立即执行必要的任务,将设备恢复到期望状态。这种计算可以在客户端(桌面端)中执行以实现低延迟、离线的纠正(如果可能的话),也可以在服务器端进行轻量级端点(移动端)的纠正。这种新的范例转变为更好的安全性、设备合规性,甚至更加简化的设备管理,开启了巨大的机遇。 现在,由于苹果公司的声明式管理和谷歌的AMAPI,我们对能够预期到这种从命令式到声明式管理模型的演变欢欣鼓舞。我们很自豪地开始了早期的重构,以舒适地拥抱这个令人兴奋的新世界。 客户可以从这种新的Workspace ONE架构中获得哪些好处? 客户将从新的现代化架构中获得许多好处,以下是一些例子。 1.超强的性能和可扩展性 采用新的Workspace ONE架构,企业可以期望看到性能方面的显著提升。该架构设计能够处理大量的流量和用户,确保IT能够快速高效地交付应用和服务。架构现代化将为应用和配置文件交付提供至少10倍的改进,并提供至少10倍的管理员体验改进,通过更顺畅的设备管理功能和秒级无缝屏幕加载,即使在有数百万台设备的环境下也能实现。 2.更快的功能交付速度和更高的产品质量 基于服务的架构允许我们的工程团队显著提高开发和部署自包含模块化服务的能力。测试覆盖率、自动化以及服务之间低依赖性将带来更高的产品质量。这种新的架构也将允许我们将特定的功能解耦出来,以模块化的方式进行更新,以支持同日支持。例如,基于数据驱动的配置文件UI将使我们的客户能够通过浏览器控制台界面进行简单的刷新(无需对Workspace ONE UEM进行全面升级),就能呈现任何新的同日支持特性。 3.强大的低代码功能、先进的安全特性和创新 Workspace ONE不断维护设备期望状态的概念,未来将解锁先进安全和本地强制设备合规性的巨大机会。通过DSM与Freestyle Orchestrator提供的低代码编排能力相结合,将为终端用户计算IT团队提供一个强大的工具包,解决以前难懂的高阶业务问题。这种新的架构也将是新创新的基础——包括Microsoft Windows更新和多用户功能、Linux管理、Google的AMAPI和Apple的声明性管理。 我们何时可以看到现代的Workspace ONE架构和它的实际效果? SaaS UAT环境将于2023年上半年开始推出新的架构和性能改进。生产共享的SaaS和专用的SaaS环境将于2023年下半年开始推出新的架构和性能改进。所有基于新架构构建的新创新产品将在上述时间表之后不久推出。 内容来源|公众号:VMware 中国研发中心

优秀的个人博客,低调大师

[雪峰磁针石博客]python 3.7极速入门教程1安装:Linux(Ubuntu 18.04)及Windows上安装Anaconda

安装 Linux安装 Anaconda是最受欢迎的python数据科学和机器学习平台,用于大规模数据处理,预测分析和科学计算。Anaconda发行版附带了1,000多个数据包,conda命令行工具和Anaconda Navigator的桌面图形用户界面。一般而言,使用Anaconda比直接使用官方的python更好用。 本教程将指导您完成在Ubuntu 18.04上下载和安装Anaconda Python Distribution。通常也适合多数其他Linux。 下载Anaconda https://www.anaconda.com/download/#linux 在撰写本文时,Anaconda的最新稳定版本是5.3版本。 图片.png 请选择64-Bit (x86) Installer 进行下载,尽量不要用python2.7,很多库已经不提供python2.7支持。 点击链接就会进行下载,同时会弹出信息收集框,直接关闭就好。 图片.png 安装Anaconda $ sudo sh Anaconda3-5.3.0-Linux-x86_64.sh [sudo] andrew 的密码: Welcome to Anaconda3 5.3.0 In order to continue the installation process, please review the license agreement. Please, press ENTER to continue >>> # 按下回车 ... # 多次按空格读完license。 Do you accept the license terms? [yes|no] [no] >>> yes # 输入yes - Press ENTER to confirm the location - Press CTRL-C to abort the installation - Or specify a different location below ... [/home/andrew/anaconda3] >>> /usr/local/anaconda3 # 输入自定义目录 ... # 安装根据机器性能,通常需要持续几分钟。 # 讨论 钉钉群21745728 qq群144081101 567351477 # 本文地址:https://www.jianshu.com/p/9fe9ff999234 Do you wish to proceed with the installation of Microsoft VSCode? [yes|no] #选择no,一般来说自带的spyder和专业IDE wingIDE更好用。 ... Do you wish the installer to initialize Anaconda3 in your /home/andrew/.bashrc ? [yes|no] [no] >>> # 选择yes Initializing Anaconda3 in /home/andrew/.bashrc A backup will be made to: /home/andrew/.bashrc-anaconda3.bak For this change to become active, you have to open a new terminal. Thank you for installing Anaconda3! =========================================================================== Anaconda is partnered with Microsoft! Microsoft VSCode is a streamlined code editor with support for development operations like debugging, task running and version control. To install Visual Studio Code, you will need: - Administrator Privileges - Internet connectivity Visual Studio Code License: https://code.visualstudio.com/license Do you wish to proceed with the installation of Microsoft VSCode? [yes|no] >>> no 添加“export PATH=/usr/local/anconda3/bin:$PATH“ 到/etc/profile,这样所有用户都可以使用Anaconda python3.7了。 上面的.bashrc在刚才安装时添加了如下内容: # added by Anaconda3 5.3.0 installer # >>> conda init >>> # !! Contents within this block are managed by 'conda init' !! __conda_setup="$(CONDA_REPORT_ERRORS=false '/usr/local/anaconda3/bin/conda' shell.bash hook 2> /dev/null)" if [ $? -eq 0 ]; then \eval "$__conda_setup" else if [ -f "/usr/local/anaconda3/etc/profile.d/conda.sh" ]; then . "/usr/local/anaconda3/etc/profile.d/conda.sh" CONDA_CHANGEPS1=false conda activate base else \export PATH="/usr/local/anaconda3/bin:$PATH" fi fi unset __conda_setup~/.bashrc # <<< conda init <<< 验证安装 通过重新登陆或者执行'source ~/.bashrc"加载环境变量。 $ conda info active environment : base active env location : /usr/local/anaconda3 shell level : 1 user config file : /home/andrew/.condarc populated config files : conda version : 4.5.11 conda-build version : 3.15.1 python version : 3.7.0.final.0 base environment : /usr/local/anaconda3 (read only) channel URLs : https://repo.anaconda.com/pkgs/main/linux-64 https://repo.anaconda.com/pkgs/main/noarch https://repo.anaconda.com/pkgs/free/linux-64 https://repo.anaconda.com/pkgs/free/noarch https://repo.anaconda.com/pkgs/r/linux-64 https://repo.anaconda.com/pkgs/r/noarch https://repo.anaconda.com/pkgs/pro/linux-64 https://repo.anaconda.com/pkgs/pro/noarch package cache : /usr/local/anaconda3/pkgs /home/andrew/.conda/pkgs envs directories : /home/andrew/.conda/envs /usr/local/anaconda3/envs platform : linux-64 user-agent : conda/4.5.11 requests/2.19.1 CPython/3.7.0 Linux/4.15.0-36-generic ubuntu/18.04 glibc/2.27 UID:GID : 1000:1000 netrc file : None offline mode : False $ python Python 3.7.0 (default, Jun 28 2018, 13:15:42) [GCC 7.2.0] :: Anaconda, Inc. on linux Type "help", "copyright", "credits" or "license" for more information. >>> 至此,已经安装完毕。 更新Anaconda 一般是有新版本发布时才需要使用。 $ conda update conda $ conda update anaconda 删除Anaconda 一般是有新版本发布时才需要使用。 $sudo rm -rf /usr/local/anaconda3 删除上面~/.bashrc和/etc/profile的修改 清空隐藏文件: rm -rf ~/.condarc ~/.conda ~/.continuum 参考资料 讨论qq群144081101 591302926 567351477 钉钉免费群21745728 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 https://linuxize.com/post/how-to-install-anaconda-on-ubuntu-18-04/ Windows安装 下载,比如:https://repo.anaconda.com/archive/Anaconda3-5.3.0-Windows-x86_64.exe 执行: 图片.png 图片.png 图片.png 图片.png 图片.png 上面红色的部分一定要选中,这样会帮你自动配置环境变量。 图片.png 图片.png 图片.png 图片.png 新开cmd,输入python 图片.png 命令行输入spyder 图片.png wingide 图片.png MAC安装 MAC的安装和Windows类似。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册