首页 文章 精选 留言 我的

精选列表

搜索[技术极客],共10000篇文章
优秀的个人博客,低调大师

ChatGPT小型平替之ChatGLM-6B本地化部署、接入本地知识库体验 | 京东云技术团队

本文期望通过本地化部署一个基于LLM模型的应用,能让大家对构建一个完整的应用有一个基本认知。包括基本的软硬环境依赖、底层的LLM模型、中间的基础框架及最上层的展示组件,最终能达到在本地零编码体验的目的。 一、ChatGLM-6B模型介绍 https://github.com/THUDM/ChatGLM-6B [Star 27.6k] 一个清华开源的、支持中英双语的对话语言模型,基于GLM架构,62亿参数。可以本地安装部署运行在消费级的显卡上做模型的推理和训练。 开源10天10000stars 当天在GitHub的趋势排行第一 Huggingface下载超过100万 开源的训练数据量达到1万亿字符的模型 1、能力 自我认知 文案写作 提纲写作 信息抽取 2、缺点 模型容量小导致回答存在偏见内容,推理能力较弱 3、场景 垂直领域知识 基于私有数据的问答 二、部署体验 1、环境依赖: 硬件: 基于GPU,建议16GB起步,建议24GB+体验,否则多轮容易爆显存; 无GPU可以仅用CPU,大约需要25GB内存,CPU会慢一点,本次不使用。 软件: CUDA 11.7+ Python3.10.8+ pip3 git 2、钞能力-算力市场: 强烈不建议本地部署,一整套硬件价值不菲,费时耗力,按需购买算力对于体验来说最划算,建议使用京东Ku+平台即可,目前都有配额,可直接申请使用,本次演示流程基于autodl算力平台搭建: ▪http://kuplus.jd.com [Ku+] ▪https://www.autodl.com [AutoDL] 3、下载demo: # 下载项目源代码 git clone https://github.com/THUDM/ChatGLM-6B # 切换到项目根目录 cd ChatGLM-6B # 安装依赖 pip install -r requirements.txt # 安装回老版本gradio,解决输出内容未渲染html标签问题 pip install gradio==3.28.3 # 如果pip下载有问题,修改其他源,比例douban或aliyun,没有pip.conf需新建 mkdir ~/.pip && touch ~/.pip/pip.conf && vim ~/.pip/pip.conf [global] index-url=http://pypi.douban.com/simple/ [install] trusted-host=pypi.douban.com 4、下载模型: # 直接git下载模型,大约需要13G空间 git clone https://huggingface.co/THUDM/chatglm-6b # 或者部分地区可能无法下载,可以使用镜像单独下载,新建url.txt, 拷贝以下镜像地址保存 https://cloud.tsinghua.edu.cn/seafhttp/files/08ff8050-912c-47b8-ad5c-56bcd231df71/ice_text.model https://cloud.tsinghua.edu.cn/seafhttp/files/88a7978c-8eda-498d-85e8-0671294a4c47/pytorch_model-00001-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/de998e41-7093-41b3-84f1-59e32361e703/pytorch_model-00002-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/077b5058-5ebd-4930-9470-8e873c01f47c/pytorch_model-00003-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/728f7324-ce96-44bc-a08f-5c7222727ca5/pytorch_model-00004-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/932b40ac-d195-4ba4-8d06-7946b8e6d0d8/pytorch_model-00005-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/d763678e-c438-416b-a4b9-5594c52cb3f6/pytorch_model-00006-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/59da96fd-8eb9-42d4-992e-03e1d0637a01/pytorch_model-00007-of-00008.bin https://cloud.tsinghua.edu.cn/seafhttp/files/849d7de4-9253-487a-bc37-9a43418e3c0c/pytorch_model-00008-of-00008.bin # 此处文件夹名称使用THUDM/chatglm-6b mkdir -p THUDM/chatglm-6b && cd THUDM/chatglm-6b && touch url.txt # 保存批量下载地址 vim url.txt # 执行wget批量下载到当前文件夹 wget -i url.txt 5、安装运行: 打开 web_demo.py # 一、如果模型位置不是默认path,修改如下位置: tokenizer = AutoTokenizer.from_pretrained("THUDM/chatglm-6b", trust_remote_code=True) model = AutoModel.from_pretrained("THUDM/chatglm-6b", trust_remote_code=True).half().cuda() # 二、找到最后一行或者类似 queue().launch 位置,指定ip、端口方便外网映射用,一般算力市场会默认提供一个映射端口,指定即可: demo.queue().launch(share=False, inbrowser=True, server_name='0.0.0.0', server_port=6006) # 启动 python web_demo.py root@autodl-container-9494499a62-3e5ab6d1:~/ChatGLM-6B# python web_demo.py Explicitly passing a `revision` is encouraged when loading a model with custom code to ensure no malicious code has been contributed in a newer revision. Explicitly passing a `revision` is encouraged when loading a configuration with custom code to ensure no malicious code has been contributed in a newer revision. Explicitly passing a `revision` is encouraged when loading a model with custom code to ensure no malicious code has been contributed in a newer revision. Loading checkpoint shards: 100%|█████████████████████████████████████████████████████████████████████| 8/8 [00:10<00:00, 1.36s/it] Running on local URL: http://0.0.0.0:6006 To create a public link, set `share=True` in `launch()`. 6、实际效果、资源占用: 主机配置 演示效果  7、推理参数含义: · Maximum length 通常用于限制输入序列的最大长度,因为ChatGLM-6B是2048长度推理的,一般这个保持默认就行, 太大可能会导致性能下降 · Top P Top P 参数是指在生成文本等任务中,选择可能性最高的前P个词的概率累加和。这个参数被称为Top P,也称为Nucleus Sampling。 例如,如果将Top P参数设置为0.7,那么模型会选择可能性排名超过70%的词进行采样。这样可以保证生成的文本准确性较高,但可能会缺乏多样性。相反,如果将Top P参数设置为0.3,则会选择可能性超过30%的词进行采样,这可能会导致生成文本的准确性下降,但能够更好地增加多样性。 · Temperature Temperature参数通常用于调整softmax函数的输出,用于增加或减少模型对不同类别的置信度。 具体来说,softmax函数将模型对每个类别的预测转换为概率分布。Temperature参数可以看作是一个缩放因子,它可以增加或减少softmax函数输出中每个类别的置信度。 例如,将Temperature设置为0.05和0.95的主要区别在于,T=0.05会使得模型更加自信,更加倾向于选择概率最大的类别作为输出,而T=0.95会使得模型更加不确定,更加倾向于输出多个类别的概率值较大。 8、其他好玩的: 看图说话,VisualGLM-6B,一个支持图像理解的多模态对话语言模型,语言模型基于ChatGLM-6B。 三、结合LangChain实现本地知识库 1、LangChain: https://github.com/hwchase17/langchain [Star 45k] ⽤于开发由语⾔模型驱动的应⽤程序的基础框架,是一个链接面向用户程序和LLM之间的中间层,可以理解成是一个lib。 · 简介原理 · 主要功能 1.调⽤语⾔模型; 2.将不同数据源接⼊到语⾔模型的交互中; 3.允许语⾔模型与运⾏环境交互。 · 模块介绍 1.Modules:⽀持的模型类型和集成; 2.Prompt:提示词管理、优化和序列化; 3.Memory:内存是指在链/代理调⽤之间持续存在的状态; 4.Indexes:当语⾔模型与特定于应⽤程序的数据相结合时,会变得更加强⼤-此模块包含⽤于加载、查询和更新外部数据的接⼝和集成; 5.Chain:链是结构化的调⽤序列(对LLM或其他实⽤程序); 6.Agents:代理是⼀个链,其中LLM在给定⾼级指令和⼀组⼯具的情况下,反复决定操作,执⾏操作并观察结果,直到⾼级指令执行完成; 7.Callbacks:回调允许您记录和流式传输任何链的中间步骤,从⽽轻松观察、调试和评估应⽤程序的内部。 2、LangChain-ChatGLM https://github.com/imClumsyPanda/langchain-ChatGLM [Star 8k] 一种利用langchain实现的基于本地知识库的问答应用,目标期望建立一套对中文场景与开源模型支持友好、可离线运行的知识库问答解决方案。 实现过程:包括加载文件 -> 读取文本 -> 文本分割 -> 文本向量化 -> 问句向量化 -> 在文本向量中匹配出与问句向量最相似的top k个 -> 匹配出的文本作为上下文和问题一起添加到prompt中 -> 提交给LLM生成回答。 · 项⽬特点 1.依托ChatGLM等开源模型实现,可离线部署; 2.基于langchain实现,可快速实现接⼊多种数据源; 3.在分句、⽂档读取等⽅⾯,针对中⽂使⽤场景优化; 4.⽀持pdf、txt、md、docx等⽂件类型接⼊,具备命令⾏demo、webui和vue前端。 · 项⽬结构 1.models:llm的接⼝类与实现类,针对开源模型提供流式输出⽀持; 2.loader:⽂档加载器的实现类; 3.textsplitter:⽂本切分的实现类; 4.chains:⼯作链路实现,如chains/local_doc_qa实现了基于本地⽂档的问答实现; 5.content:⽤于存储上传的原始⽂件; 6.vector_store:⽤于存储向量库⽂件,即本地知识库本体; 7.configs:配置⽂件存储。 · 安装部署 与ChatGLM安装基本类似,git clone之后修改模型地址到本地chartglm-6b的path启动即可,如果使用AutoDL平台,可用镜像一键拉起,镜像保持最新master版本,可体验最新功能。 最新镜像地址,已包含离线llm model: chatglm-6b 和 embedding: text2vec-large-chinese: https://www.codewithgpu.com/i/Liudapeng/langchain-ChatGLM/langchain-chatglm-master # 新增一步,下载离线 embedding model sudo apt-get install git-lfs git lfs install git clone https://huggingface.co/GanymedeNil/text2vec-large-chinese # 启用本地离线模型 vim ~/langchain-ChatGLM/configs/model_config.py # 1、修改 embedding path embedding_model_dict = { "text2vec": "/root/GanymedeNil/text2vec-large-chinese", } # 2、修改 llm path, 直接指向为第一章节的 chatglm-6b path即可 "chatglm-6b": { "name": "chatglm-6b", "pretrained_model_name": "THUDM/chatglm-6b", "local_model_path": "/root/ChatGLM-6B/THUDM/chatglm-6b", "provides": "ChatGLM" } # 3、启用本地模型 NO_REMOTE_MODEL = True # 运行Gradio web demo cd ~/langchain-ChatGLM/ root@autodl-container-95b111aeb0-c6fdac9f:~/langchain-ChatGLM# python webui.py INFO 2023-06-08 14:10:58,531-1d: loading model config llm device: cuda embedding device: cuda dir: /root/langchain-ChatGLM flagging username: dc706ff885da43a8b0e8181bcc72ad1e WARNING: OMP_NUM_THREADS set to 14, not 1. The computation speed will not be optimized if you use data parallel. It will fail if this PaddlePaddle binary is compiled with OpenBlas since OpenBlas does not support multi-threads. PLEASE USE OMP_NUM_THREADS WISELY. Loading chatglm-6b... Loading checkpoint shards: 100%|██████████████████████████████████████████████████████████████████████████████| 8/8 [00:13<00:00, 1.66s/it] Loaded the model in 23.48 seconds. INFO 2023-06-08 14:11:26,780-1d: Load pretrained SentenceTransformer: /root/GanymedeNil/text2vec-large-chinese {'answer': '你好👋!我是人工智能助手 ChatGLM-6B,很高兴见到你,欢迎问我任何问题。'} INFO 2023-06-08 14:11:33,694-1d: 模型已成功加载,可以开始对话,或从右侧选择模式后开始对话 Running on local URL: http://0.0.0.0:6006 To create a public link, set `share=True` in `launch()`. · 效果对比 LLM回答 LLM+知识库 知识库来源 四、视图框架 快速构建针对人工智能的python的webApp库,封装前端页面+后端接口+AI算法模型推理,方便AI算法工程师快速展示成果,常用的两个展示层框架: 1、Gradio: 优势在于易用性,代码结构相比Streamlit简单,只需简单定义输入和输出接口即可快速构建简单的交互页面,更轻松部署模型。适合场景相对简单,想要快速部署应用的开发者; 2、Streamlit: 优势在于可扩展性,相比Gradio复杂。适合场景相对复杂,想要构建丰富多样交互页面的开发者。 作者:京东科技 刘大朋 来源:京东云开发者社区

优秀的个人博客,低调大师

☕【Java深层系列】「并发编程系列」让我们一起探索一下CountDownLatch的技术原理和源码分析

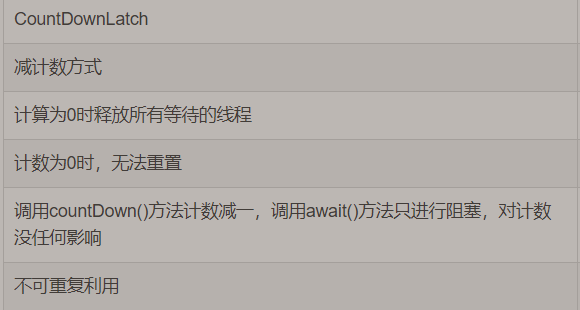
CountDownLatch工作原理分析 一、大致介绍 那么本篇文章和大家分享分析一下JDK1.8的CountDownLatch的工作原理; 简单认识CountDownLatch 何为CountDownLatch? CountDownLatch从字面上理解,count计数做down的减法动作,而Latch又是门闩的意思; CountDownLatch是一种同步帮助,允许一个或多个线程等待,直到在其他线程中执行的一组操作完成; CountDownLatch内部没有所谓的公平锁\非公平锁的静态内部类,只有一个Sync静态内部类,CountDownLatch内部基本上也是通过sync.xxx之类的这种调用方式的; CountDownLatch内部维护了一个虚拟的资源池,如果许可数不为为0一直线程阻塞等待,直到许可数为0时才释放继续往下执行; CountDownLatch的state关键词 其实CountDownLatch的实现也恰恰很好利用了其父类AQS的state变量值; 初始化一个数量值作为计数器的默认值,假设为N,那么当任何线程调用一次countDown则计数值减1,直到许可为0时才释放等待; CountDownLatch,简单大致意思为:A组线程等待另外B组线程,B组线程执行完了,A组线程才可以执行; 常用重要的方法 创建一个给定许计数值的计数同步器对象 public CountDownLatch(int count) 入队等待,直到计数器值为0则释放等待 public void await() 释放许可,计数器值减1,若计数器值为0则触发释放无用结点 public void countDown() 获取目前最新的共享资源计数器值 public long getCount() 设计与实现伪代码 获取共享锁: 如果检测中断状态发现被中断过的话,那么则抛出InterruptedException异常 如果尝试获取共享锁失败的话( 尝试获取共享锁的各种方式由AQS的子类实现 ), 那么就新增共享锁结点通过自旋操作加入到队列中,然后通过调用LockSupport.park进入阻塞等待,直到计数器值为零才释放等待 public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } 释放共享锁: 如果尝试释放共享锁失败的话( 尝试释放共享锁的各种方式由AQS的子类实现 ), 那么通过自旋操作完成阻塞线程的唤起操作 public void countDown() { sync.releaseShared(1); } CountDownLatch生活细节化理解 比如百米赛跑,我就以赛跑为例生活化阐述该CountDownLatch原理: 1、场景:百米赛跑十人参赛,终点处有一个裁判计数; 2、开跑一声起跑信号,十个人争先恐后的向终点跑去,真的是振奋多秒,令人振奋; 3、当一个人到达终点,这个人就完成了他的赛跑事情了,就没事一边玩去了,那么裁判则减去一个人; 4、随着人员陆陆续续的都跑到了终点,最后裁判计数显示还有0个人未到达,意思就是人员都达到了; 5、然后裁判就拿着登记的成绩屁颠屁颠去输入电脑登记了; 6、到此打止,这一系列的动作认为是A组线程等待另外其他组线程的操作,直到计数器为零,那么A则再干其他事情; 源码分析CountDownLatch CountDownLatch构造器 构造器源码: /** * Constructs a {@code CountDownLatch} initialized with the given count. * * @param count the number of times {@link #countDown} must be invoked * before threads can pass through {@link #await} * @throws IllegalArgumentException if {@code count} is negative */ public CountDownLatch(int count) { if (count < 0) throw new IllegalArgumentException("count < 0"); this.sync = new Sync(count); } 2、创建一个给定许计数值的计数同步器对象,计数器值必须大于零,count值最后赋值给了state这个共享资源值; Sync同步器 AQS --> Sync CountDownLatch内的同步器都是通过Sync抽象接口来操作调用关系的,细看会发现基本上都是通过sync.xxx之类的这种调用方式的; await() 源码 /** * Causes the current thread to wait until the latch has counted down to * zero, unless the thread is {@linkplain Thread#interrupt interrupted}. * * // 导致当前线程等待,直到计数器值减为零则释放等待,或者由于线程被中断也可导致释放等待; * * <p>If the current count is zero then this method returns immediately. * * <p>If the current count is greater than zero then the current * thread becomes disabled for thread scheduling purposes and lies * dormant until one of two things happen: * <ul> * <li>The count reaches zero due to invocations of the * {@link #countDown} method; or * <li>Some other thread {@linkplain Thread#interrupt interrupts} * the current thread. * </ul> * * <p>If the current thread: * <ul> * <li>has its interrupted status set on entry to this method; or * <li>is {@linkplain Thread#interrupt interrupted} while waiting, * </ul> * then {@link InterruptedException} is thrown and the current thread's * interrupted status is cleared. * * @throws InterruptedException if the current thread is interrupted * while waiting */ public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } await此方法被调用后,则一直会处于等待状态,其核心还是由于调用了LockSupport.park进入阻塞等待; 当计数器值state=0时可以打破等待现状,当然还有线程被中断后也可以打破线程等待现状; acquireSharedInterruptibly(int) 源码: /** * Acquires in shared mode, aborting if interrupted. Implemented * by first checking interrupt status, then invoking at least once * {@link #tryAcquireShared}, returning on success. Otherwise the * thread is queued, possibly repeatedly blocking and unblocking, * invoking {@link #tryAcquireShared} until success or the thread * is interrupted. * @param arg the acquire argument. * This value is conveyed to {@link #tryAcquireShared} but is * otherwise uninterpreted and can represent anything * you like. * @throws InterruptedException if the current thread is interrupted */ public final void acquireSharedInterruptibly(int arg) throws InterruptedException { if (Thread.interrupted()) // 调用之前先检测该线程中断标志位,检测该线程在之前是否被中断过 throw new InterruptedException(); // 若被中断过的话,则抛出中断异常 if (tryAcquireShared(arg) < 0) // 尝试获取共享资源锁,小于0则获取失败,此方法由AQS的具体子类实现 doAcquireSharedInterruptibly(arg); // 将尝试获取锁资源的线程进行入队操作 } 由于是实现同步计数器功能,所以tryAcquireShared首次调用必定小于0,则就顺利了进入了doAcquireSharedInterruptibly线程等待; 至于首次调用为什么会小于0,请看子类的实现,子类的实现判断为 "(getState() == 0) ? 1 : -1" ; 3.5、tryAcquireShared(int) 源码 protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; // 计数器值与零比较判断,小于零则获取锁失败,大于零则获取锁成功 } 尝试获取共享锁资源,但是在计数器CountDownLatch这个功能中,小于零则需要入队,进入阻塞队列进行等待;大于零则唤醒等待队列,释放await方法的阻塞等待; doAcquireSharedInterruptibly(int) 源码 /** * Acquires in shared interruptible mode. * @param arg the acquire argument */ private void doAcquireSharedInterruptibly(int arg) throws InterruptedException { // 按照给定的mode模式创建新的结点,模式有两种:Node.EXCLUSIVE独占模式、Node.SHARED共享模式; final Node node = addWaiter(Node.SHARED); // 创建共享模式的结点 boolean failed = true; try { for (;;) { // 自旋的死循环操作方式 final Node p = node.predecessor(); // 获取结点的前驱结点 if (p == head) { // 若前驱结点为head的话,那么说明当前结点自然不用说了,仅次于老大之后的便是老二了咯 int r = tryAcquireShared(arg); // 而且老二也希望尝试去获取一下锁,万一头结点恰巧刚刚释放呢?希望还是要有的,万一实现了呢 if (r >= 0) { // 若r>=0,说明已经成功的获取到了共享锁资源 setHeadAndPropagate(node, r); // 把当前node结点设置为头结点,并且调用doReleaseShared释放一下无用的结点 p.next = null; // help GC failed = false; return; } // 但是在await方法首次被调用会流转到此,这个时候获取锁资源会失败,即r<0,所以会进入是否需要休眠的判断 // 但是第一次进入休眠方法,因为被创建的结点waitStatus=0,所以会被修改一次为SIGNAL状态,再次循环一次 // 而第二次循环进入shouldParkAfterFailedAcquire方法时,返回true就是需要休眠,则顺利调用park方式阻塞等待 } if (shouldParkAfterFailedAcquire(p, node) && // 根据前驱结点看看是否需要休息一会儿 parkAndCheckInterrupt()) // 阻塞操作,正常情况下,获取不到共享锁,代码就在该方法停止了,直到被唤醒 // 被唤醒后,发现parkAndCheckInterrupt()里面检测了被中断了的话,则补上中断异常,因此抛了个异常 throw new InterruptedException(); } } finally { if (failed) cancelAcquire(node); } } doAcquireSharedInterruptibly在实现计数器原理的时候,主要的干的事情就是等待再等待,等到计数器值为零时才苏醒; countDown() 源码 /** * Decrements the count of the latch, releasing all waiting threads if * the count reaches zero. * * <p>If the current count is greater than zero then it is decremented. * If the new count is zero then all waiting threads are re-enabled for * thread scheduling purposes. * * <p>If the current count equals zero then nothing happens. */ public void countDown() { sync.releaseShared(1); // 释放一个许可资源 } 释放许可资源,也就是计数器值不断的做减1操作,当计数器值为零的时候,该方法将会释放所有正在等待的线程队列;至于为什么还会释放所有,请看后续的releaseShared(int arg)讲解; releaseShared(int) 源码: /** * Releases in shared mode. Implemented by unblocking one or more * threads if {@link #tryReleaseShared} returns true. * * @param arg the release argument. This value is conveyed to * {@link #tryReleaseShared} but is otherwise uninterpreted * and can represent anything you like. * @return the value returned from {@link #tryReleaseShared} */ public final boolean releaseShared(int arg) { if (tryReleaseShared(arg)) { // 尝试释放共享锁资源,此方法由AQS的具体子类实现 doReleaseShared(); // 自旋操作,唤醒后继结点 return true; // 返回true表明所有线程已释放 } return false; // 返回false表明目前还没释放完全,只要计数器值不为零的话,那么都会返回false } releaseShared方法首先就判断了tryReleaseShared(arg)的返回值,但是计数器值只要不为零,都会返回false,因此releaseShared该方法就立马返回false了; 所以当计数器值慢慢减至零时,则立马返回true,那么也就立马会调用doReleaseShared释放所有等待的线程队列; tryReleaseShared(int) 源码: // CountDownLatch 的静态内部类 Sync 类的 tryReleaseShared 方法 protected boolean tryReleaseShared(int releases) { // Decrement count; signal when transition to zero for (;;) { // 自旋的死循环操作方式 int c = getState(); // 获取最新的计数器值 if (c == 0) // 若计数器值为零,说明已经通过CAS操作减至零了,所以在并发中读取到零时并不需要做什么操作,因此返回false return false; int nextc = c-1; // 计数器值减1操作 if (compareAndSetState(c, nextc)) // 通过CAS比较,顺利情况下设置成功返回true return nextc == 0; // 当通过计算操作得到的nextc为零时通过CAS修改成功,那么表明所有事情都已经做完,需要释放所有等待的线程队列 // 若CAS失败,想都不用想肯定是由于并发操作,导致CAS失败,那么唯一可做的就是下一次循环查看是否已经被其他线程处理了 } } CountDownLatch的静态内部类实现父类AQS的方法,用来处理如何释放锁,笼统的讲,若返回负数则需要进入阻塞队列,否则需要释放所有等待队列; doReleaseShared() 主要目的是释放线程中所有等待的队列,当计数器值为零时,此方法马上会被调用,通过自旋方式轮询干掉所有等待的队列; /** * Release action for shared mode -- signals successor and ensures * propagation. (Note: For exclusive mode, release just amounts * to calling unparkSuccessor of head if it needs signal.) */ private void doReleaseShared() { /* * Ensure that a release propagates, even if there are other * in-progress acquires/releases. This proceeds in the usual * way of trying to unparkSuccessor of head if it needs * signal. But if it does not, status is set to PROPAGATE to * ensure that upon release, propagation continues. * Additionally, we must loop in case a new node is added * while we are doing this. Also, unlike other uses of * unparkSuccessor, we need to know if CAS to reset status * fails, if so rechecking. */ for (;;) { // 自旋的死循环操作方式 Node h = head; // 每次都是取出队列的头结点 if (h != null && h != tail) { // 若头结点不为空且也不是队尾结点 int ws = h.waitStatus; // 那么则获取头结点的waitStatus状态值 if (ws == Node.SIGNAL) { // 若头结点是SIGNAL状态则意味着头结点的后继结点需要被唤醒了 // 通过CAS尝试设置头结点的状态为空状态,失败的话,则继续循环,因为并发有可能其它地方也在进行释放操作 if (!compareAndSetWaitStatus(h, Node.SIGNAL, 0)) continue; // loop to recheck cases unparkSuccessor(h); // 唤醒头结点的后继结点 } // 如头结点为空状态,则把其改为PROPAGATE状态,失败的则可能是因为并发而被改动过,则再次循环处理 else if (ws == 0 && !compareAndSetWaitStatus(h, 0, Node.PROPAGATE)) continue; // loop on failed CAS } // 若头结点没有发生什么变化,则说明上述设置已经完成,大功告成,功成身退 // 若发生了变化,可能是操作过程中头结点有了新增或者啥的,那么则必须进行重试,以保证唤醒动作可以延续传递 if (h == head) // loop if head changed break; } } 总结 1、有了分析AQS的基础后,再来分析CountDownLatch便快了很多; 2、在这里我简要总结一下CountDownLatch的流程的一些特性: • 管理一个大于零的计数器值; • 每countDown一次则state就减1一次,直到许可证数量等于0则释放队列中所有的等待线程; • 也可以通过countDown/await组合一起使用,来实现CyclicBarrier的功能; CountDownLatch用法 CountDownLatch类只提供了一个构造器: public CountDownLatch(int count) { }; //参数count为计数值 然后下面这3个方法是CountDownLatch类中最重要的方法: public void await() throws InterruptedException { }; //调用await()方法的线程会被挂起,它会等待直到count值为0才继续执行 public boolean await(long timeout, TimeUnit unit) throws InterruptedException { }; //和await()类似,只不过等待一定的时间后count值还没变为0的话就会继续执行 public void countDown() { }; //将count值减1 CountDownLatch, 一个同步辅助类,在完成一组正在其他线程中执行的操作之前,它允许一个或多个线程一直等待。 举个例子说明: package main.java.CountDownLatch; import java.util.concurrent.CountDownLatch; public class countDownlatchTest { public static void main(String[] args) throws InterruptedException { CountDownLatch countDownLatch = new CountDownLatch(5); for(int i=0;i<5;i++){ new Thread(new readNum(i,countDownLatch)).start(); } countDownLatch.await(); System.out.println("线程执行结束。。。。"); } static class readNum implements Runnable{ private int id; private CountDownLatch latch; public readNum(int id,CountDownLatch latch){ this.id = id; this.latch = latch; } @Override public void run() { synchronized (this){ System.out.println("id:"+id); latch.countDown(); System.out.println("线程组任务"+id+"结束,其他任务继续"); } } } } 输出结果: id:1 线程组任务1结束,其他任务继续 id:0 线程组任务0结束,其他任务继续 id:2 线程组任务2结束,其他任务继续 id:3 线程组任务3结束,其他任务继续 id:4 线程组任务4结束,其他任务继续 线程执行结束。。。。 线程在countDown()之后,会继续执行自己的任务

优秀的个人博客,低调大师

【CI/CD技术专题】「Jenkins实战系列」(1)全流程介绍Jenkins环境搭建+基础部署配置(Windows->Linux)

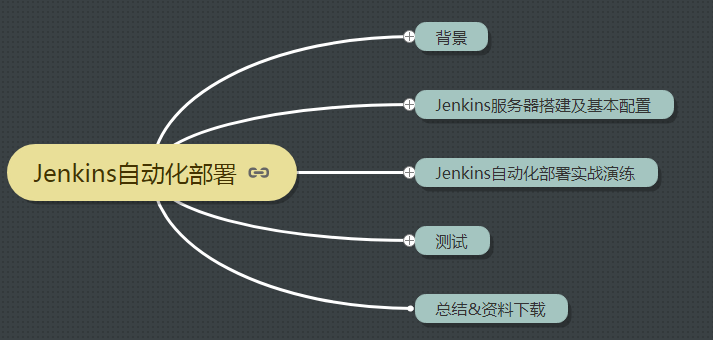
背景 在实际开发中,我们经常要一边开发一边测试,当然这里说的测试并不是程序员对自己代码的单元测试,而是同组程序员将代码提交后,由测试人员测试; 前后端分离后,经常会修改接口,然后重新部署;这些情况都会涉及到频繁的打包部署; 手动打包常规步骤: git commit + git push 提交代码 问一下同组小伙伴有没有要提交的代码 拉取代码并打包(war包,或者jar包) 上传到Linux服务器 查看当前程序是否在运行 关闭当前程序 启动新的jar包 观察日志看是否启动成功 如果有同事说,自己还有代码没有提交......再次重复1到8的步骤。 基于以上的痛点,有一种工具能够实现,将代码提交到git后就自动打包部署勒,答案是肯定的:现在这里主要介绍jenkins 当然除了Jenkins以外,也还有其他的工具可以实现自动化部署,如Hudson、gitlab CI/CD等。只是Jenkins相对来说,使用得更广泛。 文章结构: Jenkins服务器搭建及基本配置 简介 Jenkins是一个开源软件项目,是基于Java开发的一种持续集成工具,用于监控持续重复的工作,旨在提供一个开放易用的软件平台,使软件的持续集成变成可能。 Jenkins自动化部署实现原理 Jenkins部署环境 基本环境 jdk环境,Jenkins是java语言开发的,因需要jdk环境。 git/svn客户端,因一般代码是放在git/svn服务器上的,我们需要拉取代码。 maven客户端,因一般java程序是由maven工程,需要maven打包,当然也有其他打包方式,如:gradle 以上是自动化部署java程序jenkins需要的基本环境,请自己提前安装好,下面着重讲解Jenkins的安装部署配置。 Jenkins安装 下载安装包jenkins.war; 在安装包根路径下,运行命令 java -jar jenkins.war --httpPort=8080,(linux环境、Windows环境都一样); 打开浏览器进入链接 http://localhost:8080. 填写初始密码,激活系统 进入插件安装选择 这里建议选择,推荐安装的插件,保证基本常用的功能可以使用。 中文版 英文版 选择后,进入插件安装页面 设置初始用户和密码 进入系统,安装完成 Jenkins基本配置 系统初始化配置 Configure System (系统设置) 在系统设置这里,我们只需要设置最后面的一项,配置远程服务器地址, 即我们代码最终运行的服务器地址信息,就像我们之前手动部署时使用xshell登录Linux服务器一样, 当然这里是可以配置多台远程Linux服务器的,配置完成后点击保存即可,为后面我们配置自动化部署做准备,配置如下图 Configure Global Security (全局安全配置) 配置用户相关的权限 配置钩子程序(当用代码更新时通知)访问权限,避免报403错误 默认是勾选上了的,这里去掉勾选 Global Tool Configuration (全局工具配置 ) 配置maven的全局settings路径 配置jdk 配置git 配置maven的安装路径 配置必要插件 主要是检查如下这两个插件是否已安装 插件1:Publish over SSH 插件2:Deploy to container Plugin Jenkins自动化部署 我们配置一个自动化部署的的java程序(springBoot+maven+gitHub),基本必要配置就差不多了,后面配置过程中如果需要在配置。 Jenkins服务器上创建项目和配置 大体步骤:General(基础配置)--》源码管理--》构建触发器--》构建环境--》构建--》构建后操作 创建一个工程 General(基础配置) 仅需填写标准部分,其他可不填写 源码管理 上图中点击“添加”按钮添加一组账号和密码 构建触发器 如上图:当前项目的回调地址为: http://localhost:8080/job/jenkinsSpringBootDemo/build?token=token_demo2 只要执行这个地址(在浏览器上访问改地址),该项目就会发起一次构建项目,即拉取代码打包部署操作,在实际中,是由git服务器回调该地址。 构建环境(无需配置) 构建 构建后操作 构建后操作的意思是,jar打包好后,要将jar发送到哪里去,发送后去和启动等。 这里需要提前在需要部署的服务器上配置好路径,写好启动和停止项目的脚本,并设置为可以执行的脚本, 其实就是我们平时在Linux上手动部署项目操作的脚本。 案例中给出的start.sh脚本如下: #!/bin/bash export JAVA_HOME=/usr/java/jdk1.8.0_131 echo ${JAVA_HOME} echo 'Start the program : demo2-0.0.1-SNAPSHOT.jar' chmod 777 /home/ldp/app/demo2-0.0.1-SNAPSHOT.jar echo '-------Starting-------' cd /home/ldp/app/ nohup ${JAVA_HOME}/bin/java -jar demo2-0.0.1-SNAPSHOT.jar & echo 'start success' 案例中给出的stop.sh脚本如下: #!/bin/bash echo "Stop Procedure : demo2-0.0.1-SNAPSHOT.jar" pid=`ps -ef | grep java | grep demo2-0.0.1-SNAPSHOT.jar | awk '{print $2}'` echo 'old Procedure pid:'$pid if [ -n "$pid" ] then kill -9 $pid fi Linux服务器配置 在Linux 服务上,上传上文中的两个脚本,用于启动和停止 GitHub服务器配置 在GitHub服务器上的指定项目里面配置上文中提到的回调地址 特别注意:为了保证回调地址网可以使用, 所以,下面配置的是外网映射地址。 可以参考:官方文档

优秀的个人博客,低调大师

🏆「作者推荐」Java技术专题-JVM研究系列(43) 字节码指令集调用执行流程分析(语法分析篇)

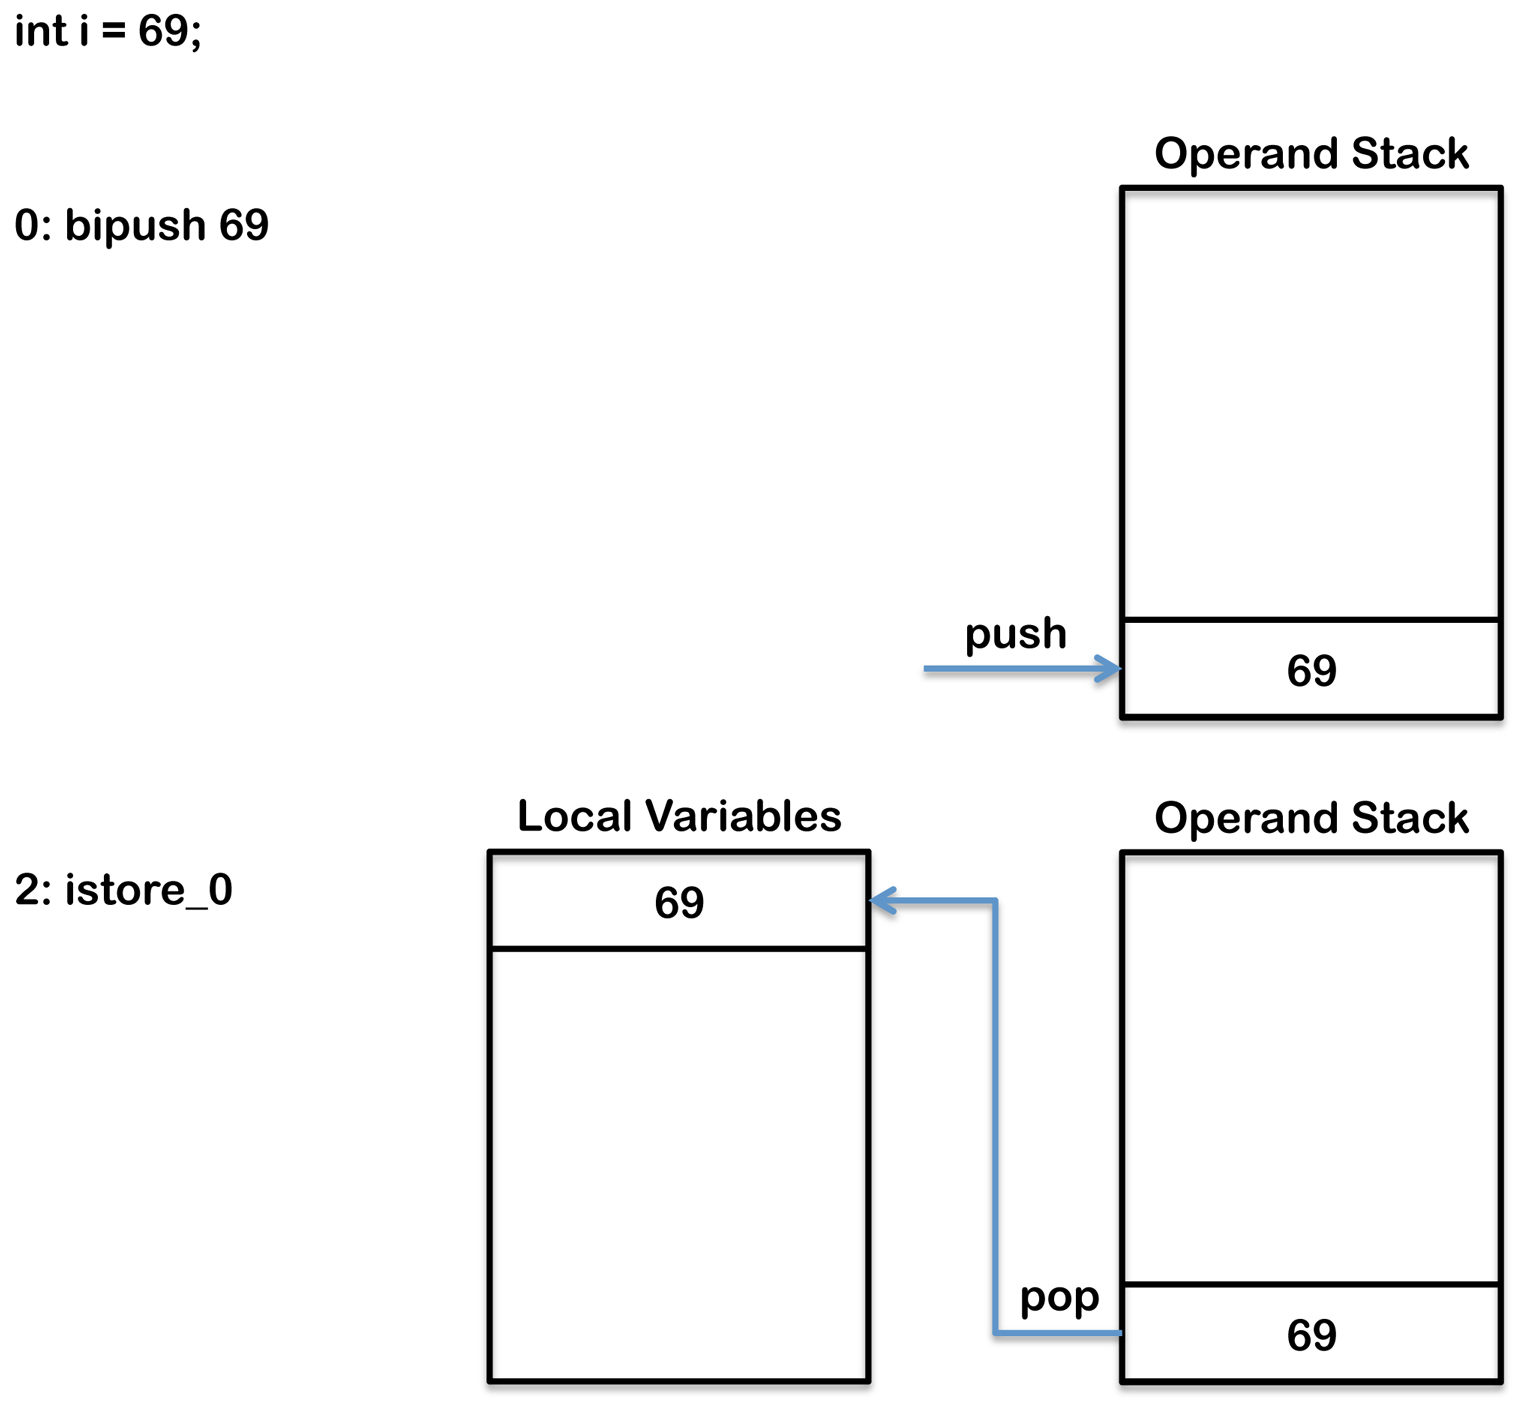
文章介绍 这篇文章讲解了在Java虚拟机上Java代码是如何编译成字节码并执行的。理解在Java虚拟机中Java代码如何别被编译成字节码并执行是非常重要的,因为这可以帮助你理解你的程序在运行时发生了什么。 这种理解不仅能确保你对语言特性有逻辑上的认识而且做具体的讨论时可以理解在语言特性上的妥协和副作用。 在字节码中每条指令(或操作码)前面的数字指示了这个字节的位置。 比如一条指令如1: iconst_1仅一个字节的长度,没有操作数,所以,接下来的字节码的位置为2。 再比如这样一条指令1: bipush 5将会占两个字节,操作码bipush占一个字节,操作数5占一个字节。 那么,接下来的字节码的位置为3,因为操作数占用的字节在位置2。 Java虚拟机是基于栈的架构。当一个方法包括初始化main方法执行,在栈上就会创建一个栈帧(frame),栈帧中存放着方法中的局部变量。 变量 局部变量 局部变量数组(local veriable array)包含在方法执行期间用到的所有变量包括一个引用变量this,所有的方法参数和在方法体内定义的变量。 类方法(比如:static方法)方法参数从0开始。 实例方法,第0个slot用来存放this,所以参数需要从1开始哦!。 局部变量类型 boolean byte char long short int float double reference returnAddress 除了long和double所有的类型在本地变量数组中占用一个slot,long和double需要两个连续的slot因为这两个类型为64位类型。 当在操作数栈上创建一个新的变量来存放一个这个新变量的值。这个新变量的值随后会被存放到局部变量数组对应的位置上。 如果这个变量不是一个基本类型,对应的slot上值存放指向这个变量的引用。这个引用指向存放在堆中的一个对象。 例如 int i = 5; 被编译为字节码为 0: bipush 5(占用两个字节) 2: istore_0 bipush 将一个字节作为一个整数推送到操作数栈。在这个例子中5被推送到操作数栈。 istore_0 它是一组格式为 istore_n 操作数的其中之一,它们都是将一个整数存储到局部变量表中。 n为在局部变量表中的位置,取值只能为0,1,2,3。另一个操作码用作值大于3的情况,为istore w,它将一个操作数放到本地变量数组中合适的位置,后面会详细进行介绍!。 上面的代码在内存中执行的情况如下: 这个类文件中对应每一个方法还包含一个局部变量表(local veribale table),如果这段代码被包含在一个方法中,在类文件对应于这个方法的本地变量表中你将会得到下面的实体(entry): LocalVariableTable: Start Length Slot Name Signature 0 1 1 i I 成员变量(类变量) 一个成员变量(field)被作为一个类实例(或对象)的一部分存储在堆上。关于这个成员变量的信息被定义到在类文件class字节码中field_info[] 数组中,如下: ClassFile { u4 magic; u2 minor_version; u2 major_version; u2 constant_pool_count; cp_info contant_pool[constant_pool_count – 1]; u2 access_flags; u2 this_class; u2 super_class; u2 interfaces_count; u2 interfaces[interfaces_count]; u2 fields_count; field_info fields[fields_count]; u2 methods_count; method_info methods[methods_count]; u2 attributes_count; attribute_info attributes[attributes_count]; } 另外,如果这个变量被初始化,进行初始化操作的字节码将被添加到实例构造器中。 当如下的代码被编译: public class SimpleClass{ public int simpleField = 100; } 一个额外的小结将会使用javap命令来演示将成员变量添加到field_info数组中。 public int simpleField; Signature: I flags: ACC_PUBLIC 进行初始化操作的字节码被添加到构造器中,如下: public SimpleClass(); Signature: ()V flags: ACC_PUBLIC Code: stack=2, locals=1, args_size=1 0: aload_0 1: invokespecial #1 // Method java/lang/Object."<init>":()V 4: aload_0 5: bipush 100 7: putfield #2 // Field simpleField:I 10: return aload_0 将本地变量数组slot中一个对象引用推送到操作数栈栈顶。 尽管,上面的代码中显示没有构造器对成员变量进行初始化,实际上,编译器会创建一个默认的构造器对成员变量进行初始化。 第一个局部变量实际上指向this。 aload_0操作码将this这个引用变量推送到操作数栈。 aload_0是一组格式为aload_的操作数中其中一员,它们的作用都是将一个对象引用推送到操作数栈。 其中n指的是被访问的本地变量数组中这个对象引用所在的位置,取值只能为0,1,2或3。 与之类似的操作码有iload_,lload_,fload_和dload_,不过这些操作码是用来加载值而不是一个对象引用,这里的i指的是int,l指的是long,f指的是float,d指的是double。 本地变量的索引大于3的可以使用iload,lload,fload,dload和aload来加载,这些操作码都需要一个单个的操作数指定要加载的本地变量的索引。 注意一点:用从1开始的局部变量Slot,参数表分配完毕后,再根据方法体内部定义的变量顺序和作用域分配其余的Slot(比如方法method(int a1,inta2),参数表为a1和a2,则局部变量表索引0、1、2则分别存储了this指针、a1、a2,如果方法内部有其他内部变量,则在局部变量表中存在a2之后的位置)。 invokespecial invokespecial指令用来调用实例方法,私有方法和当前类的父类的方法,构造方法等。 方式调用方法的操作码的一部分: invokedynamic(MethodHandle、Lamdba) invokeinterface(接口方法) invokespecial(构造器、父类方法、私有方法) invokestatic(静态方法) invokevirtual(实例方法) invokespecial指令在这段代码用来调用父类的构造器。 bipush 将一个字节作为一个整数推送到操作数栈。在这个例子中100被推送到操作数栈。 putfield 后面跟一个操作数 #2,这个操作数是运行时常量池(cp_info)中一个成员变量的引用,在这个例子中这个成员变量叫做simpleField。给这个成员变量赋值,然后包含这个成员变量的对象一起被弹出操作数栈。 前面的aload_0指令将包含这个成员变量的对象和前面的bipush指令将100分别推送到操作数栈顶。putfield随后将它们都从操作数栈顶移除(弹出)。最终结果就是在这个对象上的成员变量simpleFiled的值被更新为100。 上面的代码在内存中执行的情况如下: java_class_variable_creation_byte_code putfield操作码有一个单个的操作数指向在常量池中第二个位置。 JVM维护了一个常量池,一个类似于符号表的运行时数据结构,但是包含了更多的数据。 Java中的字节码需要数据,通常由于这种数据太大而不能直接存放在字节码中,而是放在常量池中,字节码中持有一个指向常量池中的引用。当一个类文件被创建时,其中就有一部分为常量池,如下所示: Constant pool: #1 = Methodref #4.#16 // java/lang/Object."<init>":()V #2 = Fieldref #3.#17 // SimpleClass.simpleField:I #3 = Class #13 // SimpleClass #4 = Class #19 // java/lang/Object #5 = Utf8 simpleField #6 = Utf8 I #7 = Utf8 <init> #8 = Utf8 ()V #9 = Utf8 Code #10 = Utf8 LineNumberTable #11 = Utf8 LocalVariableTable #12 = Utf8 this #13 = Utf8 SimpleClass #14 = Utf8 SourceFile #15 = Utf8 SimpleClass.java #16 = NameAndType #7:#8 // "<init>":()V #17 = NameAndType #5:#6 // simpleField:I #18 = Utf8 LSimpleClass; #19 = Utf8 java/lang/Object 常量(类常量) 被final修饰的变量我们称之为常量,在类文件中我们标识为ACC_FINAL。 例如: public class SimpleClass { public final int simpleField = 100; public int simpleField2 = 100; } 变量描述中多了一个ACC_FINAL参数: public static final int simpleField = 100; Signature: I flags: ACC_PUBLIC, ACC_FINAL ConstantValue: int 100 不过,构造器中的初始化操作并没有受影响: 4: aload_0 5: bipush 100 7: putfield #2 // Field simpleField2:I 静态变量 被static修饰的变量,我们称之为静态类变量,在类文件中被标识为ACC_STATIC,如下所示: public static int simpleField; Signature: I flags: ACC_PUBLIC, ACC_STATIC 在实例构造器中并没有发现用来对静态变量进行初始化的字节码。静态变量的初始化是在类构造器中,使用putstatic操作码而不是putfield字节码,是类构造器的一部分。 static {}; Signature: ()V flags: ACC_STATIC Code: stack=1, locals=0, args_size=0 0: bipush 100 2: putstatic #2 // Field simpleField:I 5: return 条件语句 条件流控制,比如,if-else语句和switch语句,在字节码层面都是通过使用一条指令来与其它的字节码比较两个值和分支。 for循环和while循环这两条循环语句也是使用类似的方式来实现的,不同的是它们通常还包含一条goto指令,来达到循环的目的。 do-while循环不需要任何goto指令因为他们的条件分支位于字节码的尾部。更多的关于循环的细节可以查看loops section。 一些操作码可以比较两个整数或者两个引用,然后在一个单条指令中执行一个分支。其它类型之间的比较如double,long或float需要分为两步来实现。 首先,进行比较后将1,0或-1推送到操作数栈顶。接下来,基于操作数栈上值是大于,小于还是等于0执行一个分支。 首先,我们拿if-else语句为例进行讲解,其他用来进行分支跳转的不同的类型的指令将会被包含在下面的讲解之中。 if-else 下面的代码展示了一条简单的用来比较两个整数大小的if-else语句。 public int greaterThen(int intOne, int intTwo) { if (intOne > intTwo) { return 0; } else { return 1; } } 这个方法编译成如下的字节码: 0: iload_1 1: iload_2 2: if_icmple 7 5: iconst_0 6: ireturn 7: iconst_1 8: ireturn 首先,使用iload_1和iload_2将两个参数推送到操作数栈。 然后,使用if_icmple比较操作数栈栈顶的两个值。 如果intOne小于或等于intTwo,这个操作数分支变成字节码7,跳转到字节码指令行7line。 注意,在Java代码中if条件中的测试与在字节码中是完全相反的,因为在字节码中如果if条件语句中的测试成功执行,则执行else语句块中的内容,而在Java代码,如果if条件语句中的测试成功执行,则执行if语句块中的内容。 换句话说,if_icmple指令是在测试如果if条件不为true,则跳过if代码块。if代码块的主体是序号为5和6的字节码,else代码块的主体是序号为7和8的字节码。 java_if_else_byte_code 下面的代码示例展示了一个稍微复杂点的例子,需要一个两步比较: public int greaterThen(float floatOne, float floatTwo) { int result; if (floatOne > floatTwo) { result = 1; } else { result = 2; } return result; } 这个方法产生如下的字节码: 0: fload_1 1: fload_2 2: fcmpl 3: ifle 11 6: iconst_1 7: istore_3 8: goto 13 11: iconst_2 12: istore_3 13: iload_3 14: ireturn 在这个例子中,首先使用fload_1和fload_2将两个参数推送到操作数栈栈顶。这个例子与上一个例子不同在于这个需要两步比较。fcmpl首先比较floatOne和floatTwo,然后将结果推送到操作数栈栈顶。如下所示: floatOne > floatTwo -> 1 floatOne = floatTwo -> 0 floatOne < floatTwo -> -1 floatOne or floatTwo= Nan -> 1 接下来,如果fcmpl的结果是<=0,ifle用来跳转到索引为11处的字节码。 这个例子和上一个例子的不同之处还在于这个方法的尾部只有一个单个的return语句,而在if语句块的尾部还有一条goto指令用来防止else语句块被执行。 goto分支对应于序号为13处的字节码iload_3,用来将局部变量表中第三个slot中存放的结果推送扫操作数栈顶,这样就可以由return语句来返回。 java_if_else_byte_code_extra_goto 和存在进行数值比较的操作码一样,也有进行引用相等性比较的操作码比如==,与null进行比较比如 == null和 != null,测试一个对象的类型比如 instanceof。 if_cmp eq ne lt le gt ge 这组操作码用于操作数栈栈顶的两个整数并跳转到一个新的字节码处。可取的值有: eq – 等于 ne – 不等于 lt – 小于 le – 小于或等于 gt – 大于 ge – 大于或等于 if_acmp eq ne 这两个操作码用于测试两个引用相等(eq)还是不相等(ne),然后跳转到由操作数指定的新一个新的字节码处。 ifnonnull/ifnull这两个字节码用于测试两个引用是否为null或者不为null,然后跳转到由操作数指定的新一个新的字节码处。 lcmp这个操作码用于比较在操作数栈栈顶的两个整数,然后将一个值推送到操作数栈,如下所示: 如果 value1 > value2 -> 推送1 如果 value1 = value2 -> 推送0 如果 value1 < value2 -> 推送-1 fcmp l g / dcmp l g 这组操作码用于比较两个float或者double值,然后将一个值推送的操作数栈,如下所示: 如果 value1 > value2 -> 推送1 如果 value1 = value2 -> 推动0 如果value1 < value2 -> 推送-1 以l或g类型操作数结尾的差别在于它们如何处理NaN。 fcmpg和dcmpg将int值1推送到操作数栈而fcmpl和dcmpl将-1推送到操作数栈。这就确保了在测试时如果两个值中有一个为NaN(Not A Number),测试就不会成功。 比如,如果x > y(这里x和y都为doube类型),x和y中如果有一个为NaN,fcmpl指令就会将-1推送到操作数栈。 接下来的操作码总会是一个ifle指令,如果这是栈顶的值小于0,就会发生分支跳转。结果,x和y中有一个为NaN,ifle就会跳过if语句块,防止if语句块中的代码被执行到。 instanceof 如果操作数栈栈顶的对象一个类的实例,这个操作码将一个int值1推送到操作数栈。这个操作码的操作数用来通过提供常量池中的一个索引来指定类。如果这个对象为null或者不是指定类的实例则int值0就会被推送到操作数栈。 if eq ne lt le gt ge所有的这些操作码都是用来将操作数栈栈顶的值与0进行比较,然后跳转到操作数指定位置的字节码处。 如果比较成功,这些指令总是被用于更复杂的,不能用一条指令完成的条件逻辑,例如,测试一个方法调用的结果。 switch 一个Java switch表达式允许的类型可以为char,byte,short,int,Character,Byte,Short.Integer,String或者一个enum类型。为了支持switch语句。 Java虚拟机使用两个特殊的指令:tableswitch和lookupswitch,它们背后都是通过整数值来实现的。仅使用整数值并不会出现什么问题,因为char,byte,short和enum类型都可以在内部被提升为int类型。 在Java7中添加对String的支持,背后也是通过整数来实现的。tableswitch通过速度更快,但是通常占用更多的内存。 tableswitch通过列举在最小和最大的case值之间所有可能的case值来工作。最小和最大值也会被提供,所以如果switch变量不在列举的case值的范围之内,JVM就会立即跳到default语句块。在Java代码没有提供的case语句的值也会被列出,不过指向default语句块,确保在最小值和最大值之间的所有值都会被列出来。 例如,执行下面的swicth语句: public int simpleSwitch(int intOne) { switch (intOne) { case 0: return 3; case 1: return 2; case 4: return 1; default: return -1; } 这段代码产生如下的字节码: 0: iload_1 1: tableswitch { default: 42 min: 0 max: 4 0: 36 1: 38 2: 42 3: 42 4: 40 } 36: iconst_3 37: ireturn 38: iconst_2 39: ireturn 40: iconst_1 41: ireturn 42: iconst_m1 43: ireturn tableswitch指令拥有值0,1和4去匹配Java代码中提供的case语句,每一个值指向它们对应的代码块的字节码。tableswitch指令还存在值2和3,它们并没有在Java代码中作为case语句提供,它们都指向default代码块。当这些指令被执行时,在操作数栈栈顶的值会被检查看是否在最大值和最小值之间。如果值不在最小值和最大值之间,代码执行就会跳到default分支,在上面的例子中它位于序号为42的字节码处。为了确保default分支的值可以被tableswitch指令发现,所以它总是位于第一个字节处(在任何需要的对齐补白之后)。如果值位于最小值和最大值之间,就用于索引tableswitch内部,寻找合适的字节码进行分支跳转。 例如,值为,则代码执行会跳转到序号为38处的字节码。 下图展示了这个字节码是如何执行的: java_switch_tableswitch_byte_code 如果在case语句中的值”离得太远“(比如太稀疏),这种方法就会不太可取,因为它会占用太多的内存。当switch中case比较稀疏时,可以使用lookupswitch来替代tableswitch。lookupswitch会为每一个case语句例举出分支对应的字节码,但是不会列举出所有可能的值。 当执行lookupswitch时,位于操作数栈栈顶的值会同lookupswitch中的每一个值进行比较,从而决定正确的分支地址。使用lookupswitch,JVM会查找在匹配列表中查找正确的匹配,这是一个耗时的操作。而使用tableswitch,JVM可以快速定位到正确的值。 当一个选择语句被编译时,编译器必须在内存和性能二者之间做出权衡,决定选择哪一种选择语句。下面的代码,编译器会使用lookupswitch: public int simpleSwitch(int intOne) { switch (intOne) { case 10: return 1; case 20: return 2; case 30: return 3; default: return -1; } } 这段代码产生的字节码,如下: 0: iload_1 1: lookupswitch { default: 42 count: 3 10: 36 20: 38 30: 40 } 36: iconst_1 37: ireturn 38: iconst_2 39: ireturn 40: iconst_3 41: ireturn 42: iconst_m1 43: ireturn 为了更高效的搜索算法(比线性搜索更高效),lookupswitch会提供匹配值个数并对匹配值进行排序。下图显示了上述代码是如何被执行的: java_switch_lookupswitch_byte_code String switch 在Java7中,switch语句增加了对字符串类型的支持。虽然现存的实现switch语句的操作码仅支持int类型且没有新的操作码加入。字符串类型的switch语句分为两个部分完成。首先,比较操作数栈栈顶和每个case语句对应的值之间的哈希值。这一步可以通过lookupswitch或者tableswitch来完成(取决于哈希值的稀疏度)。 这也会导致一个分支对应的字节码去调用String.equals()进行一次精确地匹配。一个tableswitch指令将利用String.equlas()的结果跳转到正确的case语句的代码处。 public int simpleSwitch(String stringOne) { switch (stringOne) { case "a": return 0; case "b": return 2; case "c": return 3; default: return 4; } } 这个字符串switch语句将会产生如下的字节码: 0: aload_1 1: astore_2 2: iconst_m1 3: istore_3 4: aload_2 5: invokevirtual #2 // Method java/lang/String.hashCode:()I 8: tableswitch { default: 75 min: 97 max: 99 97: 36 98: 50 99: 64 } 36: aload_2 37: ldc #3 // String a 39: invokevirtual #4 // Method java/lang/String.equals:(Ljava/lang/Object;)Z 42: ifeq 75 45: iconst_0 46: istore_3 47: goto 75 50: aload_2 51: ldc #5 // String b 53: invokevirtual #4 // Method java/lang/String.equals:(Ljava/lang/Object;)Z 56: ifeq 75 59: iconst_1 60: istore_3 61: goto 75 64: aload_2 65: ldc #6 // String c 67: invokevirtual #4 // Method java/lang/String.equals:(Ljava/lang/Object;)Z 70: ifeq 75 73: iconst_2 74: istore_3 75: iload_3 76: tableswitch { default: 110 min: 0 max: 2 0: 104 1: 106 2: 108 } 104: iconst_0 105: ireturn 106: iconst_2 107: ireturn 108: iconst_3 109: ireturn 110: iconst_4 111: ireturn 这个类包含这段字节码,同时也包含下面由这段字节码引用的常量池值。了解更多关于常量池的知识可以查看JVM内部原理这篇文章的 运行时常量池 部分。 Constant pool: #2 = Methodref #25.#26 // java/lang/String.hashCode:()I #3 = String #27 // a #4 = Methodref #25.#28 // java/lang/String.equals:(Ljava/lang/Object;)Z #5 = String #29 // b #6 = String #30 // c #25 = Class #33 // java/lang/String #26 = NameAndType #34:#35 // hashCode:()I #27 = Utf8 a #28 = NameAndType #36:#37 // equals:(Ljava/lang/Object;)Z #29 = Utf8 b #30 = Utf8 c #33 = Utf8 java/lang/String #34 = Utf8 hashCode #35 = Utf8 ()I #36 = Utf8 equals #37 = Utf8 (Ljava/lang/Object;)Z 注意,执行这个switch需要的字节码的数量包括两个tableswitch指令,几个invokevirtual指令去调用 String.equals()。了解更多关于invokevirtual的更多细节可以参看下篇文章方法调用的部分。下图显示了在输入“b”时代码是如何执行的: 如果不同case匹配到的哈希值相同,比如,字符串”FB”和”Ea”的哈希值都是28。这可以通过像下面这样轻微的调整equlas方法流来处理。注意,序号为34处的字节码:ifeg 42 去调用另一个String.equals() 来替换上一个不存在哈希冲突的例子中的 lookupsswitch操作码。 public int simpleSwitch(String stringOne) { switch (stringOne) { case "FB": return 0; case "Ea": return 2; default: return 4; } } 上面代码产生的字节码如下: 0: aload_1 1: astore_2 2: iconst_m1 3: istore_3 4: aload_2 5: invokevirtual #2 // Method java/lang/String.hashCode:()I 8: lookupswitch { default: 53 count: 1 2236: 28 } 28: aload_2 29: ldc #3 // String Ea 31: invokevirtual #4 // Method java/lang/String.equals:(Ljava/lang/Object;)Z 34: ifeq 42 37: iconst_1 38: istore_3 39: goto 53 42: aload_2 43: ldc #5 // String FB 45: invokevirtual #4 // Method java/lang/String.equals:(Ljava/lang/Object;)Z 48: ifeq 53 51: iconst_0 52: istore_3 53: iload_3 54: lookupswitch { default: 84 count: 2 0: 80 1: 82 } 80: iconst_0 81: ireturn 82: iconst_2 83: ireturn 84: iconst_4 85: ireturn 循环 条件流控制,比如,if-else语句和switch语句都是通过使用一条指令来比较两个值然后跳转到相应的字节码来实现的。了解更多关于条件语句的细节可以查看 conditionals section 。 循环包括for循环和while循环也是通过类似的方法来实现的除了它们通常一个goto指令来实现字节码的循环。do-while循环不需要任何goto指令,因为它们的条件分支位于字节码的末尾。 一些字节码可以比较两个整数或者两个引用,然后使用一个单个的指令执行一个分支。其他类型之间的比较如double,long或者float需要两步来完成。首先,执行比较,将1,0,或者-1 推送到操作数栈栈顶。接下来,基于操作数栈栈顶的值是大于0,小于0还是等于0执行一个分支。了解更多关于进行分支跳转的指令的细节可以 see above 。 while循环 while循环一个条件分支指令比如 if_fcmpge或 if_icmplt(如上所述)和一个goto语句。在循环过后就理解执行条件分支指令,如果条件不成立就终止循环。循环中最后一条指令是goto,用于跳转到循环代码的起始处,直到条件分支不成立,如下所示: public void whileLoop() { int i = 0; while (i < 2) { i++; } } 被编译成: 0: iconst_0 1: istore_1 2: iload_1 3: iconst_2 4: if_icmpge 13 7: iinc 1, 1 10: goto 2 13: return if_cmpge指令测试在位置1处的局部变量是否等于或者大于10,如果大于10,这个指令就跳到序号为14的字节码处完成循环。goto指令保证字节码循环直到if_icmpge条件在某个点成立,循环一旦结束,程序执行分支立即就会跳转到return指令处。iinc指令是为数不多的在操作数栈上不用加载(load)和存储(store)值可以直接更新一个局部变量的指令之一。在这个例子中,iinc将第一个局部变量的值加 1。 for循环 for循环和while循环在字节码层面使用了完全相同的模式。这并不令人惊讶因为所有的while循环都可以用一个相同的for循环来重写。上面那个简单的的while循环的例子可以用一个for循环来重写,并产生完全一样的字节码,如下所示: public void forLoop() { for(int i = 0; i < 2; i++) { } } do-while循环 do-while循环和for循环以及while循环也非常的相似,除了它们不需要将goto指令作为条件分支成为最后一条指令用于回退到循环起始处。 public void doWhileLoop() { int i = 0; do { i++; } while (i < 2); } 产生的字节码如下: 0: iconst_0 1: istore_1 2: iinc 1, 1 5: iload_1 6: iconst_2 7: if_icmplt 2 10: return

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册