智能仓储 WMS 前端系统 | 计算机视觉集成:摄像头视频流 + AI 识别结果叠加
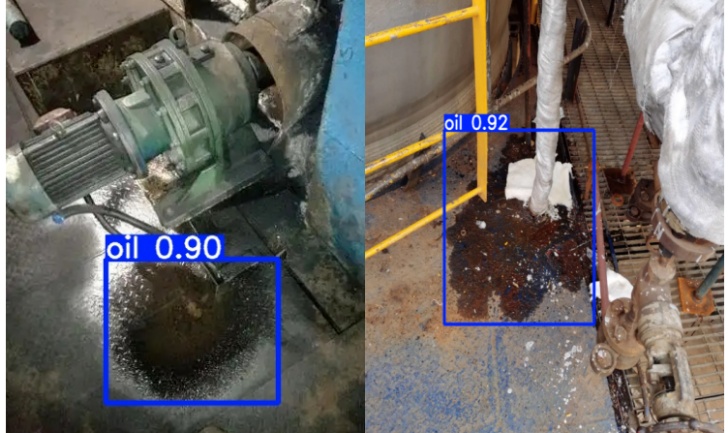
# 引言 仓库摄像头不是"看得见"就够用。当 AI 在另一端识别到破损、错贴面单、托盘塌垛、货位错放时,如果前端只弹一条文字告警,拣货员要做的第一件事是**把画面切回去找那条边**。真正的视觉集成,是把识别结果钉在它出现的那一帧、那一块像素上——框跟着物体走,标签跟着框走,告警跟着任务走。 这件事的技术难点全在同步:视频帧在编码器里排队、AI 推理在云端排队、网络有抖动、设备有丢帧。任何一个环节脱节,框就会画在错的位置上,比没有框更危险。本文落地一套能扛住这些现实的视频-AI 叠加方案:摄像头接入、带时间戳的推理结果流、坐标系变换、按 PTS 对齐的渲染循环,以及离线与降级策略。 --- # 一、接入层:四种视频源,四条不同的路 仓库现场的设备差异极大:USB 工业相机、H.265 网络摄像头、无头闸机的 RTSP 流、PDA 端的前后置摄像头。把它们统一成同一个 `MediaStream`,是这一层唯一的目标。 ```javascript // src/vision/stream.js export async function acquireVideoSource(kind, constraints = {}) { if (kind === 'usb') { const devices = await navigator.mediaDevices.enumerateDevices(); const cam = devices.find((d) => d.kind === 'videoinput' && d.deviceId); return await navigator.mediaDevices.getUserMedia({ video: { deviceId: { exact: cam.deviceId }, width: { ideal: 1920 }, height: { ideal: 1080 } }, audio: false, }); } if (kind === 'ip') { // 浏览器无法直接解析 RTSP/H.265,必须由边缘网关转成 WebRTC 或 MSE return await connectGateway(constraints.gatewayUrl); } if (kind === 'pda') { return await navigator.mediaDevices.getUserMedia({ video: { facingMode: { ideal: 'environment' } }, // 后置摄像头 audio: false, }); } } async function connectGateway(url) { const pc = new RTCPeerConnection({ iceServers: [{ urls: 'stun:stun.l.google.com:19302' }] }); const stream = new MediaStream(); pc.ontrack = (e) => e.streams[0].getTracks().forEach((t) => stream.addTrack(t)); const offer = await (await fetch(`${url}/offer`, { method: 'POST' })).json(); await pc.setRemoteDescription(offer); const answer = await pc.createAnswer(); await pc.setLocalDescription(answer); await fetch(`${url}/answer`, { method: 'POST', body: JSON.stringify(answer) }); return stream; } ``` 逐段解读: - `enumerateDevices()` 在**未授权前返回的设备名为空字符串**。所以初始化流程必须是"先请求权限,再枚举选设备",不能反着来。这是一个极其常见的坑,会导致明明有摄像头却拿到空列表。 - `audio: false` 必须显式写。移动端 Safari 上,含音频轨道的流在后台会被整条挂起,画面随之冻结;纯视频轨道则不会。 - `width: { ideal: 1920 }` 用 `ideal` 而非 `exact`。`exact` 在设备不支持时会直接抛 `OverconstrainedError`;`ideal` 让浏览器在能力范围内尽量给,拿不到时降级到 1280×720 而不报错。工业相机常见的 30fps 与 1080p,应在能力查询 `getSupportedConstraints()` 后按设备能力设定。 - RTSP/H.265 的处理是关键判断:**浏览器无法原生解析**。H.265 的专利授权问题使主流浏览器至今不支持硬解,RTSP 也不是 Web 标准。必须靠边缘网关(如带有 WebRTC 网关的 NVR)转码或转协议。MSE(Media Source Extensions)只能处理 fragmented MP4/WebM,也绕不开编码格式问题。因此网关选型在架构阶段就要定,不能留到联调。 --- # 二、推理通道:把"帧编号"变成"时间锚" AI 服务返回的不是一个框,而是一批带**时间戳**的框。时间戳是整套系统能正确叠加的唯一依据。 ```javascript // src/vision/inference.js export function createInferenceChannel({ wsUrl, video, codec = 'image/jpeg' }) { const ws = new WebSocket(wsUrl); const pending = new Map(); // 帧编号 → 时间戳,用于把结果对回原始帧 let seq = 0; ws.onopen = () => { video.requestVideoFrameCallback?.(function loop(now, meta) { const id = ++seq; pending.set(id, { expectedTime: now / 1000, pts: meta.mediaTime }); ws.send(JSON.stringify({ id, pts: meta.mediaTime })); // 实际抓帧通过 canvas.captureStream 或 ImageCapture,此处仅发触发信号 video.requestVideoFrameCallback(loop); }); }; ws.onmessage = (e) => { const msg = JSON.parse(e.data); // { id, boxes: [{x,y,w,h,label,confidence}], latency } const ctx = pending.get(msg.id); if (!ctx) return; // 过期结果直接丢弃 pending.delete(msg.id); dispatchResult({ ...msg, clientTime: ctx.expectedTime }); }; return { close() { ws.close(); pending.clear(); }, }; } ``` 逐段解读: - `requestVideoFrameCallback` 是这里的王牌 API。它与 `requestAnimationFrame` 不同:rAF 只告诉你"浏览器准备画下一帧",而 rVFC **在每一帧合成完成后立即回调,并给出该帧的 **`mediaTime`**(即 PTS)**。用它做时间戳锚点,框的偏移可以控制在亚帧级别。 - `pending` 是一个"发出即忘"的回执表。发出请求时登记编号与时间,结果回来时查表配对。**过期结果必须丢弃**——如果一个推理结果晚到了 3 秒,用它画框只会误导操作员。配对失败直接 return,不留兜底。 - `meta.expectedDisplayTime` 才是该帧**预计呈现时间**,`mediaTime` 是媒体时间戳。配对时两个值各有用途:用 `mediaTime` 对回原始帧,用 `expectedDisplayTime` 判断该不该画。 - `latency` 由服务端返回。它是判断通道是否健康的唯一客观指标:超过 800ms 就该告警"AI 通道拥塞",而不是默默让框漂移。  --- # 三、坐标系变换:从归一化到屏幕像素 AI 模型输出的坐标几乎总是**归一化值**(0~1 的相对比例),而画布需要的是像素。此外视频有横竖屏、镜像、裁剪,任一项不处理,框就会系统性偏移。 ```javascript // src/vision/overlay.js export function createOverlay(video, canvas, { mirror = false } = {}) { const ctx = canvas.getContext('2d'); function syncSize() { const dpr = Math.min(window.devicePixelRatio || 1, 2); canvas.width = video.videoWidth * dpr; canvas.height = video.videoHeight * dpr; canvas.style.width = `${video.clientWidth}px`; canvas.style.height = `${video.clientHeight}px`; ctx.setTransform(dpr, 0, 0, dpr, 0, 0); // 逻辑坐标 = CSS 像素 } function drawBoxes(boxes, now) { const vw = video.clientWidth; const vh = video.clientHeight; const sx = vw / video.videoWidth; // 视频像素 → 显示像素 const sy = vh / video.videoHeight; ctx.clearRect(0, 0, vw, vh); ctx.save(); if (mirror) { ctx.translate(vw, 0); ctx.scale(-1, 1); } for (const b of boxes) { const x = b.x * video.videoWidth * sx; const y = b.y * video.videoHeight * sy; const w = b.w * video.videoWidth * sx; const h = b.h * video.videoHeight * sy; const age = now - b.clientTime; const stale = age > 1500; // 超过 1.5 秒判定为过期 ctx.strokeStyle = stale ? '#94a3b8' : colorFor(b.label); ctx.lineWidth = 2; ctx.setLineDash(stale ? [6, 4] : []); ctx.strokeRect(x, y, w, h); // 标签背景 + 文字:左上角锚定,不随框位置抖动 const label = `${b.label} ${Math.round(b.confidence * 100)}%`; ctx.font = '12px system-ui'; const tw = ctx.measureText(label).width; ctx.fillStyle = ctx.strokeStyle; ctx.fillRect(x, y - 18, tw + 8, 18); ctx.fillStyle = '#fff'; ctx.fillText(label, x + 4, y - 5); } ctx.restore(); } return { syncSize, drawBoxes }; } function colorFor(label) { const map = { damage: '#ef4444', // 破损:红 wrong_label: '#f59e0b', // 面单异常:橙 collapse: '#dc2626', // 塌垛:深红 misplace: '#8b5cf6', // 错放:紫 }; return map[label] || '#3b82f6'; } ``` 逐段解读: - `syncSize` 是容器尺寸与视频尺寸不一致时的桥梁。摄像头常是 16:9,UI 容器可能是卡片比例,直接把 canvas 设成 `videoWidth` 会造成拉伸。**正确做法是 canvas 匹配视频真实分辨率、CSS 尺寸匹配容器**,再用 `sx/sy` 缩放系数做映射。 - `setTransform(dpr, ...)` 之后,所有绘图调用都用 CSS 像素书写,心智负担大幅降低。这是 Canvas 开发的统一规范,不是可选项。 - `mirror` 只做**坐标镜像**,不改变 `x/y` 语义。移动端自拍预览镜像但识别坐标不镜像,会导致框画在物体反方向——这是 PDA 视觉集成的头号 Bug。`scale(-1, 1)` + `translate(vw, 0)` 的组合是标准做法。 - **过期判定是安全机制**。1.5 秒没有新结果就把框变灰虚线,明确告诉操作员"这是旧数据"。没有这层处理,最危险的场景是:物体已移走,框还钉在原地。 - 标签放在框**左上角外部**而非内部。放在内部会被物体遮挡,放在右下角容易超出画布被裁。锚定外部是视觉叠加的通用约定。 --- # 四、渲染循环:按时间戳对齐,而不是按"最新"画 最简单也最错的写法:`onmessage` 里收到框就画。问题是一帧可能收到多个结果,下一帧可能一个都没收到,画布会闪烁且框会跳。 ```javascript // src/vision/renderLoop.js export function startOverlayLoop(overlay, video, resultQueue) { let raf = 0; function frame() { const now = performance.now(); const latest = resultQueue.consumeLatest(now); // 取 pts ≤ now 的最新结果 if (latest) { // 用 drawImage 直接绘制 ,零拷贝,避免再次 captureStream overlay.drawVideo(video); overlay.drawBoxes(latest.boxes, now); } else { overlay.drawVideo(video); // 无结果时也维持画面,避免黑屏闪烁 } raf = requestAnimationFrame(frame); } raf = requestAnimationFrame(frame); return () => cancelAnimationFrame(raf); } ``` ```javascript // src/vision/resultQueue.js export function createResultQueue({ maxAge = 2000 } = {}) { let buffer = []; return { push(result) { buffer.push(result); buffer.sort((a, b) => a.clientTime - b.clientTime); // 只保留窗口内的结果,防止内存膨胀 const cutoff = performance.now() - maxAge; buffer = buffer.filter((r) => r.clientTime >= cutoff); }, consumeLatest(now) { // 取 pts ≤ now 的最后一条:丢弃未来帧,避免"预测性"错位 let latest = null; for (const r of buffer) { if (r.clientTime ` 元素直接当 `CanvasImageSource` 绘制,是**零拷贝**操作,浏览器直接读取视频帧缓冲。不要用 `captureStream()` 再取一遍,那是给推流用的。 - `consumeLatest` 的关键词是**"≤ now"**。它主动丢弃未来的帧。这意味着:如果某条推理结果的时间戳晚于当前渲染时刻(比如时钟偏差、乱序到达),就不画——宁可暂时空框,也不画预测性的错位。 - 无结果时仍画视频帧。否则缓冲区空一瞬间画布就清空成黑屏,视觉上是严重闪烁。 - `maxAge` 窗口淘汰。一个忘记清理的结果队列会持续增长,长时间运行后排序和过滤的 O(n log n) 会变成可感知的卡顿。 --- # 五、性能:两个独立层级,各有各的预算 视频叠加的帧预算是 16.6ms(60fps)。这 16.6ms 里,`drawImage` 占大头,绘制几十个框通常不到 1ms,文本是相对昂贵的操作。  --- 图表是经验量级:1080p 的 `drawImage` 是绝对主力,文本填充次之。**优化顺序应该反着来**——先砍最贵的是 `drawImage` 本身:DPR 封顶到 2、检测区域不要求全屏高分辨率时降采样视频源。文本无法避免,但可以合并:同 SKU 的多个框合并成一个标签。 三条通用规则: - `willReadFrequently`** 不要开**。我们的场景只写不读,开了反而触发 CPU 回读路径,性能下降明显。只有做像素级分析(比如局部截图送 OCR)才需要它。 - **离屏缓冲复用**。标签背景、置信度文字如果需要频繁重绘,预渲染到离屏 Canvas 再 `drawImage` 上去,比反复 `fillRect + fillText` 更快。 - **分层画布**。视频层一块、框层一块、UI 控件层一块。框只在有新结果时重绘,视频层单独循环,减少无效重绘。这是瓦片式地图的同源思路。 --- # 六、告警与交互:识别结果要能触发动作 框画出来只是第一步。真正的价值是**把视觉发现接进 WMS 作业流**:破损要拦截出库,错放要触发移库,面单异常要挂起该单复核。 ```javascript // src/vision/alerts.js const SEVERITY = { damage: 'critical', // 破损:阻断当前出库任务 collapse: 'critical', // 塌垛:要求立即处理 wrong_label: 'warning', // 面单异常:挂起订单 misplace: 'warning', // 错放:触发移库建议 }; export function handleDetections(detections, { onCritical, onWarning } { const byLevel = detections.reduce((acc, d) => { acc[SEVERITY[d.label] || 'info'].push(d); return acc; }, { critical: [], warning: [], info: [] }); if (byLevel.critical.length) { onCritical(byLevel.critical); // 视觉层:屏幕边缘红色脉冲 + 蜂鸣(Web Audio 短促提示音) flashEdge('critical'); } if (byLevel.warning.length) onWarning(byLevel.warning); return byLevel; } let flashTimer = null; function flashEdge(level) { document.body.dataset.visionAlert = level; clearTimeout(flashTimer); flashTimer = setTimeout(() => { delete document.body.dataset.visionAlert; }, 1200); } ``` 逐段解读: - 严重级别在前端**再判定一次**。服务端返回的是标签,最终该阻断还是仅告警,由前端按业务规则落定,方便不发包快速调整。但关键规则(如是否阻断出库)应在服务端二次校验,防止被绕过。 - `flashEdge` 用 `data-*` 属性驱动 CSS 动画。屏幕边缘红色脉冲是最不打断作业的告警方式——拣货员视线本就在画面上,边缘闪烁不会遮挡内容。 - 告警**必须可确认、可撤销**。操作员确认"这是误报"后,该 SKU + 该标签类型应进入本班次的抑制名单,避免同一处反复告警导致"告警疲劳"而错过真正的异常。 --- # 七、降级策略:离线、丢帧、弱网都不能崩 仓库现场的网络是不可靠的。降级不是"失败了就报错",而是**在能力边界内继续工作**。 ```javascript // src/vision/fallback.js export function pickStrategy({ rtcSupported, wsLatency, online }) { if (!online) { return { mode: 'offline', draw: (canvas, video) => drawFrozenFrame(canvas, video), // 缓存最后一帧 + 提示 hint: '网络离线,AI 识别已暂停,可继续本地复核', }; } if (!rtcSupported) { return { mode: 'mse', src: '/api/vision/stream.m3u8', // 走 HLS 降级流 hint: '当前使用兼容流,画质已降低', }; } if (wsLatency > 800) { return { mode: 'degraded', interval: 2000, // 降为 2 秒抓帧一次 hint: 'AI 通道拥塞,识别频率已降低', }; } return { mode: 'realtime', interval: 200 }; } ``` 四条降级路径: |场景|策略|代价|用户体验| | --- | --- | --- | --- | |完全离线|缓存最后一帧 + 本地提示|无实时识别|可继续人工复核| |WebRTC 不支持|切 HLS/MSE 兼容流|延迟升高 2–5 秒|画面可用,框略有滞后| |推理通道拥塞|降低抓帧频率 5–10 倍|实时性下降|仍有关键帧检测| |单帧超时|标记过期变灰虚线|无|明确区分新旧数据| 权限边界也要写清楚:摄像头属于敏感权限,首次授权需由明确的用户手势触发(按钮点击),`getUserMedia` 不能在页面加载时自动调用。PDA 端要处理前后摄像头切换和锁屏后流释放;工业相机场景则要提示用户检查 HTTPS——`getUserMedia` 在非安全上下文里会静默失败。 --- # 结语 本文交付了一套能在实际仓库里跑起来的视频-AI 叠加方案。四条核心结论: **第一,先解决协议,再解决画面。** 浏览器无法解析 RTSP 与 H.265,摄像头接入必须依赖边缘网关转 WebRTC 或 MSE。网关选型是架构决策,不是联调细节;`enumerateDevices` 必须在授权后调用,否则拿到空列表。 **第二,时间戳是唯一的对齐依据。**`requestVideoFrameCallback` 给出的 `mediaTime` 和 `expectedDisplayTime` 让结果能对回原始帧。结果队列按 `pts ≤ now` 消费、主动丢弃未来帧,宁可空框也不画错位——这是安全底线。 **第三,坐标系变换是精度的全部。** 视频像素与显示像素之间的 `sx/sy`、镜像处理、DPR 归一化,三处任一缺失都会让框系统性偏移。过期判定(1.5 秒变灰虚线)则让"旧数据"与"实时数据"在视觉上不可混淆。 **第四,降级决定可用性。** 离线缓存末帧、WebRTC 不支持切 HLS、通道拥塞降抓帧频率、单帧超时标灰——四条路径让系统在网络不可靠的仓库里仍能工作。告警要可确认可撤销,否则告警疲劳会让真正的异常被淹没。 这套方案的价值不在"框得准",而在于**框得可信**——操作员看到框的瞬间知道它是新的还是旧的、该信还是该确认。可信,才是视觉 AI 能进入生产作业流的前提。