首页 文章 精选 留言 我的

精选列表

搜索[SEO优化],共10000篇文章
优秀的个人博客,低调大师

基于Redis的原子操作优化秒杀逻辑

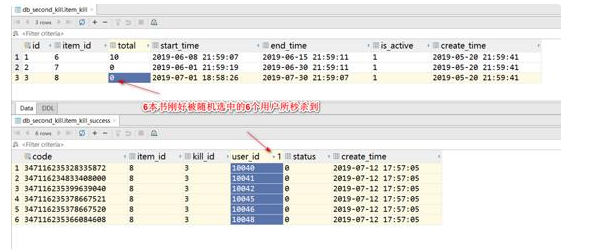
内容: 对于缓存中间件Redis,相信各位小伙伴或多或少都有听说过,甚至实战过,本文我们将基于SpringBoot整合Redis中间件,并基于其优秀的“单线程”特性和原子操作实现一种“分布式锁”,进而控制“高并发情况下多线程对于共享资源的访问”,最终解决“并发安全”,即“库存超卖”或者“重复秒杀”的问题! (1)按照惯例,首先我们需要加入Redis的第三方依赖,如下所示: org.springframework.bootspring-boot-starter-redis1.3.5.RELEASE复制代码然后,需要在application.properties配置文件中加入Redis服务所在的Host、端口Post、链接密钥Password等信息,如下所示: (2)紧接着,我们还需要自定义注入跟Redis的操作组件相关的Bean配置,在这里主要是自定义注入配置RedisTemplate跟StringRedisTemplate操作组件,并指定其对应的Key、Value的序列化策略: // redis的通用化配置@Configurationpublic class RedisConfig { @Autowired private RedisConnectionFactory redisConnectionFactory; @Bean public RedisTemplate redisTemplate(){ RedisTemplate redisTemplate=new RedisTemplate<>(); redisTemplate.setConnectionFactory(redisConnectionFactory); //TODO:指定Key、Value的序列化策略 redisTemplate.setKeySerializer(new StringRedisSerializer()); redisTemplate.setValueSerializer(new JdkSerializationRedisSerializer()); redisTemplate.setHashKeySerializer(new StringRedisSerializer()); return redisTemplate; } @Bean public StringRedisTemplate stringRedisTemplate(){ StringRedisTemplate stringRedisTemplate=new StringRedisTemplate(); stringRedisTemplate.setConnectionFactory(redisConnectionFactory); return stringRedisTemplate; }}复制代码(3)至此,可以说是做好了充足的准备,接下来我们就可以拿来用了!为了区分之前的秒杀逻辑方法,我们开了一个新的秒杀逻辑方法killItemV3,并采用Redis的原子操作SETNX和EXPIRE方法来实现一种“分布式锁”,进而控制高并发多线程对共享资源的访问,其完整源代码如下所示: //商品秒杀核心业务逻辑的处理-redis的分布式锁@Overridepublic Boolean killItemV3(Integer killId, Integer userId) throws Exception { Boolean result=false; if (itemKillSuccessMapper.countByKillUserId(killId,userId) <= 0){ //TODO:借助Redis的原子操作实现分布式锁-对共享操作-资源进行控制 ValueOperations valueOperations=stringRedisTemplate.opsForValue(); final String key=new StringBuffer().append(killId).append(userId).append("-RedisLock").toString(); final String value=RandomUtil.generateOrderCode(); Boolean cacheRes=valueOperations.setIfAbsent(key,value); if (cacheRes){ stringRedisTemplate.expire(key,30, TimeUnit.SECONDS); try { ItemKill itemKill=itemKillMapper.selectByIdV2(killId); if (itemKill!=null && 1==itemKill.getCanKill() && itemKill.getTotal()>0){ int res=itemKillMapper.updateKillItemV2(killId); if (res>0){ commonRecordKillSuccessInfo(itemKill,userId); result=true; } } }catch (Exception e){ throw new Exception("还没到抢购日期、已过了抢购时间或已被抢购完毕!"); }finally { if (value.equals(valueOperations.get(key).toString())){ stringRedisTemplate.delete(key); } } } }else{ throw new Exception("Redis-您已经抢购过该商品了!"); } return result;}复制代码在上述代码中,我们主要是通过以下几个操作综合实现了“分布式锁”的功能,其中包括 (1)valueOperations.setIfAbsent(key,value);:表示当前的Key如果不存在于缓存中,那么将设置值成功,反之,如果Key已经存在于缓存中了,那么设置值将不成功!通过这一特性,我们可以将“KillId和UserId的一一对应关系~即一个人只能抢到一个商品”组合在一起作为Key! (2)设置了Key,那么就需要在某个时间点去释放,即stringRedisTemplate.expire(key,30, TimeUnit.SECONDS);操作可以辅助实现! (3)然鹅,真正“释放锁”的操作是如下这段代码去实现的,即判断一下当前要释放的锁是否就是之前一开始获取到的锁,如果是,就释放!这一点可以很好的避免误删锁的问题! if (value.equals(valueOperations.get(key).toString())){ stringRedisTemplate.delete(key);}复制代码至此,基于Redis的原子操作实现的分布式锁,进而控制高并发多线程对于共享资源的访问,从而解决秒杀场景下“库存超卖”、“重复秒杀”等问题,下面采用JMeter进行压测,压测的用户列表跟商品的“可秒杀数量total”跟上一篇章是一样的,即total=6本书,用户总共是10个。 点击JMeter的启动按钮,观察控制台的输出信息以及数据库表item_kill和item_kill_success表,可以看到秒杀记录的结果很是令人满意: 即库存为6本的商品~书籍恰好被10个用户中的6个秒杀得到!这种结果其实对于我们、对于用户来讲肯定是皆大欢喜的结局! 虽然演员对于自己的结局很满意,但是导演却察觉到戏中仍然有一些瑕疵!即如果秒杀系统在执行Redis的原子操作SetNX后、执行Expire之前,Redis的节点宕机了,那么此时将很有可能永久进入“Key锁死”的窘境,即重启之后,由于之前的Key没有得到释放,故而这个Key将永远存在于缓存中,即对应的用户将不能秒杀该商品了! 这一点确实是一个隐患! 既然存在隐患,那么我们就得想办法解决了!莫急,下一篇章我们继续! 需要java学习路线图的私信笔者“java”领取哦!另外喜欢这篇文章的可以给笔者点个赞,关注一下,每天都会分享Java相关文章!还有不定时的福利赠送,包括整理的学习资料,面试题,源码等~~


优秀的个人博客,低调大师

HBase优化之路-合理的使用编码压缩

为什么要讨论HBase编码压缩 编码+压缩能够成倍的减少数据的磁盘占用空间,节省可观的存储费用 编码+压缩通常情况下可以提高系统吞吐率,让系统可以做更多的功 默认建表不启用编码或者压缩,对初学者不友好 了解HBase编码 举个栗子,我们有一张物流表叫"express",记录物流订单的流转详情。如下面表格:rowkey包含两个部分,用#号分割,左边是物流订单号,右边是物流信息的更新时间点。表包含两个列,一个物流状态,一个是物流描述信息 rowkey 状态列 描述信息列 10324224#2019-04-21 10:51 已发货 包裹正在等待揽收 10324224#2019-04-21 19:46 已揽件 [嘉兴市]平湖南桥的xxx已揽收 10324224#2019-04-21 19:46 运输中 [嘉兴市]快件已从平湖南桥出发,准备发往嘉兴中转部 10324224#2

优秀的个人博客,低调大师

内存优化篇-String/char[]/byte[]的选择

Java基本数据类型的大小 type size(bits) bytes boolean 8 1 byte 8 1 char 16 2 short 16 2 int 32 4 long 64 8 float 32 4 double 64 8 Java引用的大小 在 32 位的 JVM 上,一个对象引用占用 4 个字节;在 64 位JVM上,占用 8 个字节。 使用 8 个字节是为了能够管理大于 4G 的内存,如果你的程序不需要访问大于 4G 的内存, 可通过-XX:+UseCompressedOops选项,开启指针压缩。从Java 1.6.0_23开始,这个选项默认是开的。 Java对象头的大小 在32位JVM中,对象头的大小为8个字节(4字节的Mark Word+4字节的Klass Pointer). 在64位JVM上,占用16个字节(8字节的Mark Word+8字节的Klass Pointer),因为开启UseCompressedOops,所以实际占用12个字节(8字节的Mark Word+4字节的Klass Pointer) 。参考klass pointer 接下来的内容都基于64位的JVM来展开 Java对象的大小 1、任意Java对象都包含至少12个字节的Object Header。 2、JVM分配内存以8字节为基本单位,如果不满小于8字节,则向8字节的倍数补齐。参考8 byte alignment 思考 Object object = new Object(); 占用多少内存? 数组的大小如何计算? 验证 添加Maven依赖 <dependency> <groupId>org.openjdk.jol</groupId> <artifactId>jol-core</artifactId> <version>0.9</version> </dependency> import org.openjdk.jol.info.ClassLayout; /** * Created by jianpingpan on 2019/1/17. */ public class BasicClass { public static void main(String[] args) throws Exception { System.out.println(ClassLayout.parseClass(Object.class).toPrintable()); System.out.println(ClassLayout.parseClass(String.class).toPrintable()); System.out.println(ClassLayout.parseClass(byte[].class).toPrintable()); System.out.println(ClassLayout.parseClass(char[].class).toPrintable()); } } byte[] 和char[]的 object header为16个字节是因为有4个字节的数组长度。 String / char[] /byte[] 内存大小计算 String a = new String("abc"); String b = new String("abcd"); String c = new String("abc"); 第一行占用JVM内存的大小: 对象大小 = 12字节(object header)+ 4字节 (hash)+ 4字节(数组引用vlaue[]) + 4字节 (padding) 16字节+3*2字节+2字节padding (数组value[]) = 48字节 假设要缓存的字符个数为N。 String的内存大小计算公式 = 40+N*2 +padding char数组的内存大小计算公式=16+N*2+padding 如果用byte数组来存储字符串数据,占用的内存大小X需要分2种情况讨论: 1、如果需要存储的字符全在ASCII码中,一个字符用一个byte就可以存储 (编码方式可选ISO-8859-1/GBK/UTF-8): X = 16+N+padding 2、如果需要存储的字符范围不能被ASCII码覆盖,则需要根据字符范围确定合适的存储方式。 如需要要存储字符集为ASCII+中文字符,则可使用GBK编码: 16+N+padding<X < 16+N*2+padding 如果字符集不能被ASCII码覆盖,并且包含非中文字符,则使用UTF-8编码: 16+N+padding<X<16+6*N+padding 结论: 由此可见,char数组占用的内存大小小于String占用的内存大小。 若存储的字符范围以ASCII码为主,使用byte数组存储优于char数组。 实际使用场景 那么在缓存中可以直接用char[]或byte[]替换String么? 把 Set<String> set = new HashSet<>(); 替换成 Set<byte[]> set = new HashSet<>(); 会怎样呢? 很明显,contains方法、get方法都会失效。因为每个byte[]的hashCode不一样。 我们用下面的这个ByteArray/CharArray封装byte[],再用ByteArray替换String。 /** * Created by jianpingpan on 2019/1/23. */ public class ByteArray { byte[] bytes; public ByteArray(byte[] bytes){ this.bytes = bytes; } @Override public int hashCode() { if(null == bytes){ return 0; } return new String(bytes).hashCode(); } @Override public boolean equals(Object obj) { if(obj == null){ return false; } return hashCode()==obj.hashCode(); } } (CharArray的实现方式同ByteArray,只是把byte[] bytes 替换成 char[] chars即可) ByteArray占用的内存大小= 12字节(object header+ 4字节(数组引用bytes[]) + 16字节+N字节+padding (数组bytes[]) = 32字节+N字节+padding CharArray占用的内存大小= 12字节(object header+ 4字节(数组引用bytes[]) + 16字节+2*N字节+padding (数组bytes[]) = 32字节+2*N字节+padding 其中,N为数组中元素的个数。 例子 以存储100万条长度为32位的MD5字符串为例且内容互不相同字符串为例(假设字符串中的字符均为字母、数字、下划线)。 可以用classmexer来计算内存使用量 。 import com.javamex.classmexer.MemoryUtil; /** * Created by jianpingpan on 2019/1/25. */ public class StringTest { public static void main(String[] args){ String s="cfcd208495d565ef66e7dff9f98764da"; ByteArray b = new ByteArray(s.getBytes()); CharArray c = new CharArray(s.toCharArray()); long stringBytes = MemoryUtil.deepMemoryUsageOf(s); long byteArrayBytes = MemoryUtil.deepMemoryUsageOf(b); long charArrayBytes = MemoryUtil.deepMemoryUsageOf(c); System.out.println("stringBytes:"+stringBytes); System.out.println("byteArrayBytes:"+byteArrayBytes); System.out.println("charArrayBytes:"+charArrayBytes); } } 用String存储,每条记录占用的空间为 40+32*2 = 104字节 用ByteArray存储,每条记录占用的空间为 32+32 = 64字节 用CharArray存储,每条记录占用的空间为 32+32*2 = 96字节 参考文档: http://btoddb-java-sizing.blogspot.com/2012/01/object-sizes.html https://stackoverflow.com/questions/26357186/what-is-in-java-object-header/26416983 http://openjdk.java.net/groups/hotspot/docs/HotSpotGlossary.html

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册