首页 文章 精选 留言 我的

精选列表

搜索[小程序开发],共10000篇文章
优秀的个人博客,低调大师

Python爬虫-小测验

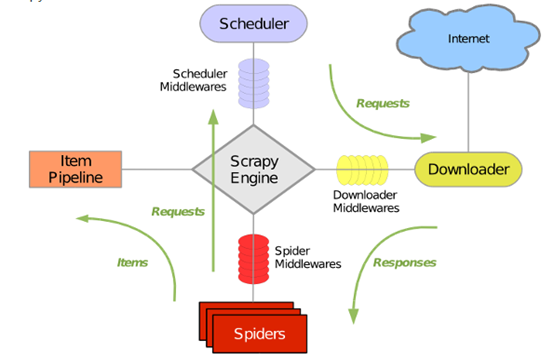
一、 使用scrapy.Selector或BeautifulSoup,实现以下需求(30分) (1)读取给定的dangdang.html页面内容,注:编码为gbk(5分) (2)获取页面中所有图书的名称,价格,作者,出版社及图书图片的url地址(20分) (3)将获取的信息保存至文件(excel、csv、json、txt格式均可)(5分) 网页文件dangdang.html文件下载链接: https://pan.baidu.com/s/1awbG5zqOMdnWzXee7TZm6A 密码: 3urs 1.1使用BeautifulSoup解决 from bs4 import BeautifulSoup as bs import pandas as pd def cssFind(book,cssSelector,nth=1): if len(book.select(cssSelector)) >= nth: return book.select(cssSelector)[nth-1].text.strip() else: return '' if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: html = file.read() soup = bs(html,'lxml') book_list = soup.select("div ul.bigimg li") result_list = [] for book in book_list: item = {} item['name'] = book.select("a.pic")[0]['title'] item['now_price'] = cssFind(book,"span.search_now_price") item['pre_price'] = cssFind(book,"span.search_pre_price") item['author'] = book.select("p.search_book_author a")[0]['title'] item['publisher'] = book.select("p.search_book_author span a")[-1].text item['detailUrl'] = book.select("p.name a")[0]['href'] item['imageUrl'] = book.select("a.pic img")[0]['src'] if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.select("a.pic img")[0]['data-original'] result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 1.2使用scrapy.selector解决 from scrapy.selector import Selector import pandas as pd if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: response = Selector(text=file.read()) book_list = response.xpath("//ul[@class='bigimg']/li") result_list = [] for book in book_list: item = {} item['name'] = book.xpath("a[@class='pic']/@title").extract_first() item['now_price'] = book.xpath(".//span[@class='search_now_price']/text()").extract_first() item['pre_price'] = book.xpath(".//span[@class='search_pre_price']/text()").extract_first() item['author'] = book.xpath("p[@class='search_book_author']//a/@title").extract_first() item['publisher'] = book.xpath("p[@class='search_book_author']//a/@title").extract()[-1] item['detailUrl'] = book.xpath(".//p[@class='name']/a/@href").extract_first() item['imageUrl'] = book.xpath("a[@class='pic']/img/@src").extract_first() if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.xpath("a[@class='pic']/img/@data-original").extract_first() result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 二、 需求:抓取天猫三只松鼠旗舰店超级满减商品信息(55分) 网站地址如下https://sanzhisongshu.tmall.com/p/rd523844.htm?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop 评分标准如下: 1、创建函数获取页面所有内容,代码无误(5分) 2、得到页面内容后解析信息,获取页面中图片链接,并将图片下载至本地photo文件夹。(10分) 3、获取页面中每个商品信息的商品名称、价格以及商品图片url信息(20分) 4、创建数据库product,及表格productinfo,包含(商品名称、价格及图片地址三个字段)(5分) 5、将第(3)步获取的结果写入数据库(10分) 6、代码规范,有注释(5分) import requests from bs4 import BeautifulSoup as bs import urllib import os import pymysql #获取实例化BeautifulSoup对象 def getSoup(url, encoding="gbk", **params): reponse = requests.get(url, **params) reponse.encoding = encoding soup = bs(reponse.text, 'lxml') return soup #下载单个图片函数 def downloadImage(imgUrl, imgName): imgDir = "photo" if not os.path.isdir(imgDir): os.mkdir(imgDir) imgPath = "%s/%s" %(imgDir,imgName) urllib.request.urlretrieve(imgUrl,imgPath) #下载所有图片函数 def downloadAllImages(soup): image_list = soup.select("img") count = 0 for image in image_list: try: srcStr = image['data-ks-lazyload'] imgFormat = srcStr[-3:] if imgFormat == 'gif': continue count += 1 imgName = "%d.%s" % (count, imgFormat) imgUrl = "http:" + srcStr downloadImage(imgUrl, imgName) except Exception as e: print(str(e)) #通过css选择器语法选择出标签 def cssFind(movie,cssSelector,nth=1): if len(movie.select(cssSelector)) >= nth: return movie.select(cssSelector)[nth-1].text.strip() else: return '' #获取数据库连接函数 def getConn(database ="product"): args = dict( host = 'localhost', user = 'root', passwd = '.... your password', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": soup = getSoup("https://sanzhisongshu.tmall.com/p/rd523844.htm" \ "?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop") #下载所有图片 downloadAllImages(soup) #获取数据库连接 conn = getConn() cursor = conn.cursor() #新建数据库中的表productinfo sql_list = [] sql_list.append("drop table if exists productinfo") sql_list.append("create table productinfo(name varchar(200)," \ "price varchar(20),imageUrl varchar(500))") for sql in sql_list: cursor.execute(sql) conn.commit() #获取商品信息并插入数据库 item_list = soup.select("div.item4line1 dl.item") for item in item_list: name = cssFind(item,"dd.detail a") price = cssFind(item,"dd.detail span.c-price") imageUrl = item.select("dt img")[0]['data-ks-lazyload'] insert_sql = 'insert into productinfo values("%s","%s","%s")' %(name,price,imageUrl) cursor.execute(insert_sql) conn.commit() 三、请以你的理解尽可能准确的描述出scrapy运行的原理图(15分) scrapy框架原理图.png 在实际编写代码的过程一种,一般按照下列顺序编写代码文件: 1.编写item.py文件;2.编写爬虫文件;3.编写pipelines.py文件;4.编写settings.py文件 在Scrapy框架理解上: 1.爬虫Spiders发送请求Requests给调度器Scheduler 2.调度器Scheduler发送下载网页的请求Requests给下载器Downloader 3.下载器Downloader获取网页相应response交给爬虫Spiders 4.爬虫Spiders对response进行解析形成Item 5.Item传送给管道,管道对数据进行相应处理,数据持久化。 6.Middelwares分为三种:调度中间件Scheduler middlewares、爬虫中间件spider Middlewares、下载中间件Download Middlewares。在编写scrapy-redis分布式爬虫时,redis就相当于调度中间件Scheduler middlewares;对爬虫进行伪装,设置用户代理User-agent和代理Ip,是在爬虫中间件spider Middlewares中进行设置,下载中间件Download Middlewares可以对下载进行相应设置。

优秀的个人博客,低调大师

C++小例子

#include <iostream> #include <conio.h> int main(){ std::cout<<"Enter two numbers:"<<std::endl; int v1,v2; std::cin>>v1>>v2; int lower,upper; if(v1<=v2){ lower = v1; upper = v2; }else{ lower = v2; upper = v1; } int sum = 0; for(int val = lower;val<=upper;++val){ sum +=val; } std::cout<<"Sum of "<<lower<<"to"<<upper <<" is " <<sum<<std::endl; getch(); return 0; } 输入两个数 计算出,他们之间的和 例如输入1、3 计算1+2+3 本文转自TBHacker博客园博客,原文链接:http://www.cnblogs.com/jiqing9006/p/3723660.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android系统小知识

1.添加振动 http://blog.csdn.net/caesardadi/article/details/8251933 2.excel操作 jxl.jar jxcell.jar Appache的poi库 3.保证屏幕黑屏之后CPU继续运作 http://blog.csdn.net/jhope/article/details/53737402 4.文件新建之后,在电脑上看不见。 http://blog.csdn.net/lmw21848/article/details/52297346 5.java文件加解密 http://zhangzhaoaaa.iteye.com/blog/2124700 6.AlarmManager定点提醒 http://blog.csdn.net/fxdaniel/article/details/41150129 几个设置参数的意义 http://blog.csdn.net/wangjia55/article/details/21518931 7. 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/2048586,如需转载请自行联系原作者

优秀的个人博客,低调大师

陪玩小程序订单链路的工程实现:派单状态机、结算分账与资金合规设计

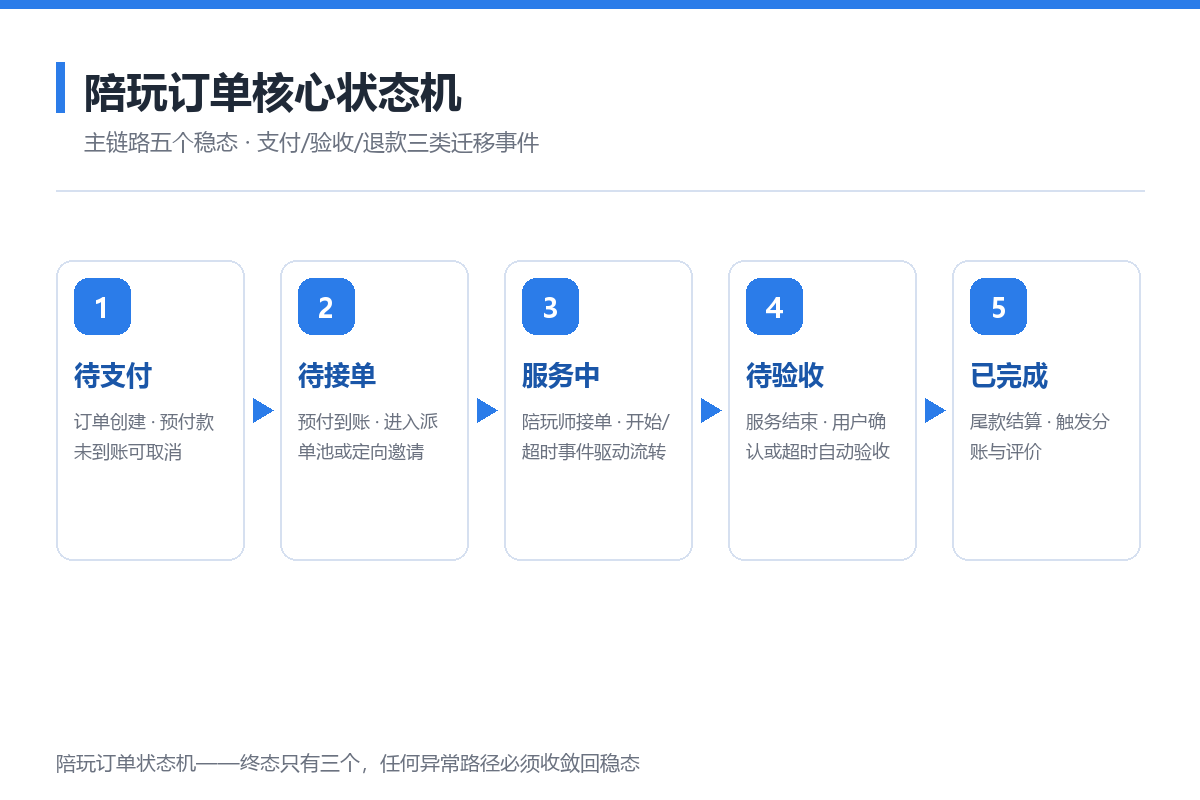
陪玩平台在工程上真正难的从来不是"陪玩师列表 + 下单"这两页——任何团队都能做出来。难的是订单从创建到结清要穿越支付、派单、服务、验收、结算五个环节,每个环节都有异常路径:用户不付尾款、陪玩师接了不上线、服务中断谁举证、抽佣比例中途调整怎么算。这些问题决定了订单链路必须按状态机建模、按分层设计结算,而不是围着页面写增删改查。本文从实现视角拆解陪玩订单的核心状态机、结算分账的三层结构,以及派单与抢单两种调度模式的工程取舍。 ## 一、订单状态机:把异常路径收敛回稳态 ![](https://developer.qcloudimg.com/http-save/yehe-10749150/a86246b813dbb2306d87f9a81e505f5b.png) > 陪玩订单核心状态机——终态只有三个,异常路径必须收敛回稳态 **1. 状态定义宁少勿多** 主链路五个稳态(待支付 / 待接单 / 服务中 / 待验收 / 已完成),终态三个(已取消 / 已退款 / 已完成)。状态越多,组合测试的空间越大;工程上宁可把"接单后取消""验收有争议"这类过程态用事件表记录,也不要为每种业务情形新增一个稳态。 **2. 迁移事件驱动,不用前端触发** 状态迁移只由后端事件驱动:支付回调、超时任务、确认动作、仲裁结果。前端传"把订单改成已完成"这类指令一律拒绝——验收超时自动完成的定时任务、支付回调的异步通知,都是事件源的例子。事件进队列表,状态变更落变更流水,任何一次异常都能回放出完整链路。 **3. 两个必备防错机制** - **幂等**:支付回调重复通知、确认按钮重复点击,都靠迁移前置条件(当前状态 + 事件签名)挡住,而不是靠前端防抖 - **超时回池**:待接单超过响应时限未接,订单自动回派单池并给原候选者记响应率扣分——没有这条,派单池会被死单堵住 ## 二、结算分账:三层结构隔离资金风险 ![](https://developer.qcloudimg.com/http-save/yehe-10749150/4641081bba6f017e3244bc75e3602a5d.png) > 结算分账三层结构——平台自有账户不留存用户资金 **1. 资金层交给持牌机构** 预付款、尾款、退款的资金收付全部走持牌支付机构的分账能力,分账指令由持牌系统执行,平台自有账户不留存用户资金。这一条同时是工程设计和合规设计:资金池模式在监管上是高危形态,在工程上也要额外承担对账与存证的全部复杂度。 **2. 计算层规则配置化** 抽佣比例按品类、段位、订单类型进配置表;多角色分账(平台 / 陪玩师 / 邀请人)在订单成交时生成计算快照——比例后调不影响历史订单复算。优惠分摊、违约金扣减都规则化,每笔结算可从原始数据重算核对。 **3. 对账层任务化** 支付渠道账单 T+1 自动对账,差异单进人工处理队列;提现有审核与限额;结算流水只追加、不修改,修正用冲正记录表达。 ## 三、派单与抢单:两种调度模式的工程取舍 ![](https://developer.qcloudimg.com/http-save/yehe-10749150/cf9079642337d5aec72dac826bbc2153.png) > 派单与抢单对比——两种模式的适用阶段与工程代价 **抢单模式**实现简单,订单进大厅池先到先得。高并发下的核心问题是防超卖:多人同时抢一单,用数据库行锁或 Redis 预扣保证只有一个成功。它的问题在于体验不可控——接单质量取决于陪玩师手速而不是匹配度。 **派单模式**按段位、胜率、响应率加权匹配,体验可控、纠纷率低,但工程代价明显更高:要维护在线心跳、响应率画像、权重配置,还要处理"派了不接"的降级策略(顺延候选人或回池)。常见的落地路径是起步期用抢单跑数据,成长期叠加派单规则——两种模式共存于同一状态机之下,切换的只是候选人生成方式。 ## 四、风控与内容安全:陪玩类目的必答题 陪玩类目的平台风险集中在私下交易导流、站外收款、语言骚扰三件事上,工程上对应三个子系统: 1. **违规词库**:聊天与动态内容过词库 + 分级处置(拦截 / 提示 / 人工复审),词库支持后台热更新 1. **行为识别**:同 device 下多账号、订单后加好友、异常话术频次等信号进风险分,高危账号限功能 1. **举报与处置**:举报工单、证据留存(聊天记录快照)、处置动作(警告 / 限单 / 封禁)全流程留痕,可审计 这套东西在页面原型上看不见,但决定了平台能不能通过应用审核、能不能长期活着——技术评审时它应该和状态机、结算占同样权重。 ## 结尾:三个高频踩坑 1. 结算比例写死在代码里,运营第一次调抽佣就要发版,还容易算错历史订单 1. 没有订单状态变更流水,出了纠纷只能翻服务器日志拼时间线 1. 抢单接口没做幂等与预扣,大促发券后同一单被多个陪玩师同时"抢到" 陪玩平台是典型的"交易型双边系统",页面之下是状态机、结算、风控三条链路。这三条链路在设计期多花的时间,都会在上线后的每一个异常工单里赚回来。

优秀的个人博客,低调大师

JI-UI适用于微信小程序的UI库(二)——j-local-popup点击位置弹出层

读者你好,我将在这一系列文章中逐步更新JI-UI的公共UI库。但在短期内只会更新由我创作的部分。 问题的引出 全局弹出层无疑的最常见的弹出层实现,但是它带来的问题。在我看来,不够轻型化,难以胜任某些场景。 我希望,可以实现如下的行为: 如图可以看到,我在点击选择字体颜色图标时,弹出层会跟随鼠标点击(实际中当然是跟随用户触碰)弹出。 问题的解决 要点 要获取用户点击位置;事件里会有 要获取弹出层的宽高;这里肯定要动态获取,通过this.createSelectorQuery()实现 确定弹出层的位置;要考虑到不能超出页面边界,以及从实用性的角度,应该考虑从上方弹出、从下方弹出以及从左边、从右边弹出。 弹出层怎么取消?我们考虑了如何弹出,但是也务必考虑它的注销流程。实际上我们在设计自定义组件的时候,应当考虑它的整个生命周期。简略来说,即组件的创建、工作、销毁。 解决问题 组件的wxml部分 <slot name="main" catchtouchend="openPopup"></slot> <view class="popup" catchtouchend="closePopup" wx:if="{{visible}}"> </view> <view wx:if="{{visible||ishow}}" style="top:{{top}}px;left:{{left}}px;position:fixed;opacity:0;transform:scale(0.1)" class="out-class {{show?'show':''}}"> <slot name="popup"></slot> </view> 解析一下,这段代码中中存在两个插槽,其中一个为main,另一个为popup; main是设计给被点击对象的,这样子想使用触碰弹出层的话方式会非常简单,只需要把原本的代码带上slot="main"放进组件中即可 以下边这段代码为例,我们希望点击它可以弹出“Love you”。 <i class="hello"> hello </i> 只需要: <j-local-popup> <i class="hello" slot="main"> hello </i> <view slot="popup" class="love">Love you</view> </j-local-popup> 同样的,slot名为popup的组件将作为点击后的弹出层出现。 组件的js部分 阅读了wxml部分,你应当知道组件是创建方法是openPopup,销毁它则是通过closePopup 下边是openPopup的解析,closePopup较为简单,如果有需要可以自行在git中查看。 openPopup(e){ var that=this; let detail=e.changedTouches[0]; var top=detail.clientY; var left=detail.clientX; var width=0; var height=0; new Promise((resolve,reject)=>{ that.setData({ visible:true, ishow:true },()=>{ let o = that.createSelectorQuery().select(".out-class").boundingClientRect(rect => { width=rect.width; height=rect.height; }).exec((res)=>{ resolve(res[0]) }); }) }).then(res=>{ if (that.properties.position=='top') { that.setData({ top:top-(height*10)-5, left:left-(width*10/2), show:true }) } }) } 基本上,代码由三步组成。 1. 开始渲染组件 that.setData({ visible:true, ishow:true } 2.在渲染完组件后获取popup插槽父组件的高度、宽度 that.createSelectorQuery().select(".out-class").boundingClientRect(rect => { width=rect.width; height=rect.height; }).exec((res)=>{ resolve(res[0]) }); 3. 处理top从上方弹出 that.setData({ top:top-(height*10)-5, left:left-(width*10/2), show:true }) 这里对height和width进行*10是因为初始状态通过scale(0.1)改变了组件的大小,-5则是一定程度的偏移。 组件的动画效果 演示图中,我们看到的是组件的放大缩小显隐,从我个人的角度我认为这种形式的动画会让我更舒适。 这种效果并不是很难做到。 opacity:0; transform:scale(0.1) opacity改变透明度,transform中的scale改变大小。 当我们把这两个初始值取消,并在tranistion中配置好贝塞尔曲线、影响参以及动画时间 transition:all ease .6s; 于是我们便完成了这个简单的动画 一个有趣的事情 有一位初学前端的朋友问我,为什么你在动画里不通过改变width和height实现,是因为这个函数方便么? 显然不能只是这样...... transform里几个函数都有极强的功能。细究会发现其中的translate移动和scale缩放的部分或者全部功能其实是可以通过改变其他css属性实现的。 通过直接改变width和height只会改变对应组件的长宽,子组件不会被改变,直接改变长宽适用于卷轴式的动画 通过带有top、left等的属性我们可以改变组件位置,但是为什么我们不应该这样做?因为通过这种方式创建出来的动画不流畅,可能我们的肉眼不一定能很好察觉,但是性能可以好为什么不做好点。 至于为什么通过带有top、left等的属性改变组件位置创建的动画并不流畅,这和浏览器的工作机制有关系,之后会专门说明。 Tips&Bugs tip:使用catchtouch而不是bingtouch或是bindtap,因为点击这里并不希望事件传递出去使得出现输入框失焦等问题 bug:是的,我没有做不能超出页面边界的控制这一部分。因为目前还没遇见该问题,暂且不想花费宝贵的期末复习时间。 JI-UI库gitee地址:https://gitee.com/grinzero/ji-ui文件已经上传了一部分

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册