系统架构师-基础到企业应用架构-系统设计规范与原则[下篇]
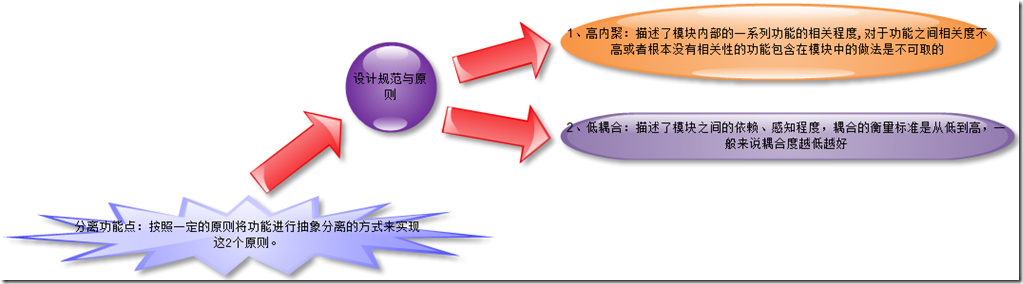
、上章回顾 上章我们主要讲述了系统设计规范与原则中的具体原则与规范。如何实现满足规范的设计,我们也讲述了通过分离功能点的方式来实现,而在软件开发过程中的具 体实现方式简单的分为面向过程与面向对象的开发方式,而目前更多的是面向对象的开发设计方式。具体的内容请看下图: 上图描述了软件设计的原则:低耦合,高内聚,并且简单说明了,如何实现这2个原则,通过分离关注点的方式。我们把功能称之为关注点。 二、摘要 本文将通过实例来讲解如何通过分离功能点,并且讲解分离关注点实现相应功能点时应该注意的问题。比如说一些相关的重要部分的内容。分离功能点是实现软 件功能的一项重要基础,随着软件复杂度的不断提高,传统分离关注点的技术是只从一种方式去分离关注点,例如按照功能或者按照结构等等,使得越来越多的关注点 得不到有效、充分的分离。因此有效、充分的分离关注点就是我们更好的实现软件功能的重要标准,那么我们如果想实现这个目的,就必须对软件同时从多种方式进行 分解,因为分解的越详细,那么系统的设计就越清晰,那么就更容易满足设计原则需求。通过分离关注点能够使软件的复杂度降到最低,同时可理解性得到提高。 本文将会举例说明如何同时按照多种方式去分离关注点。因为本文中的内容都是本人对工作过程中的经验与总结,不足之处在所难免,还请大家多多提出自己的 意见和建议,错误之处,在所难免,请大家批评指出。 三、本章大纲 1、上章回顾。 2、摘要。 3、本章大纲。 4、分离关注点的多种方式。 5、相关设计方法。 6、本章总结。 7、系列进度。 8、下篇预告。 四、分离关注点的多种方式 我的理解是分离关注点(功能点)的方式有以下几种及每种划分的原则,下面我们将会讲解如何按照不同的方式去划分一个系统,通过抽象功能点来降低软件系统的 复杂度,并且提高系统的可理解度。 1、按模型来划分 这里的模型划分分为概念模型与物理模型:当然这里的概念模型就是抽象模型,例如我们平时说的功能的分离,我们以B2C的产品管理来说吧,产品管理里面 至少拥有的功能是选择产品分类,选择产品单位,产品的扩展属性,产品的所属品牌等相关属性信息。那么我们闲来说说概念模型就是说是抽象模型,那么我们通过图 形化的方式来描述 这是添加一个产品必须具备的四个相关功 能点的分离。 那么我们在物理模型上如何去实现产品管理的物理模型呢?下面我们来看看。 简单的解释就是具体的每个功能点的具体业务设计模型,物理模式是概念模型的实现。 2、按层次来划分 层次可以简单的分为分层分离的方式与横切分离的方式,那么来举例说明,我们都知道横切和纵切,就是说看待的问题的角度,下面来举例说明如何以这2种 方式来分离功能点。 当然我们这里仍然以B2C系统为例来说明这样的情况。我们这里先来看分层分离的方式来处理。 我们的B2C可以简单按照如下方式进行分层,业务逻辑层与界面通过服务层来调用,这样可以避免UI层与业务层之间的耦合,而业务 逻辑层通过数据访问层与数据库进行交互。当然可能我这里的部分设计还存在不合理之处,还请大家多多提出宝贵意见,好让这个设计更加完善。 那么我们下面来看下横切分离方式的情况,我们知道,我们系统中可能会对管理员或者任何操作人员的操作的详细信息进行详细的记录,那么我们 就会通过日志的方式来处理,横切的方式就是系统从头到尾的任何一个功能处都会用到,这是一个横向分离关注点的过程。那么我们在设计系统操作日志时就会记录相应 的操作日志或者系统的错误日志等等相关信息。 操作日志与错误日志贯穿每个分层结构、分离关注点横向分离的方法实现就是AOP(面向方面编程)。当然我们后面会介绍AOP的具体实现方式细节。 五、相关设计方法 本节将会详细的阐述分层与横切分离关注点的二种编程方式的实现,通过编程方法实现关注的不同切面来分析设计方法的实现。这里介绍的二种编程方法是面向 对象的编程方法实现分层方式的分离关注点与面向切面的编程方法实现横切分离关注点的方式。 1、面向对象设计 首先、面向对象作为一种编程思想,我想在园子里面的大多数同仁都比较熟悉,我这里也不详细谈面向对象的设计,这里我们只是谈谈面向对象设计中的几个 原则和需要注意的方面。 我们知道面向对象的编程思想是把世界万物都看作是对象,而复杂的功能可以看作对象与对象之间的关系组成。那么我们在分离关注点后,那么每个关 注点可以进一步细化为多个对象及对象之间的关系。 那么我们来看看面向对象设计中的几个基本的原则,并且分别的举例说明: a、首先必须先从分离关注点中分析出对象及对象之间的关系。例如我们以B2C系统中的店铺管理来说。 图中简单描述了店铺管理中应有的对象。 图中简单的描述了对象之间的关系,店铺信息依赖店铺等级与店铺类型信息,店铺认证信息 依赖店铺信息。 b、对象分离出来之后,那么我们先来看看对象对应的类的几个相关原则: (1)、(SRP)单一职责原则,简单来说就是一个类只提供一种功能和仅有一个引起它变化的因素。如果我们发现一个类具有多个引起它变化的因素时就必须想办 法拆分成单独的类。下面来举例说明。我们这里以ORM中的实体接口层来说。 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 public interface IEntity { /// <summary> /// 保存 /// </summary> /// <returns>返回影响的行数</returns> int Save(); /// <summary> /// 删除 /// </summary> /// <returns>返回影响的行数</returns> int Delete(); /// <summary> /// 写入日志信息 /// </summary> /// <param name="message">写入信息</param> /// <returns>返回影响的行数</returns> int WriteLog( string message); } 很明显这里的写入日志与前面的对实体的持久化的操作明显不搭边,这样的可能会造成2中引起类发生改变的因素时就必须分离,那么就必须把它抽出来,单独定义一个接口。修改后结果如下: ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 public interface IEntity { /// <summary> /// 保存 /// </summary> /// <returns>返回影响的行数</returns> int Save(); /// <summary> /// 删除 /// </summary> /// <returns>返回影响的行数</returns> int Delete(); } public interface Logger { /// <summary> /// 写入日志信息 /// </summary> /// <param name="message">写入信息</param> /// <returns>返回影响的行数</returns> int WriteLog( string message); } (2)、(OCP)开发封闭原则:简单来说就是不能修改现有的类,而需要在这个类的功能之上扩展新的功能,这时通过开放封闭原则来实现这样的要求。该原则使我 们不但能够拥抱变化,同时又不会修改现有的代码。而这个原则的实现可以简单来说就是我们将一系列发生变化的类的行为抽象为接口,然后让这些类去实现我们定义 的接口,调用者通过接口进行操作。例如我们以MP3播放器来说。 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 public interface IMP3 { /// <summary> /// 播放 /// </summary> /// <returns>返回操作是否成功</returns> bool Play(); /// <summary> /// 停止 /// </summary> /// <returns>返回操作是否成功</returns> bool Stop(); } 定义2个不同的实现 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 /// <summary> /// 台电播放器 /// </summary> public class TD : IMP3 { #region IMP3 成员 public bool Play() { return true ; } public bool Stop() { return true ; } #endregion } /// <summary> /// 惠普播放器 /// </summary> public class HP : IMP3 { #region IMP3 成员 public bool Play() { return true ; } public bool Stop() { return true ; } #endregion } 通过一个测试类来模拟接口调用,通过依赖注入的方式实现。 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class Test { IMP3 mp3 = null ; public Test(IMP3 mp) { mp3 = mp; } public bool Play() { return mp3.Play(); } public bool Stop() { return mp3.Stop(); } } 具体的测试代码我就不书写了,我想大家都知道了。 (3)、(LSP)替换原则:简单的来说就是基类出现的地方,扩展类都能够进行替换,那么前提就是我们不能修改基类的行为。也就是说基类与扩展类可以互相相 容。在面向对象中可能会认为很容易实现,不过我们要注意有时候我们从父类中继承的行为有可能因为子类的重写而发生变化,那么此时可能就不满足前面说的不改变 基类本身的行为。我们最熟悉的多态其实这样的情况就不满足这个原则。需要注意的时,对调用者来说基类与派生类并不相同,我们简单来说明。 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 public class Test { private int tempValue=0; public void TestA() { tempValue = 2; } public virtual void TestB() { tempValue = 9; } } public class Test1 : Test { public override void TestB() { //如果调用该方法,那么tempValue的值可以和基类中的得到的值是相同的,如果不显示的调用几类方法,那么这个值将丢失 //则不满足替换原则。 base .TestB(); } } 通过上面的简单代码可知,里氏替换原则中需要注意的地方:当对具有virtual关键字和saled关键字的类或者方法需要特别注意,因为这些关键字会对继承类的 行为造成一定的影响,当然上面的例子中只是说了重写的情况,还有new的情况,就是把父类中的方法隐藏,同样都是不满足里氏替换原则的。本例中我们的 tempValue是私有类型的变量,那么在基类中可以访问到,派生类中却无法访问,所以我们要注意,在处基类替换时需要注意继承的成员函数的访问域,建议的方式是 虚方法访问的类的成员变量尽量使用保护类型,这样可以防止丢失的情况。当然基类中有虚方法访问了基类中定义的私有变量,那么如果在继承类中如果想不丢失该基 类中该虚方法对其内部的私有变量的访问,那么可以在继承类中通过“base.(函数名)”的形式来显示调用基类方法,可以保持基类的行为。 (4)、(DIP)依赖倒置原则:简单来说就是依赖于抽象而不应该依赖于实现,这样的目的就是降低耦合性。简单的来说就是让二个类之间的依赖关系通过接口来解 耦,让一个类依赖一个接口,然后让另外一个类实现这个接口,通过构造注入或者属性注入的方式来实现依赖。简单来说就是抽象不依赖于细节,细节依赖于抽象。下 面我们来举例说明: ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 /// <summary> /// 汽车制动系统 /// </summary> public interface IControl { int UpSpeed(); bool Brake(); } /// <summary> /// 其他服务 /// </summary> public interface IServer { bool Radio(); bool GPS(); } 具体的使用 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 /// <summary> /// 汽车 /// </summary> public class Car { private IControl control = null ; private IServer server = null ; public Car(IControl con, IServer ser) { control = con; server = ser; } public void Start() { control.UpSpeed(); } public void Play() { server.Radio(); } public void Map() { server.GPS(); } } 上面简单的举例说明,并没有给出具体的实现,只要实现上面的2个接口即可,这里就不详细说明了,希望大家能够明白。错误之处还请大家指出。 (5)、(ISP)接口隔离原则:简单的来说就是客户不关心细节的东西,他就只关心自己能够得到的服务,而面向对象的原则我想大家都知道,通过接口的方式来提 供服务。因此我们提供给客户的是一系列的接口,那么这样就具有很好的低耦合性。我们来简单的举例说明:以ORM中的简单的持久化操作来说 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 public interface IORM { /// <summary> /// 保存 /// </summary> /// <returns>返回影响的行数</returns> int Save(); /// <summary> /// 删除 /// </summary> /// <returns>返回影响的行数</returns> int Delet(); /// <summary> /// 获取所有列表 /// </summary> /// <returns>返回一个DataTable</returns> DataTable GetList(); } 这里我们让一个实体来继承实现。 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 public class ORM : IORM { #region IORM 成员 public int Save() { return 1; } public int Delet() { return 1; } public System.Data.DataTable GetList() { return new System.Data.DataTable(); } #endregion } 业务层的实现 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class Entity { private IORM orm = null ; public Entity(IORM orm1) { orm = orm1; } public int Save() { return orm.Save(); } public int Delete() { return orm.Delet(); } } 这里我就不贴出来测试代码的实现了,后面我会把代码贴出来下载,如果有兴趣的同仁可以下载看看。当然我这里只是抛砖引玉,不足之处,还请大家多多 指出。面向对象设计中还有很多的原则,这里也不会一一复述。这里只是冰山一角,还希望大家多多提出宝贵意见。 2、面向切面编程 面向切面编程,其实就是面向方面编程,其实这个概念很早之前就提出了,但是并没有广泛的流行,这个是比较让人不解的地方,我平时其实使用的也是比 较少的。不过我们在系统架构中却是非常有用,特别是在关注点的分离的过程中起到很大的作用。AOP的主要目的呢,是将横切的关注点与核心的分层形式的或者说是 功能组件的分离。下面我们来看看AOP中的如何实现方面编程。 面向方面编程中的方面并不是直接有编译器来实现,而是通过某种特殊的方式将方面合并到常规的源代码中,然后通过编译器编译的方式。我们知道一个方 面就是一个横切关注点,在实现方面的过程中,我们通常需要定义连接点与基于这个连接点上的通知来完成。下面我们来看看AOP的处理源代码的模型: AOP一般都是有框架提供注入的功能,而这里的代码注入功能与我们在面向对象的依赖注入不同。这里的注 入是将方面的代码植入到常规代码片段中。 下面我们先来介绍AOP中的连接点与通知。 连接点:用来标识某个类型中的植入某个方面的位置,而连接点可以是某个方法的调用,属性访问器,方法主体或者是其他。连接点一般用来标识注入某个 方面的类型中的代码位置。 通知:用来标识注入到类型中植入方面的具体的代码。简单来说就是要注入的方面代码。 目前在.NET中已提供AOP的植入基础功能。PIAB就是AOP在.NET下的一种实现方式。下面我们来简单的说说,当然园子里面不少的大牛也讨论过这个 PIAB的相关介绍及用法。大家可以参考这些作者的文章。 一般我们在.NET平台下有2种注入方面代码的方式,下面以图例来说明: 可能具体的实现方案这里枚举的并不全面。但是一般采取植入的方式就这2类了,运行期实现的方案较多,编译期实现则需要有第三方提供方面植入工具, 完成编译前的代码植入,并且必须保证植入的代码是可以编译通过的。 如果想详细了解PIAB请参考 :大牛Artech的PIAB系列《EnterLib PIAB深入剖析》系列博文汇总。 六、本章总结 本章详细的阐述了软件设计的规范与原则的实现方式,通过面向对象与面向方面编程来分离实现关注点,并且在实现过程中遵循的原则等。并且分析了分离关注点 中的分离方法与角度,通过多种方式及多角度的分离关注点,当然本文只是抛砖引玉,不足之处,还请大家多多提出宝贵意见。鄙人将在后续文章中持续改进,谢谢! 七、系列进度 八、下篇预告 下一篇我们将会开始讲解软件设计中最重要也是最基本的技能-设计模式,希望大家多多提出已经,后面3篇我们将会讲解如何在项目中使用设计模式及使用设计 模式需要注意的事项,将会举例说明每个设计模式可能出现的场景。希望大家持续关注! 九、Demo下载 下载:点击下载 本文转自 hot的fans 51CTO博客,原文链接:http://blog.51cto.com/2435232/600637