AI 预测可视化平台 | 场景模拟器:Slider + What-if Analysis 交互设计
# 引言 **如果下周把价格降到 89 元会怎样?如果把促销强度从 0.6 提到 0.9 呢?如果供应商断供两周,库存能撑到什么时候?** 这类问题模型没在训练时见过,也不能靠重新训练来回答。场景模拟器(What-if Analysis)要做的,是让计划员在前端"拧动"特征值、即时看到预测曲线如何响应,再把这套假设保存成可分享、可复现的场景。本文将拆解交互架构、滑块组件、代理模型与不确定性处理、批量对比方案,以及性能底线。 --- # 一、先界定边界:前端能模拟到什么程度 不是所有"如果"都适合在前端算。这决定了整个模块的技术路线,也决定了它能不能在 16ms 内响应。 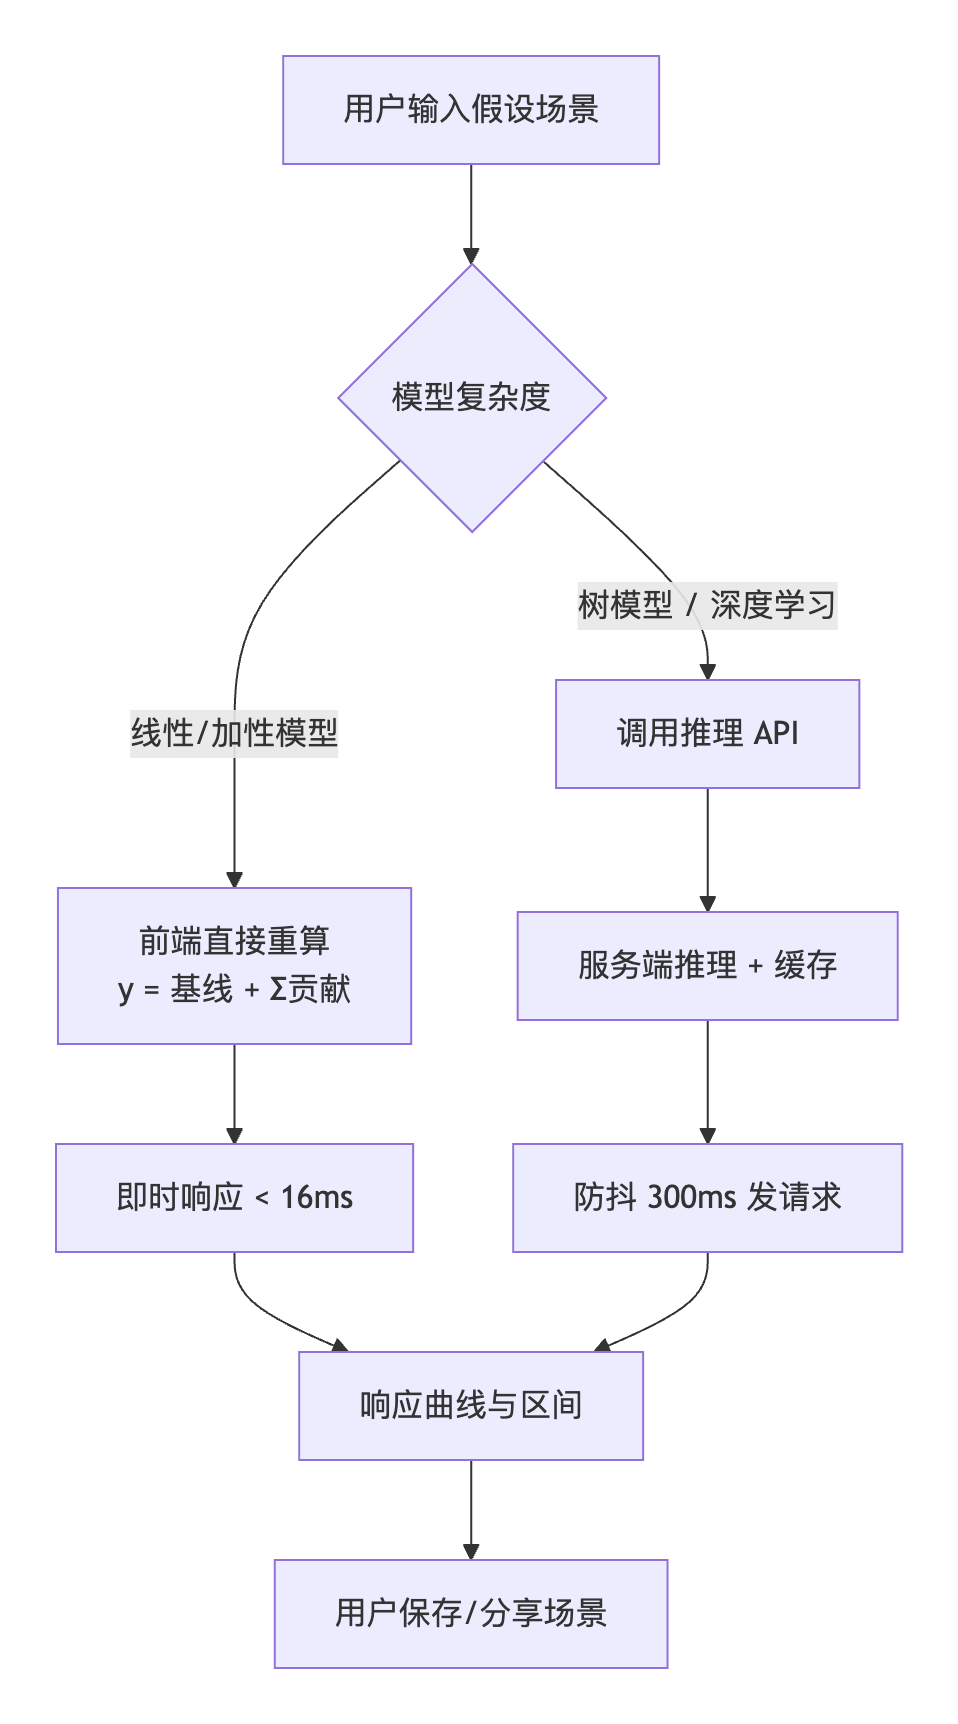 **解析**:Prophet 是加法模型 `y = trend + seasonality + holidays + regressors`,**外部回归因子(价格、促销强度)的贡献是显式的**,前端只要保留基线和其他分量,就能用新因子值即时重算。这是最理想的情况。但树模型和深度学习模型没有这样的显式结构,必须回传后端推理,此时前端只做请求编排与缓存,不做越权计算。 数据契约上,建议后端下发"可模拟因子"的元信息,而不是前端写死因子名: ```javascript { "sku": "SKU-1002331", "baseline": 1200, "scenario": { "base": { "price": 99, "promo_intensity": 0.6, "inventory": 3400, "stockout": 0 }, "editable": ["price", "promo_intensity"], "readonly": ["inventory", "stockout"], "bounds": { "price": { "min": 59, "max": 149, "step": 1, "unit": "元" }, "promo_intensity": { "min": 0, "max": 1, "step": 0.05, "unit": "" } }, "effects": { "price": -12.4, "promo_intensity": 210 } } } ``` **解析**:`editable` 和 `readonly` 是权限模型——**库存和缺货是事实字段,不允许假设修改**,否则计划员能"模拟"出一个不存在的库存状态,得出的结论反而误导。这是模拟器最容易出事故的地方。`effects` 是该因子对预测值的一阶影响系数,即 `∂y/∂x`,前端用它与新值做线性外推。下发边界让滑块自带合法值域,避免输入离谱数值。 --- # 二、滑块组件:让"拧动"有即时反馈 滑块是场景模拟器的主交互。它的价值不在"能拖",而在于**拖动的每一帧都同步更新曲线**——这是"假设"变成"洞察"的唯一通道。  **解析**:拖动过程**不应触发网络请求**,全部走前端内存计算。只有用户点"保存场景"或切换 SKU 时才请求。这是 60fps 响应的前提。 ```javascript import { useState, useMemo, useCallback } from 'react' const SLIDER_META = { price: { label: '售价', unit: '元', color: '#6366f1', format: v => `${v}元` }, promo_intensity: { label: '促销强度', unit: '', color: '#10B981', format: v => v.toFixed(2) }, } export function ScenarioSlider({ factor, meta, base, effect, value, onChange }) { const pct = ((value - meta.min) / (meta.max - meta.min)) * 100 const delta = useMemo( () => (value - base) * effect, [value, base, effect] ) return ( {meta.label} {meta.format(value)} {/* 基线锚点与当前值刻度 */} 基线 {meta.format(base)} onChange(factor, Number(e.target.value))} className="absolute inset-0 w-full opacity-0 cursor-pointer" /> 0 ? 'text-emerald-600' : delta 预测影响 {delta > 0 ? '+' : ''}{Math.round(delta)} 件 ) } ``` **解析**:滑块轨道上叠加了一条**基线锚点线**,这是整组件最关键的设计——用户拖动时能看到"离基线多远",而不是只看绝对数值。渐变色条从半透明到实色表达"偏离强度"。`useMemo` 包裹的 `delta` 在拖动过程中实时重算,`onChange` 每帧触发但只更新值,**整个组件不重渲染无关 DOM**。`opacity-0` 的 `` 覆盖在最上层承接事件,既保留原生键盘可达性(方向键微调),又能完全自定义视觉。 --- # 三、模拟引擎:一阶外推与代理模型 前端能算到什么精度,取决于模型结构。对于加法模型,线性外推足够且即时;对于非线性模型,需要更聪明的代理。 ```javascript // 加法模型的一阶模拟:用偏导近似因子变化的影响 export function simulateAdditive(scenario, overrides) { const { base, effects } = scenario const changes = {} let totalDelta = 0 for (const [f, v] of Object.entries(overrides)) { const eff = effects[f] if (eff == null) continue const delta = (v - scenario.base[f]) * eff changes[f] = delta totalDelta += delta } return { newBaseline: base + totalDelta, delta: totalDelta, changes, // 各因子的独立贡献,用于归因瀑布 warning: totalDelta > base * 0.3 ? '偏离基线过大,线性近似可能失真' : null, } } ``` **解析**:`base + Σ(factor - base) × effect` 是线性外推的标准写法。`changes` 把每个因子的独立贡献保留下来,可以复用前文的瀑布图做归因——**这让"为什么这个场景预测会变"同样可解释**。`warning` 是诚实性机制:**线性外推在偏离基线 30% 以上时误差会快速放大**,必须提示用户这是近似值,避免把外推当结论。  **解析**:这是一个**精度与性能的自动分级**——小扰动用即时外推,大扰动自动升级为真实推理。分界点 30% 可按模型校准曲线调整,关键是要有这个分界,而不是一刀切。 对于非线性模型,前端可以用训练好的小型代理(如用模型预测结果拟合的多项式或 shallow tree),但更稳妥的方案是后端推理加缓存: ```javascript // 带缓存的场景推理请求 const scenarioCache = new Map() export async function runScenario(sku, overrides) { const key = `${sku}:${JSON.stringify(overrides)}` if (scenarioCache.has(key)) return scenarioCache.get(key) const promise = fetch(`/api/scenario/${sku}`, { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: JSON.stringify({ overrides }), }).then(r => r.json()) scenarioCache.set(key, promise) const result = await promise return result } ``` **解析**:`key` 用因子组合序列化,**相同的假设场景绝不重复请求**,这是模拟器流畅的核心。用 promise 本身缓存,即使并发触发也只发一次请求。注意缓存要按 SKU 设置上限(LRU,100 条),否则切换大量 SKU 后会内存膨胀。 --- # 四、多场景对比:把假设变成可比较的方案 单个场景是探索,多个场景并排才是决策。计划员需要同时看"不促销 / 弱促销 / 强促销"三档,判断投入产出比。  **解析**:对比视图必须**共轴**——同一时间轴、同一量纲,才能直接比高低。区间带叠加在每条曲线上,让用户同时看到"预期收益"和"不确定性"。差异表要换算到业务指标(毛利、库存),而不只是件数,这是从"预测"到"经营决策"的最后一步。 ```javascript const DEFAULT_SCENARIOS = { baseline: { price: 99, promo_intensity: 0.6 }, aggressive: { price: 89, promo_intensity: 0.9 }, conservative: { price: 109, promo_intensity: 0.3 }, } export function ScenarioDiffTable({ baseline, scenarios, marginPerUnit }) { const rows = scenarios.map(s => { const sim = simulateAdditive(s.data, s.overrides) const extraUnits = sim.delta const extraRevenue = extraUnits * (s.overrides.price ?? 0) const extraMargin = extraUnits * marginPerUnit - extraRevenue * 0.12 return { ...s, extraUnits, extraRevenue, extraMargin } }) return ( 场景价格促销 额外销量 额外毛利 {rows.map(r => ( {r.name} {r.overrides.price}元 {r.overrides.promo_intensity} 0 ? 'text-emerald-600' : 'text-rose-600'}`}> {r.extraUnits > 0 ? '+' : ''}{Math.round(r.extraUnits)} 0 ? 'text-emerald-600' : 'text-rose-600'}`}> {r.extraMargin > 0 ? '+' : ''}{Math.round(r.extraMargin)}元 ))} ) } ``` **解析**:`marginPerUnit` 是外部传入的经营参数,模拟器**不自己猜毛利率**。三档场景(激进 / 保守 / 现状)提供可对比的锚点,避免计划员在无限连续的滑块上迷失。**件数用绿色、亏损用红色**,方向与颜色严格对应。这张表的价值在于把"预测变化"翻译成"这笔投入值不值"。 --- # 五、不确定性:模拟结果也必须带区间 这是模拟器最容易漏掉的环节。用户拧动滑块后,前端如果只给一个 `yhat` 点位,就相当于把外推伪装成确定结论——风险很大。  **解析**:柱状为基线、折线为激进场景,**两条序列都带各自的置信区间**。如果激进场景的区间比基线宽得多,说明"多卖的这部分很不确定"——这是计划员必须知道的信息,直接影响他敢不敢按这个数备货。区间变宽的原因通常是因子偏离基线太远、进入了训练数据稀疏区,正好和前面的 `warning` 机制呼应。 区间的绘制沿用系列第二篇的闭合多边形法: ```javascript export function buildScenarioTraces(baseSeries, simulated) { return [ { x: baseSeries.map(d => d.ds), y: baseSeries.map(d => d.yhat), type: 'scatter', mode: 'lines', name: '基线预测', line: { color: '#9CA3AF', dash: 'dot', width: 2 }, }, { x: [...simulated.map(d => d.ds), ...simulated.map(d => d.ds).reverse()], y: [...simulated.map(d => d.yhatUpper), ...simulated.map(d => d.yhatLower).reverse()], fill: 'toself', fillcolor: 'rgba(99,102,241,0.18)', line: { width: 0 }, name: '模拟场景区间', hoverinfo: 'skip', }, { x: simulated.map(d => d.ds), y: simulated.map(d => d.yhat), type: 'scatter', mode: 'lines', name: '模拟预测', line: { color: '#6366F1', width: 2.5 }, }, ] } ``` **解析**:基线用灰色虚线、模拟用紫色实线加区间带,**三者的视觉权重严格区分**——用户一眼知道哪条是"假设"。基线不加区间,避免视图过于拥挤;模拟曲线带区间,因为它才是需要评估风险的主体。 --- # 六、交互架构与性能底线 模拟器的整体交互架构要保证"输入—计算—渲染"三者在主线程外不阻塞: 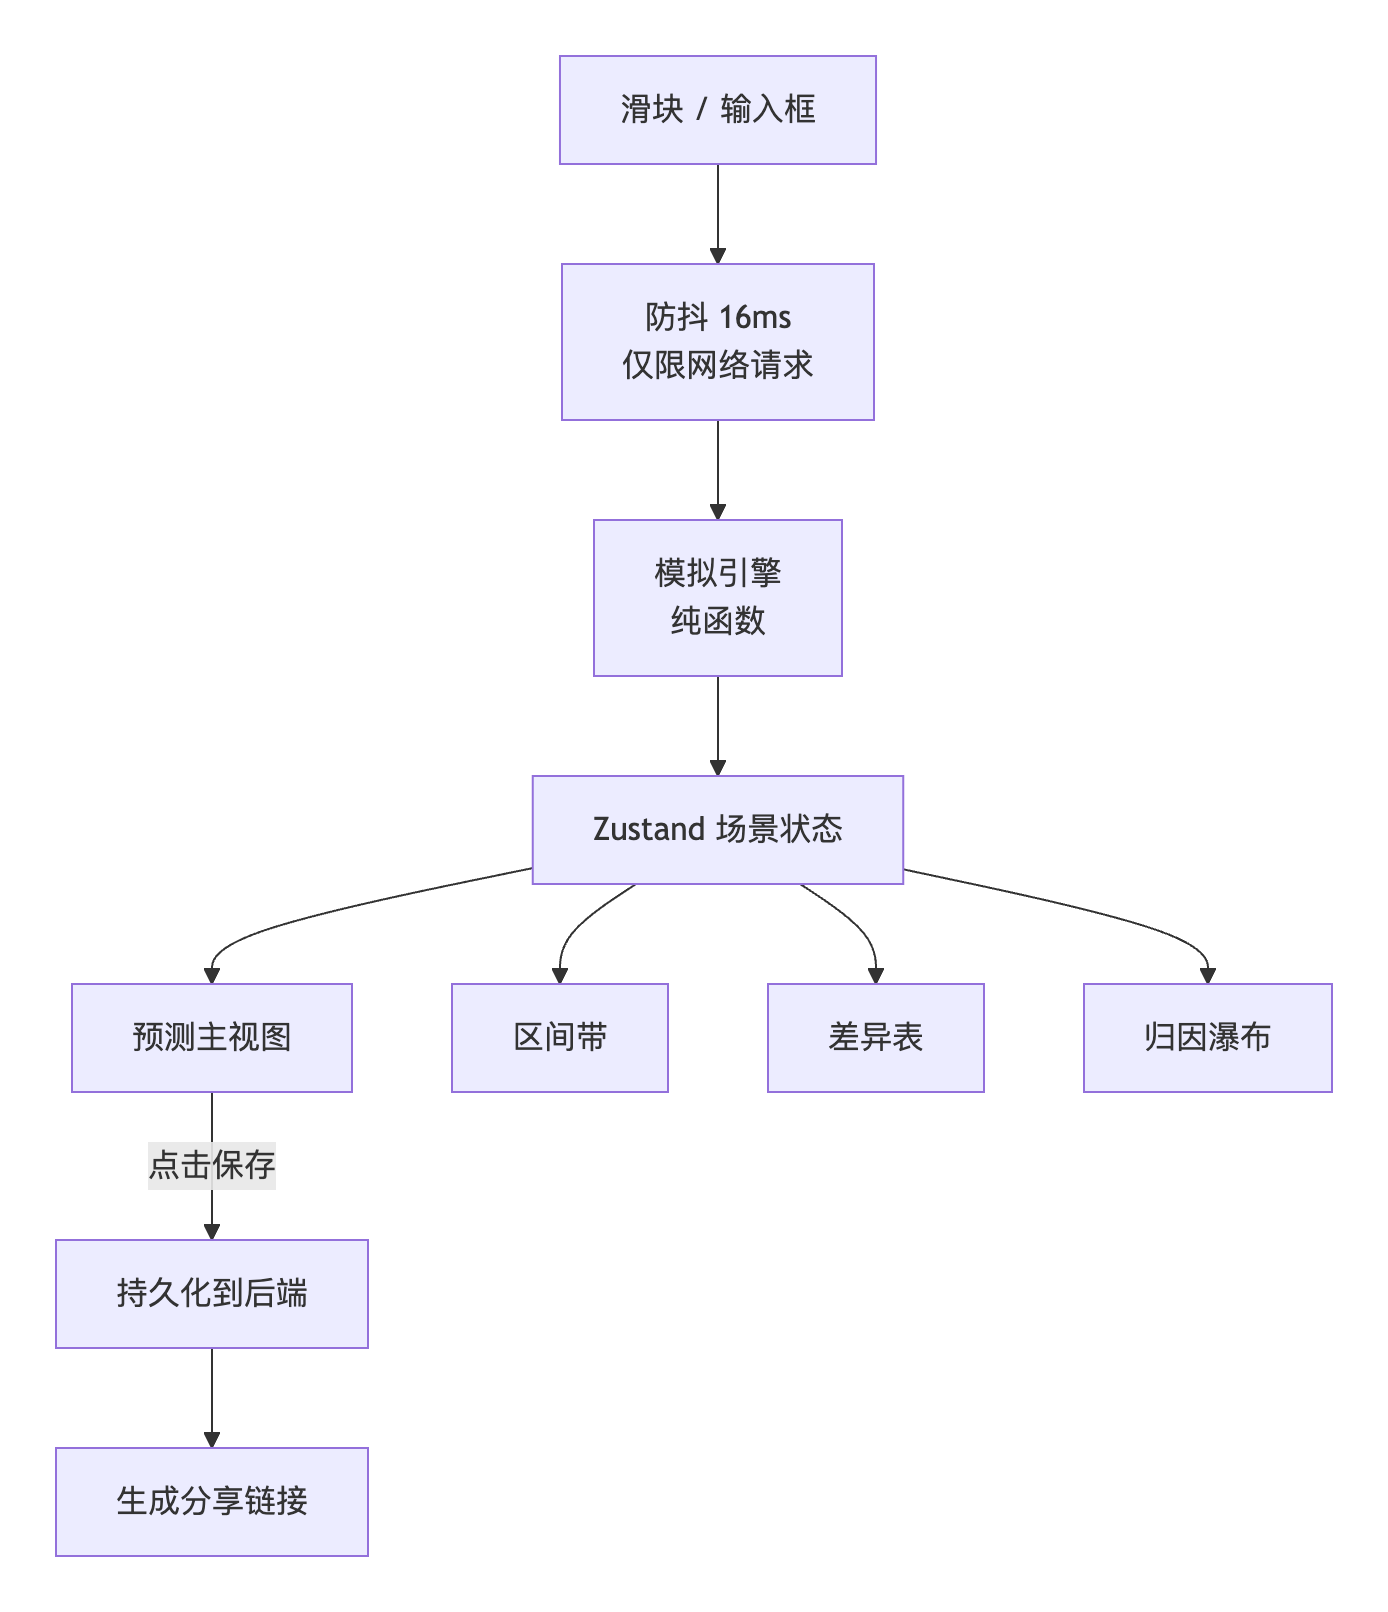 **解析**:滑块拖动**不走防抖**——防抖会让拖动有延迟感,破坏"即时反馈"。防抖只用于网络请求。状态用极轻量的 store,所有派生值(delta、区间、归因)用 `useMemo` 计算,避免无效渲染。 |场景|响应预算|方案| | --- | --- | --- | |滑块拖动| 900 bar [3, 45, 860, 12] ``` **解析**:差距在两个数量级。这也印证了设计原则——**能前端算的绝不上网**,上网的一定缓存。模拟器流畅与否,几乎完全取决于这条铁律。 --- # 七、保存与复现:让假设成为可协作的资产 场景模拟的最终产出不是一张图,而是一个**可被同事复现的假设**。保存时必须记录完整上下文: ```javascript export function serializeScenario(sku, overrides, metadata) { return { sku, overrides, createdBy: metadata.user, createdAt: new Date().toISOString(), baselineVersion: metadata.modelVersion, note: metadata.note, } } ``` **解析**:`baselineVersion` 是必须字段——**同一个假设在不同模型版本下结果不同**,没有版本号的场景不可复现。保存后生成的链接应包含场景 ID,打开即还原全部因子值,直接对接本系列第九篇的协作与导出。 --- # 结语 场景模拟器把预测平台从"解释过去"推进到"辅助决策"。它的设计核心是三个原则:因子必须有可编辑与只读之分,否则模拟会变成对现实的篡改;线性外推只在该可信的区间内即时生效,超出范围必须提示或升级为真实推理;每一个模拟结果都要带区间和归因,让用户既看到收益也看到风险。 阅读本文的收获: - 基线锚点是滑块组件可读性的关键,它让用户始终知道自己在偏离什么; - 因子影响系数的一阶外推要保留各因子的独立贡献,才能复用归因瀑布; - 超过基线 30% 的外推必须给出失真警告; - 所有场景必须带模型版本号保存,否则无法复现。