FDE进化36记-第34记-AI能力怎么真正沉淀成企业可复用资产?
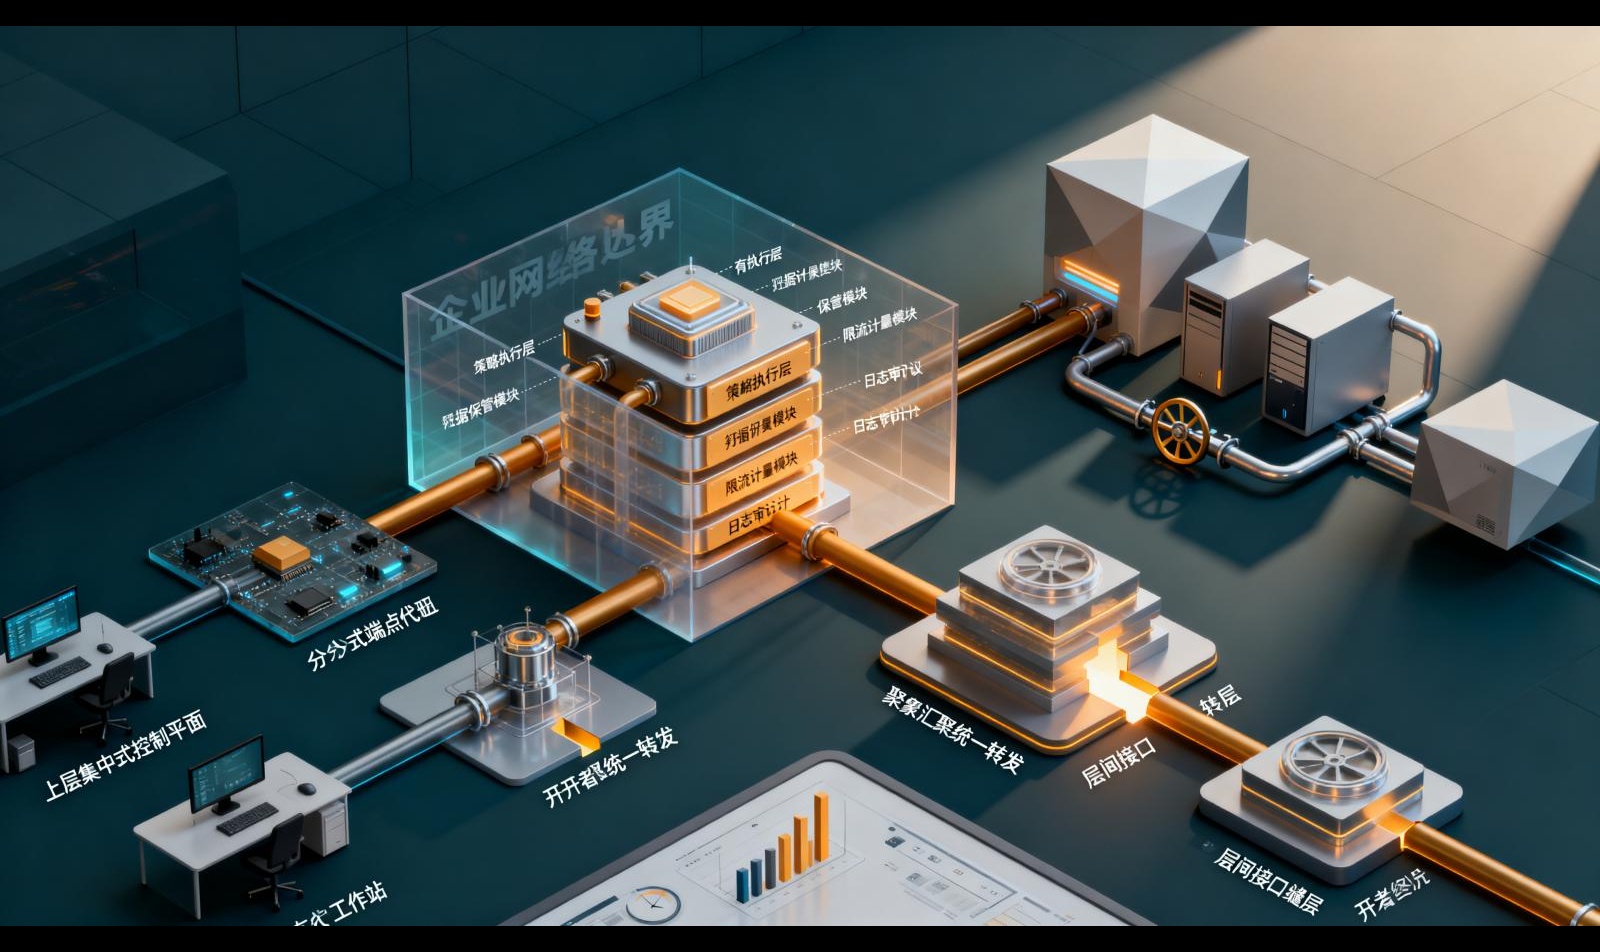
# 统一资产目录:让第二个企业项目不再重造一套Agent > 复用失败,多半不是模型不行,而是资产没有身份。 ```text [读者] 同时交付多个企业Agent项目的FDE与平台工程师 [痛点] 第一个项目跑通,第二个项目又从Prompt和Skill开始复制一遍 [现在读] 企业客户从1家涨到3家,复制成本正在指数级放大 [读完] 能落一套带身份、作用域、依赖、评测和回滚的统一资产目录 ``` ```text [旧方案] 每个项目自建一套Prompt、规则、工具与评测集 | v [新需求] 第二、第三个企业直接复用第一批能力 | v [冲突] 资产没有id、version、scope和依赖,复用只能退化成复制 | v [后果] 改一条合规规则要动N个地方,漏一处就是线上事故 ``` 我是老李,做客服系统出身,这几年带 FDE 团队把 Agent 从 Demo 推到生产。 我们做的是全球智能客服平台:多企业、多项目、多语言、多渠道,后面连着 CRM、订单、支付、物流、工单和知识库。第一个企业客户上线时,团队把 Scenario、Skill、Prompt、Rule、Ontology、Knowledge、Workflow、Tool、Eval Dataset、Metric、Evidence Template、Model Config 这一整套都做出来了,跑得挺好。 第二个企业客户进来时我们才发现,这套东西没有“身份”:散落在不同项目目录、不同仓库、不同 Prompt 管理后台里,没有 id,没有 version,没有 owner,没有依赖关系,也查不到上一轮评测结果。大家只能复制一份,改吧改吧就上线了。 第三个客户进来时,同一条“退款时效规则”已经有 5 个副本,没人说得清线上跑的是哪一版。这时候真正的问题已经不是“Agent 能不能用”,而是“这批能力还能不能被复用”。 第二个项目为什么又要把第一个项目重做一遍?因为没有 id 的能力,等于没有能力。 既然要复用,是共享一个运行实例,还是共享一份可寻址的资产? 如果目录本身设计错了,会怎样?——它不会报错,只会在第三、第四个项目上把团队慢慢拖死。 # 01、故事 第一个项目的现场是这样:一条客服对话进来,Agent 要在几步之内判断用户是想退款、查物流还是投诉,然后调用对应系统。第一个项目沉淀下来的东西,我列一遍:Scenario 是“退款受理”;Skill 是“查订单、查物流、发起退款”;Prompt 是“意图识别”和“话术生成”;Rule 是“30 天退款窗口”;Ontology 里定义订单、退款、物流的关系;Knowledge 是退款政策;Workflow 是退款受理流程;Tool 是 order.query、refund.create;Eval Dataset 是 500 条真实对话;Metric 是任务完成率和转人工率;Evidence Template 规定回答里必须带订单号和政策条款;Model Config 是主模型加降级模型。整套跑通了,指标也能看。 第二个项目是物流延误客服。我们评估后认为,至少一半以上的能力可以直接复用。任务是:让第二个、第三个企业项目用声明式引用的方式复用第一批资产,而不是重新做一套 Agent。 变化随即而来。项目从 1 个变成 3 个,语言从中文变成中英西,渠道从网页变成 WhatsApp 加电话。冲突也很直接:所有资产都没有唯一身份,没有作用域,没有依赖描述,复用根本无从下手,只能复制。复制之后的代价是,一次改动要同步 N 份,改漏一份,就是一次线上事故。 > 一份能力一次写 > 一次改动一处收 > 一旦复制成习惯 > 三个项目三条路 # 02、问题 旧方案是:每个项目一套资产目录,靠人肉同步。 业务影响先出现。合规规则、话术模板、评测集这三样最容易漂移。客户投诉时,我们甚至回答不了“你们依据的是哪一条规则、哪一版话术”。 技术表现紧跟其后。同一个意图识别 Prompt 有 7 个副本,灰度中的版本无法定位;升级之后想回滚,找不到上一版是什么;新项目接入时,工程师的第一反应是“我先复制一份改改”。 要解决它,先得把完成标准写清楚,而且必须可验证。 第一,任一资产可被唯一引用,形如 `asset://{type}/{id}@{version}`,且这个引用在任何项目里含义一致。 第二,任一线上资产都能回答四个问题:owner 是谁、scope 是什么、依赖了谁、最近一次评测结果和可回滚版本是什么。 第三,第二个项目接入时,新增资产只出现在真正差异化的部分,共性能力一律引用。 第四,撤回一次变更,可以不重新部署、不重新构建,只改一次别名指向。 > 标准先写死 > 引用才有意义 > 回滚能落地 > 复用才不是口号 # 03、原理 这一篇只需要三个原理:身份、作用域、版本。 身份。id 是资产的身份证,不是文件名。命名要按领域,不按项目。`rule.refund.window` 是可以复用的,`acme_rule_v2_final` 从命名那一刻起就注定不能被复用。 作用域。同一个 id 在不同 tenant / project 下可以有不同的实现。解析时按 global → tenant → project 由低到高覆盖,就近优先。这个设计让“全局默认 + 租户覆盖”成为可能,而不是让每个租户复制一份。 版本。版本不可变,别名可变。稳定版、灰度版是别名,不是版本号本身。MLflow GenAI 的 Prompt Registry 把 Prompt 纳入版本与别名管理,Langfuse 的 prompt 管理同样用版本加 label 的方式区分环境;具体 API 和字段行为需按当前官方文档核验。 反直觉判断:复用率低的根本原因,通常不是抽象做得不够,而是身份做得不够。没有 id 和 version,任何“共享”都会在第二次复制时退化成本地文件——因为工程师没有办法安全地引用一个说不清版本的东西。 第二个反直觉判断:目录越统一,团队短期会变慢,中期会变快。变慢是因为要给资产补 owner、评测集和版本策略;变快是因为变更成本从“改 N 处”变成了“改 1 处 + 一次回归”。 还有一层可以借鉴:Model Cards(Mitchell 等,arXiv:1810.03993)提出用结构化卡片描述模型的用途、适用因子、指标、评估数据和局限。这个思路可以整体迁移到资产上——每个资产配一张资产卡,评审时看卡片,而不是看实现。 > 名字即契约 > 版本即证据 > 作用域即边界 > 别名即开关 # 04、架构 ```text [输入] 项目装配请求 {root_asset_id, tenant, project, alias} | v [模块] Asset Registry / Scope Resolver / Dependency Resolver / Eval Gate | v [数据/状态] asset(id, version, scope, owner, payload, eval_result, rollback_version) + deps + aliases + evals | v [处理] 作用域寻址 -> 依赖展开 -> 环检测 -> 评测门禁 -> 物化装配清单 | v [输出] 可执行的 Agent 装配清单 + 审计记录 ``` 边界要先说清楚:目录只管“资产是什么、谁能用、依赖谁、有没有通过评测”,不管资产内部的业务逻辑,也不做运行时调度。它是一层注册与解析,不是编排引擎。 收益是明确的:跨项目复用从“人工同步”变成“声明式引用”;变更影响面从“凭记忆”变成“可计算”。 代价同样明确:它是新增的一个有状态组件,会引入解析延迟和新的失败模式(解析不到、作用域错、版本漂移),而且需要有人持续维护 owner、评测集和版本策略。 适用条件:项目数大于等于 2,或者同一个能力有 2 个以上租户需要差异化。只有一个项目、一个租户时,直接写死反而更快。 > 注册不复用 > 解析不编排 > 边界说在前 > 代价摆上桌 # 05、实战一次 环境与依赖:Python 3.11,SQLite(Python 标准库自带),零第三方依赖。目标是先跑通一个最小的注册与解析。 核心实现 `registry.py`: ```python #!/usr/bin/env python3 '''统一资产目录 V1:注册、寻址、作用域解析、依赖展开''' import argparse import json import sqlite3 from pathlib import Path DB_PATH = Path('assets.db') SCHEMA = ''' CREATE TABLE IF NOT EXISTS assets ( id TEXT NOT NULL, version TEXT NOT NULL, type TEXT NOT NULL, scope TEXT NOT NULL, owner TEXT NOT NULL, payload TEXT NOT NULL, eval_result TEXT, rollback_version TEXT, created_at TEXT DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (id, version, scope) ); CREATE TABLE IF NOT EXISTS deps ( id TEXT NOT NULL, version TEXT NOT NULL, scope TEXT NOT NULL, dep_id TEXT NOT NULL, PRIMARY KEY (id, version, scope, dep_id) ); CREATE TABLE IF NOT EXISTS aliases ( id TEXT NOT NULL, scope TEXT NOT NULL, alias TEXT NOT NULL, version TEXT NOT NULL, PRIMARY KEY (id, scope, alias) ); ''' def conn(): c = sqlite3.connect(DB_PATH) c.executescript(SCHEMA) return c def scope_chain(tenant=None, project=None): chain = ['global'] if tenant: chain.append('tenant:' + tenant) if tenant and project: chain.append('project:' + tenant + '/' + project) return chain def register(c, a): c.execute( 'INSERT OR REPLACE INTO assets ' '(id, version, type, scope, owner, payload, eval_result, rollback_version) ' 'VALUES (?,?,?,?,?,?,?,?)', (a['id'], a['version'], a['type'], a['scope'], a['owner'], json.dumps(a.get('payload', {}), ensure_ascii=False), a.get('eval_result'), a.get('rollback_version'))) for d in a.get('depends_on', []): c.execute( 'INSERT OR REPLACE INTO deps (id, version, scope, dep_id) VALUES (?,?,?,?)', (a['id'], a['version'], a['scope'], d)) c.commit() def resolve_one(c, asset_id, chain, alias='stable'): for s in reversed(chain): row = c.execute( 'SELECT version FROM aliases WHERE id=? AND scope=? AND alias=?', (asset_id, s, alias)).fetchone() if row: return row[0], s for s in reversed(chain): row = c.execute( 'SELECT version FROM assets WHERE id=? AND scope=? ' 'ORDER BY created_at DESC LIMIT 1', (asset_id, s)).fetchone() if row: return row[0], s return None, None def resolve(c, root_id, tenant=None, project=None): chain = scope_chain(tenant, project) seen = set() out = [] stack = [root_id] while stack: aid = stack.pop() if aid in seen: continue seen.add(aid) ver, scope = resolve_one(c, aid, chain) if ver is None: out.append({'id': aid, 'version': None, 'scope': None, 'state': 'MISSING'}) continue row = c.execute( 'SELECT type, owner, eval_result, rollback_version, payload ' 'FROM assets WHERE id=? AND version=? AND scope=?', (aid, ver, scope)).fetchone() out.append({ 'id': aid, 'version': ver, 'scope': scope, 'type': row[0], 'owner': row[1], 'eval_result': json.loads(row[2]) if row[2] else None, 'rollback_version': row[3], 'payload': json.loads(row[4]), }) for d in c.execute( 'SELECT dep_id FROM deps WHERE id=? AND version=? AND scope=?', (aid, ver, scope)): stack.append(d[0]) return out def main(): p = argparse.ArgumentParser() sub = p.add_subparsers(dest='cmd', required=True) r = sub.add_parser('register') r.add_argument('--id', required=True) r.add_argument('--version', required=True) r.add_argument('--type', required=True) r.add_argument('--scope', required=True) r.add_argument('--owner', required=True) r.add_argument('--payload', default='{}') r.add_argument('--depends-on', action='append', default=[]) r.add_argument('--eval-result', default=None) r.add_argument('--rollback-version', default=None) a = sub.add_parser('alias') a.add_argument('--id', required=True) a.add_argument('--scope', required=True) a.add_argument('--alias', required=True) a.add_argument('--version', required=True) q = sub.add_parser('resolve') q.add_argument('--id', required=True) q.add_argument('--tenant') q.add_argument('--project') args = p.parse_args() c = conn() if args.cmd == 'register': register(c, { 'id': args.id, 'version': args.version, 'type': args.type, 'scope': args.scope, 'owner': args.owner, 'payload': json.loads(args.payload), 'depends_on': args.depends_on, 'eval_result': args.eval_result, 'rollback_version': args.rollback_version, }) print('registered %s@%s scope=%s' % (args.id, args.version, args.scope)) elif args.cmd == 'alias': c.execute('INSERT OR REPLACE INTO aliases (id, scope, alias, version) VALUES (?,?,?,?)', (args.id, args.scope, args.alias, args.version)) c.commit() print('alias %s scope=%s %s -> %s' % (args.id, args.scope, args.alias, args.version)) else: for item in resolve(c, args.id, args.tenant, args.project): print(json.dumps(item, ensure_ascii=False)) if __name__ == '__main__': main() ``` 注册几个资产,验证作用域覆盖: ```bash python registry.py register --id tool.order.query --version 1.0.0 --type Tool \ --scope global --owner fde-platform \ --payload '{"endpoint":"https://crm.internal/orders"}' \ --eval-result '{"suite":"tool.order.query.v1","pass":true}' python registry.py register --id rule.refund.window --version 1.0.0 --type Rule \ --scope global --owner fde-platform --payload '{"max_days":30}' \ --eval-result '{"suite":"rule.refund.window.v1","pass":true}' python registry.py register --id rule.refund.window --version 1.1.0 --type Rule \ --scope tenant:acme --owner fde-acme --payload '{"max_days":15}' \ --rollback-version 1.0.0 python registry.py register --id skill.refund.handle --version 2.0.0 --type Skill \ --scope global --owner fde-platform \ --depends-on tool.order.query --depends-on rule.refund.window python registry.py alias --id skill.refund.handle --scope global --alias stable --version 2.0.0 ``` 发起一次解析请求: ```bash python registry.py resolve --id skill.refund.handle --tenant acme --project cs-v2 ``` 未在当前环境实测,以下为预期结果。 注册阶段的示例输出: ```bash registered tool.order.query@1.0.0 scope=global registered rule.refund.window@1.0.0 scope=global registered rule.refund.window@1.1.0 scope=tenant:acme registered skill.refund.handle@2.0.0 scope=global alias skill.refund.handle scope=global stable -> 2.0.0 ``` 解析阶段的示例输出: ```json {"id": "skill.refund.handle", "version": "2.0.0", "scope": "global", "type": "Skill", "owner": "fde-platform", "eval_result": null, "rollback_version": null, "payload": {}} {"id": "rule.refund.window", "version": "1.1.0", "scope": "tenant:acme", "type": "Rule", "owner": "fde-acme", "eval_result": null, "rollback_version": "1.0.0", "payload": {"max_days": 15}} {"id": "tool.order.query", "version": "1.0.0", "scope": "global", "type": "Tool", "owner": "fde-platform", "eval_result": {"suite": "tool.order.query.v1", "pass": true}, "rollback_version": null, "payload": {"endpoint": "https://crm.internal/orders"}} ``` V1 跑通了:acme 租户解析到了自己的 15 天规则,其他租户仍然拿到 global 的 30 天规则。但它也留下了三颗雷——评测结果没有绑定版本,没有评测门禁,也没有依赖环检测。 > 先跑通一步 > 再暴露一坑 > 最小可验证 > 才好谈演进 # 06、排查 V1 上线第二天,客服侧就来反馈了。 **现象一**:acme 租户的客服在 16 天到 30 天之间的退款申请被自动通过了,按 acme 的规则本该转人工。 怀疑:数据是不是没写进去。检查方式:直接查库。 ```bash sqlite3 assets.db "select id, version, scope from assets where id='rule.refund.window';" ``` 证据: ```bash rule.refund.window|1.0.0|global rule.refund.window|1.1.0|tenant:acme ``` 数据在。再把解析清单打出来看,发现 `rule.refund.window` 解析出来的是 1.0.0 / global。 根因不在数据,在解析顺序。V1 的 `resolve` 是用栈做依赖遍历的,而作用域优先级在遍历过程中被“后写覆盖”了——本来应该是 project 覆盖 tenant、tenant 覆盖 global,实际执行时 global 的结果最后落到清单里,把 tenant 的覆盖掉了。 修复:把“选择版本”和“组装清单”分开。先按 chain 由低到高确定优先级,再按 id 去重保留最高优先级的结果。 **现象二**:把意图识别 Prompt 从 2.0.0 升级到 2.1.0 之后,看板上的评测状态仍然是“通过”。 怀疑:评测任务没跑。检查:查评测记录。 ```bash sqlite3 assets.db "select id, version, eval_result from assets where id like 'prompt.intent%';" ``` 证据:2.0.0 的 `eval_result` 是 `{"suite":"prompt.intent.v2","pass":true}`,2.1.0 的 `eval_result` 是 NULL。但看板读的是“这个 id 最近一次通过的结果”,而不是“这个版本的通过结果”,于是 2.1.0 继承了 2.0.0 的绿灯。 根因:评测结果绑定在资产 id 上,没有绑定到 (id, version)。这是资产治理里最常见的一个错觉——以为“这个能力评测过”,其实只是“它的某个历史版本评测过”。 修复:把评测结果拆到独立的 evals 表,主键带上 version,解析时只认当前版本的评测结果。 **错误尝试**:在这之前,我们试过一个更省事的方案——把所有资产集中写进一个 `assets.json`,用 Git 做版本管理。 为什么错:文件是打包单元,不是寻址单元。三个后果立刻出现:第一,每个项目都要读全量文件,diff 噪音大到没人愿意 review;第二,无法回答“acme 当前用的是哪个版本”;第三,无法按 scope 做权限和评审隔离。更麻烦的是并发写冲突——两个项目同时新增资产,合并冲突天天有。 正确方向不是“把文件合并”,而是“把资产拆成可寻址的记录”。 **现象三**:第三个项目接入时,`skill.logistics.delay` 的解析结果里 `tool.order.query` 指向了一个从未正式发布的版本。 怀疑:别名没生效。检查:查 aliases 表。 ```bash sqlite3 assets.db "select * from aliases;" ``` 证据:`tool.order.query` 在 global 下根本没有 stable 别名,`resolve_one` 静默回退到“最新注册的版本”。 根因:静默回退。V1 的设计里,取不到别名就用最新版,这个行为没有任何日志,也没写进装配清单。 修复:回退必须显式。要么在清单里标注 `resolved_by: fallback`,要么直接报错要求补别名。 > 先看数据 > 再看顺序 > 证据落纸 > 根因自现 # 07、优化 针对第 06 章的三条证据,V2 只做三件事,每件都对应一条根因。 第一件:评测结果从 assets 行里剥离,独立成 evals 表,按 (id, version) 绑定。 ```python EVALS_SCHEMA = ''' CREATE TABLE IF NOT EXISTS evals ( id TEXT NOT NULL, version TEXT NOT NULL, scope TEXT NOT NULL, suite TEXT NOT NULL, pass INTEGER NOT NULL, run_at TEXT DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (id, version, scope, suite) ); ''' def record_eval(c, asset_id, version, scope, suite, passed): c.execute( 'INSERT OR REPLACE INTO evals (id, version, scope, suite, pass) VALUES (?,?,?,?,?)', (asset_id, version, scope, suite, 1 if passed else 0)) c.commit() def eval_state(c, asset_id, version): row = c.execute( 'SELECT pass FROM evals WHERE id=? AND version=? ' 'ORDER BY run_at DESC LIMIT 1', (asset_id, version)).fetchone() if row is None: return 'UNKNOWN' return 'PASS' if row[0] == 1 else 'FAIL' ``` 为什么这样改:因为“通过”是版本属性,不是能力属性。一个新版本如果没有自己的评测记录,它的正确状态是 UNKNOWN,而不是继承上一个版本的 PASS。 新行为:`resolve` 出来的每一项都带 `eval_state`,UNKNOWN 和 FAIL 都会被显式暴露。 第二件:评测门禁。没有 PASS 的版本不允许进入 stable 别名。 ```python def promote(c, asset_id, scope, version, alias='stable'): state = eval_state(c, asset_id, version) if state != 'PASS': raise SystemExit('refuse to promote %s@%s: eval_state=%s' % (asset_id, version, state)) c.execute('INSERT OR REPLACE INTO aliases (id, scope, alias, version) VALUES (?,?,?,?)', (asset_id, scope, alias, version)) c.commit() ``` 第三件:显式回退、环检测与影响面。 ```python def resolve_one(c, asset_id, chain, alias='stable'): for s in reversed(chain): row = c.execute( 'SELECT version FROM aliases WHERE id=? AND scope=? AND alias=?', (asset_id, s, alias)).fetchone() if row: return row[0], s, 'alias' top = chain[-1] row = c.execute( 'SELECT version FROM assets WHERE id=? AND scope=? ' 'ORDER BY created_at DESC LIMIT 1', (asset_id, top)).fetchone() if row: return row[0], top, 'fallback' return None, None, 'missing' def find_cycle(edges): color, path = {}, [] def dfs(node): color[node] = 1 path.append(node) for nxt in edges.get(node, []): if color.get(nxt) == 1: return path[path.index(nxt):] + [nxt] if color.get(nxt, 0) == 0: found = dfs(nxt) if found: return found path.pop() color[node] = 2 return None for node in edges: if color.get(node, 0) == 0: found = dfs(node) if found: return found return None def impact(c, asset_id): rows = c.execute('SELECT DISTINCT id FROM deps WHERE dep_id=?', (asset_id,)).fetchall() return [r[0] for r in rows] ``` 验证方式(这里只描述方法,不编造数据):对同一个 `skill.refund.handle @ acme / cs-v2` 请求重复解析,检查三项——每一项是否带 `eval_state`;`rule.refund.window` 是否解析到 1.1.0;`resolved_by` 是否显式标出 alias 或 fallback。再用一个故意配成环的依赖(A 依赖 B、B 依赖 A)验证 `find_cycle` 能报出完整环路径。 这里的取舍要说清楚:门禁会让上线变慢,因为任何一次资产升级都要先跑评测。但这是可接受的成本——比起线上跑着一个没人评测过的 Prompt,慢一点是划算的。 > 评测绑版本 > 门禁挡风险 > 回退要显式 > 依赖须无环 # 08、演进 ```text [同一输入] resolve(skill.refund.handle, tenant=acme, project=cs-v2) | +--[V1] 按 id 找最新版 / 无评测门禁 / 静默回退 | 代价: 版本不可控, 灰度无法定位, 回滚靠猜 | +--[V2] 按 id@version 寻址 + 别名 + eval 门禁 + 环检测 + 影响面 | 代价: 需要维护评测集与别名流程, 接入有门槛 | [Trade-off] 得到: 变更可定位、可回滚、可审计, 第二第三个项目可直接引用 失去: 免治理的自由度, 上线速度会被评测流程拖慢 边界: 项目数 >= 2 或租户数 >= 2 才值得引入 ``` 正确性上,V1 依赖“最新版就是对的”这个假设,V2 把假设换成了显式证据。稳定性上,V1 的静默回退要到第三个项目接入时才暴露,V2 把这个失败模式提前到了解析阶段。 复杂度上,V2 多了一张 evals 表和一套别名流程,这是实打实的运维成本。成本上,主要成本不在机器,在人来维护 owner、评测集和版本策略。 适用范围要说清楚:单项目单租户的场景,V1 够用,甚至更划算;一旦进入多租户、多项目,V2 是下限而不是上限。 遗留问题有三个:第一,资产卡的字段还没有标准化,目前靠约定;第二,跨资产的评测集编排还没有做,Skill 的评测和 Rule 的评测是分开的;第三,语义层的作用域冲突(比如 Ontology 和 Rule 对“退款窗口”的定义不一致)还没有检测机制。 > 旧版靠假设 > 新版靠证据 > 取舍写在明 > 边界划在前 # 09、洞见 ## 9.1 资产的身份先于资产的抽象 这一篇最深的一条:我们一开始以为复用难是因为抽象做得不够好,后来发现是因为资产没有身份。`rule.refund.window` 和 `acme_rule_final_2` 的差别不在于命名美观,而在于前者可以被引用、被依赖、被评测、被回滚,后者只能被复制。 ## 9.2 复用的敌人不是技术复杂度,是作用域 反直觉判断:多租户场景下,把租户差异当作“特殊需求”去写 if-else,短期最快,长期最贵。作用域不是一个技术开关,它是一种资产组织方式——同一个 id,在不同 scope 下有不同的实现,解析时按优先级覆盖。这样租户差异是数据,不是代码分支。 ## 9.3 目录不是给人看的文档,是给运行时查的注册中心 反直觉判断:很多团队把“资产目录”做成了一个漂亮的文档页面,然后发现没人看。目录的价值不在于描述得有多全,而在于运行时能不能拿它做决策——解析、门禁、回滚、影响面分析,四件事都能跑在上面,它才是资产,否则它只是文档。 ## 9.4 eval_result 必须绑定版本,否则它只是一个装饰 第 06 章的现象二说明了这一点:新版本继承了旧版本的绿灯,这是最危险的一类错误,因为它不会报错,只会让一个没评测过的 Prompt 上线。评测结果的最小粒度是 (id, version),不是 id。 ## 9.5 回滚能力要在设计期就预留 `rollback_version` 这个字段看起来平平无奇,但它决定了出事时你是改一行数据,还是回滚一次发布。回滚能力和发布能力是同一件事的两面,设计资产表的时候没有它,出事时就要付出十倍代价。 > 先有身份 > 再谈复用 > 证据绑版本 > 回滚要预留 # 10、系统落地 回到贯穿案例。这套全球智能客服平台原来有什么?有第一个企业项目跑通的全套资产,但它们以文件形式散落在项目目录里;有一批能用的 Skill 和 Tool,但没有任何元数据;有一次不错的评测结果,但它绑在“能力”上而不是“版本”上。 这一篇新增了什么?一层资产注册与解析:Scenario、Skill、Prompt、Rule、Ontology、Knowledge、Workflow、Tool、Eval Dataset、Metric、Evidence Template、Model Config 全部纳入同一张资产表,每个资产带 id、version、scope、owner、dependency、eval_result 和 rollback_version;外面套一层作用域解析、依赖展开、环检测和评测门禁。 现在能做什么?第二个企业项目接入时,不再从 Prompt 开始重写,而是声明一条引用;acme 用 15 天退款窗口,beta 用 30 天,差异是数据不是代码。任何一次变更都能回答“影响哪些资产、能不能回滚”。 还缺什么?三件事:资产卡的字段标准还没有定死;跨资产的组合评测还没有编排;Ontology、Rule、Knowledge 之间的语义冲突还没有自动检测。 下一步怎么演进?把资产卡标准化成可生成的产物,评审时按卡片走;把评测从“单资产”升级成“场景级回归”,一次跑通 Scenario 下的全部依赖;再把作用域冲突检测接入解析器,让语义不一致在解析阶段暴露,而不是在客户投诉时暴露。 > 原来一堆文件 > 现在一张资产表 > 引用代替复制 > 差异变成数据 # 11、小结 ```text Q1 → 第二个项目为什么又要把第一个项目重做一遍? 因为没有 id 和 version 的能力无法被安全引用,复用只能退化成复制。 Q2 → 既然要复用,是共享运行实例还是共享可寻址资产? 共享可寻址资产:同一份能力在不同租户下按 scope 覆盖,差异是数据不是分支。 Q3 → 目录设计错了会怎样? 不会报错,只会让变更不可定位、回滚不可执行,在第三、第四个项目上耗尽团队。 状态 → 一套可运行的最小资产目录:注册、作用域解析、依赖展开、评测门禁、显式回退与影响面分析。 ``` > 身份定下来 > 版本沉下来 > 门禁立起来 > 复用才立得住 # 12、作业 ## 12.1 理解题:为什么 eval_result 必须绑定 (id, version),而不是绑定 id? 参考答案:因为“通过”是版本属性。绑定 id 会让新版本继承旧版本的绿灯,导致未评测的资产上线,而且不会产生任何报错。最小评测粒度是 (id, version),无记录时应返回 UNKNOWN 而不是 PASS。 ## 12.2 实战题:给你三个租户、两个项目和一份 global 的 Prompt,请写出它的作用域链和解析顺序。 参考答案:作用域链为 global → tenant:{t} → project:{t}/{p}。解析时从链尾向前找:先看 project 级别的别名,再看 tenant 级,最后看 global;找到即返回。找不到时不允许静默回退,必须在装配清单里显式标记 fallback,或者直接报错。 ## 12.3 排障题:解析出来的资产版本是对的,但线上行为不符合预期,可能的根因有哪些? 参考答案:优先排查三类。一是配置与代码的作用域不一致,比如 Rule 已被租户覆盖,但代码里还写死了默认值;二是评测结果与版本错配,导致未验证的版本上线;三是依赖图里的传递依赖被解析到了另一个租户的实现,比如 Skill 是 global 版本,但它依赖的 Tool 被 project 级覆盖。按“解析清单 → 依赖边 → 最终 payload”的顺序逐层比对。 ## 12.4 架构判断题:把资产目录做成一个 SQLite 单文件,还是做成一个带 API 的注册中心服务? 参考答案:看项目数和并发写。单项目、单人维护时,SQLite 单文件足够;一旦进入多项目、多租户,就需要注册中心服务,因为要解决并发写、权限隔离、审计和解析缓存问题。判断标准不是技术先进程度,而是“是否存在两个以上团队同时写同一份资产元数据”。 > 题不在多 > 在能否落地 > 答不在全 > 在能否验证 # 13、思考 这一篇的核心冲突是:第一个项目跑通之后,团队以为自己在积累能力,其实什么都没有沉淀下来——因为沉淀的前提是资产可被引用,而引用的前提是资产有身份。 工程判断有三条可以带走。 第一,身份优先于抽象。做能力复用之前,先给能力一个稳定的 id 和不可变的 version。没有这两样,所有的架构设计都会在第二次复制时失效。 第二,作用域优先于分支。多租户差异应该是数据,不是代码里的 if-else。作用域链加就近覆盖,让“全局默认 + 租户覆盖”成为默认能力。 第三,版本优先于能力。评测结果、回滚版本、依赖关系,都必须挂在具体版本上。挂在“能力”上的元数据,最终都会变成装饰。 这三条不解决“Agent 够不够聪明”的问题,它们解决的是“第二个企业项目还要不要重做一遍”的问题。而后者,往往才是 FDE 真正的时间黑洞。 > 一物一身份 > 一版一证据 > 一域一覆盖 > 一改一可回