首页 文章 精选 留言 我的

精选列表

搜索[超融合软件],共10000篇文章
优秀的个人博客,低调大师

定时任务最简单的3种实现方法(超好用)

这是我的第86篇原创文章 作者 | 王磊 来源 | Java中文社群(ID:javacn666) 转载请联系授权(微信ID:GG_Stone) 定时任务在实际的开发中特别常见,比如电商平台 30 分钟后自动取消未支付的订单,以及凌晨的数据汇总和备份等,都需要借助定时任务来实现,那么我们本文就来看一下定时任务最简单的几种实现方式。 TOP 1:Timer Timer 是 JDK 自带的定时任务执行类,无论任何项目都可以直接使用 Timer 来实现定时任务,所以 Timer 的优点就是使用方便,它的实现代码如下: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义一个任务TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);}} 程序执行结果如下: Run timerTask:Mon Aug 17 21:29:25 CST 2020 Run timerTask:Mon Aug 17 21:29:28 CST 2020 Run timerTask:Mon Aug 17 21:29:31 CST 2020 Timer 缺点分析 Timer 类实现定时任务虽然方便,但在使用时需要注意以下问题。 问题 1:任务执行时间长影响其他任务 当一个任务的执行时间过长时,会影响其他任务的调度,如下代码所示: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义任务1TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("进入 timerTask 1:"+newDate());try{//休眠5秒TimeUnit.SECONDS.sleep(5);}catch(InterruptedExceptione){e.printStackTrace();}System.out.println("Run timerTask 1:"+newDate());}};//定义任务2TimerTasktimerTask2=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask 2:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);timer.schedule(timerTask2,1000,3000);}} 程序执行结果如下: 进入 timerTask 1:Mon Aug 17 21:44:08 CST 2020 Run timerTask 1:Mon Aug 17 21:44:13 CST 2020 Run timerTask 2:Mon Aug 17 21:44:13 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:13 CST 2020 Run timerTask 1:Mon Aug 17 21:44:18 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:18 CST 2020 Run timerTask 1:Mon Aug 17 21:44:23 CST 2020 Run timerTask 2:Mon Aug 17 21:44:23 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:23 CST 2020 从上述结果中可以看出,当任务 1 运行时间超过设定的间隔时间时,任务 2 也会延迟执行。 原本任务 1 和任务 2 的执行时间间隔都是 3s,但因为任务 1 执行了 5s,因此任务 2 的执行时间间隔也变成了 10s(和原定时间不符)。 问题 2:任务异常影响其他任务 使用 Timer 类实现定时任务时,当一个任务抛出异常,其他任务也会终止运行,如下代码所示: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义任务1TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("进入 timerTask 1:"+newDate());//模拟异常intnum=8/0;System.out.println("Run timerTask 1:"+newDate());}};//定义任务2TimerTasktimerTask2=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask 2:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);timer.schedule(timerTask2,1000,3000);}} 程序执行结果如下: 进入 timerTask 1:Mon Aug 17 22:02:37 CST 2020 Exception in thread "Timer-0" java.lang.ArithmeticException: / by zero at com.example.MyTimerTask$1.run(MyTimerTask.java:21) at java.util.TimerThread.mainLoop(Timer.java:555) at java.util.TimerThread.run(Timer.java:505) Process finished with exit code 0 Timer 小结 Timer 类实现定时任务的优点是方便,因为它是 JDK 自定的定时任务,但缺点是任务如果执行时间太长或者是任务执行异常,会影响其他任务调度,所以在生产环境下建议谨慎使用。 TOP 2:ScheduledExecutorService ScheduledExecutorService 也是 JDK 1.5 自带的 API,我们可以使用它来实现定时任务的功能,也就是说 ScheduledExecutorService 可以实现 Timer 类具备的所有功能,并且它可以解决了 Timer 类存在的所有问题。 ScheduledExecutorService 实现定时任务的代码示例如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//10为线程数量//执行任务scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: Run Schedule:Mon Aug 17 21:44:23 CST 2020 Run Schedule:Mon Aug 17 21:44:26 CST 2020 Run Schedule:Mon Aug 17 21:44:29 CST 2020 ScheduledExecutorService 可靠性测试 ① 任务超时执行测试 ScheduledExecutorService 可以解决 Timer 任务之间相应影响的缺点,首先我们来测试一个任务执行时间过长,会不会对其他任务造成影响,测试代码如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//执行任务1scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("进入 Schedule:"+newDate());try{//休眠5秒TimeUnit.SECONDS.sleep(5);}catch(InterruptedExceptione){e.printStackTrace();}System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次//执行任务2scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule2:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: Run Schedule2:Mon Aug 17 11:27:55 CST 2020 进入 Schedule:Mon Aug 17 11:27:55 CST 2020 Run Schedule2:Mon Aug 17 11:27:58 CST 2020 Run Schedule:Mon Aug 17 11:28:00 CST 2020 进入 Schedule:Mon Aug 17 11:28:00 CST 2020 Run Schedule2:Mon Aug 17 11:28:01 CST 2020 Run Schedule2:Mon Aug 17 11:28:04 CST 2020 从上述结果可以看出,当任务 1 执行时间 5s 超过了执行频率 3s 时,并没有影响任务 2 的正常执行,因此使用 ScheduledExecutorService 可以避免任务执行时间过长对其他任务造成的影响。 ② 任务异常测试 接下来我们来测试一下 ScheduledExecutorService 在一个任务异常时,是否会对其他任务造成影响,测试代码如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//执行任务1scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("进入 Schedule:"+newDate());//模拟异常intnum=8/0;System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次//执行任务2scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule2:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: 进入 Schedule:Mon Aug 17 22:17:37 CST 2020 Run Schedule2:Mon Aug 17 22:17:37 CST 2020 Run Schedule2:Mon Aug 17 22:17:40 CST 2020 Run Schedule2:Mon Aug 17 22:17:43 CST 2020 从上述结果可以看出,当任务 1 出现异常时,并不会影响任务 2 的执行。 ScheduledExecutorService 小结 在单机生产环境下建议使用 ScheduledExecutorService 来执行定时任务,它是 JDK 1.5 之后自带的 API,因此使用起来也比较方便,并且使用 ScheduledExecutorService 来执行任务,不会造成任务间的相互影响。 TOP 3:Spring Task 如果使用的是 Spring 或 Spring Boot 框架,可以直接使用 Spring Framework 自带的定时任务,使用上面两种定时任务的实现方式,很难实现设定了具体时间的定时任务,比如当我们需要每周五来执行某项任务时,但如果使用 Spring Task 就可轻松的实现此需求。 以 Spring Boot 为例,实现定时任务只需两步: 开启定时任务; 添加定时任务。 具体实现步骤如下。 ① 开启定时任务 开启定时任务只需要在 Spring Boot 的启动类上声明 @EnableScheduling即可,实现代码如下: @SpringBootApplication@EnableScheduling//开启定时任务publicclassDemoApplication{//dosomeing} ② 添加定时任务 定时任务的添加只需要使用 @Scheduled注解标注即可,如果有多个定时任务可以创建多个 @Scheduled 注解标注的方法,示例代码如下: importorg.springframework.scheduling.annotation.Scheduled;importorg.springframework.stereotype.Component;@Component//把此类托管给Spring,不能省略publicclassTaskUtils{//添加定时任务@Scheduled(cron="595923005")//cron表达式,每周五23:59:59执行publicvoiddoTask(){System.out.println("我是定时任务~");}} 注意:定时任务是自动触发的无需手动干预,也就是说 Spring Boot 启动后会自动加载并执行定时任务。 Cron 表达式 Spring Task 的实现需要使用 cron 表达式来声明执行的频率和规则,cron 表达式是由 6 位或者 7 位组成的(最后一位可以省略),每位之间以空格分隔,每位从左到右代表的含义如下: 其中 * 和 ? 号都表示匹配所有的时间。 cron 表达式在线生成地址:https://cron.qqe2.com/ 知识扩展:分布式定时任务 上面的方法都是关于单机定时任务的实现,如果是分布式环境可以使用 Redis 来实现定时任务。 使用 Redis 实现延迟任务的方法大体可分为两类:通过 ZSet 的方式和键空间通知的方式。 ① ZSet 实现方式 通过 ZSet 实现定时任务的思路是,将定时任务存放到 ZSet 集合中,并且将过期时间存储到 ZSet 的 Score 字段中,然后通过一个无线循环来判断当前时间内是否有需要执行的定时任务,如果有则进行执行,具体实现代码如下: importredis.clients.jedis.Jedis;importutils.JedisUtils;importjava.time.Instant;importjava.util.Set;publicclassDelayQueueExample{//zsetkeyprivatestaticfinalString_KEY="myTaskQueue";publicstaticvoidmain(String[]args)throwsInterruptedException{Jedisjedis=JedisUtils.getJedis();//30s后执行longdelayTime=Instant.now().plusSeconds(30).getEpochSecond();jedis.zadd(_KEY,delayTime,"order_1");//继续添加测试数据jedis.zadd(_KEY,Instant.now().plusSeconds(2).getEpochSecond(),"order_2");jedis.zadd(_KEY,Instant.now().plusSeconds(2).getEpochSecond(),"order_3");jedis.zadd(_KEY,Instant.now().plusSeconds(7).getEpochSecond(),"order_4");jedis.zadd(_KEY,Instant.now().plusSeconds(10).getEpochSecond(),"order_5");//开启定时任务队列doDelayQueue(jedis);}/***定时任务队列消费*@paramjedisRedis客户端*/publicstaticvoiddoDelayQueue(Jedisjedis)throwsInterruptedException{while(true){//当前时间InstantnowInstant=Instant.now();longlastSecond=nowInstant.plusSeconds(-1).getEpochSecond();//上一秒时间longnowSecond=nowInstant.getEpochSecond();//查询当前时间的所有任务Set<String>data=jedis.zrangeByScore(_KEY,lastSecond,nowSecond);for(Stringitem:data){//消费任务System.out.println("消费:"+item);}//删除已经执行的任务jedis.zremrangeByScore(_KEY,lastSecond,nowSecond);Thread.sleep(1000);//每秒查询一次}}} ② 键空间通知 我们可以通过 Redis 的键空间通知来实现定时任务,它的实现思路是给所有的定时任务设置一个过期时间,等到了过期之后,我们通过订阅过期消息就能感知到定时任务需要被执行了,此时我们执行定时任务即可。 默认情况下 Redis 是不开启键空间通知的,需要我们通过 config set notify-keyspace-events Ex 的命令手动开启,开启之后定时任务的代码如下: importredis.clients.jedis.Jedis;importredis.clients.jedis.JedisPubSub;importutils.JedisUtils;publicclassTaskExample{publicstaticfinalString_TOPIC="__keyevent@0__:expired";//订阅频道名称publicstaticvoidmain(String[]args){Jedisjedis=JedisUtils.getJedis();//执行定时任务doTask(jedis);}/***订阅过期消息,执行定时任务*@paramjedisRedis客户端*/publicstaticvoiddoTask(Jedisjedis){//订阅过期消息jedis.psubscribe(newJedisPubSub(){@OverridepublicvoidonPMessage(Stringpattern,Stringchannel,Stringmessage){//接收到消息,执行定时任务System.out.println("收到消息:"+message);}},_TOPIC);}} 更多关于定时任务的实现,请点击《史上最全的延迟任务实现方式汇总!附代码》。 往期推荐 史上最全的延迟任务实现方式汇总!附代码(强烈推荐) 磊哥最近面试了好多人,聊聊我的感受!(附面试知识点) 关注下方二维码,查看更多干货! 本文分享自微信公众号 - Java中文社群(javacn666)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。


优秀的个人博客,低调大师

超简单的神经网络构建方法,你上你也行!

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 人工智能,深度学习,这些词是不是听起来就很高大上,充满了神秘气息?仿佛是只对数学博士开放的高级领域? 错啦!在B站已经变成学习网站的今天,还有什么样的教程是网上找不到的呢?深度学习从未如此好上手,至少实操部分是这样。 假如你只是了解人工神经网络基础理论,却从未踏足如何编写,跟着本文一起试试吧。你将会对如何在PyTorch 库中执行人工神经网络运算,以预测原先未见的数据有一个基本的了解。 这篇文章最多10分钟就能读完;如果要跟着代码一步步操作的话,只要已经安装了必要的库,那么也只需15分钟。相信我,它并不难。 长话短说,快开始吧! 导入语句和数据集 在这个简单的范例中将用到几个库: Pandas:用于数据加载和处理 Matplotlib: 用于数据可视化处理 PyTorch: 用于模型训练 Scikit-learn: 用于拆分训练集和测试集 如果仅仅是想复制粘贴的话,以下几条导入语句可供参考: import torch import torch.nn as nn import torch.nn.functional as F import pandas as pd import matplotlib.pyplot as plt from sklearn.model_selection import train_test_split 至于数据集,Iris数据集可以在这个URL上找到。下面演示如何把它直接导入 Pandas: iris = pd.read_csv( https://raw.githubusercontent.com/pandas-dev/pandas/master/pandas/tests/data/iris.csv ) iris.head() 前几行如下图所示: 现在需要将 Name列中鸢尾花的品种名称更改或者重映射为分类值。——也就是0、1、2。以下是步骤说明: mappings = { Iris-setosa : 0, Iris-versicolor : 1, Iris-virginica : 2 }iris[ Name ] = iris[ Name ].apply(lambda x: mappings[x]) 执行上述代码得到的DataFrame如下: 这恭喜你,你已经成功地迈出了第一步! 拆分训练集和测试集 在此环节,将使用 Scikit-Learn库拆分训练集和测试集。随后, 将拆分过的数据由 Numpy arrays 转换为PyTorchtensors。 首先,需要将Iris 数据集划分为“特征”和“ 标签集” ——或者是x和y。Name列是因变量而其余的则是“特征”(或者说是自变量)。 接下来笔者也将使用随机种子,所以可以直接复制下面的结果。代码如下: X = iris.drop( Name , axis=1).values y = iris[ Name ].valuesX_train, X_test, y_train, y_test = train_test_split(X,y, test_size=0.2, random_state=42)X_train = torch.FloatTensor(X_train) X_test = torch.FloatTensor(X_test) y_train = torch.LongTensor(y_train) y_test = torch.LongTensor(y_test) 如果从 X_train 开始检查前三行,会得到如下结果: 从 y_train开始则得到如下结果: 地基已经打好,下一环节将正式开始搭建神经网络。 定义神经网络模型 模型的架构很简单。重头戏在于神经网络的架构: 1.输入层 (4个输入特征(即X所含特征的数量),16个输出特征(随机))2.全连接层 (16个输入特征(即输入层中输出特征的数量),12个输出特征(随机))3.输出层(12个输入特征(即全连接层中输出特征的数量),3个输出特征(即不同品种的数量) 大致就是这样。除此之外还将使用ReLU 作为激活函数。下面展示如何在代码里执行这个激活函数。 class ANN(nn.Module): def __init__(self): super().__init__() self.fc1 =nn.Linear(in_features=4, out_features=16) self.fc2 =nn.Linear(in_features=16, out_features=12) self.output =nn.Linear(in_features=12, out_features=3) def forward(self, x): x = F.relu(self.fc1(x)) x = F.relu(self.fc2(x)) x = self.output(x) return x PyTorch使用的面向对象声明模型的方式非常直观。在构造函数中,需定义所有层及其架构,若使用forward(),则需定义正向传播。 接着创建一个模型实例,并验证其架构是否与上文所指的架构相匹配: model = ANN() model 在训练模型之前,需注明以下几点: 评价标准:主要使用 CrossEntropyLoss来计算损失 优化器:使用学习率为0.01的Adam 优化算法 下面展示如何在代码中执行CrossEntropyLoss和Adam : criterion = nn.CrossEntropyLoss() optimizer = torch.optim.Adam(model.parameters(), lr=0.01) 令人期盼已久的环节终于来啦——模型训练! 模型训练 这部分同样相当简单。模型训练将进行100轮, 持续追踪时间和损失。每10轮就向控制台输出一次当前状态——以指出目前所处的轮次和当前的损失。 代码如下: %%timeepochs = 100 loss_arr = []for i in range(epochs): y_hat = model.forward(X_train) loss = criterion(y_hat, y_train) loss_arr.append(loss) if i % 10 == 0: print(f Epoch: {i} Loss: {loss} ) optimizer.zero_grad() loss.backward() optimizer.step() 好奇最后三行是干嘛用的吗?答案很简单——反向传播——权重和偏置的更新使模型能真正地“学习”。 以下是上述代码的运行结果: 进度很快——但不要掉以轻心。 如果对纯数字真的不感冒,下图是损失曲线的可视化图(x轴为轮次编号,y轴为损失): 模型已经训练完毕,现在该干嘛呢?当然是模型评估。需要以某种方式在原先未见的数据上对这个模型进行评估。 模型评估 在评估过程中,欲以某种方式持续追踪模型做出的预测。需要迭代 X_test并进行预测,然后将预测结果与实际值进行比较。 这里将使用 torch.no_grad(),因为只是评估而已——无需更新权重和偏置。 总而言之,代码如下: preds = []with torch.no_grad(): for val in X_test: y_hat = model.forward(val) preds.append(y_hat.argmax().item()) 现在预测结果被存储在 preds阵列。可以用下列三个值构建一个Pandas DataFrame。 Y:实际值 YHat: 预测值 Correct:对角线,对角线的值为1表示Y和YHat相匹配,值为0则表示不匹配 代码如下: df = pd.DataFrame({ Y : y_test, YHat :preds})df[ Correct ] = [1 if corr == pred else 0 for corr, pred in zip(df[ Y ],df[ YHat ])] df 的前五行如下图所示: 下一个问题是,实际该如何计算精确度呢? 很简单——只需计算 Correct列的和再除以 df的长度: df[ Correct ].sum() / len(df)>>> 1.0 此模型对原先未见数据的准确率为100%。但需注意这完全是因为Iris数据集非常易于归类,并不意味着对于Iris数据集来说,神经网络就是最好的算法。NN对于这类问题来讲有点大材小用,不过这都是以后讨论的话题了。 这可能是你写过最简单的神经网络,有着完美简洁的数据集、没有缺失值、层次最少、还有神经元!本文没有什么高级深奥的东西,相信你一定能够掌握它。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-05-11本文作者:读芯术本文来自:“读芯术公众号”,了解相关信息可以关注“读芯术”

优秀的个人博客,低调大师

超炫酷的 Docker 终端 UI lazydocker,想看哪里点哪里

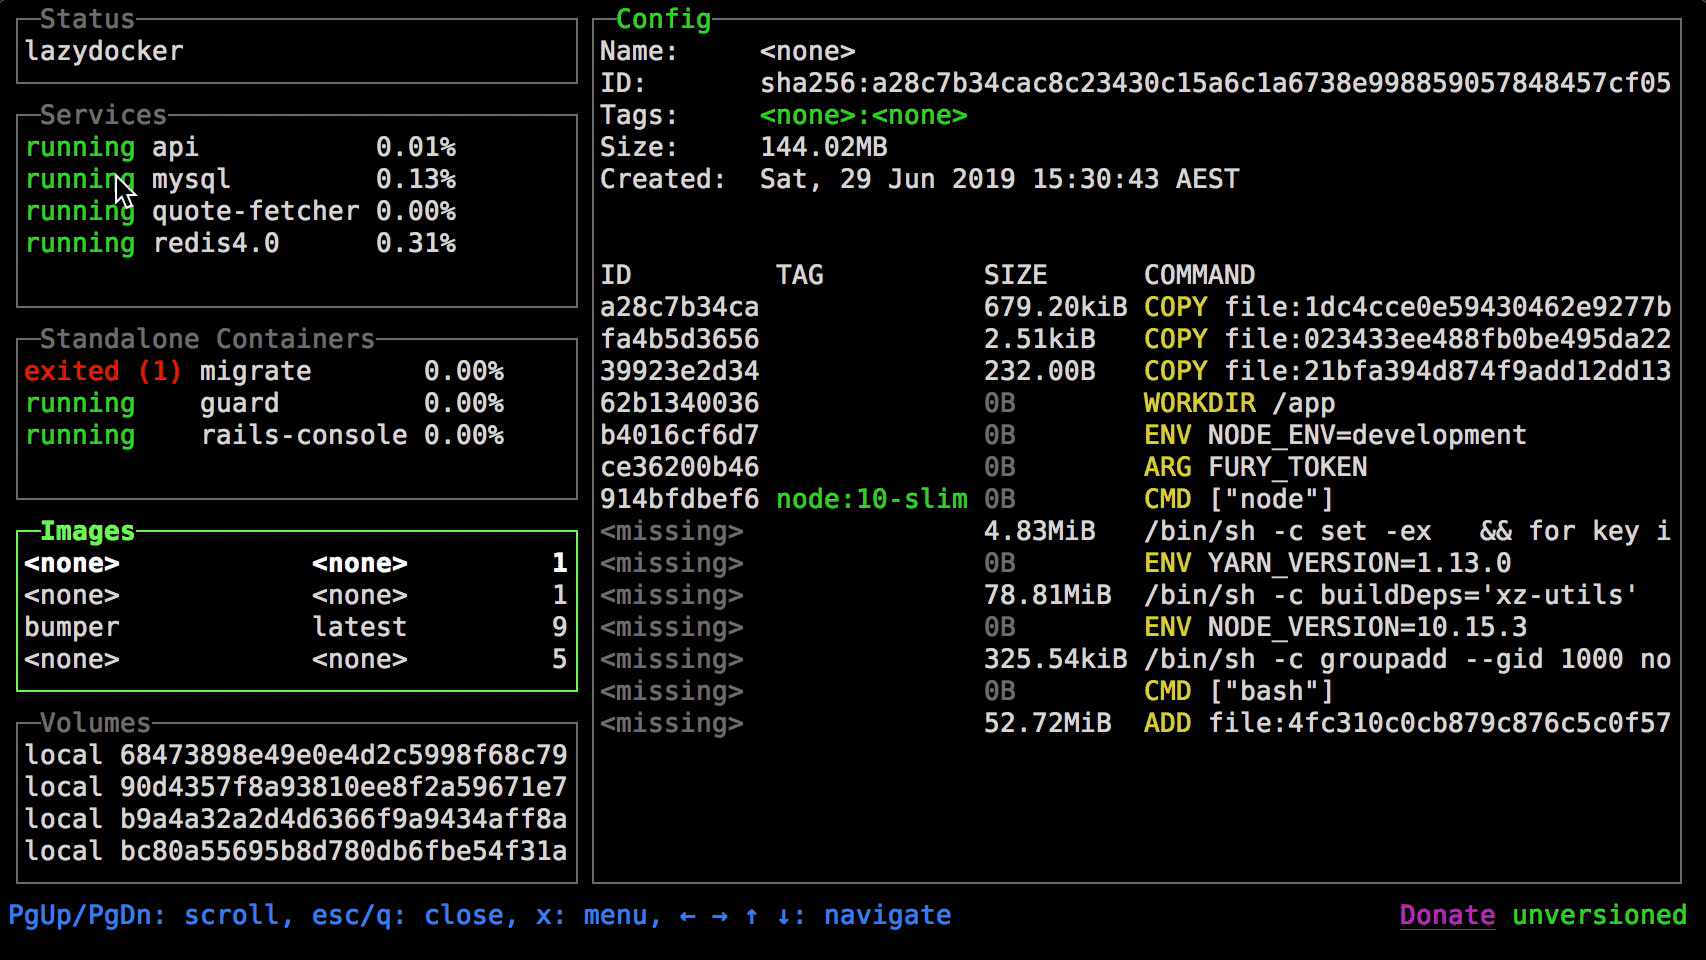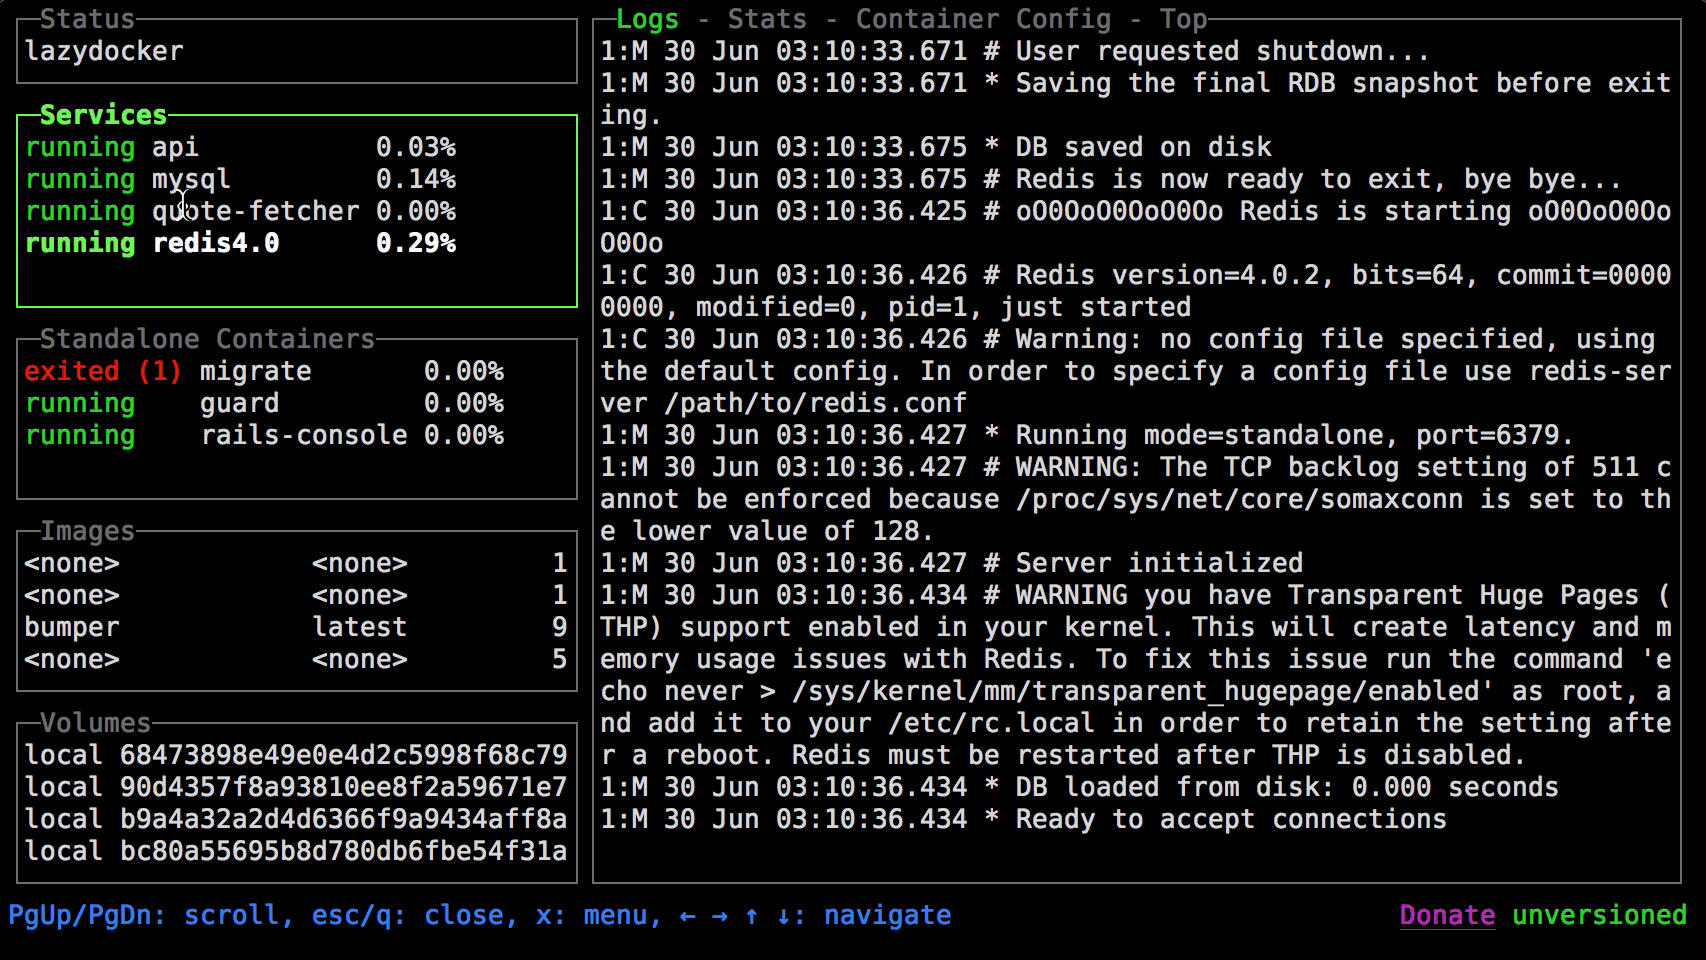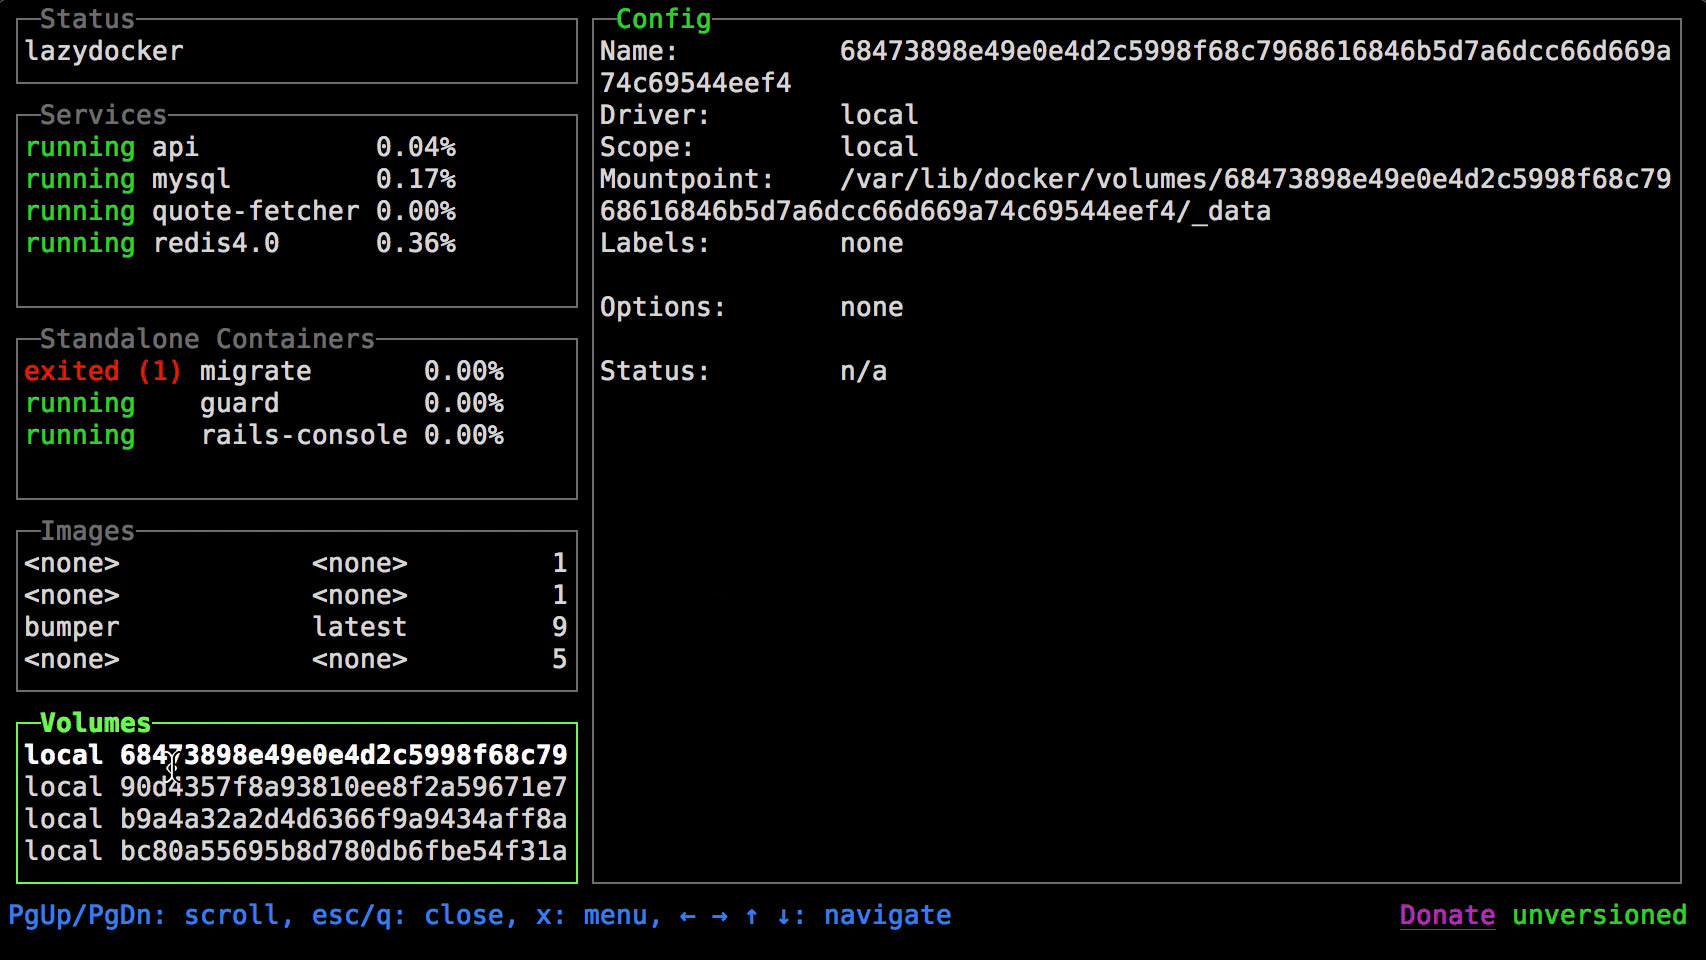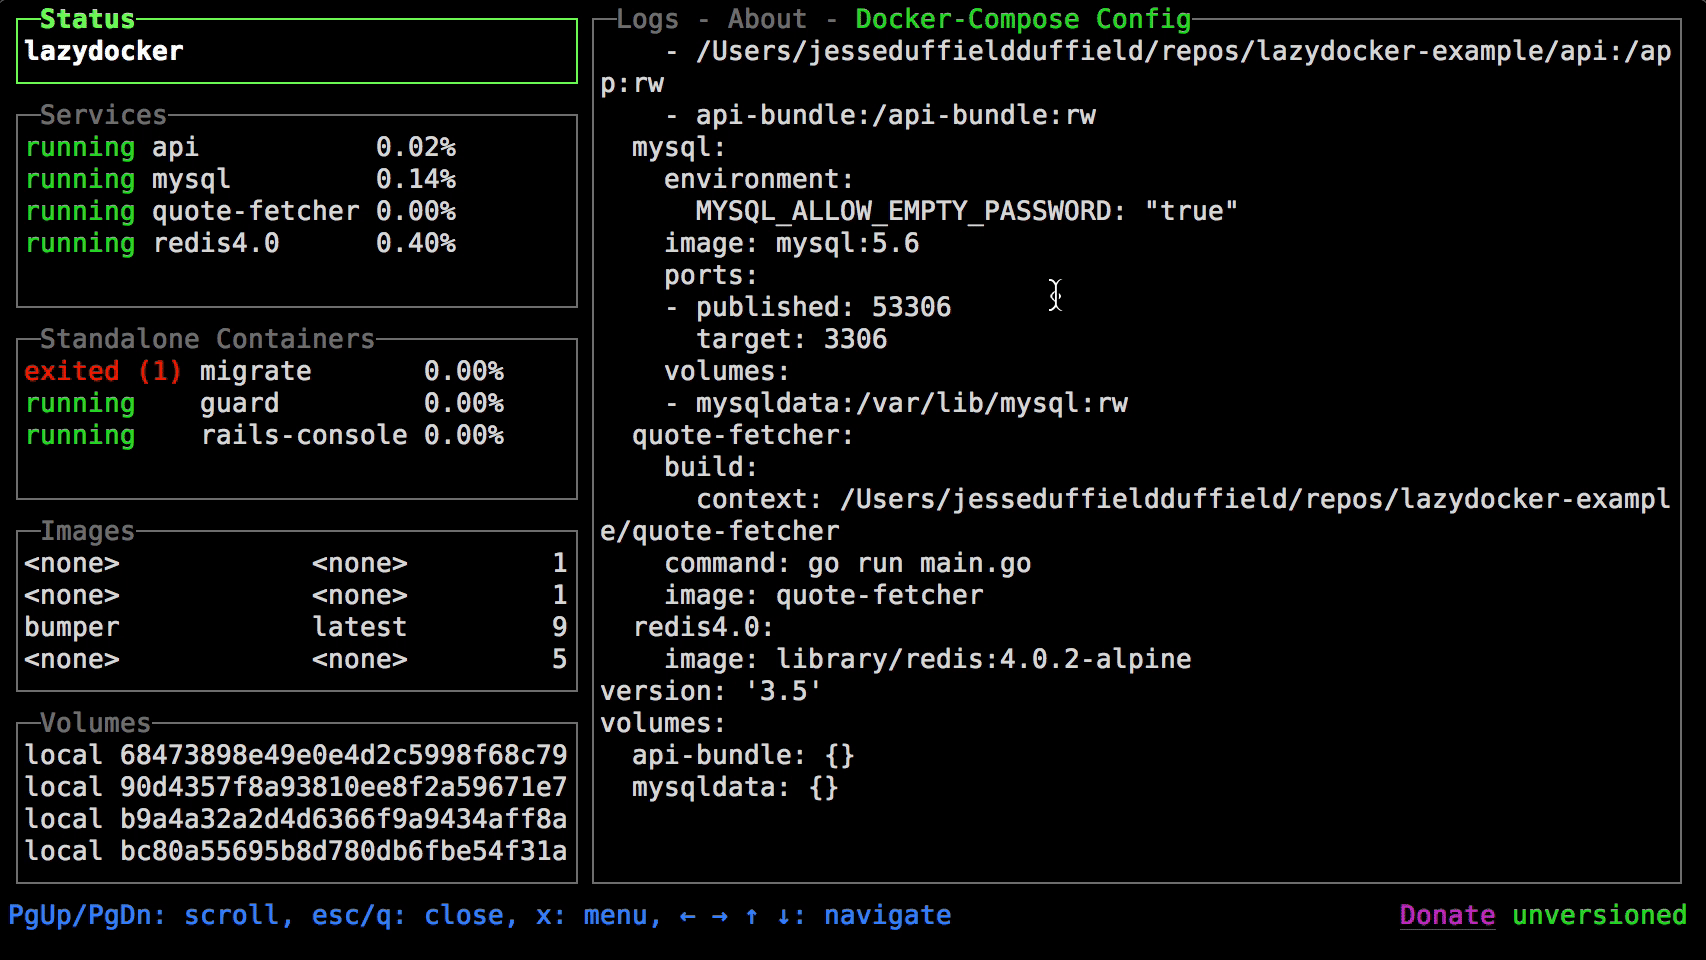
有开发者开源了一个用于 Docker 和 docker-compose 的简单终端 UI —— lazydocker,才短短几天目前已经收获了 2k+ star。 作者表示记住 Docker 命令很难,并且在多个终端窗口中跟踪容器几乎是不可能的,lazydocker 正是为了解决这种问题而产生的,它可以在一个终端窗口中拥有所需的所有信息,并且每个 Docker 常用命令都可以绑定快捷键,同时可以添加自定义命令。一切都只需如上图一样一键敲击键盘或单击鼠标。 lazydocker 基于gocui 库,环境需要 Go 1.12 版本,在终端中调用命令如: echo "alias ld='lazydocker'" >> ~/.zshrc lazydocker 的具体特性如下: 全视野查看 Docker 或 docker-compose 容器环境的状态 查看容器或服务的日志 查看容器指标的 ascii 图表,这样你会更像个开发者 自定义图表以测量不同指标 附加到容器/服务 重启、删除与重新构建容器/服务 查看给定镜像的祖先图层 修剪占用磁盘空间的容器、镜像或卷 详情查看: https://github.com/jesseduffield/lazydocker

优秀的个人博客,低调大师

超实用的 Nginx 极简教程,覆盖了常用场景

概述 什么是 Nginx? Nginx (engine x)是一款轻量级的 Web 服务器 、反向代理服务器及电子邮件(IMAP/POP3)代理服务器。 什么是反向代理? 反向代理(Reverse Proxy)方式是指以代理服务器来接受 internet 上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给 internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。 安装与使用 安装 详细安装方法请参考:Nginx 安装 使用 nginx 的使用比较简单,就是几条命令。 常用到的命令如下: nginx -s stop 快速关闭Nginx,可能不保存相关信息,并迅速终止web服务。 nginx -s quit 平稳关闭Nginx,保存相关信息,有安排的结束web服务。 nginx -s reload 因改变了Nginx相关配置,需要重新加载配置而重载。 nginx -s reopen 重新打开日志文件。 nginx -c filename 为 Nginx 指定一个配置文件,来代替缺省的。 nginx -t 不运行,而仅仅测试配置文件。nginx 将检查配置文件的语法的正确性,并尝试打开配置文件中所引用到的文件。 nginx -v 显示 nginx 的版本。 nginx -V 显示 nginx 的版本,编译器版本和配置参数。 如果不想每次都敲命令,可以在 nginx 安装目录下新添一个启动批处理文件startup.bat,双击即可运行。内容如下: @echo off rem 如果启动前已经启动nginx并记录下pid文件,会kill指定进程 nginx.exe -s stop rem 测试配置文件语法正确性 nginx.exe -t -c conf/nginx.conf rem 显示版本信息 nginx.exe -v rem 按照指定配置去启动nginx nginx.exe -c conf/nginx.conf 如果是运行在 Linux 下,写一个 shell 脚本,大同小异。 nginx 配置实战 我始终认为,各种开发工具的配置还是结合实战来讲述,会让人更易理解。 http 反向代理配置 我们先实现一个小目标:不考虑复杂的配置,仅仅是完成一个 http 反向代理。 nginx.conf 配置文件如下:注:conf / nginx.conf 是 nginx 的默认配置文件。你也可以使用 nginx -c 指定你的配置文件 #运行用户 #user somebody; #启动进程,通常设置成和cpu的数量相等 worker_processes 1; #全局错误日志 error_log D:/Tools/nginx-1.10.1/logs/error.log; error_log D:/Tools/nginx-1.10.1/logs/notice.log notice; error_log D:/Tools/nginx-1.10.1/logs/info.log info; #PID文件,记录当前启动的nginx的进程ID pid D:/Tools/nginx-1.10.1/logs/nginx.pid; #工作模式及连接数上限 events { worker_connections 1024; #单个后台worker process进程的最大并发链接数 } #设定http服务器,利用它的反向代理功能提供负载均衡支持 http { #设定mime类型(邮件支持类型),类型由mime.types文件定义 include D:/Tools/nginx-1.10.1/conf/mime.types; default_type application/octet-stream; #设定日志 log_format main '[$remote_addr] - [$remote_user] [$time_local] "$request" ' '$status $body_bytes_sent "$http_referer" ' '"$http_user_agent" "$http_x_forwarded_for"'; access_log D:/Tools/nginx-1.10.1/logs/access.log main; rewrite_log on; #sendfile 指令指定 nginx 是否调用 sendfile 函数(zero copy 方式)来输出文件,对于普通应用, #必须设为 on,如果用来进行下载等应用磁盘IO重负载应用,可设置为 off,以平衡磁盘与网络I/O处理速度,降低系统的uptime. sendfile on; #tcp_nopush on; #连接超时时间 keepalive_timeout 120; tcp_nodelay on; #gzip压缩开关 #gzip on; #设定实际的服务器列表 upstream zp_server1{ server 127.0.0.1:8089; } #HTTP服务器 server { #监听80端口,80端口是知名端口号,用于HTTP协议 listen 80; #定义使用www.xx.com访问 server_name www.helloworld.com; #首页 index index.html #指向webapp的目录 root D:\01_Workspace\Project\github\zp\SpringNotes\spring-security\spring-shiro\src\main\webapp; #编码格式 charset utf-8; #代理配置参数 proxy_connect_timeout 180; proxy_send_timeout 180; proxy_read_timeout 180; proxy_set_header Host $host; proxy_set_header X-Forwarder-For $remote_addr; #反向代理的路径(和upstream绑定),location 后面设置映射的路径 location / { proxy_pass http://zp_server1; } #静态文件,nginx自己处理 location ~ ^/(images|javascript|js|css|flash|media|static)/ { root D:\01_Workspace\Project\github\zp\SpringNotes\spring-security\spring-shiro\src\main\webapp\views; #过期30天,静态文件不怎么更新,过期可以设大一点,如果频繁更新,则可以设置得小一点。 expires 30d; } #设定查看Nginx状态的地址 location /NginxStatus { stub_status on; access_log on; auth_basic "NginxStatus"; auth_basic_user_file conf/htpasswd; } #禁止访问 .htxxx 文件 location ~ /\.ht { deny all; } #错误处理页面(可选择性配置) #error_page 404 /404.html; #error_page 500 502 503 504 /50x.html; #location = /50x.html { # root html; #} } } 好了,让我们来试试吧: 启动 webapp,注意启动绑定的端口要和 nginx 中的upstream设置的端口保持一致。 更改 host:在 C:\Windows\System32\drivers\etc 目录下的 host 文件中添加一条 DNS 记录 127.0.0.1 www.helloworld.com 启动前文中 startup.bat 的命令 在浏览器中访问www.helloworld.com,不出意外,已经可以访问了。 负载均衡配置 上一个例子中,代理仅仅指向一个服务器。 但是,网站在实际运营过程中,多半都是有多台服务器运行着同样的 app,这时需要使用负载均衡来分流。 nginx 也可以实现简单的负载均衡功能。 假设这样一个应用场景:将应用部署在 192.168.1.11:80、192.168.1.12:80、192.168.1.13:80 三台 linux 环境的服务器上。网站域名叫www.helloworld.com,公网IP 为 192.168.1.11。在公网 IP 所在的服务器上部署 nginx,对所有请求做负载均衡处理。 nginx.conf 配置如下: http { #设定mime类型,类型由mime.type文件定义 include /etc/nginx/mime.types; default_type application/octet-stream; #设定日志格式 access_log /var/log/nginx/access.log; #设定负载均衡的服务器列表 upstream load_balance_server { #weigth参数表示权值,权值越高被分配到的几率越大 server 192.168.1.11:80 weight=5; server 192.168.1.12:80 weight=1; server 192.168.1.13:80 weight=6; } #HTTP服务器 server { #侦听80端口 listen 80; #定义使用www.xx.com访问 server_name www.helloworld.com; #对所有请求进行负载均衡请求 location / { root /root; #定义服务器的默认网站根目录位置 index index.html index.htm; #定义首页索引文件的名称 proxy_pass http://load_balance_server ;#请求转向load_balance_server 定义的服务器列表 #以下是一些反向代理的配置(可选择性配置) #proxy_redirect off; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; #后端的Web服务器可以通过X-Forwarded-For获取用户真实IP proxy_set_header X-Forwarded-For $remote_addr; proxy_connect_timeout 90; #nginx跟后端服务器连接超时时间(代理连接超时) proxy_send_timeout 90; #后端服务器数据回传时间(代理发送超时) proxy_read_timeout 90; #连接成功后,后端服务器响应时间(代理接收超时) proxy_buffer_size 4k; #设置代理服务器(nginx)保存用户头信息的缓冲区大小 proxy_buffers 4 32k; #proxy_buffers缓冲区,网页平均在32k以下的话,这样设置 proxy_busy_buffers_size 64k; #高负荷下缓冲大小(proxy_buffers*2) proxy_temp_file_write_size 64k; #设定缓存文件夹大小,大于这个值,将从upstream服务器传 client_max_body_size 10m; #允许客户端请求的最大单文件字节数 client_body_buffer_size 128k; #缓冲区代理缓冲用户端请求的最大字节数 } } } 网站有多个 webapp 的配置 当一个网站功能越来越丰富时,往往需要将一些功能相对独立的模块剥离出来,独立维护。这样的话,通常,会有多个 webapp。 举个例子:假如www.helloworld.com站点有好几个 webapp,finance(金融)、product(产品)、admin(用户中心)。访问这些应用的方式通过上下文(context)来进行区分: www.helloworld.com/finance/ www.helloworld.com/product/ www.helloworld.com/admin/ 我们知道,http 的默认端口号是 80,如果在一台服务器上同时启动这 3 个 webapp 应用,都用 80 端口,肯定是不成的。所以,这三个应用需要分别绑定不同的端口号。 那么,问题来了,用户在实际访问www.helloworld.com站点时,访问不同 webapp,总不会还带着对应的端口号去访问吧。所以,你再次需要用到反向代理来做处理。 配置也不难,来看看怎么做吧: http { #此处省略一些基本配置 upstream product_server{ server www.helloworld.com:8081; } upstream admin_server{ server www.helloworld.com:8082; } upstream finance_server{ server www.helloworld.com:8083; } server { #此处省略一些基本配置 #默认指向product的server location / { proxy_pass http://product_server; } location /product/{ proxy_pass http://product_server; } location /admin/ { proxy_pass http://admin_server; } location /finance/ { proxy_pass http://finance_server; } } } https 反向代理配置 一些对安全性要求比较高的站点,可能会使用 HTTPS(一种使用 ssl 通信标准的安全 HTTP 协议)。 这里不科普 HTTP 协议和 SSL 标准。但是,使用 nginx 配置 https 需要知道几点: HTTPS 的固定端口号是 443,不同于 HTTP 的 80 端口 SSL 标准需要引入安全证书,所以在 nginx.conf 中你需要指定证书和它对应的 key 其他和 http 反向代理基本一样,只是在Server部分配置有些不同。 #HTTP服务器 server { #监听443端口。443为知名端口号,主要用于HTTPS协议 listen 443 ssl; #定义使用www.xx.com访问 server_name www.helloworld.com; #ssl证书文件位置(常见证书文件格式为:crt/pem) ssl_certificate cert.pem; #ssl证书key位置 ssl_certificate_key cert.key; #ssl配置参数(选择性配置) ssl_session_cache shared:SSL:1m; ssl_session_timeout 5m; #数字签名,此处使用MD5 ssl_ciphers HIGH:!aNULL:!MD5; ssl_prefer_server_ciphers on; location / { root /root; index index.html index.htm; } } 静态站点配置 有时候,我们需要配置静态站点(即 html 文件和一堆静态资源)。 举例来说:如果所有的静态资源都放在了/app/dist目录下,我们只需要在nginx.conf中指定首页以及这个站点的 host 即可。 配置如下: worker_processes 1; events { worker_connections 1024; } http { include mime.types; default_type application/octet-stream; sendfile on; keepalive_timeout 65; gzip on; gzip_types text/plain application/x-javascript text/css application/xml text/javascript application/javascript image/jpeg image/gif image/png; gzip_vary on; server { listen 80; server_name static.zp.cn; location / { root /app/dist; index index.html; #转发任何请求到 index.html } } } 然后,添加 HOST: 127.0.0.1 static.zp.cn 此时,在本地浏览器访问 static.zp.cn ,就可以访问静态站点了。 搭建文件服务器 有时候,团队需要归档一些数据或资料,那么文件服务器必不可少。使用 Nginx 可以非常快速便捷的搭建一个简易的文件服务。 Nginx 中的配置要点: 将 autoindex 开启可以显示目录,默认不开启。 将 autoindex_exact_size 开启可以显示文件的大小。 将 autoindex_localtime 开启可以显示文件的修改时间。 root 用来设置开放为文件服务的根路径。 charset 设置为charset utf-8,gbk;,可以避免中文乱码问题(windows 服务器下设置后,依然乱码,本人暂时没有找到解决方法)。 一个最简化的配置如下: autoindex on;# 显示目录 autoindex_exact_size on;# 显示文件大小 autoindex_localtime on;# 显示文件时间 server { charset utf-8,gbk; # windows 服务器下设置后,依然乱码,暂时无解 listen 9050 default_server; listen [::]:9050 default_server; server_name _; root /share/fs; } 跨域解决方案 web 领域开发中,经常采用前后端分离模式。这种模式下,前端和后端分别是独立的 web 应用程序,例如:后端是 Java 程序,前端是 React 或 Vue 应用。 各自独立的 web app 在互相访问时,势必存在跨域问题。解决跨域问题一般有两种思路: CORS 在后端服务器设置 HTTP 响应头,把你需要运行访问的域名加入加入Access-Control-Allow-Origin中。 jsonp 把后端根据请求,构造 json 数据,并返回,前端用 jsonp 跨域。 这两种思路,本文不展开讨论。 需要说明的是,nginx 根据第一种思路,也提供了一种解决跨域的解决方案。 举例:www.helloworld.com网站是由一个前端 app ,一个后端 app 组成的。前端端口号为 9000, 后端端口号为 8080。 前端和后端如果使用 http 进行交互时,请求会被拒绝,因为存在跨域问题。来看看,nginx 是怎么解决的吧: 首先,在 enable-cors.conf 文件中设置 cors : # allow origin list set $ACAO '*'; # set single origin if ($http_origin ~* (www.helloworld.com)$) { set $ACAO $http_origin; } if ($cors = "trueget") { add_header 'Access-Control-Allow-Origin' "$http_origin"; add_header 'Access-Control-Allow-Credentials' 'true'; add_header 'Access-Control-Allow-Methods' 'GET, POST, OPTIONS'; add_header 'Access-Control-Allow-Headers' 'DNT,X-Mx-ReqToken,Keep-Alive,User-Agent,X-Requested-With,If-Modified-Since,Cache-Control,Content-Type'; } if ($request_method = 'OPTIONS') { set $cors "${cors}options"; } if ($request_method = 'GET') { set $cors "${cors}get"; } if ($request_method = 'POST') { set $cors "${cors}post"; } 接下来,在你的服务器中include enable-cors.conf来引入跨域配置: # ---------------------------------------------------- # 此文件为项目 nginx 配置片段 # 可以直接在 nginx config 中 include(推荐) # 或者 copy 到现有 nginx 中,自行配置 # www.helloworld.com 域名需配合 dns hosts 进行配置 # 其中,api 开启了 cors,需配合本目录下另一份配置文件 # ---------------------------------------------------- upstream front_server{ server www.helloworld.com:9000; } upstream api_server{ server www.helloworld.com:8080; } server { listen 80; server_name www.helloworld.com; location ~ ^/api/ { include enable-cors.conf; proxy_pass http://api_server; rewrite "^/api/(.*)$" /$1 break; } location ~ ^/ { proxy_pass http://front_server; } } 到此,就完成了。 免费Java资料领取,涵盖了Java、Redis、MongoDB、MySQL、Zookeeper、Spring Cloud、Dubbo/Kafka、Hadoop、Hbase、Flink等高并发分布式、大数据、机器学习等技术。 传送门:https://mp.weixin.qq.com/s/JzddfH-7yNudmkjT0IRL8Q

优秀的个人博客,低调大师

超详细 Nginx 极简教程,傻瓜一看也会!

什么是Nginx? Nginx (engine x) 是一款轻量级的Web 服务器 、反向代理服务器及电子邮件(IMAP/POP3)代理服务器。 什么是反向代理? 反向代理(Reverse Proxy)方式是指以代理服务器来接受internet上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给internet上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。 安装与使用 安装 nginx官网下载地址:http://nginx.org,发布版本分为 Linux 和 windows 版本。 也可以下载源码,编译后运行。 从源代码编译 Nginx 把源码解压缩之后,在终端里运行如下命令: 默认情况下,Nginx 会被安装在 /usr/local/nginx。通过设定编译选项,你可以改变这个设定。 Windows 安装 为了安装 Nginx / Win32,需先下载它。然后解压之,然后运行即可。下面以 C 盘根目录为例说明下: Nginx / Win32 是运行在一个控制台程序,而非 windows 服务方式的。服务器方式目前还是开发尝试中。 使用 nginx 的使用比较简单,就是几条命令。 常用到的命令如下: nginx -s stop :快速关闭Nginx,可能不保存相关信息,并迅速终止web服务。 nginx -s quit :平稳关闭Nginx,保存相关信息,有安排的结束web服务。 nginx -s reload :因改变了Nginx相关配置,需要重新加载配置而重载。 nginx -s reopen :重新打开日志文件。 nginx -c filename :为 Nginx 指定一个配置文件,来代替缺省的。 nginx -t :不运行,而仅仅测试配置文件。nginx 将检查配置文件的语法的正确性,并尝试打开配置文件中所引用到的文件。 nginx -v:显示 nginx 的版本。 nginx -V:显示 nginx 的版本,编译器版本和配置参数。 如果不想每次都敲命令,可以在nginx安装目录下新添一个启动批处理文件startup.bat,双击即可运行。内容如下: 如果是运行在 Linux 下,写一个 shell 脚本,大同小异。 nginx 配置实战 我始终认为,各种开发工具的配置还是结合实战来讲述,会让人更易理解。 http反向代理配置 我们先实现一个小目标:不考虑复杂的配置,仅仅是完成一个 http 反向代理。 nginx.conf 配置文件如下: 注:conf / nginx.conf 是 nginx 的默认配置文件。你也可以使用 nginx -c 指定你的配置文件 好了,让我们来试试吧: 启动 webapp,注意启动绑定的端口要和nginx中的 upstream 设置的端口保持一致。 更改 host: 在 C:Windows\System32\drivers\etc 目录下的host文件中添加一条DNS 记录127.0.0.1 www.javastack.cn 启动前文中 startup.bat 的命令 在浏览器中访问 www.javastack.cn,不出意外,已经可以访问了。 负载均衡配置 上一个例子中,代理仅仅指向一个服务器。 但是,网站在实际运营过程中,多半都是有多台服务器运行着同样的app,这时需要使用负载均衡来分流。 nginx也可以实现简单的负载均衡功能。 假设这样一个应用场景:将应用部署在 192.168.1.11:80、192.168.1.12:80、192.168.1.13:80 三台linux环境的服务器上。网站域名叫 www.javastack.cn,公网IP为 192.168.1.11。在公网IP所在的服务器上部署 nginx,对所有请求做负载均衡处理。 nginx.conf 配置如下: 网站有多个webapp的配置 当一个网站功能越来越丰富时,往往需要将一些功能相对独立的模块剥离出来,独立维护。这样的话,通常,会有多个 webapp。 举个例子:假如 www.javastack.cn 站点有好几个webapp,finance(金融)、product(产品)、admin(用户中心)。访问这些应用的方式通过上下文(context)来进行区分: www.javastack.cn/finance/ www.javastack.cnproduct/ www.javastack.cn/admin/ 我们知道,http的默认端口号是80,如果在一台服务器上同时启动这3个 webapp 应用,都用80端口,肯定是不成的。所以,这三个应用需要分别绑定不同的端口号。 那么,问题来了,用户在实际访问 www.javastack.cn 站点时,访问不同 webapp,总不会还带着对应的端口号去访问吧。所以,你再次需要用到反向代理来做处理。 配置也不难,来看看怎么做吧: https反向代理配置 一些对安全性要求比较高的站点,可能会使用 HTTPS(一种使用ssl通信标准的安全HTTP协议)。 这里不科普 HTTP 协议和 SSL 标准。但是,使用 nginx 配置 https 需要知道几点: HTTPS 的固定端口号是 443,不同于 HTTP 的 80 端口 SSL 标准需要引入安全证书,所以在 nginx.conf 中你需要指定证书和它对应的 key 其他和 http 反向代理基本一样,只是在 Server 部分配置有些不同。 静态站点配置 有时候,我们需要配置静态站点(即 html 文件和一堆静态资源)。 举例来说:如果所有的静态资源都放在了 /app/dist 目录下,我们只需要在 nginx.conf 中指定首页以及这个站点的 host 即可。 配置如下: 然后,添加 HOST: 127.0.0.1 static.zp.cn,此时,在本地浏览器访问 static.zp.cn ,就可以访问静态站点了。 跨域解决方案 web 领域开发中,经常采用前后端分离模式。这种模式下,前端和后端分别是独立的 web 应用程序,例如:后端是 Java 程序,前端是 React 或 Vue 应用 各自独立的 web app 在互相访问时,势必存在跨域问题。解决跨域问题一般有两种思路: CORS 在后端服务器设置 HTTP 响应头,把你需要运行访问的域名加入加入 Access-Control-Allow-Origin 中。 jsonp 把后端根据请求,构造json数据,并返回,前端用 jsonp 跨域。 这两种思路,本文不展开讨论。 需要说明的是,nginx 根据第一种思路,也提供了一种解决跨域的解决方案。 举例:www.javastack.cn 网站是由一个前端 app ,一个后端 app 组成的。前端端口号为 9000, 后端端口号为 8080。 前端和后端如果使用 http 进行交互时,请求会被拒绝,因为存在跨域问题。来看看,nginx 是怎么解决的吧: 首先,在 enable-cors.conf 文件中设置 cors : 接下来,在你的服务器中 include enable-cors.conf 来引入跨域配置: 到此,就完成了。 欢迎工作一到五年的Java工程师朋友们加入Java填坑之路:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

ICLR投稿论文PyTorch出镜率快要反超了

自PyTorch出道以来,不断有人表示,发现了这样的趋势: “学术圈正在慢慢地抛弃TensorFlow,转投PyTorch。” 如今,PyTorch 1.0发布,ICLR 2019也才截稿不久,又是讨论这个问题的好时节。 Reddit上面,有小伙伴用非常低碳的方法观察了一下,这两年的论文用的都是什么框架: 从ICLR 2018到ICLR 2019的投稿来看,TensorFlow、PyTorch和Keras的搜索结果数发生了以下变化。 TensorFlow 228→266 PyTorch 87→252 Keras 42→56 虽然,三者数据皆有上升,但一年之间PyTorch搜索结果涨幅接近200%,好像已经对TensorFlow的宝座产生了威胁。 2017年1月19日,PyTorch第一次公开发布,到今天还不到两年,何以发展得这般蓬勃? PyTorch

优秀的个人博客,低调大师

搭建Hadoop的HA高可用架构(超详细步骤+已验证)

一、集群的规划 Zookeeper集群: 192.168.182.12 (bigdata12)192.168.182.13 (bigdata13)192.168.182.14 (bigdata14) Hadoop集群: 192.168.182.12 (bigdata12) NameNode1主节点 ResourceManager1主节点 Journalnode192.168.182.13 (bigdata13) NameNode2备用主节点 ResourceManager2备用主节点 Journalnode192.168.182.14 (bigdata14) DataNode1 NodeManager1192.168.182.15 (bigdata15) DataNode2 NodeManager2 二、准备工作 1、安装JDK:每台机器都需要安装 我这里使用的是jdk-8u152-linux-x64.tar.gz安装包 解压JDK: tar -zxvf jdk-8u144-linux-x64.tar.gz -C ~/training 2、配置环境变量: 1)配置java环境变量: vi ~/.bash_profile export JAVA_HOME=/root/training/jdk1.8.0_144 export PATH=$JAVA_HOME/bin:$PATH 2)生效环境变量: source ~/.bash_profile 3)验证是否安装成功: java -version 3、配置IP地址与主机名的映射关系 原因:方便SSH调用 方便Ping通 vi /etc/hosts 输入: 192.168.182.13 bigdata13 192.168.182.14 bigdata14 192.168.182.15 bigdata15 4、配置免密码登录 1)在每台机器上产生公钥和私钥 ssh-keygen -t rsa 含义:通过ssh协议采用非对称加密算法的rsa算法生成一组密钥对:公钥和私钥 2)在每台机器上将自己的公钥复制给其他机器 注:以下四个命令需要在每台机器上都运行一遍 ssh-copy-id -i .ssh/id_rsa.pub root@bigdata12 ssh-copy-id -i .ssh/id_rsa.pub root@bigdata13 ssh-copy-id -i .ssh/id_rsa.pub root@bigdata14 ssh-copy-id -i .ssh/id_rsa.pub root@bigdata15 三、安装Zookeeper集群(在bigdata12上安装) 在主节点(bigdata12)上安装和配置ZooKeeper 我这里使用的是zookeeper-3.4.10.tar.gz安装 1、解压Zookeeper: tar -zxvf zookeeper-3.4.10.tar.gz -C ~/training 2、配置和生效环境变量: export ZOOKEEPER_HOME=/root/training/zookeeper-3.4.10 export PATH=$ZOOKEEPER_HOME/bin:$PATH source ~/.bash_profile 3、修改zoo.cfg配置文件: vi /root/training/zookeeper-3.4.10/conf/zoo.cfg 修改: dataDir=/root/training/zookeeper-3.4.10/tmp 在最后一行添加: server.1=bigdata12:2888:3888 server.2=bigdata13:2888:3888 server.3=bigdata14:2888:3888 4、修改myid配置文件 在/root/training/zookeeper-3.4.10/tmp目录下创建一个myid的空文件: mkdir /root/training/zookeeper-3.4.10/tmp/myid echo 1 > /root/training/zookeeper-3.4.10/tmp/myid 5、将配置好的zookeeper拷贝到其他节点,同时修改各自的myid文件 scp -r /root/training/zookeeper-3.4.10/ bigdata13:/root/training scp -r /root/training/zookeeper-3.4.10/ bigdata14:/root/training 进入bigdata13和bigdata14两台机器中,找到myid文件,将其中的1分别修改为2和3: vi myid 在bigdata13中输入:2在bigdata14中输入:3 四、安装Hadoop集群(在bigdata12上安装) 1、修改hadoop-env.sh export JAVA_HOME=/root/training/jdk1.8.0_144 2、修改core-site.xml <configuration> <!-- 指定hdfs的nameservice为ns1 --> <property> <name>fs.defaultFS</name> <value>hdfs://ns1</value> </property> <!-- 指定HDFS数据存放路径,默认存放在linux的/tmp目录中 --> <property> <name>hadoop.tmp.dir</name> <value>/root/training/hadoop-2.7.3/tmp</value> </property> <!-- 指定zookeeper的地址 --> <property> <name>ha.zookeeper.quorum</name> <value>bigdata12:2181,bigdata13:2181,bigdata14:2181</value> </property> </configuration> 3、修改hdfs-site.xml(配置这个nameservice中有几个namenode) <configuration> <!--指定hdfs的nameservice为ns1,需要和core-site.xml中的保持一致 --> <property> <name>dfs.nameservices</name> <value>ns1</value> </property> ​ <!-- ns1下面有两个NameNode,分别是nn1,nn2 --> <property> <name>dfs.ha.namenodes.ns1</name> <value>nn1,nn2</value> </property> ​ <!-- nn1的RPC通信地址 --> <property> <name>dfs.namenode.rpc-address.ns1.nn1</name> <value>bigdata12:9000</value> </property> ​ <!-- nn1的http通信地址 --> <property> <name>dfs.namenode.http-address.ns1.nn1</name> <value>bigdata12:50070</value> </property> ​ <!-- nn2的RPC通信地址 --> <property> <name>dfs.namenode.rpc-address.ns1.nn2</name> <value>bigdata13:9000</value> </property> ​ <!-- nn2的http通信地址 --> <property> <name>dfs.namenode.http-address.ns1.nn2</name> <value>bigdata13:50070</value> </property> ​ <!-- 指定NameNode的日志在JournalNode上的存放位置 --> <property> <name>dfs.namenode.shared.edits.dir</name> <value>qjournal://bigdata12:8485;bigdata13:8485;/ns1</value> </property> ​ <!-- 指定JournalNode在本地磁盘存放数据的位置 --> <property> <name>dfs.journalnode.edits.dir</name> <value>/root/training/hadoop-2.7.3/journal</value> </property> ​ <!-- 开启NameNode失败自动切换 --> <property> <name>dfs.ha.automatic-failover.enabled</name> <value>true</value> </property> ​ <!-- 配置失败自动切换实现方式 --> <property> <name>dfs.client.failover.proxy.provider.ns1</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> ​ <!-- 配置隔离机制方法,多个机制用换行分割,即每个机制暂用一行--> <property> <name>dfs.ha.fencing.methods</name> <value> sshfence shell(/bin/true) </value> </property> <!-- 使用sshfence隔离机制时需要ssh免登陆 --> <property> <name>dfs.ha.fencing.ssh.private-key-files</name> <value>/root/.ssh/id_rsa</value> </property> <!-- 配置sshfence隔离机制超时时间 --> <property> <name>dfs.ha.fencing.ssh.connect-timeout</name> <value>30000</value> </property> </configuration> 4、修改mapred-site.xml <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> </configuration> 配置Yarn的HA 5、修改yarn-site.xml <configuration> <!-- 开启RM高可靠 --> <property> <name>yarn.resourcemanager.ha.enabled</name> <value>true</value> </property> <!-- 指定RM的cluster id --> <property> <name>yarn.resourcemanager.cluster-id</name> <value>yrc</value> </property> <!-- 指定RM的名字 --> <property> <name>yarn.resourcemanager.ha.rm-ids</name> <value>rm1,rm2</value> </property> <!-- 分别指定RM的地址 --> <property> <name>yarn.resourcemanager.hostname.rm1</name> <value>bigdata12</value> </property> <property> <name>yarn.resourcemanager.hostname.rm2</name> <value>bigdata13</value> </property> <!-- 指定zk集群地址 --> <property> <name>yarn.resourcemanager.zk-address</name> <value>bigdata12:2181,bigdata13:2181,bigdata14:2181</value> </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> </configuration> 6、修改slaves 从节点的地址 bigdata14 bigdata15 7、将配置好的hadoop拷贝到其他节点 scp -r /root/training/hadoop-2.7.3/ root@bigdata13:/root/training/ scp -r /root/training/hadoop-2.7.3/ root@bigdata14:/root/training/ scp -r /root/training/hadoop-2.7.3/ root@bigdata15:/root/training/ 五、启动Zookeeper集群 在每一台机器上输入: zkServer.sh start 六、启动journalnode 在bigdata12和bigdata13两台节点上启动journalnode节点: hadoop-daemon.sh start journalnode 七、格式化HDFS和Zookeeper(在bigdata12上执行) 格式化HDFS: hdfs namenode -format 将/root/training/hadoop-2.7.3/tmp拷贝到bigdata13的/root/training/hadoop-2.7.3/tmp下 scp -r dfs/ root@bigdata13:/root/training/hadoop-2.7.3/tmp 格式化zookeeper: hdfs zkfc -formatZK 日志:INFO ha.ActiveStandbyElector: Successfully created /hadoop-ha/ns1 in ZK. 以上日志表明在Zookeeper的文件系统中创建了/hadoop-ha/ns1的子目录用于保存Namenode的结构信息 八、启动Hadoop集群(在bigdata12上执行) 启动Hadoop集群的命令: start-all.sh 日志: Starting namenodes on [bigdata12 bigdata13] bigdata12: starting namenode, logging to /root/training/hadoop-2.4.1/logs/hadoop-root-namenode-hadoop113.out bigdata13: starting namenode, logging to /root/training/hadoop-2.4.1/logs/hadoop-root-namenode-hadoop112.out bigdata14: starting datanode, logging to /root/training/hadoop-2.4.1/logs/hadoop-root-datanode-hadoop115.out bigdata15: starting datanode, logging to /root/training/hadoop-2.4.1/logs/hadoop-root-datanode-hadoop114.out bigdata13: starting zkfc, logging to /root/training/hadoop-2.7.3/logs/hadoop-root-zkfc- bigdata13.out bigdata12: starting zkfc, logging to /root/training/hadoop-2.7.3/logs/hadoop-root-zkfc-bigdata12.out 在bigdata13上手动启动ResourceManager作为Yarn的备用主节点: yarn-daemon.sh start resourcemanager 至此,Hadoop集群的HA架构就已经搭建成功。 版权声明:本文为博主原创文章, 未经博主允许不得转载。http://www.cnblogs.com/lijinze-tsinghua/

优秀的个人博客,低调大师

多年经验的大牛总结出来的Python案例超详细

batch_file_rename.py This batch renames a group of files in a given directory, once you pass the current and the new extensions. create_dir_if_not_there.py 检查目录是否存在用户的主目录,如果没有然后创建它。Python的学习q-u n 二二七,四三五,四五零 ,是想转行还是想入行都可以来了解一起进步一起学习!内有开发工具,很多干货和技术资料分享!希望新手少走弯路 Youtube快速下载器 使用aria2c迅速与并行线程下载youtube视频 谷歌图片下载器 查询特定的术语从谷歌图片数据库和检索图像。 create_dir.py create_dir.py ~ 图像grapper.py 图像grapper.py ~ dir_test.py 测试来看看目录testdir存在,如果不是它将为你创建该目录。 env_check.py 这个脚本会检查所需的所有环境变量设置。 fileinfo.py 显示了对于一个给定的文件信息文件 folder_size.py 扫描当前目录及其所有子目录并显示大小 logs.py 该脚本将搜索所有*.log给定目录中的文件,压缩他们使用您所指定的计划,然后日期戳。 move_files_over_x_days.py 移动超过240天从源目录的所有文件到目标目录中 nslookup_check.py 这个简单的脚本打开文件server_list.txt然后做一个为每一个网路资讯查询检查DNS条目。 osinfo.py 显示一些信息关于你的操作系统运行这个脚本 ping_servers.py 这个脚本,根据提供的参数,将ping服务器相关的应用程序组。 ping_subnet.py 提供第一个3八位字节这个文件扫描后的最终范围可用地址 powerdown_startup.py 这个文件经过服务器列表和ping机器,如果是将负载腻子会话,如果不是它会通知你。 puttylogs.py 这个文件中的所有日志的拉链给目录 script_count.py 这个文件扫描的脚本目录,并给出了一个计算不同类型的脚本。 script_listing.py 这个文件将列表中的所有文件目录,以及经历的所有子目录。 testlines.py 这个简单的脚本打开一个文件,并打印出100行线的任何一组变量。 tweeter.py 这个脚本允许你发送文本或图片的终端 serial_scanner.py 包含一个方法叫做ListAvailablePorts返回一个列表的串行端口的名字在电脑使用,这种方法只能在Linux和Windows(mac osx可以扩展)。 如果没有找到港口,将返回一个空列表。 get_youtube_view.py 这是非常简单的python脚本得到多个视图的youtube视频, 用于重复歌曲在youtube上。 CountMillionCharacter.py和CountMillionCharacter2.0. py 统计字符脚本,或多少字符出现在任何基于文本的文件。 xkcd_downloader.py 下载最新的XKCD漫画和地点在一个名为“漫画”的新文件夹 timymodule.py 一个伟大的替代蟒蛇“时间”模块和更容易使用。 calculator.py 使用Python的eval()函数来实现一个计算器 Google_News.py 使用BeautifulSoup提供最新新闻标题与新闻链接 cricket_live_score 使用BeautifulSoup提供活的板球得分 youtube.py 以歌曲名称作为输入和获取最佳匹配的歌曲和戏剧的youtube url

优秀的个人博客,低调大师

超全面的大型IT公司Java开发岗面试题集锦

# 一年之计在于春,一天之计在于晨,又到一年招聘就业季,或许你还沉浸在春节的安逸里,但新的征程已经拉开帷幕,那些无处安放的青春,那些尚未实现的梦想,那些还没到达的远方,都在等待你动身出发。今天小编为大家安利一些大型互联网公司Java开发岗位面试题,分为12个大类,希望能引燃大家2018IT职场的大爆发和收获!! 一、Java基础 1.String类为什么是final的。 2.HashMap的源码,实现原理,底层结构。 3.说说你知道的几个Java集合类:list、set、queue、map实现类咯。。。 4.描述一下ArrayList和LinkedList各自实现和区别 5.Java中的队列都有哪些,有什么区别。 6.反射中,Class.forName和classloader的区别 7.Java7、Java8的新特性(baidu问的,好BT) 8.Java数组和链表两种结构的操作效率,在哪些情况下(从开头开始,从结尾开始,从中间开始),哪些操作(插入,查找,删除)的效率高 9.Java内存泄露的问题调查定位:jmap,jstack的使用等等 10.string、stringbuilder、stringbuffer区别 11.hashtable和hashmap的区别 13.异常的结构,运行时异常和非运行时异常,各举个例子 14.Stringa=“abc”Stringb=“abc”Stringc=newString(“abc”)Stringd=“ab”+“c”.他们之间用==比较的结果 15.String类的常用方法 16.Java的引用类型有哪几种 17.抽象类和接口的区别 18.java的基础类型和字节大小。 19.Hashtable,HashMap,ConcurrentHashMap底层实现原理与线程安全问题(建议熟悉jdk源码,才能从容应答) 20.如果不让你用JavaJdk提供的工具,你自己实现一个Map,你怎么做。说了好久,说了HashMap源代码,如果我做,就会借鉴HashMap的原理,说了一通HashMap实现 21.Hash冲突怎么办?哪些解决散列冲突的方法? 22.HashMap冲突很厉害,最差性能,你会怎么解决?从O(n)提升到log(n)咯,用二叉排序树的思路说了一通 23.rehash 24.hashCode()与equals()生成算法、方法怎么重写 二、JavaIO 1.讲讲IO里面的常见类,字节流、字符流、接口、实现类、方法阻塞。 2.讲讲NIO。 3.String编码UTF-8和GBK的区别? 4.什么时候使用字节流、什么时候使用字符流? 5.递归读取文件夹下的文件,代码怎么实现 三、JavaWeb 1.session和cookie的区别和联系,session的生命周期,多个服务部署时session管理。 2.servlet的一些相关问题 3.webservice相关问题 4.jdbc连接,forname方式的步骤,怎么声明使用一个事务。举例并具体代码 5.无框架下配置web.xml的主要配置内容 6.jsp和servlet的区别 四、JVM 1.Java的内存模型以及GC算法 2.jvm性能调优都做了什么 3.介绍JVM中7个区域,然后把每个区域可能造成内存的溢出的情况说明 4.介绍GC和GCRoot不正常引用。 5.自己从classload加载方式,加载机制说开去,从程序运行时数据区,讲到内存分配,讲到String常量池,讲到JVM垃圾回收机制,算法,hotspot。反正就是各种扩展 6.jvm如何分配直接内存,new对象如何不分配在堆而是栈上,常量池解析 7.数组多大放在JVM老年代(不只是设置PretenureSizeThreshold,问通常多大,没做过一问便知) 8.老年代中数组的访问方式 9.GC算法,永久代对象如何GC,GC有环怎么处理 10.谁会被GC,什么时候GC 11.如果想不被GC怎么办 12.如果想在GC中生存1次怎么办 五、开源框架 1.hibernate和ibatis的区别 2.讲讲mybatis的连接池。 3.spring框架中需要引用哪些jar包,以及这些jar包的用途 4.springMVC的原理 5.springMVC注解的意思 6.spring中beanFactory和ApplicationContext的联系和区别 7.spring注入的几种方式(循环注入) 8.spring如何实现事物管理的 9.springIOC 10.springAOP的原理 11.hibernate中的1级和2级缓存的使用方式以及区别原理(Lazy-Load的理解) 12.Hibernate的原理体系架构,五大核心接口,Hibernate对象的三种状态转换,事务管理。 六、多线程 1.Java创建线程之后,直接调用start()方法和run()的区别 2.常用的线程池模式以及不同线程池的使用场景 3.newFixedThreadPool此种线程池如果线程数达到最大值后会怎么办,底层原理。 4.多线程之间通信的同步问题,synchronized锁的是对象,衍伸出和synchronized相关很多的具体问题,例如同一个类不同方法都有synchronized锁,一个对象是否可以同时访问。或者一个类的static构造方法加上synchronized之后的锁的影响。 5.了解可重入锁的含义,以及ReentrantLock和synchronized的区别 6.同步的数据结构,例如concurrentHashMap的源码理解以及内部实现原理,为什么他是同步的且效率高 7.atomicinteger和Volatile等线程安全操作的关键字的理解和使用 8.线程间通信,wait和notify 9.定时线程的使用 10.场景:在一个主线程中,要求有大量(很多很多)子线程执行完之后,主线程才执行完成。多种方式,考虑效率。 11.进程和线程的区别 12.什么叫线程安全?举例说明 13.线程的几种状态 14.并发、同步的接口或方法 15.HashMap是否线程安全,为何不安全。ConcurrentHashMap,线程安全,为何安全。底层实现是怎么样的。 16.J.U.C下的常见类的使用。ThreadPool的深入考察;BlockingQueue的使用。(take,poll的区别,put,offer的区别);原子类的实现。 17.简单介绍下多线程的情况,从建立一个线程开始。然后怎么控制同步过程,多线程常用的方法和结构 18.volatile的理解 19.实现多线程有几种方式,多线程同步怎么做,说说几个线程里常用的方法 七、网络通信 1.http是无状态通信,http的请求方式有哪些,可以自己定义新的请求方式么。 2.socket通信,以及长连接,分包,连接异常断开的处理。 3.socket通信模型的使用,AIO和NIO。 4.socket框架netty的使用,以及NIO的实现原理,为什么是异步非阻塞。 5.同步和异步,阻塞和非阻塞。 6.OSI七层模型,包括TCP,IP的一些基本知识 7.http中,getpost的区别 8.说说http,tcp,udp之间关系和区别。 9.说说浏览器访问www.taobao.com,经历了怎样的过程。 10.HTTP协议、HTTPS协议,SSL协议及完整交互过程; 11.tcp的拥塞,快回传,ip的报文丢弃 12.https处理的一个过程,对称加密和非对称加密 13.head各个特点和区别 14.说说浏览器访问www.taobao.com,经历了怎样的过程。 **八、数据库MySql**1.MySql的存储引擎的不同 2.单个索引、联合索引、主键索引 3.Mysql怎么分表,以及分表后如果想按条件分页查询怎么办(如果不是按分表字段来查询的话,几乎效率低下,无解) 4.分表之后想让一个id多个表是自增的,效率实现 5.MySql的主从实时备份同步的配置,以及原理(从库读主库的binlog),读写分离 6.写SQL语句。。。 7.索引的数据结构,B+树 8.事务的四个特性,以及各自的特点(原子、隔离)等等,项目怎么解决这些问题 9.数据库的锁:行锁,表锁;乐观锁,悲观锁 10.数据库事务的几种粒度; 11.关系型和非关系型数据库区别 九、设计模式 1.单例模式:饱汉、饿汉。以及饿汉中的延迟加载,双重检查 2.工厂模式、装饰者模式、观察者模式。 3.工厂方法模式的优点(低耦合、高内聚,开放封闭原则) 十、算法 1.使用随机算法产生一个数,要求把1-1000W之间这些数全部生成。(考察高效率,解决产生冲突的问题) 2.两个有序数组的合并排序 3.一个数组的倒序 4.计算一个正整数的正平方根 5.说白了就是常见的那些查找、排序算法以及各自的时间复杂度 6.二叉树的遍历算法 7.DFS,BFS算法 9.比较重要的数据结构,如链表,队列,栈的基本理解及大致实现。 10.排序算法与时空复杂度(快排为什么不稳定,为什么你的项目还在用) 11.逆波兰计算器 12.Hoffman编码 13.查找树与红黑树 十一、并发与性能调优 1.有个每秒钟5k个请求,查询手机号所属地的笔试题(记得不完整,没列出),如何设计算法?请求再多,比如5w,如何设计整个系统? 2.高并发情况下,我们系统是如何支撑大量的请求的 3.集群如何同步会话状态 4.负载均衡的原理 5.如果有一个特别大的访问量,到数据库上,怎么做优化(DB设计,DBIO,SQL优化,Java优化) 6.如果出现大面积并发,在不增加服务器的基础上,如何解决服务器响应不及时问题“。 7.假如你的项目出现性能瓶颈了,你觉得可能会是哪些方面,怎么解决问题。 8.如何查找造成性能瓶颈出现的位置,是哪个位置照成性能瓶颈。 9.你的项目中使用过缓存机制吗?有没用用户非本地缓存 十二、其他 常用的linux下的命令 新年伊始,即将迎来“金三银四”的招聘就业旺季,为了让大家在职场上有实力去竞争和抗衡,博为峰网校特推出了Java测试开发组合套餐,感兴趣的同学们欢迎大家前来了解和咨询!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册