首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10000篇文章
优秀的个人博客,低调大师

Apache Flink 进阶(十三):深度探索 Flink SQL

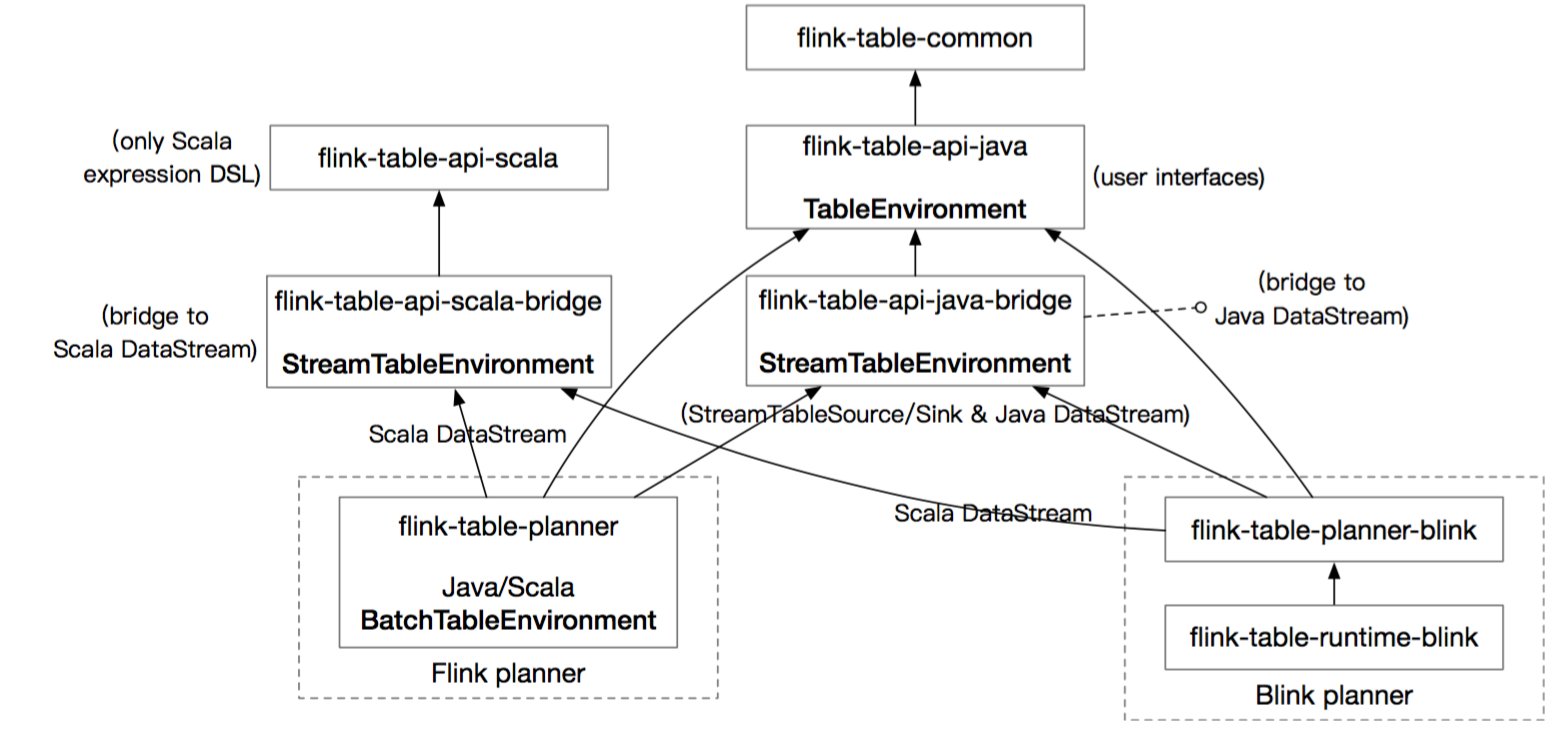
作者:贺小令(晓令)整理:郑仲尼 本文根据 Apache Flink 进阶篇系列直播整理而成,由阿里巴巴技术专家贺小令分享,文章将从用户的角度来讲解 Flink 1.9 版本中 SQL 相关原理及部分功能变更,希望加深大家对 Flink 1.9 新功能的理解,在使用上能够有所帮助。主要内容: 新 TableEnvironment 的设计与使用场景 新 Catalog 的设计以及 DDL 实践 Blink Planner 的几点重要改进及优化 新 TableEnvironment FLIP-32 中提出,将 Blink 完全开源,合并到 Flink 主分支中。合并后在 Flink 1.9 中会存在两个 Planner:Flink Planner 和 Blink Planner。 在之前的版本中,Flink Table 在整个 Flink 中是一个二等公民。而 Flink SQL 具备的易用性,使用门槛低等特点深受用户好评,也越来越被重视,Flink Table 模块也因此被提升为一等公民。而 Blink 在设计之初就考虑到流和批的统一,批只是流的一种特殊形式,所以在将 Blink 合并到 Flink 主分支的过程中,社区也同时考虑了 Blink 的特殊设计。 新 TableEnvironment 整体设计 图1 新 Table Environment 整体设计 从图 1 中,可以看出,TableEnvironment 组成部分如下: flink-table-common:这个包中主要是包含 Flink Planner 和 Blink Planner 一些共用的代码。 flink-table-api-java:这部分是用户编程使用的 API,包含了大部分的 API。 flink-table-api-scala:这里只是非常薄的一层,仅和 Table API 的 Expression 和 DSL 相关。 两个 Planner:flink-table-planner 和 flink-table-planner-blink。 两个 Bridge:flink-table-api-scala-bridge 和 flink-table-api-java-bridge,从图中可以看出,Flink Planner 和 Blink Planner 都会依赖于具体的 JAVA API,也会依赖于具体的 Bridge,通过 Bridge 可以将 API 操作相应的转化为 Scala 的 DataStream、DataSet,或者转化为 JAVA 的 DataStream 或者 Data Set。 新旧 TableEnvironment 对比 在 Flink 1.9 之前,原来的 Flink Table 模块,有 7 个 Environment,使用和维护上相对困难。7 个 Environment 包括:StreamTableEnvironment,BatchTableEnvironment 两类,JAVA 和 Scala 分别 2 个,一共 4 个,加上 3 个父类,一共就是 7 个。 在新的框架之下,社区希望流和批统一,因此对原来的设计进行精简。首先,提供统一的 TableEnvironment,放在 flink-table-api-java 这个包中。然后,在 Bridge 中,提供了两个用于衔接 Scala DataStream 和 Java DataStream 的 StreamTableEnvironment。最后,因为 Flink Planner 中还残存在着 toDataSet() 类似的操作,所以,暂时保留 BatchTableEnvironment。这样,目前一共是 5 个 TableEnvironment。 因为未来 Flink Planner 将会被移除,BatchTableEnvironment 就会被废弃,这样,未来就剩下 3 个 Environment 了,整个 TableEnvironment 的设计将更加简洁明了。 新 TableEnvironment 的应用 本节中,将介绍新的应用场景以及相关限制。 下图详细列出了新 TableEnvironment 的适用场景: 图2 新 Table Environment 适应场景 第一行,简单起见,在后续将新的 TableEnvironment 称为 UnifyTableEnvironment。在 Blink 中,Batch 被认为是 Stream 的一个特例,因此 Blink 的 Batch 可以使用 UnifyTableEnvironment。 UnifyTableEnvironment 在 1.9 中有一些限制,比如它不能够注册 UDAF 和 UDTF,当前新的 Type System 的类型推导功能还没有完成,Java、Scala 的类型推导还没统一,所以这部分的功能暂时不支持。可以肯定的是,这部分功能会在 1.10 中实现。此外,UnifyTableEnvironment 无法转化为 DataStream 和 DataSet。 第二行,Stream TableEnvironment 支持转化成 DataStream,也可以注册 UDAF 和 UDTF。如果是 JAVA 写的,就注册到 JAVA 的 TableEnvironment,如果是用 Scala 写的,就注册到 Scala 的 TableEnvironment。 注意,Blink Batch 作业是不支持 Stream TableEnvironment 的,因为目前没有 toAppendStream(),所以 toDataStream() 这样的语义暂时不支持。从图中也可以看出,目前操作只能使用 TableEnvironment。 最后一行,BatchTableEvironment 能够使用 toDataSet() 转化为 DataSet。 从上面的图 2 中,可以很清晰的看出各个 TableEnvironment 能够做什么事情,以及他们有哪些限制。 接下来,将使用示例对各种情况进行说明。 示例1:Blink Batch EnvironmentSettings settings = EnvironmentSettings.newInstance().useBlinkPlanner().inBatchMode().build(); TableEnvironment tEnv = TableEnvironment.create(settings); tEnv… tEnv.execute(“job name”); 从图 2 中可以看出,Blink Batch 只能使用 TableEnvironment(即UnifyTableEnvironment),代码中,首先需要创建一个 EnvironmentSetting,同时指定使用 Blink Planner,并且指定用 Batch 模式。之所以需要指定 Blink Planner,是因为目前 Flink 1.9 中,将 Flink Planner 和 Blink Planner 的 jar 同时放在了 Flink 的 lib 目录下。如果不指定使用的 Planner,整个框架并不知道需要使用哪个 Planner,所以必须显示的指定。当然,如果 lib 下面只有一个 Planner 的 jar,这时不需要显示指定使用哪个 Planner。 另外,还需要注意的是在 UnifyEnvironment 中,用户是无法获取到 ExecutionEnvironment 的,即用户无法在写完作业流程后,使用 executionEnvironment.execute() 方法启动任务。需要显式的使用 tableEnvironment.execute() 方法启动任务,这和之前的作业启动很不相同。 示例 2:Blink Stream EnvironmentSettings settings = EnvironmentSettings.newInstance().useBlinkPlanner().inStreamingMode().build(); StreamExecutionEnvironment execEnv = … StreamTableEnvironment tEnv = StreamTableEnvironment.create(execEnv, settings); tEnv… Blink Stream 既可以使用 UnifyTableEnvironment,也可以使用 StreamTableEnvironment,与 Batch 模式基本类似,只是需要将 inBatchMode 换成 inStreamingMode。 示例 3:Flink Batch ExecutionEnvironment execEnv = ... BatchTableEnvironment tEnv = BatchTableEnvironment.create(execEnv); tEnv... 与之前没有变化,不做过多介绍。 示例 4:Flink Stream EnvironmentSettings settings = EnvironmentSettings.newInstance().useOldPlanner().inStreamMode().build(); TableEnvironment tEnv = TableEnvironment.create(settings); tEnv… tEnv.execute(“job name”); Flink Stream 也是同时支持 UnifyEnvironment 和 StreamTableEnvironment,只是在指定 Planner 时,需要指定为 useOldPlanner,也即 Flink Planner。因为未来 Flink Planner 会被移除,因此,特意起了一个 OlderPlanner 的名字,而且只能够使用 inStreamingMode,无法使用 inBatchMode。 新 Catalog 和 DDL 构建一个新的 Catalog API 主要是 FLIP-30 提出的,之前的 ExternalCatalog 将被废弃,Blink Planner 中已经不支持 ExternalCatalog 了,Flink Planner 还支持 ExternalCatalog。 新 Catalog 设计 下图是新 Catalog 的整体设计: 图3 新 Catalog 设计 可以看到,新的 Catalog 有三层结构(..),最顶层是 Catalog 的名字,中间一层是 Database,最底层是各种 MetaObject,如 Table,Partition,Function 等。当前,内置了两个 Catalog 实现:MemoryCatalog 和 HiveCatalog。当然,用户也可以实现自己的 Catalog。 Catalog 能够做什么事情呢?首先,它可以支持 Create,Drop,List,Alter,Exists 等语句,另外它也支持对 Database,Table,Partition,Function,Statistics 等的操作。基本上,常用的 SQL 语法都已经支持。 CatalogManager 正如它名字一样,主要是用来管理 Catalog,且可以同时管理多个 Catalog。也就是说,可以通过在一个相同 SQL 中,跨 Catalog 做查询或者关联操作。例如,支持对 A Hive Catalog 和 B Hive Catalog 做相互关联,这给 Flink 的查询带来了很大的灵活性。 CatalogManager 支持的操作包括: 注册 Catalog(registerCatalog) 获取所有的 Catalog(getCatalogs) 获取特定的 Catalog(getCatalog) 获取当前的 Catalog(getCurrentCatalog) 设置当前的 Catalog(setCurrentCatalog) 获取当前的 Database(getCurrentDatabase) 设置当前的 Database(setCurrentDatabase) Catalog 虽然设计了三层结构,但在使用的时候,并不需要完全指定三层结构的值,可以只写Table Name,这时候,系统会使用 getCurrentCatalog,getCurrentDatabase 获取到默认值,自动补齐三层结构,这种设计简化了对 Catalog 的使用。如果需要切换默认的 Catalog,只需要调用 setCurrentCatalog 就可以了。 在 TableEnvironment 层,提供了操作 Catalog 的方法,例如: 注册 Catalog(registerCatalog) 列出所有的 Catalog(listCatalogs) 获取指定 Catalog(getCatalog) 使用某个 Catalog(useCatalog) 在 SQL Client 层,也做了一定的支持,但是功能有一定的限制。用户不能够使用 Create 语句直接创建 Catalog,只能通过在 yarn 文件中,通过定义 Description 的方式去描述 Catalog,然后在启动 SQL Client 的时候,通过传入 -e +file_path 的方式,定义 Catalog。目前 SQL Client 支持列出已定义的 Catalog,使用一个已经存在的 Catalog 等操作。 DDL 设计与使用 有了 Catalog,就可以使用 DDL 来操作 Catalog 的内容,可以使用 TableEnvironment 的 sqlUpdate() 方法执行 DDL 语句,也可以在 SQL Client 执行 DDL 语句。 sqlUpdate() 方法中,支持 Create Table,Create View,Drop Table,Drop View 四个命令。当然,inset into 这样的语句也是支持的。 下面分别对 4 个命令进行说明: Create Table:可以显示的指定 Catalog Name 或者 DB Name,如果缺省,那就按照用户设定的 Current Catalog 去补齐,然后可以指定字段名称,字段的说明,也可以支持 Partition By 语法。最后是一个 With 参数,用户可以在此处指定使用的 Connector,例如,Kafka,CSV,HBase 等。With 参数需要配置一堆的属性值,可以从各个 Connector 的 Factory 定义中找到。Factory 中会指出有哪些必选属性,哪些可选属性值。 需要注意的是,目前 DDL 中,还不支持计算列和 Watermark 的定义,后续的版本中将会继续完善这部分。 Create Table [[catalog_name.]db_name.]table_name( a int comment 'column comment', b bigint, c varchar )comment 'table comment' [partitioned by(b)] With( update-mode='append', connector.type='kafka', ... ) Create View:需要指定 View 的名字,然后紧跟着的是 SQL。View 将会存储在 Catalog 中。 CREATE VIEW view_name AS SELECT xxx Drop Table&Drop View:和标准 SQL 语法差不多,支持使用 IF EXISTS 语法,如果未加 IF EXISTS ,Drop 一个不存在的表,会抛出异常。 DROP TABLE [IF EXISTS] [[catalog_name.]db_name.]table_name SQL Client中执行DDL:大部分都只支持查看操作,仅可以使用 Create View 和 Drop View。Catalog,Database,Table ,Function 这些只能做查看。用户可以在 SQL Client 中 Use 一个已经存在的 Catalog,修改一些属性,或者做 Description,Explain 这样的一些操作。 CREATE VIEW DROP VIEW SHOW CATALOGS/DATABASES/TABLES/FUNCTIONS l USE CATALOG xxx SET xxx=yyy DESCRIBE table_name EXPLAIN SELECT xxx DDL 部分,在 Flink 1.9 中其实基本已经成型,只是还有一些特性,在未来需要逐渐的完善。 Blink Planner 本节将主要从 SQL/Table API 如何转化为真正的 Job Graph 的流程开始,让大家对 Blink Planner 有一个比较清晰的认识,希望对大家阅读 Blink 代码,或者使用 Blink 方面有所帮助。然后介绍 Blink Planner 的改进及优化。 图4 主要流程 从上图可以很清楚的看到,解析的过程涉及到了三层:Table API/SQL,Blink Planner,Runtime,下面将对主要的步骤进行讲解。 Table API&SQL 解析验证:在 Flink 1.9 中,Table API 进行了大量的重构,引入了一套新的 Operation,这套 Operation 主要是用来描述任务的 Logic Tree。 当 SQL 传输进来后,首先会去做 SQL 解析,SQL 解析完成之后,会得到 SqlNode Tree(抽象语法树),然后会紧接着去做 Validator(验证),验证时会去访问 FunctionManger 和 CatalogManger,FunctionManger 主要是查询用户定义的 UDF,以及检查 UDF 是否合法,CatalogManger 主要是检查这个 Table 或者 Database 是否存在,如果验证都通过,就会生成一个 Operation DAG(有向无环图)。 从这一步可以看出,Table API 和 SQL 在 Flink 中最终都会转化为统一的结构,即 Operation DAG。 生成RelNode:Operation DAG 会被转化为 RelNode(关系表达式) DAG。 优化:优化器会对 RelNode 做各种优化,优化器的输入是各种优化的规则,以及各种统计信息。当前,在 Blink Planner 里面,绝大部分的优化规则,Stream 和 Batch 是共享的。差异在于,对 Batch 而言,它没有 state 的概念,而对于 Stream 而言,它是不支持 sort 的,所以目前 Blink Planner 中,还是运行了两套独立的规则集(Rule Set),然后定义了两套独立的 Physical Rel:BatchPhysical Rel 和 StreamPhysical Rel。优化器优化的结果,就是具体的 Physical Rel DAG。 转化:得到 Physical Rel Dag 后,继续会转化为 ExecNode,通过名字可以看出,ExecNode 已经属于执行层的概念了,但是这个执行层是 Blink 的执行层,在 ExecNode 中,会进行大量的 CodeGen 的操作,还有非 Code 的 Operator 操作,最后,将 ExecNode 转化为 Transformation DAG。 生成可执行 Job Graph:得到 Transformation DAG 后,最终会被转化成 Job Graph,完成 SQL 或者 Table API 的解析。 Blink Planner 改进及优化 Blink Planner 功能方面改进主要包含如下几个方面: 更完整的 SQL 语法支持:例如,IN,EXISTS,NOT EXISTS,子查询,完整的 Over 语句,Group Sets 等。而且已经跑通了所有的 TPCH,TPCDS 这两个测试集,性能还非常不错。 提供了更丰富,高效的算子。 提供了非常完善的 cost 模型,同时能够对接 Catalog 中的统计信息,使 cost 根据统计信息得到更优的执行计划。 支持 join reorder。 shuffle service:对 Batch 而言,Blink Planner 还支持 shuffle service,这对 Batch 作业的稳定性有非常大的帮助,如果遇到 Batch 作业失败,通过 shuffle service 能够很快的进行恢复。 性能方面,主要包括以下部分: 分段优化。 Sub-Plan Reuse。 更丰富的优化 Rule:共一百多个 Rule ,并且绝大多数 Rule 是 Stream 和 Batch 共享的。 更高效的数据结构 BinaryRow:能够节省序列化和反序列化的操作。 mini-batch 支持(仅 Stream):节省 state 的访问的操作。 节省多余的 Shuffle 和 Sort(Batch 模式):两个算子之间,如果已经按 A 做 Shuffle,紧接着他下的下游也是需要按 A Shuffle 的数据,那中间的这一层 Shuffle,就可以省略,这样就可以省很多网络的开销,Sort 的情况也是类似。Sort 和 Shuffle 如果在整个计算里面是占大头,对整个性能是有很大的提升的。 深入性能优化及实践 本节中,将使用具体的示例进行讲解,让你深入理解 Blink Planner 性能优化的设计。 分段优化 示例 5 create view MyView as select word, count(1) as freq from SourceTable group by word; insert into SinkTable1 select * from MyView where freq >10; insert into SinkTable2 select count(word) as freq2, freq from MyView group by freq; 上面的这几个 SQL,转化为 RelNode DAG,大致图形如下: 图5 示例5 RelNode DAG 如果是使用 Flink Planner,经过优化层后,会生成如下执行层的 DAG: 图6 示例 5 Flink Planner DAG 可以看到,Flink Planner 只是简单的从 Sink 出发,反向的遍历到 Source,从而形成两个独立的执行链路,从上图也可以清楚的看到,Scan 和第一层 Aggregate 是有重复计算的。 在 Blink Planner 中,经过优化层之后,会生成如下执行层的 DAG: 图7 示例 5 Blink Planner DAG Blink Planner 不是在每次调用 insert into 的时候就开始优化,而是先将所有的 insert into 操作缓存起来,等到执行前才进行优化,这样就可以看到完整的执行图,可以知道哪些部分是重复计算的。Blink Planner 通过寻找可以优化的最大公共子图,找到这些重复计算的部分。经过优化后,Blink Planner 会将最大公共子图的部分当做一个临时表,供其他部分直接使用。 这样,上面的图可以分为三部分,最大公共子图部分(临时表),临时表与 Filter 和 SinkTable1 优化,临时表与第二个 Aggregate 和 SinkTable 2 优化。 Blink Planner 其实是通过声明的 View 找到最大公共子图的,因此在开发过程中,如果需要复用某段逻辑,就将其定义为 View,这样就可以充分利用 Blink Planner 的分段优化功能,减少重复计算。 当然,当前的优化也不是最完美的,因为提前对图进行了切割,可能会导致一些优化丢失,今后会持续地对这部分算法进行改进。 总结一下,Blink Planner 的分段优化,其实解的是多 Sink 优化问题(DAG 优化),单 Sink 不是分段优化关心的问题,单 Sink 可以在所有节点上优化,不需要分段。 Sub-Plan Reuse 示例 6 insert into SinkTabl select freq from (select word, count(1) as freq from SourceTable group by word) t where word like 'T%' union all select count(word) as freq2 from (select word, count(1) as freq from SourceTable group by word) t group by freq; 这个示例的 SQL 和分段优化的 SQL 其实是类似的,不同的是,没有将结果 Sink 到两个 Table 里面,而是将结果 Union 起来,Sink 到一个结果表里面。 下面看一下转化为 RelNode 的 DAG 图: 图 8 示例 6 RelNode DAG 从上图可以看出,Scan 和第一层的 Aggregate 也是有重复计算的,Blink Planner 其实也会将其找出来,变成下面的图: 图9 示例 6 Blink Planner DAG Sub-Plan 优化的启用,有两个相关的配置: table.optimizer.reuse-sub-plan-enabled (默认开启) table.optimizer.reuse-source-enabled(默认开启) 这两个配置,默认都是开启的,用户可以根据自己的需求进行关闭。这里主要说明一下 table.optimizer.reuse-source-enabled 这个参数。在 Batch 模式下,join 操作可能会导致死锁,具体场景是在执行 hash-join 或者 nested-loop-join 时一定是先读 build 端,然后再读 probe 端,如果启用 reuse-source-enabled,当数据源是同一个 Source 的时候,Source 的数据会同时发送给 build 和 probe 端。这时候,build 端的数据将不会被消费,导致 join 操作无法完成,整个 join 就被卡住了。 为了解决死锁问题,Blink Planner 会先将 probe 端的数据落盘,这样 build 端读数据的操作才会正常,等 build 端的数据全部读完之后,再从磁盘中拉取 probe 端的数据,从而解决死锁问题。但是,落盘会有额外的开销,会多一次写的操作;有时候,读两次 Source 的开销,可能比一次写的操作更快,这时候,可以关闭 reuse-source,性能会更好。当然,如果读两次 Source 的开销,远大于一次落盘的开销,可以保持 reuse-source 开启。需要说明的是,Stream 模式是不存在死锁问题的,因为 Stream 模式 join 不会有选边的问题。 总结而言,sub-plan reuse 解的问题是优化结果的子图复用问题,它和分段优化类似,但他们是一个互补的过程。 注:Hash Join:对于两张待 join 的表 t1, t2。选取其中的一张表按照 join 条件给的列建立hash 表。然后扫描另外一张表,一行一行去建好的 hash 表判断是否有对应相等的行来完成 join 操作,这个操作称之为 probe (探测)。前一张表叫做 build 表,后一张表的叫做 probe 表。 Agg 分类优化 Blink 中的 Aggregate 操作是非常丰富的: group agg,例如:select count(a) from t group by b over agg,例如:select count(a) over (partition by b order by c) from t window agg,例如:select count(a) from t group by tumble(ts, interval '10' second), b table agg ,例如:tEnv.scan('t').groupBy('a').flatAggregate(flatAggFunc('b' as ('c', 'd'))) 下面主要对 Group Agg 优化进行讲解,主要是两类优化。 1. Local/Global Agg 优化 Local/Global Agg 主要是为了减少网络 Shuffle。要运用 Local/Global 的优化,必要条件如下: Aggregate 的所有 Agg Function 都是 mergeable 的,每个 Aggregate 需要实现 merge 方法,例如 SUM,COUNT,AVG,这些都是可以分多阶段完成,最终将结果合并;但是求中位数,计算 95% 这种类似的问题,无法拆分为多阶段,因此,无法运用 Local/Global 的优化。 table.optimizer.agg-phase-strategy 设置为 AUTO 或者 TWO_PHASE。 Stream 模式下,mini-batch 开启 ;Batch 模式下 AUTO 会根据 cost 模型加上统计数据,选择是否进行 Local/Global 优化。 示例 7 select count(*) from t group by color 没有优化的情况下,下面的这个 Aggregate 会产生 10 次的 Shuffle 操作。 图 10 示例 7 未做优化的 Count 操作 使用 Local/Global 优化后,会转化为下面的操作,会在本地先进行聚合,然后再进行 Shuffle 操作,整个 Shuffle 的数据剩下 6 条。在 Stream 模式下,Blink 其实会以 mini-batch 的维度对结果进行预聚合,然后将结果发送给 Global Agg 进行汇总。 图 11 示例 7 经过 Local/Global 优化的 Count 操作 2. Distinct Agg 优化 Distinct Agg 进行优化,主要是对 SQL 语句进行改写,达到优化的目的。但 Batch 模式和 Stream 模式解决的问题是不同的: Batch 模式下的 Distinct Agg,需要先做 Distinct,再做 Agg,逻辑上需要两步才能实现,直接实现 Distinct Agg 开销太大。 Stream 模式下,主要是解决热点问题,因为 Stream 需要将所有的输入数据放在 State 里面,如果数据有热点,State 操作会很频繁,这将影响性能。 Batch 模式 第一层,求 distinct 的值和非 distinct agg function 的值,第二层求 distinct agg function 的值 示例 8 select color, count(distinct id), count(*) from t group by color 手工改写成: select color, count(id), min(cnt) from ( select color, id, count(*) filter (where $e=2) as cnt from ( select color, id, 1 as $e from t --for distinct id union all select color, null as id, 2 as $e from t -- for count(*) ) group by color, id, $e ) group by color 转化的逻辑过程,如下图所示: 图 12 示例 8 Batch 模式 Distinct 改写逻辑 Stream 模式 Stream 模式的启用有一些必要条件: 必须是支持的 agg function:avg/count/min/max/sum/first_value/concat_agg/single_value; table.optimizer.distinct-agg.split.enabled(默认关闭) 示例 9 select color, count(distinct id), count(*) from t group by color 手工改写成: select color, sum(dcnt), sum(cnt) from ( select color, count(distinct id) as dcnt, count(*) as cnt from t group by color, mod(hash_code(id), 1024) ) group by color 改写前,逻辑图大概如下: 图 13 示例 9 Stream 模式未优化 Distinct 改写后,逻辑图就会变为下面这样,热点数据被打散到多个中间节点上。 图14 示例 9 Stream 模式优化 Distinct 需要注意的是,示例 5 的 SQL 中 mod(hash_code(id),1024)中的这个 1024 为打散的维度,这个值建议设置大一些,设置太小产生的效果可能不好。 总结 本文首先对新的 TableEnvironment 的整体设计进行了介绍,并且列举了各种模式下TableEnvironment 的选择,然后通过具体的示例,展示了各种模式下代码的写法,以及需要注意的事项。 在新的 Catalog 和 DDL 部分,对 Catalog 的整体设计、DDL 的使用部分也都以实例进行拆分讲解。最后,对 Blink Planner 解析 SQL/Table API 的流程、Blink Planner 的改进以及优化的原理进行了讲解,希望对大家探索和使用 Flink SQL 有所帮助。

优秀的个人博客,低调大师

Apache Flink 进阶(十二):深度探索 Flink SQL

作者:贺小令(晓令)整理:郑仲尼 本文根据 Apache Flink 进阶篇系列直播整理而成,由阿里巴巴技术专家贺小令分享,文章将从用户的角度来讲解 Flink 1.9 版本中 SQL 相关原理及部分功能变更,希望加深大家对 Flink 1.9 新功能的理解,在使用上能够有所帮助。主要内容: 新 TableEnvironment 的设计与使用场景 新 Catalog 的设计以及 DDL 实践 Blink Planner 的几点重要改进及优化 新 TableEnvironment FLIP-32 中提出,将 Blink 完全开源,合并到 Flink 主分支中。合并后在 Flink 1.9 中会存在两个 Planner:Flink Planner 和 Blink Planner。 在之前的版本中,Flink Table 在整个 Flink 中是一个二等公民。而 Flink SQL 具备的易用性,使用门槛低等特点深受用户好评,也越来越被重视,Flink Table 模块也因此被提升为一等公民。而 Blink 在设计之初就考虑到流和批的统一,批只是流的一种特殊形式,所以在将 Blink 合并到 Flink 主分支的过程中,社区也同时考虑了 Blink 的特殊设计。 新 TableEnvironment 整体设计 图1 新 Table Environment 整体设计 从图 1 中,可以看出,TableEnvironment 组成部分如下: flink-table-common:这个包中主要是包含 Flink Planner 和 Blink Planner 一些共用的代码。 flink-table-api-java:这部分是用户编程使用的 API,包含了大部分的 API。 flink-table-api-scala:这里只是非常薄的一层,仅和 Table API 的 Expression 和 DSL 相关。 两个 Planner:flink-table-planner 和 flink-table-planner-blink。 两个 Bridge:flink-table-api-scala-bridge 和 flink-table-api-java-bridge,从图中可以看出,Flink Planner 和 Blink Planner 都会依赖于具体的 JAVA API,也会依赖于具体的 Bridge,通过 Bridge 可以将 API 操作相应的转化为 Scala 的 DataStream、DataSet,或者转化为 JAVA 的 DataStream 或者 Data Set。 新旧 TableEnvironment 对比 在 Flink 1.9 之前,原来的 Flink Table 模块,有 7 个 Environment,使用和维护上相对困难。7 个 Environment 包括:StreamTableEnvironment,BatchTableEnvironment 两类,JAVA 和 Scala 分别 2 个,一共 4 个,加上 3 个父类,一共就是 7 个。 在新的框架之下,社区希望流和批统一,因此对原来的设计进行精简。首先,提供统一的 TableEnvironment,放在 flink-table-api-java 这个包中。然后,在 Bridge 中,提供了两个用于衔接 Scala DataStream 和 Java DataStream 的 StreamTableEnvironment。最后,因为 Flink Planner 中还残存在着 toDataSet() 类似的操作,所以,暂时保留 BatchTableEnvironment。这样,目前一共是 5 个 TableEnvironment。 因为未来 Flink Planner 将会被移除,BatchTableEnvironment 就会被废弃,这样,未来就剩下 3 个 Environment 了,整个 TableEnvironment 的设计将更加简洁明了。 新 TableEnvironment 的应用 本节中,将介绍新的应用场景以及相关限制。 下图详细列出了新 TableEnvironment 的适用场景: 图2 新 Table Environment 适应场景 第一行,简单起见,在后续将新的 TableEnvironment 称为 UnifyTableEnvironment。在 Blink 中,Batch 被认为是 Stream 的一个特例,因此 Blink 的 Batch 可以使用 UnifyTableEnvironment。 UnifyTableEnvironment 在 1.9 中有一些限制,比如它不能够注册 UDAF 和 UDTF,当前新的 Type System 的类型推导功能还没有完成,Java、Scala 的类型推导还没统一,所以这部分的功能暂时不支持。可以肯定的是,这部分功能会在 1.10 中实现。此外,UnifyTableEnvironment 无法转化为 DataStream 和 DataSet。 第二行,Stream TableEnvironment 支持转化成 DataStream,也可以注册 UDAF 和 UDTF。如果是 JAVA 写的,就注册到 JAVA 的 TableEnvironment,如果是用 Scala 写的,就注册到 Scala 的 TableEnvironment。 注意,Blink Batch 作业是不支持 Stream TableEnvironment 的,因为目前没有 toAppendStream(),所以 toDataStream() 这样的语义暂时不支持。从图中也可以看出,目前操作只能使用 TableEnvironment。 最后一行,BatchTableEvironment 能够使用 toDataSet() 转化为 DataSet。 从上面的图 2 中,可以很清晰的看出各个 TableEnvironment 能够做什么事情,以及他们有哪些限制。 接下来,将使用示例对各种情况进行说明。 示例1:Blink Batch EnvironmentSettings settings = EnvironmentSettings.newInstance().useBlinkPlanner().inBatchMode().build(); TableEnvironment tEnv = TableEnvironment.create(settings); tEnv… tEnv.execute(“job name”); 从图 2 中可以看出,Blink Batch 只能使用 TableEnvironment(即UnifyTableEnvironment),代码中,首先需要创建一个 EnvironmentSetting,同时指定使用 Blink Planner,并且指定用 Batch 模式。之所以需要指定 Blink Planner,是因为目前 Flink 1.9 中,将 Flink Planner 和 Blink Planner 的 jar 同时放在了 Flink 的 lib 目录下。如果不指定使用的 Planner,整个框架并不知道需要使用哪个 Planner,所以必须显示的指定。当然,如果 lib 下面只有一个 Planner 的 jar,这时不需要显示指定使用哪个 Planner。 另外,还需要注意的是在 UnifyEnvironment 中,用户是无法获取到 ExecutionEnvironment 的,即用户无法在写完作业流程后,使用 executionEnvironment.execute() 方法启动任务。需要显式的使用 tableEnvironment.execute() 方法启动任务,这和之前的作业启动很不相同。 示例 2:Blink Stream EnvironmentSettings settings = EnvironmentSettings.newInstance().useBlinkPlanner().inStreamingMode().build(); StreamExecutionEnvironment execEnv = … StreamTableEnvironment tEnv = StreamTableEnvironment.create(execEnv, settings); tEnv… Blink Stream 既可以使用 UnifyTableEnvironment,也可以使用 StreamTableEnvironment,与 Batch 模式基本类似,只是需要将 inBatchMode 换成 inStreamingMode。 示例 3:Flink Batch ExecutionEnvironment execEnv = ... BatchTableEnvironment tEnv = BatchTableEnvironment.create(execEnv); tEnv... 与之前没有变化,不做过多介绍。 示例 4:Flink Stream EnvironmentSettings settings = EnvironmentSettings.newInstance().useOldPlanner().inStreamMode().build(); TableEnvironment tEnv = TableEnvironment.create(settings); tEnv… tEnv.execute(“job name”); Flink Stream 也是同时支持 UnifyEnvironment 和 StreamTableEnvironment,只是在指定 Planner 时,需要指定为 useOldPlanner,也即 Flink Planner。因为未来 Flink Planner 会被移除,因此,特意起了一个 OlderPlanner 的名字,而且只能够使用 inStreamingMode,无法使用 inBatchMode。 新 Catalog 和 DDL 构建一个新的 Catalog API 主要是 FLIP-30 提出的,之前的 ExternalCatalog 将被废弃,Blink Planner 中已经不支持 ExternalCatalog 了,Flink Planner 还支持 ExternalCatalog。 新 Catalog 设计 下图是新 Catalog 的整体设计: 图3 新 Catalog 设计 可以看到,新的 Catalog 有三层结构(..),最顶层是 Catalog 的名字,中间一层是 Database,最底层是各种 MetaObject,如 Table,Partition,Function 等。当前,内置了两个 Catalog 实现:MemoryCatalog 和 HiveCatalog。当然,用户也可以实现自己的 Catalog。 Catalog 能够做什么事情呢?首先,它可以支持 Create,Drop,List,Alter,Exists 等语句,另外它也支持对 Database,Table,Partition,Function,Statistics 等的操作。基本上,常用的 SQL 语法都已经支持。 CatalogManager 正如它名字一样,主要是用来管理 Catalog,且可以同时管理多个 Catalog。也就是说,可以通过在一个相同 SQL 中,跨 Catalog 做查询或者关联操作。例如,支持对 A Hive Catalog 和 B Hive Catalog 做相互关联,这给 Flink 的查询带来了很大的灵活性。 CatalogManager 支持的操作包括: 注册 Catalog(registerCatalog) 获取所有的 Catalog(getCatalogs) 获取特定的 Catalog(getCatalog) 获取当前的 Catalog(getCurrentCatalog) 设置当前的 Catalog(setCurrentCatalog) 获取当前的 Database(getCurrentDatabase) 设置当前的 Database(setCurrentDatabase) Catalog 虽然设计了三层结构,但在使用的时候,并不需要完全指定三层结构的值,可以只写Table Name,这时候,系统会使用 getCurrentCatalog,getCurrentDatabase 获取到默认值,自动补齐三层结构,这种设计简化了对 Catalog 的使用。如果需要切换默认的 Catalog,只需要调用 setCurrentCatalog 就可以了。 在 TableEnvironment 层,提供了操作 Catalog 的方法,例如: 注册 Catalog(registerCatalog) 列出所有的 Catalog(listCatalogs) 获取指定 Catalog(getCatalog) 使用某个 Catalog(useCatalog) 在 SQL Client 层,也做了一定的支持,但是功能有一定的限制。用户不能够使用 Create 语句直接创建 Catalog,只能通过在 yarn 文件中,通过定义 Description 的方式去描述 Catalog,然后在启动 SQL Client 的时候,通过传入 -e +file_path 的方式,定义 Catalog。目前 SQL Client 支持列出已定义的 Catalog,使用一个已经存在的 Catalog 等操作。 DDL 设计与使用 有了 Catalog,就可以使用 DDL 来操作 Catalog 的内容,可以使用 TableEnvironment 的 sqlUpdate() 方法执行 DDL 语句,也可以在 SQL Client 执行 DDL 语句。 sqlUpdate() 方法中,支持 Create Table,Create View,Drop Table,Drop View 四个命令。当然,inset into 这样的语句也是支持的。 下面分别对 4 个命令进行说明: Create Table:可以显示的指定 Catalog Name 或者 DB Name,如果缺省,那就按照用户设定的 Current Catalog 去补齐,然后可以指定字段名称,字段的说明,也可以支持 Partition By 语法。最后是一个 With 参数,用户可以在此处指定使用的 Connector,例如,Kafka,CSV,HBase 等。With 参数需要配置一堆的属性值,可以从各个 Connector 的 Factory 定义中找到。Factory 中会指出有哪些必选属性,哪些可选属性值。 需要注意的是,目前 DDL 中,还不支持计算列和 Watermark 的定义,后续的版本中将会继续完善这部分。 Create Table [[catalog_name.]db_name.]table_name( a int comment 'column comment', b bigint, c varchar )comment 'table comment' [partitioned by(b)] With( update-mode='append', connector.type='kafka', ... ) Create View:需要指定 View 的名字,然后紧跟着的是 SQL。View 将会存储在 Catalog 中。 CREATE VIEW view_name AS SELECT xxx Drop Table&Drop View:和标准 SQL 语法差不多,支持使用 IF EXISTS 语法,如果未加 IF EXISTS ,Drop 一个不存在的表,会抛出异常。 DROP TABLE [IF EXISTS] [[catalog_name.]db_name.]table_name SQL Client中执行DDL:大部分都只支持查看操作,仅可以使用 Create View 和 Drop View。Catalog,Database,Table ,Function 这些只能做查看。用户可以在 SQL Client 中 Use 一个已经存在的 Catalog,修改一些属性,或者做 Description,Explain 这样的一些操作。 CREATE VIEW DROP VIEW SHOW CATALOGS/DATABASES/TABLES/FUNCTIONS l USE CATALOG xxx SET xxx=yyy DESCRIBE table_name EXPLAIN SELECT xxx DDL 部分,在 Flink 1.9 中其实基本已经成型,只是还有一些特性,在未来需要逐渐的完善。 Blink Planner 本节将主要从 SQL/Table API 如何转化为真正的 Job Graph 的流程开始,让大家对 Blink Planner 有一个比较清晰的认识,希望对大家阅读 Blink 代码,或者使用 Blink 方面有所帮助。然后介绍 Blink Planner 的改进及优化。 图4 主要流程 从上图可以很清楚的看到,解析的过程涉及到了三层:Table API/SQL,Blink Planner,Runtime,下面将对主要的步骤进行讲解。 Table API&SQL 解析验证:在 Flink 1.9 中,Table API 进行了大量的重构,引入了一套新的 Operation,这套 Operation 主要是用来描述任务的 Logic Tree。 当 SQL 传输进来后,首先会去做 SQL 解析,SQL 解析完成之后,会得到 SqlNode Tree(抽象语法树),然后会紧接着去做 Validator(验证),验证时会去访问 FunctionManger 和 CatalogManger,FunctionManger 主要是查询用户定义的 UDF,以及检查 UDF 是否合法,CatalogManger 主要是检查这个 Table 或者 Database 是否存在,如果验证都通过,就会生成一个 Operation DAG(有向无环图)。 从这一步可以看出,Table API 和 SQL 在 Flink 中最终都会转化为统一的结构,即 Operation DAG。 生成RelNode:Operation DAG 会被转化为 RelNode(关系表达式) DAG。 优化:优化器会对 RelNode 做各种优化,优化器的输入是各种优化的规则,以及各种统计信息。当前,在 Blink Planner 里面,绝大部分的优化规则,Stream 和 Batch 是共享的。差异在于,对 Batch 而言,它没有 state 的概念,而对于 Stream 而言,它是不支持 sort 的,所以目前 Blink Planner 中,还是运行了两套独立的规则集(Rule Set),然后定义了两套独立的 Physical Rel:BatchPhysical Rel 和 StreamPhysical Rel。优化器优化的结果,就是具体的 Physical Rel DAG。 转化:得到 Physical Rel Dag 后,继续会转化为 ExecNode,通过名字可以看出,ExecNode 已经属于执行层的概念了,但是这个执行层是 Blink 的执行层,在 ExecNode 中,会进行大量的 CodeGen 的操作,还有非 Code 的 Operator 操作,最后,将 ExecNode 转化为 Transformation DAG。 生成可执行 Job Graph:得到 Transformation DAG 后,最终会被转化成 Job Graph,完成 SQL 或者 Table API 的解析。 Blink Planner 改进及优化 Blink Planner 功能方面改进主要包含如下几个方面: 更完整的 SQL 语法支持:例如,IN,EXISTS,NOT EXISTS,子查询,完整的 Over 语句,Group Sets 等。而且已经跑通了所有的 TPCH,TPCDS 这两个测试集,性能还非常不错。 提供了更丰富,高效的算子。 提供了非常完善的 cost 模型,同时能够对接 Catalog 中的统计信息,使 cost 根据统计信息得到更优的执行计划。 支持 join reorder。 shuffle service:对 Batch 而言,Blink Planner 还支持 shuffle service,这对 Batch 作业的稳定性有非常大的帮助,如果遇到 Batch 作业失败,通过 shuffle service 能够很快的进行恢复。 性能方面,主要包括以下部分: 分段优化。 Sub-Plan Reuse。 更丰富的优化 Rule:共一百多个 Rule ,并且绝大多数 Rule 是 Stream 和 Batch 共享的。 更高效的数据结构 BinaryRow:能够节省序列化和反序列化的操作。 mini-batch 支持(仅 Stream):节省 state 的访问的操作。 节省多余的 Shuffle 和 Sort(Batch 模式):两个算子之间,如果已经按 A 做 Shuffle,紧接着他下的下游也是需要按 A Shuffle 的数据,那中间的这一层 Shuffle,就可以省略,这样就可以省很多网络的开销,Sort 的情况也是类似。Sort 和 Shuffle 如果在整个计算里面是占大头,对整个性能是有很大的提升的。 深入性能优化及实践 本节中,将使用具体的示例进行讲解,让你深入理解 Blink Planner 性能优化的设计。 分段优化 示例 5 create view MyView as select word, count(1) as freq from SourceTable group by word; insert into SinkTable1 select * from MyView where freq >10; insert into SinkTable2 select count(word) as freq2, freq from MyView group by freq; 上面的这几个 SQL,转化为 RelNode DAG,大致图形如下: 图5 示例5 RelNode DAG 如果是使用 Flink Planner,经过优化层后,会生成如下执行层的 DAG: 图6 示例 5 Flink Planner DAG 可以看到,Flink Planner 只是简单的从 Sink 出发,反向的遍历到 Source,从而形成两个独立的执行链路,从上图也可以清楚的看到,Scan 和第一层 Aggregate 是有重复计算的。 在 Blink Planner 中,经过优化层之后,会生成如下执行层的 DAG: 图7 示例 5 Blink Planner DAG Blink Planner 不是在每次调用 insert into 的时候就开始优化,而是先将所有的 insert into 操作缓存起来,等到执行前才进行优化,这样就可以看到完整的执行图,可以知道哪些部分是重复计算的。Blink Planner 通过寻找可以优化的最大公共子图,找到这些重复计算的部分。经过优化后,Blink Planner 会将最大公共子图的部分当做一个临时表,供其他部分直接使用。 这样,上面的图可以分为三部分,最大公共子图部分(临时表),临时表与 Filter 和 SinkTable1 优化,临时表与第二个 Aggregate 和 SinkTable 2 优化。 Blink Planner 其实是通过声明的 View 找到最大公共子图的,因此在开发过程中,如果需要复用某段逻辑,就将其定义为 View,这样就可以充分利用 Blink Planner 的分段优化功能,减少重复计算。 当然,当前的优化也不是最完美的,因为提前对图进行了切割,可能会导致一些优化丢失,今后会持续地对这部分算法进行改进。 总结一下,Blink Planner 的分段优化,其实解的是多 Sink 优化问题(DAG 优化),单 Sink 不是分段优化关心的问题,单 Sink 可以在所有节点上优化,不需要分段。 Sub-Plan Reuse 示例 6 insert into SinkTabl select freq from (select word, count(1) as freq from SourceTable group by word) t where word like 'T%' union all select count(word) as freq2 from (select word, count(1) as freq from SourceTable group by word) t group by freq; 这个示例的 SQL 和分段优化的 SQL 其实是类似的,不同的是,没有将结果 Sink 到两个 Table 里面,而是将结果 Union 起来,Sink 到一个结果表里面。 下面看一下转化为 RelNode 的 DAG 图: 图 8 示例 6 RelNode DAG 从上图可以看出,Scan 和第一层的 Aggregate 也是有重复计算的,Blink Planner 其实也会将其找出来,变成下面的图: 图9 示例 6 Blink Planner DAG Sub-Plan 优化的启用,有两个相关的配置: table.optimizer.reuse-sub-plan-enabled (默认开启) table.optimizer.reuse-source-enabled(默认开启) 这两个配置,默认都是开启的,用户可以根据自己的需求进行关闭。这里主要说明一下 table.optimizer.reuse-source-enabled 这个参数。在 Batch 模式下,join 操作可能会导致死锁,具体场景是在执行 hash-join 或者 nested-loop-join 时一定是先读 build 端,然后再读 probe 端,如果启用 reuse-source-enabled,当数据源是同一个 Source 的时候,Source 的数据会同时发送给 build 和 probe 端。这时候,build 端的数据将不会被消费,导致 join 操作无法完成,整个 join 就被卡住了。 为了解决死锁问题,Blink Planner 会先将 probe 端的数据落盘,这样 build 端读数据的操作才会正常,等 build 端的数据全部读完之后,再从磁盘中拉取 probe 端的数据,从而解决死锁问题。但是,落盘会有额外的开销,会多一次写的操作;有时候,读两次 Source 的开销,可能比一次写的操作更快,这时候,可以关闭 reuse-source,性能会更好。当然,如果读两次 Source 的开销,远大于一次落盘的开销,可以保持 reuse-source 开启。需要说明的是,Stream 模式是不存在死锁问题的,因为 Stream 模式 join 不会有选边的问题。 总结而言,sub-plan reuse 解的问题是优化结果的子图复用问题,它和分段优化类似,但他们是一个互补的过程。 注:Hash Join:对于两张待 join 的表 t1, t2。选取其中的一张表按照 join 条件给的列建立hash 表。然后扫描另外一张表,一行一行去建好的 hash 表判断是否有对应相等的行来完成 join 操作,这个操作称之为 probe (探测)。前一张表叫做 build 表,后一张表的叫做 probe 表。 Agg 分类优化 Blink 中的 Aggregate 操作是非常丰富的: group agg,例如:select count(a) from t group by b over agg,例如:select count(a) over (partition by b order by c) from t window agg,例如:select count(a) from t group by tumble(ts, interval '10' second), b table agg ,例如:tEnv.scan('t').groupBy('a').flatAggregate(flatAggFunc('b' as ('c', 'd'))) 下面主要对 Group Agg 优化进行讲解,主要是两类优化。 1. Local/Global Agg 优化 Local/Global Agg 主要是为了减少网络 Shuffle。要运用 Local/Global 的优化,必要条件如下: Aggregate 的所有 Agg Function 都是 mergeable 的,每个 Aggregate 需要实现 merge 方法,例如 SUM,COUNT,AVG,这些都是可以分多阶段完成,最终将结果合并;但是求中位数,计算 95% 这种类似的问题,无法拆分为多阶段,因此,无法运用 Local/Global 的优化。 table.optimizer.agg-phase-strategy 设置为 AUTO 或者 TWO_PHASE。 Stream 模式下,mini-batch 开启 ;Batch 模式下 AUTO 会根据 cost 模型加上统计数据,选择是否进行 Local/Global 优化。 示例 7 select count(*) from t group by color 没有优化的情况下,下面的这个 Aggregate 会产生 10 次的 Shuffle 操作。 图 10 示例 7 未做优化的 Count 操作 使用 Local/Global 优化后,会转化为下面的操作,会在本地先进行聚合,然后再进行 Shuffle 操作,整个 Shuffle 的数据剩下 6 条。在 Stream 模式下,Blink 其实会以 mini-batch 的维度对结果进行预聚合,然后将结果发送给 Global Agg 进行汇总。 图 11 示例 7 经过 Local/Global 优化的 Count 操作 2. Distinct Agg 优化 Distinct Agg 进行优化,主要是对 SQL 语句进行改写,达到优化的目的。但 Batch 模式和 Stream 模式解决的问题是不同的: Batch 模式下的 Distinct Agg,需要先做 Distinct,再做 Agg,逻辑上需要两步才能实现,直接实现 Distinct Agg 开销太大。 Stream 模式下,主要是解决热点问题,因为 Stream 需要将所有的输入数据放在 State 里面,如果数据有热点,State 操作会很频繁,这将影响性能。 Batch 模式 第一层,求 distinct 的值和非 distinct agg function 的值,第二层求 distinct agg function 的值 示例 8 select color, count(distinct id), count(*) from t group by color 手工改写成: select color, count(id), min(cnt) from ( select color, id, count(*) filter (where $e=2) as cnt from ( select color, id, 1 as $e from t --for distinct id union all select color, null as id, 2 as $e from t -- for count(*) ) group by color, id, $e ) group by color 转化的逻辑过程,如下图所示: 图 12 示例 8 Batch 模式 Distinct 改写逻辑 Stream 模式 Stream 模式的启用有一些必要条件: 必须是支持的 agg function:avg/count/min/max/sum/first_value/concat_agg/single_value; table.optimizer.distinct-agg.split.enabled(默认关闭) 示例 9 select color, count(distinct id), count(*) from t group by color 手工改写成: select color, sum(dcnt), sum(cnt) from ( select color, count(distinct id) as dcnt, count(*) as cnt from t group by color, mod(hash_code(id), 1024) ) group by color 改写前,逻辑图大概如下: 图 13 示例 9 Stream 模式未优化 Distinct 改写后,逻辑图就会变为下面这样,热点数据被打散到多个中间节点上。 图14 示例 9 Stream 模式优化 Distinct 需要注意的是,示例 5 的 SQL 中 mod(hash_code(id),1024)中的这个 1024 为打散的维度,这个值建议设置大一些,设置太小产生的效果可能不好。 总结 本文首先对新的 TableEnvironment 的整体设计进行了介绍,并且列举了各种模式下TableEnvironment 的选择,然后通过具体的示例,展示了各种模式下代码的写法,以及需要注意的事项。 在新的 Catalog 和 DDL 部分,对 Catalog 的整体设计、DDL 的使用部分也都以实例进行拆分讲解。最后,对 Blink Planner 解析 SQL/Table API 的流程、Blink Planner 的改进以及优化的原理进行了讲解,希望对大家探索和使用 Flink SQL 有所帮助。

优秀的个人博客,低调大师

深度学习OSSIM关联分析(附源码注解)

从海量安全事件中挖掘有用的威胁信息与情报是当今讨论的热门话题,同时这也是一个难点?怎么实现呢?这里用到一种技术叫做关联分析,他也是SIEM(Security Information Event Management安全信息和事件管理)系统中最常见的事件检测手段,这并不是什么新鲜事物,20年前就已经有人提出来了。通常基于时序来对相同数据源或来自不同数据源的安全事件,使用关联规则来进行综合的关联分析,下面介绍关联分析的具体功能。 通常来说,一次恶意Gong JI会在多个安全设备或应用程序(如网络防火墙,交换机,Web 应用日志,SQL 日志,审核日志等)中留下痕迹. 然而,所有这些信息都是孤立隔绝的,被保存在不同的设备日志中,如果利用了关联分析技术就可以快速定位故障。 关联分析为什么有如此神通广大呢?其实后台有很多复杂的关联规则最为基础的,这些检测规则可以识别A t t a c k事件,实际上这些规则是人工在大量实践中总结出来生成对Gong JI事件的一种语言描述,并对其进行了精确分类,分类越细描述越准确,识别率就越高。 Tips:下文中“Gong Ji”“**”代表铭感词汇,你懂得。 一、关联分析核心思想 关联分析技术的核心思想是通过对某一类事件进行训练建立行为基线,基线范围外的事件视为异常事件来进行分类. 该算法较适合于本文检测场景,通常 SIEM 系统中绝大多数的日志为正常事件,通过对正常事件训练建模,来检测异常或Gong JI事件,这就是理论上说的One-Class SVM(单类支持向量机)。OSSIM系统中需要更多维度特征向量,才能准确判断Gong JI源,避免检测精度低或过拟合情况. 算法输入是经过 OSSIM 归一化后具备相同数据结构的安全事件,输出则为带有标记的安全事件,标记分为两类:正常(Negative)与Gong JI(Positive). 而OSSIM关联分析引擎的输出就是 One-Class SVM分类算法输出的带标记的正常与Gong JI事件。 通过深入分析 SIEM 系统的关联规则,其中最常见的配置字段如:event_id,timestamp,plugin_id,plugin_sid,src_ip,src_port,des_ip,des_port,protocol 等。 为了使关联分析规则不依赖于传感器配置,本文从 OSSIM 的规则库中抽取了几个重要的字段 plugin_id_name,plu-gin_id_description,sid_name,并将所有字段拆分成关键词标签,然后针对每一条检测规则生成其关键词标签统计模型,利用规则统计模型来代替原始的规则来检测Gong JI。 关联分析的核心通过一个或一组关联指令来完成,下面用SSH**破解的例子加以说明,如图1所示,SSH**破解(Brute Force)大约自UNIX诞生之后,就衍生出来的一种Gong JI行为,据统计发现大约有50%以上的用户名是root。一个低可靠性(low reliability)的SSH 服务器,在经过100登录尝试之后成功登录,而高可靠性(high reliability)的SSH服务器,则经过10000次登录才成功,那么关联引擎可通过在一定时间内,登录的次数,以及这些时间的不同源地址和相同目标IP地址,以及这些IP地址来自于那些国家,它们信誉度如何等信息来综合判定Gong JI以及作出响应。 图1 下面大家将亲生经历关联引擎的关联指令的组成结构。 二、 关联指令配置界面 OSSIM中关联指令的界面通过Configuration->Threat Intelligence->Directives打开,经过前面几节的内容的学习,大家或多或少的已经接触过关联指令的界面,下面我们进行一下归纳,如下图2所示。 图2 OSSIM 关联指令界面 关键功能解释: New Directive:单击此选项以从头开始创建一个新的指令。 Test Directives:单击此按钮,将检测当前新建/修改的指令是否正确。 Restart Server:单击此按钮,将重启ossim-server进程,凡是修改了任何一条关联指令都需重新启动Server,按这个按钮比你重启整个USM服务器更明智。 需要注意的是,虽然重启时间短暂,但重启期间所有关联数据会丢失。 图3 一条完整指令 ● Sensor:传感器,用于收集各种事件信息。 ● Protocol:协议,包括ANY、TCP、UDP、ICMP。 ● Sticky different: 还记得Linux基础是指中,用于文件及目录属性设定的sticky位吗?从OSSIM 4.3起在关联指令中添加了新属性,Sticky different(不同的粘粘位)域,规则中Sticky different为None。它是用来设定指令规则的属性, 有关Sticky different的取值大家可参考/etc/ossim/server/directives.xsd文件 <xs:simpleType name="stickydifferenttype"> ... ...略 </xs:simpleType> 当新收集的事件到达关联引擎时,它将和已有的事件相关联,如果事件属性(如IP地址和端口号)相同,但一个指令的属性里可以设置不同的粘粘位,比如None、DST_PORT、SRC_IP、PLUGIN_ID等,用来区别收到的不同事件,以便进行相互关联。例如在端口扫描类Gong JI中,如果你设置目标端口为Sticky different,那么只有来自不同目标端口的事件被关联。 三、在OSSIM 的Web UI中查看效果 下面我们查看实际的例子,如图4所示。 图4 STICKY DIFF 打开/etc/ossim/server/alienvault-dos.xml查看关联指令AvAttacks,Possible DDOS ● Username:事件中指定的用户名 ● Pass: 事件中指定的口令 ● Userdata1~Userdata8:事件中指定的数据域。 图5 查看更对关联规则属性 注意,From、To、Data source 、Event Type 列下方的号表示可修改,Action下的号代表可添加规则 ,但系统默认指令中的规则不允许修改。 四、深入关联规则 1. 基本操作 在OSSIM利用预先定义的规则(/etc/ossim/server/*.xml)来进行关联分析。那么我们如何操作呢,首先,我们通过Web界面,新建一个Correlation Directives,新建两个规则ssh和test,然后我们看看详细文件内容,路径在/etc/ossim/server目录,名为user.xml文件。其他默认规则由/etc/ossim/server/directives.xml定义,如图6所示。 图6自定义指令 当系统调用Directive下的策略是,首先根据categories.xml配置文件读取相应的XML配置文件,这些文件功能如下: 策略文件存储位置:/etc/ossim/server/及说明 Ø alienvault-attacks.xml AlienVault Gong JI类策略 Ø alienvault-bruteforce.xml AlienVault**破解类Gong JI Ø alienvault-dos.xml Alienvault拒绝服务类 Ø alienvault-malware.xml Alienvault 恶意软件(包括检测各种蠕虫的规则) Ø alienvault-misc.xml Alienvault各种失误类(Miscellaneous) Ø alienvault-network.xml Alienvault网络类 (开源版无此项) Ø alienvault-policy.xml Alienvault策略 Ø alienvault-scan.xml Alienvault扫描 Ø user.xml Alienvault用户自定义 如果OSSIM关联引擎读不到这些策略配置文件,在Analysis→Alarm就不会生成报警。接下来我们详细看看一个xml的例子。 2.理解规则树 关联引擎通过规则来实现对安全事件的关联分析,读者需要能够看懂OSSIM的规则,其中采用了特有的树形规则,在规则树中的每一个节点对应一条关联规则(rules)。在匹配时关联引擎将某段时间内收到的统一格式的报警,从根节点开始往叶子节点逐次匹配,系统根据匹配的结果可以进行事件聚合和再次提升报警级别。下面看个实例: 图7 自定义指令内容 从上图可以看出,这种基于事件序列的关联方法中的每条指令相当于一颗由规则组成的树,所以可以把它叫做基于树形指令(Directive)的关联方法,其基本思想是根据相关事件序列创建一系列的规则来表示Gong JI场景,在OSSIM系统中采用了XML来定义关联序列,关联分析引擎启动时就将所有关联导入每个关联规则序列由下面标签组成将上面的实际xml提炼一下,得到如下模板: <directive id="" name="" priority=""> <rule type="" name="" reliability="" occurence="” from="" to="" port_from="" port_to="" plugin_id=""plugin_sid=""> <rules> <rules> ...... </rules ...... </rule> </directive> 每个序列开头包括两个标签“directive_id”和“directive name”,而每个序列,又包括很多规则,规则之中又可以嵌套规则,即递归方法。 其中Rule 代表规则,规则后面代表一个可能发生的Gong JI场景,Event 代表在当前已发生的Gong JI场景下,一个Gong JI场景由若干条规则组成,这些规则可能是“与”和“或”的关系。这样表示的好处是,我们清楚的知道,如果一个Gong JI场景发生,那么只需要满足哪些规则即可。 通过计算每个Rule 里的Reliability 来确认这个Gong JI发生的可信度是多少。其中Scene 的id用directive_id来表示;前面讲过Reliability 可以是0~10之间的数,直接给可靠性赋值,也可以使一个修改量,表示当这个规则满足时将前一步Gong JI场景的可靠性做修改,将结果存入New_Reliability中;规则部分的其它属性代表了将和它做匹配的Event 的属性值;而和数据库的具体交互是通过Action 来表示。 下面我们看个实际的例子,下面这段指令主要是用来检测公网服务器是否可用,其中包含了两个规则。 <directive id="500000" name="Public Web Server unavailable" priority="1"> <rule type="detector" name="server unavailable" reliability="1" occurrence="1" from="192.168.11.100" to="ANY" port_from="ANY" port_to="ANY" plugin_id="1525" plugin_sid="1,7,9"> <rules> <rule type="monitor" name="Ping Baidu Server in order to check internet connection" reliability="10" from="www.baidu.com" to="www.baidu.com" plugin_id="2009" plugin_sid="1" condition="gt" value="0" interval="20" time_out="120" /> </rules> </directive> 关键参数解释: ● Detector: 探测器规则自动收集从代理发来的记录,包括Snort、Apache、Arpwatch等。 ● Monitor:监控器负责查询Ntop服务发来的数据和会话。 ● Name:事件数据库中的规则名称。 ● Reliability:可靠性 ● Plugin_id:插件ID,查看更多插件ID请参考《开源安全运维平台OSSIM最佳实践》第一章内容。 ● Plugin_sid:插件子ID号,分配给每个插件事件的子ID,比如Snort这个插件ID号为1001,而1501就是它的子ID号,代表Apache事件的响应代码,当然可不止这一件。 ● Condition:条件参数和下面6个逻辑有关系,必须符合的逻辑条件匹配规则如下: Ø eq – 等于(Equal) Ø ne – 不等于(Not equal) Ø lt – 小于(Lesser than) Ø gt – 大于(Greater than) Ø le – 小于等于(Lesser or equal) Ø ge – 大于等于(Greater or equal) ●Interval:间隔,这个值类似于time_out,用于监控类规则。 3.Alienvault-scan规则描述 再举一个OSSIM自带的例子,我们查看/etc/ossim/server/alienvault-scan.xml这个扫描Gong JI场景的策略文件,描述的结构就像个逻辑树,基本格式如下: Gree:level 1 Yellow : level2 Orange:level3 Red: level 4 下面给出部分代码内容,如图8所示 图8 Gong JI扫描指令示例 ● Occurrence,表示发生次数,默认为1,Gong JI场景不同这个值也不一样。这个值越大,越要引起管理员的警觉。这里表示的发生次数,也就是计算具有相同的 "from、to、port_from、port_to、plugin_id、plugin_sid" 发生次数,用以进行到关联模式中的下一规则。 这个数值在基于规则的关联分析中非常有用,例如当目标IP地址发生的异常行为事件数量的频率达到了一定数值时(某人针对该系统发动Gong JI),OSSIM会发出预警提示,管理员就可以有针对性开展深入调查。当然对源IP也适用。 From表示来源,源地址有以下几种形式: ①ANY,任意IP地址都可以匹配。 ②小数点和数字的IPv4形式。 ③以逗号隔开的IPv4地址,不带掩码。 ④可以使用任意数目的IP地址,中间用逗号隔开。 ⑤网络名称,可以使用网络中事先定义好的网络名称。 ⑥相对值,这种情况比较复杂,可以引用上条规则中的IP地址,例如: l 1:SRC_IP 表示引用前一条规则的源地址 l 2:DST_IP 表示引用前第二条的目的地址作为源地址 ⑦否定形式,可以使用地址的否定形式如 :"!192.168.150.200,HOME_NET"。 如果 HOME_NET = 192.168.150.0/24 将匹配一个C类子网排除192.168.150.200。 l Time_out,表示超时,其等待一定时间以匹配规则,时间超出则匹配失败。 l Port_from/Port_to ,表示来自哪里/目的端口,Port_from可以是ANY,Port_to,可以是一个端口号或一个逗号分隔的端口序列,1:DST_PORT,也可以否定端口例如,port=“!22,25”。 注意:dst_ip表示目的ip地址,而dst_port则表示目的端口号,ipaddr本地ip地址。 l Protocol(协议),可以使用以下字符串:TCP、UDP、ANY。 l Plugin_id(插件ID),参考plugin中的plugin_id。 l Plugin_sid(插件SID),每个事件都是分配一个子ID。 图9 规则树的嵌套 在OSSIM系统运行前,必须为已知的Gong JI场景建立对应的树形规则集,在启动时,系统将预先定义好的指令读入内存,在接收到一个事件 (event)后,先将该event与之前已经匹配,而还没有匹配完的指令中的规则进行匹配,然后在于其他规则匹配。那么在一个复杂的Gong JI场景中一条Event就会与多条规则匹配,如果此事件的风险值超过预先设定的阈值,则将其alarm属性设为真,并在Alarm界面中显示。 例如:plugin_id="1001" plugin_sid="2008609,2008641"。 在OSSIM 4.6系统中,有385个数据源,这里ID=1001,代表Snort检测插件,产品类型属于IDS,主要适用于Snort规则,其它插件ID还记得吗?如果忘了请返回本书第1章,查看“插件&功能”对应表。 实际上在OSSIM系统中,Snort插件ID范围是1001~1145。在OSSIM 4.8 版中位于Configuration→Threat Intelligence→Data Source可以查看到所有数据源。如图10所示。 图10 数据源分类 在Ossim的关联引擎运行之前,必须为所有已知的Gong JI场景建立对应的树形指令(在开源系统中提供了84条,在OSSIM 4.15的商业版本提供了1800余条,OSSIM USM 5.x提供2100+条),这也是它的核心价值的体现,在OSSIM启动时,系统会将所有预先定义好的指令读入内存,在接收到一个directive_event后,先将该事件与之前已经匹配,而还没有匹配完的指令中的规则匹配,然后再与其它指令的规则匹配。注意一个事件可以与很多指令中的规则匹配。 五、 完善规则 OSSIM系统中的关联规则生成主要通过安全专家人工编写,这种方式效率低下,且人工成本难以承受. 对于新出现的Gong JI和漏洞无法及时作出响应,检测规则的编写往往出现滞后的情况, 大家也许会考虑能否利用AI技术和数据融合技术进行智能化的数据挖掘呢,这些刚高级的黑科技在实际应用中往往生成的关联规则检测精度较低,检测结果不理想,实际应用效果有限。利用人工神经网络来自动生成关联规则,是关联分析研究领域今后发展的方向。 对于新手而言从一张白纸开始写规则有些难了,但是对照系统给出的默认规则,照葫芦画瓢还是可以实现的,不管这个模型是否完善,先用起来,然后逐步修改。在合适的时间,对自己进行***,然后监控SIEM的反应,观察它是否产生正确的警报,而警报是否提供足够的信息来协助相应这弄清楚发生了什么威胁,如果没有那就需要修改规则,然后你需要不断的优化阈值,你是否发现SIEM报警过于频繁,或者非常稀少,你需要调节阈值来解决,顺便说一句,面对动态的网络Gong JI,这个调节的过程没有终点如果读者在学习关联规则的过程中遇到各种问题也可以参考我的新书《开源安全运维平台OSSIM疑难解析:提高篇》。 附件: 下面分享的是OSSIM关联分析的一部分源代码。 /* ***该指令是否与根节点指令匹配,这里只检查根节点,并不检查指令的子节点** */gboolean sim_directive_match_by_event(SimDirective*directive, SimEvent*event) { SimRule*rule; gbooleanmatch; g_return_val_if_fail(directive,FALSE); g_return_val_if_fail(SIM_IS_DIRECTIVE(directive),FALSE); g_return_val_if_fail(!directive->_priv->matched,FALSE); g_return_val_if_fail(directive->_priv->rule_root,FALSE); g_return_val_if_fail(directive->_priv->rule_root->data,FALSE); g_return_val_if_fail(SIM_IS_RULE(directive->_priv->rule_root->data),FALSE); g_return_val_if_fail(event,FALSE); g_return_val_if_fail(SIM_IS_EVENT(event),FALSE); rule=SIM_RULE(directive->_priv->rule_root->data); match=sim_rule_match_by_event(rule,event); returnmatch; }/* ***这将检查事件是否可以与backlog中的某些数据匹配。backlog实际上是一个包含事件数据的指令。每个backlog条目都是一个树,其中包含来自一个指令的所有规则(它相当于是一个指令克隆)。其中每个规则(simrule)还包含与规则匹配的事件的数据。** * */gboolean sim_directive_backlog_match_by_event(SimDirective*directive, SimEvent*event) { GNode*node=NULL; g_return_val_if_fail(directive,FALSE); g_return_val_if_fail(SIM_IS_DIRECTIVE(directive),FALSE); g_return_val_if_fail(!directive->_priv->matched,FALSE); g_return_val_if_fail(directive->_priv->rule_curr,FALSE); g_return_val_if_fail(directive->_priv->rule_curr->data,FALSE); g_return_val_if_fail(SIM_IS_RULE(directive->_priv->rule_curr->data),FALSE); g_return_val_if_fail(event,FALSE); g_return_val_if_fail(SIM_IS_EVENT(event),FALSE); node=directive->_priv->rule_curr->children;while(node)//**我们必须对照backlog中的所有规则节点检查事件,除了根节点,因为它签入了sim_directive_match_by_event是从sim_organizer_correlation调用的.** { SimRule*rule=(SimRule*)node->data;if(sim_rule_match_by_event(rule,event)) { g_log(G_LOG_DOMAIN,G_LOG_LEVEL_DEBUG,"sim_directive_backlog_match_by_event;sim_rule_match_by_event:True"); time_ttime_last=time(NULL); directive->_priv->rule_curr=node;//每次事件匹配时,该指令都下一级到匹配的节点。下次将根据此级别检查事件。 //FIXME:父节点中可能存在内存泄漏. directive->_priv->time_last=time_last; directive->_priv->time_out=sim_directive_get_rule_curr_time_out_max(directive); sim_rule_set_event_data(rule,event);//这里我们将事件中的各个字段分配到规则中,所以每次我们进入规则时,我们可以看到匹配的事件. sim_rule_set_time_last(rule,time_last);if(!G_NODE_IS_LEAF(node)) { GNode*children=node->children;while(children) { SimRule*rule_child=(SimRule*)children->data; sim_rule_set_time_last(rule_child,time_last); sim_directive_set_rule_vars(directive,children); children=children->next; g_log(G_LOG_DOMAIN,G_LOG_LEVEL_DEBUG,"sim_directive_backlog_match_by_event:Therearechildrensin%ddirective",directive->_priv->id); } }else { directive->_priv->matched=TRUE; g_log(G_LOG_DOMAIN,G_LOG_LEVEL_DEBUG,"sim_directive_backlog_match_by_event:Thedirective%dhasmatched",directive->_priv->id); }returnTRUE; }else { g_log(G_LOG_DOMAIN,G_LOG_LEVEL_DEBUG,"sim_directive_backlog_match_by_event:sim_rule_match_by_event:False"); } node=node->next; }returnFALSE; }/* *检查指令中的所有节点规则,以查看....... */gboolean sim_directive_backlog_match_by_not(SimDirective*directive) { GNode*node=NULL; GNode*children=NULL; g_return_val_if_fail(directive,FALSE); g_return_val_if_fail(SIM_IS_DIRECTIVE(directive),FALSE); g_return_val_if_fail(!directive->_priv->matched,FALSE); g_return_val_if_fail(directive->_priv->rule_curr,FALSE); g_return_val_if_fail(directive->_priv->rule_curr->data,FALSE); g_return_val_if_fail(SIM_IS_RULE(directive->_priv->rule_curr->data),FALSE); node=directive->_priv->rule_curr->children;while(node) { SimRule*rule=(SimRule*)node->data;//如果规则已超时&& if((sim_rule_is_time_out(rule))&&(sim_rule_get_not(rule))&&(!sim_rule_is_not_invalid(rule))) { time_ttime_last=time(NULL); directive->_priv->rule_curr=node; directive->_priv->time_last=time_last; directive->_priv->time_out=sim_directive_get_rule_curr_time_out_max(directive); sim_rule_set_not_data(rule);if(!G_NODE_IS_LEAF(node))//这不是最后的节点,他还有一些子节点. { children=node->children;while(children) { SimRule*rule_child=(SimRule*)children->data; sim_rule_set_time_last(rule_child,time_last); sim_directive_set_rule_vars(directive,children); children=children->next; } }else//lastnode! { directive->_priv->matched=TRUE; }returnTRUE; } node=node->next; }returnFALSE; }/* *backlog&directives几乎是相同的:backlog是存储指令并填充事件数据的地方。 *“node”是子节点函数。我们需要从引用其级别的节点向该节点添加src_ip、port等。如果“node”参数是根节点->子节点1->子节点2中的children2,并且我们在children2中有1:plugin-sid,那么我们必须将根节点中的plugin-sid添加到children2中。 */void sim_directive_set_rule_vars(SimDirective*directive, GNode*node) { SimRule*rule; SimRule*rule_up; GNode*node_up; GList*vars; GInetAddr*ia; GInetAddr*sensor; gintport; gintsid; SimProtocolTypeprotocol; gchar*aux=NULL; g_return_if_fail(directive); g_return_if_fail(SIM_IS_DIRECTIVE(directive)); g_return_if_fail(node); g_return_if_fail(g_node_depth(node)>1); rule=(SimRule*)node->data; vars=sim_rule_get_vars(rule); 2019 最 新 作 品

优秀的个人博客,低调大师

Zookeeper深度学习(三):源码分析-Leader选举

前两篇文章已经对Zookeeper是什么,能做什么,以及Paxos算法和底层使用的Zab协议做了详细的描述(如果你还不了解Paxos算法和Zab协议建议先到文稿末尾查看前两篇再来学习本篇文章),相信大家一定都有了自己的理解,那么本文就开始真正走进Zookeeper底层源码的学习。俗话说授人以鱼不如授人以渔,今天我们就来分析下Zookeeper非常重要的一个环节--Leader选举。 一、前言 1. 基本概念 SID:服务器ID,用来标示ZooKeeper集群中的机器,每台机器不能重复,和myid的值一致 ZXID:事务ID Vote: 选票,具体的数据结构后面有 Quorum:过半机器数 logicalclock:逻辑时钟(选举轮次),zk服务器Leader选举的轮次 服务器类型: 在zk中,引入了Leader、Follwer和Observer三种角色。zk集群中的所有机器通过一个Leader选举过程来选定一台被称为Leader的机器,Leader服务器为客户端提供读和写服务。Follower和Observer都能够提供读服务,唯一的区别在于,Observer机器不参与Leader选举过程,也不参与写操作的过半写成功策略。因此,Observer存在的意义是:在不影响写性能的情况下提升集群的读性能。 服务器状态: LOOKING:Leader选举阶段; FOLLOWING:Follower服务器和Leader保持同步状态; LEADING:Leader服务器作为主进程领导状态; OBSERVING:观察者状态,表明当前服务器是Observer,不参与投票; 选举的目的就是选择出合适的Leader机器,由Leader机器决定事务性的Proposal处理过程,实现类两阶段提交协议(具体是ZAB协议)。 二、启动选举主流程 在zk服务器集群启动过程中,经QuorumPeerMain中,不光会创建ZooKeeperServer对象,同时会生成QuorumPeer对象,代表了ZooKeeper集群中的一台机器。在整个机器运行期间,负责维护该机器的运行状态,同时会根据情况发起Leader选举。 QuorumPeer是一个独立的线程,维护着zk机器的状态。 本次主要介绍的是选举相关的内容,之后的行文都是从startLeaderElection中衍生出来的。 1. QuorumPeer维护集群机器状态 QuorumPeer的职责就是不断地检测当前的zk机器的状态,执行对应的逻辑,简单来说,就是根据服务所处的不同状态执行不同的逻辑。为了避免篇幅过长,影响阅读体验,删除了一部分逻辑后,代码如下: 当机器处于LOOKING状态时,QuorumPeer会进行选举,但是具体的逻辑并不是由QuorumPeer来负责的,整体的投票过程独立出来了,从逻辑执行的角度看,整个过程设计到两个主要的环节: 与其他的zk集群机器通信的过程 实现具体的选举算法 QuorumPeer中默认使用的选举算法是FastLeaderElection。 三、 选举过程中的整体架构 zk提拱多种选举算法 不过之前版本的都废弃掉了,一般默认使用FastLeaderElection 也就是在配置文件中设置 electorArg=3。在集群启动的过程中,QuorumPeer会根据配置实现不同的选举策略: 1. QuorumCnxManager 如果ClientCnxn是zk客户端中处理IO请求的管理器,QuorumCnxManager是zk集群间负责选举过程中网络IO的管理器,在每台服务器启动的时候,都会启动一个QuorumCnxManager,用来维持各台服务器之间的网络通信。 QuorumCnxManager、 Listener、 SendWorker、 RecvWorker 的分工很明确 准确的说 QuorumCnxManager这个类的职责也很明确,就是负责监听端口 发消息 读消息 其中: Listener 监听连接,维护与其他服务器的连接; SendWorker 负责根据Listener保存的连接信息 向对应的server发送(投票)信息; RecvWorker 获取其他server的(投票)信息 并存入队列; 对于每一台zk机器,都需要建立一个TCP的端口监听,在QuorumCnxManager中交给Listener来处理,使用的是Socket的阻塞式IO(默认监听的端口是3888,是在config文件里面设置的)。在两两相互连接的过程中,为了避免两台机器之间重复地创建TCP连接,zk制定了连接的规则:只允许SID打的服务器主动和其他服务器建立连接。实现的方式也比较简单,在receiveConnection中,服务器会对比与自己建立连接的服务器的SID,判断是否接受请求,如果自己的SID更大,那么会断开连接,然后自己主动去和远程服务器建立连接。这段逻辑是由Listener来做的,且Listener独立线程。核心代码如下: QuorumCnxManager这里只负责与其他server的信息交换 但不负责信息的生成与处理 数据的处理就要交给对应的选举算法进行处理了。 以上内容主要是建立各台zk服务器之间的连接通信过程,具体的选举策略zk抽象成了Election,主要分析的是FastLeaderElection方式(选举算法的核心部分): 四、正式选举(FastLeaderElection选举算法) 上面QuorumPeer在一直循环的检测当前主机的状态,如果是Looking状态,就会进行新一轮的选举,通过: setCurrentVote(makeLEStrategy().lookForLeader()); 也就是FastLeaderElection的lookForLeader来进行leader选择,实现代码不多,不过有些地方还是不好理解的。。。 talk is cheap, show me code! 接下来,我们将org.apache.zookeeper.server.quorum.FastLeaderElection#lookForLeader 方法中的逻辑分为5个步骤来理解,这样我认为比直接看一整段代码效果好,如果你觉得这样看比较碎片,可以打开源码对照我们这里梳理的流程,在整体梳理几遍(看源码一定得多啃几遍,一遍基本上搞下不来)。 1. 创建选举对象,做选举前的初始化工作 2. 将自己作为新的Leader投出去(我选我) 这里需要注意的是更新选票时获取的epoch是当前Server的epech,即上一轮leader的epoch; 着重看一下sendNotifications方法,这里是将当前机器的选票发送给所有参与投票的机器,不包括Observer: 3. 验证当前自己的选票与大家的选票谁更适合做Leader 这里有一些点还是比较难以理解的,比如当从票箱取出的选票为null时需要判断当前服务器是集群其他服务器是否保持连接状态,不过都已经标注了详细的注释,相信仔细看两遍一定可以理解的。 这里的 recvqueue 就是所有收到其它服务器投票后的票箱(带头结点的单向链表),recvqueue.poll 即取出第一票,这里我们看下poll方法做的操作: 一目了然,就是将链表头的next指针指向自己,即删除头节点,然后将head 指向之前头节点的next,也就是下一个元素,返回第一个元素的值,将当前第一个元素置为null,也就是新的头节点。 4. 判断本轮选举中否应该结束了 到了这一步,开始遍历当前服务器收到的选票中是否已经有过半的参与者选择了当前服务器的选票(经过上面的步骤,当前服务器选票已经修改为最合适的),我们一起看下 org.apache.zookeeper.server.quorum.FastLeaderElection#termPredicate 方法: 如果当前选票没有过半,直接break继续取下一票进行判断,这个很好理解。 可是问题来了,如果已经过半了,后面的这个步骤为什么还要取下一票在和当前选票比看谁更适合呢? 我们一起来看下面的代码: 我初次看的时候也是难以理解,为什么取出下一票后判断比当前选票更合适后要在将选票放回去,然后break呢? 上面的代码我已经写了注释,这个while 循环的目的是要遍历完票箱防止有比当前更合适的选票, 如果 n==null 则说明没有找到任何比当前“过半选票更合适的选票”,进行收尾工作,修改当前主机状态: proposedLeader == self.getId()) ? ServerState.LEADING: learningState() 然后清空队列,返回最终选票。 如果剩下的选票中有比自己更合适的则将其放回票箱,重新走一遍前面的流程,修改当前选票广播。 说明:票箱也就是当前接收选票的容器 recvset,本质是一个HashMap,key为投票者的serverId,所以收到多次投票也只是更新选票而已,设计很是巧妙呀! 5. 无需选举的情况 最后这块的代码虽然不多,可是却是最难理解的,上面的注释中分析了为什么选举过程中可以收到通知发送者状态为FOLLOWING, LEADING, OBSERVING 的情况,结合注释还得仔细的看几遍,其实就是为了处理下面这三种情况下的选举状态: 新的Server(非Observer)加入到正常运行的集群 当Leader挂了,并不是所有follower都同时能够感知到leader挂了,先感知到的server会发送通知给其它server,但由于其它server还未感知到,所以它们发送给这个server的通知状态就是FOLLOWING 本轮选举中其它Server已经选举出了新的leader,但还没有通知到当前server,这些已经知道leader选举完毕的server向该server发送的通知就是LEADING或FOLLOWING 五、总结 以上就是zk的默认选举流程,按照ZAB协议的两种状态分析: 初始化的时候,处于同一轮次进行投票直到投票选择出一个Leader 崩溃恢复阶段: Leader服务器挂了,那么经历的和初始化流程类似的过程,选择Leader Follower服务器挂了,那么自己在执行选举的过程中,会收到其他服务器给的Leader选票信息(对应上文无需选举情况中的分支代码),也可以确定Leader所属 本篇文章主要介绍了Zk leader选举过程中的代码逻辑,包括机器宕机重启以及集群初始化时QuorumPeer 都会检测到机器的状态为LOOKING,然后调用 FastLeaderElection 的 lookForLeader 方法进行 leader选举。 这块的代码虽然不多,可是理解起来还是有一定的难读的,建议大家结合本文多度几遍,加深印象。 推荐阅读 初探|Zookeeper基础之Paxos算法详解(一) Zookeeper实现之Zab协议详解(二) ​

优秀的个人博客,低调大师

系列文章深度解读|SwiftUI 背后那些事儿

前言 今年苹果的WWDC你看了吗?苹果在2019年的WWDC的重头戏当然非SwiftUI莫属:全新的声明式语法、绑定式API、和响应式变成框架Combine。这一切的一切都预示着即将在Apple Native布局系统掀起一场革命。为此,苹果在很多方面都做了努力,这才促成了SwiftUI现在的样子。想要了解Swift的新特性、SwiftUI数据流和SwiftUI布局系统等新知识吗?一起来看吧。 Swift 5.1 新语法 单表达式隐式返回值 在 Swift 5.0 之前的语法中,如果一个闭包表达式只有一个表达式,那么可以省略 return 关键字。 现在 Swift 5.1 以后的版本中计算属性和函数语句同样适用。如 // before swift 5.0 struct Rectangle { var width = 0.0, h

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册