首页 文章 精选 留言 我的

精选列表

搜索[日活数],共10000篇文章
优秀的个人博客,低调大师

bucket表:数仓存算分离中CU与DN解绑的关键

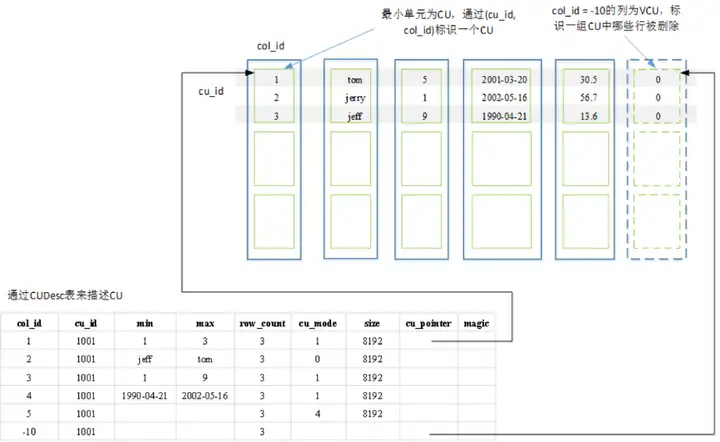
摘要:Bucket存储是数据共享中重要的一环,当前阶段,bucket存储可以将列存中的CU数据和DN节点解绑。 本文分享自华为云社区《存算分离之bucket表——【玩转PB级数仓GaussDB(DWS)】》,作者:yd_278301229 。 在云原生环境,用户可以自由配置cup型号、内存、磁盘、带宽等资源,需要在计算和IO之间做平衡;如果计算和存储耦合,扩缩容时数据要在节点之间移动,同时还要对外提供计算,性能会大受影响。如果存算分离,计算出和存储层可以独立增加节点互不干扰,这其中一个关键点是做到数据共享。Bucket存储是数据共享中重要的一环,当前阶段,bucket存储可以将列存中的CU数据和DN节点解绑。 一、bucket表在存算分离中的作用 通过存算分离,把DWS完全的shared nothing架构改造成计算层shared nothing + 存储层shared storage。使用OBS替换EVS,OBS对append only存储友好,与列存CU存储天然适配;由于存算分离数据共享,对写的并发性能不高,在OLAP场景下读多写少更有优势,这一点也是和列存相匹配的,目前主要实现的是列存的存算分。 在当前。bucket表在存储层共享中,为了将CU数据和DN节点解绑,主要做了两件关键的事,CUID和FILEID全局统一管理。我们来看看为什么这两件事能把CU和DN节点解绑以及带来的好处。 为了解释这个问题,先看看目前shared nothing架构中,建库和存储数据的过程。 二,当建立一张列存表并存储数据时,我们在做什么 建一张列存表时,主要要做以下两步: 1,系统表中建立表的数据。 2,为列存建立CUDesc表、Delta表等辅助表 当存储数据时,主要做以下几步: 1,根据数据分布方式,决定数据存储到哪个DN。 2,把列存存储时需要的辅助信息填入CUDesc表、Delta表等辅助表。 3,把存储用户数据的CU存储本地DN。 在上面的过程中,由于DN之间互不干扰,那就需要各自管理自己的存储的表的信息。 CUDesc表的一大功能是CU数据的“指路牌”,就像指针一样,指出CU数据存储的位置。靠的是CUID对应的CUPoint(偏移量),加上存储在DN的文件位置就能标注出具体的CU数据,而文件名就是系统表中的relfilenode。 由于在MPPDB的存算一体中,数据都存储在DN节点,DN节点之间互不干扰,CUID和relfilenode各个DN节点自己管理,只要自己不出问题就行了,也就是“各人自扫门前雪莫管他人瓦上霜”,例如下图,显示一张列存表在集群中的存储状态。 CN把要存储的数据根据分布算法(例如对DN数量做除法取余数)把1,3,5存到DN1,把2,4,6存到DN2。DN1此时生成存储CU文件的relfilenode是12345,每插入一次CUID,就把该表的CUDesc表CUID自增,DN1只要把自己的数据管理好,与DN2无关。DN2同理。 三,数据共享和扩缩容时,遇到的困难 1,数据共享时遇到的困难 如上所述,当用户想查询数据1,2,4,6时,该怎么办。因为DN1和DN2都不可能单独完成任务,就需要共享数据了。问题就来了,DN间肯定是想以最小代价来完成数据共享,系统表最小,CUDesc表也很小(就像指针一样,同等规模下,只有CU数据的1/3000左右),CU数据最大。假如最后决定以DN2来汇聚所有结果,就算DN1把系统表和CUDesc表中的数据传给DN2,DN2也看不懂,因为在DN2上,relfilenode为12345可能是另外一张表,cudesc表为中CUID为1001的CUPoint也不知道是指向哪儿了(data1,data2),没办法,只能是DN1自己计算,最后把data1的CU数据通过stream算子发送给DN2。DN1迫不得已选了最难的那条路,CU的数据量太大,占用了网络带宽,还需要DN1来参与计算,并发上不去。 2,扩缩容时遇到的困难 当用户发现DN1,DN2节点不够用时,想要一个DN3,该怎么办。根据分布假设的算法(对DN数量做除法取余数),data3和data6应该要搬去DN3才对。系统表还比较好搬,无非是在DN3上新建一份数据,CUDesc表也好搬,因为数据量小,再把CUID和CUPoint按照DN3的逻辑写上数据就好了,CU数据也要搬,但是因为CU数据量大,会占用过多的计算资源和带宽,同时还要对外提供计算。真是打了几份工,就赚一份工资。 总结起来,困难主要是 1)系统表元数据(计算元数据) 每个节点有自己的系统表元数据,新增dn必须创建“自己方言”的系统表,而实际上这些系统表内容是“相同的”,但是dn之间互相不理解; 2)CUDesc元数据(存储元数据) 每个节点的CUID自己分配,同一个CUID在不同节点指向不同的数据,CU无法在dn之间迁移,因为迁移后会混乱,必须通过数据重分布生成dn “自己方言的CUID” CU的可见性信息(clog/csnlog)各自独立管理,dn1读取dn2的cudesc行记录之后,不知道记录是否可见 3)CU用户数据 filepath(relfilenode) dn节点各自独立管理,dn1不知道到哪里读取dn2的数据 四、揭秘CU与DN解绑的关键——bucket表 1,存储映射 bucket表的存储方式如图,CU的管理粒度不再是DN,而是bucket,bucket是抽象出来的一个概念,DN存储的,是系统元数据和bucket对应的CUDesc元数据,由于在bucket作为存储粒度下,CUID和FILEID是全局统一管理的,DN只需要懂全局的规则,并且拿到别的bucket对应的CUDesc元数据,那就可以很方便的去OBS上拿到CU数据了。通过这种方式,把本该存储在DN上的CU数据,映射到OBS上,可以保证DN间共享数据时相互独立,换句话说,每个DN都读的懂其他DN的CUDesc数据,不再需要把CU数据喂到嘴边了。 2,全局CUID和FILEID表生成 CUID不再是各节点自己管理生成,而是全局唯一的。其原因是CUID与bucket号绑定,特定的bucket号只能生成特定的globalCUID,与此同时,relfilenode不再作为存储的文件名,而是作为存储路径。CU存放的文件名为relfilenode/C1_fileId.0,fileId的计算只与bukcet号和seqno有关。 这样V3表就建立起了一套映射关系(以V2表示存算一体表,V3表示为bucket表): step 1,数据插入哪一个bucket由分布方式来确定,例如是RR分布,那么就是轮巡插入bucket。 step 2,CUID是多少,由bucket粒度级别的CUID来确定,比如+1自增作为下一个CUID。 step 3,在bucket上存储bucket粒度级别的fileId。 step 4,生成全局唯一fileId,由bucketid和bucket粒度级别的fileId来生成,对应生成的CU插入该fileId文件名的文件。 setp 5,生成全局唯一globalCUID。由bucketid和bucket粒度级别的CUID计算得到全局唯一的globalCUID。 CUDesc表中,也为bucket表新建了一个属性fileId,用来让DN查找到OBS上的CU数据所在的文件。 3,共享数据和扩缩容的便利 如上所述,DN可以通过全局CUID和FILEID来找到CU数据,在数据共享时,不再需要其他DN参与大量的计算和搬迁CU,扩缩容时,也不需要搬迁CU了,只需要正确生成系统表中的信息和搬迁CUDesc即可。 最后,来看一看bucket表在OBS上存储的CU数据: 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

面对锁等待难题,数仓如何实现问题的秒级定位和分析

摘要:GaussDB(DWS)提供了两个集群级别的视图快速识别和查询锁等待和分布式死锁信息,可实现此类问题的秒级问题的定位和分析。 本文分享自华为云社区《GaussDB(DWS)运维 -- 一键式锁等待和分布式死锁检测》,作者:譡里个檔。 锁是GaussDB(DWS)实现并发管理的关键要素,GaussDB(DWS)锁类别有表级锁、分区级锁(和表级锁一致)、事务锁、咨询锁等,当前业务最常用的是表级锁、分区级锁(和表级锁一致)、事务锁。不同的SQL语句执行时需要申请并持有对应的锁,当这些锁资源存在互斥时,对应的业务SQL就会产生等待;这种等待会产生下面几种后果: 持锁的一方释放锁(一般对应的动作为持锁的事物提交),等待锁的一方申请到锁,然后继续执行 持锁的一方事物长时间未提交,等待锁的一方因为锁等待超时导致作业报错 A实例上持锁事物和申请锁的事物在B实例上角色互换,产生分布式死锁(具体见下文介绍)。这种场景下需要首先达到锁等待超时的事物报错回滚时释放锁资源,然后另外一个事物申请到才能正常进行 从上述的描述可以看到,锁等待特别是分布式死锁对业务影响很大,轻则产生等待导致业务性能抖动和下降,甚至业务报错。GaussDB(DWS)提供了两个集群级别的视图快速识别和查询锁等待和分布式死锁信息,可实现此类问题的秒级定位和分析。 1)锁等待检测视图pgxc_lock_conflicts 【功能】查询当前库里面不同节点上的锁等待信息 【解析】执行如下查询结果 postgres=# SELECT * FROM pgxc_lock_conflicts ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | username | gxid | xactstart | queryid | query | pid | mode | granted -----------+----------+----------+---------+-----------------------+----------+------+-------+---------------+-----------+----------+-------------------------------+--------------------+----------------------------------------------------------+-----------------+---------------------+--------- partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 104145741383084190 | alter table table_partition_num_3 truncate partition p1; | 140160505136896 | AccessExclusiveLock | f partition | cn_5001 | postgres | public | table_partition_num_3 | p1 | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 0 | alter table table_partition_num_3 truncate partition p1; | 140160568055552 | AccessExclusiveLock | t relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24102679 | 2022-02-17 18:41:36.580348+08 | 175921860444402398 | truncate xxx; | 140418767369984 | AccessShareLock | f relation | cn_5002 | postgres | public | xxx | | | | | dfm | 24097147 | 2022-02-17 17:56:03.113194+08 | 0 | truncate xxx; | 140420489144064 | AccessExclusiveLock | t (4 rows) 如上的SQL显示 在节点cn_5001的postgres里面的表public.table_partition_num_3的分区p1上存在分区级别(partition)的锁冲突。在当前的锁冲突中线程140160568055552持有锁(mode = true),锁级别是AccessExclusiveLock,执行语句为alter table table_partition_num_3 truncate partition p1。线程140160568055552在等待(mode = false)AccessExclusiveLock锁,等待锁的语句也是alter table table_partition_num_3 truncate partition p1。 在节点cn_5002的postgres里面的表http://public.xxx上存在表级别(relation)的锁冲突。线程140420489144064持有锁AccessExclusiveLock(mode = true),线程140418767369984在等待(mode = false)AccessShareLock锁 2)分布式锁等待检测视图pgxc_deadlock 【功能】查询当前库里面不同节点上的分布式死锁信息 【解析】执行如下查询结果 postgres=# SELECT * FROM pgxc_deadlock ORDER BY nodename,dbname,locktype,nspname,relname,partname; locktype | nodename | dbname | nspname | relname | partname | page | tuple | transactionid | waitusername | waitgxid | waitxactstart | waitqueryid | waitquery | waitpid | waitmode | holdusername | holdgxid | holdxactstart | holdqueryid | holdquery | holdpid | holdmode ----------+----------+----------+---------+---------+----------+------+-------+---------------+--------------+----------+-------------------------------+--------------------+-----------------------------------------------------+-----------------+-----------------+--------------+----------+-------------------------------+-------------+--------------+-----------------+--------------------- relation | cn_5001 | postgres | public | t2 | | | | | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 104145741383110084 | EXECUTE DIRECT ON(dn_6003_6004) 'SELECT * FROM t2'; | 140160505136896 | AccessShareLock | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 0 | TRUNCATE t2; | 140160421234432 | AccessExclusiveLock relation | cn_5002 | postgres | public | t1 | | | | | j00565968 | 24112465 | 2022-02-17 20:02:24.220656+08 | 175921860444446866 | EXECUTE DIRECT ON(dn_6001_6002) 'SELECT * FROM t1'; | 140418784151296 | AccessShareLock | j00565968 | 24112406 | 2022-02-17 20:01:57.421532+08 | 0 | TRUNCATE t1; | 140421763163904 | AccessExclusiveLock (2 rows) 如上的SQL显示,在postgres库里面 节点cn_5001上 事务24112465通过线程140160421234432持有表public.t2的AccessExclusiveLock锁 事务24112406通过线程140160505136896在等待申请表public.t2的AccessShareLock锁 节点cn_5002上 事务24112465通过线程140418784151296在等待申请表public.t1的AccessShareLock锁 事物24112406通过线程140421763163904持有表public.t1的AccessExclusiveLock锁 如果我们把资源的持有情况按照持有到申请定义一个防线的话,可以形成如下表格 从上述可以看出,事务24112465在节点cn_5001持有表public.t2的AccessExclusiveLock锁,等待申请申请表public.t1的AccessShareLock锁;事务24112406在节点cn_5002上持有表public.t1的AccessExclusiveLock锁,等待申请申请表public.t2的AccessShareLock锁;事务24112406和事务24112465只有等待彼此提交才能申请到锁资源,让自己继续执行,这种在多个实例上的分布式等待关系形成了一个环状,我们称这种现象为分布式死锁。 3) 锁等待和分布式死锁的区别 对于分布式死锁,只能一个事务因为锁等待(参数lockwait_timeout)超时回滚的时候,另外一个事务才能进行下去;或者人工干预kill或者cancel其中一个事务,让另外一个事务进行下去。 对于没有分布式死锁的锁等待,这种一般不需要人工干涉,等待持锁事务正常执行完成之后另外一个事务就可以正常执行;但是如果事务持锁时间超过锁等待超时参数(参数lockwait_timeout),等待锁的事务会因为锁等待超时失败。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

50 亿观众的 “云上奥运”,顶级媒体背后的数智化力量

东京 2020 奥运会即将闭幕,本届奥运会由于疫情限制,东京地区赛事以无观众的空场形式举行,在无法亲临现场的情况下,全球观众首次以 “云上” 方式观看奥运。 “云上奥运” 该如何保证赛事的生动性和现场感,缩短观众与赛场之间的距离,随时随地捕捉精彩赛事瞬间?阿里云作为本届奥运会最高等级的全球合作伙伴,支撑奥运会实现首次全球云上转播,供各大转播商使用。同时,阿里云支持国内顶级媒体实现云上 “采编发” 整体流程的验证,为媒体跨地域协同报道提供了宝贵的实战经验。 新华社作为中国国家通讯社和世界性通讯社,是此次全球仅有的具有资格在主新闻中心展示奥运精彩瞬间 6 家世界级媒体之一。东京奥运会也是新华社第一次作为国际通讯社报道奥运,新华社派出 133 人的奥运会报道团队对奥运现场进行全方位的报道,通过云技术,前方记者和后方团队可以进行密切配合,使得报道内容能够更高效完成。 针对阿里云对新华社 “云上制播” 的技术助力,具体到跨地域 “采编发” 协同制播流程的实现、探索、验证,分为以下几步: 异地协同,网络先行 媒体素材内容能否高效地传输回来,网络保障是关键所在。早在今年年初,新华社考虑到信号和视频内容传输的各类需求,申请了 100Mbps 的宽带链路。而当 7 月份记者抵达东京进行现场带宽测速时,结果十分不理想。百兆网络访问国内的服务,带宽只到了 KB/s 级别,如同回归了拨号上网时代。 现场带宽测速 如何解决跨区域网络传输的问题? 前方记者拿出了事先准备好的 “神器”:阿里云一站式快速上云 SDWAN 接入产品(Smart Access Gateway,简称 SAG)。 由于已在国内进行过配置和测试,因此,在报道现场,记者直接将预留的以太网插到 SAG 产品 WAN 端口,再把需要连接的设备接入到 SAG 的 LAN 端口,便可自动获取 IP 地址,东京报道现场的设备就和国内云端提前配置好的计算、存储等资源构成了一个加密安全的内网环境。当然,还可以通过 PC 和手机等终端安装的 APP 形态,满足各类移动终端的 point-to-site 快速接入。 今年年初,新华社联合阿里云、优酷进行多场测试验证,通过 SAG 网关可以最大化的优化网络传输质量,降低系统访问时延,满足远程制作、云上生产等各类应用场景。 5 路 NDI 流接收情况下相关测试截图 Full NDI 情况推流上云延时效果 智能接入网关 SAG 是阿里云混合云 SD-WAN 解决方案的 CPE 终端设备,可同时基于互联网宽带 / 4G/5G / 专线等多种类型链路,帮助企业安全高速接入阿里云。充分发挥阿里云网络资源优势,就近加密接入 POP 点,优化网络质量,一站式完成跨地域、弹性、高效的分支机构及线下 IDC 互联及业务上云。 伴随 5G 技术发展,诸多企业已探索基于 5G 访问互联网或云上资源,在上半年国内测试中,SAG 的 5G 带宽值最高可以达到 80Mbps (上行)、200Mbps (下行)。 在流媒体视频传输协议中,常用的流媒体协议主要有 RTSP 协议、RTMP 协议、UDP 协议、HLS 协议、SRT 协议、NDI 协议等。对于 UDP、NDI 等仅支持私网的传输协议,SAG 也把跨洋传输的不可能变成了可能,可以实现低延时的跨境传输,应用于远程制作、远程介绍等各类场景。 除了网络手段,还可以通过其他方式来进行速度的优化。实际测试中,虽然东京现场内容回传很慢,但东京现场访问东京资源的速度良好。 因此,在云上东京区域开放存储空间,便可满足内容快速上传的需求,再将东京区域存储内容通过跨区域复制方式复制到国内存储区,实现在东京和国内不同 OSS 地域之间自动、异步复制文件,将源存储空间中文件的改动(新建、覆盖、删除操作)同步到目标存储空间中。既满足了数据复制的需求,也可以作为异地容灾的应对方法。 当然,由于存在一些临时存储内容,并不是所有文件都需要进行同步,对此,可以根据指定文件名前缀进行有选择的同步,以满足各类报道需求。 云上制播,如影随形 传统节目生产,需要按需配置支持 4K 或是高清的、带显卡的工作站进行编辑制作,并通过网络化存储访问达到协同效。但跨境报道,大规模网络化系统部署携带不便,且仅能满足当地访问的需求,因此,在这次移动报道中,通过云桌面方式实现了多地域更灵活的访问体验。 业务系统部署在云端,对位于各类互联网环境的客户而言,安全、高质量的访问,实现和线下业务系统类似的效果是关键。 云桌面是一种易用、安全、高效的云上桌面服务,可以快速构建、高效管理桌面办公环境,提供安全、灵活的访问体系,使用云桌面的用户,可通过客户端方式连接云桌面,运维管理人员也可以远程进行统一的云桌面管理,包括管理工作区、桌面、策略、镜像、网络、存储等的管理。 因为云端可提供丰富的计算资源选择,在无影云桌面中,可以选择 CPU、GPU 多种规格,即用即买,按需计费,灵活弹性,管理员可以实现定义好应用和资源镜像,如高清非编、4K 非编等,快速复制启动新的机器。云桌面可以根据需求设定多种安全策略,既能开放上传下载功能提升便捷程度,又可以根据安全需求关闭上传下载,U 盘,剪切板,网络等通路,防止数据和 IP 外泄。 对于终端的话,可以按需灵活选择软件或是软硬一体形式,硬件终端提供统一轻空间,搭载个人云盘做到数据随身携带,根据权限使用云端资源。 无影云桌面软件终端形态 云桌面可以以低带宽、高分辨率、高显示质量显示云端站点编辑效果,支持国内国外多种非编软件,最高支持 9 层 500Mbps XAVC 视频编辑。 根据实测结果,通过家庭宽带、办公网络、酒店 wifi 等各类 Wifi 连接方式均能实现较低的访问时延(RTT(Round-Trip Time,总体延时)小于 50ms),占用带宽在 10Mbps 以下(高清 / 4K 分辨率进行编辑操作访问情况下),可以流畅的进行编辑、审核、调色等各类操作,同时,还可以通过外部设备重定向功能,接入调色台等外设设备,满足更好的用户操作体验。 整体云端制播网络架构如下: 此次为了保证北京、东京两地的同时访问,阿里云在北京和东京之间的上海区域开通了云桌面服务,两地网络测试情况下,对应 RTT 数值均在百毫秒以下,可以很好的满足业务需求。 为了满足不同人员对不同非编软件的使用需求,云上部署统一的 CS 资源管理系统,以具备与 Adobe Premiere、Final cut Pro、Edius、大洋、索贝、剪映等非编软件的协同制作能力,用户可以通过拖拽的方式,直接将素材或打点片段拖入非编中进行编辑。用户的整个剪辑操作流程就是在素材管理系统和剪辑软件中进行流转的,避免了用户在多软件中频繁切换的操作。 在素材管理系统中,素材的存放管理被定义划分为个人库和部门库两种方式,其中个人库所属于登录的个人账户,仅用户本人有权看到并管理其内容;部门库所属整个部门,所有部门内的工作人员均可共享其中素材,用户可以在个人库中将素材共享至部门库来实现部门库资源扩充。 同时,还可以通过左侧收录素材目录下看到收录得到的素材,收录素材展示视频元数据信息并且可以进行预览。视频预览框中可以实现视频打点并拖拽至非编软件进行编辑功能,正在收录的内容可以和非编配合实现边采边编操作。 资源管理器对应不同非编软件拖拽上板 资源库还可以提供结合 AI 智能能力的 BS 管理端,实现智能封面提取、语音识别、人物识别、智能拆条、智能编目,做后台内容的快速管理,减轻素材管理人员的压力,也使得内容的搜索更加的灵活便捷。 不仅内容生产可以通过云端进行,信号的云端导播切换更可以在维持传统操作方式(切换面板、监看习惯等)情况下通过云端实现调度、AI 处理及导播切换,如下图所示: 智能加持,一站式服务 在云上,通过编辑软件提供商和公共云基础能力的结合,可以实现更多的业务场景,将异构业务生产环节流程化、智能化串接起来。 而通过和 BS 编辑应用的结合,可以一站式满足业务的增值应用,实现更好的业务提效。 此次,针对奥运报道的需求,结合阿里云视频云的 AI 能力,进行了进一步的贴身定做:赛前创建奥运体育健儿库,在前方报道入库后第一时间进行视频分析、内容展现,可以更好更快的为业务系统提供服务。 同时,在 “策采编发追评” 的整套传媒业务流程中,可以通过 AI 能力的加持,实现移动端 + PC 端编辑的协同生产,完成大小屏内容的统一准备和分发,既能实现业务闭环,也能快速切入发布环节,以统一的 BS 界面,实现各业务流程以及智能化工具的一站式服务。 为了本次奥运比赛,赛前提前制作了各类体育报道的模板,可以快速和拍摄视频结合,实现内容的快速生产分发。 体育类新媒体海报 阿里云视频云针对媒体行业打造的 AI 编辑部,致力于将阿里云的各项 AI 能力在媒体行业的不同场景中进行落地,提升内容生产与制作的生产效率,降低人工成本。 在云上制播的时代,AI 编辑部已经面向市场基于分布式媒体处理引擎的超高清内容倍速处理能力,此外还有多模搜索、人物翻库、视频指纹、数字水印各类全新能力,为云上内容生产的时代中的各类生产场景提供能力支撑,为行业的不断发展提供更多的产品与解决方案。 云上制播的未来 全球的云上奥运,带来了全新 “云上制播” 概念,其本质就是媒体 “策、采、编、发、追、评” 完整业务流程的全面云化,核心在于云化环境对业务的支持和通过无影云桌面实现和推云入端。 通过云上制播,阿里云实现了媒体核心业务的全面上云,完成了传统专业设备的云化替代,解决了从业人员内容采集、生产、审核、发布的空间限制和设备依赖。 针对媒体行业,在实际生产过程中,因为大多数历史资料内容存储在线下系统,需要频繁涉及到原有素材的导入上传,利用互联网络耗时较大,影响实际体验。目前采、编、发、存等业务,分布在云上云下,将会是一个比较长的过渡阶段,因此对原有内容的导入和融合、专线链路的建设,是非常迫切且重要的问题。 随着云技术和网络基础设施的发展,云上生产将会得到更广泛的应用发展,在阿里云和优酷的联合测试中,还实现了以下场景的验证: 低延时远程监看 云端内容增强制播 通过将阿里云视频增强系统在优酷制作网部署,对高标清素材进行 4K 增强与色彩优化,可用作直播信号处理,更可应用于视频文件处理,实现低成本 4K 内容生产,缓解行业内原生 4K 内容制作成本高,原创内容少的问题,填补了高清制作与原生 4K 制作之间的空白市场空间。还可以用来对来源质量不高的内容实时优化处理。 智能化云化转播方案 5G + 4K + AI + 云的云化转播车方案,该方案旨在通过云制作技术赋予现有电视转播车云上生产的能力,提升内容制作效率,降低制作成本,孵化新内容形态。 通过智能接入网关打通本地设备和云上资源,实现本地多路摄像机信号上云、云上导播、字幕包装、编码推流、多路分发、云端收录、AI 分析、智能剪辑的全链路云上解决方案,并在现有优酷自制节目中落地完善细节。 适合网络媒体、OGC、广电融媒等新媒体高清 HD 直播场景,相较于传统的 EFP 制作流程,具有便捷、稳定、低成本的特点,更可以通过智能化的手段完成智能抠像、动漫化、多主体分割等亮点应用。 通过这次云上奥运报道的实践与验证,可以感受到云上生产可以极大满足现有生产业务诉求。同时,在运维、弹性、跨地域协同、智能化协助等方面具备更大的优势、深度重构了 “采编发” 业务流程,并创生出新的应用模式。视频内容云上生产,能够在全媒体传播,传统媒体机构进军互联网主战场的征程中发挥更大的价值。 阿里云借助此次东京奥运会的云上制播实战,也为即将到来的全运会、冬奥会积累更多的前瞻性实战经验,在云上制播时代,让我们共同期待更优质的体验和全新的云上图景。 「视频云技术」你最值得关注的音视频技术公众号,每周推送来自阿里云一线的实践技术文章,在这里与音视频领域一流工程师交流切磋。公众号后台回复【技术】可加入阿里云视频云产品技术交流群,和业内大咖一起探讨音视频技术,获取更多行业最新信息。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册