首页 文章 精选 留言 我的

精选列表

搜索[单体架构],共10000篇文章
优秀的个人博客,低调大师

寻找未来的架构师

http://v.youku.com/v_show/id_XMzA0NTgyMDU2.html 在百度,有这么一个部门,有这么一群工程师; 他们面对着百度 巨大的流量 所带来的技术挑战; 他们每天思考研究着如何 让百度更快更稳定 ; 他们做到了,他们支撑了百度的快速发展; 他们是快乐的, 他们是 运维开发工程师 和 数据库工程师 ; 他们所在的团队叫运维部 我们就是他们 我们坚信,只有 以服务为中心 ,才能带给用户最大价值; 我们坚信,只有 精益求精 ,才能满足卓越的需要; 我们坚信,只有 诚信守诺 ,才能赢得世界的喝彩; 我们坚信,只有 务实创新 ,才能不断地实现和超越自我; 我们坚信,只有 协作共赢 ,才能发挥自己的全部力量。 【本文首发于: 百度运维空间】 http://hi.baidu.com/ops_bd/blog/item/1ede65a8d9d9cfd77dd92a74.html 【 关注百度技术沙龙】 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/748875,如需转载请自行联系原作者

优秀的个人博客,低调大师

Nginx提升学习架构总结

1.选择nginx的理由 (1)支持高并发;(官方5w并发,实测3w并发,因为采用epoll网络IO模型) (2)内存消耗少;(nginx+php-fcgi在3w并发下开启10个nginx进程,消耗150mb内存,64个nginx进程消耗内存1280mb) (3)成本低廉;(开源免费,可用于商业,相对硬件f5成本低) (4)节省带宽; (5)稳定高; (6)内置健康检查功能; (7)支持反向代理; (8)支持负载均衡;(应用层) 2.网络IO连接方法 分2种:阻塞IO(block IO)和多路复用IO(现在服务器多用); 阻塞IO:一个请求过来,只能干这个事情,别的事情不能干;(如同学来找你,告诉他你的地址,且在宿舍门口等,在这个过程中,一直等待,直到同学找到你,期间你不能做任何事情) 多路复用IO:包含select和epoll模型;(select模型举例如同学来找你,告诉你同学地址并在宿舍等,同学来到宿舍门口还是找不到你,就找楼管,楼管挨个宿舍去找,效率很慢;epoll模型举例如同学来找你,告诉你同学地址并在宿舍等,同学来到宿舍门口还是找不到你,就找楼管,楼管处有人员登记数据库,查看登记名册,告诉你同学在哪层楼多少号房间,这样就快速找到你了) 3.nginx虚拟主机及相关配置 (1)nginx配置文件结构图 ...... event{ ...... } http{ ...... server{ ...... } server{ ...... } } (2)nginx虚拟主机 定义server,可以基于端口、ip、域名做虚拟主机。 (3)nginx匹配规则 location语法:location=[=|~|~*|^~]/uri/{...} ~ 区分大小写 ~* 不区分大小写 ^~ 禁止表达式匹配 = 精确匹配 举例如: location =/{ #只匹配/的查询 } location /{ #匹配任何以/开头的查询,但正则与一些较长字符串被首先匹配 #./document/index.html } location ^~ /images/{ #匹配任何以/images/开头的查询,且停止搜索,不检查正则 #./images/1.gif } location ^* \.(gif|jpg|jpeg)${ #匹配任何以gif,jpg,jpeg结尾的文件,但所有/images/目录的请求在上面处理,精确匹配 #./document/1.gif } 解释:url和uri url:统一资源定位符,如http://www.onon.com/news/a10.html uri:统一资源标示符,指具体的路径,如news/a10.html (4)自定义错误页面 error_page 403 404 /40x.html; location = /40x.html{ root /var/web/error/; } 解释:server中定义,其中/40x.html前面的/是指定义server指定文件root的路径。 另针对error指定专门存放路径,如上面的“root /var/web/error/”,至此就可以将40x.html页面放到改目录下。 对于50x错误也同样定义: error_page 500 502 503 504 /50x.html location = /50x.html{ root /var/web/error/; } (5)自动索引及别名功能 location /onon{ root /web/html; index index.html; autoindex on; } 解释:将/web/html目录下的文件索引显示 location /over/{ alias /data/web3/images/toto/; } 解释:访问/data/web3/images/toto/top.jpg文件时,可以使用/over/top.jpg访问 (6)控制站点访问 location /onon{ root /web/html; index index.html; autoindex on; deny 192.168.0.110; allow 192.168.0.0/24; allow 192.168.1.12; deny all; } (7)目录身份验证 /usr/local/apache/bin/htpasswd -c /home/nginx/conf/authdb webadmin nginx auth_basic认证采用apache兼容的密码文件,创建webadmin用户,输入密码即可。 当访问/onon时就会提示输入用户名和密码。 location /onon{ root /web/html; index index.html; autoindex on; auth_basic "Enter your user and password"; auth_basic_user_file /home/nginx/conf/authdb; deny 192.168.0.110; allow 192.168.0.0/24; allow 192.168.1.12; deny all; } (8)nginx状态检查 location /nginx_status{ stub_status on; access_log off; } 解释:不需要开启访问日志access_log;访问目录/nginx_status添加认证,见上;编译的时候需要添加此模块:--with-http_stub_status_module (9)nginx rewrite 编译时需要添加pcre库,prel兼容正则表达式; nginx rewrite是实现url/uri重写; 语法指令:set、if、return、break、rewrite 语法规则: =和!= ~ 区分大小写 ~* 不区分大小写 !~和!~* -f和!-f 判断文件是否存在 -d和!-d 判断目录是否存在 -e和!-e 判断文件或目录是否存在 -x和!-x 判断文件是否可以执行 $1 - $9 位置化参数 全局变量(系统已定义好) $arg_PARAMETER#这个变量包含GET请求中,如果有变量PARAMETER时的值。 $args #这个变量等于请求行中(GET请求)的参数,例如foo=123&bar=blahblah; $binary_remote_addr#二进制的客户地址。 $body_bytes_sent#响应时送出的body字节数数量。即使连接中断,这个数据也是精确的。 $content_length#请求头中的Content-length字段。 $content_type#请求头中的Content-Type字段。 $cookie_COOKIE#cookie COOKIE变量的值 $document_root#当前请求在root指令中指定的值。 $document_uri#与$uri相同。 $host#请求主机头字段,否则为服务器名称。 $hostname#Set to the machine’s hostname as returned by gethostname $http_HEADER $is_args#如果有$args参数,这个变量等于”?”,否则等于”",空值。 $http_user_agent#客户端agent信息 $http_cookie#客户端cookie信息 $limit_rate#这个变量可以限制连接速率。 $query_string#与$args相同。 $request_body_file#客户端请求主体信息的临时文件名。 $request_method#客户端请求的动作,通常为GET或POST。 $remote_addr#客户端的IP地址。 $remote_port#客户端的端口。 $remote_user#已经经过Auth Basic Module验证的用户名。 $request_completion#如果请求结束,设置为OK. 当请求未结束或如果该请求不是请求链串的最后一个时,为空(Empty)。 $request_method#GET或POST $request_filename#当前请求的文件路径,由root或alias指令与URI请求生成。 $request_uri#包含请求参数的原始URI,不包含主机名,如:”/foo/bar.php?arg=baz”。不能修改。 $scheme#HTTP方法(如http,https)。 $server_protocol#请求使用的协议,通常是HTTP/1.0或HTTP/1.1。 $server_addr#服务器地址,在完成一次系统调用后可以确定这个值。 $server_name#服务器名称。 $server_port#请求到达服务器的端口号。 $uri#不带请求参数的当前URI,$uri不包含主机名,如”/foo/bar.html”。该值有可能和$request_uri 不一致。$request_uri是浏览器发过来的值。该值是rewrite后的值。例如做了internal redirects后。 if指令: if($http_user_agent ~MSIE){ rewrite ^(.*)$ /msie/$1 break; } 解释:$http_user_agent用户代理,如浏览器ie,firefox等; ~区分大小写,MSIE浏览器ie; ^以什么开始,$以什么结尾,.*匹配任意字符串;$1位置符,/msie/$1指的是web所指向的root路径下 的/msie/$1,如/data/web3/images/toto/msie/index.html return指令: 如果访问url以“*.sh”或“*.bash”结尾,则返回状态码403 location ~.*\.(sh|bash)?$ { return 403; } 解释:“~”匹配大小写,“.*”前面不管是什么字符,“.(sh|bash)?$”以sh或bas,用$标识,“\”去掉其后面“.”的特殊意义的。403错误就是指error_page定义的错误。 rewrite指令: 最后一项参数flag标记,有以下: last:完成rewrite,相当于apache的[L]标记,浏览器url地址不变; break:本条规则匹配后就完成,终止匹配,浏览器url地址不变; redirect:返回302临时重定向,浏览器显示跳转后的url; permanent:返回301永久重定向,浏览器显示跳转后的url; 案例: 1)将/bbs目录重写到/data rewrite ^/bbs/?$ /data/ permanent; location /data{ index index.html; } location /bbs{ rewrite ~/bbs/?$ /data/ permanent; } 2)根据不同的浏览器将得到不同的结果 if($http_user_agent ~MSIE){ rewrite ^(.*)$ /msie/$1 break; } server{ listen 80 default_server; server_name www.onon.com; index index.html; root /data/www/onon; if($http_user_agent ~Firefox){ rewrite ^(.*)$ /firefox/$1 break; } if($http_user_agent ~MSIE){ rewrite ^(.*)$ /msie/$1 break; } } 3)防止盗链 所谓防盗链就是别人网站的图片引用我们的网站上的,且点击别人网站上的那个图片,使用的是我们网站的流量,只引用我们网站的图片,不会跳转到我们网站上来。 location ~ .*\.(gif|jpg|jpeg|png|bmp|swf|flv)$ { valid_referers none blocked www.onon.com *.onon.com; if ($invalid_referer) { rewrite ^/(.*) http://www.onon.com/block.html; } } 4)实现域名跳转 访问www.onon.com跳转到www.onbing.com server{ listen 80 default_server; server_name www.onon.com; index index.html; root /data/www/onon; location / { rewrite ~(.*)$ http://www.onbing.com$1 permanent; } } 5)URL rewrite和反向代理同时进行 location /news/ { proxy_pass http://10.0.0.10; } location /health/ { proxy_pass http://10.0.0.20; } (10)nginx日志管理 语法如下:log_format name format (format ....) 自定义日志格式如下: log_format main '$remote_addr - $remote_user [$time_local] "$request"' '$status $body_bytes_sent "$http_referer"'; '"$http_user_agent" "$http_x_forwarded_for"'; $http_x_forwarded_for 记录远程用户真实ip地址,不是缓存/代理服务器地址; $remote_user 记录远程客户端用户名称,一般不会记录的; $time_local 记录访问时间及地区,记录用户访问时的本地时间; $request 记录请求的URL与HTTP协议,具体访问的页面; $status 记录请求的状态,第一次成功访问状态为200,再次访问页面未更新状态为304,页面找不到时为404 $body_bytes_sent 记录发送给客户端的文件主体内容大小 $http_referer 记录是从哪个页面链接访问过来的,如百度链接过来的; $http_user_agent 记录客户端浏览器的相关信息 注意:上面定义的日志格式,跟在access_log后面,error_log后面跟错误级别,如下: access_log /data0/logs/nginx/www.onon.com-access.log main; access_log /data0/logs/$server_name.log mylogformat buffer=32k; 解释:main、mylogformat为定义日志格式时取名;$server_name为自动获取访问地址,如www.onon.com,消耗资源;buffer=32k为设置缓存区大小,只记录日志文件描述符。 error_log /data0/logs/nginx/www.onon.com-error.log warn; 解释:warn为错误级别,日志等级有8个,分别为:emerg、alert、crit、err、warn、notice、info、debug 开启日志缓存 每一条日志记录,日志文件先打开文件,写入日志记录,马上关闭。 如何提高包含变量的日志文件存放路径性能?开启open_log_file_cache open_log_file_cache max=1000 inactive=20s min_uses=2 valid=1m; 解释:max最大文件描述符数量,inactive设定时间内没有使用此文件描述符,则自动删除此描述符, min_uses在inactive指定时间范围内,若日志文件超过被使用次数,则计入缓存,默认10秒,valid多长时间检查一次,看日志文件路径和文件名是否仍然存在,默认60秒。 nginx日志分割 vim /data/sh/nginxlog_cut.sh #! /bin/bash #nginx log 存放位置 logs_path="/data/logs/nglogcut/" #将日志改名 mkdir -p ${logs_path}$(date -d "yesterday" + "%Y")/$(date -d "yesterday" + "%m")/ mv ${logs_path}access.log ${logs_path}$(date -d "yesterday" + "%Y")/$(date -d "yesterday" + "%m")/access_$(date -d "yesterday" + "%Y%m%d").log 重新加载nginx服务 service nginx reload 添加计划任务 chmod +x /data/sh/nginxlog_cut.sh #crontab -l 01 01 * * * /bin/bash /data/sh/nginxlog_cut.sh (11)nginx压缩输出 在http{}中间启用压缩 模块:HttpGzipModule和HttpGzipStaticModule 前者用于启用在文件传输过程中使用gzip压缩,而后者的作用是将一个文件以压缩的方式传递到一个支持压缩功能的客户端之前,首先检查是否已经存在相应的*.gz结尾的文件名格式,这样避免重复压缩而造成资源浪费。 对于nginx的网页压缩传输在nginx中的配置是将其分到两种模式:一种是动态的,实时压缩输出(边压缩边输出),另一种是静态的,找到同名文件的.gz格式文件就输出。 启用gzip功能需要zlib库的支持,--with-http_gzip_module; 编译时需要指定--with-http_gzip_static_module gzip(GNU-ZIP)是一种压缩技术。经过gzip压缩后页面大小可以变为原来的30%甚至更小,这样,用户浏览页面的时候速度会块得多。gzip的压缩页面需要浏览器和服务器双方都支持,实际上就是服务器端压缩,传到浏览器后浏览器解压并解析。浏览器那里不需要我们担心,因为目前的巨大多数浏览器都支持解析gzip过的页面。 #vim nginx.conf http{ gzip on; gzip_min_length 1k; gzip_buffer 4 16k; gzip_http_version 1.1; gzip_comp_level 2; gzip_types text/plain application/x-javascript text/css application/xml; gzip_vary on; } 解释:gzip on开启gzip模块,关闭使用off; gzip_min_length设置允许压缩的页面最小字节数,页面字节数从header头的content-length中进行获取。默认为0,不管页面多大都压缩。建议设为1k,小于1k可能会越压越大; gzip_buffer设置系统获取几个单位的缓存用于存储gzip的压缩结果数据流。上面的设置为以16k为单位的4倍申请内存; gzip_http_version识别http协议的版本,早期的浏览器不支持gzip压缩,用户会看到乱码,所以为了支持前期版本加了此选项,目前此项基本可以忽略; gzip_comp_level为gzip压缩比,分1-9等级,1压缩比最小处理速度最快,9压缩比最大但处理速度最慢(传输快但比较消耗cpu); gzip_types匹配mime类型进行压缩,无论是否指定,”text/html”类型总是会被压缩的; gzip_vary和http头有关系,加个vary头,给代理服务器用的,有的浏览器支持压缩,有的不支持,所以避免浪费不支持的也压缩,所以根据客户端的HTTP头来判断,是否需要压缩; (12)nginx的浏览器本地缓存设置 #vim nginx.conf location ~.*\.(gif|jpg|jpeg|png|bmp|swf|flv)${ expires 30d; } location ~.*\.(js|css|jsp)?${ expires 1h; } (13)设定限速(常见流媒体) location /download { limit_rate 256k; proxy_pass http://www.onbing.com; proxy_set_header Host $host; proxy_set_header X-Forwarded-For $remote_addr; } location /movie { limit_rate_after 10m; limit_rate 100k; } 解释:前10m不限速,之后限速为100k。 if($http_user_agent ~Google|Yahoo|baidu){ limit_rate 20k; } 解释:通过google,yahoo或baidu搜索引擎访问进来的,限速为20k。 (14)反向代理 正向代理和反向代理?正向就是一个从内向外的访问,反向则是一个从外向内的访问。正向和反向是一个相对的概念。 正向:典型应用为在防火墙内的局域网客户端提供访问Internet的途径; 相对于用户,就是正向代理,代理用户去请求; 让nginx成为正向代理,而将外网视为整个后端在给我们提供服务。 反向:典型应用为将防火墙后面的服务器提供给Internet用户访问; 相对于内部的服务那么nginx就是反向代理,代理接受用户请求; http { client_body_buffer_size 600; client_header_buffer_size 600; client_max_body_size 300M; proxy_buffering on; proxy_cache_min_uses 3; proxy_ignore_client_abort off; proxy_intercept_errors on; proxy_next_upstream error timeout invalid_header; proxy_redirect off; proxy_connect_timeout 60; proxy_send_timeout 600; proxy_read_timeout 600; proxy_buffer_size 256k; proxy_buffers 4 256k; proxy_busy_buffers_size 256k; proxy_temp_file_write_size 256k; proxy_temp_path /usr/local/nginx/proxy_temp; proxy_cache_path /usr/local/nginx/proxy_cache/ levels=1:2 keys_zone=cache_onon:10m inactive=10m max_size=1000M; location /weibo { proxy_pass http://192.168.10.213; proxy_set_header Host $host; proxy_cache cache_onon; proxy_set_header X-Forward-For $remote_addr; } location ~.*\.(gif|jpg|jpeg|png|bmp|swf|flv|js|css|html)${ #状态码 proxy_cache cache_onon; proxy_cache_valid 200 10m; proxy_cache_valid 304 1m; proxy_cache_valid 301 302 1h; proxy_cache_valid any 1m; #哈希key值 proxy_cache_key $host$uri$is_args$args; proxy_set_header Host $host; proxy_set_header X-Forward-For $remote_addr; proxy_pass http://192.168.1.66; } } (15)负载均衡 upstream news_server_pool{ server 10.0.0.21:80 weight=1 max_fails=2 fail_timeout=30s; server 10.0.0.22:80 weight=1 max_fails=2 fail_timeout=30s; } upstream tv_server_pool{ server 10.0.0.31:80 weight=1 max_fails=2 fail_timeout=30s; server 10.0.0.32:80 weight=2 max_fails=2 fail_timeout=30s; } 解释:30s内检测2次,失效就找下一个服务器。 location /news { proxy_pass http://news_server_pool; proxy_set_header Host $host; proxy_set_header X-Forward-For $remote_addr; } location /tv { proxy_pass http://tv_server_pool; proxy_set_header Host $host; proxy_set_header X-Forward-For $remote_addr; } 本文转自自由心行博客51CTO博客,原文链接http://blog.51cto.com/xiaojiang2008/1247187如需转载请自行联系原作者 xiaojiang

优秀的个人博客,低调大师

DNS系统架构与解析原理

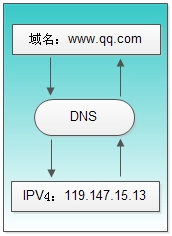
网络通讯大部分是基于TCP/IP的,而TCP/IP是基于IP地址的,所以计算机在网络上进行通讯时只能识别如“202.96.134.133”之类的IP地址,而不能认识域名。我们无法记住10个以上IP地址的网站,所以我们访问网站时,更多的是在浏览器地址栏中输入域名,就能看到所需要的页面,这是因为有一个叫“DNS服务器”的计算机自动把我们的域名“翻译”成了相应的IP地址,然后调出IP地址所对应的网页。 什么是DNS? DNS( Domain Name System)是“域名系统”的英文缩写,是一种组织成域层次结构的计算机和网络服务命名系统,它用于TCP/IP网络,它所提供的服务是用来将主机名和域名转换为IP地址的工作。DNS就是这样的一位“翻译官”,它的基本工作原理可用下图来表示。 DNS域名称 域名系统作为一个层次结构和分布式数据库,包含各种类型的数据,包括主机名和域名。DNS数据库中的名称形成一个分层树状结构称为域命名空间。域名包含单个标签分隔点,例如:im.qq.com。 完全限定的域名 (FQDN) 唯一地标识在 DNS 分层树中的主机的位置,通过指定的路径中点分隔从根引用的主机的名称列表。 下图显示与主机称为 im 内 qq.com DNS 树的示例。 主机的 FQDN 是 im.qq.com。 DNS 域的名称层次结构 DNS域名称空间的组织方式 按其功能命名空间中用来描述 DNS 域名称的五个类别的介绍详见下表中,以及与每个名称类型的示例。 DNS 和 Internet 域 互联网域名系统由名称注册机构负责维护分配由组织和国家/地区的顶级域在 Internet 上进行管理。 这些域名按照国际标准 3166。 一些很多现有缩写,保留以供组织中,以及两个字母和三个字母的国家/地区使用的缩写使用下表所示。一些常见的DNS域名称如下图: 资源记录 DNS 数据库中包含的资源记录 (RR)。 每个 RR 标识数据库中的特定资源。我们在建立DNS服务器时,经常会用到SOA,NS,A之类的记录,在维护DNS服务器时,会用到MX,CNAME记录。 常见的RR见下图: Dns服务的工作过程 当 DNS 客户机需要查询程序中使用的名称时,它会查询本地DNS 服务器来解析该名称。 客户机发送的每条查询消息都包括3条信息,以指定服务器应回答的问题。 ● 指定的 DNS 域名,表示为完全合格的域名 (FQDN) 。 ● 指定的查询类型,它可根据类型指定资源记录,或作为查询操作的专门类型。 ● DNS域名的指定类别。 对于DNS 服务器,它始终应指定为 Internet 类别。例如,指定的名称可以是计算机的完全合格的域名,如im.qq.com,并且指定的查询类型用于通过该名称搜索地址资源记录。 DNS 查询以各种不同的方式进行解析。客户机有时也可通过使用从以前查询获得的缓存信息就地应答查询。DNS 服务器可使用其自身的资源记录信息缓存来应答查询,也可代表请求客户机来查询或联系其他 DNS 服务器,以完全解析该名称,并随后将应答返回至客户机。这个过程称为递归。 另外,客户机自己也可尝试联系其他的 DNS 服务器来解析名称。如果客户机这么做,它会使用基于服务器应答的独立和附加的查询,该过程称作迭代,即DNS服务器之间的交互查询就是迭代查询。 DNS 查询的过程如下图所示。 1、在浏览器中输入www.qq.com域名,操作系统会先检查自己本地的hosts文件是否有这个网址映射关系,如果有,就先调用这个IP地址映射,完成域名解析。 2、如果hosts里没有这个域名的映射,则查找本地DNS解析器缓存,是否有这个网址映射关系,如果有,直接返回,完成域名解析。 3、如果hosts与本地DNS解析器缓存都没有相应的网址映射关系,首先会找TCP/ip参数中设置的首选DNS服务器,在此我们叫它本地DNS服务器,此服务器收到查询时,如果要查询的域名,包含在本地配置区域资源中,则返回解析结果给客户机,完成域名解析,此解析具有权威性。 4、如果要查询的域名,不由本地DNS服务器区域解析,但该服务器已缓存了此网址映射关系,则调用这个IP地址映射,完成域名解析,此解析不具有权威性。 5、如果本地DNS服务器本地区域文件与缓存解析都失效,则根据本地DNS服务器的设置(是否设置转发器)进行查询,如果未用转发模式,本地DNS就把请求发至13台根DNS,根DNS服务器收到请求后会判断这个域名(.com)是谁来授权管理,并会返回一个负责该顶级域名服务器的一个IP。 本地DNS服务器收到IP信息后,将会联系负责.com域的这台服务器。这台负责.com域的服务器收到请求后,如果自己无法解析,它就会找一个管理.com域的下一级DNS服务器地址(qq.com)给本地DNS服务器。当本地DNS服务器收到这个地址后,就会找qq.com域服务器,重复上面的动作,进行查询,直至找到www.qq.com主机。 6、如果用的是转发模式,此DNS服务器就会把请求转发至上一级DNS服务器,由上一级服务器进行解析,上一级服务器如果不能解析,或找根DNS或把转请求转至上上级,以此循环。不管是本地DNS服务器用是是转发,还是根提示,最后都是把结果返回给本地DNS服务器,由此DNS服务器再返回给客户机。 从客户端到本地DNS服务器是属于递归查询,而DNS服务器之间就是的交互查询就是迭代查询。 附录: 本地DNS配置转发与未配置转发数据包分析 新建一DNS,具体怎么建我这里就不再描述了1、DNS服务器不设转发 在192.168.145.228服务器上安装上wireshark软件,并打开它,设置数据包为UDP过滤,在192.168.145.12客户机上用nslookup命令查询一下www.sohu.com,马上可以看到本地DNS服务器直接查全球13台根域中的某几台,然后一步步解析,通过递代的方式,直到找到www.sohu.com对应的IP为220.181.118.87。 本地DNS服务器得到www.sohu.com的IP后,它把这个IP返回给192.168.145.12客户机,完成解析。 2、DNS服务器设置转发 因www.sohu.com域名在第一步的验证中使用过,有缓存,为了不受上步实验干扰,我们在客户机上192.168.145.12上nslookup www.baidu.com。从图上看,本地DNS把请求转发至192.168.133.10服务器,133.10服务器把得到的IP返回给本地DNS,然后本地DNS再把IP告诉DNS客户机,完成解析。 本文转自写个博客骗钱博客51CTO博客,原文链接http://blog.51cto.com/dadonggg/1948716如需转载请自行联系原作者 菜鸟东哥

优秀的个人博客,低调大师

理解思科IPS的部署架构

在该任务中主要描述关于思科入侵防御系统的接口配置、关于旁路模式和穿越模式的特性与区别、思科IPS系统的virtual sensor、traffic flow notifications、bypass mode、signature、以及 signature检测入侵行为后的动作、signature的引擎等。 关于思科IPS的接口配置 思科的IDS/IPS只有一个command(或者叫做control接口),最多可以有8个monitor接口(或者叫8个sensor接口),多个接口可以同时监控多个网络,如下图5.1所示,可以作穿越模式(在线模式),也可以做旁边路模式(杂合模式),但是必须考虑IPS自身能否承受如此之在的网络流量压力。并且所有的sensor接口使用相同的配置,比如:图5.1所示的环境中,完成了一个signature的配置,那么这个配置即针对图中在线模式(inline)的所有接口生效,也针对图中的所有杂合模式接口生效。默认情况下思科IPS上的所有接口全部是保持关闭状态,并且没有任何接口关联到Virtual sensor,思科IPS任何接口要完成相关的入侵检测行为,必须启动接口,并将接口关联到Virtualsensor,那么什么是Virtual sensor?将在下一博文进行描述。 注意:如果您刚购买了一台全新的思科IPS设备,默认它只有两个接口,一个command接口和一个sensor接口,但是提供了两个模块化的槽位,您可以通过扩展模块来获得更多的sensor接口。 接口处于旁路模式(杂合模式)的特性: 在旁路模式中,分析的数据包并没有真正的穿越sensor接口,它实际上是分析实时通信流中数据包的一个拷贝包,当然这需要接合交换机的端口镜像功能来完成。旁路模式的最大优点在于不影响流量的性能,比如说一些要超低延迟的数据包(IP语音包)就不会受到IPS分析的影响,最降低转发延迟,这种模式的最大缺点是不能阻止初始化攻击,面对攻击时的响应迟缓,也叫做post-event,也就是常说的事后才知。关于旁路模式的部署将在本项目的5.2任务二 旁路模式(杂合模式)下思科IDS/IPS传感器的部署有详细描述。 接口处于穿越模式(在线模式)的特性: 如果是连接同一交换机,两个接口要处于不同的VLAN,一个VLAN就没有意义了,最初穿越模式中的两个接口必须要使用两个物理接口,现在一个物理接口也可以做在线模式,因为它可以跟交换机的trunk联动并提供了VLAN Pairs特性,这就有点类似于VLAN间的单臂路由(将一个物理接口分为多个逻辑子接口并规划到不同的VLAN中)。要配置在线模式,必须遵守这样一个则规则:首先激活两个接口,其次是把两个接口放到interface Pairs,最后把interface Pairs关联到virtual sensor。IPS是没有必要像防火墙那样去区分内外接口的。 使用穿越模式的IPS会对流量性能造成一定的影响,特别是一些要超低延迟的数据包(IP语音包),最大的优点是可以阻止初始化攻击。 本文转自 kingsir827 51CTO博客,原文链接:http://blog.51cto.com/7658423/1285421,如需转载请自行联系原作者

优秀的个人博客,低调大师

linux的mtd架构分析【转】

阅读目录 linux mtd yaffs2与mtd之间的连接 yaffs2文件系统介绍 Readme-linux yaffs2 FTL和NFTL---FLASH转换层 MTD块设备---mtd_blkdevs.c mtd块设备缓冲操作---mtdblock.c mtd字符设备(mtdchar.c) mtd分区 Nandflash的驱动加载 Nor flash的探测 mtd_info map_info FLASH的知识 MTD是干什么的 转自:http://blog.csdn.net/column/details/xgbing-linux-mtd.html 回到顶部 linux mtd 嵌入式系统的存储有很多不可靠之处。随着使用容量的增大,现在使用得最多的是nand flash。nand flash价格低廉,但它有很多不足之处。nand flash出厂就可能有坏块,随着使用时间的增长... 2014-03-25 09:36 1193 回到顶部 yaffs2与mtd之间的连接 yaffs2工作在VFS和MTD之间。 (1)移植yaffs2 在终端执行: mkdir yaffs2_source cd yaffs2_source git clone git://www... 2014-03-04 21:15 1370 回到顶部 yaffs2文件系统介绍 YAFFS意义为‘yet another flash file system’,是一个开源的文件系统。是专门为NAND闪存设计的,它的出现使得价格低廉的NAND闪存芯片具有了高效性和健壮性。 YA... 2014-03-01 21:05 5199 回到顶部 Readme-linux yaffs2 Welcome to YAFFS, the first file system developed specifically for NAND flash. 欢迎来到YAFFS,这是第一个专门为NAN... 2008-07-16 16:13 2124 回到顶部 FTL和NFTL---FLASH转换层 FTL(Flash Translation Layer)是nor flash转换层,NTFL(Nand Flash Translation Layer)是Nand Flash的转换层。 Fl... 2014-02-24 20:36 2462 回到顶部 MTD块设备---mtd_blkdevs.c (1)mtd块设备结构定义 static struct block_device_operations mtd_blktrans_ops = { .owner = THIS_MODULE, ... 2014-02-21 16:04 1317 回到顶部 mtd块设备缓冲操作---mtdblock.c 这个文件中并没有增加mtd块设备,mtd块设备的代码文件是Mtd_blkdevs.c。它的功能是为mtd块设备读写提供缓冲操作。 驱动入口: static struct mtd_blktrans_op... 2014-02-19 11:58 1598 回到顶部 mtd字符设备(mtdchar.c) Mtdchar.c是linux下字符设备驱动程序的实现: static const struct file_operations mtd_fops = { .owner = THIS_MODU... 2014-02-15 14:54 2101 回到顶部 mtd分区 mtd_part结构: /* Our partition node structure */ struct mtd_part { struct mtd_info mtd; //分区的信息 ... 2014-02-15 14:33 1657 回到顶部 Nandflash的驱动加载 分析at91sam9260ek的代码示范。 (1)板级初始化。 Board-sam9260ek.c中的初始化调用: static void __init ek_board_init(void) ... 2014-02-15 14:16 1524 回到顶部 Nor flash的探测 首先说明一下,笔者使用的linux源码的版本是2.6.30。 Map.h中定义了一个结构体: struct mtd_chip_driver { struct mtd_info *(*prob... 2014-01-18 16:39 1489 回到顶部 mtd_info mtd_info 用于描述MTD原始设备的数据结构是mtd_info,这其中定义了大量的关于MTD的数据和操作函数。每个MTD原始设备都有一个mtd_info结构(master),其中的pr... 2014-01-18 16:37 2206 回到顶部 map_info map_info结构体用于描述一个FLASH的信息。 它在map.h中定义: /* The map stuff is very simple. You fill in your struc... 2014-01-18 15:58 837 回到顶部 FLASH的知识 传统的FLASH分为Nor falsh和Nand flash。 (1)Nor flash Nor flash存储以块为单元,写入时必须先擦除,并且擦除和写入的速度都很慢。但nor fash具... 2014-01-18 00:15 2076 回到顶部 MTD是干什么的 MTD(memory technology device 存储 技术设备 ) 是用于访问 memory 设备( ROM 、 flash )的 Linux 的子系统。 先来看一个图: ... 2014-01-17 22:42 979 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sky-heaven/p/5825567.html,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册