首页 文章 精选 留言 我的

精选列表

搜索[linux运维],共10017篇文章
优秀的个人博客,低调大师

python linux 系统管理与自动化运维

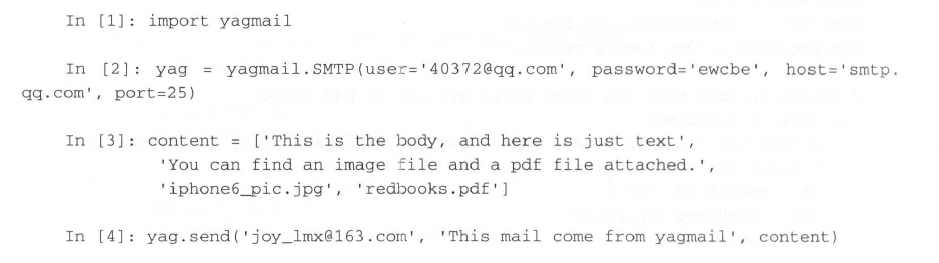
pypdf2 图片:pillow 邮件:smtplib yagmail:简单发送邮件 image.png image.png 接收邮件:imapclient image.png settools打包 python-nmap image.png image.png ipy。。。。。。 dnspython... 同时处理多台服务器:polysh wget http://guichaz.free.fr/polysh/files/polysh-0.4.tar.gz tar -zxvf polysh-0.4.tar.gz cd polysh-0.4 python setup.py install 获取用户输入:pexcept paramiko:https://blog.csdn.net/l1028386804/article/details/79029041 脚本操作ssh fabric from fabric.api import * #导入fabric.api模块 env.hosts= ['192.168.122.101','192.168.122.102','192.168.122.103'] #指定远端服务器的ip地址。如果有dns解析的也可以写主机名。 env.password='indionce' #指定远端主机的密码,如果各个密码不相同可以使用一个字典指定,例如:env.password={“root@192.168.122.101”:"indionce"} @runs_once def local_uname(): #定义一个本地任务的函数 local('uname -r') def remote_uname(): #定义一个远程任务的函数 run('uname -r') def uname(): #定义一个函数,将本地与远端组合起来使用 local_uname() remote_uname() 查看列表 from fabric.api import * @runs_once #一定要指定这一条,否则会让你输入多次路径 def input(): return prompt("input path:") #prompt函数,让用户输入自己想要的路径,将输入的值返回到函数。 def ls_path(dirname): #在定义函数的时候指定形参。 run("ls -l "+dirname) def go(): ls_path(input()) #使用input返回的值,用于ls_path()的参数 处理异常 from fabric.api import * from fabric.contrib.console import * #这个模块中包含confirm def backup(): with settings(warn_only=True): #with命令表示执行这句后,执行下面的命令。使用settings命令来设置警告模式 state=local('mkdir /root/zz') #创建一个文件夹 if state.failed and not confirm("/root/zz is already exist,continue?"): #使用failed来判断state这条命令是否失败,失败了为真。confirm向用户确认是否继续,继续为真。如果命令失败了,并且用户希望停止,便通过if判断。 abort("退出任务") #abort是退出任务,有些类似python的exit。退出并且时返回给用户一串字符串 local('tar cavf /root/zz/etc.tar.gz /etc') #将etc的文件备份到/root/zz文件夹中 并行执行与顺序执行 @parallel #将下面的函数设为并行执行。 def runs_parallel(): run('uname -r') @serial #将下面的函数设为顺序执行(默认即为顺序执行 ) def runs_serially(): pass @parallel(pool_size=5) #将下面的函数设为并行执行,并且限制最多5个线程。 def runs_parallel(): pass

优秀的个人博客,低调大师

Hadoop运维操作

1. 处理hadoop的namenode宕机 处理措施: 进入hadoop的bin目录,重启namenode服务 操作命令: cd path/to/hadoop/bin ./hadoop-daemon.sh start namenode 2. 处理hadoop的jobtacker宕机 处理措施: 进入hadoop的bin目录,重启jobtacker服务 操作命令: cd path/to/hadoop/bin ./hadoop-daemon.sh start jobtracker 3. 处理hadoop的datanode宕机 处理措施: 进入hadoop的bin目录,重启datanode服务 操作命令: cd path/to/hadoop/bin ./hadoop-daemon.sh start datanode 4. 处理hadoop的tasktracker宕机 处理措施: 进入hadoop的bin目录,重启tasktacker服务 操作命令: cd path/to/hadoop/bin ./hadoop-daemon.sh start tasktracker 5. 启动hadoop集群 处理措施: 进入hadoop的bin目录,执行start-all.sh脚本 操作命令: cd path/to/hadoop/bin ./start-all.sh 注意事项: namenode在启动的时候首先进入安全模式,如果datanode丢失的block达到一定的比例(1- dfs.safemode.threshold.pct),则系统会一直处于安全模式状态即只读状态。 dfs.safemode.threshold.pct(缺省值0.999f)表示hdfs启动的时候,如果datanode上报的block个数达到了 元数据记录的block个数的0.999倍才可以离开安全模式,否则一直是这种只读模式。如果设为1则hdfs永远是处于safemode。 有两个方法离开这种安全模式 (1)修改dfs.safemode.threshold.pct为一个比较小的值,缺省是0.999。 (2)hadoop dfsadmin -safemode leave命令强制离开 用户可以通过dfsadmin -safemode $value来操作安全模式,参数$value的说明如下: enter – 进入安全模式 leave – 强制namenode离开安全模式 get – 返回安全模式是否开启的信息 wait – 等待,一直到安全模式结束。 6. 关闭hadoop机器 处理措施: 进入hadoop的bin目录,执行stop-all.sh脚本 操作命令: cd path/to/hadoop/bin ./ stop-all.sh 7. 从hadoop移除机器 处理措施: 把需要移除的机器增加到exclueds文件中,强制刷新datanode列表,等待decommission状态正常后,即可停机下架,如有必要在namenode执行balancer操作。 操作命令: 在master的conf/hdfs-site.xml中加入 <property> <name>dfs.hosts.exclude</name> <value>excludes</value> </property> 在$hadoop_home下创建exclueds文件 文件内容增加你想删除的节点的机器名,一行一个 /bin/hadoop dfsadmin -refreshnodes命令刷新datanode例表 /bin/hadoop dfsadmin -report查看结果 datanodes available: 1 (1 total, 0 dead) name: 192.168.200.118:50010 decommission status : decommission in progress configured capacity: 211370565632 (196.85 gb) dfs used: 11459694592 (10.67 gb) non dfs used: 187135799296 (174.28 gb) dfs remaining: 12775071744(11.9 gb) dfs used%: 5.42% dfs remaining%: 6.04% last contact: wed feb 22 23:51:48 pst 2012 在decommission status : decommission in progress变为 decommission status : decommission normal前mapreduce会异常增加节点 8. 向hadoop添加机器 处理措施: 把新机器的增加到conf/slaves文件中,重启datanode和jobtracker进程,当新添加的机器向namenode发送心跳信息后,namenode会自动感知新加入的机器,如果有必要可以做balancer操作。 操作命令: 1.把新机器的增加到conf/slaves文件中(datanode或者tasktracker crash则可跳过) 2.在新机器上进入hadoop安装目录 $bin/hadoop-daemon.sh start datanode $bin/hadoop-daemon.sh start tasktracker 3.在namenode上 $bin/hadoop balancer 9. 杀死正在运行的job 操作命令: bin/hadoop job –kill {job-id} 10.处理hbase的master宕机 操作命令: ./hbase-daemon.sh start master ./hbase-daemon.sh start zookeeper//可选 11.处理hbase的regionserver宕机 操作命令: ./hbase-daemon.sh start regionserver ./hbase-deamon.sh start zookeeper//可选 12.hbase集群间数据迁移方法总结 一、需要在hbase集群停掉的情况下迁移 步骤: (1)执行hadoop distcp -f filelist "hdfs://new cluster ip:9000/hbasetest" (2)在new cluster执行./hbase org.jruby.main add_table.rb /hbase/table20111222,将拷贝来的表加入到.meat.中(会出现region的数目不一致的问题,这个需要重启hase才能解决) 说明:(1)filelist为hdfs上的列表文件,内容如下: /hbase/table20111222 /hbase/table20120131 (2)如果两个集群的hadoop版本不一致,需要在new cluster上执行hadoop distcp,否则会出现读写异常; 二、在集群运行的时候进行数据迁移 1、replication:这个是动态的备份(可以理解为实时备份) 步骤:(1)在old cluster将需要迁移的表属性进行修改: disable 'your_table' alter 'your_table', {name => 'family_name', replication_scope => '1'} enable 'your_table' (2)打开new cluster集群的replication,修改hbase-site.xml <property> <name>hbase.replication</name> <value>true</value> </property> (3)添加peer,在new cluster的hbase shell中执行:add_peer '1','old cluster ip:2181:/hbase',启动replication,执行start_replication 说明:需要两个集群的hadoop版本一致,否则出现读写错误 2、copytable:可以在本集群中拷贝一张表,也可以将表拷贝到其他的集群中。 命令:./hbase org.apache.hadoop.hbase.mapreduce.copytable --peer.adr=new cluster ip:2181:/hbase zy_test 说明:(1)拷贝完成,不需要重启机器,在new cluster中就可以看到该表; (2)稳定性还需要考虑,测试过程中遇到一个问题 此文来自:马开东博客 转载请注明出处 网址:http://www.makaidong.com ,拷贝过程中始终都停留在这里lookedup root region location, 查看日志没有什么错误和相关的信息。 3、export and import 步骤:(1)在old cluster上执行:./hbase org.apache.hadoop.hbase.mapreduce.export test hdfs://new cluster ip:9000/zhuangyang/test (2)在new cluster上执行:./hbase org.apache.hadoop.hbase.mapreduce.import test hdfs://new cluster ip:9000/zhuangyang/test 说明:(1)一定要写全路径,不能写相对路劲; (2)在import前,需要将表事先在new cluster中创建好. 以上都是在old cluster和new cluster网络相通的情况下实现数据迁移的办法。 如果两个集群网络不通,只能先将old cluster中的数据都下载到本地或者其他的地方,然后在人工的转移到new cluster上了 13.不重启namenode可以使配置文件生效 hadoop dfsadmin -refreshnodes 14.清空垃圾回收站 [root@master data]# hadoop fs -rmr .Trash Deleted hdfs://master:9000/user/root/.Trash 此文链接:http://www.makaidong.com/%E5%8D%9A%E5%AE%A2%E5%9B%AD%E6%8E%92%E8%A1%8C/9639.shtml 本文转自茄子_2008博客园博客,原文链接:http://www.cnblogs.com/xd502djj/p/4675217.html,如需转载请自行联系原作者。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册