首页 文章 精选 留言 我的

精选列表

搜索[b2b2c],共231篇文章
优秀的个人博客,低调大师

java B2B2C Springcloud电子商务平台源码------Hystrix的缓存使用

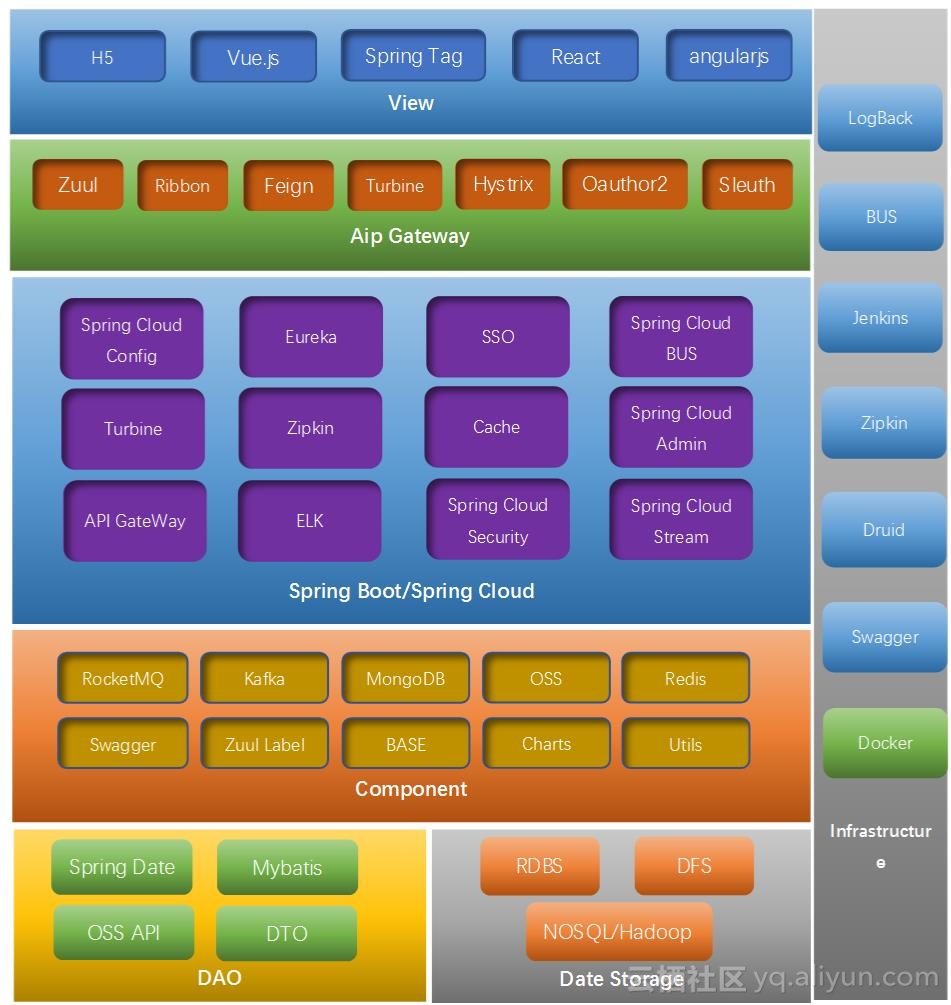
一介绍 在高并发的场景之下,Hystrix中提供了请求缓存的功能,可以方便地开启和使用请求缓存来优化系统,达到减轻高并发时请求线程的消耗、降低请求响应时间的效果。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 二开启请求缓存功能 在实现HystrixCommand或HystrixObservableCommand时,通过重载getCacheKey()方法来开启请求缓存。 例如: public class CommandUsingRequestCache extends HystrixCommand<Boolean> { private final int value; protected CommandUsingRequestCache(int value) { super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.value = value; } @Override protected Boolean run() { return value == 0 || value % 2 == 0; } //通过getCacheKey方法中返回的请求缓存key值,就能让该请求命令具备缓存功能。此时当不同的外部请求 //处理逻辑调用了同一个依赖服务时,Hystrix会根据getCacheKey方法返回的值区分是否是重复请求, //如果它们的cachekey相同时候,那么该依赖服务值会在第一个请求达到时被真实的调用一次,另外一个 //请求则直接从请求缓存中返回结果,所以开启缓存有以下好处: //减少重复请求数,降低依赖服务的并发度 //在同一用户请求的上下文中,相同依赖服务的返回数据始终保持一致。 //请求缓存在run()和construct()执行之前生效,所以可以有效减少不必要的线程开销。 @Override protected String getCacheKey() { return String.valueOf(value); } } 三清理失效缓存功能 使用请求缓存时,如果只是读操作,那么不需要考虑缓存内容是否正确的问题,但是如果请求命令中还有更新数据的操作,那么缓存中的数据就需要我们在进行写操作时进行及时处理,以防止读操作的请求命令获取到失效的数据。 在Hystrix中,可以通过HystrixRequestCache.clear()方法来进行缓存的清理。 例如: //当我们对GetterCommand命令实现了请求缓存之后,那么势必需要为SetterCommand命令实现清理缓存,以保证 //prefixStoredOnRemoteDataStore被更新之后,Hystrix请求缓存中相同的缓存的结果被移除,这样下一次根据id //获取prefixStoredOnRemoteDataStore时,不会从缓存去获取数据 public class CommandUsingRequestCacheInvalidation { /* represents a remote data store */ private static volatile String prefixStoredOnRemoteDataStore = "ValueBeforeSet_"; //根据id获取数据 public static class GetterCommand extends HystrixCommand<String> { private static final HystrixCommandKey GETTER_KEY = HystrixCommandKey.Factory.asKey("GetterCommand"); private final int id; public GetterCommand(int id) { super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("GetSetGet")) .andCommandKey(GETTER_KEY)); this.id = id; } @Override protected String run() { return prefixStoredOnRemoteDataStore + id; } @Override protected String getCacheKey() { return String.valueOf(id); } //该方法从默认的Hystrix并发策略中根据GETTER_KEY获取命令的请求缓存对象HystrixRequestCache的实例 //然后再调用该请求缓存对象的clear方法,对Key为id值的缓存内容进行清理。 public static void flushCache(int id) { HystrixRequestCache.getInstance(GETTER_KEY, HystrixConcurrencyStrategyDefault.getInstance()).clear(String.valueOf(id)); } } //用于更新prefixStoredOnRemoteDataStore的值 public static class SetterCommand extends HystrixCommand<Void> { private final int id; private final String prefix; public SetterCommand(int id, String prefix) { super(HystrixCommandGroupKey.Factory.asKey("GetSetGet")); this.id = id; this.prefix = prefix; } @Override protected Void run() { // persist the value against the datastore prefixStoredOnRemoteDataStore = prefix; //在调用了写prefixStoredOnRemoteDataStore之后,增加了对GetterCommand //中静态方法flushCache的调用,以实现对时效缓存的清理工作。 GetterCommand.flushCache(id); // no return value return null; } } } 代码结构如下:资料和源码来源
优秀的个人博客,低调大师

java B2B2C springmvc mybatis电子商务平台源码-------zuul网关实现

一、简介 在Springcloud中用zuul来实现网关功能,客户端的请求首先经过负载均衡Ngnix,再到达服务网关(zuul集群),然后再到具体的服务。Zuul的主要功能是路由转发和过滤器。路由功能是微服务的一部分,比如/api/server1转发到到server1服务。zuul默认和Ribbon结合实现了负载均衡的功能。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 二、搭建 首先是POM文件 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zuul</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> 然后在applicaton类加上注解@EnableZuulProxy,开启zuul的功能 @SpringBootApplication @EnableZuulProxy @EnableEurekaClient @RefreshScope public class HfzZuulApplication { public static void main(String[] args) { SpringApplication.run(HfzZuulApplication.class, args); } } yml配置如下 eureka: client: serviceUrl: defaultZone: http://name:pass@IP/eureka/ instance: ip-address: Ip地址 prefer-ip-address: true server: port: 8769 spring: application: name: service-zuul sleuth: sampler: percentage: 1.0 cloud: config: discovery: enabled: true service-id: CONFIG-SERVER label: master profile: dev name: hfz-zuul username: name password: pass 以上是在项目中配置的,为了使项目更加灵活,所以将路由的配置放在github上,这样可以动态读取 zuul: routes: api-a: path: /api-a/** serviceId: service-ribbon api-b: path: /api-b/** serviceId: service-feign 以/api-a/ 开头的请求都转发给service-ribbon服务;以/api-b/开头的请求都转发给service-feign服务; 三、服务过滤 zuul不仅可以路由,并且还能通过过滤来拦截一些服务,可以用来做安全验证。 public class MyFilter extends ZuulFilter{ private static Logger log = LoggerFactory.getLogger(MyFilter.class); @Override public String filterType() { return "pre"; } @Override public int filterOrder() { return 0; } @Override public boolean shouldFilter() { return true; } @Override public Object run() { RequestContext ctx = RequestContext.getCurrentContext(); HttpServletRequest request = ctx.getRequest(); log.info(String.format("%s >>> %s", request.getMethod(), request.getRequestURL().toString())); Object accessToken = request.getParameter("token"); if(accessToken == null) { log.warn("token is empty"); ctx.setSendZuulResponse(false); ctx.setResponseStatusCode(401); try { ctx.getResponse().getWriter().write("token is empty"); }catch (Exception e){} return null; } log.info("ok"); return null; } } filterType:返回一个字符串代表过滤器的类型,在zuul中定义了四种不同生命周期的过滤器类型,具体如下:pre:路由之前routing:路由之时post: 路由之后error:发送错误调用filterOrder:过滤的顺序shouldFilter:逻辑判断,是否要过滤run:过滤器的具体逻辑控制接下来就可以测试访问了。 技术架构图如下:资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十四-----注册中心 Consul

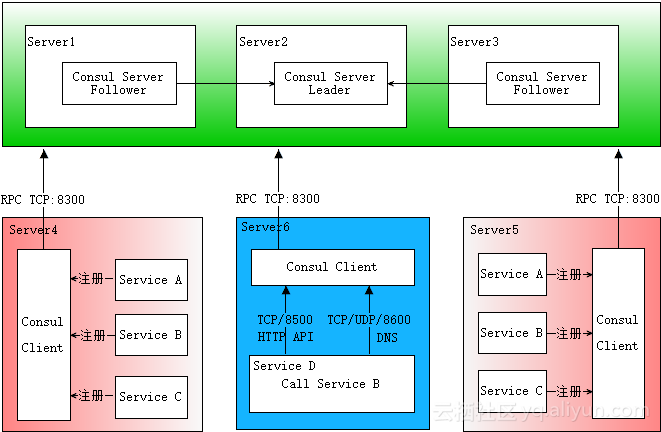
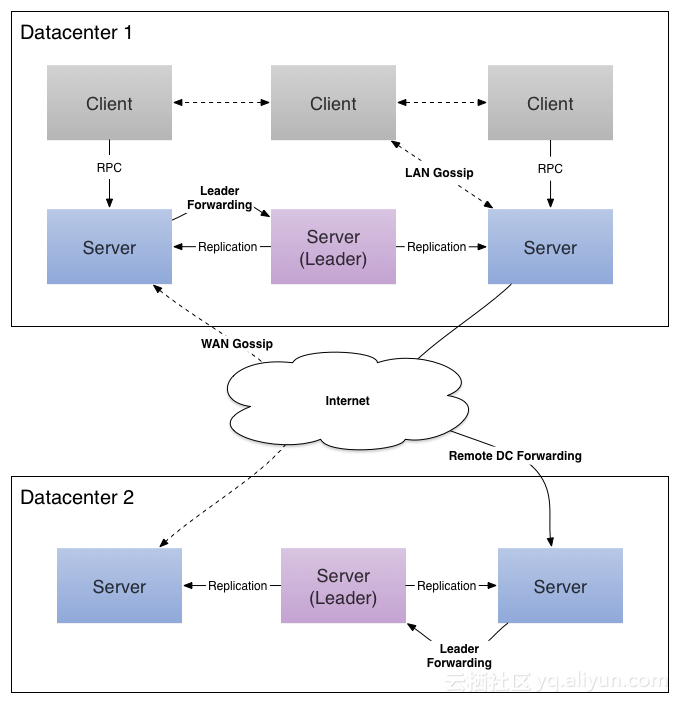
Consul 介绍Consul 是 HashiCorp 公司推出的开源工具,用于实现分布式系统的服务发现与配置。与其它分布式服务注册与发现的方案,Consul 的方案更“一站式”,内置了服务注册与发现框 架、分布一致性协议实现、健康检查、Key/Value 存储、多数据中心方案,不再需要依赖其它工具(比如 ZooKeeper 等)。使用起来也较 为简单。Consul 使用 Go 语言编写,因此具有天然可移植性(支持Linux、windows和Mac OS X);安装包仅包含一个可执行文件,方便部署,与 Docker 等轻量级容器可无缝配合。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 Consul 的优势: 使用 Raft 算法来保证一致性, 比复杂的 Paxos 算法更直接. 相比较而言, zookeeper 采用的是 Paxos, 而 etcd 使用的则是 Raft。支持多数据中心,内外网的服务采用不同的端口进行监听。 多数据中心集群可以避免单数据中心的单点故障,而其部署则需要考虑网络延迟, 分片等情况等。 zookeeper 和 etcd 均不提供多数据中心功能的支持。支持健康检查。 etcd 不提供此功能。支持 http 和 dns 协议接口。 zookeeper 的集成较为复杂, etcd 只支持 http 协议。官方提供 web 管理界面, etcd 无此功能。综合比较, Consul 作为服务注册和配置管理的新星, 比较值得关注和研究。特性: 服务发现健康检查Key/Value 存储多数据中心Consul 角色 client: 客户端, 无状态, 将 HTTP 和 DNS 接口请求转发给局域网内的服务端集群。server: 服务端, 保存配置信息, 高可用集群, 在局域网内与本地客户端通讯, 通过广域网与其它数据中心通讯。 每个数据中心的 server 数量推荐为 3 个或是 5 个。Consul 客户端、服务端还支持夸中心的使用,更加提高了它的高可用性。 Consul 工作原理: 1、当 Producer 启动的时候,会向 Consul 发送一个 post 请求,告诉 Consul 自己的 IP 和 Port2、Consul 接收到 Producer 的注册后,每隔10s(默认)会向 Producer 发送一个健康检查的请求,检验Producer是否健康3、当 Consumer 发送 GET 方式请求 /api/address 到 Producer 时,会先从 Consul 中拿到一个存储服务 IP 和 Port 的临时表,从表中拿到 Producer 的 IP 和 Port 后再发送 GET 方式请求 /api/address4、该临时表每隔10s会更新,只包含有通过了健康检查的 ProducerSpring Cloud Consul 项目是针对 Consul 的服务治理实现。Consul 是一个分布式高可用的系统,它包含多个组件,但是作为一个整体,在微服务架构中为我们的基础设施提供服务发现和服务配置的工具。 技术架构图如下: 资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十二-----Spring Cloud Sleuth

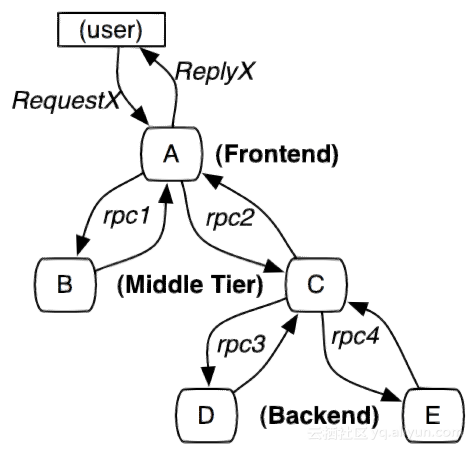
一、简介 Spring Cloud Sleuth 主要功能就是在分布式系统中提供追踪解决方案,并且兼容支持了 zipkin,你只需要在pom文件中引入相应的依赖即可。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 二、服务追踪分析 微服务架构上通过业务来划分服务的,通过REST调用,对外暴露的一个接口,可能需要很多个服务协同才能完成这个接口功能,如果链路上任何一个服务出现问题或者网络超时,都会形成导致接口调用失败。随着业务的不断扩张,服务之间互相调用会越来越复杂。 三、术语 Spring Cloud Sleuth采用的是Google的开源项目Dapper的专业术语。 Span:基本工作单元,例如,在一个新建的span中发送一个RPC等同于发送一个回应请求给RPC,span通过一个64位ID唯一标识,trace以另一个64位ID表示,span还有其他数据信息,比如摘要、时间戳事件、关键值注释(tags)、span的ID、以及进度ID(通常是IP地址)span在不断的启动和停止,同时记录了时间信息,当你创建了一个span,你必须在未来的某个时刻停止它。Trace:一系列spans组成的一个树状结构,例如,如果你正在跑一个分布式大数据工程,你可能需要创建一个trace。Annotation:用来及时记录一个事件的存在,一些核心annotations用来定义一个请求的开始和结束cs - Client Sent -客户端发起一个请求,这个annotion描述了这个span的开始sr - Server Received -服务端获得请求并准备开始处理它,如果将其sr减去cs时间戳便可得到网络延迟ss - Server Sent -注解表明请求处理的完成(当请求返回客户端),如果ss减去sr时间戳便可得到服务端需要的处理请求时间cr - Client Received -表明span的结束,客户端成功接收到服务端的回复,如果cr减去cs时间戳便可得到客户端从服务端获取回复的所有所需时间将Span和Trace在一个系统中使用Zipkin注解的过程图形化: 每个颜色的表明一个span(总计7个spans,从A到G),每个span有类似的信息 Trace Id = XSpan Id = DClient Sent此span表示span的Trance Id是X,Span Id是D,同时它发送一个Client Sent事件 spans 的parent/child关系图形化如下: spring cloud提供了spring-cloud-sleuth-zipkin来方便集成zipkin实现(指的是Zipkin Client,而不是Zipkin服务器),该jar包可以通过spring-cloud-starter-zipkin依赖来引入。 技术架构图如下:资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十三-----Spring Cloud Zipkin

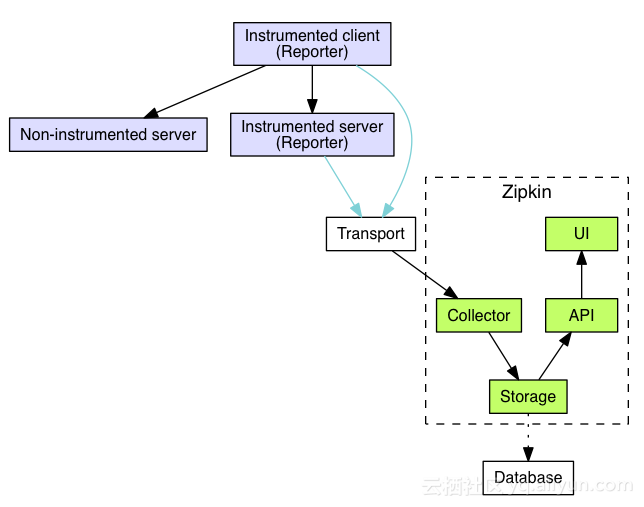
Zipkin是什么Zipkin分布式跟踪系统;它可以帮助收集时间数据,解决在microservice架构下的延迟问题;它管理这些数据的收集和查找;Zipkin的设计是基于谷歌的Google Dapper论文。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 每个应用程序向Zipkin报告定时数据,Zipkin UI呈现了一个依赖图表来展示多少跟踪请求经过了每个应用程序;如果想解决延迟问题,可以过滤或者排序所有的跟踪请求,并且可以查看每个跟踪请求占总跟踪时间的百分比。 为什么使用Zipkin随着业务越来越复杂,系统也随之进行各种拆分,特别是随着微服务架构和容器技术的兴起,看似简单的一个应用,后台可能有几十个甚至几百个服务在支撑;一个前端的请求可能需要多次的服务调用最后才能完成;当请求变慢或者不可用时,我们无法得知是哪个后台服务引起的,这时就需要解决如何快速定位服务故障点,Zipkin分布式跟踪系统就能很好的解决这样的问题。 Zipkin原理 针对服务化应用全链路追踪的问题,Google发表了Dapper论文,介绍了他们如何进行服务追踪分析。其基本思路是在服务调用的请求和响应中加入ID,标明上下游请求的关系。利用这些信息,可以可视化地分析服务调用链路和服务间的依赖关系。 对应Dpper的开源实现是Zipkin,支持多种语言包括JavaScript,Python,Java, Scala, Ruby, C#, Go等。其中Java由多种不同的库来支持 Spring Cloud Sleuth是对Zipkin的一个封装,对于Span、Trace等信息的生成、接入HTTP Request,以及向Zipkin Server发送采集信息等全部自动完成。 Zipkin架构 跟踪器(Tracer)位于你的应用程序中,并记录发生的操作的时间和元数据,提供了相应的类库,对用户的使用来说是透明的,收集的跟踪数据称为Span;将数据发送到Zipkin的仪器化应用程序中的组件称为Reporter,Reporter通过几种传输方式之一将追踪数据发送到Zipkin收集器(collector),然后将跟踪数据进行存储(storage),由API查询存储以向UI提供数据。架构图如下: 1.TraceZipkin使用Trace结构表示对一次请求的跟踪,一次请求可能由后台的若干服务负责处理,每个服务的处理是一个Span,Span之间有依赖关系,Trace就是树结构的Span集合; 2.Span每个服务的处理跟踪是一个Span,可以理解为一个基本的工作单元,包含了一些描述信息:id,parentId,name,timestamp,duration,annotations等。 3.Transport收集的Spans必须从被追踪的服务运输到Zipkin collector,有三个主要的传输方式:HTTP, Kafka和Scribe; 4.Components有4个组件组成Zipkin:collector,storage,search,web UIcollector:一旦跟踪数据到达Zipkin collector守护进程,它将被验证,存储和索引,以供Zipkin收集器查找;storage:Zipkin最初数据存储在Cassandra上,因为Cassandra是可扩展的,具有灵活的模式,并在Twitter中大量使用;但是这个组件可插入,除了Cassandra之外,还支持ElasticSearch和MySQL; 存储,zipkin默认的存储方式为in-memory,即不会进行持久化操作。如果想进行收集数据的持久化,可以存储数据在Cassandra,因为Cassandra是可扩展的,有一个灵活的模式,并且在Twitter中被大量使用,我们使这个组件可插入。除了Cassandra,我们原生支持ElasticSearch和MySQL。其他后端可能作为第三方扩展提供。search:一旦数据被存储和索引,我们需要一种方法来提取它。查询守护进程提供了一个简单的JSON API来查找和检索跟踪,主要给Web UI使用;web UI:创建了一个GUI,为查看痕迹提供了一个很好的界面;Web UI提供了一种基于服务,时间和注释查看跟踪的方法。 整体代码结构如下:资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之七-Spring Cloud Config

在我们了解spring cloud config之前,我可以想想一个配置中心提供的核心功能应该有什么,愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 提供服务端和客户端支持 集中管理各环境的配置文件 配置文件修改之后,可以快速的生效 可以进行版本管理 支持大的并发查询 支持各种语言 Spring Cloud Config可以完美的支持以上所有的需求。 要使用加密和解密功能,您需要在JVM中安装全面的JCE(默认情况下不存在)。您可以从Oracle下载“Java加密扩展(JCE)无限强度管理策略文件”,并按照安装说明(实际上将JRE lib / security目录中的2个策略文件替换为您下载的文件)。 如果远程属性源包含加密内容(以{cipher}开头的值),则在通过HTTP发送到客户端之前,它们将被解密。这种设置的主要优点是,当它们“静止”时,属性值不必是纯文本(例如在git仓库中)。如果值无法解密,则从属性源中删除该值,并添加具有相同键的附加属性,但以“无效”作为前缀。和“不适用”的值(通常为“”)。这主要是为了防止密码被用作密码并意外泄漏。 如果要为config客户端应用程序设置远程配置存储库,可能会包含一个application.yml,例如:application.yml spring: datasource: username: dbuser password: '{cipher}FKSAJDFGYOS8F7GLHAKERGFHLSAJ' .properties文件中的加密值不能用引号括起来,否则不会解密该值:application.properties spring.datasource.username: dbuser spring.datasource.password: {cipher}FKSAJDFGYOS8F7GLHAKERGFHLSAJ 您可以安全地将此纯文本推送到共享git存储库,并且保密密码。 服务器还暴露了/encrypt和/decrypt端点(假设这些端点将被保护,并且只能由授权代理访问)。如果您正在编辑远程配置文件,可以使用Config Server通过POST到/encrypt端点来加密值,例如 $ curl localhost:8888/encrypt -d mysecret 682bc583f4641835fa2db009355293665d2647dade3375c0ee201de2a49f7bda 逆向操作也可通过/decrypt获得(如果服务器配置了对称密钥或全密钥对): 注意如果要加密的值具有需要进行URL编码的字符,则应使用--data-urlencode选项curl来确保它们已正确编码。 $ curl localhost:8888/decrypt -d 682bc583f4641835fa2db009355293665d2647dade3375c0ee201de2a49f7bda mysecret 如果您使用curl进行测试,则使用--data-urlencode(而不是-d)或设置显式Content-Type: text/plain,以确保在有特殊字符时正确地对数据进行编码('+'特别是棘手)。 将加密的值添加到{cipher}前缀,然后再将其放入YAML或属性文件中,然后再提交并将其推送到远程可能不安全的存储区。 /encrypt和/decrypt端点也都接受/*/{name}/{profiles}形式的路径,当客户端调用到主环境资源时,可以用于每个应用程序(名称)和配置文件控制密码。 注意为了以这种细微的方式控制密码,您还必须提供一种TextEncryptorLocator类型的@Bean,可以为每个名称和配置文件创建不同的加密器。默认提供的不会这样做(所有加密使用相同的密钥)。 spring命令行客户端(安装了Spring Cloud CLI扩展)也可以用于加密和解密,例如 $ spring encrypt mysecret --key foo 682bc583f4641835fa2db009355293665d2647dade3375c0ee201de2a49f7bda $ spring decrypt --key foo 682bc583f4641835fa2db009355293665d2647dade3375c0ee201de2a49f7bda mysecret 要在文件中使用密钥(例如用于加密的RSA公钥),使用“@”键入键值,并提供文件路径,例如 $ spring encrypt mysecret --key @${HOME}/.ssh/id_rsa.pub AQAjPgt3eFZQXwt8tsHAVv/QHiY5sI2dRcR+... 关键参数是强制性的(尽管有一个--前缀)。 整体代码结构如下: 资料和源码来源

优秀的个人博客,低调大师

java B2B2C 多级分销多租户电子商城系统-单点登录(SSO)简介

单点登录SSO(Single Sign-On)是身份管理中的一部分。 SSO的一种较为通俗的定义是:SSO是指访问同一服务器不同应用中的受保护资源的同一用户,只需要登录一次,即 通过一个应用中的安全验证后,再访问其他应用中的受保护资源时,不再需要重新登录验证。 目前的企业应用环境中,往往有很多的应用系统,如办公自动化(OA)系统,财务管理系统,档案管理系统,信息查询系统等等。这些应用系统服务于企业的信息 化建设,为企业带来了很好的效益。但是,用户在使用这些应用系统时,并不方便。用户每次使用系统,都必须输入用户名称和用户密码,进行身份验证;而且应用 系统不同,用户账号就不同,用户必须同时牢记多套用户名称和用户密码。特别是对于应用系统数目较多,用户数目也很多的企业,这个问题尤为突出。问题的原因 并不是系统开发出现失误,而是缺少整体规划,缺乏统一的用户登录平台,使用SSO技术可以解决以上这些问题。 一、使用SSO的好处主要有 (1)方便用户 用户使用应用系统时,能够一次登录,多次使用。用户不再需要每次输入用户名称和用户密码,也不需要牢记多套用户名称和用户密码。单点登录平台能够改善用户使用应用系统的体验。 (2)方便管理员 系统管理员只需要维护一套统一的用户账号,方便、简单。相比之下,系统管理员以前需要管理很多套的用户账号。每一个应用系统就有一套用户账号,不仅给管理上带来不方便,而且,也容易出现管理漏洞。 (3)简化应用系统开发 开发新的应用系统时,可以直接使用单点登录平台的用户认证服务,简化开发流程。单点登录平台通过提供统一的认证平台,实现单点登录。因此,应用系统并不需要开发用户认证程序。 二、实现SSO的技术主要有 (1)基于cookies实现,需要注意如下几点:如果是基于两个域名之间传递sessionid的方法可能在windows中成立,在 unix&linux中可能会出现问题;可以基于数据库实现;在安全性方面可能会作更多的考虑。另外,关于跨域问题,虽然cookies本身不跨 域,但可以利用它实现跨域的SSO。 (2)Broker-based(基于经纪人),例如Kerberos等; 这种技术的特点就是,有一个集中的认证和用户帐号管理的服务器。经纪人给被用于进一步请求的电子的身份存取。中央数据库的使用减少了管理的代价,并为认证 提供一个公共和独立的"第三方"。例如Kerberos、Sesame、IBM KryptoKnight(凭证库思想)等。 (3)Agent-based(基于代理) 在这种解决方案中,有一个自动地为不同的应用程序认证用户身份的代理程序。这个代理程序需要设计有不同的功能。比如, 它可以使用口令表或加密密钥来自动地将认证的负担从用户移开。代理被放在服务器上面,在服务器的认证系统和客户端认证方法之间充当一个"翻译"。例如 SSH等。 (4)Token-based,例如SecurID、WebID、现在被广泛使用的口令认证,比如FTP,邮件服务器的登录认证,这是一种简单易用的方式,实现一个口令在多种应用当中使用。 (5)基于网关 Agent and Broker-based,这里不作介绍。 (6)基于安全断言标记语言(SAML)实现,SAML(Security Assertion Markup Language,安全断言标记语言)的出现大大简化了SSO,并被OASIS批准为SSO的执行标准。开源组织OpenSAML 实现了 SAML 规范,可参考http//www.opensaml.org。 三、SUN SSO技术 SUN SSO技术是Sun Java System Access Manager产品中的一个组成部分。 Sun 的新身份管理产品包括Sun Java System Identity Manager、Sun Java System Directory Server Enterprise Edition 和 Sun Java System Access Manager,以上三者为Sun Java Identity Management Suite (身份识别管理套件)的组成部分,它们与Sun Java Application Platform Suite、Sun Java Availability Suite、Sun Java Communications Suite、Sun Java Web Infrastructure Suite组成Java ES。具有革新意义的这一系列产品提供端到端身份管理,同时可与 60 多种第三方资源和技术实现互操作,集成产品可以从SUN公司网站下载,一般以Agent软件方式提供,是业内集成程序最高、最为开放的身份管理解决方案之 一。 在Sun 的新身份管理产品中,Sun Java System Access Manager是基中的一个重要组成部分,Java Access Manager基于J2EE架构,采用标准的API,可扩展性强,具有高可靠性和高可用性,应用是部署在Servlets容器中的,支持分布式,容易部署 且有较低的TCO。通过使用集中验证点、其于角色的访问控制以及 SSO,Sun Java System Access Manager 为所有基于 Web 的应用程序提供了一个可伸缩的安全模型。它简化了信息交换和交易,同时能保护隐私及重要身份信息的安全。 四、CAS 介绍 CAS(Central Authentication Service),是耶鲁大学开发的单点登录系统(SSO,single sign-on),应用广泛,具有独立于平台的,易于理解,支持代理功能。CAS系统在各个大学如耶鲁大学、加州大学、剑桥大学、香港科技大学等得到应 用。 Spring Framework的Acegi安全系统支持CAS,并提供了易于使用的方案。Acegi安全系统,是一个用于Spring Framework的安全框架,能够和目前流行的Web容器无缝集成。它使用了Spring的方式提供了安全和认证安全服务,包括使用Bean Context,拦截器和面向接口的编程方式。因此,Acegi安全系统能够轻松地适用于复杂的安全需求。Acegi安全系统在国内外得到了广泛的应用, 有着良好的社区环境。 CAS 的设计目标 (1)为多个Web应用提供单点登录基础设施,同时可以为非Web应用但拥有Web前端的功能服务提供单点登录的功能; (2)简化应用认证用户身份的流程; (3)将用户身份认证集中于单一的Web应用,让用户简化他们的密码管理,从而提高安全性;而且当应用需要修改身份验证的业务逻辑时,不需要到处修改代码。 CAS 的实现原理 CAS(Central Authentication Server)被设计成一个独立的Web应用。实现原理非常简单。 CAS创建一个位数很长的随机数(ticket)。CAS把这个ticket和成功登录的用户以及用户要访问的service联系起来。例如,如果用户 peon重定向自service S,CAS创建ticket T,这个ticket T允许peon访问service S。这个ticket是个一次性的凭证;它仅仅用于peon和仅仅用于service S,并且只能使用一次,使用之后马上会过期,即ticket通过验证,CAS立即删除该ticket,使它以后不能再使用。这样可以保证其安全性。 关于ST,在取一个ST时,即使用delete Ticket(ticketId)同时将一次性的ST删除;而对于TGT或PT,则通过reset Timer(ticketId)以更新TGT或PT的时间。在CAS服务端返回的ST中只能得出用户名。 另外,CAS3.0版本也已经发布了,现在最新的版本是3.03,希望CAS3.0在向下兼容的同时,更能向我们提供一些新东西。

优秀的个人博客,低调大师

java B2B2C 源码 多级分销Springcloud多租户电子商城系统-KAFKA介绍

Kafka是一个分布式的、可分区的、可复制的消息系统。 它提供了普通消息系统的功能,但具有自己独特的设计。这个独特的设计是什么样的呢? 首先让我们看几个基本的消息系统术语: Kafka将消息以topic为单位进行归纳。 将向Kafka topic发布消息的程序成为producers. 将预订topics并消费消息的程序成为consumer. Kafka以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个broker. producers通过网络将消息发送到Kafka集群,集群向消费者提供消息,如下图所示: 客户端和服务端通过TCP协议通信。Kafka提供了Java客户端,并且对多种语言都提供了支持。 Topics 和Logs 先来看一下Kafka提供的一个抽象概念:topic. 一个topic是对一组消息的归纳。对每个topic,Kafka 对它的日志进行了分区,如下图所示: 每个分区都由一系列有序的、不可变的消息组成,这些消息被连续的追加到分区中。分区中的每个消息都有一个连续的序列号叫做offset,用来在分区中唯一的标识这个消息。 在一个可配置的时间段内,Kafka集群保留所有发布的消息,不管这些消息有没有被消费。比如,如果消息的保存策略被设置为2天,那么在一个消 息被发布的两天时间内,它都是可以被消费的。之后它将被丢弃以释放空间。Kafka的性能是和数据量无关的常量级的,所以保留太多的数据并不是问题。 实际上每个consumer唯一需要维护的数据是消息在日志中的位置,也就是offset.这个offset有consumer来维护:一般情 况下随着consumer不断的读取消息,这offset的值不断增加,但其实consumer可以以任意的顺序读取消息,比如它可以将offset设置 成为一个旧的值来重读之前的消息。 以上特点的结合,使Kafka consumers非常的轻量级:它们可以在不对集群和其他consumer造成影响的情况下读取消息。你可以使用命令行来"tail"消息而不会对其他正在消费消息的consumer造成影响。 将日志分区可以达到以下目的:首先这使得每个日志的数量不会太大,可以在单个服务上保存。另外每个分区可以单独发布和消费,为并发操作topic提供了一种可能。 分布式 每个分区在Kafka集群的若干服务中都有副本,这样这些持有副本的服务可以共同处理数据和请求,副本数量是可以配置的。副本使Kafka具备了容错能力。 每个分区都由一个服务器作为“leader”,零或若干服务器作为“followers”,leader负责处理消息的读和 写,followers则去复制leader.如果leader down了,followers中的一台则会自动成为leader。集群中的每个服务都会同时扮演两个角色:作为它所持有的一部分分区的leader,同 时作为其他分区的followers,这样集群就会据有较好的负载均衡。 Producers Producer将消息发布到它指定的topic中,并负责决定发布到哪个分区。通常简单的由负载均衡机制随机选择分区,但也可以通过特定的分区函数选择分区。使用的更多的是第二种。 consumer 发布消息通常有两种模式:队列模式和发布-订阅模式。队列模式中,consumers可以同时从服务端读取消息,每个消息只被其中一个consumer读到;发布-订阅模式中消息被广播到所有的consumer中。 Consumers可以加入一个consumer 组,共同竞争一个topic,topic中的消息将被分发到组中的一个成员中。同一组中的consumer可以在不同的程序中,也可以在不同的机器上。如果所有的consumer都在一个组中,这就成为了传统的队列模式,在各consumer中实现负载均衡。 如果所有的consumer都不在不同的组中,这就成为了发布-订阅模式,所有的消息都被分发到所有的consumer中。 更常见的是,每个topic都有若干数量的consumer组,每个组都是一个逻辑上的“订阅者”,为了容错和更好的稳定性,每个组由若干consumer组成。这其实就是一个发布-订阅模式,只不过订阅者是个组而不是单个consumer。 由两个机器组成的集群拥有4个分区 (P0-P3) 2个consumer组. A组有两个consumerB组有4个 相比传统的消息系统,Kafka可以很好的保证有序性。 传统的队列在服务器上保存有序的消息,如果多个consumers同时从这个服务器消费消息,服务器就会以消息存储的顺序向consumer分 发消息。虽然服务器按顺序发布消息,但是消息是被异步的分发到各consumer上,所以当消息到达时可能已经失去了原来的顺序,这意味着并发消费将导致 顺序错乱。为了避免故障,这样的消息系统通常使用“专用consumer”的概念,其实就是只允许一个消费者消费消息,当然这就意味着失去了并发性。 在这方面Kafka做的更好,通过分区的概念,Kafka可以在多个consumer组并发的情况下提供较好的有序性和负载均衡。将每个分区分 只分发给一个consumer组,这样一个分区就只被这个组的一个consumer消费,就可以顺序的消费这个分区的消息。因为有多个分区,依然可以在多 个consumer组之间进行负载均衡。注意consumer组的数量不能多于分区的数量,也就是有多少分区就允许多少并发消费。 Kafka只能保证一个分区之内消息的有序性,在不同的分区之间是不可以的,这已经可以满足大部分应用的需求。如果需要topic中所有消息的有序性,那就只能让这个topic只有一个分区,当然也就只有一个consumer组消费它。

优秀的个人博客,低调大师

java B2B2C springmvc mybatis多租户电子商城系统--Zuul的高可用

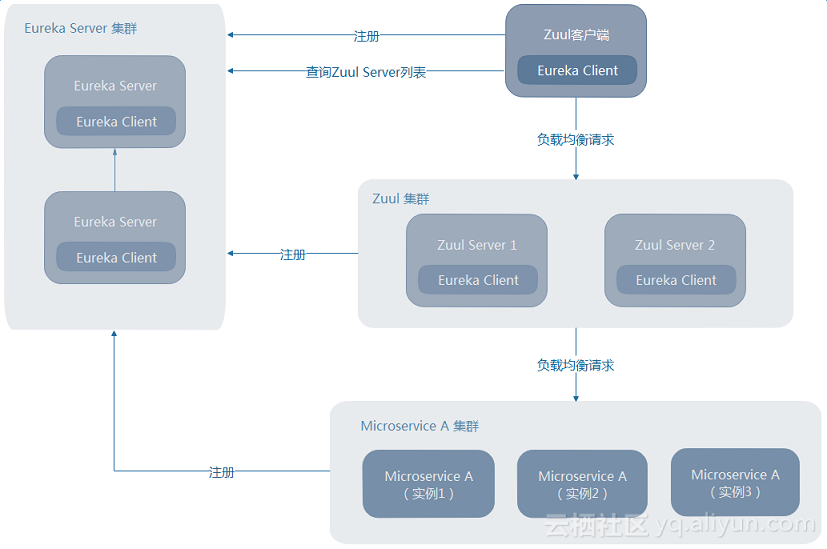
Zuul的高可用非常关键,因为外部请求到后端服务的流量都会经过Zuul。故而在生产环境下一般都需要部署高可用的Zuul以避免单点故障。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三一Zuul客户端也注册到EurekaServer上这种情况下,Zuul的高可用非常简单,只须将多个Zuul节点注册到EurekaServer上,就可实现Zuul的高可用。此时Zuul的高可用与其他微服务的高可用没什么区别。如下图,当Zuul客户端也注册到EurekaServer上时,只须部署多个Zuul节点即可实现其高可用。Zuul客户端会自动从EurekaServer中查询ZuulServer的列表,并使用Ribbon负责均衡地请求Zuul集群。 二Zuul客户端未注册到EurekaServer上现实中,这种场景更多,例如,Zuul客户端是一个手机APP——不可能让所有的手机终端都注册到EurekaServer上。这种情况下,可借助一个额外的负载均衡器来实现Zuul的高可用,例如Nginx、HAProxy、F5等。如下图,Zuul客户端请求发送到负载均衡器,负载均衡器将请求转发到其代理的其中一个Zuul节点。这样,就可以实现Zuul的高可用。 整体代码结构如下:资料和源码来源

优秀的个人博客,低调大师

java B2B2C源码电子商务平台 -----客户端负载均衡策略

一、负载均衡介绍负载均衡(Load Balance):建立在现有网络结构之上,它提供了一种廉价有效透明的方法扩展网络设备和服务器的带宽、增加吞吐量、加强网络数据处理能力、提高网络的灵活性和可用性。其意思就是分摊到多个操作单元上进行执行,例如Web服务器、FTP服务器、企业关键应用服务器和其它关键任务服务器等,从而共同完成工作任务。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 1、服务端负载均衡:客户端请求到负载均衡服务器,负载均衡服务器根据自身的算法将该请求转给某台真正提供业务的服务器,该服务器将响应数据给负载均衡服务器,负载均衡服务器最后将数据返回给客服端。(nginx) 2、客服端负载均衡:基于客户端的负载均衡,简单的说就是在客户端程序里面,自己设定一个调度算法,在向服务器发起请求的时候,先执行调度算法计算出向哪台服务器发起请求,然后再发起请求给服务器。 二、负载均衡策略介绍(1) AbstractLoadBalancerRuleAbstractLoadBalancerRule是一个抽象类,里边主要定义了一个ILoadBalancer,定义它的目的主要是辅助负责均衡策略选取合适的服务端实例。 (2) RandomRule该负载均衡策略就是随机选择一个服务实例,看源码我们知道,在RandomRule的无参构造方法中初始化了一个Random对象,然后在它重写的choose方法又调用了choose(ILoadBalancer lb, Object key)这个重载的choose方法,在这个重载的choose方法中,每次利用random对象生成一个不大于服务实例总数的随机数,并将该数作为下标所以获取一个服务实例。 (3) RoundRobinRuleRoundRobinRule这种负载均衡策略叫做线性负载均衡策略,也就是我们在上文所说的BaseLoadBalancer负载均衡器中默认采用的负载均衡策略。这个类的choose(ILoadBalancer lb, Object key)函数整体逻辑是这样的:开启一个计数器count,在while循环中遍历服务清单,获取清单之前先通过incrementAndGetModulo方法获取一个下标,这个下标是一个不断自增长的数先加1然后和服务清单总数取模之后获取到的(所以这个下标从来不会越界),拿着下标再去服务清单列表中取服务,每次循环计数器都会加1,如果连续10次都没有取到服务,则会报一个警告No available alive servers after 10 tries from load balancer: XXXX。 (4) RetryRule 看名字就知道这种负载均衡策略带有重试功能。首先RetryRule中又定义了一个subRule,它的实现类是RoundRobinRule,然后在RetryRule的choose(ILoadBalancer lb, Object key)方法中,每次还是采用RoundRobinRule中的choose规则来选择一个服务实例,如果选到的实例正常就返回,如果选择的服务实例为null或者已经失效,则在失效时间deadline之前不断的进行重试(重试时获取服务的策略还是RoundRobinRule中定义的策略),如果超过了deadline还是没取到则会返回一个null。 (5) WeightedResponseTimeRuleWeightedResponseTimeRule是RoundRobinRule的一个子类,在WeightedResponseTimeRule中对RoundRobinRule的功能进行了扩展,WeightedResponseTimeRule中会根据每一个实例的运行情况来给计算出该实例的一个权重,然后在挑选实例的时候则根据权重进行挑选,这样能够实现更优的实例调用。WeightedResponseTimeRule中有一个名叫DynamicServerWeightTask的定时任务,默认情况下每隔30秒会计算一次各个服务实例的权重,权重的计算规则也很简单,如果一个服务的平均响应时间越短则权重越大,那么该服务实例被选中执行任务的概率也就越大。 (6) ClientConfigEnabledRoundRobinRuleClientConfigEnabledRoundRobinRule选择策略的实现很简单,内部定义了RoundRobinRule,choose方法还是采用了RoundRobinRule的choose方法,所以它的选择策略和RoundRobinRule的选择策略一致,不赘述。 (7) BestAvailableRuleBestAvailableRule继承自ClientConfigEnabledRoundRobinRule,它在ClientConfigEnabledRoundRobinRule的基础上主要增加了根据loadBalancerStats中保存的服务实例的状态信息来过滤掉失效的服务实例的功能,然后顺便找出并发请求最小的服务实例来使用。然而loadBalancerStats有可能为null,如果loadBalancerStats为null,则BestAvailableRule将采用它的父类即ClientConfigEnabledRoundRobinRule的服务选取策略(线性轮询)。 (8) PredicateBasedRulePredicateBasedRule是ClientConfigEnabledRoundRobinRule的一个子类,它先通过内部定义的一个过滤器过滤出一部分服务实例清单,然后再采用线性轮询的方式从过滤出来的结果中选取一个服务实例。 (9) ZoneAvoidanceRuleZoneAvoidanceRule是PredicateBasedRule的一个实现类,只不过这里多一个过滤条件,ZoneAvoidanceRule中的过滤条件是以ZoneAvoidancePredicate为主过滤条件和以AvailabilityPredicate为次过滤条件组成的一个叫做CompositePredicate的组合过滤条件,过滤成功之后,继续采用线性轮询的方式从过滤结果中选择一个出来。使用ZoneAvoidancePredicate和AvailabilityPredicate来判断是否选择某个server,前一个判断判定一个zone的运行性能是否可用,剔除不可用的zone(的所有server),AvailabilityPredicate用于过滤掉连接数过多的Server。 技术架构图如下: 资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十------服务网关zuul

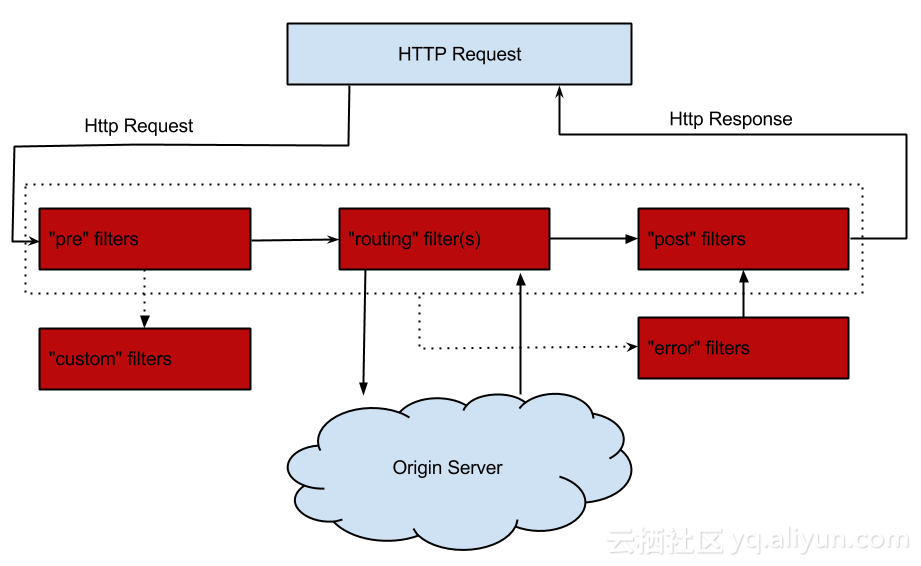
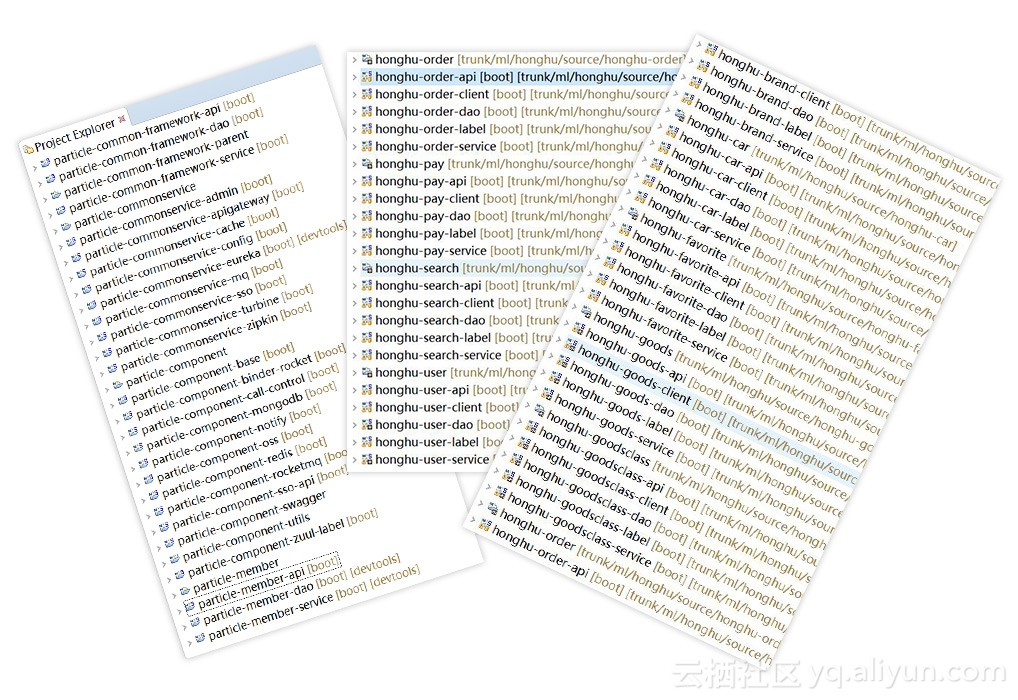
Zuul是什么微服务场景下,每一个微服务对外暴露了一组细粒度的服务。客户端的请求可能会涉及到一串的服务调用,如果将这些微服务都暴露给客户端,那么会增加客户端代码的复杂度。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 参考GOF设计模式中的Facade模式,将细粒度的服务组合起来提供一个粗粒度的服务,所有请求都导入一个统一的入口,那么整个服务只需要暴露一个api,对外屏蔽了服务端的实现细节,也减少了客户端与服务器的网络调用次数。这就是api gateway。 有了api gateway之后,一些与业务关系并不大的通用处理逻辑可以从api gateway中剥离出来,api gateway仅仅负责服务的编排与结果的组装。 Spring Cloud Netflix的Zuul组件可以做反向代理的功能,通过路由寻址将请求转发到后端的粗粒度服务上,并做一些通用的逻辑处理。 2.Zuul 能做什么Zuul可以通过加载动态过滤机制,从而实现以下各项功能: 验证与安全保障: 识别面向各类资源的验证要求并拒绝那些与要求不符的请求。审查与监控: 在边缘位置追踪有意义数据及统计结果,从而为我们带来准确的生产状态结论。动态路由: 以动态方式根据需要将请求路由至不同后端集群处。压力测试: 逐渐增加指向集群的负载流量,从而计算性能水平。负载分配: 为每一种负载类型分配对应容量,并弃用超出限定值的请求。静态响应处理: 在边缘位置直接建立部分响应,从而避免其流入内部集群。多区域弹性: 跨越AWS区域进行请求路由,旨在实现ELB使用多样化并保证边缘位置与使用者尽可能接近。3.Zuul的核心Filter是Zuul的核心,用来实现对外服务的控制。Filter的生命周期有4个,分别是“PRE”、“ROUTING”、“POST”、“ERROR”,整个生命周期可以用下图来表示。 Zuul大部分功能都是通过过滤器来实现的,这些过滤器类型对应于请求的典型生命周期。 PRE:这种过滤器在请求被路由之前调用。我们可利用这种过滤器实现身份验证、在集群中选择请求的微服务、记录调试信息等。ROUTING:这种过滤器将请求路由到微服务。这种过滤器用于构建发送给微服务的请求,并使用Apache HttpClient或Netfilx Ribbon请求微服务。POST:这种过滤器在路由到微服务以后执行。这种过滤器可用来为响应添加标准的HTTP Header、收集统计信息和指标、将响应从微服务发送给客户端等。ERROR:在其他阶段发生错误时执行该过滤器。 除了默认的过滤器类型,Zuul还允许我们创建自定义的过滤器类型。例如,我们可以定制一种STATIC类型的过滤器,直接在Zuul中生成响应,而不将请求转发到后端的微服务。Zuul中默认实现的Filter4.怎么使用ZuulSpring Cloud Zuul路由是微服务架构的不可或缺的一部分,提供动态路由,监控,弹性,安全等的边缘服务。Zuul是Netflix出品的一个基于JVM路由和服务端的负载均衡器。 下面我们通过代码来了解Zuul是如何工作的 1.简单使用 1、添加依赖 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zuul</artifactId> </dependency> 引入spring-cloud-starter-zuul包 2、配置文件 spring.application.name=gateway-service-zuul server.port=8888 #这里的配置表示,访问/it/** 直接重定向到http://www.ityouknow.com/** zuul.routes.baidu.path=/it/** zuul.routes.baidu.url=http://www.ityouknow.com/ 3、启动类 @SpringBootApplication @EnableZuulProxy public class GatewayServiceZuulApplication { public static void main(String[] args) { SpringApplication.run(GatewayServiceZuulApplication.class, args); } } 启动类添加@EnableZuulProxy,支持网关路由。 史上最简单的zuul案例就配置完了。 整体代码结构如下: 资料和源码来源

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册