Java并发编程-AQS
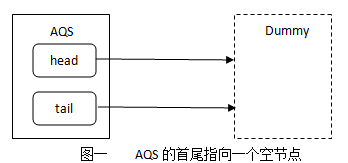
文章耗时一个月,所以篇幅有点长,需要一点耐心。 1、AQS产生背景 通过JCP的JSR166规范,Jdk1.5开始引入了j.u.c包,这个包提供了一系列支持并发的组件。这些组件是一系列的同步器,这些同步器主要维护着以下几个功能:内部同步状态的管理(例如表示一个锁的状态是获取还是释放),同步状态的更新和检查操作,且至少有一个方法会导致调用线程在同步状态被获取时阻塞,以及在其他线程改变这个同步状态时解除线程的阻塞。上述的这些的实际例子包括:互斥排它锁的不同形式、读写锁、信号量、屏障、Future、事件指示器以及传送队列等。可以看下这里的4.2的图便能理解j.u.c包的组件构成。 几乎任一同步器都可以用来实现其他形式的同步器。例如,可以用可重入锁实现信号量或者用信号量实现可重入锁。但是,这样做带来的复杂性、开销及不灵活使j.u.c最多只能是一个二流工程,且缺乏吸引力。如果任何这样的构造方式不能在本质上比其他形式更简洁,那么开发者就不应该随意地选择其中的某个来构建另一个同步器。因此,JSR166基于AQS类建立了一个小框架,这个框架为构造同步器提供一种通用的机制,并且被j.u.c包中大部分类使用,同时很多用户也可以用它来定义自己的同步器。这个就是j.u.c的作者Doug Lea大神的初衷,通过提供AQS这个基础组件来构建j.u.c的各种工具类,至此就可以理解AQS的产生背景了。 2、AQS的设计和结构 2.1设计思想 同步器的核心方法是acquire和release操作,其背后的思想也比较简洁明确。acquire操作是这样的: while (当前同步器的状态不允许获取操作) { 如果当前线程不在队列中,则将其插入队列 阻塞当前线程 } 如果线程位于队列中,则将其移出队列 release操作是这样的: 更新同步器的状态 if (新的状态允许某个被阻塞的线程获取成功) 解除队列中一个或多个线程的阻塞状态 从这两个操作中的思想中我们可以提取出三大关键操作:同步器的状态变更、线程阻塞和释放、插入和移出队列。所以为了实现这两个操作,需要协调三大关键操作引申出来的三个基本组件: ·同步器状态的原子性管理; ·线程阻塞与解除阻塞; ·队列的管理; 由这三个基本组件,我们来看j.u.c是怎么设计的。 2.1.1同步状态 AQS类使用单个int(32位)来保存同步状态,并暴露出getState、setState以及compareAndSet操作来读取和更新这个同步状态。其中属性state被声明为volatile,并且通过使用CAS指令来实现compareAndSetState,使得当且仅当同步状态拥有一个一致的期望值的时候,才会被原子地设置成新值,这样就达到了同步状态的原子性管理,确保了同步状态的原子性、可见性和有序性。 基于AQS的具体实现类(如锁、信号量等)必须根据暴露出的状态相关的方法定义tryAcquire和tryRelease方法,以控制acquire和release操作。当同步状态满足时,tryAcquire方法必须返回true,而当新的同步状态允许后续acquire时,tryRelease方法也必须返回true。这些方法都接受一个int类型的参数用于传递想要的状态。 2.1.2阻塞 直到JSR166,阻塞线程和解除线程阻塞都是基于Java的内置管程,没有其它非基于Java内置管程的API可以用来达到阻塞线程和解除线程阻塞。唯一可以选择的是Thread.suspend和Thread.resume,但是它们都有无法解决的竞态问题,所以也没法用,目前该方法基本已被抛弃。具体不能用的原因可以官方给出的答复。 j.u.c.locks包提供了LockSupport类来解决这个问题。方法LockSupport.park阻塞当前线程直到有个LockSupport.unpark方法被调用。unpark的调用是没有被计数的,因此在一个park调用前多次调用unpark方法只会解除一个park操作。另外,它们作用于每个线程而不是每个同步器。一个线程在一个新的同步器上调用park操作可能会立即返回,因为在此之前可以有多余的unpark操作。但是,在缺少一个unpark操作时,下一次调用park就会阻塞。虽然可以显式地取消多余的unpark调用,但并不值得这样做。在需要的时候多次调用park会更高效。park方法同样支持可选的相对或绝对的超时设置,以及与JVM的Thread.interrupt结合 ,可通过中断来unpark一个线程。 2.1.3队列 整个框架的核心就是如何管理线程阻塞队列,该队列是严格的FIFO队列,因此不支持线程优先级的同步。同步队列的最佳选择是自身没有使用底层锁来构造的非阻塞数据结构,业界主要有两种选择,一种是MCS锁,另一种是CLH锁。其中CLH一般用于自旋,但是相比MCS,CLH更容易实现取消和超时,所以同步队列选择了CLH作为实现的基础。 CLH队列实际并不那么像队列,它的出队和入队与实际的业务使用场景密切相关。它是一个链表队列,通过AQS的两个字段head(头节点)和tail(尾节点)来存取,这两个字段是volatile类型,初始化的时候都指向了一个空节点。如下图: 入队操作:CLH队列是FIFO队列,故新的节点到来的时候,是要插入到当前队列的尾节点之后。试想一下,当一个线程成功地获取了同步状态,其他线程将无法获取到同步状态,转而被构造成为节点并加入到同步队列中,而这个加入队列的过程必须要保证线程安全,因此同步器提供了一个CAS方法,它需要传递当前线程“认为”的尾节点和当前节点,只有设置成功后,当前节点才正式与之前的尾节点建立关联。入队操作示意图大致如下: 出队操作:因为遵循FIFO规则,所以能成功获取到AQS同步状态的必定是首节点,首节点的线程在释放同步状态时,会唤醒后续节点,而后续节点会在获取AQS同步状态成功的时候将自己设置为首节点。设置首节点是由获取同步成功的线程来完成的,由于只能有一个线程可以获取到同步状态,所以设置首节点的方法不需要像入队这样的CAS操作,只需要将首节点设置为原首节点的后续节点同时断开原节点、后续节点的引用即可。出队操作示意图大致如下: 这一小节只是简单的描述了队列的大概,目的是为了表达清楚队列的设计框架,实际上CLH队列已经和初始的CLH队列已经发生了一些变化,具体的可以看查看资料中Doug Lea的那篇论文中的3.3 Queues。 2.1.4条件队列 上一节的队列其实是AQS的同步队列,这一节的队列是条件队列,队列的管理除了有同步队列,还有条件队列。AQS只有一个同步队列,但是可以有多个条件队列。AQS框架提供了一个ConditionObject类,给维护独占同步的类以及实现Lock接口的类使用。 ConditionObject类实现了Condition接口,Condition接口提供了类似Object管程式的方法,如await、signal和signalAll操作,还扩展了带有超时、检测和监控的方法。ConditionObject类有效地将条件与其它同步操作结合到了一起。该类只支持Java风格的管程访问规则,这些规则中,当且仅当当前线程持有锁且要操作的条件(condition)属于该锁时,条件操作才是合法的。这样,一个ConditionObject关联到一个ReentrantLock上就表现的跟内置的管程(通过Object.wait等)一样了。两者的不同仅仅在于方法的名称、额外的功能以及用户可以为每个锁声明多个条件。 ConditionObject类和AQS共用了内部节点,有自己单独的条件队列。signal操作是通过将节点从条件队列转移到同步队列中来实现的,没有必要在需要唤醒的线程重新获取到锁之前将其唤醒。signal操作大致示意图如下: await操作就是当前线程节点从同步队列进入条件队列进行等待,大致示意图如下: 实现这些操作主要复杂在,因超时或Thread.interrupt导致取消了条件等待时,该如何处理。await和signal几乎同时发生就会有竞态问题,最终的结果遵照内置管程相关的规范。JSR133修订以后,就要求如果中断发生在signal操作之前,await方法必须在重新获取到锁后,抛出InterruptedException。但是,如果中断发生在signal后,await必须返回且不抛异常,同时设置线程的中断状态。 2.2方法结构 如果我们理解了上一节的设计思路,我们大致就能知道AQS的主要数据结构了。 组件 数据结构 同步状态 volatile int state 阻塞 LockSupport类 队列 Node节点 条件队列 ConditionObject 进而再来看下AQS的主要方法及其作用。 属性、方法 描述、作用 int getState() 获取当前同步状态 void setState(int newState) 设置当前同步状态 boolean compareAndSetState(int expect, int update) 通过CAS设置当前状态,此方法保证状态设置的原子性 boolean tryAcquire(int arg) 钩子方法,独占式获取同步状态,AQS没有具体实现,具体实现都在子类中,实现此方法需要查询当前同步状态并判断同步状态是否符合预期,然后再CAS设置同步状态 boolean tryRelease(int arg) 钩子方法,独占式释放同步状态,AQS没有具体实现,具体实现都在子类中,等待获取同步状态的线程将有机会获取同步状态 int tryAcquireShared(int arg) 钩子方法,共享式获取同步状态,AQS没有具体实现,具体实现都在子类中,返回大于等于0的值表示获取成功,反之失败 boolean tryReleaseShared(int arg) 钩子方法,共享式释放同步状态,AQS没有具体实现,具体实现都在子类中 boolean isHeldExclusively() 钩子方法,AQS没有具体实现,具体实现都在子类中,当前同步器是否在独占模式下被线程占用,一般该方法表示是否被当前线程所独占 void acquire(int arg) 模板方法,独占式获取同步状态,如果当前线程获取同步状态成功,则由该方法返回,否则会进入同步队列等待,此方法会调用子类重写的tryAcquire方法 void acquireInterruptibly(int arg) 模板方法,与acquire相同,但是此方法可以响应中断,当前线程未获取到同步状态而进入同步队列中,如果当前线程被中断,此方法会抛出InterruptedException并返回 boolean tryAcquireNanos(int arg, long nanosTimeout) 模板方法,在acquireInterruptibly基础上增加了超时限制,如果当前线程在超时时间内没有获取到同步状态,则会返回false,如果获取到了则会返回true boolean release(int arg) 模板方法,独占式的释放同步状态,该方法会在释放同步状态后,将同步队列中的第一个节点包含的线程唤醒 void acquireShared(int arg) 模板方法,共享式的获取同步状态,如果当前系统未获取到同步状态,将会进入同步队列等待,与acquire的主要区别在于同一时刻可以有多个线程获取到同步状态 void acquireSharedInterruptibly(int arg) 模板方法,与acquireShared一致,但是可以响应中断 boolean tryAcquireSharedNanos(int arg, long nanosTimeout) 模板方法,在acquireSharedInterruptibly基础上增加了超时限制 boolean releaseShared(int arg) 模板方法,共享式的释放同步状态 Collection<Thread> getQueuedThreads() 模板方法,获取等待在同步队列上的线程集合 Node int waitStatus 等待状态 1、 CANCELLED,值为1,在同步队列中等待的线程等待超时或者被中断,需要从同步队列中取消等待,节点进入该状态后将不会变化; 2、 SIGNAL,值为-1,后续节点的线程处于等待状态,而当前节点的线程如果释放了同步状态或者被取消,将会通知后续节点,使后续节点的线程得以运行; 3、 CONDITION,值为-2,节点在条件队列中,节点线程等待在Condition上,当其他线程对Condition调用了signal()方法后,该节点将会从条件队列中转移到同步队列中,加入到对同步状态的获取中; 4、 PROPAGATE,值为-3,表示下一次共享式同步状态获取将会无条件地传播下去 Node prev 前驱节点,当节点加入同步队列时被设置 Node next 后续节点 Thread thread 获取同步状态的线程 Node nextWaiter 条件队列中的后续节点,如果当前节点是共享的,那么这个字段将是一个SHARED变量,也就是说节点类型(独占和共享)和条件队列中的后续节点共用同一个字段 LockSupport void park() 阻塞当前线程,如果调用unpark方法或者当前线程被中断,才能从park方法返回 LockSupport void unpark(Thread thread) 唤醒处于阻塞状态的线程 ConditionObject Node firstWaiter 条件队列首节点 ConditionObject Node lastWaiter 条件队列尾节点 void await() 当前线程进入等待状态直到signal或中断,当前线程将进入运行状态且从await方法返回的情况,包括: 其他线程调用该Condition的signal或者signalAll方法,且当前线程被选中唤醒; 其他线程调用interrupt方法中断当前线程; 如果当前线程从await方法返回表明该线程已经获取了Condition对象对应的锁 void awaitUninterruptibly() 和await方法类似,但是对中断不敏感 long awaitNanos(long nanosTimeout) 当前线程进入等待状态直到被signal、中断或者超时。返回值表示剩余的时间。 boolean awaitUntil(Date deadline) 当前线程进入等待状态直到被signal、中断或者某个时间。如果没有到指定时间就被通知,方法返回true,否则表示到了指定时间,返回false void signal() 唤醒一个等待在Condition上的线程,该线程从等待方法返回前必须获得与Condition相关联的锁 void signalAll() 唤醒所有等待在Condition上的线程,能够从等待方法返回的线程必须获得与Condition相关联的锁 看到这,我们对AQS的数据结构应该基本上有一个大致的认识,有了这个基本面的认识,我们就可以来看下AQS的源代码。 3、AQS的源代码实现 主要通过独占式同步状态的获取和释放、共享式同步状态的获取和释放来看下AQS是如何实现的。 3.1独占式同步状态的获取和释放 独占式同步状态调用的方法是acquire,代码如下: public final void acquire(int arg) { if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 上述代码主要完成了同步状态获取、节点构造、加入同步队列以及在同步队列中自旋等待的相关工作,其主要逻辑是:首先调用子类实现的tryAcquire方法,该方法保证线程安全的获取同步状态,如果同步状态获取失败,则构造独占式同步节点(同一时刻只能有一个线程成功获取同步状态)并通过addWaiter方法将该节点加入到同步队列的尾部,最后调用acquireQueued方法,使得该节点以自旋的方式获取同步状态。如果获取不到则阻塞节点中的线程,而被阻塞线程的唤醒主要依靠前驱节点的出队或阻塞线程被中断来实现。 下面来首先来看下节点构造和加入同步队列是如何实现的。代码如下: private Node addWaiter(Node mode) { // 当前线程构造成Node节点 Node node = new Node(Thread.currentThread(), mode); // Try the fast path of enq; backup to full enq on failure // 尝试快速在尾节点后新增节点 提升算法效率 先将尾节点指向pred Node pred = tail; if (pred != null) { //尾节点不为空 当前线程节点的前驱节点指向尾节点 node.prev = pred; //并发处理 尾节点有可能已经不是之前的节点 所以需要CAS更新 if (compareAndSetTail(pred, node)) { //CAS更新成功 当前线程为尾节点 原先尾节点的后续节点就是当前节点 pred.next = node; return node; } } //第一个入队的节点或者是尾节点后续节点新增失败时进入enq enq(node); return node; } private Node enq(final Node node) { for (;;) { Node t = tail; if (t == null) { // Must initialize //尾节点为空 第一次入队 设置头尾节点一致 同步队列的初始化 if (compareAndSetHead(new Node())) tail = head; } else { //所有的线程节点在构造完成第一个节点后 依次加入到同步队列中 node.prev = t; if (compareAndSetTail(t, node)) { t.next = node; return t; } } } } 节点进入同步队列之后,就进入了一个自旋的过程,每个线程节点都在自省地观察,当条件满足,获取到了同步状态,就可以从这个自旋过程中退出,否则依旧留在这个自旋过程中并会阻塞节点的线程,代码如下: final boolean acquireQueued(final Node node, int arg) { boolean failed = true; try { boolean interrupted = false; for (;;) { //获取当前线程节点的前驱节点 final Node p = node.predecessor(); //前驱节点为头节点且成功获取同步状态 if (p == head && tryAcquire(arg)) { //设置当前节点为头节点 setHead(node); p.next = null; // help GC failed = false; return interrupted; } //是否阻塞 if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) interrupted = true; } } finally { if (failed) cancelAcquire(node); } } 再来看看shouldParkAfterFailedAcquire和parkAndCheckInterrupt是怎么来阻塞当前线程的,代码如下: private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) { //前驱节点的状态决定后续节点的行为 int ws = pred.waitStatus; if (ws == Node.SIGNAL) /*前驱节点为-1 后续节点可以被阻塞 * This node has already set status asking a release * to signal it, so it can safely park. */ return true; if (ws > 0) { /* * Predecessor was cancelled. Skip over predecessors and * indicate retry. */ do { node.prev = pred = pred.prev; } while (pred.waitStatus > 0); pred.next = node; } else { /*前驱节点是初始或者共享状态就设置为-1 使后续节点阻塞 * waitStatus must be 0 or PROPAGATE. Indicate that we * need a signal, but don't park yet. Caller will need to * retry to make sure it cannot acquire before parking. */ compareAndSetWaitStatus(pred, ws, Node.SIGNAL); } return false; } private final boolean parkAndCheckInterrupt() { //阻塞线程 LockSupport.park(this); return Thread.interrupted(); } 节点自旋的过程大致示意图如下,其实就是对图二、图三的补充。 图六 节点自旋获取队列同步状态 整个独占式获取同步状态的流程图大致如下: 图七 独占式获取同步状态 当同步状态获取成功之后,当前线程从acquire方法返回,对于锁这种并发组件而言,就意味着当前线程获取了锁。有获取同步状态的方法,就存在其对应的释放方法,该方法为release,现在来看下这个方法的实现,代码如下: public final boolean release(int arg) { if (tryRelease(arg)) {//同步状态释放成功 Node h = head; if (h != null && h.waitStatus != 0) //直接释放头节点 unparkSuccessor(h); return true; } return false; } private void unparkSuccessor(Node node) { /* * If status is negative (i.e., possibly needing signal) try * to clear in anticipation of signalling. It is OK if this * fails or if status is changed by waiting thread. */ int ws = node.waitStatus; if (ws < 0) compareAndSetWaitStatus(node, ws, 0); /*寻找符合条件的后续节点 * Thread to unpark is held in successor, which is normally * just the next node. But if cancelled or apparently null, * traverse backwards from tail to find the actual * non-cancelled successor. */ Node s = node.next; if (s == null || s.waitStatus > 0) { s = null; for (Node t = tail; t != null && t != node; t = t.prev) if (t.waitStatus <= 0) s = t; } if (s != null) //唤醒后续节点 LockSupport.unpark(s.thread); } 独占式释放是非常简单而且明确的。 总结下独占式同步状态的获取和释放:在获取同步状态时,同步器维护一个同步队列,获取状态失败的线程都会被加入到队列中并在队列中进行自旋;移出队列的条件是前驱节点为头节点且成功获取了同步状态。在释放同步状态时,同步器调用tryRelease方法释放同步状态,然后唤醒头节点的后继节点。 3.2共享式同步状态的获取和释放 共享式同步状态调用的方法是acquireShared,代码如下: public final void acquireShared(int arg) { //获取同步状态的返回值大于等于0时表示可以获取同步状态 //小于0时表示可以获取不到同步状态 需要进入队列等待 if (tryAcquireShared(arg) < 0) doAcquireShared(arg); } private void doAcquireShared(int arg) { //和独占式一样的入队操作 final Node node = addWaiter(Node.SHARED); boolean failed = true; try { boolean interrupted = false; //自旋 for (;;) { final Node p = node.predecessor(); if (p == head) { int r = tryAcquireShared(arg); if (r >= 0) { //前驱结点为头节点且成功获取同步状态 可退出自旋 setHeadAndPropagate(node, r); p.next = null; // help GC if (interrupted) selfInterrupt(); failed = false; return; } } if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) interrupted = true; } } finally { if (failed) cancelAcquire(node); } } private void setHeadAndPropagate(Node node, int propagate) { Node h = head; // Record old head for check below //退出自旋的节点变成首节点 setHead(node); /* * Try to signal next queued node if: * Propagation was indicated by caller, * or was recorded (as h.waitStatus either before * or after setHead) by a previous operation * (note: this uses sign-check of waitStatus because * PROPAGATE status may transition to SIGNAL.) * and * The next node is waiting in shared mode, * or we don't know, because it appears null * * The conservatism in both of these checks may cause * unnecessary wake-ups, but only when there are multiple * racing acquires/releases, so most need signals now or soon * anyway. */ if (propagate > 0 || h == null || h.waitStatus < 0 || (h = head) == null || h.waitStatus < 0) { Node s = node.next; if (s == null || s.isShared()) doReleaseShared(); } } 与独占式一样,共享式获取也需要释放同步状态,通过调用releaseShared方法可以释放同步状态,代码如下: public final boolean releaseShared(int arg) { //释放同步状态 if (tryReleaseShared(arg)) { //唤醒后续等待的节点 doReleaseShared(); return true; } return false; } private void doReleaseShared() { /* * Ensure that a release propagates, even if there are other * in-progress acquires/releases. This proceeds in the usual * way of trying to unparkSuccessor of head if it needs * signal. But if it does not, status is set to PROPAGATE to * ensure that upon release, propagation continues. * Additionally, we must loop in case a new node is added * while we are doing this. Also, unlike other uses of * unparkSuccessor, we need to know if CAS to reset status * fails, if so rechecking. */ //自旋 for (;;) { Node h = head; if (h != null && h != tail) { int ws = h.waitStatus; if (ws == Node.SIGNAL) { if (!compareAndSetWaitStatus(h, Node.SIGNAL, 0)) continue; // loop to recheck cases //唤醒后续节点 unparkSuccessor(h); } else if (ws == 0 && !compareAndSetWaitStatus(h, 0, Node.PROPAGATE)) continue; // loop on failed CAS } if (h == head) // loop if head changed break; } } unparkSuccessor方法和独占式是一样的。 4、AQS应用 AQS被大量的应用在了同步工具上。 ReentrantLock:ReentrantLock类使用AQS同步状态来保存锁重复持有的次数。当锁被一个线程获取时,ReentrantLock也会记录下当前获得锁的线程标识,以便检查是否是重复获取,以及当错误的线程试图进行解锁操作时检测是否存在非法状态异常。ReentrantLock也使用了AQS提供的ConditionObject,还向外暴露了其它监控和监测相关的方法。 ReentrantReadWriteLock:ReentrantReadWriteLock类使用AQS同步状态中的16位来保存写锁持有的次数,剩下的16位用来保存读锁的持有次数。WriteLock的构建方式同ReentrantLock。ReadLock则通过使用acquireShared方法来支持同时允许多个读线程。 Semaphore:Semaphore类(信号量)使用AQS同步状态来保存信号量的当前计数。它里面定义的acquireShared方法会减少计数,或当计数为非正值时阻塞线程;tryRelease方法会增加计数,在计数为正值时还要解除线程的阻塞。 CountDownLatch:CountDownLatch类使用AQS同步状态来表示计数。当该计数为0时,所有的acquire操作(对应到CountDownLatch中就是await方法)才能通过。 FutureTask:FutureTask类使用AQS同步状态来表示某个异步计算任务的运行状态(初始化、运行中、被取消和完成)。设置(FutureTask的set方法)或取消(FutureTask的cancel方法)一个FutureTask时会调用AQS的release操作,等待计算结果的线程的阻塞解除是通过AQS的acquire操作实现的。 SynchronousQueues:SynchronousQueues类使用了内部的等待节点,这些节点可以用于协调生产者和消费者。同时,它使用AQS同步状态来控制当某个消费者消费当前一项时,允许一个生产者继续生产,反之亦然。 除了这些j.u.c提供的工具,还可以基于AQS自定义符合自己需求的同步器。 AQS就学习到这,如果有描述不当的地方,还请留言交流。了解了AQS后下一步准备详细学习基于AQS的工具类。