首页 文章 精选 留言 我的

精选列表

搜索[自动化研究],共10001篇文章
优秀的个人博客,低调大师

Android robotium自动化测试

Robotium是一款测试AndroidApp的测试框架,它使得编写黑盒测试代码更加容易和稳定。它其实是对android自带测试类Instrumentation的一个封装,方便于测试人员直接调用封装好的接口。通过使用Robotium,测试用例开发人员能够跨越多个Activity,开发出功能,系统以及验收测试用例。如果你能够拿到代码,你可以直接进行白盒测试,比如assert一下当前的activity,操作的结果对不对等等,都可以验证。官方例子: http://code.g...m/p/robotium/ 下面的以测试Android自带的NotePad源代码为例: 首先创建一个Android Project,选择Create Project form existing source,选择F:\android-sdk-windows\samples\android-8\NotePad 接下来创建Android Test Project 导入 robotium-solo-2.5.jar(可到官方例子下载,上边的链接),编写自动测试脚本如下: 下面是详细的测试内容: 附上截图的功能: 有时textview或者button的click方法会失效,解决方法是在被测程序的配置文件AndroidManifest.xml文件里加上这么一句: <supports-screens android:anyDensity="true"/>就行了。如果要想在robotium的测试程序里读写SD 卡,可以被测程序的AndroidManifest.xml文件里加上 <uses-permission android:name="android.permission.WRITE_EXTERNAL_STORAGE"></uses-permission> <uses-permission android:name="android.permission.MOUNT_UNMOUNT_FILESYSTEMS"></uses-permission>。 注意是在被测程序里加上。 本文转自06peng 51CTO博客,原文链接:http://blog.51cto.com/06peng/962867,如需转载请自行联系原作者

优秀的个人博客,低调大师

React Native自动化测试

大凡做软件开发,肯定会涉及到很多的测试,本地测试,Junit测试,用例测试等,今天就来说说RN的测试。 React Native的官方代码仓库里有一些测试代码,你可以在贡献代码之后回归测试一下,以检测有没有引起别的问题。这些测试是通过Travis持续集成系统来运行的,并且会自动针对你提交的代码给出测试结果。 当然我们的测试不可能有完整的覆盖率(尤其对于复杂的用户交互),所以很多更改也还需要仔细的人工审查。我们期待你能帮助我们提高测试覆盖率,以及提供更多的测试代码或是测试用例。 使用Jest来测试 Jest是在命令行通过node来执行的纯js测试工具。测试代码放置在__tests__目录下。有一些功能我们还没有完成模拟(jest中需要模拟一些接口),因而没有纳入测试,以避免测试不通过和提高测试速度,但我们正在尽最大努力去逐渐补完这些功能的模拟。你可以在react-native源代码的根目录中使用如下命令来运行现有的jest测试代码: npm test 我们建议你在贡献代码的时候也添加自己的测试代码。你可以参考这个简单的例子getImageSource-test.js。 注意:要运行你自己的测试代码,请首先去jest的官网阅读指导文档,然后在package.json中加入jest对象,在其中包含一些预备测试环境的脚本。下面是一个示例: ... "scripts": { ... "test": "jest" }, ... "jest": { "scriptPreprocessor": "node_modules/react-native/jestSupport/preprocessor.js", "setupEnvScriptFile": "node_modules/react-native/jestSupport/env.js", "testPathIgnorePatterns": [ "/node_modules/", "packager/react-packager/src/Activity/" ], "testFileExtensions": [ "js" ], "unmockedModulePathPatterns": [ "promise", "source-map" ] }, ... 注意:你可能需要先在当前的环境中安装、更新或是链接Node.js和其他的一些工具,不然测试可能无法正常运行。点这里查看最新的测试配置文件.travis.yml。 单元测试 (Android) React Native使用Buck编译工具来运行测试。 单元测试部分直接在本地运行,不需要模拟器。运行下面的命令来执行这些测试: $ cd react-native $ ./scripts/run-android-local-unit-tests.sh 集成测试 (Android) React Native使用Buck编译工具来运行测试。 集成测试需要在模拟器/真机上运行,以验证模块、组件以及React Native的内核部分(比如bridge)在端对端测试中运作正常。 确保你正确安装和配置了Android NDK,具体配置参见这篇文档,然后运行下面的命令来执行测试: $ cd react-native $ npm install $ ./scripts/run-android-local-integration-tests.sh 集成测试 (iOS) React Native提供了一些工具来简化跨原生与JS端的组件的集成测试。这套工具的两个主要部分是RCTTestRunner与RCTTestModule。RCTTestRunner预设了ReactNative的环境,并且可以以XCTestCase的形式在Xcode中直接运行测试 (最简单的方法就是使用runTest:module)。而RCTTestModule则是以NativeModules.TestModule对象导出到了JS环境中。测试代码需要以JS写成的,并且必须在测试完成后调用TestModule.markTestCompleted()方法,否则测试过程会超时并且失败。失败的表现一般是抛出一个JS异常。测试错误条件也是可行的,使用runTest:module:initialProps:expectErrorRegex:或是runTest:module:initialProps:expectErrorBlock:方法,它们会按提供的条件去验证抛出的错误是否符合。你可以参考IntegrationTestHarnessTest.js、IntegrationTests.m以及IntegrationTestsApp.js来看具体怎么做集成测试。 Xcode中运行IntegrationTest和UIExplorer两个官方示例应用时,可以按下cmd + U键来直接在本地运行集成测试。 快照测试 (iOS) 快照测试是集成测试的一种常见类型。这类测试首先渲染一个组件,然后使用TestModule.verifySnapshot()比对屏幕截图与参考效果图,其原理是利用了FBSnapshotTestCase这个库。参考效果图是通过在RCTTestRunner中设置recordMode = YES,然后在运行测试时录制的。屏幕截图在32位和64位色深以及不同的操作系统版本上可能会有细微的差别,所以建议强制在指定的配置环境中执行测试。此外我们还强烈建议所有的网络数据和其他的潜在依赖项都应该事先模拟。你可以参考SimpleSnapshotTest这个例子。 如果你提交的PR(Pull Request,即提交你贡献的代码,并请求官方人员合并到仓库中)会影响到快照测试,比如给现有的快照测试添加一个新的测试用例,那么首先需要重新录制参考效果图。只需在UIExplorer/UIExplorerSnapshotTests.m中设置_runner.recordMode = YES;,然后重新运行先前失败的测试代码,再之后将这一设置改回去,最后提交/更新你的PR,看Travis的自动测试能否通过。

优秀的个人博客,低调大师

RPA机器人CI/CD:自动化流程也需要自动化部署

去年冬天,我帮一家中型制造企业做RPA流程改造。当时他们已经用传统方式部署了三十多个机器人,负责订单录入、库存对账、报表生成这些重复性工作。项目上线三个月,问题开始集中爆发:开发环境跑得好好的流程,到生产环境就报错;某个网页改版后,十几个机器人的元素定位全部失效;最要命的是,每次更新都要运维同事一台机器一台机器地手动替换脚本,光是发版就折腾到凌晨两点。

优秀的个人博客,低调大师

Hadoop 序列化的研究

Hadoop和java自带的序列化机制不同,它自己提供了一组序列化体系接口和类。 对于基本数据类型,Writable接口就代表了可以被序列化的数据,这个接口定义了2个方法,其中write方法可以吧这个数据序列化到参数给出的DataOutput的字节数组中,而readField方法则可以从DatInput中读取被序列化后的字节数组,并且反序列化为Hadoop数据: publicinterfaceWritable{ /** *Serializethefieldsofthisobjectto<code>out</code>. * *@paramout<code>DataOuput</code>toserializethisobjectinto. *@throwsIOException */ voidwrite(DataOutputout)throwsIOException; /** *Deserializethefieldsofthisobjectfrom<code>in</code>. * *<p>Forefficiency,implementationsshouldattempttore-usestorageinthe *existingobjectwherepossible.</p> * *@paramin<code>DataInput</code>todeseriablizethisobjectfrom. *@throwsIOException */ voidreadFields(DataInputin)throwsIOException; } 但是在Hadoop中,序列化过程一般用于Map-Reduce,我们看不到序列化的中间产物。为了捕捉到序列化的轨迹,我们自己写了一个工具方法,让其序列化到字节数组中,这样我们可以把字节数组的内容打印出来得到序列化后的产物: /* */ packagecom.charles.hadoop.serial; importjava.io.ByteArrayOutputStream; importjava.io.DataOutputStream; importjava.io.IOException; importorg.apache.hadoop.io.Writable; /** * *Description:这个类提供了工具方法来记录序列化的轨迹 *因为,在hadoop中序列化和反序列化都是在Writable接口中进行的,Writable是被序列化的Hadoop对象 *所以我们把序列化的产物存到字节数组中从而可以捕捉到内容 * *@authorcharles.wang *@createdJun2,20129:32:41AM * */ publicclassHadoopSerializationUtil{ //这个方法可以把Hadoop的对象(Writable表示这个是可以序列化的)序列化到字节数组中, //然后把字节数组中的内容返回出来 //入参,被序列化的数值对象 //返回值:序列化后的字节数组 publicstaticbyte[]serialize(Writablewritable)throwsIOException{ //创建一个字节数组 ByteArrayOutputStreamout=newByteArrayOutputStream(); //创建一个DataOutputStream,并且包装字节数组,用于存放序列化后的字节流 DataOutputStreamdataout=newDataOutputStream(out); //让Hadoop对象序列化到字节数组对应的字节流中 writable.write(dataout); dataout.close(); //返回序列化后的字节流 returnout.toByteArray(); } } 为了显示序列化前的Hadoop基本数据值和序列化后的字节数组,我们写了另一个工具类,这个工具类可以在包装序列化前后的信息到字符串对象中: /* */ packagecom.charles.hadoop.serial; importorg.apache.hadoop.io.BooleanWritable; importorg.apache.hadoop.io.ByteWritable; importorg.apache.hadoop.io.DoubleWritable; importorg.apache.hadoop.io.FloatWritable; importorg.apache.hadoop.io.IntWritable; importorg.apache.hadoop.io.LongWritable; importorg.apache.hadoop.io.Writable; importorg.apache.hadoop.util.StringUtils; /** * *Description:这个工具类用于帮助我们做实验, *它可以在封装序列化前的基本数据类型值和序列化后的字节数组的内容到字符串对象中 * *@authorcharles.wang *@createdJun2,20129:58:44AM * */ publicclassHadoopExperimentUtil{ publicstaticStringdisplaySerializationExperimentResult(Writablewritable)throwsException{ StringtypeInfo=null; StringprimaryValueInfo=null; byte[]serializedHadoopValue=null; StringlengthInfo=null; StringserializeValueInfo=null; //获取参数对象的类名 StringclassName=writable.getClass().getName(); if(className.equals("org.apache.hadoop.io.BooleanWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.BooleanWritable"+"\n"; primaryValueInfo="初始值为:"+((BooleanWritable)writable).get()+"\n"; } elseif(className.equals("org.apache.hadoop.io.ByteWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.ByteWritable"+"\n"; primaryValueInfo="初始值为:"+((ByteWritable)writable).get()+"\n"; } elseif(className.equals("org.apache.hadoop.io.IntWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.IntWritable"+"\n"; primaryValueInfo="初始值为:"+((IntWritable)writable).get()+"\n"; } elseif(className.equals("org.apache.hadoop.io.FloatWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.FloatWritable"+"\n"; primaryValueInfo="初始值为:"+((FloatWritable)writable).get()+"\n"; } elseif(className.equals("org.apache.hadoop.io.LongWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.LongWritable"+"\n"; primaryValueInfo="初始值为:"+((LongWritable)writable).get()+"\n"; } elseif(className.equals("org.apache.hadoop.io.DoubleWritable")){ typeInfo="被测试的Hadoop类型为:"+"org.apache.hadoop.io.DoubleWritable"+"\n"; primaryValueInfo="初始值为:"+((DoubleWritable)writable).get()+"\n"; } //使用我们自定义的工具类方法,这个方法最终会调用Writable接口的write方法执行序列化动作 serializedHadoopValue=HadoopSerializationUtil.serialize(writable); //获取序列化后的自己数组的长度信息 lengthInfo="序列化后的字节数组长度为:"+serializedHadoopValue.length+"\n"; //使用hadoop的StringUtils工具类来读取以16进制显示的字节数组的值 serializeValueInfo="序列化后的值为:"+StringUtils.byteToHexString(serializedHadoopValue)+"\n"; //返回全部信息 return"\n"+typeInfo+primaryValueInfo+lengthInfo+serializeValueInfo+"\n"; } } 最终,我们还需要一个实验类,我们传入各种Hadoop数据对象(都要是Writable的),然后我们依次调用实验工具类的方法,最终把这些序列化过程前后的信息打印在控制台上: /* */ packagecom.charles.hadoop.serial; importorg.apache.hadoop.io.BooleanWritable; importorg.apache.hadoop.io.ByteWritable; importorg.apache.hadoop.io.DoubleWritable; importorg.apache.hadoop.io.FloatWritable; importorg.apache.hadoop.io.IntWritable; importorg.apache.hadoop.io.LongWritable; /** * *Description:这里做实验 * *@authorcharles.wang *@createdJun2,20129:43:57AM * */ publicclassHadoopSerializationMain{ /** *@paramargs */ publicstaticvoidmain(String[]args)throwsException{ BooleanWritablehadoopBooleanValue=newBooleanWritable(false); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopBooleanValue)); byteb=3&0x0f; ByteWritablehadoopByteValue=newByteWritable(b); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopByteValue)); IntWritablehadoopIntValue=newIntWritable(100); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopIntValue)); FloatWritablehadoopFloatValue=newFloatWritable(73.54f); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopFloatValue)); LongWritablehadoopLongValue=newLongWritable(82l); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopLongValue)); DoubleWritablehadoopDoubleValue=newDoubleWritable(100.302d); System.out.println(HadoopExperimentUtil.displaySerializationExperimentResult(hadoopDoubleValue)); } } 最终控制台显示如下: 被测试的Hadoop类型为:org.apache.hadoop.io.BooleanWritable 初始值为:false 序列化后的字节数组长度为:1 序列化后的值为:00 被测试的Hadoop类型为:org.apache.hadoop.io.ByteWritable 初始值为:3 序列化后的字节数组长度为:1 序列化后的值为:03 被测试的Hadoop类型为:org.apache.hadoop.io.IntWritable 初始值为:100 序列化后的字节数组长度为:4 序列化后的值为:00000064 被测试的Hadoop类型为:org.apache.hadoop.io.FloatWritable 初始值为:73.54 序列化后的字节数组长度为:4 序列化后的值为:4293147b 被测试的Hadoop类型为:org.apache.hadoop.io.LongWritable 初始值为:82 序列化后的字节数组长度为:8 序列化后的值为:0000000000000052 被测试的Hadoop类型为:org.apache.hadoop.io.DoubleWritable 初始值为:100.302 序列化后的字节数组长度为:8 序列化后的值为:40591353f7ced917 我们从实验结果不难看出,Hadoop的序列化后的字节数组的长度和Java基本类型本身占用的字节数是完全匹配的。 本文转自 charles_wang888 51CTO博客,原文链接:http://blog.51cto.com/supercharles888/885400,如需转载请自行联系原作者

优秀的个人博客,低调大师

JPDA 架构研究2 - JVMTI代理

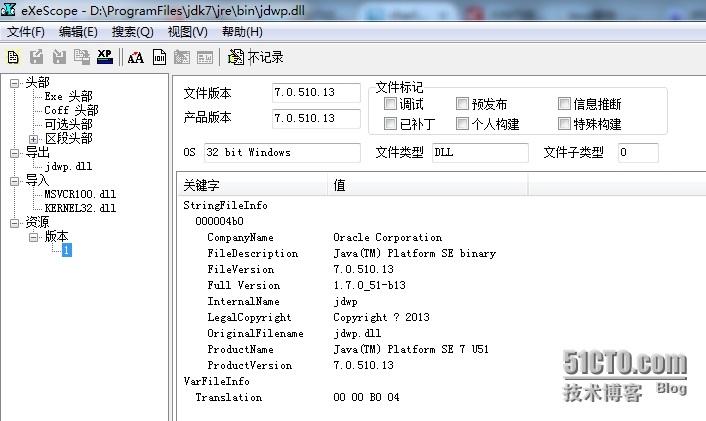
引入: 我们先从JVMTI讲起。JVMTI的主要作用是提供一组接口来检测VM的状态和控制VM中运行的JAVA程序。JVMTI是个双向接口: JVMTI的客户端叫Agent,它会在VM发生变化时通过事件机制被通知到变化。 JVMTI的服务端是许多函数,它们会和VM实际打交道并把结果告知Agent. 实践: 我们这里先来看下Agent. Agent的方法定义在哪里呢?它们定义在$JAVA_HOME/include/jvmti.h文件中。 1 2 3 4 5 JNIEXPORTjintJNICALL Agent_OnLoad(JavaVM*vm, char *options, void *reserved); JNIEXPORT void JNICAL。 Agent_OnUnload(JavaVM*vm); Agent_OnLoad方法: 当代理被VM加载时,会由VM调用Agent_Onload方法。此时VM有如下能力: (1)VM的System Property已经被设置完毕。 (2)VM的Capabilities已经被设置完毕。 (3)任何字节码都没被执行。 (4)任何类都没有被加载。 (5)任何对象都没有被创建。 Agent_OnLoad实现过程中,最重要的事情之一就是调用GetEnv方法来获取JVMTI环境的指针。 1 jintGetEnv(JavaVM*vm, void **env,jintversion); 这样,这个代理就可以知道被代理的环境的全部信息。 Agent_OnUnload方法: 当代理被VM卸载时,会由VM调用Agent_OnUnload方法。一般发生在终止VM的时候,它一般可以用来清理在Agent_OnLoad阶段创建的资源。 因为我们在远程调试时候启动JVM时候加了代理参数: java -agentlib:<agentLibName> ,而agentLibName我们配置的是jdwp, 所以它就对应上jdwp.dll. 也就是远程调试时候自动会在启动target VM时候启用jdwp这个代理库. 当明白了代理的作用后,我们来找其的实现。在Sun的JDK中,我们找到了jdwp.dll (Linux环境则是jdwp.so) . 它位于 $JAVA_HOME/jre/bin目录下。我们用exeScope软件打开查看内容: 显然,它是Oracle的Sun的JDK提供的Agent ,它提供了2个方法,一个是_Agent_OnLoad(),一个是_Agent_OnUnload() 和我们设想的一致。 总结: 从上过程我们似乎可以总结一些结论: 1. Agent 是在虚拟机启动之时加载的,这个加载处于虚拟机初始化的早期.在这个时间点上: 所有的 Java 类都未被初始化;所有的对象实例都未被创建; 因而,没有任何 Java 代码被执行; (从这点上说,最明显的好处就是它能完成早期调试中用System.out.println()无法解决的问题,因为System.out.println()前提是代码行所在的类已经被初始化过了) 2.但在这个时候,我们已经可以: 操作 JVMTI 的 Capability 参数; 使用系统参数; 动态库被加载之后,虚拟机会先寻找一个 Agent 入口函数. 本文转自 charles_wang888 51CTO博客,原文链接:http://blog.51cto.com/supercharles888/1587548,如需转载请自行联系原作者

优秀的个人博客,低调大师

JPDA 架构研究17 - JDI概览

引入: 前面用了很多篇幅来讨论JVMTI和JDWP部分,现在终于来看最靠近用户端部分了,JDI。 分析: a. JDI的基础知识 和JVMTI和JDWP不一样的是,JDI提供了一组接口,这些接口是纯JAVA编写的。他们主要是给开发环境IDE用的,虽然调试器的实现可以直接利用JDWP或者JVMTI,但是多了这一层则可以从用户的代码级别来定义要发送的请求和获取的信息。 本质上,Eclipse的调试器与目标VM之间的双向通信如下: 调试器将用户的操作转化为调试命令,命令通过链接被发送到前端运行目标程序的虚拟机上;然后,目标虚拟机根据接受的命令做出相应的操作,将调试的结果发回给后端的调试器;最后,调试器可视化数据信息反馈给用户。 JDI接口定义在$JAVA_HOME/lib/tools.jar中,从宏观上看,它分为5个大包。 包名 描述 com.sun.jdi 这是JDI的核心包,它提供了镜像机制将目标虚拟机上的所有数据、类型、域、方法、事件、状态和资源,以及调试器发向目标虚拟机的事件请求等都映射成 Mirror 对象 com.sun.jdi.connect 该包用于定义JDI到目标虚拟机的连接 com.sun.jdi.connect.spi 该包用于定义开发TransportService(也就是前面我在JDWP层讨论很深的传输器服务)所需要的必要的类和接口。 com.sun.jdi.event 该包定义了JDI事件和事件处理 com.sun.jdi.request 该包用于发送JDI事件然后在一定条件下发送。 b.JDI的具体实现 以Eclipse为例: org.eclipse.jdt.debug 是 JDI 的一个完整实现,而org.eclipse.jdt.debug.ui 是 Eclipse 调试工具界面的实现。从包名上看,我们大体上把JDI 分成三个部分: (1)数据模块。它负责调试器(Debugger)和目标虚拟机上(Target VM)的数据建模。 (2)链接模块。它建立调试器(Debugger)与目标虚拟机(Target VM)的沟通渠道。 (3)事件请求与处理模块。它提供调试器(Debugger)与目标虚拟机(VM)之间的交互方式。 我们会在接下来的几篇文章中从Eclipse的代码级别来分析这些模块。 本文转自 charles_wang888 51CTO博客,原文链接:http://blog.51cto.com/supercharles888/1587958,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册