首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10001篇文章
优秀的个人博客,低调大师

100个开箱即用的shell脚本,CV大法好,工作不费

Shell脚本是帮助程序员和系统管理员完成费时费力的枯燥工作的利器,是与计算机交互并管理文件和系统操作的有效方式。区区几行代码,就可以让计算机接近按照你的意图行事。 田哥为大家整理了100个实例,通过100个实战经典脚本实例,展示了shell脚本编程的实用技术和常见工具用法。大家只需根据自己的需求,将文中这些常见任务和可移植自动化脚本推广应用到其他类似问题上,能解决那些三天两头碰上的麻烦事。 PS:本文的脚本文件已经给大家整理成了 PDF 文档(知道大家喜欢电子版),具体获取方式见文末。 ## 1、检测两台服务器指定目录下的文件一致性 ``` #!/bin/bash ###################################### 检测两台服务器指定目录下的文件一致性 ##################################### #通过对比两台服务器上文件的md5值,达到检测一致性的目的 dir=/data/web b_ip=192.168.88.10 #将指定目录下的文件全部遍历出来并作为md5sum命令的参数,进而得到所有文件的md5值,并写入到指定文件中 find $dir -type f|xargs md5sum > /tmp/md5_a.txt ssh $b_ip "find $dir -type f|xargs md5sum > /tmp/md5_b.txt" scp $b_ip:/tmp/md5_b.txt /tmp #将文件名作为遍历对象进行一一比对 for f in `awk '{print 2} /tmp/md5_a.txt'`do #以a机器为标准,当b机器不存在遍历对象中的文件时直接输出不存在的结果 if grep -qw "$f" /tmp/md5_b.txt then md5_a=`grep -w "$f" /tmp/md5_a.txt|awk '{print $1}'` md5_b=`grep -w "$f" /tmp/md5_b.txt|awk '{print $1}'` #当文件存在时,如果md5值不一致则输出文件改变的结果 if [ $md5_a != $md5_b ]then echo "$f changed." fi else echo "$f deleted." fi done ``` ## 2、定时清空文件内容,定时记录文件大小 ``` #!/bin/bash ################################################################# 每小时执行一次脚本(任务计划),当时间为0点或12点时,将目标目录下的所有文件内#容清空,但不删除文件,其他时间则只统计各个文件的大小,一个文件一行,输出到以时#间和日期命名的文件中,需要考虑目标目录下二级、三级等子目录的文件 ################################################################ logfile=/tmp/`date +%H-%F`.log n=`date +%H` if [ $n -eq 00 ] || [ $n -eq 12 ] then #通过for循环,以find命令作为遍历条件,将目标目录下的所有文件进行遍历并做相应操作 for i in `find /data/log/ -type f` do true > $i done else for i in `find /data/log/ -type f` do du -sh $i >> $logfile done fi ``` ## 3、检测网卡流量,并按规定格式记录在日志中 ``` #!/bin/bash ####################################################### #检测网卡流量,并按规定格式记录在日志中#规定一分钟记录一次 #日志格式如下所示: #2019-08-12 20:40 #ens33 input: 1234bps #ens33 output: 1235bps ######################################################3 while : do #设置语言为英文,保障输出结果是英文,否则会出现bug LANG=en logfile=/tmp/`date +%d`.log #将下面执行的命令结果输出重定向到logfile日志中 exec >> $logfile date +"%F %H:%M" #sar命令统计的流量单位为kb/s,日志格式为bps,因此要*1000*8 sar -n DEV 1 59|grep Average|grep ens33|awk '{print $2,"\t","input:","\t",$5*1000*8,"bps","\n",$2,"\t","output:","\t",$6*1000*8,"bps"}' echo "####################" #因为执行sar命令需要59秒,因此不需要sleep done ``` ## 4、计算文档每行出现的数字个数,并计算整个文档的数字总数 ``` #!/bin/bash ######################################################### #计算文档每行出现的数字个数,并计算整个文档的数字总数 ######################################################## #使用awk只输出文档行数(截取第一段) n=`wc -l a.txt|awk '{print $1}'` sum=0 #文档中每一行可能存在空格,因此不能直接用文档内容进行遍历 for i in `seq 1 $n`do #输出的行用变量表示时,需要用双引号 line=`sed -n "$i"p a.txt`#wc -L选项,统计最长行的长度 n_n=`echo $line|sed s'/[^0-9]//'g|wc -L` echo $n_nsum=$[$sum+$n_n] done echo "sum:$sum" ``` ### 杀死所有脚本 ``` #!/bin/bash ################################################################ #有一些脚本加入到了cron之中,存在脚本尚未运行完毕又有新任务需要执行的情况, #导致系统负载升高,因此可通过编写脚本,筛选出影响负载的进程一次性全部杀死。 ################################################################ ps aux|grep 指定进程名|grep -v grep|awk '{print $2}'|xargs kill -9 ``` ## 5、从 FTP 服务器下载文件 ``` #!/bin/bash if [ $# -ne 1 ]; then echo "Usage: $0 filename" fi dir=$(dirname $1) file=$(basename $1) ftp -n -v << EOF # -n 自动登录 open 192.168.1.10 # ftp服务器 user admin password binary # 设置ftp传输模式为二进制,避免MD5值不同或.tar.gz压缩包格式错误 cd $dir get "$file" EOF ``` ## 6、连续输入5个100以内的数字,统计和、最小和最大 ``` #!/bin/bash COUNT=1 SUM=0 MIN=0 MAX=100 while [ $COUNT -le 5 ]; do read -p "请输入1-10个整数:" INT if [[ ! $INT =~ ^[0-9]+$ ]]; then echo "输入必须是整数!" exit 1 elif [[ $INT -gt 100 ]]; then echo "输入必须是100以内!" exit 1 fi SUM=$(($SUM+$INT)) [ $MIN -lt $INT ] && MIN=$INT [ $MAX -gt $INT ] && MAX=$INT let COUNT++ done echo "SUM: $SUM" echo "MIN: $MIN" echo "MAX: $MAX ``` ### 用户猜数字 ``` #!/bin/bash # 脚本生成一个 100 以内的随机数,提示用户猜数字,根据用户的输入,提示用户猜对了, # 猜小了或猜大了,直至用户猜对脚本结束。 # RANDOM 为系统自带的系统变量,值为 0‐32767的随机数 # 使用取余算法将随机数变为 1‐100 的随机数num=$[RANDOM%100+1]echo "$num" # 使用 read 提示用户猜数字 # 使用 if 判断用户猜数字的大小关系:‐eq(等于),‐ne(不等于),‐gt(大于),‐ge(大于等于), # ‐lt(小于),‐le(小于等于) while : do read -p "计算机生成了一个 1‐100 的随机数,你猜: " cai if [ $cai -eq $num ] then echo "恭喜,猜对了" exit elif [ $cai -gt $num ] then echo "Oops,猜大了" else echo "Oops,猜小了" fi done ``` ## 7、监测 Nginx 访问日志 502 情况,并做相应动作 假设服务器环境为 lnmp,近期访问经常出现 502 现象,且 502 错误在重启 php-fpm 服务后消失,因此需要编写监控脚本,一旦出现 502,则自动重启 php-fpm 服务。 ``` #场景: #1.访问日志文件的路径:/data/log/access.log #2.脚本死循环,每10秒检测一次,10秒的日志条数为300条,出现502的比例不低于10%(30条)则需要重启php-fpm服务 #3.重启命令为:/etc/init.d/php-fpm restart #!/bin/bash ########################################################### #监测Nginx访问日志502情况,并做相应动作 ########################################################### log=/data/log/access.log N=30 #设定阈值 while :do #查看访问日志的最新300条,并统计502的次数 err=`tail -n 300 $log |grep -c '502" '` if [ $err -ge $N ] then /etc/init.d/php-fpm restart 2> /dev/null #设定60s延迟防止脚本bug导致无限重启php-fpm服务 sleep 60 fi sleep 10 done ``` ## 8、将结果分别赋值给变量 应用场景:希望将执行结果或者位置参数赋值给变量,以便后续使用。 方法1: ``` for i in $(echo "4 5 6"); do eval a$i=$idone echo $a4 $a5 $a6 ``` 方法2:将位置参数192.168.1.1{1,2}拆分为到每个变量 ``` num=0 for i in $(eval echo $*);do #eval将{1,2}分解为1 2 let num+=1 eval node${num}="$i" done echo $node1 $node2 $node3 # bash a.sh 192.168.1.1{1,2} 192.168.1.11 192.168.1.12 ``` 方法3: ``` arr=(4 5 6) INDEX1=$(echo ${arr[0]}) INDEX2=$(echo ${arr[1]}) INDEX3=$(echo ${arr[2]}) ``` ## 9、批量修改文件名 示例: ``` # touch article_{1..3}.html # lsarticle_1.html article_2.html article_3.html 目的:把article改为bbs ``` 方法1: ``` for file in $(ls *html); do mv $file bbs_${file#*_} # mv $file $(echo $file |sed -r 's/.*(_.*)/bbs\1/') # mv $file $(echo $file |echo bbs_$(cut -d_ -f2) ``` 方法2: ``` for file in $(find . -maxdepth 1 -name "*html"); do mv $file bbs_${file#*_}done ``` 方法3: ``` # rename article bbs *.html 把一个文档前五行中包含字母的行删掉,同时删除6到10行包含的所有字母 ``` 1)准备测试文件,文件名为2.txt ``` 第1行1234567不包含字母 第2行56789BBBBBB 第3行67890CCCCCCCC 第4行78asdfDDDDDDDDD 第5行123456EEEEEEEE 第6行1234567ASDF 第7行56789ASDF 第8行67890ASDF 第9行78asdfADSF 第10行123456AAAA 第11行67890ASDF 第12行78asdfADSF 第13行123456AAAA ``` 2)脚本如下: ``` #!/bin/bash ############################################################### 把一个文档前五行中包含字母的行删掉,同时删除6到10行包含的所有字母 ############################################################## sed -n '1,5'p 2.txt |sed '/[a-zA-Z]/'d sed -n '6,10'p 2.txt |sed s'/[a-zA-Z]//'g sed -n '11,$'p 2.txt #最终结果只是在屏幕上打印结果,如果想直接更改文件,可将输出结果写入临时文件中,再替换2.txt或者使用-i选项 ``` ## 10、统计当前目录中以.html结尾的文件总大 方法1: ``` # find . -name "*.html" -exec du -k {} \; |awk '{sum+=$1}END{print sum}' ``` 方法2: ``` for size in $(ls -l *.html |awk '{print $5}'); do sum=$(($sum+$size)) done echo $sum ``` ## 11、扫描主机端口状态 ``` #!/bin/bash HOST=$1 PORT="22 25 80 8080" for PORT in $PORT; do if echo &>/dev/null > /dev/tcp/$HOST/$PORT; then echo "$PORT open" else echo "$PORT close" fi done ``` 用 shell 打印示例语句中字母数小于6的单词 ``` #示例语句: #Bash also interprets a number of multi-character options. #!/bin/bash ############################################################## #shell打印示例语句中字母数小于6的单词 ############################################################## for s in Bash also interprets a number of multi-character options. do n=`echo $s|wc -c` if [ $n -lt 6 ] then echo $s fi done ``` ## 12、输入数字运行相应命令 ``` #!/bin/bash ############################################################## #输入数字运行相应命令 ############################################################## echo "*cmd menu* 1-date 2-ls 3-who 4-pwd 0-exit " while : do #捕获用户键入值 read -p "please input number :" n n1=`echo $n|sed s'/[0-9]//'g` #空输入检测 if [ -z "$n" ] then continue fi #非数字输入检测 if [ -n "$n1" ] then exit 0 fi break done case $n in 1) date ;; 2) ls ;; 3) who ;; 4) pwd ;; 0) break ;; #输入数字非1-4的提示 *) echo "please input number is [1-4]" esac ``` ## 13、Expect 实现 SSH 免交互执行命令 Expect是一个自动交互式应用程序的工具,如telnet,ftp,passwd等。需先安装expect软件包。 方法1:EOF标准输出作为expect标准输入 ``` #!/bin/bash USER=root PASS=123.com IP=192.168.1.120 expect << EOFset timeout 30spawn ssh $USER@$IP expect { "(yes/no)" {send "yes\r"; exp_continue} "password:" {send "$PASS\r"} } expect "$USER@*" {send "$1\r"} expect "$USER@*" {send "exit\r"} expect eof EOF ``` 方法2: ``` #!/bin/bash USER=root PASS=123.com IP=192.168.1.120 expect -c " spawn ssh $USER@$IP expect { \"(yes/no)\" {send \"yes\r\"; exp_continue} \"password:\" {send \"$PASS\r\"; exp_continue} \"$USER@*\" {send \"df -h\r exit\r\"; exp_continue} }" ``` 方法3:将expect脚本独立出来 ``` 登录脚本: # cat login.exp #!/usr/bin/expect set ip [lindex $argv 0] set user [lindex $argv 1] set passwd [lindex $argv 2] set cmd [lindex $argv 3] if { $argc != 4 } { puts "Usage: expect login.exp ip user passwd" exit 1 } set timeout 30 spawn ssh $user@$ip expect { "(yes/no)" {send "yes\r"; exp_continue} "password:" {send "$passwd\r"} } expect "$user@*" {send "$cmd\r"} expect "$user@*" {send "exit\r"} expect eof ``` 执行命令脚本:写个循环可以批量操作多台服务器 ``` #!/bin/bash HOST_INFO=user_info.txt for ip in $(awk '{print $1}' $HOST_INFO) do user=$(awk -v I="$ip" 'I==$1{print $2}' $HOST_INFO) pass=$(awk -v I="$ip" 'I==$1{print $3}' $HOST_INFO) expect login.exp $ip $user $pass $1 done ``` Linux主机SSH连接信息: ``` # cat user_info.txt 192.168.1.120 root 123456 ``` 创建10个用户,并分别设置密码,密码要求10位且包含大小写字母以及数字,最后需要把每个用户的密码存在指定文件中 ``` #!/bin/bash ############################################################## #创建10个用户,并分别设置密码,密码要求10位且包含大小写字母以及数字 #最后需要把每个用户的密码存在指定文件中#前提条件:安装mkpasswd命令 ############################################################## #生成10个用户的序列(00-09) for u in `seq -w 0 09`do #创建用户 useradd user_$u #生成密码 p=`mkpasswd -s 0 -l 10` #从标准输入中读取密码进行修改(不安全) echo $p|passwd --stdin user_$u #常规修改密码 echo -e "$p\n$p"|passwd user_$u #将创建的用户及对应的密码记录到日志文件中 echo "user_$u $p" >> /tmp/userpassworddone ``` ## 14、监控 httpd 的进程数,根据监控情况做相应处理 ``` #!/bin/bash ############################################################################################################################### #需求: #1.每隔10s监控httpd的进程数,若进程数大于等于500,则自动重启Apache服务,并检测服务是否重启成功 #2.若未成功则需要再次启动,若重启5次依旧没有成功,则向管理员发送告警邮件,并退出检测 #3.如果启动成功,则等待1分钟后再次检测httpd进程数,若进程数正常,则恢复正常检测(10s一次),否则放弃重启并向管理员发送告警邮件,并退出检测 ############################################################################################################################### #计数器函数 check_service() { j=0 for i in `seq 1 5` do #重启Apache的命令 /usr/local/apache2/bin/apachectl restart 2> /var/log/httpderr.log #判断服务是否重启成功 if [ $? -eq 0 ] then break else j=$[$j+1] fi #判断服务是否已尝试重启5次 if [ $j -eq 5 ] then mail.py exit fi done }while :do n=`pgrep -l httpd|wc -l` #判断httpd服务进程数是否超过500 if [ $n -gt 500 ] then /usr/local/apache2/bin/apachectl restart if [ $? -ne 0 ] then check_service else sleep 60 n2=`pgrep -l httpd|wc -l` #判断重启后是否依旧超过500 if [ $n2 -gt 500 ] then mail.py exit fi fi fi #每隔10s检测一次 sleep 10done ``` ## 15、批量修改服务器用户密码 Linux主机SSH连接信息:旧密码 ``` # cat old_pass.txt 192.168.18.217 root 123456 22 192.168.18.218 root 123456 22 内容格式:IP User Password Port ``` SSH远程修改密码脚本:新密码随机生成 ``` #!/bin/bash OLD_INFO=old_pass.txt NEW_INFO=new_pass.txt for IP in $(awk '/^[^#]/{print $1}' $OLD_INFO); do USER=$(awk -v I=$IP 'I==$1{print $2}' $OLD_INFO) PASS=$(awk -v I=$IP 'I==$1{print $3}' $OLD_INFO) PORT=$(awk -v I=$IP 'I==$1{print $4}' $OLD_INFO) NEW_PASS=$(mkpasswd -l 8) # 随机密码 echo "$IP $USER $NEW_PASS $PORT" >> $NEW_INFO expect -c " spawn ssh -p$PORT $USER@$IP set timeout 2 expect { \"(yes/no)\" {send \"yes\r\";exp_continue} \"password:\" {send \"$PASS\r\";exp_continue} \"$USER@*\" {send \"echo \'$NEW_PASS\' |passwd --stdin $USER\r exit\r\";exp_continue} }" done ``` 生成新密码文件: ``` # cat new_pass.txt 192.168.18.217 root n8wX3mU% 22 192.168.18.218 root c87;ZnnL 22 ``` 16、iptables 自动屏蔽访问网站频繁的IP 场景:恶意访问,安全防范 1)屏蔽每分钟访问超过200的IP 方法1:根据访问日志(Nginx为例) ``` #!/bin/bash DATE=$(date +%d/%b/%Y:%H:%M) ABNORMAL_IP=$(tail -n5000 access.log |grep $DATE |awk '{a[$1]++}END{for(i in a)if(a[i]>100)print i}') #先tail防止文件过大,读取慢,数字可调整每分钟最大的访问量。awk不能直接过滤日志,因为包含特殊字符。 for IP in $ABNORMAL_IP; do if [ $(iptables -vnL |grep -c "$IP") -eq 0 ]; then iptables -I INPUT -s $IP -j DROP fidone ``` 方法2:通过TCP建立的连接 ``` #!/bin/bash ABNORMAL_IP=$(netstat -an |awk '$4~/:80$/ && $6~/ESTABLISHED/{gsub(/:[0-9]+/,"",$5);{a[$5]++}}END{for(i in a)if(a[i]>100)print i}') #gsub是将第五列(客户端IP)的冒号和端口去掉 for IP in $ABNORMAL_IP; do if [ $(iptables -vnL |grep -c "$IP") -eq 0 ]; then iptables -I INPUT -s $IP -j DROP fi done ``` 2)屏蔽每分钟SSH尝试登录超过10次的IP 方法1:通过lastb获取登录状态: ``` #!/bin/bash DATE=$(date +"%a %b %e %H:%M") #星期月天时分 %e单数字时显示7,而%d显示07 ABNORMAL_IP=$(lastb |grep "$DATE" |awk '{a[$3]++}END{for(i in a)if(a[i]>10)print i}')for IP in $ABNORMAL_IP; do if [ $(iptables -vnL |grep -c "$IP") -eq 0 ]; then iptables -I INPUT -s $IP -j DROP fidone ``` 方法2:通过日志获取登录状态 ``` #!/bin/bash DATE=$(date +"%b %d %H") ABNORMAL_IP="$(tail -n10000 /var/log/auth.log |grep "$DATE" |awk '/Failed/{a[$(NF-3)]++}END{for(i in a)if(a[i]>5)print i}')" for IP in $ABNORMAL_IP; do if [ $(iptables -vnL |grep -c "$IP") -eq 0 ]; then iptables -A INPUT -s $IP -j DROP echo "$(date +"%F %T") - iptables -A INPUT -s $IP -j DROP" >>~/ssh-login-limit.log fi done ``` ## 17、根据web访问日志,封禁请求量异常的IP,如IP在半小时后恢复正常,则解除封禁 ``` #!/bin/bash #################################################################################### #根据web访问日志,封禁请求量异常的IP,如IP在半小时后恢复正常,则解除封禁 #################################################################################### logfile=/data/log/access.log #显示一分钟前的小时和分钟 d1=`date -d "-1 minute" +%H%M` d2=`date +%M` ipt=/sbin/iptables ips=/tmp/ips.txt block() { #将一分钟前的日志全部过滤出来并提取IP以及统计访问次数 grep '$d1:' $logfile|awk '{print $1}'|sort -n|uniq -c|sort -n > $ips #利用for循环将次数超过100的IP依次遍历出来并予以封禁 for i in `awk '$1>100 {print $2}' $ips` do $ipt -I INPUT -p tcp --dport 80 -s $i -j REJECT echo "`date +%F-%T` $i" >> /tmp/badip.log done } unblock() { #将封禁后所产生的pkts数量小于10的IP依次遍历予以解封 for a in `$ipt -nvL INPUT --line-numbers |grep '0.0.0.0/0'|awk '$2<10 {print $1}'|sort -nr` do $ipt -D INPUT $a done $ipt -Z } #当时间在00分以及30分时执行解封函数 if [ $d2 -eq "00" ] || [ $d2 -eq "30" ] then #要先解再封,因为刚刚封禁时产生的pkts数量很少 unblock block else block fi ``` ## 18、判断用户输入的是否为IP地址 方法1: ``` #!/bin/bash function check_ip(){ IP=$1 VALID_CHECK=$(echo $IP|awk -F. '$1< =255&&$2<=255&&$3<=255&&$4<=255{print "yes"}') if echo $IP|grep -E "^[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}$">/dev/null; then if [ $VALID_CHECK == "yes" ]; then echo "$IP available." else echo "$IP not available!" fi else echo "Format error!" fi } check_ip 192.168.1.1 check_ip 256.1.1.1 ``` 方法2: ``` #!/bin/bash function check_ip(){ IP=$1 if [[ $IP =~ ^[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}$ ]]; then FIELD1=$(echo $IP|cut -d. -f1) FIELD2=$(echo $IP|cut -d. -f2) FIELD3=$(echo $IP|cut -d. -f3) FIELD4=$(echo $IP|cut -d. -f4) if [ $FIELD1 -le 255 -a $FIELD2 -le 255 -a $FIELD3 -le 255 -a $FIELD4 -le 255 ]; then echo "$IP available." else echo "$IP not available!" fi else echo "Format error!" fi } check_ip 192.168.1.1 check_ip 256.1.1.1 ``` 增加版: 加个死循环,如果IP可用就退出,不可用提示继续输入,并使用awk判断。 ``` #!/bin/bash function check_ip(){ local IP=$1 VALID_CHECK=$(echo $IP|awk -F. '$1< =255&&$2<=255&&$3<=255&&$4<=255{print "yes"}') if echo $IP|grep -E "^[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}$" >/dev/null; then if [ $VALID_CHECK == "yes" ]; then return 0 else echo "$IP not available!" return 1 fi else echo "Format error! Please input again." return 1 fi } while true; do read -p "Please enter IP: " IP check_ip $IP [ $? -eq 0 ] && break || continue done ``` 19、判断用户输入的是否为数字 方法1: ``` #!/bin/bash if [[ $1 =~ ^[0-9]+$ ]]; then echo "Is Number." else echo "No Number." fi ``` 方法2: ``` #!/bin/bash if [ $1 -gt 0 ] 2>/dev/null; then echo "Is Number." else echo "No Number." fi ``` 方法3: ``` #!/bin/bash echo $1 |awk '{print $0~/^[0-9]+$/?"Is Number.":"No Number."}' #三目运算符 12.14 找出包含关键字的文件 DIR=$1 KEY=$2 for FILE in $(find $DIR -type f); do if grep $KEY $FILE &>/dev/null; then echo "--> $FILE" fi done ``` ## 20、监控目录,将新创建的文件名追加到日志中 场景:记录目录下文件操作。需先安装inotify-tools软件包。 ``` #!/bin/bash MON_DIR=/opt inotifywait -mq --format %f -e create $MON_DIR |\ while read files; do echo $files >> test.log done ``` ## 21、给用户提供多个网卡选择 场景:服务器多个网卡时,获取指定网卡,例如网卡流量 ``` #!/bin/bash function local_nic() { local NUM ARRAY_LENGTH NUM=0 for NIC_NAME in $(ls /sys/class/net|grep -vE "lo|docker0"); do NIC_IP=$(ifconfig $NIC_NAME |awk -F'[: ]+' '/inet addr/{print $4}') if [ -n "$NIC_IP" ]; then NIC_IP_ARRAY[$NUM]="$NIC_NAME:$NIC_IP" #将网卡名和对应IP放到数组 let NUM++ fi done ARRAY_LENGTH=${#NIC_IP_ARRAY[*]} if [ $ARRAY_LENGTH -eq 1 ]; then #如果数组里面只有一条记录说明就一个网卡 NIC=${NIC_IP_ARRAY[0]%:*} return 0 elif [ $ARRAY_LENGTH -eq 0 ]; then #如果没有记录说明没有网卡 echo "No available network card!" exit 1 else #如果有多条记录则提醒输入选择 for NIC in ${NIC_IP_ARRAY[*]}; do echo $NIC done while true; do read -p "Please enter local use to network card name: " INPUT_NIC_NAME COUNT=0 for NIC in ${NIC_IP_ARRAY[*]}; do NIC_NAME=${NIC%:*} if [ $NIC_NAME == "$INPUT_NIC_NAME" ]; then NIC=${NIC_IP_ARRAY[$COUNT]%:*} return 0 else COUNT+=1 fi done echo "Not match! Please input again." done fi } local_nic ``` ## 22、MySQL数据库备份 ``` #!/bin/bash DATE=$(date +%F_%H-%M-%S) HOST=192.168.1.120 DB=test USER=bak PASS=123456 MAIL="zhangsan@example.com lisi@example.com" BACKUP_DIR=/data/db_backup SQL_FILE=${DB}_full_$DATE.sql BAK_FILE=${DB}_full_$DATE.zip cd $BACKUP_DIR if mysqldump -h$HOST -u$USER -p$PASS --single-transaction --routines --triggers -B $DB > $SQL_FILE; then zip $BAK_FILE $SQL_FILE && rm -f $SQL_FILE if [ ! -s $BAK_FILE ]; then echo "$DATE 内容" | mail -s "主题" $MAIL fi else echo "$DATE 内容" | mail -s "主题" $MAIL fi find $BACKUP_DIR -name '*.zip' -ctime +14 -exec rm {} \; ``` 由于篇幅有限,这里就只列出了其中22个脚本,不过100个吊炸天的实用shell脚本,我都整理好成一个PDF了, 免费分享给大伙,直接点击领取就行了。 - [**100g个超实用的shell脚本,开箱即用**](https://jq.qq.com/?_wv=1027&k=PjEVS3qt) 最后,都看到这了,各位看官老爷点个赞加个关注可好? **往期热文**: * [**Java基础知识总结**](https://juejin.cn/post/6959054747382841358) * [**性能调优系列专题(JVM、MySQL、Nginx and Tomcat)**](https://juejin.cn/post/6953887175062585375) * [**从被踢出局到5个30K+的offer,一路坎坷走来,沉下心,何尝不是前程万里**](https://juejin.cn/post/6951365625973309454) * [**100个Java项目解析,带源代码和学习文档!**](https://juejin.cn/post/6959440768658309157) end

优秀的个人博客,低调大师

金三银四,那些烧的JS面试题及原理

Q: JS代码是按顺序执行的吗? A: JS代码执行过程中,需要先做变量提升,而之所以需要实现变量提升是因为JS代码在执行之前需要先编译 1、变量提升 变量和函数声明会被存放到变量环境中,变量的默认值会被设置为undefined var scope = 'global scope' function a(){ // 3、顶层变量环境声明了scope初始化为undefined function b(){ // 2、b函数的上层作用域是a,向上找scope console.log(scope) } return b; // 1、虽然声明在return语句后面,依然会提升到a函数作用域的顶层 var scope = 'local scope' } a()() // undefined 1.1、同名处理 同名函数,选择最后声明的 变量和函数同名,选择函数 var a = 1 var getNum = function() { a = 2 } function getNum() { a = 3 } getNum() console.log(a) // 2 // 变量和函数同名选择提升函数,函数提升包含初始化和赋值,接着执行函数,var声明的getNum被赋值为一个函数执行完成更改变量a为2 1.2、提升阶段 创建 初始化 赋值 let 提升 x x var 提升 提升 x function 提升 提升 提升 在块作用域内,let声明的变量仅在创建时被提升,在初始化之前使用变量,就会形成一个暂时性死区 var name = 'World' ;(function () { if (typeof name === 'undefined') { var name = "HuaMu"; console.info('Goodbye ' + name) } else { console.info('Hello ' + name) } })() // if分支内的name会被提升到外层,且同全局变量同名,则访问不到外层的name,var仅创建和初始化,并未赋值,则值为undefined,满足if条件 // Goodbye HuaMu 2、调用栈 在执行上下文创建完成后,JS引擎会将执行上下文压入栈中,通常把这种用来管理执行上下文的栈称为执行上下文,又称调用栈 2.1、函数调用 JS引擎会为函数创建执行上下文,并将其压入调用栈 JS引擎执行函数代码 执行完毕后,JS引擎将该函数的执行上下文弹出栈 2.2、栈溢出 当分配的调用栈空间被占满时,会引发“栈溢出”问题。即超过了最大栈容量或最大调用深度 2.2.1、场景 <!-- todo --> 3、作用域 作用域就是变量与函数的可访问范围,即作用域控制着变量和函数的可见性和生命周期。主要有全局作用域、函数作用域以及块级作用域 当前作用域与上层作用域有同名变量时,无法访问和影响上层变量 let a = 1 function b(a) { a = 2 console.log(a) } b(a) // 2 console.log(a) // 1 4、作用域链 通过作用域查找变量的链条称为作用域链,而作用域链是通过词法作用域来确定的。词法作用域由函数声明的位置来决定,是静态的,即在代码阶段就决定好了,和函数是怎么调用的没有关系 // 连等操作是从右向左执行的,相当于b = 10、let a = b,相当于隐式创建为一个全局变量b let a = b = 10; ;(function(){ // 跟着作用域链查找到全局变量b,并修改为20 // 由于重新声明了,a变量只是局部变量,不影响全局变量a let a = b = 20 })() console.log(a) // 10 console.log(b) // 20 函数只会在第一次执行的时候被编译,因此编译时变量环境和词法环境最顶层数据已确定 var i = 1 function b() { console.log(i) } function a() { var i = 2 b() } // 由于a函数在全局作用域被定义,即便b函数在a函数内执行,它也只能访问到全局的作用域 a() // 1 5、闭包 一个作用域引用着一个本该被销毁的作用域,称之为闭包。即一个函数引用着父作用域的变量,在父函数执行结束后依然进行调用 6、this this是函数执行上下文对象,是动态变化的值,它没有作用域的限制,嵌套函数中的this不会从外层函数中继承,可通过箭头函数、self处理 6.1、类型 全局执行上下文中的this: window 函数执行上下文中的this: 严格模式 ? undefined: window var v_out = 'v_out'; let c_out = 'c_out'; var inner = { v_out: 'v_in', c_out: 'c_in', v_func: function () { return this.v_out }, c_func: function () { return this.c_out }, func:()=>{ return this.v_out } }; // 获取对象作用域内的函数,在全局环境下调用 this 指向 window const v_method = inner.v_func; const c_method = inner.c_func; // 顶层 v_out 变量会提升挂载到 window v_method(); // 'v_out' // 在块作用域内,const声明的变量不会挂载到 window,且父作用域不能访问子作用域 c_method(); // undefined // 赋值表达式和逗号表达式会返回最后一个值本身,即inner.v_func函数本身,调用位置是全局环境 (inner.v_func, inner.v_func)(); // 'v_out' (inner.v_func = inner.v_func)(); // 'v_out' // 对象的方法调用,this指向该对象 inner.v_func() // 'v_in' (inner.v_func)() // 'v_in' // 箭头函数没有自己的执行上下文,它继承调用函数的this,在这里是window inner.func() // 'v_out' 6.2、更改this指向 绑定优先级为:new > 显示绑定(call、apply、bind) > 隐式绑定(调用函数对象) > 默认绑定(window) 6.2.1、通过函数的call、apply、bind方法设置 c_method.call(inner) c_method.apply(inner) c_method.bind(inner)() 简单实现:call、apply 将当前函数链接到指定的上下文中,即将函数设置为对象属性 当前函数在context上下文中执行 移除context中已执行的当前函数 /** * 简单实现apply * @param {Function} fn 当前运行的函数 * @param {Object} context 指定的上下文 * @param {Array} args 参数集合 * @returns */ const apply = (fn,context=window,args=[])=>{ // Symbol是es6增加的第六个基本类型,对于对象属性就是uuid const id = Symbol(); // 将当前函数链接到指定的上下文中 context[id] = fn; // 当前函数在context上下文中执行 const res = context[id](...args) // 移除context中已执行的当前函数 delete context[id] return res; } // -------test------- // const context = { value:1 } function fn (name,isGirl){ console.log("🚀 ~ ", name,isGirl,this.value) } apply(fn,context,['huamu',true]) // 🚀 ~ huamu true 1 简单实现:bind 与call、apply不一样的点是bind返回一个新函数 function bind (fn, context=window, ...args) { return (...args2)=> apply(fn,context,[...args,...args2]) } 6.2.2、通过调用函数对象:指向对象本身 this的绑定是函数真正执行的位置 6.2.3、通过构造函数 function Foo() { getName = function () { console.log(1) } return this } Foo.getName = function () { console.log(2) } Foo.prototype.getName = function () { console.log(3) } var getName = function () { console.log(4) } function getName() { console.log(5) } // 执行Foo函数的静态方法 Foo.getName() // 2 // 函数getName提升并赋值,执行getName函数表达式 getName() // 4 // 在全局环境下执行Foo函数,this指向window,执行函数内的getName方法,覆盖了全局环境下的getName Foo().getName() // 1 getName() // 1 // new用于调用函数,即 new Foo.getName() 相当于 new (Foo.getName)(),执行了Foo函数的静态方法 new Foo.getName() // 2 // new 和 . 的优先级一样高,从左往右执行,相当于 (new Foo()).getName(),new会创建一个新对象,执行新对象的getName方法,在新对象本身找不到该方法,因此向原型找 new Foo().getName() // 3 new new Foo().getName() 简单实现:new 创建一个新对象,并指向函数原型 绑定this到新对象 返回对象 const newFn = (fn, ...arg) => { const obj = Object.create(fn.prototype); fn.apply(obj,arg) return obj } 拓展:Object.create方法会创建一个对象,并且将该对象的__proto__属性指向传入的对象 const person = { address: { country:"china" }, number: 111, say: function () { console.log(`it's ${this.name}, from ${this.address.country}, nums ${this.number}`) }, setCountry:function (country,number) { this.address.country=country this.number = number } } // 1、p1、p2 的原型对象指向了同一个对象 const p1 = Object.create(person) const p2 = Object.create(person) // 2、添加属性 p1.name = "huahua" // 3、在原型上找到setCountry函数,并且找到引用值address和原始值numbe属性,引用值会在所有实例共享 p1.setCountry("nanji",666) p2.name = "mumu" // 4、p2 的修改值会覆盖 p1的,最终country的值都为beiji p2.setCountry("beiji",999) p1.say() // it's huahua, from beiji, nums 666 p2.say() // it's mumu, from beiji, nums 999 6.2.4、实例 const value = 1; const objContext = { value : 2, getThis:function() { // 嵌套函数中的`this`不会从外层函数中继承 function fn1() { console.log("🚀 ~ fn1",this.value) // undefined } fn1() // 把 this 保存为一个 self 变量,再利用变量的作用域机制传递给嵌套函数 const self = this; function fn2() { console.log("🚀 ~ fn2 self",self.value) // 2 } fn2() // 箭头函数没有自己的执行上下文,会继承调用函数中的 this const fn3 = () => { console.log("🚀 ~ fn3 箭头函数",this.value) // 2 } fn3() // 箭头函数不会绑定局部变量,所有涉及它们的引用都会沿袭向上查找外层作用域链来处理,因此this的绑定只有一次 function fn4() { return () => { return () => { return () => { console.log("🚀 ~ fn4 箭头函数",this.value) // 42 }; }; }; } fn4.call( { value: 42 } )()()() // 构造函数优先级最高 function fn5(value) { this.value = value } const fn = new fn5(100) console.log("🚀 ~ fn5 构造函数", fn.value, this.value) // 100 2 } } 7、原型 7.1、函数对象 & 普通对象 通过 new Function 创建的对象称之为函数对象,其他则为普通对象,普通对象的构造函数是 Object // 函数对象 function fn(){}; const fn = () =>{}; const fn = new Function('str') // 普通对象 const obj = {} const obj = new Object() const obj = new fn() 每个对象都有内置__proto__属性,指向创建它的构造函数的原型对象,但只有函数对象才有prototype属性,指向函数的原型对象 7.2、原型对象 每个原型对象默认拥有一个constructor指针,指向prototype属性所在的函数 7.2.1、person1.__proto__ 是什么? 因为:person1 的构造函数是 Person 所以:person1.__proto__ === Person.prototype 7.2.2、Person.__proto__ 是什么? 因为:Person 的构造函数是 Function 所以:Person.__proto__ === Function.prototype 7.2.3、Person.prototype.__proto__ 是什么? 因为:Person.prototype 是构造函数的一个实例,是个普通对象,其构造函数是 Object 所以:Person.prototype.__proto__ === Object.prototype Function.prototype.__proto__ === Object.prototype 7.2.4、Object.__proto__ 是什么? 因为:所有函数对象的__proto__都指向Function.prototype,它是一个空函数 所以:Object.__proto__ === Function.prototype 7.2.5、Object.prototype.__proto__ 是什么? 因为:Object.prototype 处于 原型链的顶端,为null 所以:Object.prototype.__proto__ === null 7.2.6、12个JS内置构造器对象 8个可访问构造器 同 Object 指向 Function.prototype Number、Boolean、String、Function、Array、RegExp、Error、Date 2个以对象形式存在, 其 proto 指向 Object.prototype Math、JSON 1个不能直接访问的 Global、1个仅在函数调用时由JS引擎创建的 Arguments 8、继承 原型继承 构造函数继承 组合继承 class 继承:主要依靠extends、super(让JavaScript引擎去实现原来需要我们自己编写的原型链代码) 9、模块 9.1、模块化的意义 若不采用模块化,则引入js文件时必须确保引入顺序正确,否则无法运行。在文件数量大、依赖关系不明确的情况很难保证,因此出现了模块化 9.2、CommonJS & AMD 在ES6以前,JS没有模块体系。只有社区指定的一些模块加载方案,如用于服务器端同步加载的CommonJS和用于浏览器端异步加载的AMD、CMD 9.2.1、CommonJS(Node.js) 一个文件就是一个模块,有自己的作用域,只向外暴露特定的变量和函数。拥有四个重要变量:module、exports、require、global exports本身是一个变量对象,指向module.exports的{}模块,只能通过.语法向外暴露变量。而module.exports既可通过.也可使用=赋值,其中exports是module的属性,指向{}模块 //在这里写上需要向外暴露的函数、变量 module.exports = { add, update } // 引用自定义模块必须加./路径,不加的话只会去node_modules文件找 var math = require('./math') // 引用核心模块时,不需要带路径 var http = require('http') 9.2.2、AMD(require.js)、CMD(sea.js) 虽然都是并行加载js文件,但AMD推崇依赖前置、提前执行,即预加载,CMD推崇依赖就近、延迟执行,即懒加载。拥有三个重要变量:指定引用路径的require.config、定义模块的definde以及加载模块的require /** AMD写法 **/ define(["a", "b", "c", "d", "e", "f"], function(a, b, c, d, e, f) { // 在最前面声明并初始化了要用到的所有模块 a.doSomething(); if (false) { // 即便没用到某个模块 b,但 b 还是提前执行了 b.doSomething() } }); /** CMD写法 **/ define(function(require, exports, module) { //在需要时申明 var a = require('./a'); a.doSomething(); if (false) { var b = require('./b'); b.doSomething(); } }); 9.3、ESM CommonJS和AMD输出的是对象,引入时需查找对象属性,只能在运行时确定模块的依赖关系以及输入输出变量,即运行时加载,而ES6模块的设计思想,是尽量的静态化,它导出的不是对象,而是一个个接口,使得编译时就能确定模块的依赖关系和输入输出变量,即静态加载 9.3.1、原理解析 // index.js import { m } from './module'; // module.js const m = 1; const n = 2; export { m, n }; 将上面源码进行打包 // 1. 是一个立即执行函数 (function (modules) { var installedModules = {}; // 4. 处理入口文件模块 function __webpack_require__(moduleId) { if (installedModules[moduleId]) { return installedModules[moduleId].exports; } // 5. 创建一个模块 var module = installedModules[moduleId] = { i: moduleId, l: false, exports: {} }; // 6. 执行入口文件模块函数 modules[moduleId].call(module.exports, module, module.exports, __webpack_require__); module.l = true; // 7. 返回 return module.exports; } __webpack_require__.d = function (exports, name, getter) { if (!__webpack_require__.o(exports, name)) { // 判断name是不是exports自己的属性 Object.defineProperty(exports, name, {enumerable: true, get: getter}); } }; __webpack_require__.r = function (exports) { if (typeof Symbol !== 'undefined' && Symbol.toStringTag) { // Symbol.toStringTag作为对象的属性,值表示这个对象的自定义类型 [Object Module] // 通常只作为Object.prototype.toString()的返回值 Object.defineProperty(exports, Symbol.toStringTag, {value: 'Module'}); } Object.defineProperty(exports, '__esModule', {value: true}); }; __webpack_require__.o = function (object, property) { return Object.prototype.hasOwnProperty.call(object, property); }; // 3. 传入入口文件id return __webpack_require__(__webpack_require__.s = "./index.js"); })( // 2. 模块对象作为参数传入 { "./index.js": (function (module, __webpack_exports__, __webpack_require__) { // __webpack_exports__就是module.exports "use strict"; // 添加了__esModule和Symbol.toStringTag属性 __webpack_require__.r(__webpack_exports__); var _module__WEBPACK_IMPORTED_MODULE_0__ = __webpack_require__("./module.js"); }), "./module.js": (function (module, __webpack_exports__, __webpack_require__) { "use strict"; __webpack_require__.r(__webpack_exports__); // 把m/n这些变量添加到module.exports中,并设置getter为直接返回值 __webpack_require__.d(__webpack_exports__, "m", function () {return m;}); __webpack_require__.d(__webpack_exports__, "n", function () {return n;}); var m = 1; var n = 2; }) }); 将模块对象传入一个立即执行的函数 传入文件id,执行__webpack_require__函数 创建一个module,并绑定this到module.exports,同时传入module和module.exports对象 __webpack_require__.r给module.exports对象添加一个Symbol.toStringTag属性,值为{value: 'Module'},使得module.exports调用toString可返回[Object Module]表示一个模块 __webpack_require__.d将要导出的变量添加到module.exports,设置getter返回同名变量的值,使得变量更改,外边的引用也会变化 返回module.exports 注意喔:ESM遇到加载命令import时,只生成一个动态的只读引用,在需要调用时才去模块里取值 9.4、require和import的区别 CommonJS 模块化方案 require/exports 是为服务器端开发设计的。服务器模块系统同步读取模块文件内容,编译执行后得到模块接口。而ES6 模块化方案 import/export 是为浏览器设计的,浏览器模块系统异步加载脚本文件 require/exports 是运行时动态加载,,import/export 是静态编译 require/exports 输出的是一个值的拷贝,import/export 模块输出的是值的引用,即文件引用的模块值改变,require 引入的模块值不会改变,而 import 引入的模块值会改变 用法不同 ES6 模块可以在 import 引用语句前使用模块,CommonJS 则需要先引用后使用 import/export 只能在模块顶层使用,不能在函数、判断语句等代码块之中引用,而require/exports可以 import/export 默认采用严格模式 // require/exports const fs = require('fs') exports.fs = fs module.exports = fs // import/export import fileSystem, {readFile} from 'fs' // 引入 export default 导出的模块不用加 {},引入非 export default 导出的模块需要加 {} 10、babel 对源码字符串进行 parse,生成 AST,把对代码的修改转为对 AST 的增删改,转换完 AST 之后再打印成目标代码字符串 10.1、babel插件开发的API 10.1.1、parse 阶段 使用@babel/parser 把源码转成 AST require('@babel/parser').parse(source, { sourceType: 'module', // 解析 es module 语法 plugins: ['jsx'], // 指定jsx 等插件来解析对应的语法 }); 10.1.2、transform 阶段 使用 @babel/traverse 遍历 AST,并调用 visitor 函数修改 AST,@babel/types 用于创建、判断 AST 节点,提供了 isX、assertX 等 api,若批量创建,则可使用@babel/template require('@babel/traverse').default(ast, { // do something }) 10.1.3、generate 阶段 使用@babel/generate 把 AST 打印为目标代码字符串,同时生成 sourcemap,@babel/code-frame 用于错误时打印代码位置 const { code,map } = generator(ast, { sourceMaps: true }) 11、正则 11.1、基础语法 匹配模式 // + 前导字符必须在目标字符串中连续出现1次起 /\d+/ // * ~ 连续0次起 /\d*/ // ? ~ 0、1次 /\d?/ // ^ 定位字符串首个字符,$ 末尾字符 /^\d$/ // () 为一个捕获组,[]匹配单个字符,元素关系为或 /([\s\S]*?)["']/ // 任意字符 + "|' 匹配字符 // \s 匹配空白字符(空格、换行、缩进等)、\S相反 /[\s\S]*/ // 匹配全部内容 // \w 匹配单词([A-Za-z0-9_])、\W相反 /[\w\W]*/ // 匹配全部内容 // \b 匹配不全是\w的位置 /\bnice\b/ // a nice day -> a是显式位置,a和n之间的位置则为隐式位置,即a位置到n位置前则是\b匹配的位置,同样,e位置到d位置前也是\b匹配的,因此可匹配到 nice /\b.\bnice\b/ // a nice day -> 匹配到 a nice 匹配数字 /[0-9]/ /\d/ // 单个数字 /[0-9]+/ /\d*/ // 多个数字 /[\d]{1,3}/ // 指定个数,1-3个数字 11.2、实例解析 实用http路由表达式 /https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)/ 拆解匹配 http + (0|1个)s + :// + (0|1个) www. + (1-256个) -|a-z|A-Z|0-9|@|:|%|.|_|+|~|#|= + . + (1-6个) a-z|A-Z|0-9|(|) + 匹配不全是\w的位置 + (任意个)-|a-z|A-Z|0-9|(|)|@|:|%|_|+|.|~|#|?|&|/|=

优秀的个人博客,低调大师

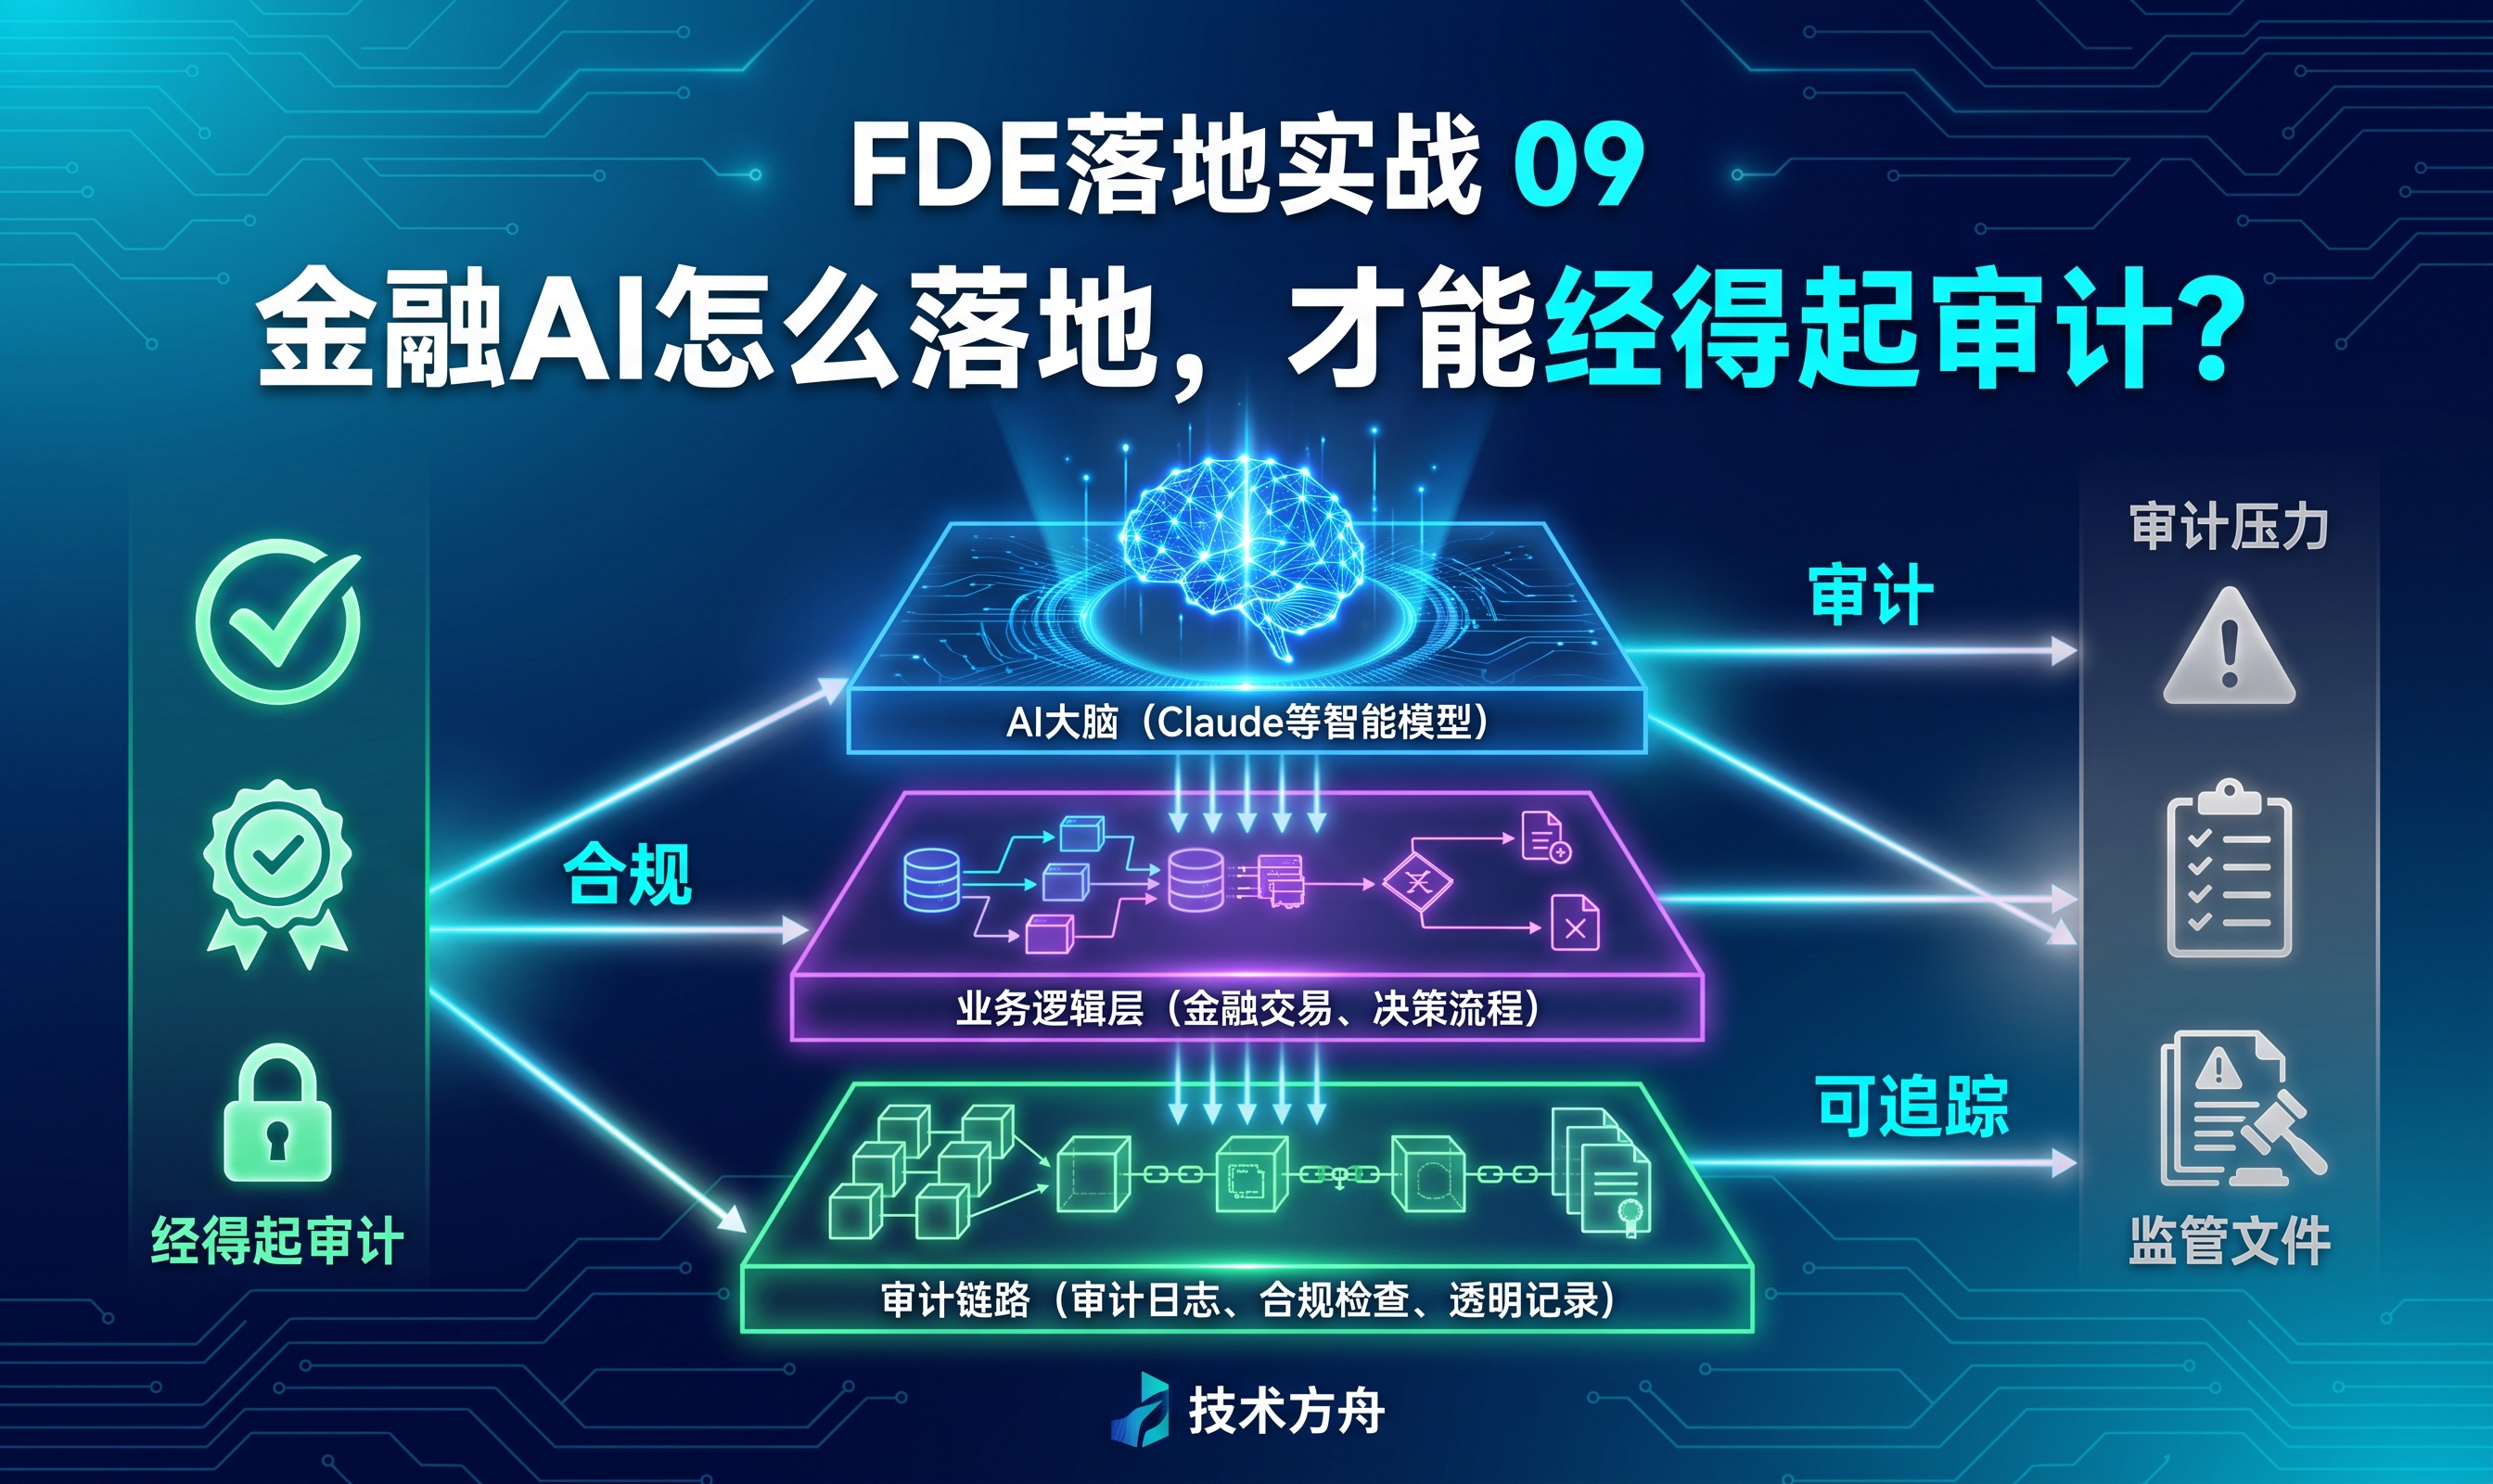
FDE落地实战 09|金融AI怎么落地,才能经得起审计?

导语:金融AI最容易制造一种错觉:只要模型能读表、写报告、回答问题,项目就已经接近生产。真正进现场才会发现,审计不关心文字像不像资深分析师,而会继续追问:这个数字来自哪张表、哪个批次、哪个口径?这条结论引用了哪版制度?计算如何复现?异常由谁判断?谁批准了对外发布?模型升级后,为什么同一输入得到不同答案?本篇以“报告生产与证据汇集”匿名复合案例为主线,拆解数据、知识、规则、模型和审批的生产架构,给出金融场景风险矩阵、报告自动化控制点与业务验收指标。核心不是让AI替人签字,而是让分析师更快获得一份有来源、有计算、有例外、有责任、可回放的初稿,并明确区分辅助报告与授信、交易、客户权益决策的风险边界。真正的交付物不是一段漂亮文字,而是一条可以由第三人独立核验的证据链。

优秀的个人博客,低调大师

腾讯混元提出 HY-WU(无相),让模型实时生成参数“换

3月6日,腾讯混元发布了一篇名为《HY-WU (Part I): An Extensible Functional Neural Memory Framework and An Instantiation in Text-Guided Image Editing》的技术报告,提出了一种崭新的功能性记忆(functional neural memory)范式(weight unleashing),在模型推理时实时生成个性化参数,由此对不同任务/分布/样本进行个性化适应。 腾讯混元团队将HY-WU (混元无相)应用在各大开源图形编辑基模上,有效扩充了基模的功能性记忆,在图形编辑任务上普遍取得了更好的内容理解、指令遵循和生成质量。与此同时,该范式的数据效率、训练效率和推理速度也做到了真正的实用性与创新性并重。 据介绍,HY-WU (混元无相)范式从“静态参数记忆”转向“功能性记忆”,其核心在于训练一个参数生成器。在模型推理时,该系统能根据当前输入的特定条件(如图像与编辑指令),实时合成一组针对该任务的个性化参数(如LoRA权重),并将其动态注入冻结的基座模型。此举实现了“动态路由”,从根本上避免了在共享权重上的参数冲突。 在文本引导图像编辑任务的实际验证中,HY-WU展现出优异表现。基于HY-Image-3.0-Instruct模型的评测显示,其在人类主观评价(GSB)中优于多数主流开源模型,与顶级闭源模型相当。在GEdit-Bench、ImgEdit-Bench等自动化评测榜单上,其综合得分亦达到开源模型的领先水平。 Blog:https://tencent-hy-wu.github.io GitHub:https://github.com/Tencent-Hunyuan/HY-WU

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册