首页 文章 精选 留言 我的

精选列表

搜索[业务组件],共10012篇文章
优秀的个人博客,低调大师

elk组件 基础语法

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 Shipper->Broker->Indexer->ES 1.input input{stdin{}} output{ stdout{codec=>rubydebug} } file { codec=>multiline{ pattern=> "^\s" what=> "previous" } path=>[ "xx" , "xx" ] exclude=> "1.log" add_field=>[ "log_ip" , "xx" ] tags=> "tag1" #设置新事件的标志 delimiter=> "\n" #设置多长时间扫描目录,发现新文件 discover_interval=>15 #设置多长时间检测文件是否修改 stat_interval=>1 #监听文件的起始位置,默认是end start_position=>beginning #监听文件读取信息记录的位置 sincedb_path=> "E:/software/logstash-1.5.4/logstash-1.5.4/test.txt" #设置多长时间会写入读取的位置信息 sincedb_write_interval=>15 } 2.filter filter{ multiline{ #指定合并规则——所有不是以数字开头的行需要被合并 pattern=> "^[^\d]" #合并到哪里——上一行 what=> "previous" } filter{ multiline{ type => "type" #类型,不多说 pattern=> "pattern,aregexp" #参数,也可以认为是字符,有点像grep,如果符合什么字符就交给下面的what去处理 negate=>boolean what=> "previous" or "next" #这个是符合上面pattern的要求后具体怎么处理,处理方法有两种,合并到上面一条日志或者下面的日志 } } filter{ grep { match=>[ "@message" , "PHPFatalerror" ] drop=> false add_tag=>[fatal_error] } grep { tags=>[fatal_error] match=>[ "@message" , ".*(xbox\.com|xbox\.mib\.com\.cn|supports\.game\.mib\.com\.cn)" ] drop=> false add_tag=>[xboxerror] } } #过滤掉内容包含5.3.3与down以外日志 filter{ if [message]!~ "5.3.3|down" { ruby{ code=> "event.cancel" } } } #使用自带的过滤规则显示更多的字段 filter{ grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } } #合并不是以[开头的日志 filter{ multiline{ pattern=> "^[^[]" negate=> true what=> "previous" } } filter{ if [path]=~ "error" { mutate{replace=>{ "type" => "apache_error" }} grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } } date { match=>[ "timestamp" , "dd/MMM/yyyy:HH:mm:ssZ" ] } } filter{ if [path]=~ "access" { mutate{replace=>{ type => "apache_access" }} grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } date { match=>[ "timestamp" , "dd/MMM/yyyy:HH:mm:ssZ" ] } } else if [path]=~ "error" { mutate{replace=>{ type => "apache_error" }} } else { mutate{replace=>{ type => "random_logs" }} } } 3.output 发邮件 output{ email{ match=>[ "@message" , "aaaaa" ] to=> "storyskya@gmail.com" from=> "monitor@mib.com.cn" options=>[ "smtpIporHost" , "smtp.mibnet.com" , "port" , "25" , "userName" , "monitor@mib.com.cn" , "starttls" , "true" , "password" , "opmonitor" , "authenticationType" , "login" ] subject=> "123" body=> '123' via=>smtp } } output{ if [ type ]== "syslog" { elasticsearch{ hosts=> "172.16.0.102:9200" index=> "syslog-%{+YYYY.MM.dd}" } } if [ type ]== "nginx" { elasticsearch{ hosts=> "172.16.0.102:9200" index=> "nglog-%{+YYYY.MM.dd}" } } #匹配内容包含paramiko与simplejson的日志通邮件发送 if [message]=~ /paramiko |simplejson/{ email{ to=> "12222222@wo.cn" from=> "good_zabbix@163.com" contenttype=> "text/plain;charset=UTF-8" address=> "smtp.163.com" username=> "test@163.com" password=> "12344" subject=> "服务器%{host}日志异常" body=> "%{@timestamp}%{type}:%{message}" } } } output{ stdout{codec=>rubydebug} redis{ host=> '192.168.1.104' data_type=> 'list' key=> 'logstash:redis' } } output{ elasticsearch{host=>localhost} stdout{codec=>rubydebug} } 替换 mutate{ type => "phplog" gsub=>[ "@message" , "'" , "\"" ] } 调试 #/usr/local/logstash-1.5.2/bin/logstash-e'input{stdin{}}output{stdout{}}' curl' logstash-e 'input{stdin{}}output{stdout{codec=>rubydebug}}' # logstash agent -f logstash-simple.conf --verbose //开启debug模式 本文转自 liqius 51CTO博客,原文链接:http://blog.51cto.com/szgb17/1865408,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop各个组件功能

HDFS 分布式文件系统 YARN 资源管理系统 MapReduce 分布式计算框架 ZooKeeper分布式协调服务 Hbase分布式数据库 Flume 日志收集 Sqoop 数据同步工具 Oozie 作业流调度系统 Ambari 安装部署工具 Hive基于MR的数据仓库 Mahout 数据挖掘库 Pig数据分析系统 计算框架: MapReduce 离线计算 Tez DAG计算 Spark 内存计算 storm 实时计算 数据分析系统 Hive基于MR的数据仓库 Pig数据分析系统 Hadoop作业流调度引擎 Oozie Azkaban 本文转自 corasql 51CTO博客,原文链接:http://blog.51cto.com/corasql/1738114,如需转载请自行联系原作者

优秀的个人博客,低调大师

openstack各个组件功能

Horizon dashboard 基于OpenStack API接口使用django开发的web管理 Keystone 身份验证服务 Glance 镜像管理服务 Nova 计算和控制服务 Cinder 块存储服务 Swift 对象存储服务 Quantum/Neutron网络服务 MySQL 数据库服务 RabbitMQ或QPid 消息服务 Ceilometer 提供监控和数据采集、计量服务 本文转自 corasql 51CTO博客,原文链接:http://blog.51cto.com/corasql/1738113,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop组件介绍(转载)

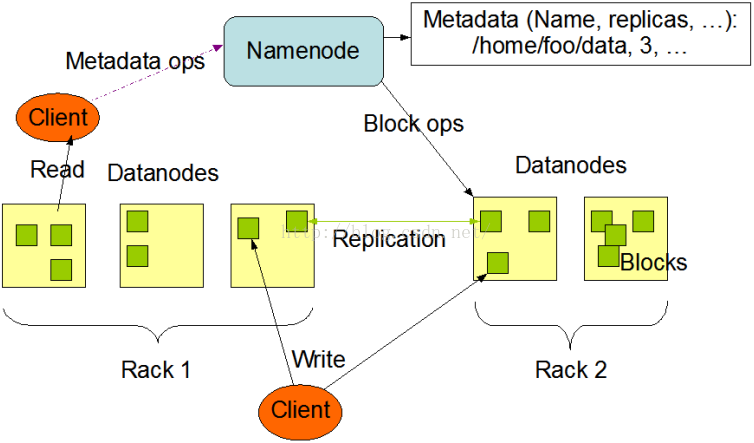
转自:http://blog.csdn.net/gamer_gyt/article/details/51758881 参考博客: http://dongxicheng.org/mapreduce-nextgen/nodemanager-architecture/ http://dongxicheng.org/mapreduce-nextgen/yarnmrv2-resource-manager-infrastructure/ http://www.aboutyun.com/thread-7778-1-1.html 1、NameNode介绍 Namenode 管理者文件系统的Namespace。它维护着文件系统树(filesystem tree)以及文件树中所有的文件和文件夹的元数据(metadata)。管理这些信息的文件有两个,分别是Namespace 镜像文件(Namespace image)和操作日志文件(edit log),这些信息被Cache在RAM中,当然,这两个文件也会被持久化存储在本地硬盘。Namenode记录着每个文件中各个块所在的数据节点的位置信息,但是他并不持久化存储这些信息,因为这些信息会在系统启动时从数据节点重建。 Namenode结构图课抽象为如图: 客户端(client)代表用户与namenode和datanode交互来访问整个文件系统。客户端提供了一些列的文件系统接口,因此我们在编程时,几乎无须知道datanode和namenode,即可完成我们所需要的功能。 1.1Namenode容错机制 没有Namenode,HDFS就不能工作。事实上,如果运行namenode的机器坏掉的话,系统中的文件将会完全丢失,因为没有其他方法能够将位于不同datanode上的文件块(blocks)重建文件。因此,namenode的容错机制非常重要,Hadoop提供了两种机制。 第一种方式是将持久化存储在本地硬盘的文件系统元数据备份。hadoop可以通过配置来让Namenode将他的持久化状态文件写到不同的文件系统中。这种写操作是同步并且是原子化的。比较常见的配置是在将持久化状态写到本地硬盘的同时,也写入到一个远程挂载的网络文件系统。 第二种方式是运行一个辅助的Namenode(Secondary Namenode)。 事实上Secondary Namenode并不能被用作Namenode它的主要作用是定期的将Namespace镜像与操作日志文件(edit log)合并,以防止操作日志文件(edit log)变得过大。通常,Secondary Namenode 运行在一个单独的物理机上,因为合并操作需要占用大量的CPU时间以及和Namenode相当的内存。辅助Namenode保存着合并后的Namespace镜像的一个备份,万一哪天Namenode宕机了,这个备份就可以用上了。 但是辅助Namenode总是落后于主Namenode,所以在Namenode宕机时,数据丢失是不可避免的。在这种情况下,一般的,要结合第一种方式中提到的远程挂载的网络文件系统(NFS)中的Namenode的元数据文件来使用,把NFS中的Namenode元数据文件,拷贝到辅助Namenode,并把辅助Namenode作为主Namenode来运行。 当然在hadoop 2.x 中,已经有了新的解决方案,那就是NameNode HA(因为Hadoop还包括 ResourceManage HA),hadoop联邦, Hadoop HA是指同时启动两个NameNode,一个处于工作状态,另外一个处于随时待命状态,这样在处于工作状态的NameNode所在的服务器宕机时,可在数据不丢失的情况下,手工或者自动切换到另外一个NameNode提供服务。 2、Datanode介绍 Datanode是文件系统的工作节点,他们根据客户端或者是namenode的调度存储和检索数据,并且定期向namenode发送他们所存储的块(block)的列表。 集群中的每个服务器都运行一个DataNode后台程序,这个后台程序负责把HDFS数据块读写到本地的文件系统。当需要通过客户端读/写某个 数据时,先由NameNode告诉客户端去哪个DataNode进行具体的读/写操作,然后,客户端直接与这个DataNode服务器上的后台程序进行通 信,并且对相关的数据块进行读/写操作。 3、Secondary NameNode介绍 另外一篇关于Secondary NameNode 的博客,描述的也十分清晰:点击阅读 SecondaryNameNode是一个用来监控HDFS状态的辅助后台程序。就想NameNode一样,每个集群都有一个SecondaryNameNode,并且部署在一个单独的服务器上。SecondaryNameNode不同于NameNode,它不接受或者记录任何实时的数据变化,但是,它会与NameNode进行通信,以便定期地保存HDFS元数据的 快照。由于NameNode是单点的,通过SecondaryNameNode的快照功能,可以将NameNode的宕机时间和数据损失降低到最小。同时,如果NameNode发生问题,SecondaryNameNode可以及时地作为备用NameNode使用。 3.1NameNode的目录结构如下: ${dfs.name.dir}/current/VERSION /edits /fsimage /fstime 3.2Secondary NameNode的目录结构如下: ${fs.checkpoint.dir}/current/VERSION /edits /fsimage /fstime /previous.checkpoint/VERSION /edits /fsimage /fstime 如上图,Secondary NameNode主要是做Namespace image和Edit log合并的。 那么这两种文件是做什么的?当客户端执行写操作,则NameNode会在edit log记录下来,(我感觉这个文件有些像Oracle的online redo logo file)并在内存中保存一份文件系统的元数据。 Namespace image(fsimage)文件是文件系统元数据的持久化检查点,不会在写操作后马上更新,因为fsimage写非常慢(这个有比较像datafile)。 由于Edit log不断增长,在NameNode重启时,会造成长时间NameNode处于安全模式,不可用状态,是非常不符合Hadoop的设计初衷。所以要周期性合并Edit log,但是这个工作由NameNode来完成,会占用大量资源,这样就出现了Secondary NameNode,它可以进行image检查点的处理工作。步骤如下: (1) Secondary NameNode请求NameNode进行edit log的滚动(即创建一个新的edit log),将新的编辑操作记录到新生成的edit log文件; (2) 通过http get方式,读取NameNode上的fsimage和edits文件,到Secondary NameNode上; (3) 读取fsimage到内存中,即加载fsimage到内存,然后执行edits中所有操作(类似OracleDG,应用redo log),并生成一个新的fsimage文件,即这个检查点被创建; (4) 通过http post方式,将新的fsimage文件传送到NameNode; (5) NameNode使用新的fsimage替换原来的fsimage文件,让(1)创建的edits替代原来的edits文件;并且更新fsimage文件的检查点时间。 整个处理过程完成。 Secondary NameNode的处理,是将fsimage和edites文件周期的合并,不会造成nameNode重启时造成长时间不可访问的情况。 4、ResourceManager介绍 ResourceManage 即资源管理,在YARN中,ResourceManager负责集群中所有资源的统一管理和分配,它接收来自各个节点(NodeManager)的资源汇报信息,并把这些信息按照一定的策略分配给各个应用程序(实际上是ApplicationManager)。 RM包括Scheduler(定时调度器)和ApplicationManager(应用管理器)。Schedular负责向应用程序分配资源,它不做监控以及应用程序的状态跟踪,并且不保证会重启应用程序本身或者硬件出错而执行失败的应用程序。ApplicationManager负责接受新的任务,协调并提供在ApplicationMaster容器失败时的重启功能。 这里简单介绍以下ApplicationMaster,每个应用程序的AM负责项Scheduler申请资源,以及跟踪这些资源的使用情况和资源调度的监控 更多关于ResourceManager的介绍参考:点击阅读 5、NodeManager介绍 NM是ResourceManager在每台机器上的代理,负责容器管理,并监控它们的资源使用情况,以及向ResourceManager/Scheduler提供资源使用报告 更多详细的架构分析请参考:点击阅读

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册