首页 文章 精选 留言 我的

精选列表

搜索[计算机基础],共10000篇文章
优秀的个人博客,低调大师

PHP基础之与MySQL那些事

前言 这篇文章会对PHP的MySQL扩展库,MySQLI的扩展库,SQL批量执行,事务控制等等进行一些简单的讲解。 MySQL扩展 PHP中MySQL扩展,虽然因为安全的原因,在PHP5.6及往上不在支持MySQL扩展库,但是还是要学习的,通过编写案例的方式来讲解。 案例 先说下操作数据库的大体思路吧,就是先获取连接-》选择数据库-》设置操作编码-》发送sql指令-》对返回的结果进行处理-》释放资源,断开连接。案例是一个在线词典查询。下面是创建表的sql语句: createdatabaseworddb createtablewords( idintprimarykeyauto_increment, enwordvarchar(32)notnull, chwordvarchar(256)notnull ); insertintowords(enword,chword)values('boy','男孩') insertintowords(enword,chword)values('school','学校') 因为是练习,所以就插入了两条数据。接下来就是编写SQL工具类,代码如下: conn=mysql_connect($this->host,$this->user,$this->password); if(!$this->conn){ die("连接数据库失败!".mysql_error()); } mysql_select_db($this->db,$this->conn); mysql_query("setnamesutf8"); } //完成select functionexecute_dql($sql){ $res=mysql_query($sql)ordie(mysql_error()); return$res; } //完成insert,update,delete functionexecute_dml($sql){ $b=mysql_query($sql,$this->conn); if(!$b){ return0; }else{ //因为有些情况执行成功,但没有行数影响,所以在判断一下。 if(mysql_affected_rows($this->conn)>0){ return1; }else{ return2; } } } } ?> 之后就是前端页面的编写了,代码如下,有点丑: 在线词典字典查询英文请输入英文: 查询中文请输入中文: 接下来就是后端逻辑代码了,如下: 现在来测试一下吧,首先打开前端页面,如下图:接下来输入boy进行查询,结果如下,查询成功:因为是案例,所以直接将前端传过来的参数没有做任何处理直接拼接到SQL语句中,这样是非常危险的!!,存在SQL注入***,现在我来演示一下,在输入框中输入: boy' and updatexml(1,concat(0x7e,(select user()),0x7e),1)#结果如下图直接报出使用者!!所以在开发功能时,要秉持“外部参数皆不可信原则”进行开发。 MYSQLI扩展 其实mysqli扩展是mysql扩展的加强版,因为历史原因,有一些老程序员擅长面向过程写法,所以PHP设计者为mysqli设计了两套方案,一套面向对象,一套面向过程,甚至一个聊本里可以混着用,不过那样很怪,下面的案例都是采用面向对象的那套方案。 案例 做一个小功能吧,向数据库中插入数据。先设计一下SQL表,语句如下: createdatabaseday1; useday1; createtableuser1( idint(6)unsignedauto_incrementprimarykey, namevarchar(20)notnull, passwordvarchar(256)notnull, emailvarchar(80)notnull, ageint(128)notnull ); INSERTINTOuser1(name,password,email,age)VALUES('Lucia','13568','12345@.com',30); 因为一会儿要插入数据,所以先插入一条,构造好后,打开数据库,查询,发现没有问题接下来构造mysqli工具类代码如下: mysqli=newmysqli($this->host,$this->user,$this->pass,$this->db); if($this->mysqli->connect_error){ echo"连接失败"; } $this->mysqli->query("setnamesutf8"); } //进行select publicfunctionexecute_dql($sql){ $res=$this->mysqli->query($sql)ordie($this->mysqli->error); return$res; } //进行update,insert,delete publicfunctionexecute_dml($sql){ $res=$this->mysqli->query($sql)ordie($this->mysqli->error); if(!$res){ return0; }else{ if($this->mysqli->affected_rows>0){ return1;//成功 }else{ return2;//没有行数收影响 } } } } ?> 下面就是前端页面了,这里我用表单向后端提交数据,代码如下: 效果如下图:然后就是后端的逻辑设计了,代码如下: execute_dml($sql); if($res==1){ echo"添加成功"; }else{ if($res==0){ echo'添加失败'; }else{ echo"行数没有变化"; } } ?> 现在测试一下,我们在表单页面输入 小明,12345678,123@qq.com,25 数据,如下图:然后提交表单,看看有没有插入到数据库中。我们发现成功插入到数据库中如下:关于mysqli扩展就说到这里。 MySQL批量执行SQL语句 上面简单介绍了MySQL扩展和MySQLI扩展,接下来说一说批量执行sql语句。先提一个需求,如果我们像数据库批量添加用户,如果按照之前的办法一条一条的发送sql语句来处理,这样很占用资源,并且效率低。所以采用批量执行sql语句的方式。接下来用两个案例来讲解,因为增加,修改,删除操作返回的是布尔值,而查询操作返回的是结果集,所以分来来处理比较好。 批量执行dml语句 因为dml返回的是布尔值,所以处理起来也比较好处理。先创建表,顺便插入一条数据如下: createdatabasetest; usetest; createtableusers( idint(8)unsignedauto_incrementprimarykey, namevarchar(128)notnull, passwordvarchar(256)notnull); insertintousers(name,password)values('test','13579'); 下面就是批量执行dml操作的代码: connect_error){ echo"连接失败"; } $sqli="insertintousers(name,password)values('小利',md5('13568'));"; //批量执行dml操作时,注意上一级句的;和下一句的.两个符号 $sqli.="insertintousers(name,password)values('小利',md5('13568'));"; $sqli.="insertintousers(name,password)values('小利和小峰',md5('13568'))"; $b=$mysqli->multi_query($sqli); if(!$b){ echo"插入失败"; }else{ echo"ok!"; } $mysqli->close(); ?> 然后访问页面,返回ok,说明插入到数据库了,现在打开数据库查看,果然插入进去了,如下图: 批量执行dql操作 批量执行dql操作的作用是一次性取回多个结果集,下面看案例代码: 结果如下图:关于MySQL的批量执行sql语句就说到这里。 MySQL事务控制 上面简单介绍了MySQL扩展库,MySQLI扩展库,批量执行SQL语句,接下来说一说MySQL事务控制。 数据库配置 说MySQL事务控制之前,先查看并修改数据库引擎,查看引擎的命令如下: show engines我们发现,只有InnoDB是支持事务的,所以先查看一下现在得数据库引擎:发现是MyISAM,我们将它修改为InnoDB,打开配置文件my.ini,将“default-storage-engine=MYISAM”改为你想设定的,然后重启即可。修改成功后,然后下一步就是代码实现。 案例 我们为什么需要事务控制呢?想一想,如果这是一个转账得场景,是不是需要同时控制住,必须我减金额得同时你加金额,任何一个出错都得转账失败。也就是说要保持一致。这也是要进行事务控制得必要性。下面看案例代码: connect_error){ echo"连接失败"; } //将提交设置为假,因为事物一旦提交就没有机会回滚 $mysqli->autocommit(false); $sql1="updatepersonsetmoney=money-3whereid=1"; //这里第二条语句我故意写错表名 $sql2="updatepersonssetmoney=money+3whereid=2"; $b1=$mysqli->query($sql1); $b2=$mysqli->query($sql2); if(!$b1||!$b2){ echo"修改失败,回滚".$mysqli->error; $mysqli->rollback(); }else{ echo"修改成功!"; $mysqli->commit(); } $mysqli->close(); ?> 当我们提交页面后,查询数据库,发现数据没有变化,说明回滚有效果,事务控制起了效果,事务控制就说到这里。以上就是本篇文章的全部内容啦,如有错误,请斧正。

优秀的个人博客,低调大师

Hadoop hdfs 基础操作 client Api(1)

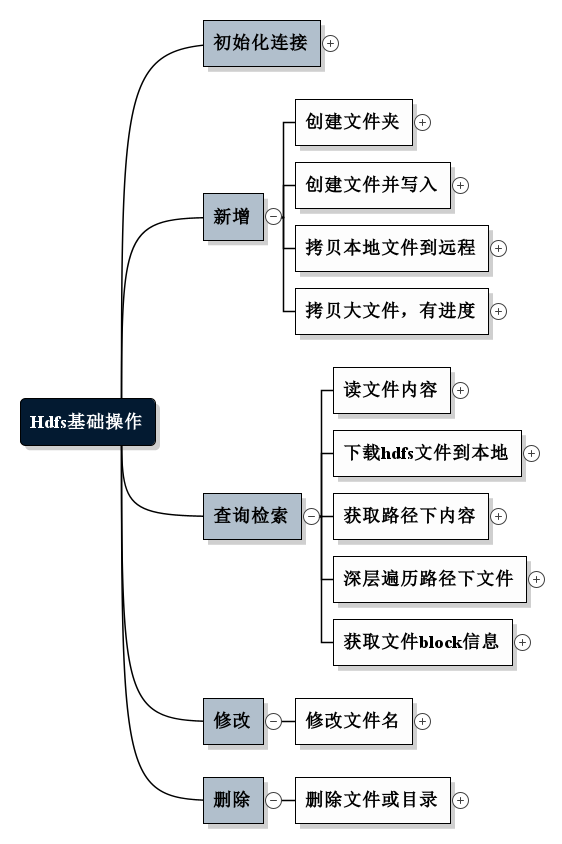
1. 初始化连接 @Before public void setup() throws Exception { configuration = new Configuration(); System.out.println(); configuration.set("dfs.replication", "1"); // configuration.set("hadoop.tmp.dir","/home/hadoop0/data/tmp"); Iterator iterator = configuration.iterator(); while(iterator.hasNext() ){ System.out.println(iterator.next()); //打印所有配置或默认参数 } fileSystem = FileSystem.get(new URI(HDFS_PATH), configuration, HDFS_USER); System.out.println("--------------setup-------------"); } @After public void teardown(){ try { fileSystem.close(); } catch (IOException e) { e.printStackTrace(); } configuration = null; System.out.println("--------------teardown-------------"); } 2. 新增 2.1 创建文件夹 @Test public void mkDir() throws Exception{ System.out.println(fileSystem.mkdirs(new Path("/Complete"))); } 2.2 创建文件并写入 @Test public void create() throws Exception{ FSDataOutputStream out = fileSystem.create(new Path("/HDFSApp/write/2.txt")); out.writeUTF("hello! first wirte to HDFS file!"); out.flush(); out.close(); } 2.3 拷贝本地文件到远程 @Test public void copyFromLocal() throws IOException { Path localFile = new Path("F:/校验大师_2.7.5.1632.zip"); Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); fileSystem.copyFromLocalFile(localFile, remoteFile); } 2.4 拷贝大文件,带进度条 @Test public void copyFromLocalLargeFile(){ String localFile = "F:/校验大师_2.7.5.1632.zip"; Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1633.zip"); InputStream in = null; FSDataOutputStream out = null; try { in = new BufferedInputStream(new FileInputStream(localFile)); out = fileSystem.create(remoteFile, new Progressable() { @Override public void progress() { System.out.println("!"); } }); } catch (IOException e) { e.printStackTrace(); System.out.println("创建输入输出流失败!"); } if(in != null && out != null){ try { IOUtils.copyBytes(in, out,2048, true); } catch (IOException e) { e.printStackTrace(); System.out.println("上传过程中失败!"); } } } 3. 查询检索 3.1 读文件内容 @Test public void text() throws Exception{ FSDataInputStream in = fileSystem.open(new Path("/output/part-r-00000")); IOUtils.copyBytes(in, System.out, 1024); } 3.2 下载hdfs文件到本地 @Test public void copyToLocal() throws IOException { Path localFile = new Path("F:/"); Path remoteFile = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); fileSystem.copyToLocalFile(remoteFile, localFile); } 3.3 获取路径下内容 @Test public void listFiles() throws IOException { Path path = new Path("/HDFSApp/write"); FileStatus[] files = fileSystem.listStatus(path); for (FileStatus file:files) { String type = file.isDirectory() ? "文件夹" : "文件"; String permission = file.getPermission().toString(); short replication = file.getReplication(); String filePath = file.getPath().toString(); System.out.println(type + "\t" + permission + "\t" + replication + "\t" + filePath); } } 3.4 深层遍历路径下文件 @Test public void listFilesRecursive() throws IOException { Path path = new Path("/"); RemoteIterator<LocatedFileStatus> remoteIterator = fileSystem.listFiles(path, true); while(remoteIterator.hasNext()){ LocatedFileStatus file = remoteIterator.next(); String type = file.isDirectory() ? "文件夹" : "文件"; String permission = file.getPermission().toString(); short replication = file.getReplication(); String filePath = file.getPath().toString(); System.out.println(type + "\t" + permission + "\t" + replication + "\t" + filePath); } } 3.5 获取文件block信息 @Test public void getBlocksInfo() throws IOException { Path path = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); FileStatus fileStatus = fileSystem.getFileStatus(path); BlockLocation[] blockLocations = fileSystem.getFileBlockLocations(fileStatus, 0 , fileStatus.getLen()); for (BlockLocation block: blockLocations) { for (String name :block.getNames()) { System.out.println(name + ":" + block.getOffset() +"," + block.getLength()); } } } 4. 修改 4.1 修改文件名 @Test public void rename() throws IOException { Path oPath = new Path("/HDFSApp/write/0.txt"); Path nPath = new Path("/HDFSApp/write/3.txt"); boolean res = fileSystem.rename(oPath, nPath); System.out.println(res); } 5. 删除 5.1 删除文件或目录 public void delete() throws IOException { Path path = new Path("/HDFSApp/write/校验大师_2.7.5.1632.zip"); boolean res = fileSystem.delete(path, false); System.out.println(res); }

优秀的个人博客,低调大师

交易背书 - fabric交易并发的基础

Hyperledger Fabric和其他许多区块链的关键区别之一,就在于Fabric区块链的交易执行过程:Fabric交易需要首先通过节点的背书,然后再进行交易排序,最后才利用有序交易进行账本的更新。本文将介绍Hyperledger Fabric所采用的执行-排序-验证这一三步交易模型的工作原理,以及引入背书环节对Hyperledger Fabric区块链性能的有益作用。 Hyperledger Fabric相关开发教程: Java链码与应用开发详解 Node.js链码与应用开发详解 1、交易的生命周期:Hyperledger Fabric vs. 其他区块链 在其他区块链平台中,交易生命周期基本由如下环节构成: 排序:交易有序加入账本,然后扩散到所有节点 执行:交易在所有节点上按顺序依次执行并更新账本 为了让所有节点保持一致的状态,交易必须确定性执行,也就是说,无论何时何地,同样的交易必须产生同样的结果。这一要求对智能合约形成了很强的约束,也是智能合约通常需要使用领域特定语言(DSL)来开发的原因之一,因此使用像Java或Go这样的通用开发语言基本上无法保证确定性。 在Hyperledger Fabric中,交易的声明周期则有所不同: 执行:交易(通过智能合约)以任意顺序执行,甚至可以并行执行 排序:当足够数量的节点对交易结果达成一致,该交易就会 被加入账本并扩散给所有节点。 验证:每个节点验证并按顺序执行交易,从而更新账本 首先需要注意的一点是,交易的执行和对账本的实际更新被拆分为两个环节,这一拆分带来一些有益的作用: 所有节点都需要更新账本,因此所有节点都需要执行验证步骤。 但并不是所有的节点都需要执行智能合约。Hyperledger Fabric 使用背书策略来定义哪些节点需要执行交易。这意味着指定的 链码(智能合约)不必开放给所有的节点 —— 那些不在背书策略中 的节点不需要由访问链码的权限。 交易可以在被排序之前先执行。这是的节点可以并行执行交易, 从而提高系统的吞吐量 在Fabric的三步交易模型中,在交易被添加到账本之前,其链码 执行结果是显式达成一致的,其他区块链的两步交易模型使用 确定性的链码,本身就隐含了节点之间就智能合约的执行结果 达成一致。显式达成一致可以让Fabric使用非确定性的链码, 这也是为什么我们可以使用Go、Java和Node.js编写Fabric链码 的原因。 2、Hyperledger Fabric的交易背书策略 Hyperledger Fabric允许用户自己定义链码执行的策略。这些背书策略定义了在交易被加入账本之前,哪些节点需要就交易结果达成一致。Fabric提供了一个小型的DSL来定义背书策略。下面展示了一些背书策略样例: 节点A、B、C和F都需要对类型为T的交易进行背书 通道中的大部分节点必须对类型为U的交易进行背书 A、B、C、D、E、F、G中的至少3个节点必须对类型为V的交易进行背书 背书策略并不保证正确的链码安装在正确的节点上。然而,背书和安装链码的确存在类似的机制,我们将在后续教程中介绍这一点。 3、Hypereledger Fabric交易背书的实现机制 到目前为止,我们都是松散地使用交易(transaction)这一术语。在排序-执行模型中,链码执行和账本更新被合二为一 —— 交易。在Fabric中,这两个概念是分开的,因此交易本身也被拆分。 Fabric从交易提议(Transaction Proposal)开始。这是一个用来触发链码执行的数据包。交易提议被发送给用于背书的节点。背书节点执行链码,如果成功的话就生成一个实际的账本交易。背书节点签名建议并返回交易提议的响应,这是执行-排序-验证模型中的执行步骤。 一旦交易提议的创建者收到足够的可以满足背书策略的签名,它就可以将交易(以及签名)提交以便添加到账本中,这就是排序步骤。 4、结论 Hyperledger Fabric在区块链交易方面采取了一个新颖的思路,将智能合约的执行与账本的更新分开使它可以提高交易吞吐量,支持更细粒度的隐私控制,实现更灵活强大的智能合约。而这些特性得以实现的一个关键因素就是在交易加入账本之前进行显式地交易背书。 原文链接:Hyperledger Fabric交易背书的深入理解 - 汇智网

优秀的个人博客,低调大师

《吊打面试官》系列- Redis基础

你知道的越多,你不知道的越多 点赞再看,养成习惯 前言 Redis在互联网技术存储方面使用如此广泛,几乎所有的后端技术面试官都要在Redis的使用和原理方面对小伙伴们进行360°的刁难。作为一个在互联网公司面一次拿一次offer的面霸(请允许我使用一下夸张的修辞手法),打败了无数竞争对手,每次都只能看到无数落寞的身影失望的离开,略感愧疚,在一个寂寞难耐的夜晚,我痛定思痛,决定开始写吊打面试官系列,希望能帮助各位读者以后面试势如破竹,对面试官进行360°的反击,吊打问你的面试官,吊打一同面试的同僚(好像不太好),疯狂收割大厂offer! 面试开始 一个大腹便便,穿着格子衬衣的中年男子,拿着一个满是划痕的mac向你走来,看着快秃顶的头发,心想着肯定是尼玛顶级架构师吧!但是我们腹有诗书气自华,虚都不虚。 小伙子您好,看你简历上写了你项目里面用到了Redis,你们为啥用Redis? 心里忍不住暗骂,这叫啥问题,大家不都是用的这个嘛,但是你不能说出来。 认真回答道:帅气迷人的面试官您好,因为传统的关系型数据库如Mysql已经不能适用所有的场景了,比如秒杀的库存扣减,APP首页的访问流量高峰等等,都很容易把数据库打崩,所以引入了缓存中间件,目前市面上比较常用的缓存中间件有Redis 和 Memcached 不过中和考虑了他们的优缺点,最后选择了Redis。 至于更细节的对比朋友们记得查阅Redis 和 Memcached 的区别,比如两者的优缺点对比和各自的场景,后续我有时间也会写出来。 那小伙子,我再问你,Redis有哪些数据结构呀? 字符串String、字典Hash、列表List、集合Set、有序集合SortedSet。 这里我相信99%的读者都能回答上来Redis的5个基本数据类型。如果回答不出来的小伙伴我们就要加油补课哟,大家知道五种类型最适合的场景更好。 但是,如果你是Redis中高级用户,而且你要在这次面试中突出你和其他候选人的不同,还需要加上下面几种数据结构HyperLogLog、Geo、Pub/Sub。 如果你还想加分,那你说还玩过Redis Module,像BloomFilter,RedisSearch,Redis-ML,这个时候面试官得眼睛就开始发亮了,心想这个小伙子有点东西啊。 注:本人在面试回答到Redis相关的问题的时候,经常提到BloomFilter(布隆过滤器)这玩意的使用场景是真的多,而且用起来是真的香,原理也好理解,看一下文章就可以在面试官面前侃侃而谈了,不香么?下方传送门 ↓ 避免缓存击穿的利器之BloomFilter 如果有大量的key需要设置同一时间过期,一般需要注意什么? 如果大量的key过期时间设置的过于集中,到过期的那个时间点,redis可能会出现短暂的卡顿现象。严重的话会出现缓存雪崩,我们一般需要在时间上加一个随机值,使得过期时间分散一些。 电商首页经常会使用定时任务刷新缓存,可能大量的数据失效时间都十分集中,如果失效时间一样,又刚好在失效的时间点大量用户涌入,就有可能造成缓存雪崩 那你使用过Redis分布式锁么,它是什么回事? 先拿setnx来争抢锁,抢到之后,再用expire给锁加一个过期时间防止锁忘记了释放。 这时候对方会告诉你说你回答得不错,然后接着问如果在setnx之后执行expire之前进程意外crash或者要重启维护了,那会怎么样? 这时候你要给予惊讶的反馈:唉,是喔,这个锁就永远得不到释放了。紧接着你需要抓一抓自己得脑袋,故作思考片刻,好像接下来的结果是你主动思考出来的,然后回答:我记得set指令有非常复杂的参数,这个应该是可以同时把setnx和expire合成一条指令来用的! 对方这时会显露笑容,心里开始默念:嗯,这小子还不错,开始有点意思了。 假如Redis里面有1亿个key,其中有10w个key是以某个固定的已知的前缀开头的,如何将它们全部找出来? 使用keys指令可以扫出指定模式的key列表。 对方接着追问:如果这个redis正在给线上的业务提供服务,那使用keys指令会有什么问题? 这个时候你要回答redis关键的一个特性:redis的单线程的。keys指令会导致线程阻塞一段时间,线上服务会停顿,直到指令执行完毕,服务才能恢复。这个时候可以使用scan指令,scan指令可以无阻塞的提取出指定模式的key列表,但是会有一定的重复概率,在客户端做一次去重就可以了,但是整体所花费的时间会比直接用keys指令长。 不过,增量式迭代命令也不是没有缺点的: 举个例子, 使用 SMEMBERS 命令可以返回集合键当前包含的所有元素, 但是对于 SCAN 这类增量式迭代命令来说, 因为在对键进行增量式迭代的过程中, 键可能会被修改, 所以增量式迭代命令只能对被返回的元素提供有限的保证 。 使用过Redis做异步队列么,你是怎么用的? 一般使用list结构作为队列,rpush生产消息,lpop消费消息。当lpop没有消息的时候,要适当sleep一会再重试。 如果对方追问可不可以不用sleep呢? list还有个指令叫blpop,在没有消息的时候,它会阻塞住直到消息到来。 如果对方接着追问能不能生产一次消费多次呢? 使用pub/sub主题订阅者模式,可以实现 1:N 的消息队列。 如果对方继续追问 pub/su b有什么缺点? 在消费者下线的情况下,生产的消息会丢失,得使用专业的消息队列如RocketMQ等。 如果对方究极TM追问Redis如何实现延时队列? 这一套连招下来,我估计现在你很想把面试官一棒打死(面试官自己都想打死自己了怎么问了这么多自己都不知道的),如果你手上有一根棒球棍的话,但是你很克制。平复一下激动的内心,然后神态自若的回答道:使用sortedset,拿时间戳作为score,消息内容作为key调用zadd来生产消息,消费者用zrangebyscore指令获取N秒之前的数据轮询进行处理。 到这里,面试官暗地里已经对你竖起了大拇指。并且已经默默给了你A+,但是他不知道的是此刻你却竖起了中指,在椅子背后。 Redis是怎么持久化的?服务主从数据怎么交互的? RDB做镜像全量持久化,AOF做增量持久化。因为RDB会耗费较长时间,不够实时,在停机的时候会导致大量丢失数据,所以需要AOF来配合使用。在redis实例重启时,会使用RDB持久化文件重新构建内存,再使用AOF重放近期的操作指令来实现完整恢复重启之前的状态。 这里很好理解,把RDB理解为一整个表全量的数据,AOF理解为每次操作的日志就好了,服务器重启的时候先把表的数据全部搞进去,但是他可能不完整,你再回放一下日志,数据不就完整了嘛。不过Redis本身的机制是 AOF持久化开启且存在AOF文件时,优先加载AOF文件;AOF关闭或者AOF文件不存在时,加载RDB文件;加载AOF/RDB文件城后,Redis启动成功; AOF/RDB文件存在错误时,Redis启动失败并打印错误信息 对方追问那如果突然机器掉电会怎样? 取决于AOF日志sync属性的配置,如果不要求性能,在每条写指令时都sync一下磁盘,就不会丢失数据。但是在高性能的要求下每次都sync是不现实的,一般都使用定时sync,比如1s1次,这个时候最多就会丢失1s的数据。 对方追问RDB的原理是什么? 你给出两个词汇就可以了,fork和cow。fork是指redis通过创建子进程来进行RDB操作,cow指的是copy on write,子进程创建后,父子进程共享数据段,父进程继续提供读写服务,写脏的页面数据会逐渐和子进程分离开来。 注:回答这个问题的时候,如果你还能说出AOF和RDB的优缺点,我觉得我是面试官在这个问题上我会给你点赞,两者其实区别还是很大的,而且涉及到Redis集群的数据同步问题等等。想了解的伙伴也可以留言,我会专门写一篇来介绍的。 Pipeline有什么好处,为什么要用pipeline? 可以将多次IO往返的时间缩减为一次,前提是pipeline执行的指令之间没有因果相关性。使用redis-benchmark进行压测的时候可以发现影响redis的QPS峰值的一个重要因素是pipeline批次指令的数目。 Redis的同步机制了解么? Redis可以使用主从同步,从从同步。第一次同步时,主节点做一次bgsave,并同时将后续修改操作记录到内存buffer,待完成后将RDB文件全量同步到复制节点,复制节点接受完成后将RDB镜像加载到内存。加载完成后,再通知主节点将期间修改的操作记录同步到复制节点进行重放就完成了同步过程。后续的增量数据通过AOF日志同步即可,有点类似数据库的binlog。 是否使用过Redis集群,集群的高可用怎么保证,集群的原理是什么? Redis Sentinal着眼于高可用,在master宕机时会自动将slave提升为master,继续提供服务。 Redis Cluster着眼于扩展性,在单个redis内存不足时,使用Cluster进行分片存储。 面试结束 小伙子你可以的,什么时候有时间来上班啊,要不明天就来吧? 你强装镇定,这么急啊我还需要租房,要不下礼拜一吧。 好的 心想这小子这么NB是不是很多Offer在手上,不行我得叫hr给他加钱。 能撑到最后,你自己都忍不住自己给自己点个赞了(暗示点赞,每次都看了不点赞,你们想白嫖我么?你们好坏喲,不过我喜欢⁄(⁄ ⁄•⁄ω⁄•⁄ ⁄)⁄)。 总结 在技术面试的时候,不管是Redis还是什么问题,如果你能举出实际的例子,或者是直接说自己开发过程的问题和收获会给面试官的印象分会加很多,回答逻辑性也要强一点,不要东一点西一点,容易把自己都绕晕的。 还有一点就是我问你为啥用Redis你不要一上来就直接回答问题了,你可以这样回答: 帅气的面试官您好,首先我们的项目DB遇到了瓶颈,特别是秒杀和热点数据这样的场景DB基本上就扛不住了,那就需要缓存中间件的加入了,目前市面上有的缓存中间件有 Redis 和 Memcached ,他们的优缺点......,综合这些然后再结合我们项目特点,最后我们在技术选型的时候选了谁。 如果你这样有条不紊,有理有据的回答了我的问题而且还说出这么多我问题外的知识点,我会觉得你不只是一个会写代码的人,你逻辑清晰,你对技术选型,对中间件对项目都有自己的理解和思考,说白了就是你的offer有戏了。 好了 以上就是这篇文章的全部内容了,我后面会不断更新《吊打面试官》系列和Java技术栈相关的文章。如果你有什么想知道的,也可以留言给我,我一有时间就会写出来,我们共同进步。 非常感谢您能看到这里,如果这个文章写得还不错的话 求点赞 求关注 求分享 求留言 各位的支持和认可,就是我创作的最大动力,OK各位我们下期见! 敖丙 | 文 【原创】 后面会持续更新《吊打面试官》系列可以关注我的公众号第一时间阅读,也会有朋友一线大厂的内推机会不定期推出(字节跳动,阿里,网易,PDD,滴滴,蘑菇街等),就业上有什么问题也可以直接微信滴滴我,我也是个新人,不过不影响我们一起进步,作为渣男,我给不了你工作,还给不了你温暖嘛?

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册