首页 文章 精选 留言 我的

精选列表

搜索[前端设计],共10000篇文章
优秀的个人博客,低调大师

前端百题——数组中方法原理早知道

js的Array对象可以调用很多方法,每一个方法都有其特殊的用途,但是很多情况下我们仅仅会使用这么高级方法,多于其实现过程知之甚少,本节就数组中的常用方法map、filter、reduce进行实现,帮助了解其原理。 19.1 map 19.1.1 基础 map() 方法创建一个新数组,其结果是该数组中的每个元素是调用一次提供的函数后的返回值。 map方法的用法如下所示: const new_array = arr.map(function callback(currentValue[, index[, array]]) { // …… }[, thisArg]) 复制代码 小试牛刀 const arr = [1, 2, 3, 4]; const newArr = arr.map(value => value * 3); console.log(arr); // [ 1, 2, 3, 4 ] 原数组不变 console.log(newArr); // [ 3, 6, 9, 12 ] 复制代码 19.1.2 实现 map做的事情很单纯,就是处理每个元素然后返回一个新的数组,下面就来看看怎样实现自己的map函数。实现步骤如下所示: 判断输入的第一个参数是不是函数 获取需要处理的数组内容 新建一个新数组用于装载新的内容 对数组中每个值进行处理(注意改变this指向) 返回结果 Array.prototype.myMap = function(fn) { // 判断输入的第一个参数是不是函数 if (typeof fn !== 'function') { throw new TypeError(fn + 'is not a function'); } // 获取需要处理的数组内容 const arr = this; const len = arr.length; // 新建一个空数组用于装载新的内容 const temp = new Array(len); // 对数组中每个值进行处理 for (let i = 0; i < len; i++) { // 获取第二个参数,改变this指向 let result = fn.call(arguments[1], arr[i], i, arr); temp[i] = result; } // 返回新的结果 return temp; } const arr = [1, 2, 3, 4]; const newArr = arr.myMap(value => value * 3); console.log(arr); // [ 1, 2, 3, 4 ] 原数组不变 console.log(newArr); // [ 3, 6, 9, 12 ] 复制代码 上述就是map的实现流程,并且经过验证与原生的map方法的结果一致。 19.2 filter 19.2.1 基础 filter() 方法创建一个新数组, 其包含通过所提供函数实现的测试的所有元素。 filter方法的用法如下所示: const newArray = arr.filter(callback(element[, index[, array]])[, thisArg]) 复制代码 小试牛刀 const arr = [1, 2, 3, 4]; const newArr = arr.filter(value => value > 2); console.log(arr); // [ 1, 2, 3, 4 ] console.log(newArr); // [ 3, 4 ] 复制代码 19.2.2 实现 filter函数做的事情就是过滤出符合条件的元素,对于filter的实现步骤和map的基本一致,不同之处在于其在数组中处理每个值的时候稍有区别。 Array.prototype.myFilter = function (fn) { if (typeof fn !== 'function') { throw new TypeError(`${fn} is not a function`); } // 获取该数组 const arr = this; // 获取该数组长度 const len = this.length >>> 0; // 新建一个新的数组用于放置该内容 const temp = []; // 对数组中每个值进行处理 for (let i = 0; i < len; i++) { // 处理时注意this指向 const result = fn.call(arguments[1], arr[i], i, arr); result && temp.push(arr[i]); } return temp; } const arr = [1, 2, 3, 4]; const newArr = arr.myFilter(value => value > 2); console.log(arr); // [ 1, 2, 3, 4 ] console.log(newArr); // [ 3, 4 ] 复制代码 19.3 reduce 19.3.1 基础 reduce() 方法对数组中的每个元素执行一个由您提供的reducer函数(升序执行),将其结果汇总为单个返回值。 reduce方法的用法如下所示: const result = arr.reduce(callback(accumulator, currentValue[, index[, array]])[, initialValue]) 复制代码 小试牛刀 const arr = [1, 2, 3, 4]; const result = arr.reduce((accumulator, value) => accumulator + value); console.log(result); // 10 复制代码 19.3.2 实现 reduce为数组中的每一个元素依次执行callback函数,下面就来看看怎样实现自己的filter函数。实现步骤如下所示: 判断输入的第一个参数是不是函数 获取需要处理的数组内容 获取初始值 依次处理后续数组中的元素 返回累加器处理的结果 Array.prototype.myReduce = function(fn) { if (typeof fn !== 'function') { throw new TypeError(`${fn} is not a function`); } const arr = this; const len = arr.length >>> 0; let value;// 最终返回的值 let k = 0;// 当前索引 if (arguments.length >= 2) { value = arguments[1]; } else { // 当数组为稀疏数组时,判断数组当前是否有元素,如果没有索引加一 while (k < len && !( k in arr)) { k++; } // 如果数组为空且初始值不存在则报错 if (k >= len) { throw new TypeError('Reduce of empty array with no initial value'); } value = arr[k++]; } while (k < len) { if (k in arr) { value = fn(value, arr[k], k, arr); } k++; } return value; } const arr = [1, 2, 3, 4]; const result = arr.myReduce((accumulator, value) => accumulator + value); console.log(result); // 10 复制代码 1.如果觉得这篇文章还不错,来个分享、点赞吧,让更多的人也看到 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源世界 ” ,链接: https://ym.baisou.ltd/post/735.html ,如需转载,请注明出处,否则将追究法律责任。 ​​​​​​

优秀的个人博客,低调大师

戏说前端 JavaScript 之『防抖节流』基础知识

往事不堪回首 犹记在很久之前的某次面试中,和那技术大哥谈的正欢呢,冷不防他来了句:谈一谈防抖和节流吧。 抹了把凉汗,我用颤抖的、不自信的语气回答道:呃,防抖就是应该是防止抖动的意思,节流大概是节省流量吧…… 当时,我的心理活动是这样的: 当年心理素质是真的差,这个坎没翻过去,最后的结果就是: 知耻而后勇 以我不服输的性格,这场子必须找回来! 经过这几年的勤学苦练,我现在自信简直爆棚,如果,时光能够倒流,我相信我可以做到这样: 今天,我要跟「防抖节流」来做个了断,以证明现在的我已不是过去的我,用一个成语来形容,那就是——今非昔比! 知己知彼,方能百战百胜 古老的法则告诉我们:欲要消灭敌人,必须先要了解敌人。 防抖(debounce) 从字面意思来看,防抖就是防止抖动的意思。 举个例子:比如说你对象要你帮她拍美照, 结果因为你加班太多身体虚,手抖的厉害,拍出来的照片模糊不清,为免受雷霆之怒,你就需要想想办法。首先,分析一下照片模糊的原因: 手抖的厉害(1s 十几次!!??) 导致相机不能完美的捕捉画面 所以照片模糊。 看来,「手抖」才是罪魁祸首啊,那想个办法解决手抖的问题就好了:找一个支架,让它代替手来支撑相机,这样就不「抖」了! 这操作,让我不得不对你竖起大拇指: 想想看上面这个例子本质上是解决了什么问题? 我觉得应该是解决了**「抖动频率」**的问题——手拿着,一秒会抖好多次;可支架撑着,好长时间都未必会抖一次。可谓是「人不如架」啊! 支架起的就是防抖的作用。 回到我们今天的正题上,来看一下防抖的常规解释:当函数被连续调用时,该函数并不执行,只有当其全部停止调用超过一定时间后才执行1次。 节流(throttle) 现在回头看看我当年的回答,还是摸到了一点门槛(手动缓解尴尬,嘿嘿)。 再来个例子:家里的水龙头,即使你开的再大,它在单位时间里能流出的水就那么多,因为水龙头的规格限制了它单位时间里的流量。 水龙头起到的就是节流的作用。 节流的常规解释:规定一个单位时间,在这个单位时间内,只能有一次触发事件的回调函数执行,如果在同一个单位时间内某事件被触发多次,只有一次能生效。 常用场景 防抖节流一般用于以下场景: 浏览器窗口的缩放,页面的滑动触发的 resize ,scroll 鼠标事件 onmousemove ,onmousedown, onmouseup 输入框录入触发的 keyup ,keydown…… 原理 防抖是维护一个计时器,规定在 delay 时间后触发函数,但是在 delay 时间内再次触发的话,都会清除当前的 timer 然后重新设置超时调用,即重新计时。这样一来,只有最后一次操作能被触发。 节流是通过判断是否到达一定时间来触发函数,若没到规定时间则使用计时器延后,而下一次事件则会重新设定计时器。 区别 函数防抖是某一段时间内只执行一次,而函数节流是间隔时间执行,不管事件触发有多频繁,都会保证在规定时间内一定会执行一次真正的事件处理函数。 总结 今天就先来了解一下「防抖」和「节流」的基础知识,详细代码实现待后续。 ~ ~ ~ 未完待续 学习有趣的知识,结识有趣的朋友,塑造有趣的灵魂! 大家好!我是〖编程三昧〗的作者 隐逸王,我的公众号是『编程三昧』,欢迎关注,希望大家多多指教! 知识与技能并重,内力和外功兼修,理论和实践两手都要抓、两手都要硬!

优秀的个人博客,低调大师

前端面试常考题:JS垃圾回收机制

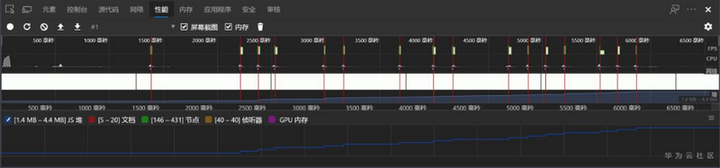
摘要:众所周知,应用程序在运行过程中需要占用一定的内存空间,且在运行过后就必须将不再用到的内存释放掉,否则就会出现下图中内存的占用持续升高的情况,一方面会影响程序的运行速度,另一方面严重的话则会导致整个程序的崩溃。 众所周知,应用程序在运行过程中需要占用一定的内存空间,且在运行过后就必须将不再用到的内存释放掉,否则就会出现下图中内存的占用持续升高的情况,一方面会影响程序的运行速度,另一方面严重的话则会导致整个程序的崩溃。 JavaScript中的内存管理 内存:由可读写单元组成,表示一片可操作空间; 管理:人为的去操作一片空间的申请、使用和释放; 内存管理:开发者主动申请空间、使用空间、释放空间; 管理流程:申请-使用-释放 部分语言需要(例如C语言)需要手动去释放内存,但是会很麻烦,所以很多语言,例如JAVA都会提供自动的内存管理机制,称为“垃圾回收机制”,JavaScript语言中也提供了垃圾回收机制(Garbage Collecation),简称GC机制。 全停顿(Stop The World ) 在介绍垃圾回收算法之前,我们先了解一下「全停顿」。垃圾回收算法在执行前,需要将应用逻辑暂停,执行完垃圾回收后再执行应用逻辑,这种行为称为 「全停顿」(Stop The World)。例如,如果一次GC需要50ms,应用逻辑就会暂停50ms。 全停顿的目的,是为了解决应用逻辑与垃圾回收器看到的情况不一致的问题。 举个例子,在自助餐厅吃饭,高高兴兴地取完食物回来时,结果发现自己餐具被服务员收走了。这里,服务员好比垃圾回收器,餐具就像是分配的对象,我们就是应用逻辑。在我们看来,只是将餐具临时放在桌上,但是服务员看来觉得你已经不需要使用了,因此就收走了。你与服务员对于同一个事物看到的情况是不一致,导致服务员做了与我们不期望的事情。因此,为避免应用逻辑与垃圾回收器看到的情况不一致,垃圾回收算法在执行时,需要停止应用逻辑。 JavaScript中的垃圾回收 JavaScript中会被判定为垃圾的情形如下: 对象不再被引用; 对象不能从根上访问到; GC算法 常见的GC算法如下: 引用计数 标记清除 标记整理 分代回收 引用计数 早期的浏览器最常使用的垃圾回收方法叫做"引用计数"(reference counting):语言引擎有一张"引用表",保存了内存里面所有的资源(通常是各种值)的引用次数。如果一个值的引用次数是0,就表示这个值不再用到了,因此可以将这块内存释放。 const user1 = {age: 11} const user2 = {age: 22} const user3 = {age: 33} const userList = [user1.age, user2.age, user3.age] 上面这段代码,当执行过一遍过后,user1、user2、user3都是被userList引用的,所以它们的引用计数不为零,就不会被回收 function fn() { const num1 = 1 const num2 = 2 } fn() 上面代码中fn函数执行完毕,num1、num2都是局部变量,执行过后,它们的引用计数就都为零,所有这样的代码就会被当做“垃圾”,进行回收。 引用计数算法有一个比较大的问题:循环引用 function objGroup(obj1, obj2) { obj1.next = obj2 obj2.prev = obj1 return { o1: obj1, o2: obj2, } } let obj = objGroup({name: 'obj1'}, {name: 'obj2'}) console.log(obj) 上面的这个例子中,obj1和obj2通过各自的属性相互引用,所有它们的引用计数都不为零,这样就不会被垃圾回收机制回收,造成内存浪费。 引用计数算法其实还有一个比较大的缺点,就是我们需要单独拿出一片空间去维护每个变量的引用计数,这对于比较大的程序,空间开销还是比较大的。 引用计数算法优点: 引用计数为零时,发现垃圾立即回收; 最大限度减少程序暂停; 引用计数算法缺点: 无法回收循环引用的对象; 空间开销比较大; 标记清除(Mark-Sweep) 核心思想:分标记和清除两个阶段完成。 遍历所有对象找标记活动对象; 遍历所有对象清除没有标记对象; 回收相应的空间。 标记清除算法的优点是:对比引用计数算法,标记清除算法最大的优点是能够回收循环引用的对象,它也是v8引擎使用最多的算法。 标记清除算法的缺点是: 上图我们可以看到,红色区域是一个根对象,就是一个全局变量,会被标记;而蓝色区域就是没有被标记的对象,会被回收机制回收。这时就会出现一个问题,表面上蓝色区域被回收了三个空间,但是这三个空间是不连续的,当我们有一个需要三个空间的对象,那么我们刚刚被回收的空间是不能被分配的,这就是“空间碎片化”。 标记整理(Mark-Compact) 为了解决内存碎片化的问题,提高对内存的利用,引入了标记整理算法。 标记整理可以看做是标记清除的增强。标记阶段的操作和标记清除一致。 清除阶段会先执行整理,移动对象位置,将存活的对象移动到一边,然后再清理端边界外的内存。 标记整理的缺点是:移动对象位置,不会立即回收对象,回收的效率比较慢。 增量标记(Incremental Marking) 为了减少全停顿的时间,V8对标记进行了优化,将一次停顿进行的标记过程,分成了很多小步。每执行完一小步就让应用逻辑执行一会儿,这样交替多次后完成标记。 长时间的GC,会导致应用暂停和无响应,将会导致糟糕的用户体验。从2011年起,v8就将「全暂停」标记换成了增量标记。改进后的标记方式,最大停顿时间减少到原来的1/6。 v8引擎垃圾回收策略 采用分代回收的思想; 内存分为新生代、老生代; 针对不同对象采用不同算法: (1)新生代:对象的存活时间较短。新生对象或只经过一次垃圾回收的对象。 (2)老生代:对象存活时间较长。经历过一次或多次垃圾回收的对象。 V8堆的空间等于新生代空间加上老生代空间。且针对不同的操作系统对空间做了内存的限制。 针对浏览器来说,这样的内存是足够使用的。限制内存的原因: 针对浏览器的GC机制,经过不断的测试,如果内存再设置大一点,GC回收的时间就会达到用户的感知,会造成感知上的卡顿。 回收新生代对象 回收新生代对象主要采用复制算法(Scavenge 算法)加标记整理算法。而Scavenge 算法的具体实现,主要采用了Cheney算法。 Cheney算法将内存分为两个等大空间,使用空间为From,空闲空间为To。 检查From空间内的存活对象,若对象存活,检查对象是否符合晋升条件,若符合条件则晋升到老生代,否则将对象从From空间复制到To空间。若对象不存活,则释放不存活对象的空间。完成复制后,将From空间与To空间进行角色翻转。 对象晋升机制 一轮GC还存活的新生代需要晋升。 当对象从From空间复制到To空间时,若To空间使用超过 25%,则对象直接晋升到老生代中。设置为25%的比例的原因是,当完成Scavenge回收后,To空间将翻转成From空间,继续进行对象内存的分配。若占比过大,将影响后续内存分配。 回收老生代对象 回收老生代对象主要采用标记清除、标记整理、增量标记算法,主要使用标记清除算法,只有在内存分配不足时,采用标记整理算法。 首先使用标记清除完成垃圾空间的回收; 采用标记整理进行空间优化; 采用增量标记进行效率优化; 新生代和老生代回收对比 新生代由于占用空间比较少,采用空间换时间机制。 老生代区域空间比较大,不太适合大量的复制算法和标记整理,所以最常用的是标记清除算法,为了就是让全停顿的时间尽量减少。 内存泄漏识别方法 我们先写一段比较消耗内存的代码: <button class="btn">点击</button> <script> const btn = document.querySelector('.btn') const arrList = [] btn.onclick = function() { for(let i = 0; i < 100000; i++) { const p = document.createElement('p') // p.innerHTML = '我是一个p元素' document.body.appendChild(p) } arrList.push(new Array(1000000).join('x')) } </script> 使用浏览器的Performance来监控内存变化 点击录制,然后我们操作们感觉消耗性能的操作,操作完成之后,点击stop停止录制。 然后我们看一看是那些地方引起了内存的泄漏,我们只需要关注内存即可。 可以看到内存在短时间消耗的比较快,下降的小凹槽,就是浏览器在进行垃圾回收。 性能优化 1.避免使用全局变量 全局变量会挂载在window下; 全局变量至少有一个引用计数; 全局变量存活更久,持续占用内存; 在明确数据作用域的情况下,尽量使用局部变量; 2.减少判断层级 function doSomething(part, chapter) { const parts = ['ES2016', '工程化', 'Vue', 'React', 'Node'] if (part) { if (parts.includes(part)) { console.log('属于当前课程') if (chapter > 5) { console.log('您需要提供 VIP 身份') } } } else { console.log('请确认模块信息') } } doSomething('Vue', 6) // 减少判断层级 function doSomething(part, chapter) { const parts = ['ES2016', '工程化', 'Vue', 'React', 'Node'] if (!part) { console.log('请确认模块信息') return } if (!parts.includes(part)) return console.log('属于当前课程') if (chapter > 5) { console.log('您需要提供 VIP 身份') } } doSomething('Vue', 6) 3.减少数据读取次数 对于频繁使用的数据,我们要对数据进行缓存。 <div id="skip" class="skip"></div> <script> var oBox = document.getElementById('skip') // function hasEle (ele, cls) { // return ele.className === cls // } function hasEle (ele, cls) { const className = ele.className return className === cls } console.log(hasEle(oBox, 'skip')) </script> 4.减少循环体中的活动 var test = () => { var i var arr = ['Hello World!', 25, '岂曰无衣,与子同袍'] for(i = 0; i < arr.length; i++) { console.log(arr[i]) } } // 优化后,将arr.length单独提出,防止每次循环都获取一次 var test = () => { var i var arr = ['Hello World!', 25, '岂曰无衣,与子同袍'] var len = arr.length for(i = 0; i < len; i++) { console.log(arr[i]) } } 5.事件绑定优化 <ul class="ul"> <li>Hello World!</li> <li>25</li> <li>岂曰无衣,与子同袍</li> </ul> <script> var list = document.querySelectorAll('li') function showTxt(ev) { console.log(ev.target.innerHTML) } for (item of list) { item.onclick = showTxt } // 优化后 function showTxt(ev) { var target = ev.target if (target.nodeName.toLowerCase() === 'li') { console.log(ev.target.innerHTML) } } var ul = document.querySelector('.ul') ul.addEventListener('click', showTxt) </script> 6.避开闭包陷阱 <button class="btn">点击</button> <script> function foo() { let el = document.querySelector('.btn') el.onclick = function() { console.log(el.className) } } foo() // 优化后 function foo1() { let el = document.querySelector('.btn') el.onclick = function() { console.log(el.className) } el = null // 将el置为 null 防止闭包中的引用使得不能被回收 } foo1() </script> 本文分享自华为云社区《Vue进阶(幺陆玖):JS垃圾回收机制》,原文作者:SHQ5785 。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

我在阿里云做前端代码智能化

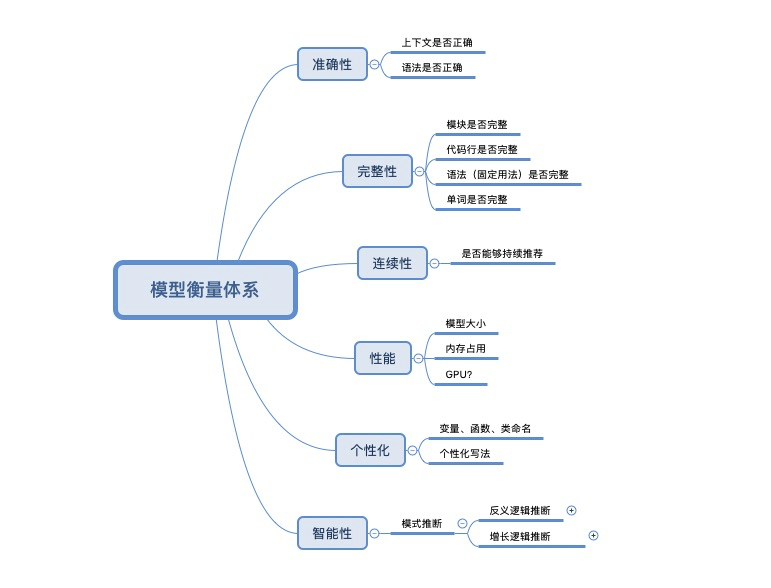
作为一个整天以代码为伴的码农,避免不了会接触到各种代码提示工具,但是呢,用久了之后会发现他们都有个共同点,那就是模型巨大,动辄几百兆;并且模型大必然需要更多的计算,同样会导致电脑内存占用高,风扇呼呼的转,时间久了逐渐会发现电脑存储不够用了,电脑变卡了等等问题。 那么,有没有一款轻量化的代码提示插件?或者说,如何实现一款轻量化的代码提示插件呢? 下面我会从 模型选择、模型实现、模型优化三个方面 来介绍我们在代码智能提示方面的一些实践。 模型选择 如何衡量一个模型的效果是好还是不好呢? 我们首先建立了基本的模型衡量体系,见下图。 我们会从推荐的准确性、完整性、连续性、性能、个性化以及智能性六个维度去综合评价一个模型的优劣。之后,我们会进一步完善这个体系,使之能够系统完整的评测模型的效果。 实践中,我们选取了 GPT-2模型和基于markov的n-gram统计模型进行对比。 对比发现,GPT-2模型在准确性和完整性方面表现优异,但是在性能方面,由于模型较大,推荐一次耗时较久,(这里我们试了最少参数的版本,训练之后模型在500M左右,推荐一次大概需要10S),由于暂时没找到模型压缩的方法,只能暂时放弃。 另一个n-gram模型,在测试后发现,它在持续推荐和性能方面表现优异,模型大小仅有40M,但也并非完美,在准确性和完整性方面表现的不是很好。 在实践中,我们发现,推荐耗时在毫秒级别能够使用户顺畅无阻碍的编写下去,多于1s,则会让用户的输入产生停顿。 基于此我们暂时选取n-gram作为我们的推荐模型。 模型实现 下面介绍一下n-gram模型的基本原理以及我们的实现。 首先,n-gram模型基于马尔可夫链的假设,即:当前这个词出现的概率仅仅跟前面几个有限的词相关。 以最简单的n=2为例,即 下一个词出现的概率仅跟之前一个词相关,基于这个思想,我们将大量代码进行切分,这样我们得到了很多的二元组,这里可以使用单词的出现次数代表概率。这样,我们根据一个词就可以得到一个不同概率分布的推荐列表,然后每次都以当前词进行推荐,就可以产生持续不断的推荐了。切分的效果参考这张图 以下是模型训练和产生推荐的大致流程。 模型优化 在真实应用中,仅仅有这些是远远不够的。模型只是其中一部分,更多的应该是在应用过程中,依据实践经验和用户的反馈,对模型进行不断调优: 比如,在实际应用中,基于同一个上下文,我们一般会同时产生基于n=3,n=4等等不通粒度的推荐,我们会给不通粒度赋予不同的权重,然后结合概率进行筛选和排序,并且根据实际效果以及我们的反馈体系,对权重进行断优化,确保产生最佳效果的推荐。 另外,为了让推荐更加个性化,我们的模型需要具备实时训练的能力,即用户的输入在产生推荐的同时,还要参与模型的增量训练,并根据用户实际的选择对模型进行调优,确保模型的准确性和个性化,大致流程图如下 还有,为了得到更加轻量的模型,我们对语料库也进行了精简,比如,在初始模型中,我们对出现概率极低的语料进行了删减,保持模型的轻巧和高效,同时由于具备实时训练的能力,确保这个操作不会影响到推荐的准确率。 结语 当然,目前的这些对于一个轻巧好用的代码提示来说是远远不够的,当前我们正在尝试完善模型的衡量体系,并且在尝试更多轻量的语言模型,希望给用户提供完美的体验。 原文链接 本文为阿里云原创内容,未经允许不得转载。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册