首页 文章 精选 留言 我的

精选列表

搜索[Solon框架],共10000篇文章
优秀的个人博客,低调大师

Linux未来监控tracing框架——eBPF

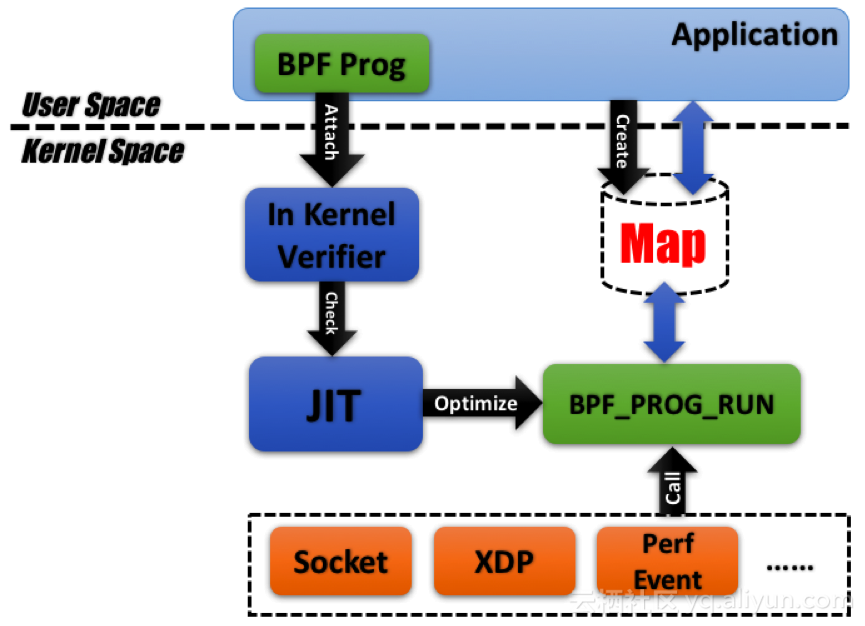
eBPF源于早年间的成型于 BSD 之上的传统技术 BPF(Berkeley Packet Filter)。BPF 的全称是 Berkeley Packet Filter,顾名思义,这是一个用于过滤(filter)网络报文(packet)的架构。 BPF 是在 1997 年首次被引入 Linux 的,Linux 内核中的报文过滤机制其实是有自己的名字的:Linux Socket Filter,简称 LSF。 从 3.15 开始,一个套源于 BPF 的全新设计开始,在3.17被添置到了 kernel/bpf 下。全新设计最终被命名为了 extended BPF(eBPF);为了后向兼容,传统的 BPF 仍被保留了下来,并被重命名为 classical BPF(cBPF)。相对于 cBPF,eBPF 带来的改变可谓是革命性的:一方面,它已经为内核追踪(Kernel Tracing)、应用性能调优/监控、流控(Traffic Control)等领域带来了激动人心的变革;另一方面,在接口的设计以及易用性上,eBPF 也有了较大的改进。 cBPF 所覆盖的功能范围很简单,就是网络监控和 seccomp 两块,数据接口设计的粗放;而 eBPF 的利用范围要广的多,性能调优、内核监控、流量控制什么的,数据接口的多样性设计。 由一个文件(net/core/filter.c)进化到一个目录(kernel/bpf) 目前,支持生成 BPF 伪代码的编译器只有 llvm 一家,即使是通篇使用 gcc 编译的 Linux 内核,samples 目录下的 bpf 范例也要借用 llvm 来编译完成。 1. 运行监测 eBPF 其实是内核模块,比内核模块更短小精干,实现的功能也更新颖, eBPF注入的代码是要在内核中运行的,会有安全隐患。 为了最大限度控制安全隐患,cBPF 时代就开始加入了代码检查机制以防止不规范的注入代码;到了 eBPF则在载入程序(bpf_load_program())时加入了更复杂的verifier 机制,会进行一系列的安全检查。 2. 架构 架构如下: 3. bcc 现在可以用 C 来实现 BPF,但编译出来的却仍然是 ELF 文件,开发者需要手动析出真正可以注入内核的代码。这工作有些麻烦,于是就有人设计了 BPF Compiler Collection(BCC),BCC 是一个 python 库,但是其中有很大一部分的实现是基于 C 和 C++的,python实现了对 BCC 应用层接口的封装。 使用 BCC 进行 BPF 的开发仍然需要开发者自行利用 C 来设计 BPF 程序——但也仅此而已,余下的工作,包括编译、解析 ELF、加载 BPF 代码块以及创建 map 等等基本可以由 BCC 一力承担,无需多劳开发者费心。 3.1 bcc安装 github的地址链接如下: https://github.com/iovisor/bcc 执行:git clone https://github.com/iovisor/bcc.git 在Ubuntu中直接安装二进制文件,命令如下: sudo apt-key adv --keyserver keyserver.ubuntu.com --recv-keys D4284CDD echo "deb https://repo.iovisor.org/apt/xenial xenial main" | sudo tee /etc/apt/sources.list.d/iovisor.list sudo apt-get update sudo apt-get install bcc-tools libbcc-examples linux-headers-$(uname -r) 这样就可以 使用bcc/example/tracing中的python用例。

优秀的个人博客,低调大师

集合框架源码学习之LinkedList

0-1. 简介0-2. 内部结构分析0-3. LinkedList源码分析 0-3-1. 构造方法 0-3-2. 添加add方法 0-3-3. 根据位置取数据的方法 0-3-4. 根据对象得到索引的方法 0-3-5. 检查链表是否包含某对象的方法 0-3-6. 删除removepop方法0-4. LinkedList类常用方法 简介 LinkedList是一个实现了List接口和Deque接口的双端链表。 LinkedList底层的链表结构使它支持高效的插入和删除操作,另外它实现了Deque接口,使得LinkedList类也具有队列的特性;LinkedList不是线程安全的,如果想使LinkedList变成线程安全的,可以调用静态类Collections类中的synchronizedList方法: List list=Collections.synchronizedList(new LinkedList(...)); 内部结构分析 如下图所示:看完了图之后,我们再看LinkedList类中的一个内部私有类Node就很好理解了: private static class Node<E> { E item;//节点值 Node<E> next;//前驱节点 Node<E> prev;//后继节点 Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } 这个类就代表双端链表的节点Node。这个类有三个属性,分别是前驱节点,本节点的值,后继结点。 LinkedList源码分析 构造方法 空构造方法: public LinkedList() { } 用已有的集合创建链表的构造方法: public LinkedList(Collection<? extends E> c) { this(); addAll(c); } 添加(add)方法 add(E e) 方法:将元素添加到链表尾部 public boolean add(E e) { linkLast(e);//这里就只调用了这一个,我们马上就分析这个方法的实现 return true; } private void linkFirst(E e) { final Node<E> f = first; final Node<E> newNode = new Node<>(null, e, f);//新建节点,以头节点为后继节点 first = newNode; //如果链表为空,last节点也指向该节点 if (f == null) last = newNode; //否则,将头节点的前驱指针指向新节点 else f.prev = newNode; size++; modCount++; } add(int index,E e):在指定位置添加元素 public void add(int index, E element) { checkPositionIndex(index); //检查索引是否处于[0-size]之间 if (index == size)//添加在链表尾部 linkLast(element); else//添加在链表中间 linkBefore(element, node(index)); } linkBefore方法需要给定两个参数,一个插入节点的值,一个指定的node,所以我们又调用了Node(index)去找到index对应的node addAll(Collection<? extends E> c ): 将集合插入到链表尾部 public boolean addAll(Collection<? extends E> c) { return addAll(size, c); } addAll(int index, Collection<? extends E> c): 将集合从指定位置开始插入 public boolean addAll(int index, Collection<? extends E> c) { //1:检查index范围是否在size之内 checkPositionIndex(index); //2:toArray()方法把集合的数据存到对象数组中 Object[] a = c.toArray(); int numNew = a.length; if (numNew == 0) return false; //3:得到插入位置的前驱节点和后继节点 Node<E> pred, succ; //如果插入位置为尾部,前驱节点为last,后继节点为null if (index == size) { succ = null; pred = last; } //否则,调用node()方法得到后继节点,再得到前驱节点 else { succ = node(index); pred = succ.prev; } // 4:遍历数据将数据插入 for (Object o : a) { @SuppressWarnings("unchecked") E e = (E) o; //创建新节点 Node<E> newNode = new Node<>(pred, e, null); //如果插入位置在链表头部 if (pred == null) first = newNode; else pred.next = newNode; pred = newNode; } //如果插入位置在尾部,重置last节点 if (succ == null) { last = pred; } //否则,将插入的链表与先前链表连接起来 else { pred.next = succ; succ.prev = pred; } size += numNew; modCount++; return true; } 上面可以看出addAll方法通常包括下面四个步骤: 检查index范围是否在size之内 toArray()方法把集合的数据存到对象数组中 得到插入位置的前驱和后继节点 遍历数据,将数据插入到指定位置 addFirst(E e): 将元素添加到链表头部 public void addFirst(E e) { linkFirst(e); } private void linkFirst(E e) { final Node<E> f = first; final Node<E> newNode = new Node<>(null, e, f);//新建节点,以头节点为后继节点 first = newNode; //如果链表为空,last节点也指向该节点 if (f == null) last = newNode; //否则,将头节点的前驱指针指向新节点 else f.prev = newNode; size++; modCount++; } addLast(E e): 将元素添加到链表尾部,与 add(E e) 方法一样 public void addLast(E e) { linkLast(e); } 根据位置取数据的方法 get(int index)::根据指定索引返回数据 public E get(int index) { //检查index范围是否在size之内 checkElementIndex(index); //调用Node(index)去找到index对应的node然后返回它的值 return node(index).item; } 获取头节点(index=0)数据方法: public E getFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return f.item; } public E element() { return getFirst(); } public E peek() { final Node<E> f = first; return (f == null) ? null : f.item; } public E peekFirst() { final Node<E> f = first; return (f == null) ? null : f.item; } 区别:getFirst(),element(),peek(),peekFirst()这四个获取头结点方法的区别在于对链表为空时的处理,是抛出异常还是返回null,其中getFirst() 和element() 方法将会在链表为空时,抛出异常 element()方法的内部就是使用getFirst()实现的。它们会在链表为空时,抛出NoSuchElementException获取尾节点(index=-1)数据方法: public E getLast() { final Node<E> l = last; if (l == null) throw new NoSuchElementException(); return l.item; } public E peekLast() { final Node<E> l = last; return (l == null) ? null : l.item; } 两者区别:getLast() 方法在链表为空时,会抛出NoSuchElementException,而peekLast() 则不会,只是会返回 null。 根据对象得到索引的方法 int indexOf(Object o): 从头遍历找 public int indexOf(Object o) { int index = 0; if (o == null) { //从头遍历 for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) return index; index++; } } else { //从头遍历 for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) return index; index++; } } return -1; } int lastIndexOf(Object o): 从尾遍历找 public int lastIndexOf(Object o) { int index = size; if (o == null) { //从尾遍历 for (Node<E> x = last; x != null; x = x.prev) { index--; if (x.item == null) return index; } } else { //从尾遍历 for (Node<E> x = last; x != null; x = x.prev) { index--; if (o.equals(x.item)) return index; } } return -1; } 检查链表是否包含某对象的方法: contains(Object o): 检查对象o是否存在于链表中 public boolean contains(Object o) { return indexOf(o) != -1; } 删除(remove/pop)方法 remove() ,removeFirst(),pop(): 删除头节点 public E pop() { return removeFirst(); } public E remove() { return removeFirst(); } public E removeFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return unlinkFirst(f); } removeLast(),pollLast(): 删除尾节点 public E removeLast() { final Node<E> l = last; if (l == null) throw new NoSuchElementException(); return unlinkLast(l); } public E pollLast() { final Node<E> l = last; return (l == null) ? null : unlinkLast(l); } 区别: removeLast()在链表为空时将抛出NoSuchElementException,而pollLast()方法返回null。 remove(Object o): 删除指定元素 public boolean remove(Object o) { //如果删除对象为null if (o == null) { //从头开始遍历 for (Node<E> x = first; x != null; x = x.next) { //找到元素 if (x.item == null) { //从链表中移除找到的元素 unlink(x); return true; } } } else { //从头开始遍历 for (Node<E> x = first; x != null; x = x.next) { //找到元素 if (o.equals(x.item)) { //从链表中移除找到的元素 unlink(x); return true; } } } return false; } 当删除指定对象时,只需调用remove(Object o)即可,不过该方法一次只会删除一个匹配的对象,如果删除了匹配对象,返回true,否则false。 unlink(Node x) 方法: E unlink(Node<E> x) { // assert x != null; final E element = x.item; final Node<E> next = x.next;//得到后继节点 final Node<E> prev = x.prev;//得到前驱节点 //删除前驱指针 if (prev == null) { first = next;如果删除的节点是头节点,令头节点指向该节点的后继节点 } else { prev.next = next;//将前驱节点的后继节点指向后继节点 x.prev = null; } //删除后继指针 if (next == null) { last = prev;//如果删除的节点是尾节点,令尾节点指向该节点的前驱节点 } else { next.prev = prev; x.next = null; } x.item = null; size--; modCount++; return element; } remove(int index):删除指定位置的元素 public E remove(int index) { //检查index范围 checkElementIndex(index); //将节点删除 return unlink(node(index)); } LinkedList类常用方法测试: package list; import java.util.Iterator; import java.util.LinkedList; public class LinkedListDemo { public static void main(String[] srgs) { //创建存放int类型的linkedList LinkedList<Integer> linkedList = new LinkedList<>(); /************************** linkedList的基本操作 ************************/ linkedList.addFirst(0); // 添加元素到列表开头 linkedList.add(1); // 在列表结尾添加元素 linkedList.add(2, 2); // 在指定位置添加元素 linkedList.addLast(3); // 添加元素到列表结尾 System.out.println("LinkedList(直接输出的): " + linkedList); System.out.println("getFirst()获得第一个元素: " + linkedList.getFirst()); // 返回此列表的第一个元素 System.out.println("getLast()获得第最后一个元素: " + linkedList.getLast()); // 返回此列表的最后一个元素 System.out.println("removeFirst()删除第一个元素并返回: " + linkedList.removeFirst()); // 移除并返回此列表的第一个元素 System.out.println("removeLast()删除最后一个元素并返回: " + linkedList.removeLast()); // 移除并返回此列表的最后一个元素 System.out.println("After remove:" + linkedList); System.out.println("contains()方法判断列表是否包含1这个元素:" + linkedList.contains(1)); // 判断此列表包含指定元素,如果是,则返回true System.out.println("该linkedList的大小 : " + linkedList.size()); // 返回此列表的元素个数 /************************** 位置访问操作 ************************/ System.out.println("-----------------------------------------"); linkedList.set(1, 3); // 将此列表中指定位置的元素替换为指定的元素 System.out.println("After set(1, 3):" + linkedList); System.out.println("get(1)获得指定位置(这里为1)的元素: " + linkedList.get(1)); // 返回此列表中指定位置处的元素 /************************** Search操作 ************************/ System.out.println("-----------------------------------------"); linkedList.add(3); System.out.println("indexOf(3): " + linkedList.indexOf(3)); // 返回此列表中首次出现的指定元素的索引 System.out.println("lastIndexOf(3): " + linkedList.lastIndexOf(3));// 返回此列表中最后出现的指定元素的索引 /************************** Queue操作 ************************/ System.out.println("-----------------------------------------"); System.out.println("peek(): " + linkedList.peek()); // 获取但不移除此列表的头 System.out.println("element(): " + linkedList.element()); // 获取但不移除此列表的头 linkedList.poll(); // 获取并移除此列表的头 System.out.println("After poll():" + linkedList); linkedList.remove(); System.out.println("After remove():" + linkedList); // 获取并移除此列表的头 linkedList.offer(4); System.out.println("After offer(4):" + linkedList); // 将指定元素添加到此列表的末尾 /************************** Deque操作 ************************/ System.out.println("-----------------------------------------"); linkedList.offerFirst(2); // 在此列表的开头插入指定的元素 System.out.println("After offerFirst(2):" + linkedList); linkedList.offerLast(5); // 在此列表末尾插入指定的元素 System.out.println("After offerLast(5):" + linkedList); System.out.println("peekFirst(): " + linkedList.peekFirst()); // 获取但不移除此列表的第一个元素 System.out.println("peekLast(): " + linkedList.peekLast()); // 获取但不移除此列表的第一个元素 linkedList.pollFirst(); // 获取并移除此列表的第一个元素 System.out.println("After pollFirst():" + linkedList); linkedList.pollLast(); // 获取并移除此列表的最后一个元素 System.out.println("After pollLast():" + linkedList); linkedList.push(2); // 将元素推入此列表所表示的堆栈(插入到列表的头) System.out.println("After push(2):" + linkedList); linkedList.pop(); // 从此列表所表示的堆栈处弹出一个元素(获取并移除列表第一个元素) System.out.println("After pop():" + linkedList); linkedList.add(3); linkedList.removeFirstOccurrence(3); // 从此列表中移除第一次出现的指定元素(从头部到尾部遍历列表) System.out.println("After removeFirstOccurrence(3):" + linkedList); linkedList.removeLastOccurrence(3); // 从此列表中移除最后一次出现的指定元素(从头部到尾部遍历列表) System.out.println("After removeFirstOccurrence(3):" + linkedList); /************************** 遍历操作 ************************/ System.out.println("-----------------------------------------"); linkedList.clear(); for (int i = 0; i < 100000; i++) { linkedList.add(i); } // 迭代器遍历 long start = System.currentTimeMillis(); Iterator<Integer> iterator = linkedList.iterator(); while (iterator.hasNext()) { iterator.next(); } long end = System.currentTimeMillis(); System.out.println("Iterator:" + (end - start) + " ms"); // 顺序遍历(随机遍历) start = System.currentTimeMillis(); for (int i = 0; i < linkedList.size(); i++) { linkedList.get(i); } end = System.currentTimeMillis(); System.out.println("for:" + (end - start) + " ms"); // 另一种for循环遍历 start = System.currentTimeMillis(); for (Integer i : linkedList) ; end = System.currentTimeMillis(); System.out.println("for2:" + (end - start) + " ms"); // 通过pollFirst()或pollLast()来遍历LinkedList LinkedList<Integer> temp1 = new LinkedList<>(); temp1.addAll(linkedList); start = System.currentTimeMillis(); while (temp1.size() != 0) { temp1.pollFirst(); } end = System.currentTimeMillis(); System.out.println("pollFirst()或pollLast():" + (end - start) + " ms"); // 通过removeFirst()或removeLast()来遍历LinkedList LinkedList<Integer> temp2 = new LinkedList<>(); temp2.addAll(linkedList); start = System.currentTimeMillis(); while (temp2.size() != 0) { temp2.removeFirst(); } end = System.currentTimeMillis(); System.out.println("removeFirst()或removeLast():" + (end - start) + " ms"); } } 欢迎关注我的微信公众号(分享各种Java学习资源,面试题,以及企业级Java实战项目回复关键字免费领取):
优秀的个人博客,低调大师

linux内存管理之全局框架

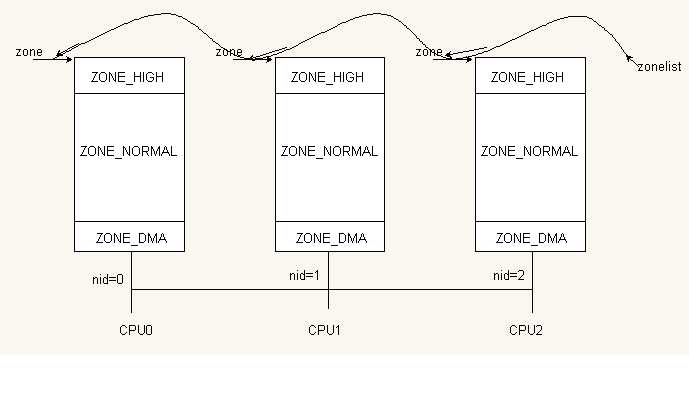
讲解复杂繁琐的机制原理,最通俗的方法就是用模型架构的方式向读者呈现,先要在整体上了解大方向大架构,再根据大方向大架构来进行分支深入,犹如毛主席那句话“战略上蔑视敌人,战术上重视敌人”。下面我也以这种方式把各个大模型方式向大家画出,并作出简略解述。 一. 地址划分。 1. CPU地址。 CPU地址是指CPU的地址总线能寻址的范围,32bit-CPU寻址范围为4G, 这个地址是虚拟的,实际上外部物理内存是不会使用这么大的内存。 CPU虚拟地址的4G空间,通常划分为两部分,一部分为内核虚拟地址,通常为3G-4G之间,另一部分为用户虚拟地址,通常为0G-3G之间,显然,用户进程能使用的虚拟地址范围远大于内核可以使用的虚拟地址空间,但是,物理内存只有局限性的几M,几G,内核虚拟地址如何使用物理内存,用户空间如何使用物理内存,这些问题正是linux内存管理的关键。 2. 物理内存 物理内存是指外部存储数据的设备,有可以被CPU寻址到的地址总线,受到CPU的Cache 和TLB/MMU管理寻址。 需要澄清一个概念:任何代码是在CPU上运行的,而不是在物理内存上,物理内存是个设备,用于存放用户进程空间的可执行代码或者内核关键数据结构,这些代码或结构终将是要受到CPU通过MMU寻址,Cache命中指令数据来获取的。 NUMA的全称是非一致性内存访问,它通常是多核访问的概念,每一个CPU核都会有一个节点对应使用一部分物理内存,对这些节点的管理附加这些数据结构:perCPU变量,list表串联各节点遍历,zone的划分,zonelist的管理等等。为了使问题更加简单化,我们只分析UMA的一个节点的情况,当然它也包含NUMA的一些数据结构特征,这个后面会有所简述。 下图是NUMA的一个简略图抽象如图2-1所示。 图2-1 NUMA多核物理内存zone示意图 3. 内核虚拟地址空间划分。 如果读者仅仅了解一些皮毛,必然认为内核的虚拟地址空间仅有逻辑地址这一说,其实这只是内存内核虚拟地址划分的一个特例,并非全部的完整表述,现在我划出完整的图形,并且改变改变对内核虚拟地址空间名称的叫法,如图2-2 图2-2 内核虚拟地址空间划分及其对物理内存的映射 下面来改改名字咯,直接映射的地址我们可以叫为内核物理直接映射地址或者逻辑地址。linux原则上只能使用虚拟空间1G中的896M,剩下的128M留作它用,所以直接映射之外的物理内存称为高端内存。128M之间的空间又划分为多个gap安全间隙,虚拟地址,固定映射和持久映射,注意这里的虚拟地址叫法通常和前述的内核虚拟地址有些混杂,后者是指CPU内核虚拟地址,是更广的概念。由于直接映射的部分有了名字叫逻辑地址,那么这里的虚拟地址空间常专指这个部分。 虚拟地址有以下用途,使用vm_struct结构体经内核管理高端内存,它可以使用kmap方式获取高端物理内存的空间;也可以不映射物理高端内存,将这段地址直接作为外部物理设备的ioremap地址,从而可以直接操纵设备,当然这也将外部设备地址空间暴露出来并且容易造成干扰,所以通常不能直接访问ioremap映射的地址而是用readb/writeb读写,而且要做好优化屏障设置并且用iounmap释放,因为映射了的设备常具有’边际效应’. 如果没有高端内存,(当然32bit的嵌入式系统通常不会使用高端内存,至少我见过的那么多关于ARM,powerPC,MIPS32的嵌入式应用都是没有使用高端内存的), 那么固定映射和持久映射也多半不会用到。固定映射可以指定长期持有物理内存某些地址页的占用,这个映射关系可以在初始阶段进行配置,而持久映射在启用时就建立了同高端内存物理页的映射关系,它在其他阶段都不会被解除。 强调的是,我这里不关心高端内存,内核的直接映射逻辑地址就可以涵盖全部物理内存。 4. 用户虚拟地址空间的划分 用户虚拟地址空间图构并不复杂,复杂的是它在虚拟内存空间中的应用,如何映射文件,如何组织区间映射,关联的进程是谁,对应的内存结构体实例是什么等等问题才是用户虚拟映射最难的地方,下面仅仅划出图示,对用户虚拟内存空间可以先有一个大了解,如图2-3。 图2-3用户空间虚拟内存布局 既然用户空间是虚拟的,那么它是怎么访问物理内存的呢,当然就是PGD,PUD,PMD,PTE,OFFSET及其TLB快表查询了,上层目录入口PUD和中间目录入口一般不考虑,考虑二级目录就可以了。从网上摘的图2-4: 图2-4 用户进程空间访问物理内存的方法 二. 伙伴系统 伙伴系统是按阶管理外界物理内存的方法,最大有11阶,每一阶有一个或者多个页合并的集合并使用指针串联起来,同时在同一阶中的一个或多个页集合中形成各自的伙伴,要强调的是各个阶的伙伴都是等页个数的,用下图2-5是比较好理解的。 图2-5 伙伴系统在内存中的大致模型 当内核申请一段按页却并非按照阶数分配的内存时候,通常会使用伙伴系统原理将其按照该申请空间的最大阶数分配,多出来的页按照伙伴系统算法归并到其他阶的链表当中形成其他阶的新伙伴。释放该内存空间的时候,释放的空间会尝试找到能以它为伙伴的那个阶进行连接,如果大小超过,则劈开,多余的再寻找其他可以以它为伙伴的阶。够拗口的,但还是很容易理解的,后面会有源代码呈现出来以实例详细分析。 三. 反碎片技术: 反碎片机制其实还在伙伴系统之前,它主要是将各个zone区域的物理内存分成可回收reclaimable但不可移动unmovable,可移动movable,不可移动unmovable. 这些标记按照一定得list串联起来管理,当外部条件申请物理内存导致许多碎片的时候,它可以按照这些数据结构的标志,来从新组织归类物理内存,从而减少碎片页或者孤独页。反碎片技术在嵌入式系统当中少用,绝大部分由伙伴系统占据江山了,因此不会对此做具体分析,简略过之。 四. Slab分配机制。

优秀的个人博客,低调大师

iOS FMDB(数据库框架)

FMDB 1. 导包 // 点击项目->General->Linked Frameworks and Libraries->搜索libsqlite3.tbd,并add. #import "FMDB.h" #import <sqlite3.h> @interface ViewController () // 数据库对象 @property (nonatomic, strong) FMDatabase *fmDatabase; @end 2. 打开数据库 // 创建数据库路径 NSString *path = [[NSSearchPathForDirectoriesInDomains(NSDocumentDirectory, NSUserDomainMask, YES) lastObject] stringByAppendingPathComponent:@"data.sqlite"]; // 创建数据库对象 FMDatabase *db = [FMDatabase databaseWithPath:path]; self.fmDatabase = db; // 打开数据库,true,打开成功;false,打开失败 BOOL isSuccess = [db open]; // 判断是否打开成功 if (isSuccess) { NSLog(@"打开数据库成功"); NSLog(@"数据库路径:%@", path); } else { NSLog(@"打开数据库失败"); } 3. 创建表 // 创建表,执行sql语句,增删改相同,查询不一样 NSString *sql = @"create table if not exists test(id integer primary key autoincrement, name text, age integer);"; // 执行创建表命令,true, 创建成功;false,创建失败 BOOL isSuccess = [self.fmDatabase executeUpdate:sql]; if (isSuccess) { NSLog(@"创建表成功"); } else { NSLog(@"创建表失败"); } 4. 插入数据 // 向表中添加100条数据 for (int i = 0; i < 100; i++) { // 名称设置 NSString *name = [NSString stringWithFormat:@"item-%d", i]; // 随机生成20--25岁之间的年龄 NSInteger age = arc4random_uniform(5) + 20; // sql语句拼接 NSString *sql = [NSString stringWithFormat:@"insert into test(name,age) values('%@',%zd);", name, age]; // 执行插入语句 BOOL isSuccess = [self.fmDatabase executeUpdate:sql]; // 判断是否添加成功 if (isSuccess) { NSLog(@"添加成功"); } else { NSLog(@"添加失败"); } } 5. 查询数据 // 查询语句 NSString *sql = @"select name,age from test where age = 23;"; // 执行查询语句 FMResultSet *result = [self.fmDatabase executeQuery:sql]; // 遍历查询结果 while ([result next]) { // name NSString *name = [result stringForColumnIndex:0]; // age NSInteger age = [result intForColumnIndex:1]; NSLog(@"name = %@, age = %ld.", name, age); } 6. 更新数据 // 修改语句 NSString *sql = @"update test set age = 30 where age < 22;"; // 执行sql语句 BOOL isSuccess = [self.fmDatabase executeUpdate:sql]; if (isSuccess) { NSLog(@"修改数据成功"); } else { NSLog(@"修改数据失败"); } 7. 删除数据 // 删除语句 NSString *sql = @"delete from test where age > 25;"; // 执行语句 BOOL isSuccess = [self.fmDatabase executeUpdate:sql]; if (isSuccess) { NSLog(@"删除成功"); } else { NSLog(@"删除失败"); }

优秀的个人博客,低调大师

AliOS Things网络适配框架 - SAL

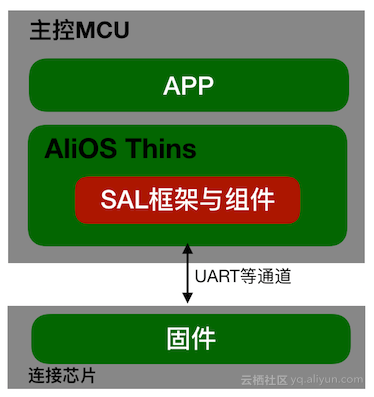
AliOS Things中提供了丰富的SAL开发组件,来加速MCU+通信连接芯片的应用场景开发和部署。在此类应用场景中,主控MCU芯片通过UART或SPI总线与WiFi、NB-IoT等通信芯片相连,AliOS Things操作系统和用户APP运行在主控MCU中,需要网络数据访问时,通过外接的通信芯片进行网络负载的接收和发射。主控MCU和外接通信芯片之间的通信,可以是AT Command通道,也可以是厂商私有协议通道。 AliOS Things SAL方案概述 目前,AliOS Things提供了atparser、at_adapter、SAL等开发组件。借助这些组件,用户可以方便地进行应用开发,同时这些组件也方便厂商在现有MCU产品基础上通过外接通信芯片方式扩展网络访问能力。下图展示了AliOS Things提供的SAL组件和方案架构:

优秀的个人博客,低调大师

android网络框架Retrofit 同步异步

http://blog.csdn.net/jiguangcanhen/article/details/39006197 同步的方式: 1)首先定义要接口。注解Get表示使用的Get请求方式,{user}代表要被替换的数据 public interface GitHubService { @GET("/users/{user}/repos") List<Repo> listRepos(@Path("user") String user); } 2)初始化RestAdapter,并利用动态代理来创建的接口对象。 RestAdapter restAdapter = new RestAdapter.Builder() .setEndpoint("https://api.github.com") .build(); GitHubService service = restAdapter.create(GitHubService.class); 3)使用网络访问并返回 List<Repo> repos = service.listRepos("octocat"); 异步的方式: @POST("/users/new") void createUser(@Body User user, Callback<User> cb); 注:body注解,在进行请求前对象会被转换器进行相应的数据转换。 前两部和之前的相同,不同在于最后一个参数变成了CallBack对象。 controller.getLogin(mail, password,newCallback<UserDataModel>() { @Override publicvoidfailure(RetrofitError error) { //TODOAuto-generated method stub } @Override publicvoidsuccess(UserDataModel ldm, Response response) { //TODOAuto-generated method stub }); 可以看到当请求网络返回之后,会在failure中和success中进行回调,而且默认的数据转换器会把相应的json字符串转换为对象。(当然,我们也可以定义自己的数据转换器) 定义自己的数据转换器: publicclassMyConverterimplementsConverter { @Override publicObject fromBody(TypedInput body, Type type)throwsConversionException { StringBuffer result =newStringBuffer(); try{ InputStream is = body.in(); byte[] buffer =newbyte[1024]; while(is.read(buffer) != -1){ result.append(newString(buffer,"UTF-8")); } }catch(IOException e) { e.printStackTrace(); } returnresult; } @Override publicTypedOutputtoBody(Objectobject) { returnnull; } } 上面的自定义数据转换器,会在请求成功之后,返回给我们字符串,而不是相应的被gson转换过格式的字符串。 RestAdapter restAdapter =newRestAdapter.Builder() .setEndpoint(“url”) .setConverter(newMyConverter()) .build(); 在创建RestAdapter之后创建设置使用自己的数据转换器就可以了。 我们还可以灵活的进行其他的配置: 1)设置请求拦截器,会在请求发出前,进行拦截。 RequestInterceptor requestInterceptor = new RequestInterceptor() { @Override public void intercept(RequestFacade request) { request.addHeader("User-Agent", "Retrofit-Sample-App"); } }; RestAdapter restAdapter = new RestAdapter.Builder() .setEndpoint("https://api.github.com") .setRequestInterceptor(requestInterceptor) .build(); 2)设置错误控制器 class MyErrorHandler implements ErrorHandler { @Override public Throwable handleError(RetrofitError cause) { Response r = cause.getResponse(); if (r != null && r.getStatus() == 401) { return new UnauthorizedException(cause); } return cause; } } RestAdapter restAdapter = new RestAdapter.Builder() .setEndpoint("https://api.github.com") .setErrorHandler(new MyErrorHandler()) .build(); 3)设置log日志。 RestAdapter restAdapter = new RestAdapter.Builder() .setLogLevel(RestAdapter.LogLevel.FULL) .setEndpoint("https://api.github.com") .build(); 上面只是简单介绍了它的使用,其实它还有很多的功能,Get,Post,Put,Delete,Head……具体请参见官方网址。 版权声明:本文为博主原创文章,未经博主允许不得转载。 本文转自wanqi博客园博客,原文链接:http://www.cnblogs.com/wanqieddy/p/4933606.html如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker基本概念和框架

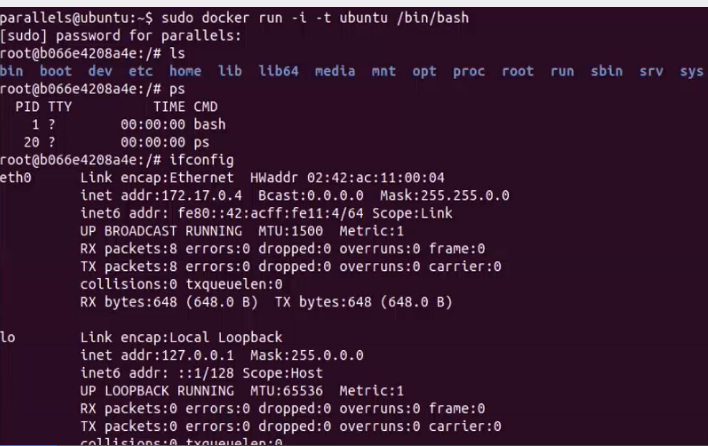
Docker简介 启动Docker容器: 什么是容器? 一种虚拟化的方案 操作系统级别的虚拟化 只能运行相同或相似内核的操作系统 依赖于Linux内核特性:Namespace和Cgroups(Control Group) 容器技术优点: 占用磁盘空间小 资源占用小 对CPU、内存资源消耗小 什么是Docker? 将应用程序自动部署到容器 Go 语言开源引擎 Github地址:https://github.com/docker/docker 2013年初 dotCloud 基于Apache2.0 开源授权协议发行 Docker的目标 提供简单轻量的建模方式 职责的逻辑分离 快速高效的开发生命周期 鼓励使用面向服务的架构 Docker的使用场景 1、使用Docker容器开发、测试、部署服务。 2、创建隔离的运行环境 3、搭建测试环境 4、构建多用的平台即服务(PaaS)基础设施 5、提供软件即服务(SaaS)应用程序 6、高性能、超大规模的宿主机部署 例如: 1、腾讯万台规模的Docker应用实践 Docker的基本组成 docker client客户端 docker daemon守护进程 docker image 镜像 docker container 容器 docker registry 仓库 Docker客户端/守护进程 c/s架构 本地/远程 Docker Image 镜像 容器的基石 层叠的只读文件系统 联合加载(union mount) Docker Container 容器 通过镜像启动 启动和执行阶段 写时复制(copy on write) Docker Registry仓库 公有 私有 docker Hub docker version 查看docker版本 docker search tutorial 查找tutorial镜像 docker pull learn/turorial 从仓库下载镜像到本地 docker run learn/turorial echo ‘ hello word’ docker run learn/turorial apt-get install -y ping 在容器中安装ping命令 docker ps -l 查看容器 docker commit 69822a9948422 learn/ping 将修改的容器提交 docker run learn/ping pingwww.google.com运行镜像 docker ps 查看你当前镜像 docker inspect efefdc74ald5 查看你运行中的容器 docker image 查看镜像 docker push learn/ping 将镜像保持到docker hub仓库上 Docker容器相关技术简介 Docker依赖的Linux内核特性 Namespaces 命名空间 Control groups (cgroups)控制组 Docker源码分析:http://www.infoq.com/cn/articles/docker-source-code-analysis-part1/ 本文转自 yard521 51CTO博客,原文链接:http://blog.51cto.com/tangyade/1905232,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册