首页 文章 精选 留言 我的

精选列表

搜索[项目构建],共10000篇文章
优秀的个人博客,低调大师

如何构建一个flink sql平台

我们都知道,离线计算有Hive,使用过的知道,需要先定义一个schema,比如针对HDFS这种存储对标mysql定义一个schema,schema的本质是什么?主要描述下面这些信息 1)当前存储的物理位置的描述 2)数据格式的组成形式 然后Hive可以让用户定义一段sql,针对上面定义的schema进行,sql的本质是什么,是业务逻辑的描述。然后Hive内部会将这段sql进行编译转化为原生的底层MapReduce操作,通过这种方式,屏蔽底层技术原理,让业务开发人员集中精力在schema和sql业务逻辑上,flink sql平台也正是做同样的事情。 一开始经过跟上海同事的讨论,选择Uber的Athenax作为技术选型,通过翻阅源码,发现还是有很多不完善的地方,比如配置文件采用yaml,如果做多集群调度,平台代码优化,多存储扩展机制,都没有考虑得很清楚,所以代码拿过来之后基本上可以说按照对yarn和flink的理解重新写了一遍。 大致的工作流程如图所示: 简单解释一下: 1)业务定义job 2)提交到web服务器,存到mysql中 3)------------------- 4)-------------------- 5)flink平台进程定时扫描mysql,探测到job定义,并从yarn集群获取当前运行状态的job的report 比较时间戳,决定哪些任务要杀死,启动 6)flink提交到yarn集群的任务,yarn会从hdfs拉取job描述里的jar包,启动这个flink job 然后步骤3,4,5,6 重复执行 下面是平台代码的思路 1)通过springboot提供HTTP API,提供多集群定义,存储在mysql里 一个集群需要定义的信息点如下: 2)提供HTTP API让业务进行Job定义 这里的Job定义包含3个方面:job的输出输出的schema定义,job的业务逻辑定义(sql),job需要的yarn资源定义,具体来说如下所示: Job定义 文中的sql定义 SELECT SUM(nested.number) as nestedNumber, hundredFunction(SUM(CAST(`value` AS DOUBLE))) as `sum`, COUNT(`value`) as `count`, AVG(CAST(`value` AS DOUBLE)) as `avg`, MAX(CAST(`value` AS DOUBLE)) as `max`, MIN(CAST(`value` AS DOUBLE)) as `min`, TUMBLE_END(`time`, INTERVAL '3' SECOND) as `time` FROM input.`ymm-appmetric-dev-self1` WHERE metric IS NOT NULL AND `value` IS NOT NULL and `time` IS NOT NULL GROUP BY metric,TUMBLE(`time`, INTERVAL '3' SECOND) 输入/输出schema定义,以kafka为例,输入和输出格式差不多 { "brokerAddress":"略", "topic":"dev-metric", "schemas":[ {"key":"sum","type":"double"}, {"key":"count","type":"int"}, {"key":"avg","type":"double"}, {"key":"max","type":"double"}, {"key":"min","type":"double"}, {"key":"time","type":"timestamp"}, {"key":"nestedNumber","type":"int"} ] } 对于业务来说,“打开IDE->了解flink语法写java代码->打包成jar->提交到yarn集群”这一环节省去了,直接打开界面,点击按钮定义sql,写一段业务逻辑sql,提交此业务到mysql,关闭浏览器即可.由平台进行调度(秒级),永远不用担心这个任务某一天挂了怎么办,平台会自动发现自动拉起.提交一次永远不需要再人工干预,除非逻辑发生变化,在逻辑发生变化时也简单,打开任务修改再提交,关闭浏览器,结束,平台会发现job变化杀死老任务拉起新任务. 下面讲一下平台内部是如何实现的 3)集群自动发现 如果平台维护方想增加一个集群,通过界面直接定义一个存在mysql即可,后台线程会自动发现,为每个集群创建一个线程,多节点情况下,整个环境中某个特定集群的多个线程通过ZK进行抢占决定哪个线程当前为这个集群服务. 增加JVM关闭钩子,在JVM退出时,主动关闭ZK客户端,释放ZK上的临时节点. 4)UDF的支持&自动发现 错误做法: 平台支持平台级UDF的定义,由平台人员进行维护,平台人员编写脚本,通过base64编码存在mysql里,归属到某个集群,这个集群的扫描线程发现有必要进行编译时,实时编译成class常驻内存,同时,打包成jar包上传到远程HDFS,后面会将此路径放入到具体job的classpath路径下. job就可以正确发现UDF. 当UDF没有发生变化时,线程不会编译,而是复用上一次的编译结果. 正确做法: 后来发现这种做法是愚蠢的,算是踩了坑吧,后来改成jar包上传的方式了!!! 5)程序可以任意部署,不依赖大数据环境 程序本身不依赖大数据环境的配置,具体是指不需要依赖当前宿主机.../etc/hadoop/*.xml文件 通过读取cluster的配置,动态生成XML配置,再生成HDFS/YARN的客户端client,这样,平台代码可以任意部署到物理机/容器中,只要环境可以通过TCP连接到对应域名/ip即可. 6)如何做任务调度-任务的自动发现 这里的任务调度是指:哪些任务需要下线,哪些任务需要第一次上线,哪些任务需要重新上线, 这里的业务逻辑就是比较mysql里job的时间戳和yarn集群里任务的时间戳 yarn集群里任务的时间戳是通过提交时打上Tag标记,就是为了下一次比较用。 这里有一个细节,就是Athenax的做法是先算出所有要杀死的任务,杀死,再拉起所有要拉起的任务,个人认为这里不妥,优化之后的做法是:按照任务级别,算出(killaction,startaction),对于单个job来说,二者至少存在1个action,然后以任务为级别进行调度,不再是之前的大一统提交方式,这样就算单个任务调度异常,也不影响其它任务,做到了任务之间做隔离. 通过时间戳的方式,就不难理解业务一旦修改任务,平台发现时间戳有变化,就可以自动杀死老任务,拉起新任务,不需要人工操作. 7)拉起任务中的编译工作 一个job需要拉起时,会实时结合(输入schema,SQL业务逻辑,输出schema)进行编译, 正如hive会翻译成原生的mapreduce操作,flink sql编译工作会翻译成原生的flink jobgraph 这部分是抽取了athenax里的编译工作做2开 代码如下: privateJobCompilerResultcompile(Mapinputs,StringoriginSql, ExternalCatalogoutput,ResourceDTOresourceDTO, ClusterDTOathenaxCluster, ConfigurationflinkConf)throwsException{ //解析sql LoggerUtil.info("tobecompiledsql:[{}]",originSql); SqlNodeListstmts=(SqlNodeList)newCalciteSqlParser().parse(originSql); Validatorvalidator=newValidator(); validator.validateQuery(stmts); HashMapudfMap=validator.getUserDefinedFunctions(); StringselectSql=validator.getStatement().toString(); ListadditionalResources=validator.getAdditionalResources(); LoggerUtil.info("succeedtoparsesql,resultis:[{}]",stmts); LoggerUtil.info("udf{}",udfMap); LoggerUtil.info("statement{}",selectSql); LoggerUtil.info("additionalResources{}",additionalResources); //准备编译,输出Flink的JobGraph LoggerUtil.info("begintocreateexecutionenvironment"); StreamExecutionEnvironmentlocalExecEnv=StreamExecutionEnvironment .createLocalEnvironment(); //非常重要 setFeature(localExecEnv, resourceDTO.getTaskManagerCount()*resourceDTO.getSlotPerTaskManager(),flinkConf); StreamTableEnvironmenttableEnv=StreamTableEnvironment.getTableEnvironment(localExecEnv); LoggerUtil.info("tableEnv:{}",tableEnv); //注册UDF,收归到平台了,也就是说,只支持平台开发人员预定义,暂时不支持业务自定义 for(Map.Entrye:udfMap.entrySet()){ finalStringname=e.getKey(); StringclazzName=e.getValue(); LoggerUtil.info("usedudfspecifiedbybusiness:{}",name); } registerSDF(athenaxCluster,tableEnv); LoggerUtil.info("alludfregisterd,bingo"); //开始注册所有的input相关的schema for(Map.Entrye:inputs.entrySet()){ LoggerUtil.info("Registeringinputcatalog{}",e.getKey()); tableEnv.registerExternalCatalog(e.getKey(),e.getValue()); } LoggerUtil.info("allinputcatalogregisterd,bingo"); Tabletable=tableEnv.sqlQuery(selectSql); LoggerUtil.info("succeedtoexecutetableEnv.sqlQuery(...)"); LoggerUtil.info("table{}",table); LoggerUtil.info("bingo!inputworkdonecompletely,letushandleoutputworknow!!!"); //开始注册output ListoutputTables=output.listTables(); for(Stringt:outputTables){ table.writeToSink(getOutputTable(output.getTable(t))); } LoggerUtil.info("handleoutputok"); //生成JobGraph StreamGraphstreamGraph=localExecEnv.getStreamGraph(); JobGraphjobGraph=streamGraph.getJobGraph(); //thisisrequiredbecausetheslotsareallocatedlazily //如果为true就会报错,然后flink内部就是一直重启,所以设置为false jobGraph.setAllowQueuedScheduling(false); LoggerUtil.info("createflinkjobok{}",jobGraph); JobGraphTool.analyze(jobGraph); //生成返回结果 JobCompilerResultjobCompilerResult=newJobCompilerResult(); jobCompilerResult.setJobGraph(jobGraph); ArrayListpaths=newArrayList(); Collectionvalues=udfMap.values(); for(Stringvalue:values){ paths.add(value); } jobCompilerResult.setAdditionalJars(paths); returnjobCompilerResult; } 这部分工作要理解,需要对Calcite有基础 8)多存储的支持 平台在一开始编写的时候,就考虑到了多存储支持,虽然很多任务是从kafka->计算->Kafka 但是平台并不只满足于这一点,因为写到kafka之后,可能还需要业务再去维护一段代码取读取kafka的消息进行消费,如果有的业务希望直接能把结果写到mysql,这个时候就是需要对多存储进行扩展 通过设计和扩展机制,平台开发人员只需要定义储存相关的类,针对schema定义的解析工作已经再父类中完成,所有存储类共用,这样可以灵活支持多存储,平台开发人员只需要把重点放在特定存储性质的支撑即可. PS:编写此类存储类需要对fink job内部的运行机制,否则会造成资源泄露和浪费. 平台内部已经针对每种类型进行了定义 //存储类型 //排名不分先后 publicstaticintSTORAGE_REDIS=1<<0;//1 publicstaticintSTORAGE_MYSQL=1<<1;//2 publicstaticintSTORAGE_ROCKETMQ=1<<2;//4 publicstaticintSTORAGE_KAFKA=1<<3;//8 publicstaticintSTORAGE_PULSAR=1<<4;//16 publicstaticintSTORAGE_OTHER0=1<<5;//32 publicstaticintSTORAGE_OTHER1=1<<6;//64 publicstaticintSTORAGE_OTHER2=1<<7;//128 publicstaticintSTORAGE_RABBITMQ=1<<8;//256 publicstaticintSTORAGE_HBASE=1<<9;//512 publicstaticintSTORAGE_ES=1<<10;//1024 publicstaticintSTORAGE_HDFS=1<<11;//2048 目前支持的情况如下: 输入:Kafka 输出:Kafka/Mysql PS:输出mysql是基于flink官方的提供类实现的第一版,经过分析源码,mysql sink官方这部分代码写得太随意,差评. 后续当业务有需求时,需要结合zebra做2次开发.毕竟运维不会提供生产环境的ip和端口等信息,只会提供一个数据源字符串标识.这样更贴合公司内部的运行环境 9)任务提交 一旦生成flink原生的job,就可以准备提交工作 这部分需要对yarn的运行机制比较清楚,比如任务提交到RM上经过哪些状态变化,ApplicationMaster如何申请资源启动TaskManager, 具体的job是如何提交给JobManager的,平台开发人员需要对此有基本的原理掌握,当初也是0基础开始学习,通过快速翻阅源代码掌握一些运行机制,方可安心进行平台开发. 10)其它优化 针对yarn client的参数优化,保证可在一定时间内返回,否则可能一直卡死 针对flink job的平台级优化,比如禁止缓存,让信息立刻传输到下一个环节(默认100毫秒延迟) 定义flink job的重启次数,当发生异常时可自行恢复等 11)压测结果 输入:本地启动7个线程,发送速度 每秒发送到kafka 十几万条 接收topic描述 ymm-appmetric-dev-self1 开发环境 partitions 6 replication 1 flink任务描述 2个TaskManager进程 每个进程800M内存 每个进程3个线程, 并行度 2*3=6 flink计算任务所用sql SELECT SUM(nested.number) as nestedNumber, hundredFunction(SUM(CAST(`value` AS DOUBLE))) as `sum`, COUNT(`value`) as `count`, AVG(CAST(`value` AS DOUBLE)) as `avg`, MAX(CAST(`value` AS DOUBLE)) as `max`, MIN(CAST(`value` AS DOUBLE)) as `min`, TUMBLE_END(`time`, INTERVAL '3' SECOND) as `time` FROM input.`ymm-appmetric-dev-self1` WHERE metric IS NOT NULL AND `value` IS NOT NULL and `time` IS NOT NULL GROUP BY metric, TUMBLE(`time`, INTERVAL '3' SECOND) 输出topic ymm-appmetric-dev-result partitions 3 观察flink consumer端的消费速度 每个线程的消费速度在24000上下浮动,并发度6,每秒可消费kafka消息14万+,应该说目前不会碰到性能瓶颈. 其它 本次测试发送数据条数:4.3 亿条 耗时:56分钟 对于业务开发人员来说,我觉得好处就是 1)不需要懂flink语法(你真的想知道flink的玩法?好吧我承认你很好学) 2)不需要打开IDE写java代码(你真的想写Java代码?好吧我承认你对Java是真爱) 3)提交一次,不再需要人工介入(你真的想在假期/晚上/过节/过年 担心任务挂掉?好吧我承认你很敬业) 只需要 1)界面点击操作,定义你的schema 2)写一段你所擅长的sql 3)点击提交按钮 4)关闭浏览器 5)关闭电脑 其它的就交给平台吧! 后续:针对平台来说,后续的主要工作是根据业务需求扩展多存储 如果再长远,那就是要深度阅读flink源码对平台进行二次优化

优秀的个人博客,低调大师

centos7之Java开发环境构建

CensOS7环境 我个人的博客环境如下: 希望这个教程可以帮助到linux新手朋友们或者其他在安装软件时遇到问题的朋友们 当然了,百度上也有很多类似这样的教程,我个人贴出来,一来为分享,二来以后自己用到时,上手就有,不必担心为此耗费比较长的时间。 该教程是我个人使用xmind写的,只是通过导出工具导出为html,才会显示如下,不过导出的显示信息,不会影响正常阅读。 本人亲自实践过,有任何问题可以留言 Java开发基本环境 1.jdk的安装 rpm安装 获取rpm安装包 wget --no-check-certificate --no-cookies --header "Cookie: oraclelicense=accept-securebackup-cookie" http://download.oracle.com/otn-pub/java/jdk/8u131-b11/d54c1d3a095b4ff2b6607d096fa80163/jdk-8u131-linux-x64.rpm jdk官网:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 安装rpm rpm -ivh jdk-8u131-linux-x64.rpm java -version 显示对应的Java版本信息 2.tomcat安装 首先在浏览器输入tomcat,进入tomcat官网 https://tomcat.apache.org/ 选择对应的版本,将链接复制下来,然后再Linux上执行wget命令进行下载 wget http://mirrors.hust.edu.cn/apache/tomcat/tomcat-8/v8.0.52/bin/apache-tomcat-8.0.52.tar.gz 解压tomcat tar -xzvf apache-tomcat-8.0.52.tar.gz 3.mysql安装 获得tar包 wget http://dev.mysql.com/get/Downloads/MySQL-5.7/mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 解压tar包 tar -xvf mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 安装(存在依赖关系,依次安装) rpm -ivh mysql-community-common-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-libs-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-client-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-server-5.7.16-1.el7.x86_64.rpm 在安装这个的时候可能会报错,通过这个方法可以解决 获取相关依赖包并安装 下载 wget http://mirror.centos.org/centos/6/os/x86_64/Packages/libaio-0.3.107-10.el6.x86_64.rpm 安装 rpm -ivh libaio-0.3.107-10.el6.x86_64.rpm yum安装相关包 yum install net-tools 数据库初始化 mysqld --initialize --user=mysql 获得随机密码 cat /var/log/mysqld.log 启动数据库 systemctl start mysqld.service 进入mysql mysql -uroot -p 修改密码 ALTER USER 'root'@'localhost' IDENTIFIED BY 'new_password'; 4. maven安装 安装命令 yum install maven 安装成功 mvn -v 显示对应的版本信息 5.git安装 安装命令 yum install git 6.nginx安装 准备相关的依赖库 yum install gcc gcc-c++ autoconf automake yun -y install zlib zlib-devel openssl openssl-devel pcre pcre-devel wget http://downloads.sourceforge.net/project/pcre/pcre/8.35/pcre-8.35.tar.gz 解压 tar-xzvf pcre-8.35.tar.gz ./configure make && make install 编译安装 获取安装包 wget http://nginx.org/download/nginx-1.6.2.tar.gz 解压该包 tar xzvf nginx-1.6.2.tar.gz /configure --prefix=/usr/local/nginx --with-http_stub_status_module --with-http_ssl_module --with-pcre=/home/yc/pcre-8.35

优秀的个人博客,低调大师

Docker 构建自己的容器(学习笔记二)

Dockerfile --------------------------------------------------------------------------------------------------------------------- 首先需要的包和dockerfile放在一起 [root@localhost docker-file]# ls Dockerfile nginx-1.9.3.tar.gz pcre-8.37.tar.gz [root@localhost docker-file]# pwd /opt/docker-file [root@localhost docker-file]# --------------------------------------------------------------------------------------------------------------------- 创建dockerfile [root@localhost docker-file]# vim Dockerfile #base images,name or id 可以是镜像名字或者镜像ID FROM 3bee3060bfc8 #maintainer 作者 MAINTAINER wangzz #add 把包添加到容器的指定目录,如果是tar包会自动解压 ADD pcre-8.37.tar.gz /usr/local/src ADD nginx-1.9.3.tar.gz /usr/local/src #run 在容器里运行命令安装nginx需要软件 RUN yum install -y wget gcc gcc-c++ make openssl-devel #run 在容器里运行命令创建用户 RUN useradd -s /sbin/nologin -M www #workdir 相当于cd到这个目录 WORKDIR /usr/local/src/nginx-1.9.3 #run 在容器里运行命令进行编译安装 RUN ./configure --prefix=/usr/local/nginx --user=www --group=www --with-http_ssl_module --with-http_stub_status_module --with-pcre=/usr/local/src/pcre-8.37 && make && make install #run 在容器里运行命令更改nginx配置文件,使其前台运行 RUN echo "daemon off;" >> /usr/local/nginx/conf/nginx.conf #env 将nginx启动命令加到环境变量里 ENV PATH /usr/local/nginx/sbin:$PATH #映射80端口 EXPOSE 80 执行nginx命令 CMD ["nginx"] --------------------------------------------------------------------------------------------------------------------- 执行dockerfile [root@localhost docker-file]# docker build -t my-nginx-1:v1 /opt/docker-file/ 当成功后会出现这个,说明执行成功 Successfully built 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看镜像 [root@localhost docker-file]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE my-nginx-1 v1 21273b8e163a 14 minutes ago 429.1 MB --------------------------------------------------------------------------------------------------------------------- 使用创建好的镜像启动容器 [root@localhost docker-file]# docker run -dit --name mynginx 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看运行的容器 [root@localhost docker-file]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES aa30accbfc06 21273b8e163a "nginx" 3 seconds ago Up 2 seconds 80/tcp mynginx --------------------------------------------------------------------------------------------------------------------- 访问这个容器的80端口,看nginx是否安装启动成功 [root@localhost docker-file]# curl 172.17.0.3 Welcome to nginx! body { width: 35em; margin: 0 auto; font-family: Tahoma, Verdana, Arial, sans-serif; } Welcome to nginx! If you see this page, the nginx web server is successfully installed and working. Further configuration is required. For online documentation and support please refer to nginx.org. Commercial support is available at nginx.com. Thank you for using nginx.

优秀的个人博客,低调大师

docker私有仓库构建,上传,下载 push,pull

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80415332 1、下载私有仓库镜像 docker pull registry docker registry 启动 docker run -d -p 5001:5000 registry 默认端口5000我虚拟机占用5000所以改5001 上传 docker push localhost:5001/test/es:v1 另一台机器下载 docker pulldocker pull 47.106.154.105:5001/test/e:v1 ip为机器1公网ip 后面仓库位置要一样 docker pull 报错:Get https://registry:5000/v1/_ping: http: server gave HTTP response to HTTPS client 下载成功

优秀的个人博客,低调大师

新华三助力公安构建新IT“警盾”

8月24日,在中国公安部指导下,人民公安报社携手公安部科信局领导、各省市公安系统科信部相关领导、云计算及大数据行业专家、产业链合作伙伴等,在浙江海宁召开了2017公安行业云计算与大数据研讨会,共同探讨云计算、大数据技术与公安业务的结合与应用,交流具有代表性、典型性的经验和做法,推进大数据时代公安科技信息化工作。 本次研讨会将国各地的公安行业科信部负责人与国内优秀IT厂商聚集在一起,重点探讨了公安行业安全云面对的主要问题及解决方案,以及如何借力大数据和“互联网+”,通过基础信息化推进警务实战化。 新华三作为全球新IT解决方案领导者受邀参加本次研讨会,并在会上分析了目前我国公安大数据平台中存在的一些问题,解读了这些问题的解决方案。 在新华三看来,目前我国的公安大数据平台技术架构可以考虑进一步向多元化发展,针对业务需求不断提升性能以及架构的可扩展性,这些将有利于进行开源管理和维护。在现有平台的基础上,可以考虑引入更多新的技术和业务模型,从而挖掘数据价值并简化应用方面的开发过程。 针对这些问题,新华三提供了一整套公安大数据平台的技术架构,通过融合现有的技术架构,实现大数据平台的自动化统一管理维护,集成丰富的分析工具,方便了后期的应用开发。 据新华三庞松介绍,目前新华三自主研发的公安行业大数据平台,已经在西藏公安等地方落地运营,均取得了非常卓越的效果,为全国其他公安行业提供了可借鉴优秀模板。 未来的新华三,将继续利用自身在云计算及大数据行业的领先技术,为全国的公安行业用户提供切实可行的解决方案,进一步推动我国公安行业的信息化建设,为整个社会治安建设贡献自己的力量。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

基于TableStore构建简易海量Topic消息队列

前言 消息队列,通常有两种场景,一种是发布者订阅模式,一种是生产者消费者模式。发布者订阅模式,即发布者生产消息放入队列,多个监听的消费者都会收到同一份消息,也就是每个消费者收到的消息是一样的。生产者消费者模式,生产者生产消息放入队列,多个消费者同时监听队列,谁先抢到消息就会从队列中取走消息,最终每个消息只会有一个消费者拥有。 在大数据时代,传统的生产者消费者队列模式中的Topic数目可能从少量的几个变为海量topic。例如要实现一个全网爬虫抓取任务调度系统,每个大型的门户,SNS都会成为一个topic。在topic内部也会有海量的子网页需要抓取。在实现这样的一个任务分发调度系统时可能会遇到以下一些问题: 海量的topic,意味着我们可能会有海量的队列。针对爬虫场景,根据网页类型,一类网站对应到一个任务队列,不同的任务队列会有自己的生产者

优秀的个人博客,低调大师

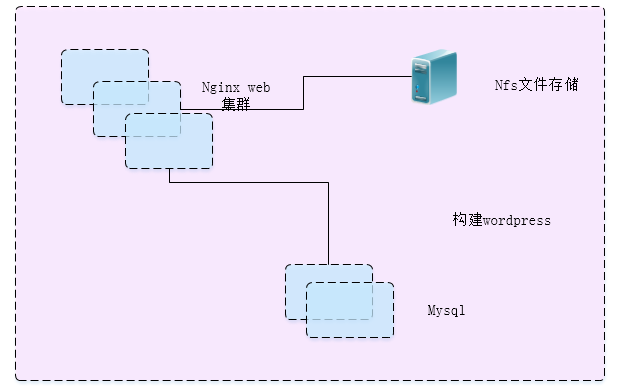
构建基于LAMP架构的论坛和博客

[root@server27 ~]# yum install httpd [root@server27 ~]# yum install mod_php [root@server27 ~]# yum install mysql mysql-server //**监听3306端口 [root@server27 ~]# yum install php-mysql //** php和mysql的连接器,支持php访问mysql 重启httpd服务 在index.php页面内写一个测试脚本测试一下,看php能否访问mysql: <h1>this is a.com</h1> <?php $link=mysql_connect('127.0.0.1','root',''); if ($link) echo "Success..."; else echo "Failure..."; ?> phpadmin //**基于Web界面管理mysql的工具 安装php常用一些的组件: [root@station39 ~]# yum install php-mbstring php-xml php-gd php-pear php-devel 或者 yum install php* [root@station39 ~]# service httpd restart 安装phpadmin, phpMyAdmin-2.11.11.1-all-languages.tar.bz2,安装包已经准备好了。 [root@station39 www]# mkdir phpmyadmin [root@station39 www]#tar xvf phpMyAdmin-2.11.11.1-all-languages.tar.bz2 [root@station39 ~]# cd phpMyAdmin-2.11.11.1-all-languages [root@station39 phpMyAdmin-2.11.11.1-all-languages]# mv * /var/www/phpmyadmin/ [root@station39 www]# vim /etc/httpd/conf/httpd.con 修改httpd.conf 文件,给/var/www/phpadmin 做一路径别名: <VirtualHost 192.168.0.39:80> DocumentRoot "/var/www/a" ServerName www.a.com Alias /phpadmin "/var/www/phpadmin" </VirtualHost> 重启服务,已经可以通过页面来访问mysql了。 [root@station39 ~]# mysqladmin -uroot -p password '123456' //*为mysql设置用户名密码 此时再刷新页面,已经禁止你直接访问mysql了。 这里我们需要修改phpmyadmin 的配置文件来支持使用用户名密码来访问mysql [root@station39 phpmyadmin]# cp config.sample.inc.php config.inc.php [root@station39 phpmyadmin]# vim config.inc.php $cfg['blowfish_secret'] = 'redhat'; /* YOU MUST FILL IN THIS FOR COOKIE AUTH! */ line 17 看,已经可以使用用户名密码来登录了: 问题: 缺少php-mcrypt模块,需要安装。 搜索rpm包:www.rpmfind.net 所需要的两个包已经准备好了,使用rpm安装即可。 libmcrypt-2.5.7-5.el5.i386.rpm php-mcrypt-5.1.6-5.el5.i386.rpm [root@station39 ~]# rpm -ivh libmcrypt-2.5.7-5.el5.i386.rpm [root@station39 ~]# rpm -ivh php-mcrypt-5.1.6-5.el5.i386.rpm 或者使用yum本地安装 [root@station39 ~]# yum --nogpgcheck localhost install libmcrypt-2.5.7-5.el5.i386.rpm php-mcrypt-5.1.6-5.el5.i386.rpm -y //** 能够自动解决依赖关系 再登录就可以了。 上面我们是通过做别名的方式来访问phpmyadmin的,下面我们来添加一个虚拟主机,通过主机名来访问phpmyadmin。 <VirtualHost 192.168.0.39:80> DocumentRoot "/var/www/phpmyadmin" ServerName pma.a.com ErrorLog /var/log/httpd/pma.a.com-err CustomLog /var/log/httpd/pma.a.com-access combined <Directory "/var/www/phpmyadmin"> Options Indexes AllowOverride None Order allow,deny allow from all </Directory> </VirtualHost> 重启服务,已经可以通过主机名pma.a.com 来访问mysql了。 PS:如果在物理机上访问,需要在C:\WINDOWS\system32\drivers\etc下的host文件中添加主机名和IP地址映射,不然系统无法通过主机名访问到你的Web页面。 OK, LAMP环境已经搭建完成,下面我们就可以来安装论坛和博客系统了。 开源界比较著名的PHP格式的论坛:phpwind(阿里巴巴收购) discuz(QQ收购) 国外比较著名的论坛:phpbb 博客系统:Wordpress xoops 框架 先安装phpwind: 建虚拟主机: <VirtualHost 192.168.0.39:80> DocumentRoot "/var/www/phpwind" ServerName pw.a.com ErrorLog /var/log/httpd/pw.a.com-err CustomLog /var/log/httpd/pw.a.com-access combined <Directory "/var/www/phpwind"> Options None AllowOverride None Order allow,deny allow from all </Directory> </VirtualHost> 保存退出。 [root@station39 ~]# cd /var/www phpwind_GBK_8.3.zip 已经准备好了,下面就开始解压缩安装了。 [root@station39 www]# unzip phpwind_GBK_8.3.zip [root@station39 www]# mv phpwind_GBK_8.3 phpwind [root@station39 phpwind]# rm -rf docs/ [root@station39 phpwind]# mv upload/* ./ 重启httpd服务,这时候就可以通过web访问到phpwind了,但此时你会发现页面出现乱码,把浏览器的字符编码设置为gb312就可以了。 PS:或者修改httpd的主配置文件,将741行 AddDefaultCharset UTF-8注释掉就可以了。 [root@station39 phpwind]# chmod 777 attachment/ -R [root@station39 phpwind]# chmod 777 html/ data/ -R 删除install.php 文件: [root@station39 phpwind]# mv install.php install.php.bak 再访问下,OK!已经可以了,这时候你就可以登录后台进行管理了。 下面我们来安装wordpress。 压缩包已经准备好了,/var/www/目录下: wordpress-3.0.4-zh_CN.zip 在httpd主配置文件里建虚拟主机: <VirtualHost 192.168.0.39:80> DocumentRoot "/var/www/wordpress" ServerName wp.a.com ErrorLog /var/log/httpd/wp.a.com-err CustomLog /var/log/httpd/wp.a.com-access combined <Directory "/var/www/wordpress"> Options None AllowOverride None Order allow,deny allow from all </Directory> </VirtualHost> 保存退出。 [root@station39 www]# unzip wordpress-3.0.4-zh_CN.zip 重启httpd服务就可以了。 给当前目录写权限 [root@station39 wordpress]# chmod a+x . 此时会自动在worpress目录下创建wp-config.php 文件。 安装完毕,这就是个人管理的界面: OK!此时就可以对你的博客进行个性化设置了。 本文转自 490999122 51CTO博客,原文链接:http://blog.51cto.com/lyp0909/514919,如需转载请自行联系原作者

优秀的个人博客,低调大师

构建MySQL+DRBD+Keepalived高性能架构

前言*DRBD(DistributedReplicatedBlockDevice)是一个基于块设备级别在远程服务器直接同步和镜像数据的开源软件,类似于RAID1数据镜像,通常配合keepalived、heartbeat等HA软件来实现高可用性。这里简单记录仅供参考。 一、实施环境 1 2 3 4 5 系统版本:CentOS 5.8 DRBD版本:drbd- 8.3 . 15 Keepalived:keepalived- 1.1 . 15 Master: 192.168 . 149.128 Backup: 192.168 . 149.129 二、初始化配置 1) 在128、129两台服务器/etc/hosts里面都添加如下配置: 1 2 192.168 . 149.128 node1 192.168 . 149.129 node2 2) 优化系统kernel参数,直接上sysctl.conf配置如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 net.ipv4.ip_forward= 0 net.ipv4.conf. default .rp_filter= 1 net.ipv4.conf. default .accept_source_route= 0 kernel.sysrq= 0 kernel.core_uses_pid= 1 net.ipv4.tcp_syncookies= 1 kernel.msgmnb= 65536 kernel.msgmax= 65536 kernel.shmmax= 68719476736 kernel.shmall= 4294967296 net.ipv4.tcp_max_tw_buckets= 10000 net.ipv4.tcp_sack= 1 net.ipv4.tcp_window_scaling= 1 net.ipv4.tcp_rmem= 4096 87380 4194304 net.ipv4.tcp_wmem= 4096 16384 4194304 net.core.wmem_default= 8388608 net.core.rmem_default= 8388608 net.core.rmem_max= 16777216 net.core.wmem_max= 16777216 net.core.netdev_max_backlog= 262144 net.core.somaxconn= 262144 net.ipv4.tcp_max_orphans= 3276800 net.ipv4.tcp_max_syn_backlog= 262144 net.ipv4.tcp_timestamps= 0 net.ipv4.tcp_synack_retries= 1 net.ipv4.tcp_syn_retries= 1 net.ipv4.tcp_tw_recycle= 1 net.ipv4.tcp_tw_reuse= 1 net.ipv4.tcp_mem= 94500000 915000000 927000000 net.ipv4.tcp_fin_timeout= 1 net.ipv4.tcp_keepalive_time= 30 net.ipv4.ip_local_port_range= 1024 65530 net.ipv4.icmp_echo_ignore_all= 1 3) 两台服务器分别添加一块设备,用于DRBD主设备存储,我这里为/dev/sdb 30G硬盘; 执行如下命令: 1 mkfs.ext3/dev/sdb;dd if =/dev/zeroof=/dev/sdbbs=1Mcount= 1 ;sync 三、DRBD安装配置 1 yum-yinstalldrbd83*kmod-drbd83;modprobedrbd 安装完成并加载drbd模块后,vi修改/etc/drbd.conf配置文件,本文内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 global{ usage-countyes; } common{ syncer{rate100M;} } resourcer0{ protocolC; startup{ } disk{ on-io-errordetach; #size1G; } net{ } onnode1{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.128 : 7898 ; meta-disk internal ; } onnode2{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.129 : 7898 ; meta-disk internal ; } } 配置修改完毕后执行如下命令初始化: 1 drbdadmcreate-mdr0;/etc/init.d/drbdrestart;/etc/init.d/status 如下图: 以上步骤,需要在两台服务器都执行,两台都配置完毕后,在node2从上面执行如下命令:/etc/init.d/drbd status 看到如下信息,表示目前两台都为从,我们需要设置node1为master,命令如下: 1 2 3 drbdadm----overwrite-data-of-peerprimaryall mkfs.ext3/dev/drbd0 mkdir/app;mount/dev/drbd0/app 自此,DRBD配置完毕,我们可以往/app目录写入任何东西,当master出现宕机或者其他故障,手动切换到backup,数据没有任何丢失,相当于两台服务器做网络RAID1。 四、Keepalived配置 1 2 3 wgethttp: //www.keepalived.org/software/keepalived-1.1.15.tar.gz;tar-xzvfkeepalived-1.1.15.tar.gz;cdkeepalived-1.1.15;./configure;make;makeinstall DIR=/usr/local/;cp$DIR/etc/rc.d/init.d/keepalived/etc/rc.d/init.d/;cp$DIR/etc/sysconfig/keepalived/etc/sysconfig/; mkdir-p/etc/keepalived;cp$DIR/sbin/keepalived/usr/sbin/ 两台服务器均安装keepalived,并进行配置,首先在node1(master)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_scriptcheck_mysql{ script "/data/sh/check_mysql.sh" interval 5 } vrrp_instanceVI_1{ stateMASTER interface eth0 virtual_router_id 52 priority 100 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } track_script{ check_mysql } } 然后创建check_mysql.sh检测脚本,内容如下: 1 2 3 4 5 6 7 8 #!/bin/sh A=`ps-Cmysqld--no-header|wc-l` if [$A-eq 0 ];then /bin/umount/app/ drbdadmsecondaryr0 killallkeepalived fi 添加node2(backup)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_sync_groupVI{ group{ VI_1 } notify_master/data/sh/master.sh notify_backup/data/sh/backup.sh } vrrp_instanceVI_1{ stateBACKUP interface eth0 virtual_router_id 52 priority 90 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } } 创建master.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash drbdadmprimaryr0 /bin/mount/dev/drbd0/app/ /etc/init.d/mysqldstart 创建backup.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash /etc/init.d/mysqldstop /bin/umount/dev/drbd0 drbdadmsecondaryr0 发生脑裂恢复步骤如下: 1 2 3 4 5 Master执行命令: drbdadmsecondaryr0 drbdadm----discard-my-dataconnectr0 Backup上执行命令: drbdadmconnectr0 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1408056

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册