【总结】Spark优化(1)-多Job并发执行
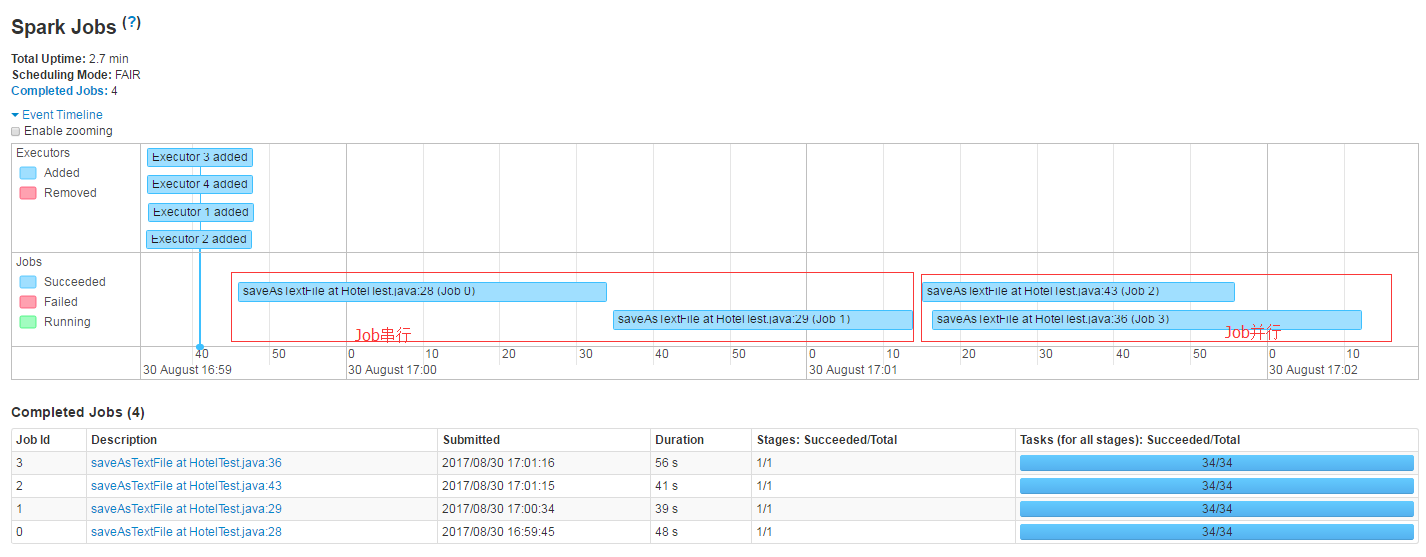
Spark程序中一个Job的触发是通过一个Action算子,比如count(), saveAsTextFile()等 在这次Spark优化测试中,从Hive中读取数据,将其另外保存四份,其中两个Job采用串行方式,另外两个Job采用并行方式。将任务提交到Yarn中执行。能够明显看出串行与兵线处理的性能。 每个Job执行时间: JobID 开始时间 结束时间 耗时 Job 0 16:59:45 17:00:34 49s Job 1 17:00:34 17:01:13 39s Job 2 17:01:15 17:01:55 40s Job 3 17:01:16 17:02:12 56s 四个Job都是自执行相同操作,Job0,Job1一组采用串行方式,Job2,Job3采用并行方式。 Job0,Job1串行方式耗时等于两个Job耗时之和 49s+39s=88s Job2,Job3并行方式耗时等于最先开始和最后结束时间只差17:02:12-17:01:15=57s 代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 package com.cn.ctripotb; import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.sql.DataFrame; import org.apache.spark.sql.hive.HiveContext; import java.util.*; import java.util.concurrent.Callable; import java.util.concurrent.Executors; /** *CreatedbyAdministratoron2016/9/12. */ public class HotelTest{ static ResourceBundlerb=ResourceBundle.getBundle( "filepath" ); public static void main(String[]args){ SparkConfconf= new SparkConf() .setAppName( "MultiJobWithThread" ) .set( "spark.serializer" , "org.apache.spark.serializer.KryoSerializer" ); JavaSparkContextsc= new JavaSparkContext(conf); HiveContexthiveContext= new HiveContext(sc.sc()); //测试真实数据时要把这里放开 final DataFramedf=getHotelInfo(hiveContext); //没有多线程处理的情况,连续执行两个Action操作,生成两个Job df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file1" ,com.hadoop.compression.lzo.LzopCodec. class ); df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file2" ,com.hadoop.compression.lzo.LzopCodec. class ); //用Executor实现多线程方式处理Job java.util.concurrent.ExecutorServiceexecutorService=Executors.newFixedThreadPool( 2 ); executorService.submit( new Callable<Void>(){ @Override public Voidcall(){ df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file3" ,com.hadoop.compression.lzo.LzopCodec. class ); return null ; } }); executorService.submit( new Callable<Void>(){ @Override public Voidcall(){ df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file4" ,com.hadoop.compression.lzo.LzopCodec. class ); return null ; } }); executorService.shutdown(); } public static DataFramegetHotelInfo(HiveContexthiveContext){ Stringsql= "select*fromcommon.dict_hotel_ol" ; return hiveContext.sql(sql); } } 本文转自巧克力黒 51CTO博客,原文链接:http://blog.51cto.com/10120275/1961130 ,如需转载请自行联系原作者