首页 文章 精选 留言 我的

精选列表

搜索[面试],共5092篇文章
优秀的个人博客,低调大师

面试官:Redis数据结构与内部编码,你知道多少?

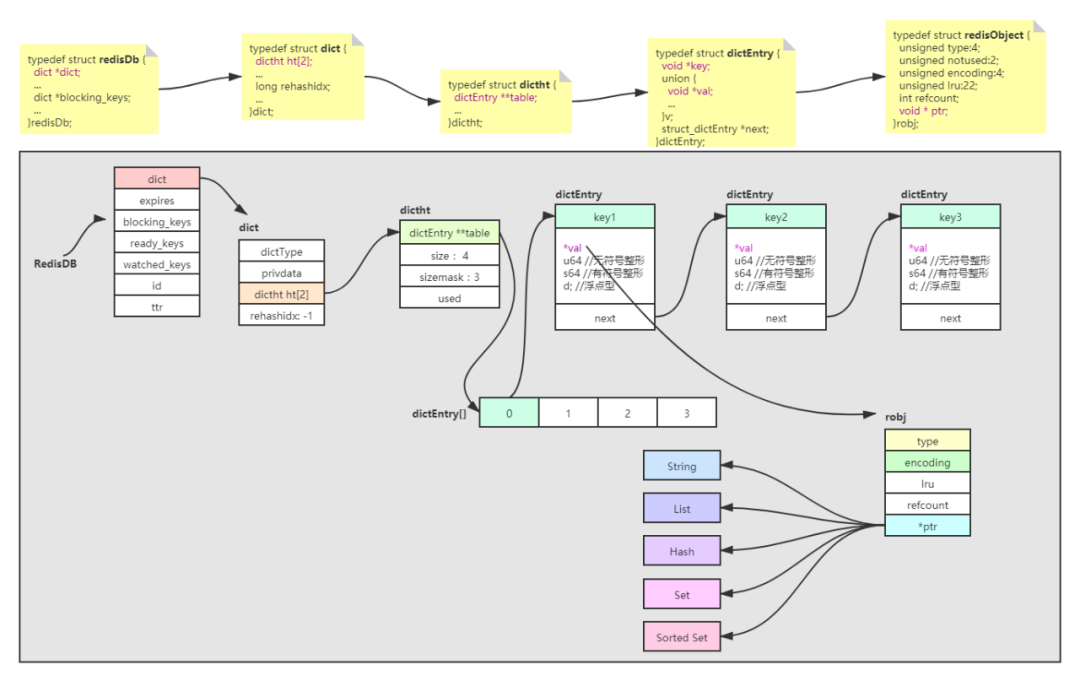
介绍 Redis是一个基于内存的数据库,所有的数据都存储在内存中,所以如何优化存储,减少内存空间占用对成本控制来说是非常重要的。精简键名和键值是最直观的减少内存占用的方式,而Redis则是通过内部编码规则来节省更多的内存空间。 Redis为每种数据类型都提供了两三种内部编码方式,以散列类型为例,散列类型是通过散列表实现的,这样就可以实现0(1)时间复杂度的查找、赋值操作,然而当键中元素很少的时候,0(1)的操作并不会比0(n)有明显的性能提高,所以这种情况下Redis会采用一种更为紧凑但性能稍差(获取元素的时间复杂度为0(n))的内部编码方式。内部编码方式的选择对于开发者来说是透明的,Redis会根据实际情况自动调整。当键中元素变多时Redis会自动将该键的内部编码方式转换成散列表。 一、Redis DB数据结构 Redis中是有16个redisDB库,默认是使用第一个。我们先来看下redisDB的数据结构: dict:字典 dictht:就是一个hashtable,以o(1)时间复杂度获取size,used当前数组里面用掉了多少空间 dictEntry:数组里面的元素,**table指针指向数组,redis中所有的key都是存在dictEntry中 *var:存储key的值,也是一个指针,指向redisObject结构进行数据存储,这个指针指向真实的数据存储 next:当key发生hash冲突时(比如都是数组0),通过next指针建立一个单向的链表解决hash冲突 robj字段介绍: type:对外的数据类型,string,list,hash,set,zset等 encoding:内部编码,raw,int,ziplist等,对内存利用率极致追求 LRU_BITS:内存淘汰策略 refcount:redis内存管理需要 *ptr:指向真实的数据存储结构,ziplist等,最终指向数据编码的对象 二、内部编码方式 下面是Redis数据结构与内部编码的关系: 查看一个键的内部编码方式: 127.0.0.1:6379>setfoo barOK127.0.0.1:6379> object encoding foo"raw" Redis的每个键值都是使用一个redisObject结构体保存的,在redis.h中声明的redisObj定义的如下: typedef struct redisObject { unsignedtype:4;/**4bit*/ unsigned encoding:4; /** 4 bit */ unsignedlru:LRU_BITS;/**24 bit*/intrefcount;/**4byte*/void*ptr;/**8byte*/}robj; 其中type字段表示的是键值的数据类型,取值可以是如下内容: #define REDIS_STRING 0 #define REDIS_LIST 1 #define REDIS_SET 2 #define REDIS_ZSET 3 #define REDIS_HASH 4 encoding字段表示的就是Redis键值的内部编码方式,取值可以是: #defineREDIS_ENCODING_RAW0/**Rawrepresentation*/#define REDIS_ENCODING_INT 1 /** ed as integer */ #defineREDIS_ENCODING_EMBSTR2/**cpu cache line*/#defineREDIS_ENCODING_HT3/**Encodedashashtable*/#defineREDIS_ENCODING_ZIPMAP4/**Encodedaszipmap*/#defineREDIS_ENCODING_QUICKEDLIST5/**Encodedasregularquickedlist*/#defineREDIS_ENCODING_ZIPLIST6/**Encodedasziplist*/#defineREDIS_ENCODING_INTSET7/**Encodedasintset*/#defineREDIS_ENCODING_SKIPLIST8/**Encodedasskiplist*/ 各个数据类型可能采用的内部编码方式以及相应的OBJECT ENCODING命令执行结果如下: 数据类型 内部编码方式 OBJECT ENCODING命令结果 字符串类型‍‍ REDIS_ENCODING_RAW "raw" REDIS_ENCODING_INT "int"‍ REDIS_ENCODING_EMBSTR "embstr" 散列类型 REDIS_ENCODING_HT "hashtable" REDIS_ENCODING_ZIPLIST "ziplist" 列表类型 REDIS_ENCODING_QUICKEDLIST "quickedlist" REDIS_ENCODING_ZIPLIST "ziplist" 集合类型 REDIS_ENCODING_HT "hashtable" REDIS_ENCODING_INTSET "intset" 有序集合类型 REDIS_ENCODING_SKIPLIST "skiplist" REDIS_ENCODING_ZIPLIST "ziplist" 下面针对每种数据类型分别介绍其内部编码规则及优化方式。 二、字符串类型优化方式 127.0.0.1:6379> set a_string aOK127.0.0.1:6379> set a_int 1OK127.0.0.1:6379> set a_long_string aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaOK127.0.0.1:6379> type a_stringstring127.0.0.1:6379> type a_intstring127.0.0.1:6379> type a_long_stringstring127.0.0.1:6379> object encoding a_string"embstr"127.0.0.1:6379> object encoding a_int"int"127.0.0.1:6379> object encoding a_long_string"raw"127.0.0.1:6379> Redis使用一个sdshdr类型的变量来存储字符串,而redisObject的ptr字段指向的是该变量的地址。sdshdr的定义如下: //redis3.2之前版本struct sdshdr { intlen;/* 表示的是字符串的长度 */ int free; /* 表示buf中的剩余空间 */ char buf[]; /* 字符串的内容 */};//redis3.2之后版本typedef char *sds;structsdshdr5{unsignedcharflags;/*3lsboftype,and5msbofstringlength*/ char buf[]; };structsdshdr8{uint8_t_len;/*used*/uint8_t_alloc;/*excluding the header and null terminator*/unsignedcharflags;/*3lsboftype,5unused bits */ char buf[]; };structsdshdr16{uint16_t_len;/*used*/uint16_t_alloc;/*excludingtheheaderandnullterminator*/ unsigned char flags; /*3 lsb of type, 5 unused bits */ char buf[]; };structsdshdr32{ ... };structsdshdr64{ ...}; redis根据字符串大小选择合适的数据存储结构: #define SDS_TYPE_5 0#defineSDS_TYPE_81#defineSDS_TYPE_162#defineSDS_TYPE_323#defineSDS_TYPE_644static inline char sdsReqType(size_t_string_size) {if(string_size<32)returnSDS_TYPE_5;if(string_size<0xff) // 2^8 - 1returnSDS_TYPE_8;if(string_size<0xffff)//2^16-1returnSDS_TYPE_16;if(string_size<0xffffffff)//2^32-1returnSDS_TYPE_32;returnSDS_TYPE_64;} 3.2之前: 可以动态扩容的数据结构 free代表可用空间,分配空间可以分配稍微大一点的空间,下次进行数据修改的时候就不用每次都分配内存,提升整体性能 3.2之后: 变得丰富多样 节省存储空间,比如就存一个字符串【i】,使用sdshdr数据结构需要len+free=4+4=8字节 sdshdr5只会使用一个字节flags,表示数据特性。如下: flags+buf,一个flags字节的低3位表示类型type,len表示数据长度(2^5-1 < 32) buf表示真实数据 缺点是无法动态扩容,没有free字段,所以redis也没有使用sdshdr5这种数据结构,never used,所以通常情况下,使用下面sdshdr8: type定义的0,1,2表示type占用的bit位,可以减少空间占用 接下来我们分别介绍下string类型的raw、int和embstr。 embstr 比如当执行SET key foobar时,在64位linux系统下,存储键值需要占用的空间是sizeof(redisObject)+sizeof(sdshdr8)+strlen("foobar")=16字节+4字节+6字节=26字节。存储结构如下: 在linux操作系统,cpu缓存行大小占64byte,而redisObject和sdshdr8正好占用20个字节,所以当业务数据大小在64-20=44字节之内的话,可以利用cpu缓存行特性:linux分配内存的时候,就会挨着redisObject进行分配,开辟一块连续的空间存储,利用cpu的缓存行一次读取到数据,减少内存IO,这样数据整合就在cpu缓存行范围内,这样在进行数据读取的时候,cpu第一次寻址到var,通过var找到redisObject,通过redisObject我们可以直接拿到值,而不用通过指针再一次寻址去拿数据,这就是embstr做的事情。 raw类型是和redisObject不在一块连续的内存空间,如下: 我们可以对embstr进行验证: 127.0.0.1:6379> set a_string_short aaaaaaaaaa-aaaaaaaaaa-aaaaaaaaaa-aaaaaaaaaa-OK127.0.0.1:6379> STRLEN a_string_short(integer) 44127.0.0.1:6379> object encoding a_string_short"embstr"127.0.0.1:6379> set b_string_short aaaaaaaaaa-aaaaaaaaaa-aaaaaaaaaa-aaaaaaaaaa-aOK127.0.0.1:6379> STRLEN b_string_short(integer) 45127.0.0.1:6379> object encoding b_string_short"raw"127.0.0.1:6379> 当字符串长度大于44时就变成了raw 使用append追加字符串方式说明: 127.0.0.1:6379> set a aOK127.0.0.1:6379> object encoding a"embstr"127.0.0.1:6379> APPEND a b(integer) 2127.0.0.1:6379> object encoding a"raw"127.0.0.1:6379> 使用append等命令会修改redis内部编码,就不适用cpu缓存行优化的方式了 int 当键值内容可以用一个64位有符号整数表示时,Redis会将键值转换成long类型来存储。如SET key 123456,实际占用的空间是sizeof(redisObject)=16字节,比存储"foobar"节省了 一半的存储空间,如下所示: redisObject中的refcount字段存储的是该键值被引用数量,即一个键值可以被多个键引用。Redis启动后会预先建立10000个分别存储从0到9999这些数字的redisObject类型变量作为共享 对象,如果要设置的字符串键值在这10000个数字内(如SET key1 123)则可以直接引用共享对象而不用再建立一个redisObject了,也就是说存储键值占用的空间是0字节,如下所示: 由此可见,使用字符串类型键存储对象ID这种小数字是非常节省存储空间的,Redis只需存储键名和一个对共享对象的引用即可。虽然整形底层存储encoding是int类型,但是在获取长度计算时会转换为字符串计算长度。 注意:当通过配置文件参数maxmemory设置了Redis可用的最大空间大小时,Redis不会使用共享对象,因为对于每一个键值都需要使用一个redisObject来记录其LRU信息。 字符串扩容的原理: 当字符串大小小于1M时,每次扩容一倍 大于1M时,每次增加1M,比如现在5M,扩容后就是6M 三、散列类型优化方式 散列类型的内部编码方式可能是REDIS_ENCODING_HT或REDIS_ENCODING_ZIPLIST。当数据量比较小或者单个元素比较小时,底层用ziplist存储。可以在配置文件中可以定义使用REDIS_ENCODING_ZIPLIST方式编码散列类型的时机: hash-max-ziplist-entries 512 hash-max-ziplist-value 64 当散列类型键的字段个数少于hash-max-ziplist-entries参数值且每个字段名和字段值的长度都小于hash-max-ziplist-value参数值(单位为字节)时,Redis就会使用REDIS_ ENCODING_ZIPLIST来存储该键,否则就会使用REDIS_ENCODING_HT。转换过程是透明的,每当键值变更后Redis都会自动判断是否满足条件来完成转换。如下演示: 127.0.0.1:6379> hset user name duan age 27 f1 v1 f2 v2 f3 v3(integer) 5127.0.0.1:6379> HGETALL user 1) "name" 2) "duan" 3) "age" 4) "27" 5) "f1" 6) "v1" 7) "f2" 8) "v2" 9) "f3"10) "v3"127.0.0.1:6379> hset user f4 vvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvv(integer) 1127.0.0.1:6379> HGETALL user 1) "f3" 2) "v3" 3) "name" 4) "duan" 5) "f4" 6) "vvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvvv" 7) "f1" 8) "v1" 9) "f2"10) "v2"11) "age"12) "27"127.0.0.1:6379> 超过64个字节变成hash,hash是无序的。 REDIS_ENCODING_HT编码即散列表,可以实现O(1)时间复杂度的赋值取值等操作,其字段和字段值都是使用redisObject存储的,所以前面讲到的字符串类型键值的优化方法同样适用于散列类型键的字段和字段值。 注意:Redis的键值对存储也是通过散列表实现的,与REDIS_ENCODING_HT编码方式类似,但键名并非使用redisObject存储,所以键名"123456"并不会比"abcdef"占用更少的空间。之所以不对键名进行优化是因为绝大多数情况下键名都不会是纯数字。 Redis支持多数据库,每个数据库中的数据都是通过结构体redisDb存储的。redisDb的定义如下: typedef struct redisDb { dict*dict;/**ThekeyspaceforthisDB*/dict* expires;/**Timeoutofkeyswithatimeoutset*/dict*blocking_keys;/**Keyswithclientswaitingfordata(BLPOP)*/dict*ready_keys;/**BlockedkeysthatreceivedaPUSH*/dict*watched_keys;/**WATCHEDkeysforMULTI/EXECCAS*/int id; } redisDb; dict类型就是散列表结构 expires存储的是数据的过期时间 当Redis启动时会根据配置文件中databases参数指定的数量创建若干个redisDb类型变量存储不同数据库中的数据。 REDIS_ENCODING_ZIPLIST编码类型是一种紧凑的编码格式,它牺牲了部分读取性能以换取极高的空间利用率,适合在元素较少时使用。该编码类型同样还在列表类型和有序集合类型中使用。REDIS_ENCODING_ZIPLIST编码结构如下所示: zlbytes是uint32_t类型, 表示整个结构占用的空间 zltail也是uint32_t类型,表示到最后一个元素的偏移,记录zltail使得程序可以直接定位到尾部元素而无需遍历整个结构,执行从尾部弹出(对列表类型而言)等操作时速度更快 zllen是uint16_t类型,存储的是元素的数量 zlend是一个单字节标识,标记结构的末尾,值永远是255 散列类型的ziplist数据结构如下图所示: 在REDIS_ENCODING_ZIPLIST中每个元素由4个部分组成: 第一个部分用来存储前一个元素的大小以实现倒序查找,当前一个元素的大小小于254字节时第一个部分占用1个字节,否则会占用5个字节 第二、三个部分分别是元素的编码类型和元素的大小,当元素的大小小于或等于63个字 节时,元素的编码类型是ZIP_STR_06B(即0<<6),同时第三个部分用6个二进制位来记录元素的长度,所以第二、三个部分总占用空间是1字节。当元素的大小大于63且小于或等于16383字节时,第二、三个部分总占用空间是2字节。当元素的大小大于16383字节时,第二、三个部 分总占用空间是5字节 第四个部分是元素的实际内容,如果元素可以转换成数字的话Redis会使用相应的数字类型来存储以节省空间,并用第二、三个部分来表示数字的类型(int16_t、int32_t等) 使用REDIS_ENCODING_ZIPLIST编码存储散列类型时元素的排列方式是:元素1存储字段1,元素2存储字段值2,依次类推,如下所示: 例如,当执行命令HSET hkey foo bar命令后,hkey键值的内存结构如下所示: 下次需要执行HSET hkey foo anothervalue时Redis需要从头开始找到值为foo的元素(查找 时每次都会跳过一个元素以保证只查找字段名),找到后删除其下一个元素,并将新值 anothervalue插入。删除和插入都需要移动后面的内存数据,而且查找操作也需要遍历才能完 成,可想而知当散列键中数据多时性能将很低,所以不宜将hash-max-ziplist-entries和hash-max- ziplist-value两个参数设置得很大。 四、列表类型优化方式 列表类型内部编码方式是REDIS_ENCODING_QUICKLIST或REDISENCODINGZIPLIST。 127.0.0.1:6379> lpush queue-task a b c(integer) 3127.0.0.1:6379> type queue-tasklist127.0.0.1:6379> object encoding queue-task"quicklist"127.0.0.1:6379> 同样在配置文件中可以设置每个ziplist的最大容量和quickList的数据压缩范围,提升数据存取效率。 list-max-ziplist-size -2list-compress-depth 0 0默认不压缩 list不关注中间数据,1表示不压缩头尾节点,压缩中间数据 2表示头尾节点和头尾相邻的一个节点不压缩,压缩初次之外中间的 注意:列表类型实现阻塞队列使用的是redisDb结构中的字段blocking_keys,维护的是key与客户端的关系,不会阻塞redis进程。如下: typedef struct redisDb { dict *dict; ... dict *blocking_keys; ...}redisDb ZIPLIST数据结构 ziplist数据结构说明: zlbytes:32bit表示ziplist占用的字节总数 zltail:32bit表示ziplist表中最后一项entry在ziplist中的偏移字节数。通过zltail我们可以很方便地找到最后一项,从而可以在ziplist尾端快速地执行push或pop操作 zlen:16bit表示ziplist中数据项entry的个数 entry:表示真正存放数据的数据项,长度不定 zlend:ziplist最后一个字节,是一个结束标记,值固定等于255 prerawlen:前一个entry的数据长度 len:entry中数据的长度 data:真实数据存储 根据len字段的第一个字节分的9种情况: 00xxxxxx:len字段前2个高位 bit为0,剩余的6个bit用来表示长度,即最大长度可以到2^6 - 1 01xxxxxx xxxxxxxx:len字段的前2个高位是01,则len字段占2个byte,共有14个bit表示,数据长度最多2^14 - 1 10xxxxxx xxxxxxxx xxxxxxxx xxxxxxxx xxxxxxxx:len字段前2个高位bit是10,则len字段占5个byte,共有32个bit表示,数据长度最多2^32 - 1,第一个字节的剩余6个bit舍弃不用 11000000:len字段前2个高位bit是11,值为OXC0,则len字段占1个byte,后面的data为2字节的int16_t类型 11010000:len字段前4个高位bit是1101,值为OXD0,则len字段占1个byte,后面的data为4字节的int32_t类型 11100000:len字段前4个高位bit是1110,值为OXE0,则len字段占1个byte,后面的data为8字节的int64_t类型 11110000:len字段前4个高位bit是1111,值为OXF0,则len字段占1个byte,后面的data为3字节的整数 11111110:len字段前7个高位bit是1111111,值为OXFE,则len字段占1个byte,后面的data为1字节的整数 1111xxxx:len字段前4个字节是1111,后4个bit的范围是(0001-1101),这时xxxx从1到13,一共13个值,这时就用这13个值来表示data的数据,真正的数值大小为对应的bit位数值-1,代表真实的业务数据 ziplist是非常紧凑的一种数据类型,为了节省内存空间。而非常紧凑的数据结构的缺点是: 空间必须是连续的 数据量非常大的时候往里面加元素,数据迁移很麻烦 频繁的内存分配与释放是不划算的,所以redis针对这个问题进行了优化,quicklist QUICKLIST数据结构 quicklist的优化是后续有数据修改,都是在一个小的ziplist中。 五、集合类型优化方式 集合类型的内部编码方式可能是REDIS_ENCODING_HT或REDIS_ENCODING_INTSET。 127.0.0.1:6379> sadd aset a b c d e f(integer) 6127.0.0.1:6379> sadd bset 1 2 3 4 5 6(integer) 6127.0.0.1:6379> object encoding aset"hashtable"127.0.0.1:6379> object encoding bset"intset"127.0.0.1:6379> sadd bset a(integer) 1127.0.0.1:6379> SMEMBERS bset1) "a"2) "5"3) "3"4) "1"5) "6"6) "4"7) "2"127.0.0.1:6379> 当集合中的所有元素都是整数且元素的个数小于配置文件中的set-max-intset-entries参数指定值(默认是512)时Redis会使用REDIS_ENCODING_INTSET编码存储该集合,否则会使用 REDIS_ENCODING_HT来存储。REDIS_ENCODING_INTSET编码存储结构体intset的定义是: typedef struct intset { uint32_t encoding; uint32_t length; int8_t contents[]; } intset; 其中contents存储的就是集合中的元素值,根据encoding的不同,每个元素占用的字节大小 不同。默认的encoding是INTSET_ENC_INT16(即2个字节),当新增加的整数元素无法使用2个字节表示时,Redis会将该集合的encoding升级为INTSET_ENC_INT32(即4个字节)并调整之前所有元素的位置和长度,同样集合的encoding还可升级为INTSET_ENC_INT64(即8个字节)。并且contents[]内存储的整数元素是顺序存储的。 REDIS_ENCODING_INTSET编码以有序的方式存储元素(所以使用SMEMBERS命令获得的结果是有序的),使得可以使用二分算法查找元素。但是无论是添加还是删除元素,Redis都需要调整后面元素的内存位置,所以当集合中的元素太多时性能较差。当新增加的元素不是整数或集合中的元素数量超过了set-max-intset-entries参数指定值时,Redis会自动将该集合的存储结构转换成REDIS_ENCODING_HT。 注意:当集合的存储结构转換成REDIS_ENCODING_HT后,即使将集合中的所有非整数元素删除,Redis也不会自动将存储结构转換回REDIS_ENCODING_INTSET。因为如果要支持自动回转,就意味着Redis在每次删除元素时都需要遍历集合中的键来判断是否可以转換回原来的编码,这会使得删除元素变成了时间复杂度为0(n)的操作。 六、有序集合类型优化方式 有序集合类型编码方式可能是REDIS_ENCODING_SKIPLIST或REDIS_ENCODING_ZIPLIST。 当数据比较少时采用ziplist编码结构存储,同样在配置文件中可以定义使用REDIS_ENCODING_ZIPLIST方式编码的时机: zset-max-ziplist-entries 128 zset-max-ziplist-value 64 有序集合的ziplist数据结构如下图: 当数据大小超过128字节,使用跳表存储,单个元素大小超多64个字节也是跳表结构。有序集合的跳表结构如下图: *forward:前进指针 span:跨越元素,比如rank操作就是通过span跨越元素来计算的 头结点不存储数据,起到索引的作用,中间和尾结点存储数据 L2找到了120,如果找150,下降一层,找到了200,则数据就在150就在120~200之间 具体规则和散列类型及列表类型一样。当编码方式是REDIS_ENCODING_SKIPLIST时,Redis使用散列表和跳跃列表(skiplist)两种数据结构来存储有序集合类型键值,其中散列表用来存储元素值与元素分数的映射关系以实现0(1)时间复杂度的ZSCORE等命令。跳跃列表用来存储元素的分数及其到元素值的映射以实现排序的功能。 Redis对跳跃列表的实现进行了几点修改,其中包括允许跳跃列表中的元素(即分数)相同,还有为跳跃链表每个节点增加了指向前一个元素的指针以实现倒序查找。 采用此种编码方式时,元素值是使用redisObject存储的,所以可以使用字符串类型键值的优化方式优化元素值,而元素的分数是使用double类型存储的。 使用REDIS_ENCODING_ZIPLIST编码时有序集合存储的方式按照"元素1的值,元素1的分数,元素2的值,元素2的分数"这样的顺序排列,并且分数是有序的。 本文分享自微信公众号 - 码农沉思录(code-thinker)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

看完这篇操作系统,和面试官扯皮就没问题

即将开播:5月20日,基于kubernetes打造企业级私有云实践 1.解释一下什么是操作系统 操作系统是运行在计算机上最重要的一种软件,它管理计算机的资源和进程以及所有的硬件和软件。它为计算机硬件和软件提供了一种中间层。 通常情况下,计算机上会运行着许多应用程序,它们都需要对内存和 CPU 进行交互,操作系统的目的就是为了保证这些访问和交互能够准确无误的进行。 2.解释一下操作系统的主要目的是什么 操作系统是一种软件,它的主要目的有三种 管理计算机资源,这些资源包括 CPU、内存、磁盘驱动器、打印机等。 提供一种图形界面,就像我们前面描述的那样,它提供了用户和计算机之间的桥梁。 为其他软件提供服务,操作系统与软件进行交互,以便为其分配运行所需的任何必要资源。 3.操作系统的种类有哪些 操作系统通常预装在你购买计算机之前。大部分用户都会使用默认的操作系统,但是你也可以升级甚至更改操作系统。但是一般常见的操作系统只有三种:Windows、macOS 和 Linux。 4.操作系统结构 4.1.单体系统 在大多数系统中,整个系统在内核态以单一程序的方式运行。整个操作系统是以程序集合来编写的,链接在一块形成一个大的二进制可执行程序,这种系统称为单体系统。 在单体系统中构造实际目标程序时,会首先编译所有单个过程(或包含这些过程的文件),然后使用系统链接器将它们全部绑定到一个可执行文件中 在单体系统中,对于每个系统调用都会有一个服务程序来保障和运行。需要一组实用程序来弥补服务程序需要的功能,例如从用户程序中获取数据。可将各种过程划分为一个三层模型 除了在计算机初启动时所装载的核心操作系统外,许多操作系统还支持额外的扩展。比如 I/O 设备驱动和文件系统。这些部件可以按需装载。在 UNIX 中把它们叫做 共享库(shared library),在 Windows 中则被称为 动态链接库(Dynamic Link Library,DLL)。他们的扩展名为 .dll,在 C:\Windows\\system32 目录下存在 1000 多个 DLL 文件,所以不要轻易删除 C 盘文件,否则可能就炸了哦。 4.2.分层系统 分层系统使用层来分隔不同的功能单元。每一层只与该层的上层和下层通信。每一层都使用下面的层来执行其功能。层之间的通信通过预定义的固定接口通信。 4.3.微内核 为了实现高可靠性,将操作系统划分成小的、层级之间能够更好定义的模块是很有必要的,只有一个模块 --- 微内核 --- 运行在内核态,其余模块可以作为普通用户进程运行。由于把每个设备驱动和文件系统分别作为普通用户进程,这些模块中的错误虽然会使这些模块崩溃,但是不会使整个系统死机。 MINIX 3 是微内核的代表作,它的具体结构如下 在内核的外部,系统的构造有三层,它们都在用户态下运行,最底层是设备驱动器。由于它们都在用户态下运行,所以不能物理的访问 I/O 端口空间,也不能直接发出 I/O 命令。相反,为了能够对 I/O 设备编程,驱动器构建一个结构,指明哪个参数值写到哪个 I/O 端口,并声称一个内核调用,这样就完成了一次调用过程。 4.4.客户-服务器模式 微内核思想的策略是把进程划分为两类:服务器,每个服务器用来提供服务;客户端,使用这些服务。这个模式就是所谓的 客户-服务器模式。 客户-服务器模式会有两种载体,一种情况是一台计算机既是客户又是服务器,在这种方式下,操作系统会有某种优化;但是普遍情况下是客户端和服务器在不同的机器上,它们通过局域网或广域网连接。 客户通过发送消息与服务器通信,客户端并不需要知道这些消息是在本地机器上处理,还是通过网络被送到远程机器上处理。对于客户端而言,这两种情形是一样的:都是发送请求并得到回应。 5.什么是按需分页 在操作系统中,进程是以页为单位加载到内存中的,按需分页是一种虚拟内存的管理方式。在使用请求分页的系统中,只有在尝试访问页面所在的磁盘并且该页面尚未在内存中时,也就发生了缺页异常,操作系统才会将磁盘页面复制到内存中。 6.多处理系统的优势 随着处理器的不断增加,我们的计算机系统由单机系统变为了多处理系统,多处理系统的吞吐量比较高,多处理系统拥有多个并行的处理器,这些处理器共享时钟、内存、总线、外围设备等。 多处理系统由于可以共享资源,因此可以开源节流,省钱。整个系统的可靠性也随之提高。 7.什么是内核 在计算机中,内核是一个计算机程序,它是操作系统的核心,可以控制操作系统中所有的内容。内核通常是在 boot loader 装载程序之前加载的第一个程序。 这里还需要了解一下什么是 boot loader。 boot loader 又被称为引导加载程序,它是一个程序,能够将计算机的操作系统放入内存中。在电源通电或者计算机重启时,BIOS 会执行一些初始测试,然后将控制权转移到引导加载程序所在的主引导记录(MBR)。 8.什么是实时系统 实时操作系统对时间做出了严格的要求,实时操作系统分为两种:硬实时和软实时 硬实时操作系统规定某个动作必须在规定的时刻内完成或发生,比如汽车生产车间,焊接机器必须在某一时刻内完成焊接,焊接的太早或者太晚都会对汽车造成永久性伤害。 软实时操作系统虽然不希望偶尔违反最终的时限要求,但是仍然可以接受。并且不会引起任何永久性伤害。比如数字音频、多媒体、手机都是属于软实时操作系统。 你可以简单理解硬实时和软实时的两个指标:是否在时刻内必须完成以及是否造成严重损害。 9.什么是虚拟内存 虚拟内存是一种内存分配方案,是一项可以用来辅助内存分配的机制。我们知道,应用程序是按页装载进内存中的。但并不是所有的页都会装载到内存中,计算机中的硬件和软件会将数据从 RAM 临时传输到磁盘中来弥补内存的不足。如果没有虚拟内存的话,一旦你将计算机内存填满后,计算机会对你说。 呃,不,对不起,您无法再加载任何应用程序,请关闭另一个应用程序以加载新的应用程序。对于虚拟内存,计算机可以执行操作是查看内存中最近未使用过的区域,然后将其复制到硬盘上。虚拟内存通过复制技术实现了 妹子,你快来看哥哥能装这么多程序 的资本。复制是自动进行的,你无法感知到它的存在。 10.什么是进程和进程表 进程就是正在执行程序的实例,比如说 Web 程序就是一个进程,shell 也是一个进程,文章编辑器 typora 也是一个进程。 操作系统负责管理所有正在运行的进程,操作系统会为每个进程分配特定的时间来占用 CPU,操作系统还会为每个进程分配特定的资源。 操作系统为了跟踪每个进程的活动状态,维护了一个进程表。在进程表的内部,列出了每个进程的状态以及每个进程使用的资源等。 http://courses.cs.vt.edu/csonline/OS/Lessons/Processes/index.html ( http://courses.cs.vt.edu/csonline/OS/Lessons/Processes/index.html ) 这个网站上面有一个关于进程状态轮转的动画,做的真是太好了。 11.什么是线程,线程和进程的区别 这又是一道老生常谈的问题了,从操作系统的角度来回答一下吧。 我们上面说到进程是正在运行的程序的实例,而线程其实就是进程中的单条流向,因为线程具有进程中的某些属性,所以线程又被称为轻量级的进程。浏览器如果是一个进程的话,那么浏览器下面的每个 tab 页可以看作是一个个的线程。 下面是线程和进程持有资源的区别 线程不像进程那样具有很强的独立性,线程之间会共享数据 创建线程的开销要比进程小很多,因为创建线程仅仅需要堆栈指针和程序计数器就可以了,而创建进程需要操作系统分配新的地址空间,数据资源等,这个开销比较大。 12.使用多线程的好处是什么 多线程是程序员不得不知的基本素养之一,所以,下面我们给出一些多线程编程的好处 能够提高对用户的响应顺序 在流程中的资源共享 比较经济适用 能够对多线程架构有深入的理解 13.什么是 RR 调度算法 RR(round-robin) 调度算法主要针对分时系统,RR 的调度算法会把时间片以相同的部分并循环的分配给每个进程,RR 调度算法没有优先级的概念。这种算法的实现比较简单,而且每个线程都会占有时间片,并不存在线程饥饿的问题。 14.导致系统出现死锁的情况 死锁的出现需要同时满足下面四个条件 互斥(Mutual Exclusion):一次只能有一个进程使用资源。如果另一个进程请求该资源,则必须延迟请求进程,直到释放该资源为止。 保持并等待(Hold and Wait):必须存在一个进程,该进程至少持有一个资源,并且正在等待获取其他进程当前所持有的资源。 无抢占(No Preemption):资源不能被抢占,也就是说,在进程完成其任务之后,只能由拥有它的进程自动释放资源。 循环等待(Circular Wait) :必须存在一组 {p0,p1,..... pn} 的等待进程,使 p0 等待 p1 持有的资源,p1 等待由 p2 持有的资源, pn-1 正在等待由 pn 持有的资源,而 pn 正在等待由 p0 持有的资源。 15.RAID 的不同级别 RAID 称为 磁盘冗余阵列,简称 磁盘阵列。利用虚拟化技术把多个硬盘结合在一起,成为一个或多个磁盘阵列组,目的是提升性能或数据冗余。 RAID 有不同的级别 RAID 0 - 无容错的条带化磁盘阵列 RAID 1 - 镜像和双工 RAID 2 - 内存式纠错码 RAID 3 - 比特交错奇偶校验 RAID 4 - 块交错奇偶校验 RAID 5 - 块交错分布式奇偶校验 RAID 6 - P + Q 冗余 16.什么是 DMA DMA 的中文名称是直接内存访问,它意味着 CPU 授予 I/O 模块权限在不涉及 CPU 的情况下读取或写入内存。也就是 DMA 可以不需要 CPU 的参与。这个过程由称为 DMA 控制器(DMAC)的芯片管理。由于 DMA 设备可以直接在内存之间传输数据,而不是使用 CPU 作为中介,因此可以缓解总线上的拥塞。DMA 通过允许 CPU 执行任务,同时 DMA 系统通过系统和内存总线传输数据来提高系统并发性。 17.多线程编程的好处是什么 对不起,我忍不住想偷笑 说直白点,为什么单线程能够处理的却要用多线程来处理?当然是为了提高程序的装逼并行能力了。多线程在某些情况下能够使你程序运行的更快,这也是为什么多核 CPU 会出现,但是多核 CPU 的出现会导致数据的一致性问题,不过这些问题程序员就能解决。另一个角度来说,多线程编程能够提高程序员的编程能力和编程思维。同时也能提高程序员的管理能力,你如果把每条线程流当作罗老师时间管理的女主一样,能够及时协调好所有 P 友的关系,那你也是超神程序员了,所以,是谁说程序员不会做管理的?Doug Lea 大佬牛逼!!! ps:Doug Lea 大佬开发的 JUC 工具包,此处不加狗头。 18.什么是设备驱动程序 在计算机中,设备驱动程序是一种计算机程序,它能够控制或者操作连接到计算机的特定设备。驱动程序提供了与硬件进行交互的软件接口,使操作系统和其他计算机程序能够访问特定设备,不用需要了解其硬件的具体构造。 19.进程间的通信方式 19.1.通信概念 进程间的通信方式比较多,首先你需要理解下面这几个概念 竞态条件:即两个或多个线程同时对一共享数据进行修改,从而影响程序运行的正确性时,这种就被称为竞态条件(race condition)。 临界区:不仅共享资源会造成竞态条件,事实上共享文件、共享内存也会造成竞态条件、那么该如何避免呢?或许一句话可以概括说明:禁止一个或多个进程在同一时刻对共享资源(包括共享内存、共享文件等)进行读写。换句话说,我们需要一种 互斥(mutual exclusion) 条件,这也就是说,如果一个进程在某种方式下使用共享变量和文件的话,除该进程之外的其他进程就禁止做这种事(访问统一资源)。 一个好的解决方案,应该包含下面四种条件 任何时候两个进程不能同时处于临界区 不应对 CPU 的速度和数量做任何假设 位于临界区外的进程不得阻塞其他进程 不能使任何进程无限等待进入临界区 忙等互斥:当一个进程在对资源进行修改时,其他进程必须进行等待,进程之间要具有互斥性,我们讨论的解决方案其实都是基于忙等互斥提出的。19.2 解决方案 进程间的通信用专业一点的术语来表示就是 Inter Process Communication,IPC,它主要有下面几种通信方式 消息传递:消息传递是进程间实现通信和同步等待的机制,使用消息传递,进程间的交流不需要共享变量,直接就可以进行通信;消息传递分为发送方和接收方 先进先出队列:先进先出队列指的是两个不相关联进程间的通信,两个进程之间可以彼此相互进程通信,这是一种全双工通信方式 管道:管道用于两个相关进程之间的通信,这是一种半双工的通信方式,如果需要全双工,需要另外一个管道。 直接通信:在这种进程通信的方式中,进程与进程之间只存在一条链接,进程间要明确通信双方的命名。 间接通信:间接通信是通信双方不会直接建立连接,而是找到一个中介者,这个中介者可能是个对象等等,进程可以在其中放置消息,并且可以从中删除消息,以此达到进程间通信的目的。 消息队列:消息队列是内核中存储消息的链表,它由消息队列标识符进行标识,这种方式能够在不同的进程之间提供全双工的通信连接。 共享内存:共享内存是使用所有进程之间的内存来建立连接,这种类型需要同步进程访问来相互保护。 20.进程间状态模型 catchapter1chapter2chapter3|greptree 第一个进程是 cat,将三个文件级联并输出。第二个进程是 grep,它从输入中选择具有包含关键字 tree 的内容,根据这两个进程的相对速度(这取决于两个程序的相对复杂度和各自所分配到的 CPU 时间片),可能会发生下面这种情况,grep 准备就绪开始运行,但是输入进程还没有完成,于是必须阻塞 grep 进程,直到输入完毕。 当一个进程开始运行时,它可能会经历下面这几种状态 图中会涉及三种状态 运行态,运行态指的就是进程实际占用 CPU 时间片运行时 就绪态,就绪态指的是可运行,但因为其他进程正在运行而处于就绪状态 阻塞态,除非某种外部事件发生,否则进程不能运行逻辑上来说,运行态和就绪态是很相似的。这两种情况下都表示进程可运行,但是第二种情况没有获得 CPU 时间分片。第三种状态与前两种状态不同的原因是这个进程不能运行,CPU 空闲时也不能运行。 三种状态会涉及四种状态间的切换,在操作系统发现进程不能继续执行时会发生状态 1的轮转,在某些系统中进程执行系统调用,例如 pause,来获取一个阻塞的状态。在其他系统中包括 UNIX,当进程从管道或特殊文件(例如终端)中读取没有可用的输入时,该进程会被自动终止。 转换 2 和转换 3 都是由进程调度程序(操作系统的一部分)引起的,进程本身不知道调度程序的存在。转换 2 的出现说明进程调度器认定当前进程已经运行了足够长的时间,是时候让其他进程运行 CPU 时间片了。当所有其他进程都运行过后,这时候该是让第一个进程重新获得 CPU 时间片的时候了,就会发生转换 3。 程序调度指的是,决定哪个进程优先被运行和运行多久,这是很重要的一点。已经设计出许多算法来尝试平衡系统整体效率与各个流程之间的竞争需求。 当进程等待的一个外部事件发生时(如从外部输入一些数据后),则发生转换 4。如果此时没有其他进程在运行,则立刻触发转换 3,该进程便开始运行,否则该进程会处于就绪阶段,等待 CPU 空闲后再轮到它运行。 21.调度算法都有哪些 调度算法分为三大类:批处理中的调度、交互系统中的调度、实时系统中的调度 21.1.批处理中的调度 先来先服务 很像是先到先得。。。可能最简单的非抢占式调度算法的设计就是 先来先服务(first-come,first-serverd)。使用此算法,将按照请求顺序为进程分配 CPU。最基本的,会有一个就绪进程的等待队列。当第一个任务从外部进入系统时,将会立即启动并允许运行任意长的时间。它不会因为运行时间太长而中断。当其他作业进入时,它们排到就绪队列尾部。当正在运行的进程阻塞,处于等待队列的第一个进程就开始运行。当一个阻塞的进程重新处于就绪态时,它会像一个新到达的任务,会排在队列的末尾,即排在所有进程最后。 这个算法的强大之处在于易于理解和编程,在这个算法中,一个单链表记录了所有就绪进程。要选取一个进程运行,只要从该队列的头部移走一个进程即可;要添加一个新的作业或者阻塞一个进程,只要把这个作业或进程附加在队列的末尾即可。这是很简单的一种实现。 不过,先来先服务也是有缺点的,那就是没有优先级的关系,试想一下,如果有 100 个 I/O 进程正在排队,第 101 个是一个 CPU 密集型进程,那岂不是需要等 100 个 I/O 进程运行完毕才会等到一个 CPU 密集型进程运行,这在实际情况下根本不可能,所以需要优先级或者抢占式进程的出现来优先选择重要的进程运行。 最短作业优先 批处理中,第二种调度算法是 最短作业优先(Shortest Job First),我们假设运行时间已知。例如,一家保险公司,因为每天要做类似的工作,所以人们可以相当精确地预测处理 1000 个索赔的一批作业需要多长时间。当输入队列中有若干个同等重要的作业被启动时,调度程序应使用最短优先作业算法 如上图 a 所示,这里有 4 个作业 A、B、C、D ,运行时间分别为 8、4、4、4 分钟。若按图中的次序运行,则 A 的周转时间为 8 分钟,B 为 12 分钟,C 为 16 分钟,D 为 20 分钟,平均时间内为 14 分钟。 现在考虑使用最短作业优先算法运行 4 个作业,如上图 b 所示,目前的周转时间分别为 4、8、12、20,平均为 11 分钟,可以证明最短作业优先是最优的。考虑有 4 个作业的情况,其运行时间分别为 a、b、c、d。第一个作业在时间 a 结束,第二个在时间 a + b 结束,以此类推。平均周转时间为 (4a + 3b + 2c + d) / 4 。显然 a 对平均值的影响最大,所以 a 应该是最短优先作业,其次是 b,然后是 c ,最后是 d 它就只能影响自己的周转时间了。 需要注意的是,在所有的进程都可以运行的情况下,最短作业优先的算法才是最优的。 最短剩余时间优先 最短作业优先的抢占式版本被称作为 最短剩余时间优先(Shortest Remaining Time Next) 算法。使用这个算法,调度程序总是选择剩余运行时间最短的那个进程运行。当一个新作业到达时,其整个时间同当前进程的剩余时间做比较。如果新的进程比当前运行进程需要更少的时间,当前进程就被挂起,而运行新的进程。这种方式能够使短期作业获得良好的服务。 21.2.交互式系统中的调度 交互式系统中在个人计算机、服务器和其他系统中都是很常用的,所以有必要来探讨一下交互式调度 轮循调度 一种最古老、最简单、最公平并且最广泛使用的算法就是 轮循算法(round-robin)。每个进程都会被分配一个时间段,称为时间片(quantum),在这个时间片内允许进程运行。如果时间片结束时进程还在运行的话,则抢占一个 CPU 并将其分配给另一个进程。如果进程在时间片结束前阻塞或结束,则 CPU 立即进行切换。轮循算法比较容易实现。调度程序所做的就是维护一个可运行进程的列表,就像下图中的 a,当一个进程用完时间片后就被移到队列的末尾,就像下图的 b。 优先级调度 事实情况是不是所有的进程都是优先级相等的。例如,在一所大学中的等级制度,首先是院长,然后是教授、秘书、后勤人员,最后是学生。这种将外部情况考虑在内就实现了优先级调度(priority scheduling) 它的基本思想很明确,每个进程都被赋予一个优先级,优先级高的进程优先运行。 但是也不意味着高优先级的进程能够永远一直运行下去,调度程序会在每个时钟中断期间降低当前运行进程的优先级。如果此操作导致其优先级降低到下一个最高进程的优先级以下,则会发生进程切换。或者,可以为每个进程分配允许运行的最大时间间隔。当时间间隔用完后,下一个高优先级的进程会得到运行的机会。 最短进程优先 对于批处理系统而言,由于最短作业优先常常伴随着最短响应时间,一种方式是根据进程过去的行为进行推测,并执行估计运行时间最短的那一个。假设每个终端上每条命令的预估运行时间为 T0,现在假设测量到其下一次运行时间为 T1,可以用两个值的加权来改进估计时间,即aT0+ (1- 1)T1。通过选择 a 的值,可以决定是尽快忘掉老的运行时间,还是在一段长时间内始终记住它们。当 a = 1/2 时,可以得到下面这个序列 可以看到,在三轮过后,T0 在新的估计值中所占比重下降至 1/8。 有时把这种通过当前测量值和先前估计值进行加权平均从而得到下一个估计值的技术称作 老化(aging)。这种方法会使用很多预测值基于当前值的情况。 彩票调度 有一种既可以给出预测结果而又有一种比较简单的实现方式的算法,就是 彩票调度(lottery scheduling)算法。他的基本思想为进程提供各种系统资源的彩票。当做出一个调度决策的时候,就随机抽出一张彩票,拥有彩票的进程将获得资源。比如在 CPU 进行调度时,系统可以每秒持有 50 次抽奖,每个中奖进程会获得额外运行时间的奖励。 可以把彩票理解为 buff,这个 buff 有 15% 的几率能让你产生 速度之靴 的效果。 公平分享调度 如果用户 1 启动了 9 个进程,而用户 2 启动了一个进程,使用轮转或相同优先级调度算法,那么用户 1 将得到 90 % 的 CPU 时间,而用户 2 将之得到 10 % 的 CPU 时间。 为了阻止这种情况的出现,一些系统在调度前会把进程的拥有者考虑在内。在这种模型下,每个用户都会分配一些 CPU 时间,而调度程序会选择进程并强制执行。因此如果两个用户每个都会有 50% 的 CPU 时间片保证,那么无论一个用户有多少个进程,都将获得相同的 CPU 份额。 22.页面置换算法都有哪些 算法 注释 最优算法 不可实现,但可以用作基准 NRU(最近未使用) 算法 和 LRU 算法很相似 FIFO(先进先出) 算法 有可能会抛弃重要的页面 第二次机会算法 比 FIFO 有较大的改善 时钟算法 实际使用 LRU(最近最少)算法 比较优秀,但是很难实现 NFU(最不经常使用)算法 和 LRU 很类似 老化算法 近似 LRU 的高效算法 工作集算法 实施起来开销很大 工作集时钟算法 比较有效的算法 最优算法在当前页面中置换最后要访问的页面。不幸的是,没有办法来判定哪个页面是最后一个要访问的,因此实际上该算法不能使用。然而,它可以作为衡量其他算法的标准。 NRU 算法根据 R 位和 M 位的状态将页面分为四类。从编号最小的类别中随机选择一个页面。NRU 算法易于实现,但是性能不是很好。存在更好的算法。 FIFO 会跟踪页面加载进入内存中的顺序,并把页面放入一个链表中。有可能删除存在时间最长但是还在使用的页面,因此这个算法也不是一个很好的选择。 第二次机会算法是对 FIFO 的一个修改,它会在删除页面之前检查这个页面是否仍在使用。如果页面正在使用,就会进行保留。这个改进大大提高了性能。 时钟 算法是第二次机会算法的另外一种实现形式,时钟算法和第二次算法的性能差不多,但是会花费更少的时间来执行算法。 LRU 算法是一个非常优秀的算法,但是没有特殊的硬件(TLB)很难实现。如果没有硬件,就不能使用 LRU 算法。 NFU 算法是一种近似于 LRU 的算法,它的性能不是非常好。 老化 算法是一种更接近 LRU 算法的实现,并且可以更好的实现,因此是一个很好的选择 最后两种算法都使用了工作集算法。工作集算法提供了合理的性能开销,但是它的实现比较复杂。WSClock 是另外一种变体,它不仅能够提供良好的性能,而且可以高效地实现。最好的算法是老化算法和 WSClock 算法。他们分别是基于 LRU 和工作集算法。他们都具有良好的性能并且能够被有效的实现。还存在其他一些好的算法,但实际上这两个可能是最重要的。 23.影响调度程序的指标是什么 会有下面几个因素决定调度程序的好坏 CPU 使用率: CPU 正在执行任务(即不处于空闲状态)的时间百分比。 等待时间 这是进程轮流执行的时间,也就是进程切换的时间 吞吐量 单位时间内完成进程的数量 响应时间 这是从提交流程到获得有用输出所经过的时间。 周转时间 从提交流程到完成流程所经过的时间。 24.什么是僵尸进程 僵尸进程是已完成且处于终止状态,但在进程表中却仍然存在的进程。僵尸进程通常发生在父子关系的进程中,由于父进程仍需要读取其子进程的退出状态所造成的。

优秀的个人博客,低调大师

高频Redis面试题解析:Redis 事务是否具备原子性?

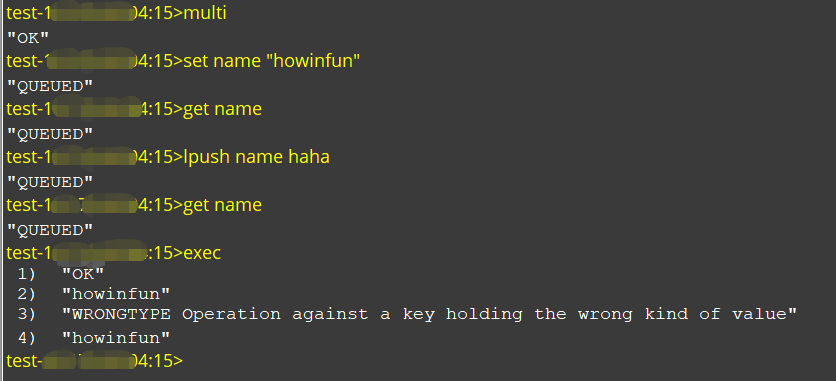
一、Redis 事务的实现原理 一个事务从开始到结束通常会经历以下三个阶段: 1、事务开始 客户端发送 MULTI 命令,服务器执行 MULTI 命令逻辑。 服务器会在客户端状态(redisClient)的 flags 属性打开 REDIS_MULTI 标识,将客户端从非事务状态切换到事务状态。 void multiCommand(redisClient *c) { // 不能在事务中嵌套事务 if (c->flags & REDIS_MULTI) { addReplyError(c,"MULTI calls can not be nested"); return; } // 打开事务 FLAG c->flags |= REDIS_MULTI; addReply(c,shared.ok); } 2、命令入队 接着,用户可以在客户端输入当前事务要执行的多个命令。 当客户端切换到事务状态时,服务器会根据客户端发来的命令来执行不同的操作。 如果客户端发送的命令为 EXEC、DISCARD、WATCH、MULTI 四个命令的其中一个,那么服务器立即执行这个命令。 与此相反,如果客户端发送的命令是 EXEC、DISCARD、WATCH、MULTI 四个命令以外的其他命令,那么服务器并不立即执行这个命令。 首先检查此命令的格式是否正确,如果不正确,服务器会在客户端状态(redisClient)的 flags 属性打开 REDIS_MULTI 标识,并且返回错误信息给客户端。 如果正确将这个命令放入一个事务队列里面,然后向客户端返回 QUEUED 回复。 我们先看看事务队列是如何实现的? 每个 Redis 客户端都有自己的事务状态,对应的是客户端状态(redisClient)的 mstate 属性。 typeof struct redisClient{ // 事务状态 multiState mstate; } redisClient; 事务状态(mstate)包含一个事务队列(FIFO 队列),以及一个已入队命令的计数器。 /* * 事务状态 */ typedef struct multiState { // 事务队列,FIFO 顺序 multiCmd *commands; /* Array of MULTI commands */ // 已入队命令计数 int count; /* Total number of MULTI commands */ int minreplicas; /* MINREPLICAS for synchronous replication */ time_t minreplicas_timeout; /* MINREPLICAS timeout as unixtime. */ } multiState; 事务队列是一个 multiCmd 类型数组,数组中每个 multiCmd 结构都保存了一个如入队命令的相关信息:指向命令实现函数的指针,命令的参数,以及参数的数量。 /* * 事务命令 */ typedef struct multiCmd { // 参数 robj **argv; // 参数数量 int argc; // 命令指针 struct redisCommand *cmd; } multiCmd; 最后我们再看看入队列的源码: /* Add a new command into the MULTI commands queue * * 将一个新命令添加到事务队列中 */ void queueMultiCommand(redisClient *c) { multiCmd *mc; int j; // 为新数组元素分配空间 c->mstate.commands = zrealloc(c->mstate.commands, sizeof(multiCmd)*(c->mstate.count+1)); // 指向新元素 mc = c->mstate.commands+c->mstate.count; // 设置事务的命令、命令参数数量,以及命令的参数 mc->cmd = c->cmd; mc->argc = c->argc; mc->argv = zmalloc(sizeof(robj*)*c->argc); memcpy(mc->argv,c->argv,sizeof(robj*)*c->argc); for (j = 0; j < c->argc; j++) incrRefCount(mc->argv[j]); // 事务命令数量计数器增一 c->mstate.count++; } 当然了,还有我们上面提到的,如果命令入队出错时,会打开客户端状态的 REDIS_DIRTY_EXEC 标识。 /* Flag the transacation as DIRTY_EXEC so that EXEC will fail. * * 将事务状态设为 DIRTY_EXEC ,让之后的 EXEC 命令失败。 * * Should be called every time there is an error while queueing a command. * * 每次在入队命令出错时调用 */ void flagTransaction(redisClient *c) { if (c->flags & REDIS_MULTI) c->flags |= REDIS_DIRTY_EXEC; } 3、事务执行 客户端发送 EXEC 命令,服务器执行 EXEC 命令逻辑。 如果客户端状态的 flags 属性不包含 REDIS_MULTI 标识,或者包含 REDIS_DIRTY_CAS 或者 REDIS_DIRTY_EXEC 标识,那么就直接取消事务的执行。 否则客户端处于事务状态(flags 有 REDIS_MULTI 标识),服务器会遍历客户端的事务队列,然后执行事务队列中的所有命令,最后将返回结果全部返回给客户端; void execCommand(redisClient *c) { int j; robj **orig_argv; int orig_argc; struct redisCommand *orig_cmd; int must_propagate = 0; /* Need to propagate MULTI/EXEC to AOF / slaves? */ // 客户端没有执行事务 if (!(c->flags & REDIS_MULTI)) { addReplyError(c,"EXEC without MULTI"); return; } /* Check if we need to abort the EXEC because: * * 检查是否需要阻止事务执行,因为: * * 1) Some WATCHed key was touched. * 有被监视的键已经被修改了 * * 2) There was a previous error while queueing commands. * 命令在入队时发生错误 * (注意这个行为是 2.6.4 以后才修改的,之前是静默处理入队出错命令) * * A failed EXEC in the first case returns a multi bulk nil object * (technically it is not an error but a special behavior), while * in the second an EXECABORT error is returned. * * 第一种情况返回多个批量回复的空对象 * 而第二种情况则返回一个 EXECABORT 错误 */ if (c->flags & (REDIS_DIRTY_CAS|REDIS_DIRTY_EXEC)) { addReply(c, c->flags & REDIS_DIRTY_EXEC ? shared.execaborterr : shared.nullmultibulk); // 取消事务 discardTransaction(c); goto handle_monitor; } /* Exec all the queued commands */ // 已经可以保证安全性了,取消客户端对所有键的监视 unwatchAllKeys(c); /* Unwatch ASAP otherwise we'll waste CPU cycles */ // 因为事务中的命令在执行时可能会修改命令和命令的参数 // 所以为了正确地传播命令,需要现备份这些命令和参数 orig_argv = c->argv; orig_argc = c->argc; orig_cmd = c->cmd; addReplyMultiBulkLen(c,c->mstate.count); // 执行事务中的命令 for (j = 0; j < c->mstate.count; j++) { // 因为 Redis 的命令必须在客户端的上下文中执行 // 所以要将事务队列中的命令、命令参数等设置给客户端 c->argc = c->mstate.commands[j].argc; c->argv = c->mstate.commands[j].argv; c->cmd = c->mstate.commands[j].cmd; /* Propagate a MULTI request once we encounter the first write op. * * 当遇上第一个写命令时,传播 MULTI 命令。 * * This way we'll deliver the MULTI/..../EXEC block as a whole and * both the AOF and the replication link will have the same consistency * and atomicity guarantees. * * 这可以确保服务器和 AOF 文件以及附属节点的数据一致性。 */ if (!must_propagate && !(c->cmd->flags & REDIS_CMD_READONLY)) { // 传播 MULTI 命令 execCommandPropagateMulti(c); // 计数器,只发送一次 must_propagate = 1; } // 执行命令 call(c,REDIS_CALL_FULL); /* Commands may alter argc/argv, restore mstate. */ // 因为执行后命令、命令参数可能会被改变 // 比如 SPOP 会被改写为 SREM // 所以这里需要更新事务队列中的命令和参数 // 确保附属节点和 AOF 的数据一致性 c->mstate.commands[j].argc = c->argc; c->mstate.commands[j].argv = c->argv; c->mstate.commands[j].cmd = c->cmd; } // 还原命令、命令参数 c->argv = orig_argv; c->argc = orig_argc; c->cmd = orig_cmd; // 清理事务状态 discardTransaction(c); /* Make sure the EXEC command will be propagated as well if MULTI * was already propagated. */ // 将服务器设为脏,确保 EXEC 命令也会被传播 if (must_propagate) server.dirty++; handle_monitor: /* Send EXEC to clients waiting data from MONITOR. We do it here * since the natural order of commands execution is actually: * MUTLI, EXEC, ... commands inside transaction ... * Instead EXEC is flagged as REDIS_CMD_SKIP_MONITOR in the command * table, and we do it here with correct ordering. */ if (listLength(server.monitors) && !server.loading) replicationFeedMonitors(c,server.monitors,c->db->id,c->argv,c->argc); } 二、为什么很多人说 Redis 事务为何不支持原子性? 1、Redis 事务不支持事务回滚机制 Redis 事务执行过程中,如果一个命令执行出错,那么就返回错误,然后还是会接着继续执行下面的命令。 下面我们演示一下: 正是因为 Redis 事务不支持事务回滚机制,如果事务执行中出现了命令执行错误(例如对 String 类型的数据库键执行 LPUSH 操作),只会返回当前命令执行的错误给客户端,并不会影响下面的命令的执行。所以很多人觉得和关系型数据库(MySQL) 不一样,而 MySQL 的事务是具有原子性的,所以大家都认为 Redis 事务不支持原子性。 2、但是其实 Redis 意义上是支持原子性的。 正常情况下,它也是要不所有命令执行成功,要不一个命令都不执行。 我们下面演示一下: 全部执行成功的: 一个都不执行: 这就是上面提到的,在事务开始后,用户可以输入事务要执行的命令;在命令入事务队列前,会对命令进行检查,如果命令不存在或者是命令参数不对,则会返回错误可客户端,并且修改客户端状态。 当后面客户端执行 EXEC 命令时,服务器就会直接拒绝执行此事务了。 所以说,Redis 事务其实是支持原子性的!即使 Redis 不支持事务回滚机制,但是它会检查每一个事务中的命令是否错误。 但是我们要注意一个点就是:Redis 事务不支持检查那些程序员自己逻辑错误。例如对 String 类型的数据库键执行对 HashMap 类型的操作! 我很赞同 Redis 作者的想法: 首先,MySQL 和 Redis 的定位不一样,一个是关系型数据库,一个是 NoSQL。 MySQL 的 SQL 查询是可以相当复杂的,而且 MySQL 没有事务队列这种说法,SQL 真正开始执行才会进行分析和检查,MySQL 不可能提前知道下一条 SQL 是否正确。所以支持事务回滚是非常有必要的~ 但是,Redis 使用了事务队列来预先将执行命令存储起来,并且会对其进行格式检查的,提前就知道命令是否可执行了。所以如果只要有一个命令是错误的,那么这个事务是不能执行的。 Redis 作者认为基本只会出现在开发环境的编程错误其实在生产环境基本是不可能出现的(例如对 String 类型的数据库键执行 LPUSH 操作),所以他觉得没必要为了这事务回滚机制而改变 Redis 追求简单高效的设计主旨。
优秀的个人博客,低调大师

面试官:MySQL的自增ID用完了,怎么办?

既然这块知识点不清楚,那回头就自己动手实践下。 首先,创建一个最简单的表,只包含一个自增id,并插入一条数据。 createtablet0(idintunsignedauto_incrementprimarykey);insert intot0values(null); 通过show命令 show create table t0; 查看表情况 CREATETABLE`t0`(`id`int(10)unsignedNOTNULLAUTO_INCREMENT, PRIMARYKEY(`id`))ENGINE=InnoDBAUTO_INCREMENT=2DEFAULT CHARSET=utf8 可以发现 AUTO_INCREMENT 已经自动变成2,这离用完还有很远,我们可以算下最大当前声明的自增ID最大是多少,由于这里定义的是 intunsigned,所以最大可以达到2的32幂次方 - 1 = 4294967295 这里有个小技巧,可以在创建表的时候,直接声明AUTO_INCREMENT的初始值 createtablet1(idintunsignedauto_incrementprimarykey) auto_increment=4294967295;insertintot1values(null); 同样,通过show命令,查看t1的表结构 CREATETABLE`t1`(`id`int(10)unsignedNOTNULLAUTO_INCREMENT, PRIMARYKEY(`id`))ENGINE=InnoDBAUTO_INCREMENT=4294967295DEFAULT CHARSET=utf8 可以发现,AUTO_INCREMENT已经变成4294967295了,当想再尝试插入一条数据时,得到了下面的异常结果 17:28:03insertintot1values(null)ErrorCode:1062.Duplicate entry'4294967295'forkey'PRIMARY'0.00054sec 说明,当再次插入时,使用的自增ID还是 4294967295,报主键冲突的错误。 4294967295,这个数字已经可以应付大部分的场景了,如果你的服务会经常性的插入和删除数据的话,还是存在用完的风险,建议采用bigint unsigned,这个数字就大了。 不过,还存在另一种情况,如果在创建表没有显示申明主键,会怎么办? 如果是这种情况,InnoDB会自动帮你创建一个不可见的、长度为6字节的row_id,而且InnoDB 维护了一个全局的 dictsys.row_id,所以未定义主键的表都共享该row_id,每次插入一条数据,都把全局row_id当成主键id,然后全局row_id加1 该全局row_id在代码实现上使用的是bigint unsigned类型,但实际上只给row_id留了6字节,这种设计就会存在一个问题:如果全局row_id一直涨,一直涨,直到2的48幂次-1时,这个时候再+1,row_id的低48位都为0,结果在插入新一行数据时,拿到的row_id就为0,存在主键冲突的可能性。 所以,为了避免这种隐患,每个表都需要定一个主键。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册