首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

大厂面试真题:“JDK 线程池”如何保证“核心线程”不被销毁?

2 --> 前言 很早之前那个时候练习线程池, 就是感觉线程池类似于 ArrayList 这种集合类结构, 将 Thread类存储, 来任务了就进行消费, 然鹅... 线程包装类 线程池并不是对 Thread 直接存储, 而是对 Thread 进行了一层包装, 包装类叫做 Worker 线程在线程池中的存储结构如下: private final HashSet<Worker> workers = new HashSet<Worker>(); 先看一下 Worker 类中的变量及方法 private final class Worker extends AbstractQueuedSynchronizer implements Runnable { /** * 此线程为线程池中的工作线程 */ final Thread thread; /** * 指定线程运行的第一项任务 * 第一项任务没有则为空 */ Worker(Runnable firstTask) { ... this.firstTask = firstTask; this.thread = getThreadFactory().newThread(this); } /** * 运行传入的 Runnable 任务 */ @Override public void run() { runWorker(this); } } 通过 Worker 的构造方法和重写的 run 得知:线程池提交的任务, 会由 Worker 中的 thread 进行执行调用 addWorker 这里还是要先放一下线程池的执行流程代码, 具体流程如下: public void execute(Runnable command) { ... int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { // 【重点】关注方法 if (addWorker(command, true)) return; c = ctl.get(); } if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (!isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0) addWorker(null, false); } else if (!addWorker(command, false)) reject(command); } 我们具体看一下 ThreadPoolExecutor#addWorker private boolean addWorker(Runnable firstTask, boolean core) { ... // worker运行标识 boolean workerStarted = false; // worker添加标识 boolean workerAdded = false; Worker w = null; try { // 调用Worker构造方法 w = new Worker(firstTask); // 获取Worker中工作线程 final Thread t = w.thread; if (t != null) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { int rs = runStateOf(ctl.get()); if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { if (t.isAlive()) throw new IllegalThreadStateException(); // 如无异常, 将w添加至workers workers.add(w); int s = workers.size(); if (s > largestPoolSize) // 更新池内最大线程 largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { // 启动Woker中thread工作线程 t.start(); // 设置启动成功标识成功 workerStarted = true; } } } finally { // 如果启动失败抛出异常终止, 将Worker从workers中移除 if (!workerStarted) addWorkerFailed(w); } return workerStarted; } 这里需要着重关心下 t.start(), t 是我们 Worker 中的工作线程 上文说到 Worker 实现了 Runnable 接口, 并重写了 run 方法, 所以 t.start() 最终还是会调用 Worker 中的 run() @Override public void run() { runWorker(this); } runWorker ThreadPoolExecutor#runWorker 是具体执行线程池提交任务的方法, 大致思路如下: 1、获取 Worker 中的第一个任务 2、如果第一个任务不为空则执行具体流程 3、第一个任务为空则从阻塞队列中获取任务, 这一点也是核心线程不被回收的关键 runWorker() 中有两个扩展方法, beforeExecute、afterExecute, 在任务执行前后输出一些重要信息, 可用作与监控等... final void runWorker(Worker w) { Thread wt = Thread.currentThread(); Runnable task = w.firstTask; w.firstTask = null; w.unlock(); // allow interrupts boolean completedAbruptly = true; try { // 【重点】getTask() 是核心线程不被回收的精髓 while (task != null || (task = getTask()) != null) { w.lock(); ... try { beforeExecute(wt, task); Throwable thrown = null; try { task.run(); } ... } finally { afterExecute(task, thrown); } } finally { // 【重点】执行完任务后, 将Task置空 task = null; w.completedTasks++; w.unlock(); } } completedAbruptly = false; } finally { // 退出Worker processWorkerExit(w, completedAbruptly); } } 关键关注下 while 循环, 内部会在执行完流程后将 task 设置为空, 这样就会跳出循环 可以看到 processWorkerExit 是在 finally 语句块中, 相当于 获取不到阻塞队列任务就会去关闭 Worker 线程池是如何保证核心线程获取不到任务时不被销毁呢? 我们继续看一下 getTask() 中是如何获取任务 getTask ThreadPoolExecutor#getTask 只做了一件事情, 就是从线程池的阻塞队列中获取任务返回 private Runnable getTask() { boolean timedOut = false; // Did the last poll() time out? for (; ; ) { int c = ctl.get(); int rs = runStateOf(c); // Check if queue empty only if necessary. if (rs >= SHUTDOWN && (rs >= STOP || workQueue.isEmpty())) { decrementWorkerCount(); return null; } int wc = workerCountOf(c); boolean timed = allowCoreThreadTimeOut || wc > corePoolSize; if ((wc > maximumPoolSize || (timed && timedOut)) && (wc > 1 || workQueue.isEmpty())) { if (compareAndDecrementWorkerCount(c)) return null; continue; } try { Runnable r = timed ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) : workQueue.take(); if (r != null) return r; timedOut = true; } catch (InterruptedException retry) { timedOut = false; } } } timed 重点代码从上面截出来, 首先是判断是否需要获取阻塞队列任务时在规定时间返回 /** * 【重点】判断线程是否超时, 这里会针对两种情况判断 * 1. 设置allowCoreThreadTimeOut参数默认false * 如果为true表示核心线程也会进行超时回收 * 2. 判断当前线程池的数量是否大于核心线程数 * * 这里参与了或运算符, 只要其中一个判断符合即为True */ boolean timed = allowCoreThreadTimeOut || wc > corePoolSize; 根据 timed 属性, 判断获取阻塞队列中任务的方式 /** * 【重点】根据timed判断两种不同方式的任务获取 * 1. 如果为True, 表示线程会根据规定时间调用阻塞队列任务 * 2. 如果为False, 表示线程会进行阻塞调用 */ Runnable r = timed ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) : workQueue.take(); 这里就比较清楚了, 如果 timed 为 True, 线程经过 非核心线程过期时间后还没有获取到任务, 则方法结束, 后续会将 Worker 进行回收 如果没有设置 allowCoreThreadTimeOut 为 True, 以及当前线程池内线程数量不大于核心线程 那么从阻塞队列获取的话是 take(), take() 会 一直阻塞, 等待任务的添加返回 这样也就间接达到了核心线程数不会被回收的效果 getTask流程 “图片本来是要放上面的, 但是画的实在有点不忍直视 ️” 核心线程与非核心线程区别 核心线程只是一个叫法, 核心线程与非核心线程的区别是: 创建核心线程时会携带一个任务, 而非核心线程没有 如果核心线程执行完第一个任务, 线程池内线程无区别 线程池是期望达到 corePoolSize 的并发状态, 不关心最先添加到线程池的核心线程是否会被销毁

优秀的个人博客,低调大师

Netty面试常驻题:你知道Netty的零拷贝机制吗?

理解零拷贝 零拷贝是Netty的重要特性之一,而究竟什么是零拷贝呢?WIKI中对其有如下定义: "Zero-copy" describes computer operations in which the CPU does not perform the task of copying data from one memory area to another. 从WIKI的定义中,我们看到“零拷贝”是指计算机操作的过程中,CPU不需要为数据在内存之间的拷贝消耗资源。而它通常是指计算机在网络上发送文件时,不需要将文件内容拷贝到用户空间(User Space)而直接在内核空间(Kernel Space)中传输到网络的方式。 Non-Zero Copy方式: Zero Copy方式: 从上图中可以清楚的看到,Zero Copy的模式中,避免了数据在用户空间和内存空间之间的拷贝,从而提高了系统的整体性能。Linux中的sendfile()以及Java NIO中的FileChannel.transferTo()方法都实现了零拷贝的功能,而在Netty中也通过在FileRegion中包装了NIO的FileChannel.transferTo()方法实现了零拷贝。 而在Netty中还有另一种形式的零拷贝,即Netty允许我们将多段数据合并为一整段虚拟数据供用户使用,而过程中不需要对数据进行拷贝操作,这也是我们今天要讲的重点。我们都知道在stream-based transport(如TCP/IP)的传输过程中,数据包有可能会被重新封装在不同的数据包中,例如当你发送如下数据时: 有可能实际收到的数据如下: 因此在实际应用中,很有可能一条完整的消息被分割为多个数据包进行网络传输,而单个的数据包对你而言是没有意义的,只有当这些数据包组成一条完整的消息时你才能做出正确的处理,而Netty可以通过零拷贝的方式将这些数据包组合成一条完整的消息供你来使用。而此时,零拷贝的作用范围仅在用户空间中。 以Netty 3.8.0.Final的源代码来进行说明 ###ChannelBuffer接口 Netty为需要传输的数据制定了统一的ChannelBuffer接口。该接口的主要设计思路如下: 1.使用getByte(int index)方法来实现随机访问 2.使用双指针的方式实现顺序访问 每个Buffer都有一个读指针(readIndex)和写指针(writeIndex) 在读取数据时读指针后移,在写入数据时写指针后移 定义了统一的接口之后,就是来做各种实现了。Netty主要实现了HeapChannelBuffer,ByteBufferBackedChannelBuffer等等,下面我们就来讲讲与Zero Copy直接相关的CompositeChannelBuffer类。###CompositeChannelBuffer类 CompositeChannelBuffer类的作用是将多个ChannelBuffer组成一个虚拟的ChannelBuffer来进行操作。 为什么说是虚拟的呢,因为CompositeChannelBuffer并没有将多个ChannelBuffer真正的组合起来,而只是保存了他们的引用,这样就避免了数据的拷贝,实现了Zero Copy。下面我们来看看具体的代码实现,首先是成员变量 private int readerIndex; private int writerIndex; private ChannelBuffer[] components; private int[] indices; private int lastAccessedComponentId; 以上这里列出了几个比较重要的成员变量。其中readerIndex既读指针和writerIndex既写指针是从AbstractChannelBuffer继承而来的;然后components是一个ChannelBuffer的数组,他保存了组成这个虚拟Buffer的所有子Buffer,indices是一个int类型的数组,它保存的是各个Buffer的索引值;最后的lastAccessedComponentId是一个int值,它记录了最后一次访问时的子Buffer ID。 从这个数据结构,我们不难发现所谓的CompositeChannelBuffer实际上就是将一系列的Buffer通过数组保存起来,然后实现了ChannelBuffer 的接口,使得在上层看来,操作这些Buffer就像是操作一个单独的Buffer一样。 创建 接下来,我们再看一下CompositeChannelBuffer.setComponents方法,它会在初始化CompositeChannelBuffer时被调用。 /** * Setup this ChannelBuffer from the list */ private void setComponents(List<ChannelBuffer> newComponents) { assert !newComponents.isEmpty(); // Clear the cache. lastAccessedComponentId = 0; // Build the component array. components = new ChannelBuffer[newComponents.size()]; for (int i = 0; i < components.length; i ++) { ChannelBuffer c = newComponents.get(i); if (c.order() != order()) { throw new IllegalArgumentException( "All buffers must have the same endianness."); } assert c.readerIndex() == 0; assert c.writerIndex() == c.capacity(); components[i] = c; } // Build the component lookup table. indices = new int[components.length + 1]; indices[0] = 0; for (int i = 1; i <= components.length; i ++) { indices[i] = indices[i - 1] + components[i - 1].capacity(); } // Reset the indexes. setIndex(0, capacity()); } 通过代码可以看到该方法的功能就是将一个ChannelBuffer的List给组合起来。它首先将List中得元素放入到components数组中,然后创建indices用于数据的查找,最后使用setIndex来重置指针。这里需要注意的是setIndex(0, capacity())会将读指针设置为0,写指针设置为当前Buffer的长度,这也就是前面需要做assert c.readerIndex() == 0和assert c.writerIndex() == c.capacity()这两个判断的原因,否则很容易会造成数据重复读写的问题。 所以Netty推荐我们使用ChannelBuffers.wrappedBuffer方法来进行Buffer的合并,因为在该方法中Netty会通过slice()方法来确保构建CompositeChannelBuffer是传入的所有子Buffer都是符合要求的。 数据访问 CompositeChannelBuffer.getByte(int index)的实现如下: public byte getByte(int index) { int componentId = componentId(index); return components[componentId].getByte(index - indices[componentId]); } 从代码我们可以看到,在随机查找时会首先通过index获取这个字节所在的componentId既字节所在的子Buffer序列,然后通过index - indices[componentId]计算出它在这个子Buffer中的第几个字节,然后返回结果。 下面再来看一下componentId(int index) 的实现: private int componentId(int index) { int lastComponentId = lastAccessedComponentId; if (index >= indices[lastComponentId]) { if (index < indices[lastComponentId + 1]) { return lastComponentId; } // Search right for (int i = lastComponentId + 1; i < components.length; i ++) { if (index < indices[i + 1]) { lastAccessedComponentId = i; return i; } } } else { // Search left for (int i = lastComponentId - 1; i >= 0; i --) { if (index >= indices[i]) { lastAccessedComponentId = i; return i; } } } throw new IndexOutOfBoundsException("Invalid index: " + index + ", maximum: " + indices.length); } 从代码中我们发现,Netty以lastComponentId既上次访问的子Buffer序号为中心,向左右两边进行搜索,这样做的目的是,当我们两次随机查找的字符序列相近时(大部分情况下都是这样),可以最快的搜索到目标索引的componentId。 写在最后 欢迎大家关注我的公众号【风平浪静如码】,海量Java相关文章,学习资料都会在里面更新,整理的资料也会放在里面。 觉得写的还不错的就点个赞,加个关注呗!点关注,不迷路,持续更新!!!

优秀的个人博客,低调大师

面试官灵魂拷问:什么是MySQL索引?为什么需要索引?

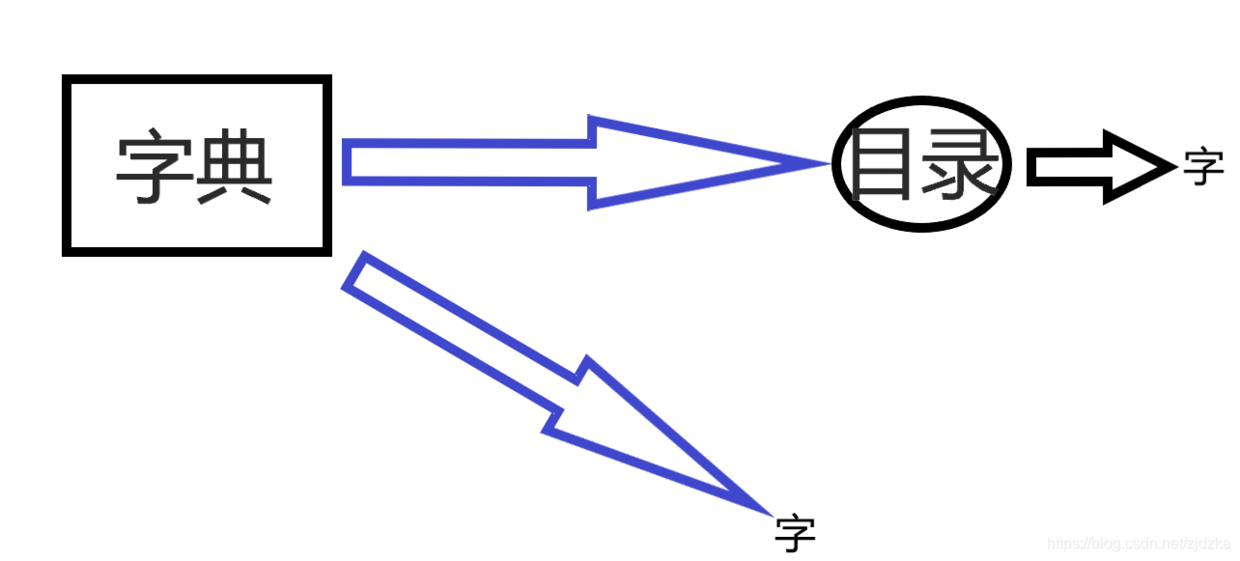
为什么需要学MySQL? 我们每天都在访问各种⽹站、APP,如微信、QQ、抖⾳、今⽇头条、腾讯新闻等,这些 东西上⾯都存在⼤量的信息,这些信息都需要有地⽅存储,存储在哪呢?数据库。 所以如果我们需要开发⼀个⽹站、app,数据库我们必须掌握的技术,常⽤的数据库有 mysql、oracle、sqlserver、db2等。 上⾯介绍的⼏个数据库,oracle性能排名第⼀,服务也是相当到位的,但是收费也是⾮常 ⾼的,⾦融公司对数据库稳定性要求⽐较⾼,⼀般会选择oracle。 mysql是免费的,其他⼏个⽬前暂时收费的,mysql在互联⽹公司使⽤率也是排名第⼀, 资料也⾮常完善,社区也⾮常活跃,所以我们主要学习mysql。 篇幅所限,本文只详写了MySQL索引,需要的同学可自行领取完整版MySQL学习笔记 一、什么是索引? 索引就好比字典的目录一样 我们通常都会先去目录查找关键偏旁或者字母再去查找 要比直接翻查字典查询要快很多 二、为什么要有索引? 然而我们在使用mysql数据库的时候也像字典一样有索引的情况下去查询,肯定速度要快很多 2.1问题: 1.mysql数据存储在什么地方? 磁盘 2.查询数据慢,一般卡在哪? IO 3.去磁盘读取数据,是用多少读取多少吗? 磁盘预读 局部性原理:数据和程序都有聚集成群的倾向,同时之前被访问过的数据很可能再次被查询,空间局部性,时间局部性 磁盘预读:内存和磁盘发生数据交互的时候,一般情况下有一个最小的逻辑单元,页。 页一般由操作系统觉得大小,4k或8k,而我们在进行数据交互的时候,可以取页的整数倍来读取。 关注公众号:北游学Java 即可获取一份578页PDF文档的MySQL学习笔记 innodb存储引擎每次读取数据,读取16k 4.索引存储在哪? 磁盘,查询数据的时候会优先将索引加载到内存中 5.索引在存储的时候,需要什么信息?需要存储存储什么字段值? key:实际数据行中存储的值 文件地址 offset:偏移量 6.这种格式的数据要使用什么样的数据结构来进行存储? key-values 哈希表,树(二叉树、红黑树、AVL树、B树、B+树) 7.mysql索引系统中不是按照刚刚说的格式存储的,为什么? OLAP:联机分析处理----对海量历史数据进行分析,产生决策性的策略----数据仓库—Hive OLTP:联机事务处理----要求很短时效内返回对应的结果----数据库—关系型数据库(mysql、oracle) 三、mysql的索引数据结构 3.1哈希表: HashMap数组加链表的结构,不适合作为索引的原因: 1.哈希冲突会造成数据散列不均匀,会产生大量的线性查询,比较浪费时间 2.不支持范围查询,当进行范围查询的时候,必须挨个遍历 3.对于内存空间的要求比较高 优点:如果是等值查询,非常快 在mysql中有没有hash索引? 1.memory存储引擎使用的是hash索引 2.innodb支持自适应hash createtabletest(idintprimarykey,namevarchar(30)) engine='innodb/memory/myisam' --5.1之后默认innodb复制代码 3.2树: 树这种数据结构有很多,我们常见的有: 二叉树、BST、AVL、红黑树、B树、B+树 ①二叉树:无序插入 这就是我们的树的结构图,但是二叉树的数据插入是无序的,也就是说当需要查找的时候,还是得一个一个挨着去遍历查找 ②BST(二叉搜索树): 插入的数据有序,左子树必须小于根节点,右子树必须大于根节点--------使用二分查找来提高效率 这样的话如果要查询数据,可以通过二分查找,快速缩小范围,减少了时间复杂度 **但是如果插入的顺序是升序或者降序的话,树的形状会变成如下: 此时二叉搜索树就会退化成链表,时间复杂度又会变成O(n) ③AVL:平衡二叉树 为了解决上述问题,通过左旋转或右旋转让树平衡 最短子树跟最长子树高度只差不能超过1 由图我们可以看到,当顺序插入的时候,会自动的进行旋转,以达到平衡 但是会通过插入性能的损失来弥补查询性能的提升 当我们插入的数据很多时候,而查询很少的时候,由于插入数据会旋转同样会消耗很多时间 ④红黑树(解决了读写请求一样多) 同样是经过左右旋让树平衡起来,还要变色的行为 最长子树只要不超过最短子树的两倍即可 查询性能和插入性能近似取得平衡 但是随着数据的插入、发现树的深度会变深,树的深度会越来越深,意味着IO次数越多,影响数据读取的效率 ⑤ B树 为了解决上述数据插入过多,树深度变深的问题,我们采用B树 把原来的有序二叉树变成有序多叉树 举例:如果要查询select * from table where id=14? 第一步,将磁盘一加载到内存中,发现14<16,寻找地址磁盘2 第二步,将磁盘二加载到内存中,发现14>11,寻找地址磁盘7 第三步,将磁盘七加载到内存中,发现14=14,读取data,取出data,结束 思考:B树就是完美的嘛? 问题1: B树不支持范围查询的快速查找,如果我们查询一个范围的数据,查找到范围一个边界时,需要回到根节点重新遍历查找,需要从根节点进行多次遍历,即便找到范围的另一个边界,查询效率会降低。问题2: 如果data存储的是行记录,行的大小随着列数的增多,所占空间会变大。这时,一个页中可存储的数据量就会变少,树相应就会变高,磁盘IO次数就会变大。 思考2:三层B树能够存储多少条记录?答:假设一个data为1k,innodb存储引擎一次读取数据为16k,三层即161616=4096; 但是往往在开发中,一个表的数据要远远大于4096,难道要继续加层,这样岂不就加大了IO 四、为什么使用B+树? 实际存储表数据的时候,怎么存储呢? key 完整的数据行 改造B+树 B+树对B树进行了改进,把数据全放在了叶子节点中,叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。例如: 查询范围 select * from table where id between 11 and 35? 第一步,将磁盘一加载到内存中,发现11<28,寻找地址磁盘2 第二步,将磁盘二加载到内存中,发现10>11>17,寻找地址磁盘5 第三步,将磁盘五加载到内存中,发现11=11,读取data 第四步,继续向右查询,读取磁盘5,发现35=35,读取11-35之间数据,结束 由此可见,这样的范围查询比B树速度提高了不少 对比B树和B+树? 叶子节点中才放数据 非叶子节点中不存储数据 B+树每个节点包含更多个节点,这样做的好处,可以降低树的高度,同时将数据范围变成多个区间,区间越多查询越快 问题:创建索引时用int还是varchar? 答:视情况而定,但是记住一定让key越小越好 五、索引的创建 在创建索引之前,我先说一下存储引擎 存储引擎:表示不同的数据在磁盘的不同表现形式 大家去观察mysql的磁盘文件会发现 innodb:innodb的数据和索引都存储在一个文件下.idb myisam:myisam的索引存储在.MYI文件中,数据存储在.MYD中 5.1聚簇索引和非聚簇索引 概念:判断是否是聚簇索引就看数据和索引是否在一个文件中 innodb: 只能有一个聚簇索引,但是有很多非聚簇索引 向innodb插入数据的时候,必须要包含一个索引的key值 这个索引的key值,可以是主键,如果没有主键,那么就是唯一键,如果没有唯一键,那么就是一个自生成的6字节的rowid myisam:非聚簇索引 MySQL—innodb----B+树 索引和数据存储在一起,找到索引即可读取对应的数据 MySQL—myisam----B+树 索引和存储数据的地址在一起,找到索引得到地址值,再通过地址找到对应的数据 5.2回表 接下来,我会创建一张案例表给大家展示 CREATETABLEuser_test( idINTPRIMARYKEYAUTO_INCREMENT,--id为主键 unameVARCHAR(20), ageINT, genderVARCHAR(10), KEY`idx_uname`(`uname`)--索引选择为名字 )ENGINE=INNODB; INSERTINTOuser_testVALUES(1,'张三',18,'男'); INSERTINTOuser_testVALUES(NULL,'马冬梅',19,'女'); INSERTINTOuser_testVALUES(NULL,'赵四',18,'男'); INSERTINTOuser_testVALUES(NULL,'王老七',22,'男'); INSERTINTOuser_testVALUES(NULL,'刘燕',16,'女'); INSERTINTOuser_testVALUES(NULL,'万宝',26,'男');复制代码 select*fromuser_testwhereuname='张三'; --当我们表中有主键索引的时候,我们再去设置一个uname为索引,那么此时这条sql语句的查询过程应该如下:复制代码 首先先根据uname查询到id,再根据id查询到行的信息 这样的操作走了两棵B+树,就是回表 当根据普通索引查询到聚簇索引的key值之后,再根据key值在聚簇索引中获取数据 我们可以发现这样的操作是很浪费时间的,因此我们日常操作的时候,尽量减少回表的次数 5.3覆盖索引 selectid,unamefromtablewhereuname='张三'; --根据uname可以直接查询到id,uname两个列的值,直接返回即可 --不需要从聚簇索引查询任何数据,此时叫做索引覆盖复制代码 5.4最左匹配 在说最左匹配之前,我们先聊一下几个名词 主键(一般为一个列)-------->联合主键(多个列) 索引-------->联合索引(可能包含多个索引列) --假设有一张表,有id,name,age,gender四个字段,id是主键,name,age是组合索引列 --组合索引使用的时候必须先匹配name,然后匹配age select*fromtablewherename=?andage=?;--生效 select*fromtablewherename=?;--生效 select*fromtablewhereage=?;--不生效 select*fromtablewhereage=?andname=?;--生效 --在mysql内部有优化器会调整对应的顺序复制代码 5.5索引下推 mysql5.7之后,默认支持的一个特点 举一个例子: select*fromtablewherename=?andage=?; --mysql里的三层架构: --客户端:JDBC --服务端:server --存储引擎:数据存储 在没有索引下推之前,根据name从存储引擎中获取符合规则的数据,在server层对age进行过滤 有索引下推之后,根据name、age两个条件从存储引擎中获取对应的数据复制代码 分析:有索引下推的好处,如果我们有50条数据,我们通过过滤会得到10条数据,如果没有索引下推,会先获取50条再去排除得到10条,而有了下推之后,我们会直接在存储引擎就过滤成了10条

优秀的个人博客,低调大师

大厂面试超高频MySQL题目(含答案):基础+索引+事务+锁

MySQL基础篇 公众号:Java架构师联盟,每日更新技术好文 说一下 MySQL 执行一条查询语句的内部执行过程? 客户端先通过连接器连接到 MySQL 服务器。 连接器权限验证通过之后,先查询是否有查询缓存,如果有缓存(之前执行过此语句)则直接返回缓存数据,如果没有缓存则进入分析器。 分析器会对查询语句进行语法分析和词法分析,判断 SQL 语法是否正确,如果查询语法错误会直接返回给客户端错误信息,如果语法正确则进入优化器。 优化器是对查询语句进行优化处理,例如一个表里面有多个索引,优化器会判别哪个索引性能更好。 优化器执行完就进入执行器,执行器就开始执行语句进行查询比对了,直到查询到满足条件的所有数据,然后进行返回。 MySQL 提示“不存在此列”是执行到哪个节点报出的? 此错误是执行到分析器阶段报出的,因为 MySQL 会在分析器阶段检查 SQL 语句的正确性。 MySQL 查询缓存的功能有何优缺点? MySQL 查询缓存功能是在连接器之后发生的,它的优点是效率高,如果已经有缓存则会直接返回结果。 查询缓存的缺点是失效太频繁导致缓存命中率比较低,任何更新表操作都会清空查询缓存,因此导致查询缓存非常容易失效。 如何关闭 MySQL 的查询缓存功能? MySQL 查询缓存默认是开启的,配置 querycachetype 参数为 DEMAND(按需使用)关闭查询缓存,MySQL 8.0 之后直接删除了查询缓存的功能。 MySQL 的常用引擎都有哪些? MySQL 的常用引擎有 InnoDB、MyISAM、Memory 等,从 MySQL 5.5.5 版本开始 InnoDB 就成为了默认的存储引擎。 MySQL 可以针对表级别设置数据库引擎吗?怎么设置? 可以针对不同的表设置不同的引擎。在 create table 语句中使用 engine=引擎名(比如Memory)来设置此表的存储引擎。完整代码如下: create table student( id int primary key auto_increment, username varchar(120), age int ) ENGINE=Memory 常用的存储引擎 InnoDB 和 MyISAM 有什么区别? InnoDB 和 MyISAM 最大的区别是 InnoDB 支持事务,而 MyISAM 不支持事务,它们主要区别如下: InnoDB 支持崩溃后安全恢复,MyISAM 不支持崩溃后安全恢复; InnoDB 支持行级锁,MyISAM 不支持行级锁,只支持到表锁; InnoDB 支持外键,MyISAM 不支持外键; MyISAM 性能比 InnoDB 高; MyISAM 支持 FULLTEXT 类型的全文索引,InnoDB 不支持 FULLTEXT 类型的全文索引,但是 InnoDB 可以使用 sphinx 插件支持全文索引,并且效果更好; InnoDB 主键查询性能高于 MyISAM。 InnoDB 有哪些特性? 1)插入缓冲(insert buffer):对于非聚集索引的插入和更新,不是每一次直接插入索引页中,而是首先判断插入的非聚集索引页是否在缓冲池中,如果在,则直接插入,否则,先放入一个插入缓冲区中。好似欺骗数据库这个非聚集的索引已经插入到叶子节点了,然后再以一定的频率执行插入缓冲和非聚集索引页子节点的合并操作,这时通常能将多个插入合并到一个操作中,这就大大提高了对非聚集索引执行插入和修改操作的性能。 2)两次写(double write):两次写给 InnoDB 带来的是可靠性,主要用来解决部分写失败(partial page write)。doublewrite 有两部分组成,一部分是内存中的 doublewrite buffer ,大小为 2M,另外一部分就是物理磁盘上的共享表空间中连续的 128 个页,即两个区,大小同样为 2M。当缓冲池的作业刷新时,并不直接写硬盘,而是通过 memcpy 函数将脏页先拷贝到内存中的 doublewrite buffer,之后通过 doublewrite buffer 再分两次写,每次写入 1M 到共享表空间的物理磁盘上,然后马上调用 fsync 函数,同步磁盘。如下图所示 3)自适应哈希索引(adaptive hash index):由于 InnoDB 不支持 hash 索引,但在某些情况下 hash 索引的效率很高,于是出现了 adaptive hash index 功能, InnoDB 存储引擎会监控对表上索引的查找,如果观察到建立 hash 索引可以提高性能的时候,则自动建立 hash 索引。 一张自增表中有三条数据,删除了两条数据之后重启数据库,再新增一条数据,此时这条数据的 ID 是几? 如果这张表的引擎是 MyISAM,那么 ID=4,如果是 InnoDB 那么 ID=2(MySQL 8 之前的版本)。 MySQL 中什么情况会导致自增主键不能连续? 以下情况会导致 MySQL 自增主键不能连续: 唯一主键冲突会导致自增主键不连续; 事务回滚也会导致自增主键不连续。 InnoDB 中自增主键能不能被持久化? 自增主键能不能被持久化,说的是 MySQL 重启之后 InnoDB 能不能恢复重启之前的自增列,InnoDB 在 8.0 之前是没有持久化能力的,但 MySQL 8.0 之后就把自增主键保存到 redo log(一种日志类型,下文会详细讲)中,当 MySQL 重启之后就会从 redo log 日志中恢复。 什么是独立表空间和共享表空间?它们的区别是什么? 共享表空间:指的是数据库的所有的表数据,索引文件全部放在一个文件中,默认这个共享表空间的文件路径在 data 目录下。 独立表空间:每一个表都将会生成以独立的文件方式来进行存储。 共享表空间和独立表空间最大的区别是如果把表放再共享表空间,即使表删除了空间也不会删除,所以表依然很大,而独立表空间如果删除表就会清除空间。 如何设置独立表空间? 独立表空间是由参数 innodbfileper_table 控制的,把它设置成 ON 就是独立表空间了,从 MySQL 5.6.6 版本之后,这个值就默认是 ON 了。 如何进行表空间收缩? 使用重建表的方式可以收缩表空间,重建表有以下三种方式: alter table t engine=InnoDB optmize table t truncate table t 说一下重建表的执行流程? 建立一个临时文件,扫描表 t 主键的所有数据页; 用数据页中表 t 的记录生成 B+ 树,存储到临时文件中; 生成临时文件的过程中,将所有对 t 的操作记录在一个日志文件(row log)中; 临时文件生成后,将日志文件中的操作应用到临时文件,得到一个逻辑数据上与表 t相同的数据文件; 用临时文件替换表 t 的数据文件。 表的结构信息存在哪里? 表结构定义占有的存储空间比较小,在 MySQL 8 之前,表结构的定义信息存在以 .frm 为后缀的文件里,在 MySQL 8 之后,则允许把表结构的定义信息存在系统数据表之中。 什么是覆盖索引? 覆盖索引是指,索引上的信息足够满足查询请求,不需要再回到主键上去取数据。 如果把一个 InnoDB 表的主键删掉,是不是就没有主键,就没办法进行回表查询了? 可以回表查询,如果把主键删掉了,那么 InnoDB 会自己生成一个长度为 6 字节的 rowid 作为主键。 执行一个 update 语句以后,我再去执行 hexdump 命令直接查看 ibd 文件内容,为什么没有看到数据有改变呢? 可能是因为 update 语句执行完成后,InnoDB 只保证写完了 redo log、内存,可能还没来得及将数据写到磁盘。 内存表和临时表有什么区别? 内存表,指的是使用 Memory 引擎的表,建表语法是 create table … engine=memory。这种表的数据都保存在内存里,系统重启的时候会被清空,但是表结构还在。除了这两个特性看上去比较“奇怪”外,从其他的特征上看,它就是一个正常的表。 而临时表,可以使用各种引擎类型 。如果是使用 InnoDB 引擎或者 MyISAM 引擎的临时表,写数据的时候是写到磁盘上的。 并发事务会带来哪些问题? 脏读 修改丢失 不可重复读 幻读 什么是脏读和幻读? 脏读是一个事务在处理过程中读取了另外一个事务未提交的数据;幻读是指同一个事务内多次查询返回的结果集不一样(比如增加了或者减少了行记录)。 为什么会出现幻读?幻读会带来什么问题? 因为行锁只能锁定存在的行,针对新插入的操作没有限定,所以就有可能产生幻读。 幻读带来的问题如下: 对行锁语义的破坏; 破坏了数据一致性。 如何避免幻读? 使用间隙锁的方式来避免出现幻读。间隙锁,是专门用于解决幻读这种问题的锁,它锁的了行与行之间的间隙,能够阻塞新插入的操作 间隙锁的引入也带来了一些新的问题,比如:降低并发度,可能导致死锁。 如何查看 MySQL 的空闲连接? 在 MySQL 的命令行中使用 show processlist; 查看所有连接,其中 Command 列显示为 Sleep 的表示空闲连接,如下图所示: MySQL 中的字符串类型都有哪些? MySQL 的字符串类型和取值如下: 类型取值范围CHAR(N)0~255VARCHAR(N)0~65536TINYBLOB0~255BLOB0~65535MEDUIMBLOB0~167772150LONGBLOB0~4294967295TINYTEXT0~255TEXT0~65535MEDIUMTEXT0~167772150LONGTEXT0~4294967295VARBINARY(N)0~N个字节的变长字节字符集BINARY(N)0~N个字节的定长字节字符集 VARCHAR 和 CHAR 的区别是什么?分别适用的场景有哪些? VARCHAR 和 CHAR 最大区别就是,VARCHAR 的长度是可变的,而 CHAR 是固定长度,CHAR 的取值范围为1-255,因此 VARCHAR 可能会造成存储碎片。由于它们的特性决定了 CHAR 比较适合长度较短的字段和固定长度的字段,如身份证号、手机号等,反之则适合使用 VARCHAR。 MySQL 存储金额应该使用哪种数据类型?为什么? MySQL 存储金额应该使用 decimal ,因为如果存储其他数据类型,比如 float 有导致小数点后数据丢失的风险。 limit 3,2 的含义是什么? 去除前三条数据之后查询两条信息。 now() 和 current_date() 有什么区别? now() 返回当前时间包含日期和时分秒,current_date() 只返回当前时间,如下图所示: 如何去重计算总条数? 使用 distinct 去重,使用 count 统计总条数,具体实现脚本如下: select count(distinct f) from t last*insert*id() 函数功能是什么?有什么特点? lastinsertid() 用于查询最后一次自增表的编号,它的特点是查询时不需要不需要指定表名,使用 select last_insert_id() 即可查询,因为不需要指定表名所以它始终以最后一条自增编号为主,可以被其它表的自增编号覆盖。比如 A 表的最大编号是 10,lastinsertid() 查询出来的值为 10,这时 B 表插入了一条数据,它的最大编号为 3,这个时候使用 lastinsertid() 查询的值就是 3。 删除表的数据有几种方式?它们有什么区别? 删除数据有两种方式:delete 和 truncate,它们的区别如下: delete 可以添加 where 条件删除部分数据,truncate 不能添加 where 条件只能删除整张表; delete 的删除信息会在 MySQL 的日志中记录,而 truncate 的删除信息不被记录在 MySQL 的日志中,因此 detele 的信息可以被找回而 truncate 的信息无法被找回; truncate 因为不记录日志所以执行效率比 delete 快。 delete 和 truncate 的使用脚本如下: delete from t where username='redis'; truncate table t; MySQL 中支持几种模糊查询?它们有什么区别? MySQL 中支持两种模糊查询:regexp 和 like,like 是对任意多字符匹配或任意单字符进行模糊匹配,而 regexp 则支持正则表达式的匹配方式,提供比 like 更多的匹配方式。 regexp 和 like 的使用示例如下: select * from person where uname like '%SQL%';> select from person where uname regexp '.SQL*.'; MySQL 支持枚举吗?如何实现?它的用途是什么? MySQL 支持枚举,它的实现方式如下: create table t( sex enum('boy','grid') default 'unknown' ); 枚举的作用是预定义结果值,当插入数据不在枚举值范围内,则插入失败,提示错误 Data truncated for column 'xxx' at row n 。 count(column) 和 count(*) 有什么区别? count(column) 和 count() 最大区别是统计结果可能不一致,count(column) 统计不会统计列值为 null 的数据,而 count() 则会统计所有信息,所以最终的统计结果可能会不同。 以下关于 count 说法正确的是? A. count 的查询性能在各种存储引擎下的性能都是一样的。 B. count 在 MyISAM 比 InnoDB 的性能要低。 C. count 在 InnoDB 中是一行一行读取,然后累计计数的。 D. count 在 InnoDB 中存储了总条数,查询的时候直接取出。 答:C 为什么 InnoDB 不把总条数记录下来,查询的时候直接返回呢? 因为 InnoDB 使用了事务实现,而事务的设计使用了多版本并发控制,即使是在同一时间进行查询,得到的结果也可能不相同,所以 InnoDB 不能把结果直接保存下来,因为这样是不准确的。 能否使用 show table status 中的表行数作为表的总行数直接使用?为什么? 不能,因为 show table status 是通过采样统计估算出来的,官方文档说误差可能在 40% 左右,所以 show table status 中的表行数不能直接使用。 以下哪个 SQL 的查询性能最高? A. select count(*) from t where time>1000 and time<4500 B. show table status where name='t' C. select count(id) from t where time>1000 and time<4500 D. select count(name) from t where time>1000 and time<4500 答:B 题目解析:因为 show table status 的表行数是估算出来,而其他的查询因为添加了 where 条件,即使是 MyISAM 引擎也不能直接使用已经存储的总条数,所以 show table status 的查询性能最高。 InnoDB 和 MyISAM 执行 select count(*) from t,哪个效率更高?为什么? MyISAM 效率最高,因为 MyISAM 内部维护了一个计数器,直接返回总条数,而 InnoDB 要逐行统计。 在 MySQL 中有对 count(*) 做优化吗?做了哪些优化? count(*) 在不同的 MySQL 引擎中的实现方式是不相同的,在没有 where 条件的情况下: MyISAM 引擎会把表的总行数存储在磁盘上,因此在执行 count(*) 的时候会直接返回这个这个行数,执行效率很高; InnoDB 引擎中 count(*) 就比较麻烦了,需要把数据一行一行的从引擎中读出来,然后累计基数。 但即使这样,在 InnoDB 中,MySQL 还是做了优化的,我们知道对于 count() 这样的操作,遍历任意索引树得到的结果,在逻辑上都是一样的,因此,MySQL 优化器会找到最小的那颗索引树来遍历,这样就能在保证逻辑正确的前提下,尽量少扫描数据量,从而优化了 count() 的执行效率。 在 InnoDB 引擎中 count(*)、count(1)、count(主键)、count(字段) 哪个性能最高? count(字段)<count(主键 id)<count(1)≈count(*) 题目解析: 对于 count(主键 id) 来说,InnoDB 引擎会遍历整张表,把每一行的 id 值都取出来,返回给 server 层。server 层拿到 id 后,判断是不可能为空的,就按行累加。 对于 count(1) 来说,InnoDB 引擎遍历整张表,但不取值。server 层对于返回的每一行,放一个数字“1”进去,判断是不可能为空的,按行累加。 对于 count(字段) 来说,如果这个“字段”是定义为 not null 的话,一行行地从记录里面读出这个字段,判断不能为 null,按行累加;如果这个“字段”定义允许为 null,那么执行的时候,判断到有可能是 null,还要把值取出来再判断一下,不是 null 才累加。 对于 count(*) 来说,并不会把全部字段取出来,而是专门做了优化,不取值,直接按行累加。 所以最后得出的结果是:count(字段)<count(主键 id)<count(1)≈count(*)。 MySQL 中内连接、左连接、右连接有什么区别? 内连(inner join)— 把匹配的关联数据显示出来; 左连接(left join)— 把左边的表全部显示出来,右边的表显示出符合条件的数据; 右连接(right join)— 把右边的表全部显示出来,左边的表显示出符合条件的数据; 什么是视图?如何创建视图? 视图是一种虚拟的表,具有和物理表相同的功能,可以对视图进行增、改、查操作。视图通常是一个表或者多个表的行或列的子集。 视图创建脚本如下: create view vname as select column_names from table_name where condition 视图有哪些优点? 获取数据更容易,相对于多表查询来说; 视图能够对机密数据提供安全保护; 视图的修改不会影响基本表,提供了独立的操作单元,比较轻量。 MySQL 中“视图”的概念有几个?分别代表什么含义? MySQL 中的“视图”概念有两个,它们分别是: MySQL 中的普通视图也是我们最常用的 view,创建语法是 create view …,它的查询和普通表一样; InnoDB 实现 MVCC(Multi-Version Concurrency Control)多版本并发控制时用到的一致性读视图,它没有物理结构,作用是事务执行期间定于可以看到的数据。 使用 delete 误删数据怎么找回? 可以用 Flashback 工具通过闪回把数据恢复回来。 Flashback 恢复数据的原理是什么? Flashback 恢复数据的原理是是修改 binlog 的内容,拿回原库重放,从而实现数据找回。 MySQL索引篇 ###什么是索引? 索引是一种能帮助 MySQL 提高查询效率的数据结构。 ###索引分别有哪些优点和缺点? 索引的优点如下: 快速访问数据表中的特定信息,提高检索速度。 创建唯一性索引,保证数据表中每一行数据的唯一性。 加速表与表之间的连接。 使用分组和排序进行数据检索时,可以显著减少查询中分组和排序的时间。 索引的缺点: 虽然提高了的查询速度,但却降低了更新表的速度,比如 update、insert,因为更新数据时,MySQL 不仅要更新数据,还要更新索引文件; 建立索引会占用磁盘文件的索引文件。 使用索引注意事项: 使用短索引,短索引不仅可以提高查询速度,更能节省磁盘空间和 I/O 操作; 索引列排序,MySQL 查询只使用一个索引,因此如果 where 子句中已经使用了索引的话,那么 order by 中的列是不会使用索引的,因此数据库默认排序可以符合要求的情况下,不要进行排序操作;尽量不要包含多个列的排序,如果需要最好给这些列创建复合索引; like 语句操作,一般情况下不鼓励使用 like 操作,如果非使用不可, 注意 like "%aaa%" 不会使用索引,而- - like "aaa%"可以使用索引; 不要在列上进行运算; 不适用 NOT IN 和 <> 操作。 ###以下 SQL 有什么问题?该如何优化? select * from t where f/2=100; 该 SQL 会导致引擎放弃索引而全表扫描,尽量避免在索引列上计算。可改为: select * from t where f=100*2; ###为什么 MySQL 官方建议使用自增主键作为表的主键? 因为自增主键是连续的,在插入过程中尽量减少页分裂,即使要进行页分裂,也只会分裂很少一部分;并且自增主键也能减少数据的移动,每次插入都是插入到最后,所以自增主键作为表的主键,对于表的操作来说性能是最高的。 ###自增主键有哪些优缺点? 优点: 数据存储空间很小; 性能最好; 减少页分裂。 缺点: 数据量过大,可能会超出自增长取值范围; 无法满足分布式存储,分库分表的情况下无法合并表; 主键有自增规律,容易被破解; 综上所述:是否需要使用自增主键,需要根据自己的业务场景来设计。如果是单表单库,则优先考虑自增主键,如果是分布式存储,分库分表,则需要考虑数据合并的业务场景来做数据库设计方案。 ###索引有几种类型?分别如何创建? MySQL 的索引有两种分类方式:逻辑分类和物理分类。 按照逻辑分类,索引可分为: 主键索引:一张表只能有一个主键索引,不允许重复、不允许为 NULL; 唯一索引:数据列不允许重复,允许为 NULL 值,一张表可有多个唯一索引,但是一个唯一索引只能包含一列,比如身份证号码、卡号等都可以作为唯一索引; 普通索引:一张表可以创建多个普通索引,一个普通索引可以包含多个字段,允许数据重复,允许 NULL 值插入; 全文索引:让搜索关键词更高效的一种索引。 按照物理分类,索引可分为: 聚集索引:一般是表中的主键索引,如果表中没有显示指定主键,则会选择表中的第一个不允许为 NULL 的唯一索引,如果还是没有的话,就采用 Innodb 存储引擎为每行数据内置的 6 字节 ROWID 作为聚集索引。每张表只有一个聚集索引,因为聚集索引的键值的逻辑顺序决定了表中相应行的物理顺序。聚集索引在精确查找和范围查找方面有良好的性能表现(相比于普通索引和全表扫描),聚集索引就显得弥足珍贵,聚集索引选择还是要慎重的(一般不会让没有语义的自增 id 充当聚集索引); 非聚集索引:该索引中索引的逻辑顺序与磁盘上行的物理存储顺序不同(非主键的那一列),一个表中可以拥有多个非聚集索引。 各种索引的创建脚本如下: -- 创建主键索引 alter table t add primary key add (`id`); -- 创建唯一索引 alter table t add unique (`username`); -- 创建普通索引 alter table t add index index_name (`username`); -- 创建全文索引 alter table t add fulltext (`username`); ###主索引和唯一索引有什么区别? 主索引不能重复且不能为空,唯一索引不能重复,但可以为空; 一张表只能有一个主索引,但可以有多个唯一索引; 主索引的查询性能要高于唯一索引。 ###在 InnDB 中主键索引为什么比普通索引的查询性能高? 因为普通索引的查询会多执行一次检索操作。比如主键查询 select * from t where id=10 只需要搜索 id 的这棵 B+ 树,而普通索引查询 select * from t where f=3 会先查询 f 索引树,得到 id 的值之后再去搜索 id 的 B+ 树,因为多执行了一次检索,所以执行效率就比主键索引要低。 ###什么叫回表查询? 普通索引查询到主键索引后,回到主键索引树搜索的过程,我们称为回表查询。 参考SQL: mysql> create table T( id int primary key, k int not null, name varchar(16), index (k))engine=InnoDB; 如果语句是 select * from T where ID=500,即主键查询方式,则只需要检索主键 ID 字段。 mysql> select * from T where ID=500; +-----+---+-------+ | id | k | name | +-----+---+-------+ | 500 | 5 | name5 | +-----+---+-------+ 如果语句是 select * from T where k=5,即普通索引查询方式,则需要先搜索 k 索引树,得到 ID 的值为 500,再到 ID 索引树搜索一次,这个过程称为回表查询。 mysql> select * from T where k=5; +-----+---+-------+ | id | k | name | +-----+---+-------+ | 500 | 5 | name5 | +-----+---+-------+ 也就是说,基于非主键索引的查询需要多扫描一棵索引树。因此,我们在应用中应该尽量使用主键查询。 ###如何查询一张表的所有索引? SHOW INDEX FROM T 查询表 T 所有索引。 ###MySQL 最多可以创建多少个索引列? MySQL 中最多可以创建 16 个索引列。 ###以下 like 查询会使用索引的是哪一个选项?为什么? A.like '%A%' B.like '%A' C.like 'A%' D.以上都不是 答:C 题目解析:like 查询要走索引,查询字符不能以通配符(%)开始。 ###如何让 like %abc 走索引查询? 我们知道如果要让 like 查询要走索引,查询字符不能以通配符(%)开始,如果要让 like %abc 也走索引,可以使用 REVERSE() 函数来创建一个函数索引,查询脚本如下: select * from t where reverse(f) like reverse('%abc'); ###MySQL 联合索引应该注意什么? 联合索引又叫复合索引,MySQL 中的联合索引,遵循最左匹配原则,比如,联合索引为 key(a,b,c),则能触发索引的搜索组合是 a|ab|abc 这三种查询。 ###联合索引的作用是什么? 联合索引的作用如下: 用于多字段查询,比如,建了一个 key(a,b,c) 的联合索引,那么实际等于建了key(a)、key(a,b)、key(a,b,c)等三个索引,我们知道,每多一个索引,就会多一些写操作和占用磁盘空间的开销,尤其是对大数据量的表来说,这可以减少一部分不必要的开销; 覆盖索引,比如,对于联合索引 key(a,b,c) 来说,如果使用 SQL:select a,b,c from table where a=1 and b = 1 ,就可以直接通过遍历索引取得数据,而无需回表查询,这就减少了随机的 IO 操作,减少随机的 IO 操作,可以有效的提升数据库查询的性能,是非常重要的数据库优化手段之一; 索引列越多,通过索引筛选出的数据越少。 ###什么是最左匹配原则?它的生效原则有哪些? 最左匹配原则也叫最左前缀原则,是 MySQL 中的一个重要原则,说的是索引以最左边的为起点任何连续的索引都能匹配上,当遇到范围查询(>、<、between、like)就会停止匹配。 生效原则来看以下示例,比如表中有一个联合索引字段 index(a,b,c): where a=1 只使用了索引 a; where a=1 and b=2 只使用了索引 a,b; where a=1 and b=2 and c=3 使用a,b,c; where b=1 or where c=1 不使用索引; where a=1 and c=3 只使用了索引 a; where a=3 and b like 'xx%' and c=3 只使用了索引 a,b。 ###列值为 NULL 时,查询会使用到索引吗? 在 MySQL 5.6 以上的 InnoDB 存储引擎会正常触发索引。但为了兼容低版本的 MySQL 和兼容其他数据库存储引擎,不建议使用 NULL 值来存储和查询数据,建议设置列为 NOT NULL,并设置一个默认值,比如 0 和空字符串等,如果是 datetime 类型,可以设置成 1970-01-01 00:00:00 这样的特殊值。 ###以下语句会走索引么? select * from t where year(date)>2018; 不会,因为在索引列上涉及到了运算。 ###能否给手机号的前 6 位创建索引?如何创建? 可以,创建方式有两种: alter table t add index index_phone(phone(6)); create index index_phone on t(phone(6)); ###什么是前缀索引? 前缀索引也叫局部索引,比如给身份证的前 10 位添加索引,类似这种给某列部分信息添加索引的方式叫做前缀索引。 ###为什么要用前缀索引? 前缀索引能有效减小索引文件的大小,让每个索引页可以保存更多的索引值,从而提高了索引查询的速度。但前缀索引也有它的缺点,不能在 order by 或者 group by 中触发前缀索引,也不能把它们用于覆盖索引。 ###什么情况下适合使用前缀索引? 当字符串本身可能比较长,而且前几个字符就开始不相同,适合使用前缀索引;相反情况下不适合使用前缀索引,比如,整个字段的长度为 20,索引选择性为 0.9,而我们对前 10 个字符建立前缀索引其选择性也只有 0.5,那么我们需要继续加大前缀字符的长度,但是这个时候前缀索引的优势已经不明显,就没有创建前缀索引的必要了。 ###什么是业? 页是计算机管理存储器的逻辑块,硬件及操作系统往往将主存和磁盘存储区分割为连续的大小相等的块,每个存储块称为一页。主存和磁盘以页为单位交换数据。数据库系统的设计者巧妙利用了磁盘预读原理,将一个节点的大小设为等于一个页,这样每个节点只需要一次磁盘 IO 就可以完全载入。 ###索引的常见存储算法有哪些? 哈希存储法:以 key、value 方式存储,把值存入数组中使用哈希值确认数据的位置,如果发生哈希冲突,使用链表存储数据; 有序数组存储法:按顺序存储,优点是可以使用二分法快速找到数据,缺点是更新效率,适合静态数据存储; 搜索树:以树的方式进行存储,查询性能好,更新速度快。 ###InnoDB 为什么要使用 B+ 树,而不是 B 树、Hash、红黑树或二叉树? 因为 B 树、Hash、红黑树或二叉树存在以下问题: B 树:不管叶子节点还是非叶子节点,都会保存数据,这样导致在非叶子节点中能保存的指针数量变少(有些资料也称为扇出),指针少的情况下要保存大量数据,只能增加树的高度,导致IO操作变多,查询性能变低; Hash:虽然可以快速定位,但是没有顺序,IO 复杂度高; 二叉树:树的高度不均匀,不能自平衡,查找效率跟数据有关(树的高度),并且 IO 代价高; 红黑树:树的高度随着数据量增加而增加,IO 代价高。 ###为什么 InnoDB 要使用 B+ 谁来存储索引? B+Tree 中的 B 是 Balance,是平衡的意思,它在经典 B Tree 的基础上进行了优化,增加了顺序访问指针,在B+Tree 的每个叶子节点增加一个指向相邻叶子节点的指针,就形成了带有顺序访问指针的 B+Tree,这样就提高了区间访问性能:如果要查询 key 为从 18 到 49 的所有数据记录,当找到 18 后,只需顺着节点和指针顺序遍历就可以一次性访问到所有数据节点,极大提到了区间查询效率(无需返回上层父节点重复遍历查找减少 IO 操作)。 索引本身也很大,不可能全部存储在内存中,因此索引往往以索引文件的形式存储的磁盘上,这样的话,索引查找过程中就要产生磁盘 IO 消耗,相对于内存存取,IO 存取的消耗要高几个数量级,所以索引的结构组织要尽量减少查找过程中磁盘 IO 的存取次数,从而提升索引效率。 综合所述,InnDB 只有采取 B+ 树的数据结构存储索引,才能提供数据库整体的操作性能。 ###唯一索引和普通索引哪个性能更好? 对于查询操作来说:普通索引和唯一索引的性能相近,都是从索引树中进行查询; 对于更新操作来说:唯一索引要比普通索引执行的慢,因为唯一索引需要先将数据读取到内存中,再在内存中进行数据的唯一效验,所以执行起来要比普通索引更慢。 ###优化器选择查询索引的影响因素有哪些? 优化器的目的是使用最小的代价选择最优的执行方案,影响优化器选择索引的因素如下: 扫描行数,扫描的行数越少,执行代价就越少,执行效率就会越高; 是否使用了临时表; 是否排序。 ###MySQL 是如何判断索引扫描行数的多少? MySQL 的扫描行数是通过索引统计列(cardinality)大致得到并且判断的,而索引统计列(cardinality)可以通过查询命令 show index 得到,索引扫描行数的多少就是通过这个值进行判断的。 ###MySQL 是如何得到索引基数的?它准确吗? MySQL 的索引基数并不准确,因为 MySQL 的索引基数是通过采样统计得到的,比如 InnoDb 默认会有 N 个数据页,采样统计会统计这些页面上的不同值得到一个平均值,然后除以这个索引的页面数就得到了这个索引基数。 ###MySQL 如何指定查询的索引? 在 MySQL 中可以使用 force index 强行选择一个索引,具体查询语句如下: select * from t force index(index_t) ###在 MySQL 中指定了查询索引,为什么没有生效? 我们知道在 MySQL 中使用 force index 可以指定查询的索引,但并不是一定会生效,原因是 MySQL 会根据优化器自己选择索引,如果 force index 指定的索引出现在候选索引上,这个时候 MySQL 不会在判断扫描的行数的多少直接使用指定的索引,如果没在候选索引中,即使 force index 指定了索引也是不会生效的。 ###以下 or 查询有什么问题吗?该如何优化? select * from t where num=10 or num=20; 答:如果使用 or 查询会使 MySQL 放弃索引而全表扫描,可以改为: select * from t where num=10 union select * from t where num=20; ###以下查询要如何优化? 表中包含索引: KEY mid (mid) KEY begintime (begintime) KEY dg (day,group) 使用以下 SQL 进行查询: select f from t where day='2010-12-31' and group=18 and begintime<'2019-12-31 12:14:28' order by begintime limit 1; 答:此查询理论上是使用 dg 索引效率更高,通过 explain 可以对比查询扫描次数。由于使用了 order by begintime 则使查询放弃了 dg 索引,而使用 begintime 索引,从侧面印证 order by 关键字会影响查询使用索引,这时可以使查询强制使用索引,改为以下SQL: select f from t use index(dg) where day='2010-12-31' and group=18 and begintime< '2019-12-31 12:14:28' order by begintime limit 1; ###MySQL 会错选索引吗? MySQL 会错选索引,比如 k 索引的速度更快,但是 MySQL 并没有使用而是采用了 v 索引,这种就叫错选索引,因为索引选择是 MySQL 的服务层的优化器来自动选择的,但它在复杂情况下也和人写程序一样出现缺陷。 ###如何解决 MySQL 错选索引的问题? 删除错选的索引,只留下对的索引; 使用 force index 指定索引; 修改 SQL 查询语句引导 MySQL 使用我们期望的索引,比如把 order by b limit 1 改为 order by b,a limit 1 语义是相同的,但 MySQL 查询的时候会考虑使用 a 键上的索引。 ###如何优化身份证的索引? 在中国因为前 6 位代表的是地区,所以很多人的前六位都是相同的,如果我们使用前缀索引为 6 位的话,性能提升也并不是很明显,但如果设置的位数过长,那么占用的磁盘空间也越大,数据页能放下的索引值就越少,搜索效率也越低。针对这种情况优化方案有以下两种: 使用身份证倒序存储,这样设置前六位的意义就很大了; 使用 hash 值,新创建一个字段用于存储身份证的 hash 值。 MySQL事务篇 事务是什么? 事务是一系列的数据库操作,是数据库应用的基本单位。MySQL 事务主要用于处理操作量大,复杂度高的数据。 事务有哪些特性? 在 MySQL 中只有 InnDB 引擎支持事务,它的四个特性如下: 原子性(Atomic):要么全部执行,要么全部不执行; 一致性(Consistency):事务的执行使得数据库从一种正确状态转化为另一种正确状态; 隔离性(Isolation):在事务正确提交之前,不允许把该事务对数据的任何改变提供给其他事务; 持久性(Durability):事务提交后,其结果永久保存在数据库中。 MySQL 中有几种事务隔离级别?分别是什么? MySQL 中有四种事务隔离级别,它们分别是: read uncommited:未提交读,读到未提交数据; read committed:读已提交,也叫不可重复读,两次读取到的数据不一致; repetable read:可重复读; serializable:串行化,读写数据都会锁住整张表,数据操作不会出错,但并发性能极低,开发中很少用到。 MySQL 默认使用 REPEATABLE-READ 的事务隔离级别。 幻读和不可重复读的区别? 不可重复读的重点是修改:在同一事务中,同样的条件,第一次读的数据和第二次读的数据不一样。(因为中间有其他事务提交了修改)。 幻读的重点在于新增或者删除:在同一事务中,同样的条件,,第一次和第二次读出来的记录数不一样。(因为中间有其他事务提交了插入/删除)。 并发事务一般有哪些问题? 更新丢失(Lost Update):当两个或多个事务选择同一行,然后基于最初选定的值更新该行时,由于每个事务都不知道其他事务的存在,就会发生丢失更新问题,最后的更新覆盖了由其他事务所做的更新。例如,两个编辑人员制作了同一文档的电子副本,每个编辑人员独立地更改其副本,然后保存更改后的副本,这样就覆盖了原始文档。 最后保存其更改副本的编辑人员覆盖另一个编辑人员所做的更改,如果在前一个编辑人员完成并提交事务之前,另一个编辑人员不能访问同一文件,则可避免此问题。 脏读(Dirty Reads):一个事务正在对一条记录做修改,在这个事务完成并提交前, 这条记录的数据就处于不一致状态; 这时, 另一个事务也来读取同一条记录,如果不加控制,第二个事务读取了这些脏数据,并据此做进一步的处理,就会产生未提交的数据依赖关系,这种现象被形象地叫做脏读。 不可重复读(Non-Repeatable Reads):一个事务在读取某些数据后的某个时间,再次读取以前读过的数据,却发现其读出的数据已经发生了改变、或某些记录已经被删除了!这种现象就叫做“不可重复读” 。 幻读(Phantom Reads): 一个事务按相同的查询条件重新读取以前检索过的数据,却发现其他事务插入了满足其查询条件的新数据,这种现象就称为“幻读” 。 并发事务有什么什么问题?应该如何解决? 并发事务可能造成:脏读、不可重复读和幻读等问题 ,这些问题其实都是数据库读一致性问题,必须由数据库提供一定的事务隔离机制来解决,解决方案如下: 加锁:在读取数据前,对其加锁,阻止其他事务对数据进行修改。 提供数据多版本并发控制(MultiVersion Concurrency Control,简称 MVCC 或 MCC),也称为多版本数据库:不用加任何锁, 通过一定机制生成一个数据请求时间点的一致性数据快照(Snapshot), 并用这个快照来提供一定级别 (语句级或事务级) 的一致性读取,从用户的角度来看,好象是数据库可以提供同一数据的多个版本。 什么是 MVCC? MVCC 全称是多版本并发控制系统,InnoDB 和 Falcon 存储引擎通过多版本并发控制(MVCC,Multiversion Concurrency Control)机制解决幻读问题。 MVCC 是怎么工作的? InnoDB 的 MVCC 是通过在每行记录后面保存两个隐藏的列来实现,这两个列一个保存了行的创建时间,一个保存行的过期时间(删除时间)。当然存储的并不是真实的时间而是系统版本号(system version number)。每开始一个新的事务,系统版本号都会自动新增,事务开始时刻的系统版本号会作为事务的版本号,用来查询到每行记录的版本号进行比较。 REPEATABLE READ(可重读)隔离级别下 MVCC 如何工作? SELECT:InnoDB 会根据以下条件检查每一行记录:第一,InnoDB 只查找版本早于当前事务版本的数据行,这样可以确保事务读取的行要么是在开始事务之前已经存在要么是事务自身插入或者修改过的。第二,行的删除版本号要么未定义,要么大于当前事务版本号,这样可以确保事务读取到的行在事务开始之前未被删除。 INSERT:InnoDB 为新插入的每一行保存当前系统版本号作为行版本号。 DELETE:InnoDB 为删除的每一行保存当前系统版本号作为行删除标识。 UPDATE:InnoDB 为插入的一行新纪录保存当前系统版本号作为行版本号,同时保存当前系统版本号到原来的行作为删除标识保存这两个版本号,使大多数操作都不用加锁。它不足之处是每行记录都需要额外的存储空间,需要做更多的行检查工作和一些额外的维护工作。 MySQL 事务实现原理是什么? 事务的实现是基于数据库的存储引擎,不同的存储引擎对事务的支持程度不一样。MySQL 中支持事务的存储引擎有InnoDB 和 NDB。 InnoDB 是高版本 MySQL 的默认的存储引擎,因此就以 InnoDB 的事务实现为例,InnoDB 是通过多版本并发控制(MVCC,Multiversion Concurrency Control )解决不可重复读问题,加上间隙锁(也就是并发控制)解决幻读问题。因此 InnoDB 的 RR 隔离级别其实实现了串行化级别的效果,而且保留了比较好的并发性能。事务的隔离性是通过锁实现,而事务的原子性、一致性和持久性则是通过事务日志实现。 如何设置 MySQL 的事务隔离级别? MySQL 事务隔离级别 MySQL.cnf 文件里设置的(默认目录 /etc/my.cnf),在文件的文末添加配置: transaction-isolation = REPEATABLE-READ 可用的配置值:READ-UNCOMMITTED、READ-COMMITTED、REPEATABLE-READ、SERIALIZABLE。 InnoDB 默认的事务隔离级别是什么?如何修改? InnoDB 默认的事务隔离是 repetable read(可重复读);可以通过 set 作用域 transaction isolation level 事务隔离级别 来修改事务的隔离级别,比如: MySQL> set global transaction isolation level read committed; // 设置全局事务隔离级别为 read committed MySQL> set session transaction isolation level read committed; // 设置当前会话事务隔离级别为 read committed InnoDB 如何开启手动提交事务? InnoDB 默认是自动提交事务的,每一次 SQL 操作(非 select 操作)都会自动提交一个事务,如果要手动开启事务需要设置 set autocommit=0 禁止自动提交事务,相当于开启手动提交事务。 在 InnoDB 中设置了 autocommit=0,添加一条信息之后没有手动执行提交操作,请问这条信息可以被查到吗? autocommit=0 表示禁止自动事务提交,在添加操作之后没有进行手动提交,默认情况下其他连接客户端是查询不到此条新增数据的。 如何手动操作事务? 使用 begin 开启事务;rollback 回滚事务;commit 提交事务。具体使用示例如下: begin; insert person(uname,age) values('laowang',18); rollback; commit; MySQL锁片 什么是锁?MySQL 中提供了几类锁? 锁是实现数据库并发控制的重要手段,可以保证数据库在多人同时操作时能够正常运行。MySQL 提供了全局锁、行级锁、表级锁。其中 InnoDB 支持表级锁和行级锁,MyISAM 只支持表级锁。 什么是死锁? 是指两个或两个以上的进程在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去。此时称系统处于死锁状态或系统产生了死锁,这些永远在互相等待的过程称为死锁。 死锁是指两个或两个以上的进程在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去。此时称系统处于死锁状态或系统产生了死锁,这些永远在互相等待的过程称为死锁。 常见的死锁案例有哪些? 将投资的钱拆封几份借给借款人,这时处理业务逻辑就要把若干个借款人一起锁住 select * from xxx where id in (xx,xx,xx) for update。 批量入库,存在则更新,不存在则插入。解决方法 insert into tab(xx,xx) on duplicate key update xx='xx'。 如何处理死锁? 对待死锁常见的两种策略: 通过 innodblockwait_timeout 来设置超时时间,一直等待直到超时; 发起死锁检测,发现死锁之后,主动回滚死锁中的某一个事务,让其它事务继续执行。 如何查看死锁? 使用命令 show engine innodb status 查看最近的一次死锁。 InnoDB Lock Monitor 打开锁监控,每 15s 输出一次日志。使用完毕后建议关闭,否则会影响数据库性能。 如何避免死锁? 为了在单个 InnoDB 表上执行多个并发写入操作时避免死锁,可以在事务开始时通过为预期要修改的每个元祖(行)使用 SELECT … FOR UPDATE 语句来获取必要的锁,即使这些行的更改语句是在之后才执行的。 在事务中,如果要更新记录,应该直接申请足够级别的锁,即排他锁,而不应先申请共享锁、更新时再申请排他锁,因为这时候当用户再申请排他锁时,其他事务可能又已经获得了相同记录的共享锁,从而造成锁冲突,甚至死锁 如果事务需要修改或锁定多个表,则应在每个事务中以相同的顺序使用加锁语句。在应用中,如果不同的程序会并发存取多个表,应尽量约定以相同的顺序来访问表,这样可以大大降低产生死锁的机会 通过 SELECT … LOCK IN SHARE MODE 获取行的读锁后,如果当前事务再需要对该记录进行更新操作,则很有可能造成死锁。 改变事务隔离级别。 InnoDB 默认是如何对待死锁的? InnoDB 默认是使用设置死锁时间来让死锁超时的策略,默认 innodblockwait_timeout 设置的时长是 50s。 如何开启死锁检测? 设置 innodbdeadlockdetect 设置为 on 可以主动检测死锁,在 Innodb 中这个值默认就是 on 开启的状态。 什么是全局锁?它的应用场景有哪些? 全局锁就是对整个数据库实例加锁,它的典型使用场景就是做全库逻辑备份。 这个命令可以使整个库处于只读状态。使用该命令之后,数据更新语句、数据定义语句、更新类事务的提交语句等操作都会被阻塞。 什么是共享锁? 共享锁又称读锁 (read lock),是读取操作创建的锁。其他用户可以并发读取数据,但任何事务都不能对数据进行修改(获取数据上的排他锁),直到已释放所有共享锁。当如果事务对读锁进行修改操作,很可能会造成死锁。 什么是排它锁? 排他锁 exclusive lock(也叫 writer lock)又称写锁。 若某个事物对某一行加上了排他锁,只能这个事务对其进行读写,在此事务结束之前,其他事务不能对其进行加任何锁,其他进程可以读取,不能进行写操作,需等待其释放。 排它锁是悲观锁的一种实现,在上面悲观锁也介绍过。 若事务 1 对数据对象 A 加上 X 锁,事务 1 可以读 A 也可以修改 A,其他事务不能再对 A 加任何锁,直到事物 1 释放 A 上的锁。这保证了其他事务在事物 1 释放 A 上的锁之前不能再读取和修改 A。排它锁会阻塞所有的排它锁和共享锁。 使用全局锁会导致什么问题? 如果在主库备份,在备份期间不能更新,业务停摆,所以更新业务会处于等待状态。 如果在从库备份,在备份期间不能执行主库同步的 binlog,导致主从延迟。 如何处理逻辑备份时,整个数据库不能插入的情况? 如果使用全局锁进行逻辑备份就会让整个库成为只读状态,幸好官方推出了一个逻辑备份工具 MySQLdump 来解决了这个问题,只需要在使用 MySQLdump 时,使用参数 -single-transaction 就会在导入数据之前启动一个事务来保证数据的一致性,并且这个过程是支持数据更新操作的。 如何设置数据库为全局只读锁? 使用命令 flush tables with read lock(简称 FTWRL)就可以实现设置数据库为全局只读锁。 除了 FTWRL 可以设置数据库只读外,还有什么别的方法? 除了使用 FTWRL 外,还可以使用命令 set global readonly=true 设置数据库为只读。 FTWRL 和 set global readonly=true 有什么区别? FTWRL 和 set global readonly=true 都是设置整个数据库为只读状态,但他们最大的区别就是,当执行 FTWRL 的客户端断开之后,整个数据库会取消只读,而 set global readonly=true 会一直让数据处于只读状态。 如何实现表锁? MySQL 里标记锁有两种:表级锁、元数据锁(meta data lock)简称 MDL。表锁的语法是 lock tables t read/write。 可以用 unlock tables 主动释放锁,也可以在客户端断开的时候自动释放。lock tables 语法除了会限制别的线程的读写外,也限定了本线程接下来的操作对象。 对于 InnoDB 这种支持行锁的引擎,一般不使用 lock tables 命令来控制并发,毕竟锁住整个表的影响面还是太大。 MDL:不需要显式使用,在访问一个表的时候会被自动加上。 MDL 的作用:保证读写的正确性。 在对一个表做增删改查操作的时候,加 MDL 读锁;当要对表做结构变更操作的时候,加 MDL 写锁。 读锁之间不互斥,读写锁之间,写锁之间是互斥的,用来保证变更表结构操作的安全性。 MDL 会直到事务提交才会释放,在做表结构变更的时候,一定要小心不要导致锁住线上查询和更新。 悲观锁和乐观锁有什么区别? 顾名思义,就是很悲观,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会 block 直到它拿到锁。正因为如此,悲观锁需要耗费较多的时间,另外与乐观锁相对应的,悲观锁是由数据库自己实现了的,要用的时候,我们直接调用数据库的相关语句就可以了。 说到这里,由悲观锁涉及到的另外两个锁概念就出来了,它们就是共享锁与排它锁。共享锁和排它锁是悲观锁的不同的实现,它俩都属于悲观锁的范畴。 乐观锁是用数据版本(Version)记录机制实现,这是乐观锁最常用的一种实现方式。何谓数据版本?即为数据增加一个版本标识,一般是通过为数据库表增加一个数字类型的 version 字段来实现。当读取数据时,将 version 字段的值一同读出,数据每更新一次,对此 version 值加 1。当我们提交更新的时候,判断数据库表对应记录的当前版本信息与第一次取出来的version值进行比对,如果数据库表当前版本号与第一次取出来的 version 值相等,则予以更新,否则认为是过期数据。 比如: 1、数据库表三个字段,分别是id、value、version select id,value,version from t where id=#{id} 2、每次更新表中的value字段时,为了防止发生冲突,需要这样操作 update t set value=2,version=version+1 where id=#{id} and version=#{version} 乐观锁有什么优点和缺点? 因为没有加锁所以乐观锁的优点就是执行性能高。它的缺点就是有可能产生 ABA 的问题,ABA 问题指的是有一个变量 V 初次读取的时候是 A 值,并且在准备赋值的时候检查到它仍然是 A 值,会误以为没有被修改会正常的执行修改操作,实际上这段时间它的值可能被改了其他值,之后又改回为 A 值,这个问题被称为 ABA 问题。 InnoDB 存储引擎有几种锁算法? Record Lock — 单个行记录上的锁; Gap Lock — 间隙锁,锁定一个范围,不包括记录本身; Next-Key Lock — 锁定一个范围,包括记录本身。 InnoDB 如何实现行锁? 行级锁是 MySQL 中粒度最小的一种锁,他能大大减少数据库操作的冲突。 INNODB 的行级锁有共享锁(S LOCK)和排他锁(X LOCK)两种。共享锁允许事物读一行记录,不允许任何线程对该行记录进行修改。排他锁允许当前事物删除或更新一行记录,其他线程不能操作该记录。 共享锁:SELECT … LOCK IN SHARE MODE,MySQL 会对查询结果集中每行都添加共享锁,前提是当前线程没有对该结果集中的任何行使用排他锁,否则申请会阻塞。 排他锁:select * from t where id=1 for update,其中 id 字段必须有索引,MySQL 会对查询结果集中每行都添加排他锁,在事物操作中,任何对记录的更新与删除操作会自动加上排他锁。前提是当前没有线程对该结果集中的任何行使用排他锁或共享锁,否则申请会阻塞。 优化锁方面你有什么建议? 尽量使用较低的隔离级别。 精心设计索引, 并尽量使用索引访问数据, 使加锁更精确, 从而减少锁冲突的机会。 选择合理的事务大小,小事务发生锁冲突的几率也更小。 给记录集显示加锁时,最好一次性请求足够级别的锁。比如要修改数据的话,最好直接申请排他锁,而不是先申请共享锁,修改时再请求排他锁,这样容易产生死锁。 不同的程序访问一组表时,应尽量约定以相同的顺序访问各表,对一个表而言,尽可能以固定的顺序存取表中的行。这样可以大大减少死锁的机会。 尽量用相等条件访问数据,这样可以避免间隙锁对并发插入的影响。 不要申请超过实际需要的锁级别。 除非必须,查询时不要显示加锁。 MySQL 的 MVCC 可以实现事务中的查询不用加锁,优化事务性能;MVCC 只在 COMMITTED READ(读提交)和 REPEATABLE READ(可重复读)两种隔离级别下工作。 对于一些特定的事务,可以使用表锁来提高处理速度或减少死锁的可能。

优秀的个人博客,低调大师

面试被问:Kafka 会不会丢消息?我是这么答的

点击“程序员内点事”关注,选择“设置星标” 坚持学习,好文每日送达! 大型互联网公司一般都会要求消息传递最大限度的不丢失,比如用户服务给代金券服务发送一个消息,如果消息丢失会造成用户未收到应得的代金券,最终用户会投诉。 为避免上面类似情况的发生,除了做好补偿措施,更应该在系设计的时候充分考虑各种异常,设计一个稳定、高可用的消息系统。 认识Kafka 看一下维基百科的定义 Kafka是分布式发布-订阅消息系统。它最初由LinkedIn公司开发,之后成为Apache项目的一部分。 Kafka是一个分布式的,可划分的,冗余备份的持久性的日志服务。它主要用于处理活跃的流式数据。 kafka架构 Kafka的整体架构非常简单,是显式分布式架构,主要由producer、broker(kafka)和consumer组成。 Kafka架构(精简版) Producer(生产者)可以将数据发布到所选择的topic(主题)中。生产者负责将记录分配到topic的哪一个 partition(分区)中。可以使用循环的方式来简单地实现负载均衡,也可以根据某些语义分区函数(如记录中的key)来完成。 Consumer(消费者)使用一个consumer group(消费组)名称来进行标识,发布到topic中的每条记录被分配给订阅消费组中的一个消费者实例。消费者实例可以分布在多个进程中或者多个机器上。 Kafka到底会不会丢失消息? 在讨论kafka是否丢消息前先来了解一下什么是消息传递语义。 消息传递语义 message delivery semantic 也就是消息传递语义,简单说就是消息传递过程中消息传递的保证性。主要分为三种: at most once:最多一次。消息可能丢失也可能被处理,但最多只会被处理一次。 at least once:至少一次。消息不会丢失,但可能被处理多次。可能重复,不会丢失。 exactly once:精确传递一次。消息被处理且只会被处理一次。不丢失不重复就一次。 理想情况下肯定是希望系统的消息传递是严格exactly once,也就是保证不丢失、只会被处理一次,但是很难做到。 回到主角Kafka,Kafka有三次消息传递的过程: 生产者发消息给Kafka Broker。 Kafka Broker 消息同步和持久化 Kafka Broker 将消息传递给消费者。 在这三步中每一步都有可能会丢失消息,下面详细分析为什么会丢消息,如何最大限度避免丢失消息。 生产者丢失消息 先介绍一下生产者发送消息的一般流程(部分流程与具体配置项强相关,这里先忽略): 生产者是与leader直接交互,所以先从集群获取topic对应分区的leader元数据; 获取到leader分区元数据后直接将消息发给过去; Kafka Broker对应的leader分区收到消息后写入文件持久化; Follower拉取Leader消息与Leader的数据保持一致; Follower消息拉取完毕需要给Leader回复ACK确认消息; Kafka Leader和Follower分区同步完,Leader分区会给生产者回复ACK确认消息。 生产者发送数据流程 生产者采用push模式将数据发布到broker,每条消息追加到分区中,顺序写入磁盘。消息写入Leader后,Follower是主动与Leader进行同步。 Kafka消息发送有两种方式:同步(sync)和异步(async),默认是同步方式,可通过producer.type属性进行配置。 Kafka通过配置request.required.acks属性来确认消息的生产: 0表示不进行消息接收是否成功的确认;不能保证消息是否发送成功,生成环境基本不会用。 1表示当Leader接收成功时确认;只要Leader存活就可以保证不丢失,保证了吞吐量。 -1或者all表示Leader和Follower都接收成功时确认;可以最大限度保证消息不丢失,但是吞吐量低。 kafka producer 的参数acks 的默认值为1,所以默认的producer级别是at least once,并不能exactly once。 敲黑板了,这里可能会丢消息的! 如果acks配置为0,发生网络抖动消息丢了,生产者不校验ACK自然就不知道丢了。 如果acks配置为1保证leader不丢,但是如果leader挂了,恰好选了一个没有ACK的follower,那也丢了。 all:保证leader和follower不丢,但是如果网络拥塞,没有收到ACK,会有重复发的问题。 Kafka Broker丢失消息 Kafka Broker 接收到数据后会将数据进行持久化存储,你以为是下面这样的: 消息持久化,无cache 没想到是这样的: 消息持久化,有cache 操作系统本身有一层缓存,叫做 Page Cache,当往磁盘文件写入的时候,系统会先将数据流写入缓存中,至于什么时候将缓存的数据写入文件中是由操作系统自行决定。 Kafka提供了一个参数 producer.type 来控制是不是主动flush,如果Kafka写入到mmap之后就立即 flush 然后再返回 Producer 叫同步 (sync);写入mmap之后立即返回 Producer 不调用 flush 叫异步 (async)。 敲黑板了,这里可能会丢消息的! Kafka通过多分区多副本机制中已经能最大限度保证数据不会丢失,如果数据已经写入系统 cache 中但是还没来得及刷入磁盘,此时突然机器宕机或者掉电那就丢了,当然这种情况很极端。 消费者丢失消息 消费者通过pull模式主动的去 kafka 集群拉取消息,与producer相同的是,消费者在拉取消息的时候也是找leader分区去拉取。 多个消费者可以组成一个消费者组(consumer group),每个消费者组都有一个组id。同一个消费组者的消费者可以消费同一topic下不同分区的数据,但是不会出现多个消费者消费同一分区的数据。 消费者群组消费消息 消费者消费的进度通过offset保存在kafka集群的__consumer_offsets这个topic中。 消费消息的时候主要分为两个阶段: 1、标识消息已被消费,commit offset坐标; 2、处理消息。 敲黑板了,这里可能会丢消息的! 场景一:先commit再处理消息。如果在处理消息的时候异常了,但是offset 已经提交了,这条消息对于该消费者来说就是丢失了,再也不会消费到了。 场景二:先处理消息再commit。如果在commit之前发生异常,下次还会消费到该消息,重复消费的问题可以通过业务保证消息幂等性来解决。 总结 那么问题来了,kafka到底会不会丢消息?答案是:会! Kafka可能会在三个阶段丢失消息: (1)生产者发送数据; (2)Kafka Broker 存储数据; (3)消费者消费数据; 在生产环境中严格做到exactly once其实是难的,同时也会牺牲效率和吞吐量,最佳实践是业务侧做好补偿机制,万一出现消息丢失可以兜底。 - END - 说两句:学习是一件时而郁郁寡欢时而开环大笑的事情,越过瓶颈又是一片新天地,坚持坚持坚持。 如果对你有用,欢迎 在看、点赞、转发 ,您的认可是我最大的动力。 整理了几百本各类技术电子书,送给小伙伴们。关注公号回复【666】自行领取。和一些小伙伴们建了一个技术交流群,一起探讨技术、共同学习进步,如果感兴趣就加入我们吧! 关注,迈开成长的第一步 本文分享自微信公众号 - 程序员内点事(chengxy-nds)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

后台高性能服务器设计的常见套路, BAT 高频面试

前言 在互联网公司,经常面临一个“三高”问题: 高并发 高性能 高可用 这篇文章将总结一下后台服务器开发中有哪些常用的解决“三高”问题的方法和思想。 希望这些知识,能够给你一丝启发和帮助,助力你收割 各大公司 Offer~ 先上本文思维导图: 正文 一、缓存 什么是缓存?看看维基百科怎么说: > In computing, a cache is a hardware or software component that stores data so that future requests for that data can be served faster; the data stored in a cache might be the result of an earlier computation or a copy of data stored elsewhere. 在计算机中,缓存是存储数据的硬件或软件组件,以便可以更快地满足将来对该数据的请求。 存储在缓存中的数据可能是之前计算结果,也可能是存储在其他位置的数据副本。 缓存本质来说是使用空间换时间的思想,它在计算机世界中无处不在, 比如 CPU 就自带 L1、L2、L3 Cache,这个一般应用开发可能关注较少。但是在一些实时系统、大规模计算模拟、图像处理等追求极致性能的领域,就特别注重编写缓存友好的代码。 什么是缓存友好?简单来说,就是代码在访问数据的时候,尽量使用缓存命中率高的方式。这个后面可以单独写一篇 CPU 缓存系统以及如何编写缓存友好代码的文章。 1.1 缓存为什么有效? 缓存之所以能够大幅提高系统的性能,关键在于数据的访问具有局部性,也就是二八定律:「百分之八十的数据访问是集中在 20% 的数据上」。这部分数据也被叫做热点数据。 缓存一般使用内存作为存储,内存读写速度快于磁盘,但容量有限,十分宝贵,不可能将所有数据都缓存起来。 如果应用访问数据没有热点,不遵循二八定律,即大部分数据访问并没有集中在小部分数据上,那么缓存就没有意义,因为大部分数据还没有被再次访问就已经被挤出缓存了。每次访问都会回源到数据库查询,那么反而会降低数据访问效率。 1.2 缓存分类 1. 本地缓存: 使用进程内成员变量或者静态变量,适合简单的场景,不需要考虑缓存一致性、过期时间、清空策略等问题。 可以直接使用语言标准库内的容器来做存储。例如: 2. 分布式缓存: 当缓存的数据量增大以后,单机不足以承载缓存服务时,就要考虑对缓存服务做水平扩展,引入缓存集群。 将数据分片后分散存储在不同机器中,如何决定每个数据分片存放在哪台机器呢?一般是采用一致性 Hash 算法,它能够保证在缓存集群动态调整,不断增加或者减少机器后,客户端访问时依然能够根据 key 访问到数据。 一致性 Hash 算法也是值得用一篇文章来讲的,如果暂时还不懂的话可以去搜一下。 常用的组件有 Memcache、 Redis Cluster 等,第二个是在高性能内存存储 Redis 的基础上,提供分布式存储的解决方案。 1.3 缓存使用指南 1. 适合缓存的场景: 读多写少: 比如电商里的商品详情页面,访问频率很高,但是一般写入只在店家上架商品和修改信息的时候发生。如果把热点商品的信息缓存起来,这将拦截掉很多对数据库的访问,提高系统整体的吞吐量。 因为一般数据库的 QPS 由于有「ACID」约束、并且数据是持久化在硬盘的,所以比 Redis 这类基于内存的 NoSQL 存储低不少。常常是一个系统的瓶颈,如果我们把大部分的查询都在 Redis 缓存中命中了,那么系统整体的 QPS 也就上去了。 计算耗时大,且实时性不高: 比如王者荣耀里的全区排行榜,一般一周更新一次,并且计算的数据量也比较大,所以计算后缓存起来,请求排行榜直接从缓存中取出,就不用实时计算了。 2. 不适合缓存的场景: 写多读少,频繁更新。 对数据一致性要求严格: 因为缓存会有更新策略,所以很难做到和数据库实时同步。 数据访问完全随机: 因为这样会导致缓存的命中率极低。 1.4 缓存更新的策略 如何更新缓存其实已经有总结得非常好的「最佳实践」,我们按照套路来,大概率不会犯错。 主要分为两类 Cache-Aside 和 Cache-As-SoR。 SoR 即「System Of Record,记录系统」,表示数据源,一般就是指数据库。 1、Cache-Aside: 这应该是最容易想到的模式了,获取数据时先从缓存读,如果 cache hit 则直接返回,没命中就从数据源获取,然后更新缓存。 写数据的时候则先更新数据源,然后设置缓存失效,下一次获取数据的时候必然 cache miss,然后触发回源。 直接看伪代码: 可以看到这种方式对于缓存的使用者是不透明的,需要使用者手动维护缓存。 2、Cache-As-SoR: 从字面上来看,就是把 Cache 当作 SoR,也就是数据源,所以一切读写操作都是针对 Cache 的,由 Cache 内部自己维护和数据源的一致性。 这样对于使用者来说就和直接操作 SoR 没有区别了,完全感知不到 Cache 的存在。 CPU 内部的 L1、L2、L3 Cache 就是这种方式,作为数据的使用方应用程序,是完全感知不到在内存和我们之间还存在几层的 Cache,但是我们之前又提到编写 “缓存友好”的代码,不是透明的吗?这是不是冲突呢? 其实不然,缓存友好是指我们通过学习了解缓存内部实现、更新策略之后,通过调整数据访问顺序提高缓存的命中率。 Cache-As-SoR 又分为以下三种方式: Read Through:这种方式和 Cache-Aside 非常相似,都是在查询时发生 cache miss 去更新缓存,但是区别在于 Cache-Aside 需要调用方手动更新缓存,而 Cache-As-SoR 则是由缓存内部实现自己负责,对应用层透明。 Write Through: 直写式,就是在将数据写入缓存的同时,缓存也去更新后面的数据源,并且必须等到数据源被更新成功后才可返回。这样保证了缓存和数据库里的数据一致性。 Write Back:回写式,数据写入缓存即可返回,缓存内部会异步的去更新数据源,这样好处是写操作特别快,因为只需要更新缓存。并且缓存内部可以合并对相同数据项的多次更新,但是带来的问题就是数据不一致,可能发生写丢失。 二、预处理和延后处理 预先延后,这其实是一个事物的两面,不管是预先还是延后核心思想都是将本来该在实时链路上处理的事情剥离,要么提前要么延后处理。降低实时链路的路径长度, 这样能有效提高系统性能。 2.1 预处理 举个我们团队实际中遇到的问题: 前两个月支付宝联合杭州市政府发放消费劵,但是要求只有杭州市常驻居民才能领取,那么需要在抢卷请求进入后台的时候就判断一下用户是否是杭州常驻居民。 而判断用户是否是常驻居民这个是另外一个微服务接口,如果直接实时的去调用那个接口,短时的高并发很有可能把这个服务也拖挂,最终导致整个系统不可用,并且 RPC 本身也是比较耗时的,所以就考虑在这里进行优化。 那么该怎么做呢?很简单的一个思路,提前将杭州所有常驻居民的 user_id 存到缓存中, 比如可以直接存到 Redis。大概就是千万量级,这样,当请求到来的时候我们直接通过缓存可以快速判断是否来自杭州常驻居民。如果不是则直接在这里返回前端。 这里通过预先处理减少了实时链路上的 RPC 调用,既减少了系统的外部依赖,也极大的提高了系统的吞吐量。 预处理在 CPU 和操作系统中也广泛使用,比如 CPU 基于历史访存信息,将内存中的指令和数据预取到 Cache 中,这样可以大大提高Cache 命中率。 还比如在 Linux 文件系统中,预读算法会预测即将访问的 page,然后批量加载比当前读请求更多的数据缓存在 page cache 中,这样当下次读请求到来时可以直接从 cache 中返回,大大减少了访问磁盘的时间。 2.2 延后处理 还是支付宝,上栗子: 这是支付宝春节集五福活动开奖当晚,不过,作为非酋的我一般是不屑于参与这种活动的。 大家发现没有,这类活动中奖奖金一般会显示 「稍后到账」,为什么呢?那当然是到账这个操作不简单! 到账即转账,A 账户给 B 账户转钱,A 减钱, B 就必须要同时加上钱,也就是说不能 A 减了钱但 B 没有加上,这就会导致资金损失。资金安全是支付业务的生命线,这可不行。 这两个动作必须一起成功或是一起都不成功,不能只成功一半,这是保证数据一致性。 保证两个操作同时成功或者失败就需要用到事务。 如果去实时的做到账,那么大概率数据库的 TPS(每秒处理的事务数) 会是瓶颈。通过产品提示,将到账操作延后处理,解决了数据库 TPS 瓶颈。 延后处理还有一个非常著名的例子,COW(Copy On Write,写时复制)。 Linux 创建进程的系统调用 fork,fork 产生的子进程只会创建虚拟地址空间,而不会分配真正的物理内存,子进程共享父进程的物理空间,只有当某个进程需要写入的时候,才会真正分配物理页,拷贝该物理页,通过 COW 减少了很多不必要的数据拷贝。 三、池化 后台开发过程中你一定离不开各种 「池子」: 内存池、连接池、线程池、对象池...... 内存、连接、线程这些都是资源,创建线程、分配内存、数据库连接这些操作都有一个特征, 那就是创建和销毁过程都会涉及到很多系统调用或者网络 IO。 每次都在请求中去申请创建这些资源,就会增加请求处理耗时,但是如果我们用一个 容器(池) 把它们保存起来,下次需要的时候,直接拿出来使用,避免重复创建和销毁浪费的时间。 3.1 内存池 在 C/C++ 中,经常使用 malloc、new 等 API 动态申请内存。由于申请的内存块大小不一,如果频繁的申请、释放会导致大量的内存碎片,并且这些 API 底层依赖系统调用,会有额外的开销。 内存池就是在使用内存前,先向系统申请一块空间留做备用,使用者需要内池时向内存池申请,用完后还回来。 内存池的思想非常简单,实现却不简单,难点在于以下几点: 如何快速分配内存 降低内存碎片率 维护内存池所需的额外空间尽量少 如果不考虑效率,我们完全可以将内存分为不同大小的块,然后用链表连接起来,分配的时候找到大小最合适的返回,释放的时候直接添加进链表。如: 当然这只是玩具级别的实现,业界有性能非常好的实现了,我们可以直接拿来学习和使用。 比如 Google 的 「tcmalloc」 和 Facebook 的 「jemalloc」。 限于篇幅我们不在这里详细讲解它们的实现原理,如果感兴趣可以搜来看看,也推荐去看看被誉为神书的 CSAPP(《深入理解计算机系统》)第 10 章,那里也讲到了动态内存分配算法。 3.2 线程池 线程是干嘛的?线程就是我们程序执行的实体。在服务器开发领域,我们经常会为每个请求分配一个线程去处理,但是线程的创建销毁、调度都会带来额外的开销,线程太多也会导致系统整体性能下降。在这种场景下,我们通常会提前创建若干个线程,通过线程池来进行管理。当请求到来时,只需从线程池选一个线程去执行处理任务即可。 线程池常常和队列一起使用来实现任务调度,主线程收到请求后将创建对应的任务,然后放到队列里,线程池中的工作线程等待队列里的任务。 线程池实现上一般有四个核心组成部分: 管理器(Manager): 用于创建并管理线程池。 工作线程(Worker): 执行任务的线程。 任务接口(Task): 每个具体的任务必须实现任务接口,工作线程将调用该接口来完成具体的任务。 任务队列(TaskQueue): 存放还未执行的任务。 线程池在 C、C++ 中没有具体的实现,需要应用开发者手动实现上诉几个部分。 在 Java 中 「ThreadPoolExecutor」 类就是线程池的实现。后续我也会写文章分析 C++ 如何写一个简单的线程池以及 Java 中线程池是如何实现的。 3.3 连接池 顾名思义,连接池是创建和管理连接的。 大家最熟悉的莫过于数据库连接池,这里我们简单分析下如果不用数据库连接池,一次 SQL 查询请求会经过哪些步骤: 和 MySQL server 建立 TCP 连接: 三次握手 MySQL 权限认证: Server 向 Client 发送 密钥 Client 使用密钥加密用户名、密码等信息,将加密后的报文发送给 Server Server 根据 Client 请求包,验证是否是合法用户,然后给 Client 发送认证结果 Client 发送 SQL 语句 Server 返回语句执行结果 MySQL 关闭 TCP 连接断开 四次挥手 可以看出不使用连接池的话,为了执行一条 SQL,会花很多时间在安全认证、网络IO上。 如果使用连接池,执行一条 SQL 就省去了建立连接和断开连接所需的额外开销。 还能想起哪里用到了连接池的思想吗?我认为 HTTP 长链接也算一个变相的链接池,虽然它本质上只有一个连接,但是思想却和连接池不谋而合,都是为了复用同一个连接发送多个 HTTP 请求,避免建立和断开连接的开销。 池化实际上是预处理和延后处理的一种应用场景,通过池子将各类资源的创建提前和销毁延后。 四、同步变异步 对于处理耗时的任务,如果采用同步的方式,那么会增加任务耗时,降低系统并发度。 可以通过将同步任务变为异步进行优化。 举个例子,比如我们去 KFC 点餐,遇到排队的人很多,当点完餐后,大多情况下我们会隔几分钟就去问好了没,反复去问了好几次才拿到,在这期间我们也没法干活了,这时候我们是这样的: 这个就叫同步轮训, 这样效率显然太低了。 服务员被问烦了,就在点完餐后给我们一个号码牌,每次准备好了就会在服务台叫号,这样我们就可以在被叫到的时候再去取餐,中途可以继续干自己的事。 这就叫异步,在很多编程语言中有异步编程的库,比如 C++ std::future、Python asyncio 等,但是异步编程往往需要回调函数(Callback function),如果回调函数的层级太深,这就是回调地狱(Callback hell)。回调地狱如何优化又是一个庞大的话题。。。。 这个例子相当于函数调用的异步化,还有的是情况是处理流程异步化,这个会在接下来消息队列中讲到。 五、消息队列 这是一个非常简化的消息队列模型,上游生产者将消息通过队列发送给下游消费者。在这之间,消息队列可以发挥很多作用,比如: 5.1 服务解耦 有些服务被其它很多服务依赖,比如一个论坛网站,当用户成功发布一条帖子有一系列的流程要做,有积分服务计算积分,推送服务向发布者的粉丝推送一条消息..... 对于这类需求,常见的实现方式是直接调用: 这样如果需要新增一个数据分析的服务,那么又得改动发布服务,这违背了依赖倒置原则,即上层服务不应该依赖下层服务,那么怎么办呢? 引入消息队列作为中间层,当帖子发布完成后,发送一个事件到消息队列里,而关心帖子发布成功这件事的下游服务就可以订阅这个事件,这样即使后续继续增加新的下游服务,只需要订阅该事件即可,完全不用改动发布服务,完成系统解耦。 5.2 异步处理 有些业务涉及到的处理流程非常多,但是很多步骤并不要求实时性。那么我们就可以通过消息队列异步处理。比如淘宝下单,一般包括了风控、锁库存、生成订单、短信/邮件通知等步骤。但是核心的就风控和锁库存, 只要风控和扣减库存成功,那么就可以返回结果通知用户成功下单了。后续的生成订单,短信通知都可以通过消息队列发送给下游服务异步处理。大大提高了系统响应速度。 这就是处理流程异步化。 5.3 流量削峰 一般像秒杀、抽奖、抢卷这种活动都伴随着短时间海量的请求, 一般超过后端的处理能力,那么我们就可以在接入层将请求放到消息队列里,后端根据自己的处理能力不断从队列里取出请求进行业务处理。 就像最近长江汛期,上游短时间大量的洪水汇聚直奔下游,但是通过三峡大坝将这些水缓存起来,然后匀速的向下游释放,起到了很好的削峰作用。 起到了平均流量的作用。 5.4 总结 消息队列的核心思想就是把同步的操作变成异步处理,异步处理会带来相应的好处,比如: 服务解耦 提高系统的并发度,将非核心操作异步处理,不会阻塞住主流程 但是软件开发没有银弹,所有的方案选择都是一种 trade-off。 同样,异步处理也不全是好处,也会导致一些问题: 降低了数据一致性,从强一致性变为最终一致性 有消息丢失的风险,比如宕机,需要有容灾机制 六、批量处理 在涉及到网络连接、IO等情况时,将操作批量进行处理能够有效提高系统的传输速率和吞吐量。 在前后端通信中,通过合并一些频繁请求的小资源可以获得更快的加载速度。 比如我们后台 RPC 框架,经常有更新数据的需求,而有的数据更新的接口往往只接受一项,这个时候我们往往会优化下更新接口, 使其能够接受批量更新的请求,这样可以将批量的数据一次性发送,大大缩短网络 RPC 调用耗时。 七、数据库 我们常把后台开发调侃为「CRUD」,数据库在整个应用开发过程中的重要性不言而喻。 而且很多时候系统的瓶颈也往往处在数据库这里,慢的原因也有很多,比如可能是没用索引、没用对索引、读写锁冲突等等。 那么如何使用数据才能又快又好呢?下面这几点需要重点关注: 7.1 索引 索引可能是我们平时在使用数据库过程中接触得最多的优化方式。索引好比图书馆里的书籍索引号,想象一下,如果我让你去一个没有书籍索引号的图书馆找《人生》这本书,你是什么样的感受?当然是怀疑人生,同理,你应该可以理解当你查询数据,却不用索引的时候数据库该有多崩溃了吧。 数据库表的索引就像图书馆里的书籍索引号一样,可以提高我们检索数据的效率。索引能提高查找效率,可是你有没有想过为什么呢?这是因为索引一般而言是一个排序列表,排序意味着可以基于二分思想进行查找,将查询时间复杂度做到 O(log(N)),快速的支持等值查询和范围查询。 二叉搜索树查询效率无疑是最高的,因为平均来说每次比较都能缩小一半的搜索范围,但是一般在数据库索引的实现上却会选择 B 树或 B+ 树而不用二叉搜索树,为什么呢? 这就涉及到数据库的存储介质了,数据库的数据和索引都是存放在磁盘,并且是 InnoDB 引擎是以页为基本单位管理磁盘的,一页一般为 16 KB。AVL 或红黑树搜索效率虽然非常高,但是同样数据项,它也会比 B、B+ 树更高,高就意味着平均来说会访问更多的节点,即磁盘IO次数! > 根据 Google 工程师 Jeff Dean 的统计,访问内存数据耗时大概在 100 ns,访问磁盘则是 10,000,000 ns。 所以表面上来看我们使用 B、B+ 树没有 二叉查找树效率高,但是实际上由于 B、B+ 树降低了树高,减少了磁盘 IO 次数,反而大大提升了速度。 这也告诉我们,没有绝对的快和慢,系统分析要抓主要矛盾,先分析出决定系统瓶颈的到底是什么,然后才是针对瓶颈的优化。 其实关于索引想写的也还有很多,但还是受限于篇幅,以后再单独写。 先把我认为索引必知必会的知识列出来,大家可以查漏补缺: 主键索引和普通索引,以及它们之间的区别 最左前缀匹配原则 索引下推 覆盖索引、联合索引 7.2 读写分离 一般业务刚上线的时候,直接使用单机数据库就够了,但是随着用户量上来之后,系统就面临着大量的写操作和读操作,单机数据库处理能力有限,容易成为系统瓶颈。 由于存在读写锁冲突,并且很多大型互联网业务往往读多写少,读操作会首先成为数据库瓶颈,我们希望消除读写锁冲突从而提升数据库整体的读写能力。 那么就需要采用读写分离的数据库集群方式,一主多从,主库会同步数据到从库。写操作都到主库,读操作都去从库。 读写分离到之后就避免了读写锁争用,这里解释一下,什么叫读写锁争用: MySQL 中有两种锁: 排它锁( X 锁): 事务 T 对数据 A 加上 X 锁时,只允许事务 T 读取和修改数据 A。 共享锁( S 锁): 事务 T 对数据 A 加上 S 锁时,其他事务只能再对数据 A 加 S 锁,而不能加 X 锁,直到 T 释放 A 上的 S 锁。 读写分离解决问题的同时也会带来新问题,比如主库和从库数据不一致 MySQL 的主从同步依赖于 binlog,binlog(二进制日志)是 MySQL Server 层维护的一种二进制日志,是独立于具体的存储引擎。它主要存储对数据库更新(insert、delete、update)的 SQL 语句,由于记录了完整的 SQL 更新信息,所以 binlog 是可以用来数据恢复和主从同步复制的。 从库从主库拉取 binlog 然后依次执行其中的 SQL 即可达到复制主库的目的,由于从库拉取 binlog 存在网络延迟等,所以主从数据存在延迟问题。 那么这里就要看业务是否允许短时间内的数据不一致,如果不能容忍,那么可以通过如果读从库没获取到数据就去主库读一次来解决。 7.3 分库分表 如果用户越来越多,写请求暴涨,对于上面的单 Master 节点肯定扛不住,那么该怎么办呢?多加几个 Master?不行,这样会带来更多的数据不一致的问题,增加系统的复杂度。那该怎么办?就只能对库表进行拆分了。 常见的拆分类型有垂直拆分和水平拆分。 考虑拼夕夕电商系统,一般有 订单表、用户表、支付表、商品表、商家表等, 最初这些表都在一个数据库里。 后来随着砍一刀带来的海量用户,拼夕夕后台扛不住了! 于是紧急从阿狸粑粑那里挖来了几个 P8、P9 大佬对系统进行重构。 P9 大佬第一步先对数据库进行垂直分库, 根据业务关联性强弱,将它们分到不同的数据库, 比如订单库,商家库、支付库、用户库。 第二步是对一些大表进行垂直分表,将一个表按照字段分成多表,每个表存储其中一部分字段。 比如商品详情表可能最初包含了几十个字段,但是往往最多访问的是商品名称、价格、产地、图片、介绍等信息,所以我们将不常访问的字段单独拆成一个表。 由于垂直分库已经按照业务关联切分到了最小粒度,数据量任然非常大,P9 大佬开始水平分库,比如可以把订单库分为订单1库、订单2库、订单3库...... 那么如何决定某个订单放在哪个订单库呢?可以考虑对主键通过哈希算法计算放在哪个库。 分完库,单表数据量任然很大,查询起来非常慢,P9 大佬决定按日或者按月将订单分表,叫做日表、月表。 分库分表同时会带来一些问题,比如平时单库单表使用的主键自增特性将作废,因为某个分区库表生成的主键无法保证全局唯一,这就需要引入全局 UUID 服务了。 经过一番大刀阔斧的重构,拼夕夕恢复了往日的活力,大家又可以愉快的在上面互相砍一刀了。 (分库分表会引入很多问题,并没有一一介绍,这里只是为了讲解什么是分库分表) 八、具体技法 8.1 零拷贝 高性能的服务器应当避免不必要数据复制,特别是在用户空间和内核空间之间的数据复制。 比如 HTTP 静态服务器发送静态文件的时候,一般我们会这样写: 如果了解 Linux IO 的话就知道这个过程包含了内核空间和用户空间之间的多次拷贝: 内核空间和用户空间之间数据拷贝需要 CPU 亲自完成,但是对于这类数据不需要在用户空间进行处理的程序来说,这样的两次拷贝显然是浪费。什么叫 「不需要在用户空间进行处理」? 比如 FTP 或者 HTTP 静态服务器,它们的作用只是将文件从磁盘发送到网络,不需要在中途对数据进行编解码之类的计算操作。 如果能够直接将数据在内核缓存之间移动,那么除了减少拷贝次数以外,还能避免内核态和用户态之间的上下文切换。 而这正是零拷贝(Zero copy)干的事,主要就是利用各种零拷贝技术,减少不必要的数据拷贝,将 CPU 从数据拷贝这样简单的任务解脱出来,让 CPU 专注于别的任务。 常用的零拷贝技术: mmap <kbd>mmap</kbd> 通过内存映射,将文件映射到内核缓冲区,同时,用户空间可以共享内核空间的数据。这样,在进行网络传输时,就可以减少内核空间到用户空间的拷贝次数。 sendfile <kbd>sendfile</kbd> 是 Linux2.1 版本提供的,数据不经过用户态,直接从页缓存拷贝到 socket 缓存,同时由于和用户态完全无关,就减少了一次上下文切换。 在 Linux 2.4 版本,对 sendfile 进行了优化,直接通过 DMA 将磁盘文件数据读取到 socket 缓存,真正实现了 ”0” 拷贝。前面 mmap 和 2.1 版本的 sendfile 实际上只是消除了用户空间和内核空间之间拷贝,而页缓存和 socket 缓存之间的拷贝依然存在。 8.2 无锁化 在多线程环境下,为了避免 竞态条件(race condition), 我们通常会采用加锁来进行并发控制,锁的代价也是比较高的,锁会导致上线文切换,甚至被挂起直到锁被释放。 基于硬件提供的原子操作 CAS(Compare And Swap) 实现一些高性能无锁的数据结构,比如无锁队列,可以在保证并发安全的情况下,提供更高的性能。 首先需要理解什么是 CAS,CAS 有三个操作数,内存里当前值M,预期值 E,修改的新值 N,CAS 的语义就是: 如果当前值等于预期值,则将内存修改为新值,否则不做任何操作。 用 C 语言来表达就是: 注意,上面 CAS 函数实际上是一条原子指令,那么是如何用的呢? 假设我需要实现这样一个功能: 对一个全局变量 global 在两个不同线程分别对它加 100 次,这里多线程访问一个全局变量存在 race condition,所以我们需要采用线程同步操作,下面我分别用锁和CAS的方法来实现这个功能。 通过使用原子操作大大降低了锁冲突的可能性,提高了程序的性能。 除了 CAS,还有一些硬件原子指令: Fetch-And-Add,对变量原子性 + 1 Test-And-Set,这是各种锁算法的核心,在 AT&T/GNU 汇编语法下,叫 xchg 指令,我会单独写一篇如何使用 xchg 实现各种锁。 8.3 序列化与反序列化 先看看维基百科怎么定义的序列化: > In computing, serialization (US spelling) or serialisation (UK spelling) is the process of translating a data structure or object state into a format that can be stored (for example, in a file or memory data buffer) or transmitted (for example, across a computer network) and reconstructed later (possibly in a different computer environment). When the resulting series of bits is reread according to the serialization format, it can be used to create a semantically identical clone of the original object. For many complex objects, such as those that make extensive use of references, this process is not straightforward. Serialization of object-oriented objects does not include any of their associated methods with which they were previously linked. 我相信你大概率没有看完上面的英文描述,其实我也不爱看英文资料,总觉得很慢,但是计算机领域一手的学习资料都是美帝那边的,所以没办法,必须逼自己去试着读一些英文的资料。 实际上也没有那么难,熟悉常用的几百个专业名词,句子都是非常简单的一些从句。没看的话,再倒回去看看? 这里我就不做翻译了,主要是水平太低,估计做到「信达雅」的信都很难。 扯远了,还是回到序列化来。 所有的编程一定是围绕数据展开的,而数据呈现形式往往是结构化的,比如结构体(Struct)、类(Class)。 但是当我们 通过网络、磁盘等传输、存储数据的时候却要求是二进制流。 比如 TCP 连接,它提供给上层应用的是面向连接的可靠字节流服务。那么如何将这些结构体和类转化为可存储和可传输的字节流呢?这就是序列化要干的事情,反之,从字节流如何恢复为结构化的数据就是反序列化。 序列化解决了对象持久化和跨网络数据交换的问题。 序列化一般按照序列化后的结果是否可读,可分为以下两类: 文本类型: 如 JSON、XML,这些类型可读性非常好,是自解释的。也常常用在前后端数据交互上,因为接口调试,可读性高非常方便。但是缺点就是信息密度低,序列化后占用空间大。 二进制类型 如 Protocol Buffer、Thrift等,这些类型采用二进制编码,数据组织得更加紧凑,信息密度高,占用空间小,但是带来的问题就是基本不可读。 还有 Java 、Go 这类语言内置了序列化方式,比如在 Java 里实现了 Serializable 接口即表示该对象可序列化。 说到这让我想起了大一写的的两个程序,一个是用刚 C 语言写的公交管理系统,当时需要将公交线路、站点信息持久化保存,当时的方案就是每个公交线路写在一行,用 "|"分割信息,比如: 5|6:00-22:00|大学城|南山站|北京站 123|6:30-23:00|南湖大道|茶山刘|世界 第一列就是线路编号、第二项是发车时间、后面就是途径的站点。是不是非常原始?实际上这也是一种序列化方式,只是效率很低,也不通用。而且存在一个问题就是如果信息中包含 “|”怎么办?当然是用转义。 第二个程序是用 Java 写的网络五子棋,当时需要通过网络传输表示棋子位置的对象,查了一圈最后发现只需要实现 Serializable 接口,自己什么都不用干,就能自己完成对象的序列化,然后通过网络传输后反序列化。当时哪懂得这就叫序列化,只觉得牛逼、神奇! 最后完成了一个可以网络五子棋,拉着隔壁室友一起玩。。。真的是成就感满满哈哈哈。 说来在编程方面,已经很久没有这样的成就感了。 总结 这篇文章主要是粗浅的介绍了一些系统设计、系统优化的套路和最佳实践。 不知道你发现没有,从缓存到消息队列、CAS......,很多看起来很牛逼的架构设计其实都来源于操作系统、体系结构。 所以我非常热衷学习一些底层的基础知识,这些看似古老的技术是经过时间洗礼留下来的好东西。现在很多的新技术、框架看似非常厉害,实则不少都是新瓶装旧酒,每几年又会被淘汰一批。 > 文章持续更新,全文首发自个人公号,可以微信搜一搜「 编程指北 」第一时间阅读,更有我搜集的上百本经典的计算机书籍电子版

优秀的个人博客,低调大师

2020年前端开发面试必考:什么是前端防抖?

防抖(去抖),以及节流(分流)在日常开发中可能用的不多,但在特定场景,却十分有用。 最近有同学遇到了要做防抖的需求,那今天李老师就来讲解一下,什么是防抖。为了方便查阅和让不了解防抖和节流的同学能针对性的学习,今天只讲解防抖的理解和实践,节流的内容放到下一次讲解。 防抖有两种模式,延时执行和直接执行,这两种方式比较容易让人迷惑,后面我们慢慢讲。 什么是防抖 首先我们先看一个案例需求 以日常开发中常用的搜索按钮为例,若用户点击一次搜索按钮后,不小心“手抖”很快又点了一次按钮,防抖可以规避第二次甚至更多次搜索。 第一个搜索按钮未做任何防抖处理。 搜索按钮A为第一种防抖模式:延时执行。若用户连续快速点击多次,只有最后一次点击结束,延时一段时间后才执行搜索。 搜索按钮B为第二种防抖模式:直接执行。若用户连续快速点击多次,只有第一次点击会执行搜索。 通过上面的案例需求来看,我们可以把防抖理解为:如果遇到多次触发事件,事件处理函数只执行一次。 如何手写防抖 我们理解了什么是防抖,那么我们接下来通过案例来讲一下实现防抖的思路。 假设我们需要实现按钮A的延迟执行的防抖,我们首先需要整理思路: 1.点击搜索按钮,函数是不会马上就执行的,而是等一段时间再执行。 2.若在这段时间里,按钮再次被点击,则出现开始计时,等待同样的一段时间后再执行。 如果我们要实现这个需求,实现发方案有2种,推荐使用第一种,我们可以使用计时器setTimeout来简化代码,这样我们就可以将重点放在是实现防抖的逻辑上了。 方法一 我们可以先画一个实现的流程图 在方法一中,我们的主要核心参数有两个: 等待时长 计时器 根据流程图思路实现方法一的防抖代码: 方法二 我们先画个流程图 在方法2中,我们的主要核心参数有两个: 等待时长 最早可执行时间 根据流程图实现方法二的防抖代码: 同样,我们可以使用类似方法实现搜索按钮B的功能。按钮B是实现直接执行防抖。 需求描述: 点击搜索按钮后,函数马上执行。只有等待一段时间后被点击才能执行函数。 若在这段时间内按钮被点击,则重新计时。 我们先画一个基本的流程图: 核心参数: 等待时长 计时器 根据我们的流程图,实现代码: 接下来就具体测试就可以了,大家可以自己写一遍,自行做一次测试 总结 防抖是一个高阶函数,能够将多个事件函数合并为一个,在“调整window尺寸”,“在搜索框中实时搜索键入文本”, “滚动滚动条”和“防止搜索按钮频繁点击触发多余请求”等案例中,十分有用。 本文分享自微信公众号 - 前端研究所(WEBqdyjs)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册