首页 文章 精选 留言 我的

精选列表

搜索[聚类],共10000篇文章
优秀的个人博客,低调大师

java加密工具类,可设置对应的加解密key

public class AesEncryptUtil { //使用AES-128-CBC加密模式,key需要为16位,key和iv可以相同! private static String KEY ="whshenke20180606"; private static String IV ="whshenke20180606"; /** * 加密方法 * @param data 要加密的数据 * @param key 加密key * @param iv 加密iv * @return 加密的结果 * @throws Exception */ public static String encrypt(String data, String key, String iv) throws Exception { try { Cipher cipher = Cipher.getInstance("AES/CBC/NoPadding");//"算法/模式/补码方式" int blockSize = cipher.getBlockSize(); byte[] dataBytes = data.getBytes(); int plaintextLength = dataBytes.length; if (plaintextLength % blockSize != 0) { plaintextLength = plaintextLength + (blockSize - (plaintextLength % blockSize)); } byte[] plaintext = new byte[plaintextLength]; System.arraycopy(dataBytes, 0, plaintext, 0, dataBytes.length); SecretKeySpec keyspec = new SecretKeySpec(key.getBytes("UTF-8"), "AES"); IvParameterSpec ivspec = new IvParameterSpec(iv.getBytes()); cipher.init(Cipher.ENCRYPT_MODE, keyspec, ivspec); byte[] encrypted = cipher.doFinal(plaintext); return Base64Util.encode(encrypted); } catch (Exception e) { e.printStackTrace(); return null; } } /** * 解密方法 * @param data 要解密的数据 * @param key 解密key * @param iv 解密iv * @return 解密的结果 * @throws Exception whshenke20180606 */ public static String desEncrypt(String data, String key, String iv) { try { byte[] encrypted1 = Base64Util.decode(data); Cipher cipher = Cipher.getInstance("AES/CBC/NoPadding"); SecretKeySpec keyspec = new SecretKeySpec(key.getBytes(), "AES"); IvParameterSpec ivspec = new IvParameterSpec(iv.getBytes()); cipher.init(Cipher.DECRYPT_MODE, keyspec, ivspec); byte[] original = cipher.doFinal(encrypted1); String originalString = new String(original, "UTF-8"); return originalString; } catch (Exception e) { //e.printStackTrace(); return null; } } /** * 使用默认的key和iv加密 * @param data * @return * @throws Exception */ public static String encrypt(String data) throws Exception { return encrypt(data, KEY, IV); } /** * 使用默认的key和iv解密 * @param data * @return * @throws Exception */ public static String desEncrypt(String data){ return desEncrypt(data, KEY, IV); } /** * 测试 */ public static void main(String args[]) throws Exception { //KNnAbiCvFxispeG+wS01jA== //KNnAbiCvFxispeG+wS01jA== //KNnAbiCvFxispeG+wS01jA== String test = "测试"; String data = null; String key = "dufy20170329java"; String iv = "dufy20170329java"; // data = encrypt(test, key, iv); //KNnAbiCvFxispeG+wS01jA== System.out.println(data); System.out.println(desEncrypt("8XguKV2aprVwg4UqEie7f9gkr7xDaSKrGZZD7x1J3uISWkvQAtpq8hpkskwi V+8bJmRcmQWIZ4sRom37GB7w7O4AH+HjH5ixViJ7k6bx+oEFVWSmIqKEj4e5 lMcyXgcXpTB8IGnt1WKS2p7Qnn+cjA==", key, iv)); } }

优秀的个人博客,低调大师

Python爬虫之多线程下载程序类电子书

近段时间,笔者发现一个神奇的网站:http://www.allitebooks.com/ ,该网站提供了大量免费的编程方面的电子书,是技术爱好者们的福音。其页面如下: 那么我们是否可以通过Python来制作爬虫来帮助我们实现自动下载这些电子书呢?答案是yes. 笔者在空闲时间写了一个爬虫,主要利用urllib.request.urlretrieve()函数和多线程来下载这些电子书。 首先呢,笔者的想法是先将这些电子书的下载链接网址储存到本地的txt文件中,便于永久使用。其Python代码(Ebooks_spider.py)如下, 该代码仅下载第一页的10本电子书作为示例: # -*- coding:utf-8 -*- # 本爬虫用来下载http://www.allitebooks.com/中的电子书 # 本爬虫将需要下载的书的链接写入txt文件,便于永久使用 # 网站http://www.allitebooks.com/提供编程方面的电子书 # 导入必要的模块 import urllib.request from bs4 import BeautifulSoup # 获取网页的源代码 def get_content(url): html = urllib.request.urlopen(url) content = html.read().decode('utf-8') html.close() return content # 将762个网页的网址储存在list中 base_url = 'http://www.allitebooks.com/' urls = [base_url] for i in range(2, 762): urls.append(base_url + 'page/%d/' % i) # 电子书列表,每一个元素储存每本书的下载地址和书名 book_list =[] # 控制urls的数量,避免书下载过多导致空间不够!!! # 本例只下载前3页的电子书作为演示 # 读者可以通过修改url[:3]中的数字,爬取自己想要的网页书,最大值为762 for url in urls[:1]: try: # 获取每一页书的链接 content = get_content(url) soup = BeautifulSoup(content, 'lxml') book_links = soup.find_all('div', class_="entry-thumbnail hover-thumb") book_links = [item('a')[0]['href'] for item in book_links] print('\nGet page %d successfully!' % (urls.index(url) + 1)) except Exception: book_links = [] print('\nGet page %d failed!' % (urls.index(url) + 1)) # 如果每一页书的链接获取成功 if len(book_links): for book_link in book_links: # 下载每一页中的电子书 try: content = get_content(book_link) soup = BeautifulSoup(content, 'lxml') # 获取每本书的下载网址 link = soup.find('span', class_='download-links') book_url = link('a')[0]['href'] # 如果书的下载链接获取成功 if book_url: # 获取书名 book_name = book_url.split('/')[-1] print('Getting book: %s' % book_name) book_list.append(book_url) except Exception as e: print('Get page %d Book %d failed' % (urls.index(url) + 1, book_links.index(book_link))) # 文件夹 directory = 'E:\\Ebooks\\' # 将书名和链接写入txt文件中,便于永久使用 with open(directory+'book.txt', 'w') as f: for item in book_list: f.write(str(item)+'\n') print('写入txt文件完毕!') 可以看到,上述代码主要爬取的是静态页面,因此效率非常高!运行该程序,显示结果如下: 在book.txt文件中储存了这10本电子书的下载地址,如下: 接着我们再读取这些下载链接,用urllib.request.urlretrieve()函数和多线程来下载这些电子书。其Python代码(download_ebook.py)如下: # -*- coding:utf-8 -*- # 本爬虫读取已写入txt文件中的电子书的链接,并用多线程下载 import time from concurrent.futures import ThreadPoolExecutor, wait, ALL_COMPLETED import urllib.request # 利用urllib.request.urlretrieve()下载PDF文件 def download(url): # 书名 book_name = 'E:\\Ebooks\\'+url.split('/')[-1] print('Downloading book: %s'%book_name) # 开始下载 urllib.request.urlretrieve(url, book_name) print('Finish downloading book: %s'%book_name) #完成下载 def main(): start_time = time.time() # 开始时间 file_path = 'E:\\Ebooks\\book.txt' # txt文件路径 # 读取txt文件内容,即电子书的链接 with open(file_path, 'r') as f: urls = f.readlines() urls = [_.strip() for _ in urls] # 利用Python的多线程进行电子书下载 # 多线程完成后,进入后面的操作 executor = ThreadPoolExecutor(len(urls)) future_tasks = [executor.submit(download, url) for url in urls] wait(future_tasks, return_when=ALL_COMPLETED) # 统计所用时间 end_time = time.time() print('Total cost time:%s'%(end_time - start_time)) main() 运行上述代码,结果如下: 再去文件夹中查看文件: 可以看到这10本书都已成功下载,总共用时327秒,每本书的平均下载时间为32.7,约半分钟,而这些书的大小为87.7MB,可见效率相当高的! 怎么样,看到爬虫能做这些多有意思的事情,不知此刻的你有没有心动呢?心动不如行动,至理名言~~ 本次代码已上传github, 地址为: https://github.com/percent4/Examples-of-Python-Spiders . 注意:本人现已开通两个微信公众号: 用Python做数学(微信号为:python_math)以及轻松学会Python爬虫(微信号为:easy_web_scrape), 欢迎大家关注哦~~

优秀的个人博客,低调大师

Swift的类,及存储属性,计算发发样码

进入机械的学习模式, 就是把代友敲完。 以期能加深些记忆。 struct Resolution { var width = 0 var height = 0 } class VideoMode { var resolution = Resolution() var interlaced = false var frameRate = 0.0 var name: String? } let someResolution = Resolution(width: 640, height: 480) let someVideoMode = VideoMode() print("The width of someResolution is \(someResolution.width)") someVideoMode.resolution.width = 1280 print("The width of someVedioMode is \(someVideoMode.resolution.width)") let hd = Resolution(width: 1920, height: 1080) var cinema = hd cinema.width = 2048 print("cienma is now \(cinema.width) pixels wide") print("hd is still \(hd.width) pixels width") enum CompassPoint { case North, South, East, West } var currentDirection = CompassPoint.West let rememberedDirection = currentDirection currentDirection = .East if rememberedDirection == .West { print("The remembered direction is still .West") } let tenEighty = VideoMode() tenEighty.resolution = hd tenEighty.interlaced = true tenEighty.name = "1080i" tenEighty.frameRate = 25.0 let alsoTenEighty = tenEighty alsoTenEighty.frameRate = 30.0 print("The frameRate property of tenEighty is now \(tenEighty.frameRate)") struct Point { var x = 0.0, y = 0.0 } struct Size { var width = 0.0, height = 0.0 } struct Rect { var origin = Point() var size = Size() var center: Point { get { let centerX = origin.x + (size.width / 2) let centerY = origin.y + (size.height / 2) return Point(x: centerX, y: centerY) } set(newCenter) { origin.x = newCenter.x - (size.width / 2) origin.y = newCenter.y - (size.height / 2) } } } var square = Rect(origin: Point(x: 0.0, y: 0.0), size: Size(width: 10.0, height: 10.0)) let initialSquareCenter = square.center square.center = Point(x: 15.0, y: 15.0) print("square.origin is now at (\(square.origin.x), \(square.origin.y))") class StepCounter { var totalSteps: Int = 0 { willSet(newTotalSteps) { print("About to set totalSteps to \(newTotalSteps)") } didSet { if totalSteps > oldValue { print("Added \(totalSteps - oldValue) steps") } } } } let stepCounter = StepCounter() stepCounter.totalSteps = 200 stepCounter.totalSteps = 360 stepCounter.totalSteps = 896 struct SomeStructure { static var storedTypeProperty = "Some value" static var computedTypeProperty: Int { return 1 } } enum SomeEnumeration { static var storedTypeProperty = "Some value" static var computedTypeProperty: Int { return 6 } } class SomeClass { static var storedTypeProperty = "Some value" static var computedTypeProperty: Int { return 27 } class var overrideableComputedTypeProperty: Int { return 107 } } print(SomeStructure.storedTypeProperty) SomeStructure.storedTypeProperty = "Another value" print(SomeStructure.storedTypeProperty) print(SomeEnumeration.computedTypeProperty) print(SomeClass.computedTypeProperty)

优秀的个人博客,低调大师

三步骤快速开发 iOS资讯类App

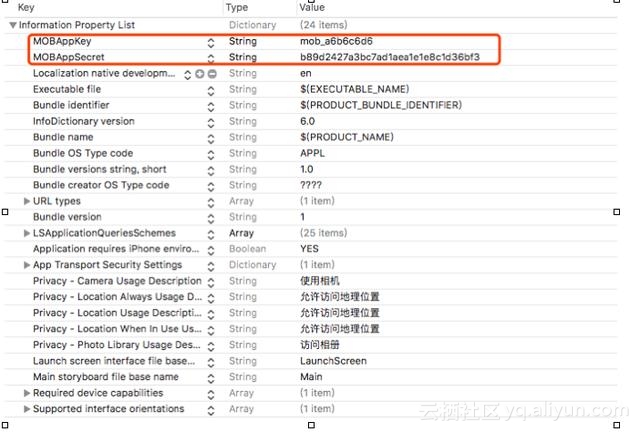
CMSSDK为新闻创造者及自媒体人推出,微信自媒体,头条号,微博红人,简书等自媒体达人,仅需10分钟快速 集成SDK生成App,让粉丝使用您的专属App。只要三步骤可快速开发出 iOS版本,下面看下步骤吧。一 、获取AppKey、AppSecret1.如何在mob上创建应用添加产品,可以参考这个注册应用的流程。2.从上述步骤申请并获取所得的AppKey, AppSecret,请在项目的Info.plist中分别添加’MOBAppKey’, ‘MOBAppSecret’此两字段并分别对应填入,如图 二 、 下载SDK并添加到项目(1)手动到官网下载并添加i.解压后名为SDK的文件夹内会包含如下内容 将整个名为’SDK’的文件夹拖入到Xcode项目中,如图操作所示 ii.添加项目依赖如图所示: 需要添加的系统依赖库: (2)pod导入1、首先 cd 至项目的根目录,执行 pod setup;2、按需在 Podfile 文件中添加命令:pod'mob_cmssdk'3、如果之前没有安装过,第一次使用请先执行安装库:pod install,如果之前一次没有已经安装过,那只需要在执行更新库:pod update三 、添加使用的代码资讯SDK通过直接展示控制器的方式来完成资讯的展示,因此集成使用仅需要初始化控制器并展示即可。1.导入头文件 #import <CMSSDKUI/CMSArticleListViewController.h> 2.初始化CMSArticleListViewController,并直接展现可选选择向控制器传入user,此user将影响到资讯展示中与评论相关的功能。建议应传入有效的用户信息 扩展(可选):在设定CMSArticleListViewController的用户时,可使用自定义用户,也可使用UMS用户,示例代码如下: 3.至此,您已经完成了CMSSDK最简单的集成!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册